
Last chance! 50% off DataCamp Premium
Sale ends in
I dati sono la base delle organizzazioni moderne, ma l’enorme volume di informazioni raccolte e archiviate può essere difficile da gestire. La chiave del successo sta nell’organizzare e analizzare efficacemente questi dati per scoprire insight preziosi che guidino decisioni informate.
Qui entra in gioco il data warehousing. È una soluzione potente che consente alle aziende di consolidare e ottimizzare i propri dati per un’analisi efficiente. E quando si parla di data warehousing, AWS Redshift si distingue come una delle scelte migliori.
In questo articolo esploreremo nel dettaglio AWS Redshift, insieme alle sue caratteristiche principali, ai benefici e alle best practice per configurazione, caricamento dei dati, interrogazione, tuning delle prestazioni, sicurezza e integrazioni.
Che tu sia un professionista dei dati o un decision maker che vuole sfruttare al massimo i propri dati, questo articolo ti fornirà conoscenze e strumenti per avere successo con AWS Redshift.
Il data warehousing è il processo di raccolta, archiviazione e gestione di grandi quantità di dati strutturati provenienti da varie fonti all’interno di un’organizzazione.
L’obiettivo principale di un data warehouse è fornire un repository centralizzato di informazioni facilmente accessibili, analizzabili e utilizzabili per reportistica e decision making.
I data warehouse sono progettati per supportare query complesse e analisi dei dati, consentendo alle aziende di ricavare insight di valore dai propri dati.
Adottare un data warehouse può offrire alle organizzazioni numerosi vantaggi:
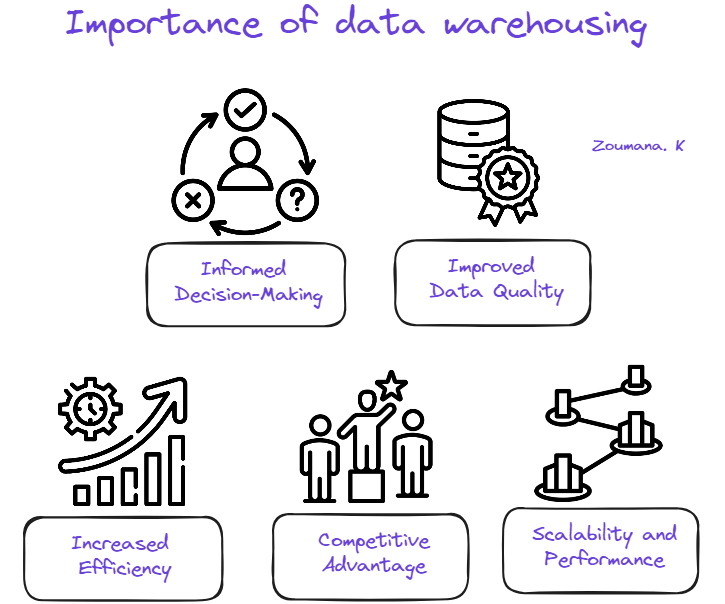
Importanza del data warehousing
AWS Redshift è un servizio di data warehousing completamente gestito e basato sul cloud che consente di archiviare e analizzare dataset su scala petabyte. Con AWS Redshift Serverless, puoi accedere e analizzare i dati senza dover configurare manualmente un data warehouse con capacità preallocata.
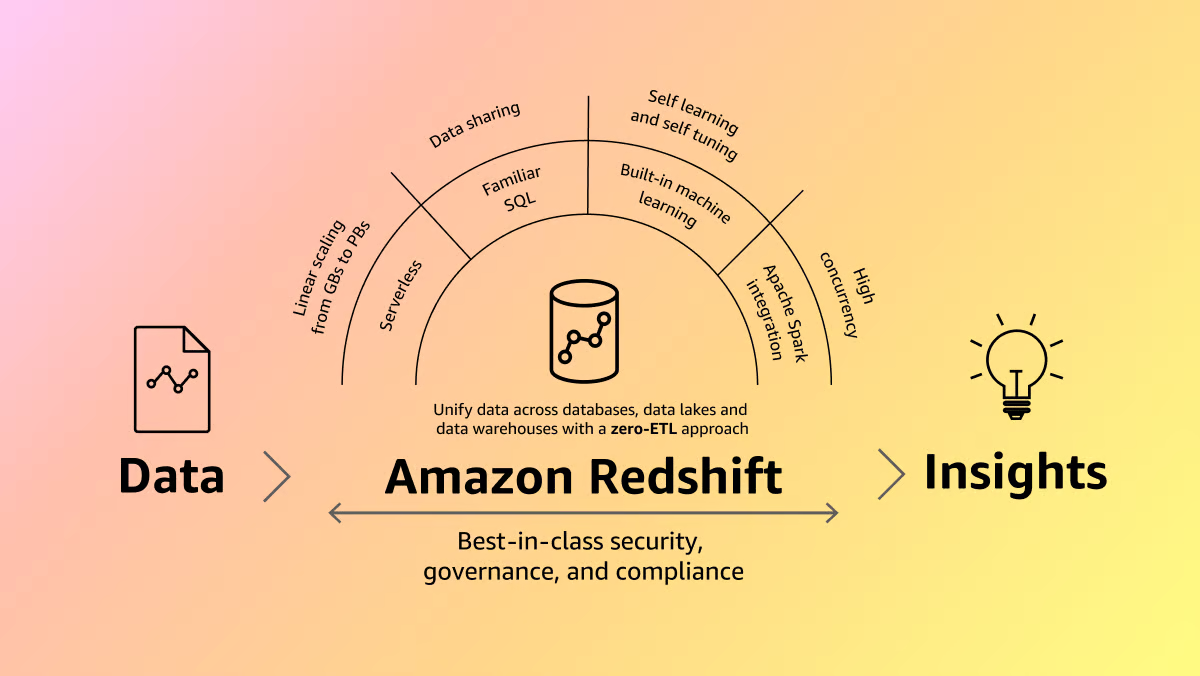
Amazon Redshift (Fonte)
Il servizio effettua automaticamente il provisioning delle risorse e scala in modo intelligente la capacità del data warehouse per garantire prestazioni rapide, anche per carichi di lavoro molto esigenti e imprevedibili. Paghi solo per le risorse effettivamente utilizzate, perché non ci sono addebiti quando il data warehouse è inattivo.
AWS Redshift consente di caricare i dati e iniziare subito a interrogare usando Amazon Redshift query editor v2 o il tuo strumento di business intelligence (BI) preferito. Il servizio offre il miglior rapporto prezzo/prestazioni e funzionalità SQL familiari in un ambiente semplice, senza necessità di amministrazione.
Indipendentemente dalle dimensioni del dataset, AWS Redshift garantisce prestazioni di query elevate utilizzando gli stessi strumenti basati su SQL e le stesse applicazioni BI comunemente in uso oggi.
AWS Redshift offre numerose funzionalità e vantaggi per aiutare le organizzazioni a archiviare, gestire e analizzare in modo efficiente grandi volumi di dati. Alcune delle caratteristiche e dei benefici chiave sono illustrati di seguito:
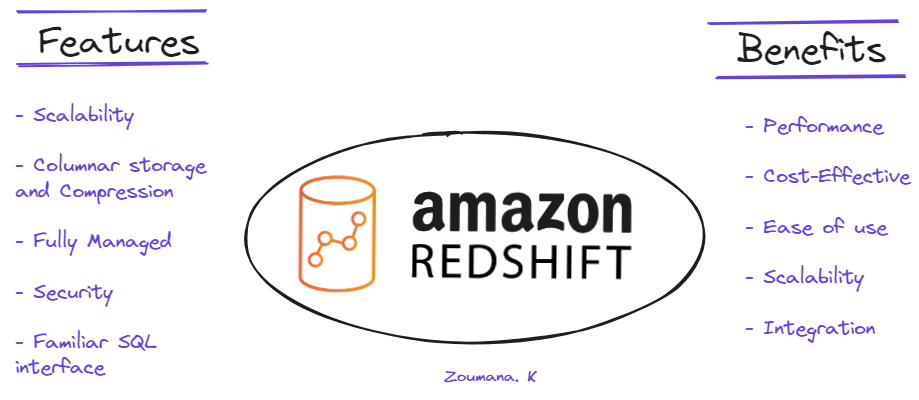
Caratteristiche e vantaggi di AWS Redshift
Le sezioni precedenti si sono concentrate soprattutto sulla comprensione generale di Redshift. Ora passiamo agli aspetti tecnici.
Questa sezione illustra prima i prerequisiti principali per configurare correttamente AWS Redshift, poi guida passo passo nella creazione di un cluster Redshift. L’ultima parte si concentra su una spiegazione dettagliata delle impostazioni chiave del cluster, come tipi di nodo, numero di nodi e configurazione della sicurezza.
Prima di addentrarci nei dettagli del caso d’uso, rivediamo i prerequisiti necessari per un’implementazione di successo:
Questa sezione fornisce tutti i passaggi per creare un cluster Redshift tramite la Console di gestione AWS in 11 semplici step, come illustrato di seguito:
1. Cerca Redshift dalla console e seleziona “Amazon Redshift”:
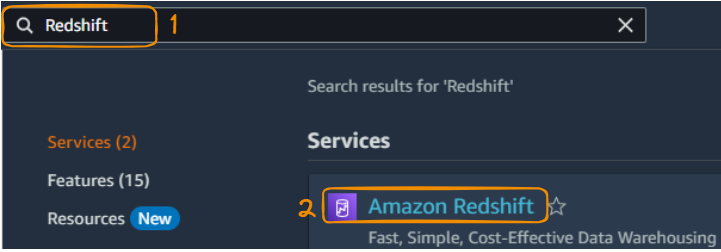
Cerca e seleziona Redshift dalla Management Console
2. Seleziona il pulsante “Create Cluster” per iniziare a creare un cluster.
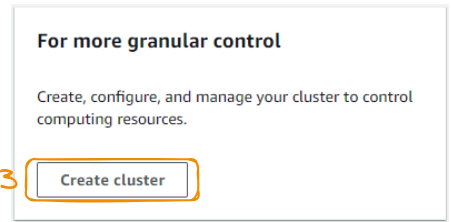
Pulsante di creazione del cluster
3. Da questa azione possiamo configurare il cluster fornendo informazioni come identificatore del cluster, dimensione del cluster, tipo di nodo, scelta della zona di disponibilità, numero di nodi.
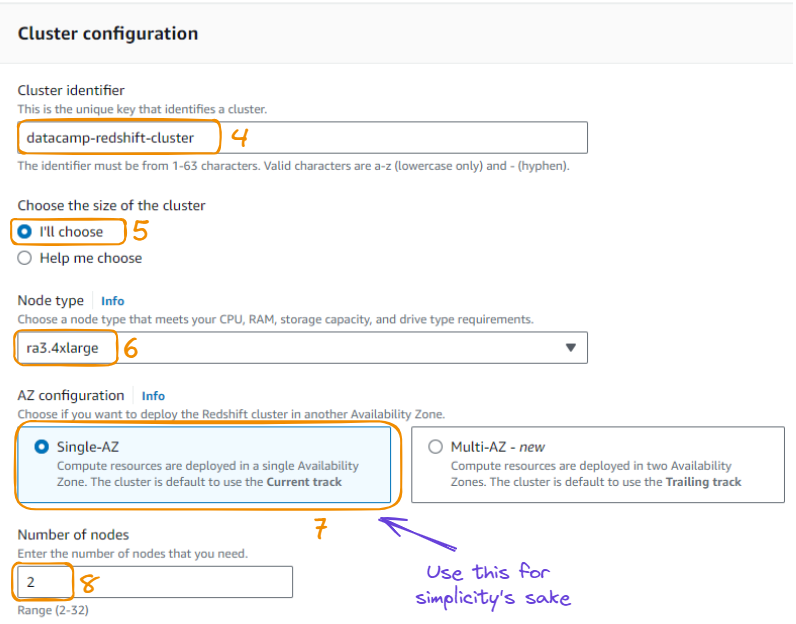
Configurazione del cluster in 8 passaggi
4. Invece di usare i dati di esempio suggeriti nella stessa pagina, useremo dati da un bucket S3 per caricarli in Redshift.
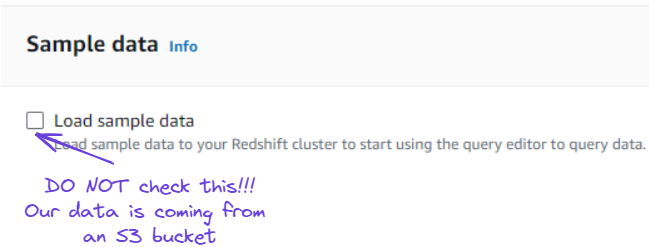
Ignora l’opzione di caricamento dei dati di esempio
5. È possibile definire le autorizzazioni dei cluster fornendo ruoli IAM. Questa sezione può essere ignorata e affrontata in seguito.
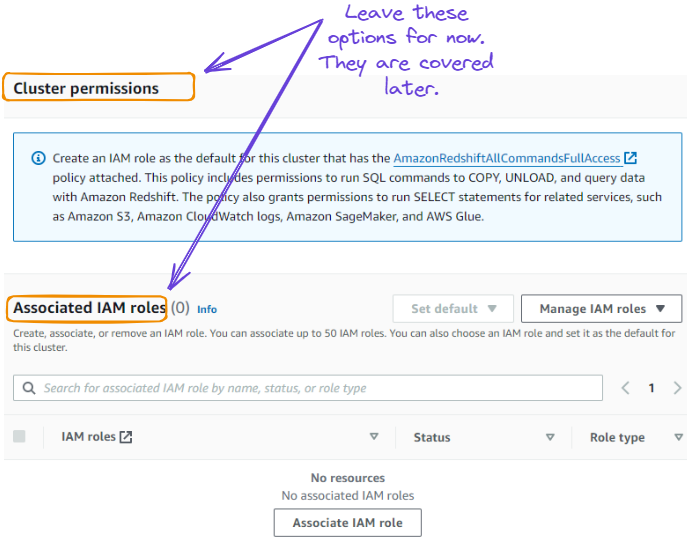
Ignora i permessi del cluster e i ruoli IAM
6. Lascia le configurazioni predefinite per rete, sicurezza, backup, manutenzione e seleziona il pulsante “Create cluster” per creare il cluster.
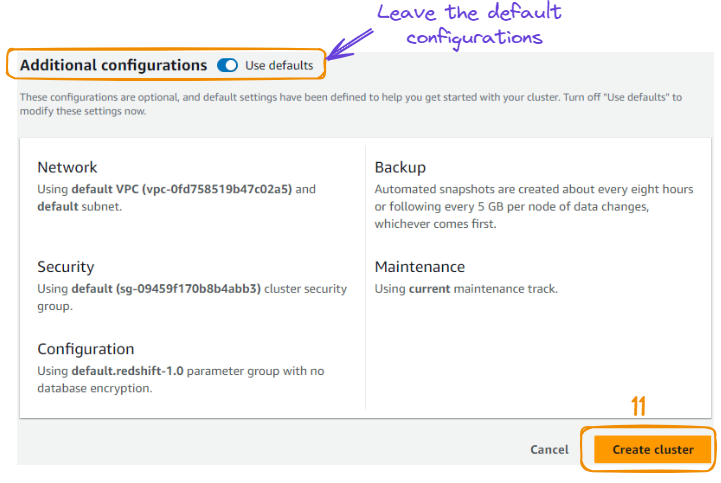
Creazione del cluster
7. Dopo l’azione precedente, verrai reindirizzato a una nuova pagina che mostra il cluster appena creato. La creazione potrebbe richiedere alcuni minuti; lo stato passa da “Creating” a “Available”.
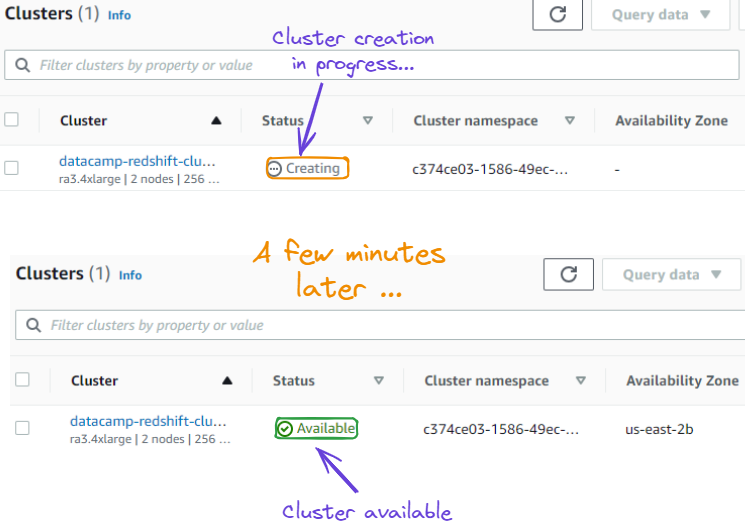
Stato del cluster da “Creating” a “Available”
Abbiamo creato con successo i nostri cluster Redshift. Questa sezione ti guida attraverso tutti i passaggi, dalla scelta del dataset sul PIL (Prodotto Interno Lordo) per Paese, Regione e Mondo disponibile sul nostro DataLab fino al caricamento in un bucket S3.
I nostri dati provengono originariamente dal dataset della Banca Mondiale. Riguardano il PIL di paesi, regioni e mondo, misurato in dollari USA correnti ($). Le regioni si riferiscono a insiemi di paesi, come Europa e Asia centrale.
Le prime dieci osservazioni dei dati sono così:
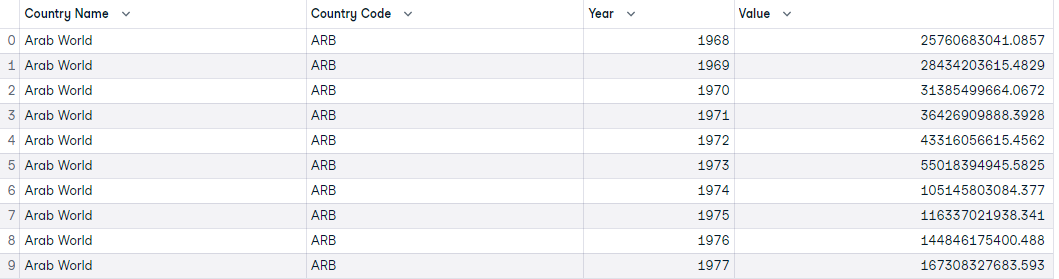
Prime dieci osservazioni dei dati sul PIL
Per un’interazione corretta tra S3 e Redshift dobbiamo prima creare un ruolo IAM e poi creare un bucket S3 per archiviare i dati.
Il vantaggio di creare un ruolo IAM è che stabilisce una connessione tra il nostro cluster Redshift e il bucket S3 che contiene i dati.
La creazione del ruolo IAM avviene così:
Dalla Management Console, cerca “IAM” e seleziona il logo “IAM” dai risultati.
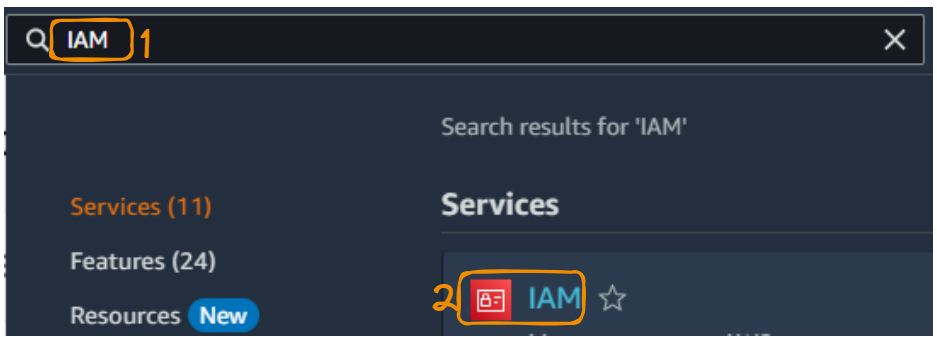
Servizio IAM dalla Management Console
Seleziona “Roles” per visualizzare tutti i ruoli possibili e scegli “Create role” per crearne uno nuovo.
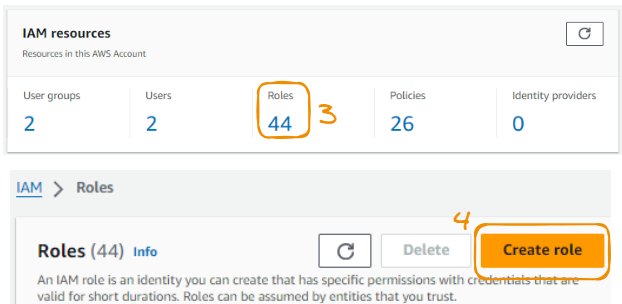
Inizio creazione di un nuovo ruolo
Scegli “AWS service” nel campo “Trusted entity type”, poi “Redshift” come “Use case” e “Next” per continuare.
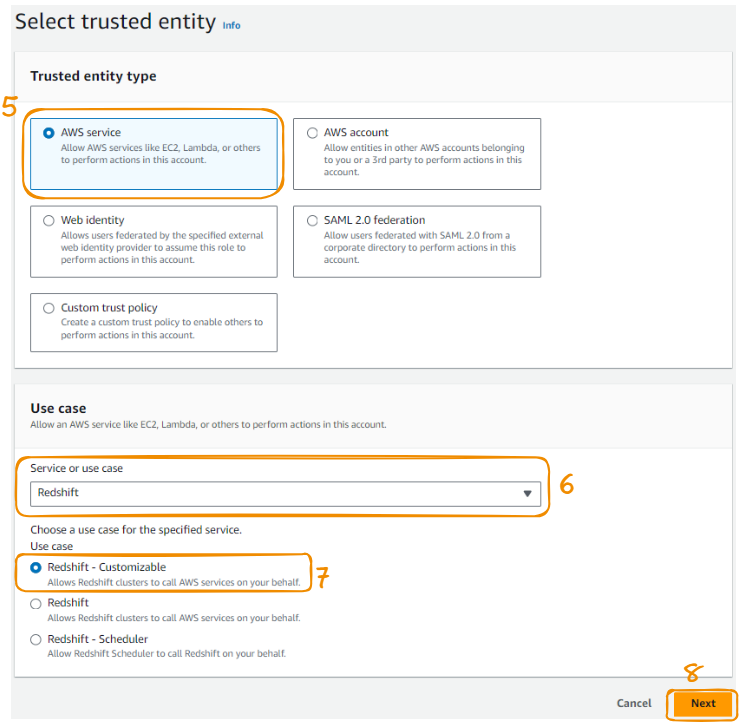
Passaggi 5–8 della creazione del ruolo AMI
Trova “S3FullAccess” dalla barra di ricerca, spunta l’opzione e seleziona “Next”.
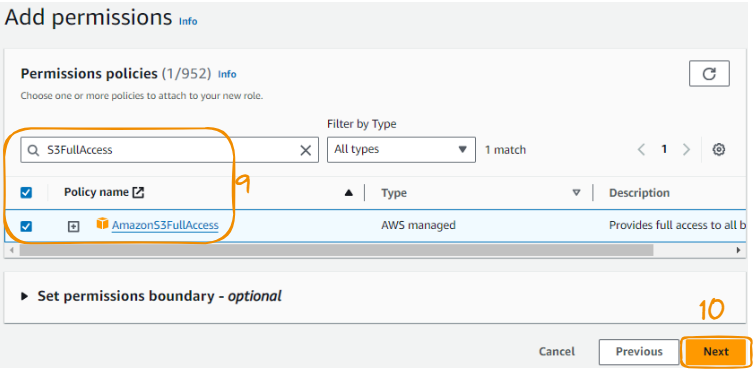
Passaggi 9–10 della creazione del ruolo AMI
Infine, assegna un nome al ruolo, rivedi i dettagli e scegli il pulsante “Create role” per completare la creazione.
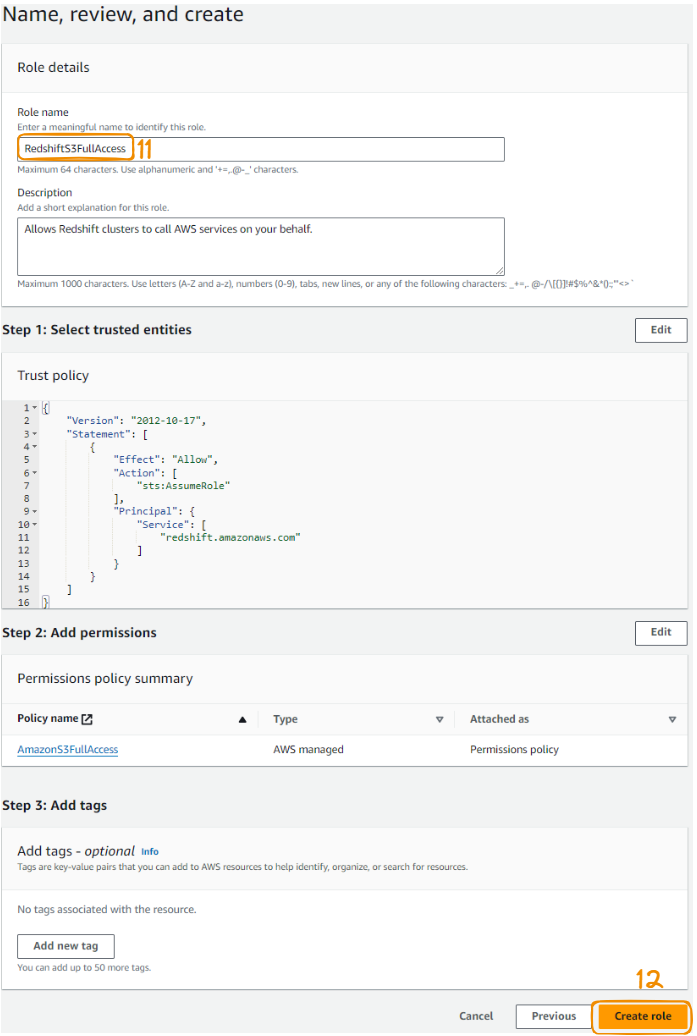
Passaggi 11–12 della creazione del ruolo AMI
Una volta andato tutto a buon fine, nell’angolo in alto comparirà il seguente messaggio verde di conferma della creazione del ruolo.
Messaggio di conferma creazione ruolo
Ora che abbiamo il ruolo IAM, possiamo collegarlo al cluster Redshift creato inizialmente, come segue:
Dalla sezione dei cluster, seleziona il cluster datacamp creato e, sotto “Actions”, scegli “Manage IAM roles”.
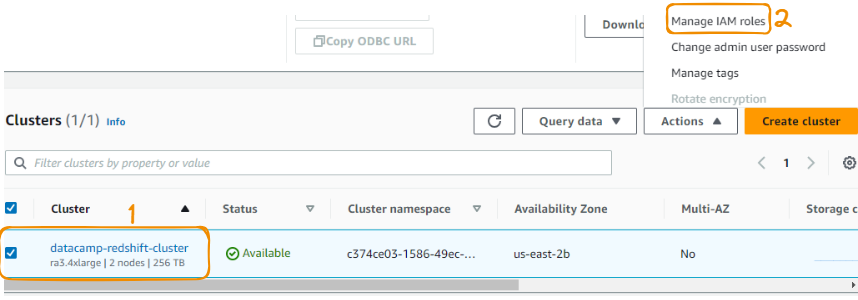
Collegare il ruolo IAM a Redshift: passaggi 1–2
In questa sezione, scegli il ruolo IAM creato in precedenza e salva le modifiche.
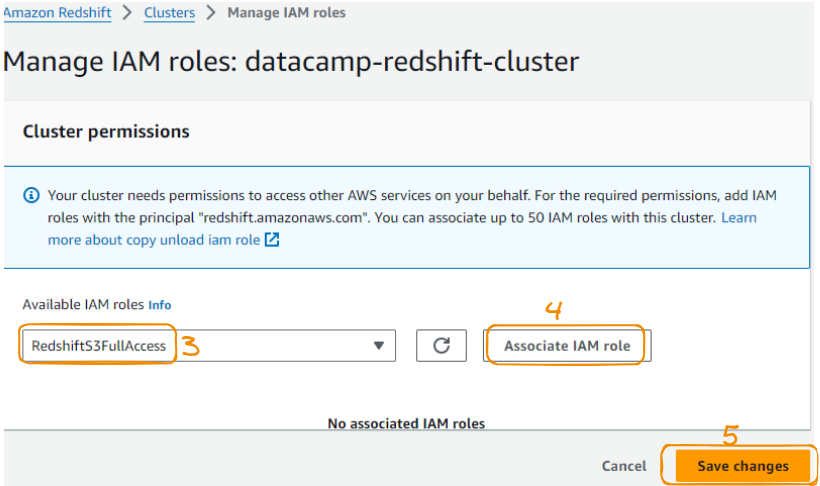
Collegare il ruolo IAM a Redshift: passaggi 3–4
Per interrogare i dati in Redshift si possono usare vari strumenti, interni ad AWS o esterni. In questo tutorial usiamo il query editor dalla Dashboard di Redshift.
Per usarlo dobbiamo prima creare una connessione al Query editor, partendo dall’opzione “Query in query editor” nella scheda “Query data”:
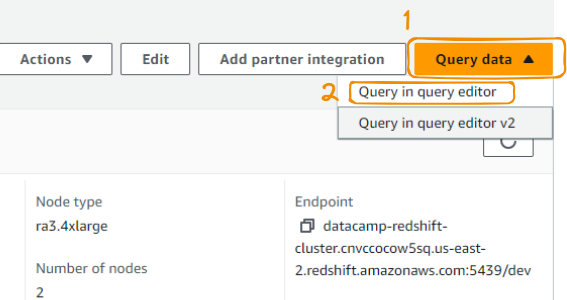
Query editor dalla scheda Query data
Questa azione porta alla pagina seguente, dove possiamo connetterci al database dopo avergli assegnato un nome e un nome utente come segue:
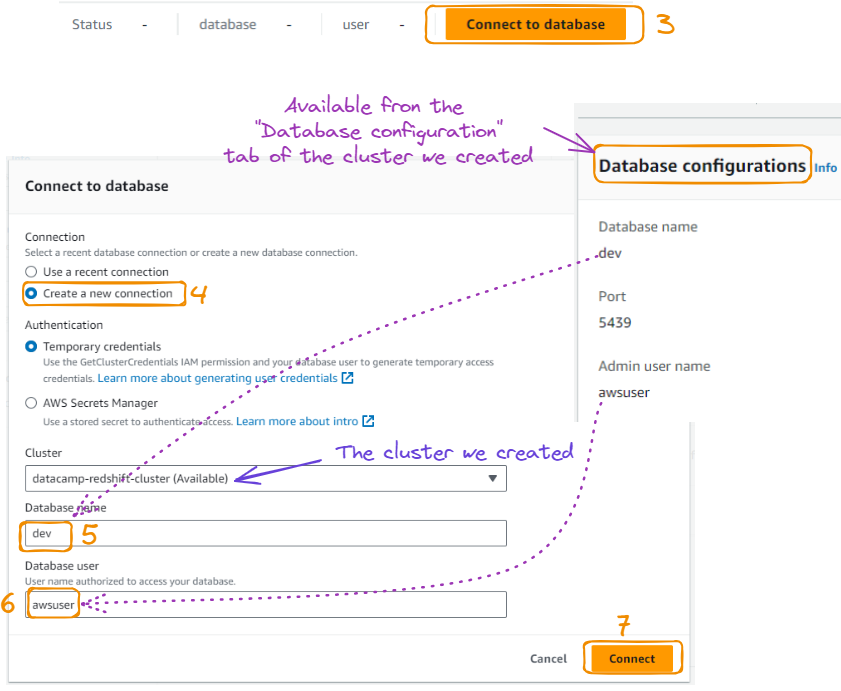
Connessione al database dal query editor
Dopo aver premuto “Connect”, vediamo la scheda verde “Connected” in alto e le informazioni del database a sinistra.
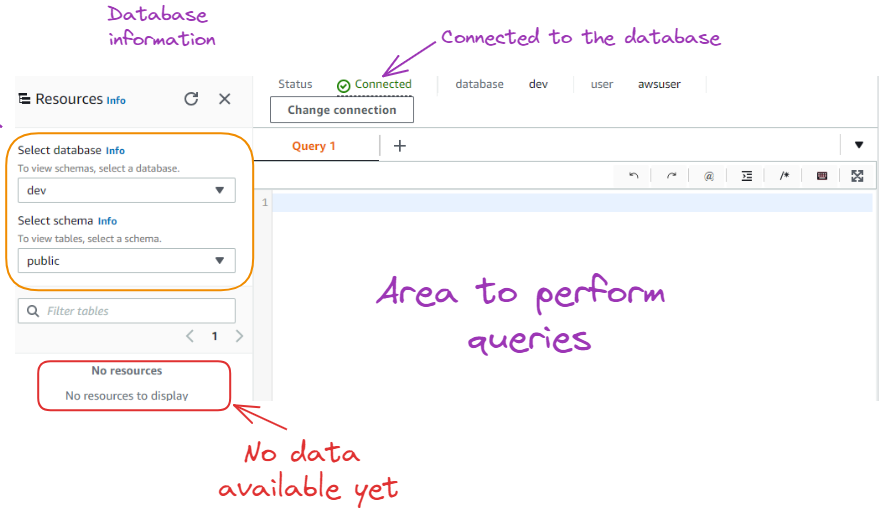
Risultato dopo la connessione al database
Come si vede sopra, nel database non sono ancora disponibili risorse/dati. Prima di importare i dati, dobbiamo creare una tabella con le stesse caratteristiche dei dati da importare.
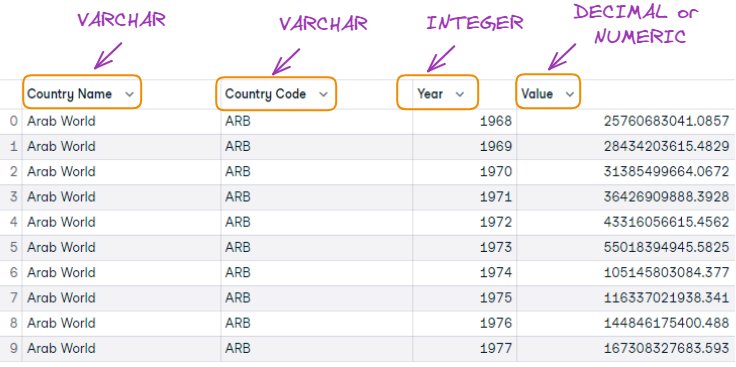
Corrispondenza tra prime 10 osservazioni e formato delle colonne della tabella
La tabella viene creata con la seguente query SQL:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
Ecco una spiegazione della query SQL, un punto per ogni colonna:
id INTEGER PRIMARY KEY: Crea una colonna chiamata "id" di tipo INTEGER e la imposta come chiave primaria della tabella, garantendo valori univoci per ogni riga.country_name VARCHAR(255): Crea una colonna chiamata "country_name" di tipo VARCHAR, che consente di archiviare stringhe fino a 255 caratteri.country_code VARCHAR(10): Crea una colonna chiamata "country_code" di tipo VARCHAR, che consente di archiviare stringhe fino a 10 caratteri.year INTEGER: Crea una colonna chiamata "year" di tipo INTEGER, adatta a memorizzare numeri interi (in questo caso, gli anni).value DECIMAL(20,2): Crea una colonna chiamata "value" di tipo DECIMAL, che consente di archiviare numeri decimali con una precisione di 20 cifre e 2 decimali.Ora eseguiamo la query per creare la tabella:
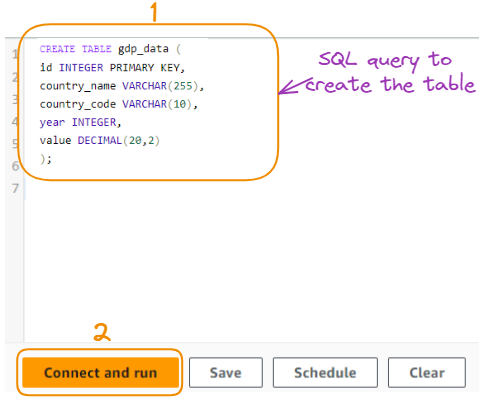
Query per creare la tabella
Questa query crea una tabella chiamata "gdp_data" con le colonne specificate per archiviare i dati sul PIL, come mostrato di seguito:
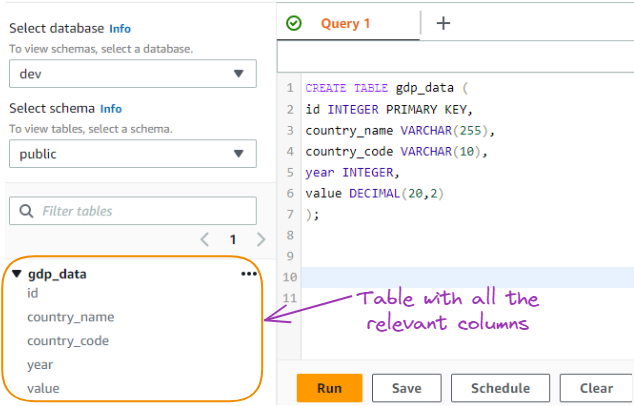
Tabella dei dati sul PIL creata dalla query SQL
I dati verranno importati nella tabella da un bucket S3. In questa sezione copriamo tutti i passaggi per creare il bucket e caricare i dati.
Trova il servizio S3 dalla Management Console, seleziona il relativo logo e assegnagli un nome lasciando tutto il resto predefinito:
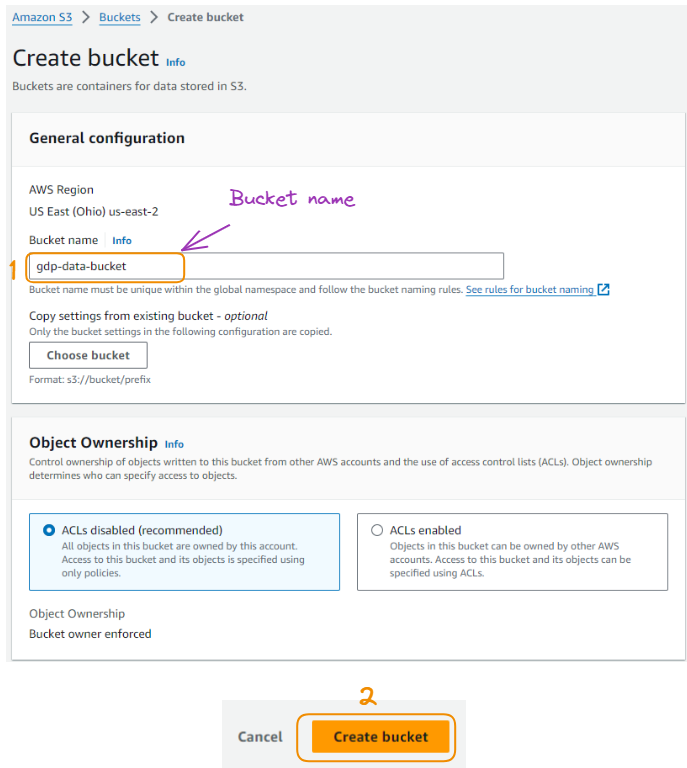
Creazione del bucket S3
Una volta creato, il bucket sarà disponibile nell’elenco di tutti i bucket creati in passato.
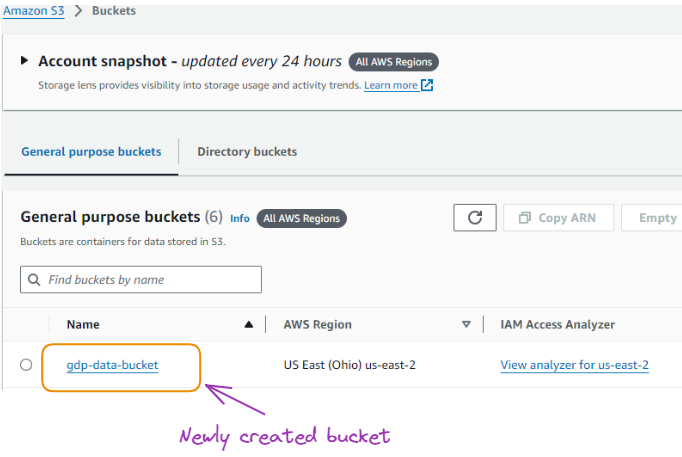
Il bucket appena creato
Da qui possiamo selezionare il nome del bucket e caricare i dati sul PIL scaricati in locale in formato CSV.
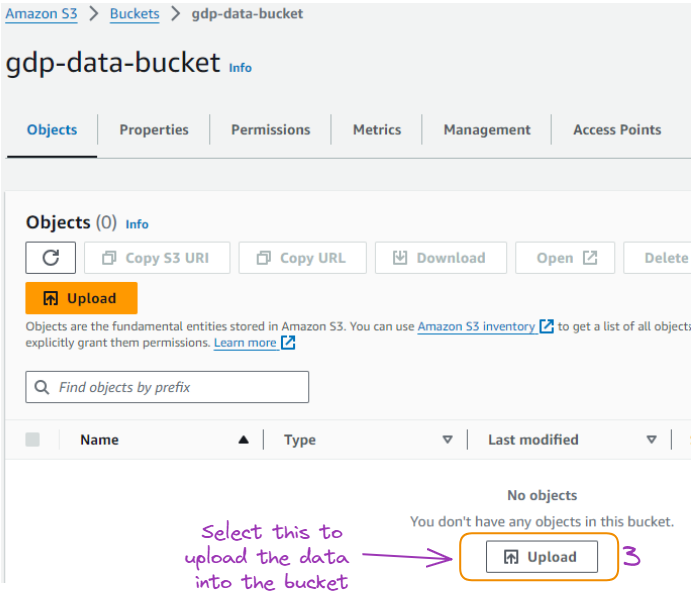
Pagina per caricare i dati nel bucket
Dopo aver importato correttamente i dati, questi saranno disponibili come mostrato di seguito:
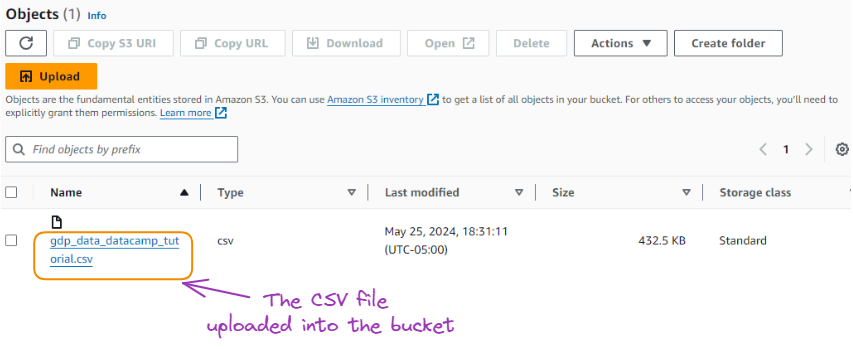
Il CSV caricato nel bucket
Complimenti per essere arrivato fin qui!
Questa sezione illustra come copiare i dati da S3 in Redshift come segue.
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Vediamo cosa succede qui:
Lo stesso codice dall’editor è riportato di seguito e l’operazione di copia è stata completata con successo dopo pochi secondi:
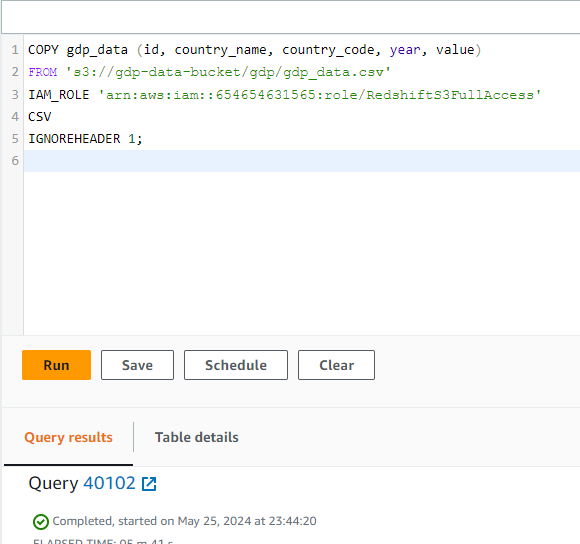
Attività COPY completata
Per semplicità, invece di caricare tutti i dati del CSV originale, è stato caricato solo un campione casuale di cento osservazioni. Possiamo avere un’anteprima dei dati selezionando l’opzione “Preview data” come segue:
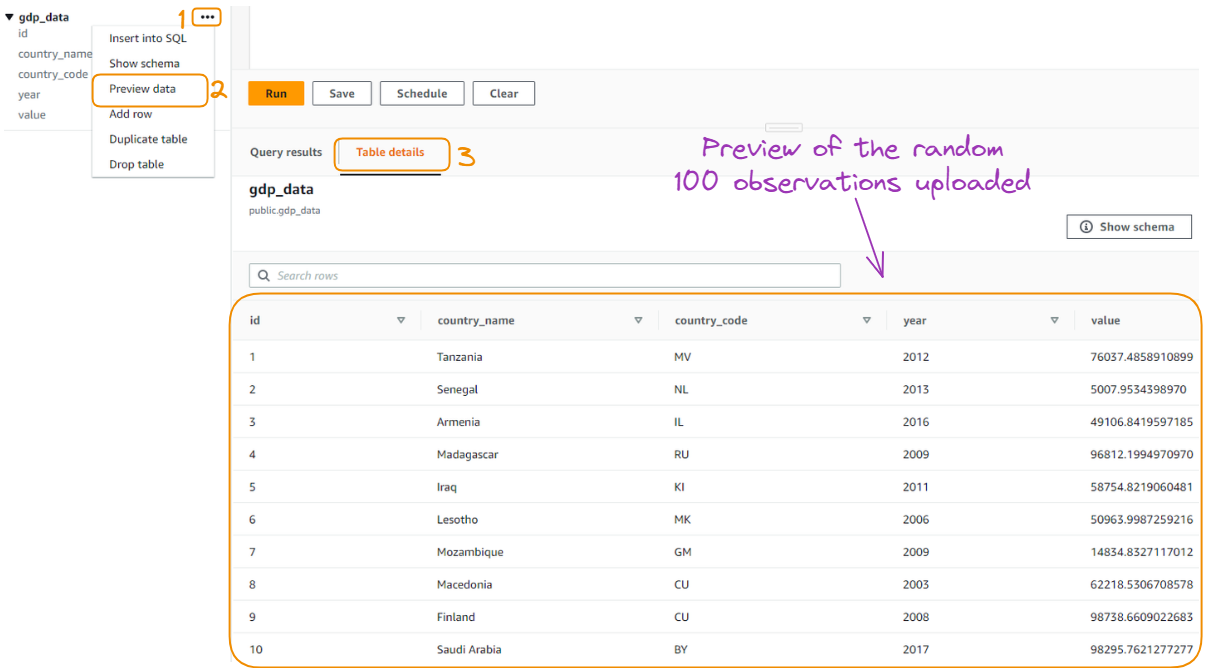
Anteprima delle 100 osservazioni caricate casualmente
L’anteprima dei dati mostra solo le prime dieci righe. Tuttavia, potremmo voler interagire di più con i nostri dati per ottenere insight: qui tornano utili le competenze SQL.
In questa sezione esploriamo i dati tramite alcune query SQL.
Useremo cinque query SQL per interagire con i dati nel nostro database, a partire dalla più comune: la selezione dei dati.
Selezionare tutti i dati
SELECT *
FROM gdp_data;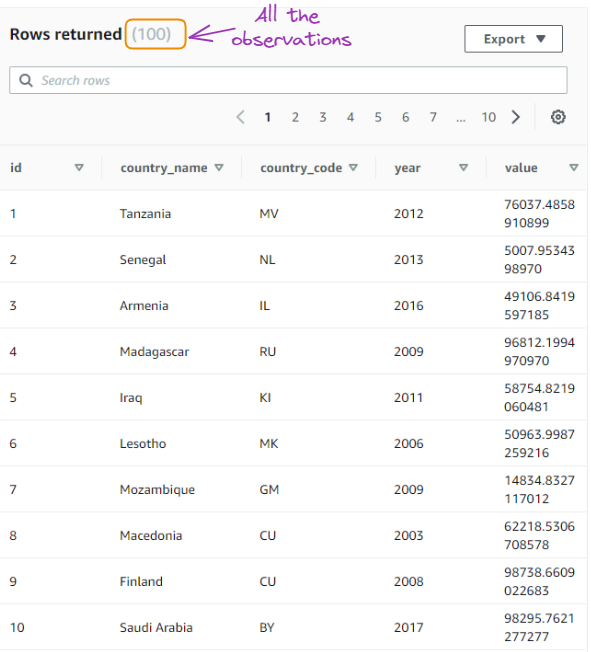
Risultato della prima query
Selezionare i dati per un paese specifico:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';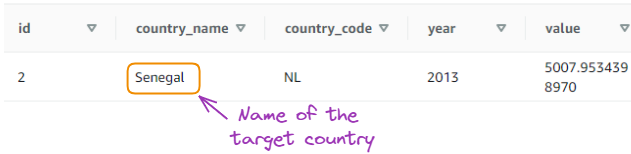
Risultato della seconda query
Calcolare il valore medio del PIL per un anno specifico:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;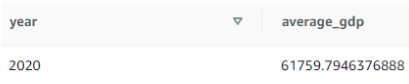
Risultato della terza query
Trovare i 5 paesi con il PIL più alto in un anno specifico:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;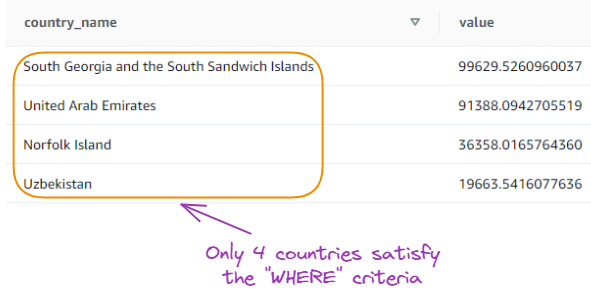
Risultato della quarta query
Contare il numero di record per anno:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;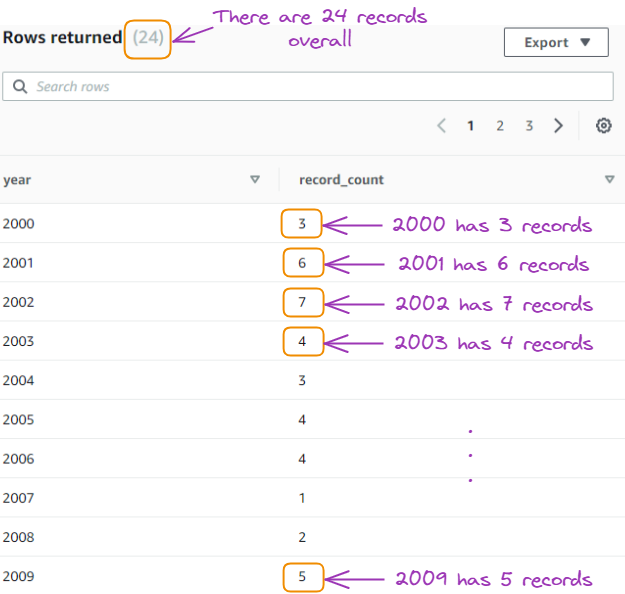
Risultato della quinta query
Le query precedenti hanno fornito una comprensione di base dei dati; qui vediamo tre tecniche avanzate di interrogazione.
Calcolo del totale progressivo: questa query calcola il totale progressivo dei valori del PIL per ciascun paese, ordinato per anno.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;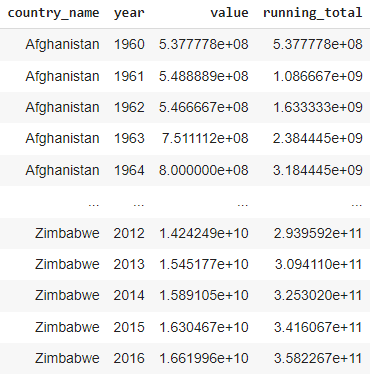
Risultato del totale progressivo
CTE per filtraggio e aggregazione: questa query usa una CTE per filtrare i dati includendo solo i record dal 2020 in poi e calcolare quindi il PIL medio per ciascun paese.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;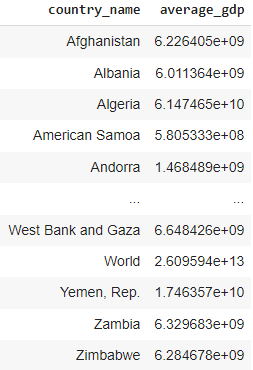
Risultato dalle CTE
Calcolare la crescita del PIL anno su anno: con questa query calcoliamo la crescita anno su anno del PIL per ciascun paese.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;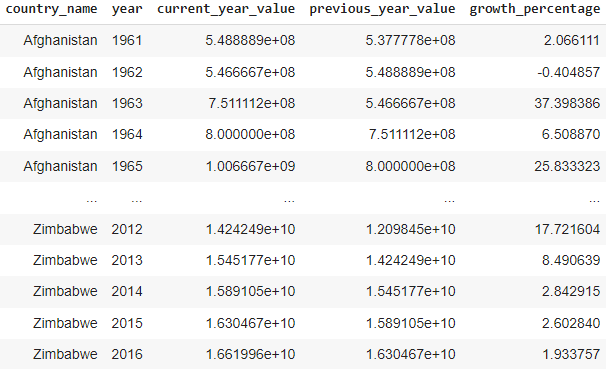
Risultato della query con self join
Per garantire prestazioni ottimali e convenienza economica, è fondamentale comprendere i fattori che influenzano le prestazioni di Redshift e applicare le best practice per il tuning del nostro cluster.
In questa sezione analizzeremo gli aspetti chiave del tuning delle prestazioni su Redshift e forniremo spunti basati sulle informazioni del cluster indicato.
Le prestazioni in Amazon Redshift sono influenzate da molteplici fattori, dalle configurazioni hardware alle tecniche di ottimizzazione delle query; comprenderli è essenziale per individuare colli di bottiglia e prendere decisioni migliori per migliorare le prestazioni del cluster.
Abbiamo configurato un cluster Redshift composto da due nodi ra3.4xlarge e i dati utilizzati pesano solo 391 KB.
Inoltre, l’immagine seguente mostra che l’utilizzo della CPU del cluster rimane vicino allo 0% per tutto il periodo, indicando che il cluster non è molto utilizzato e potrebbe essere sovradimensionato per il nostro carico attuale.
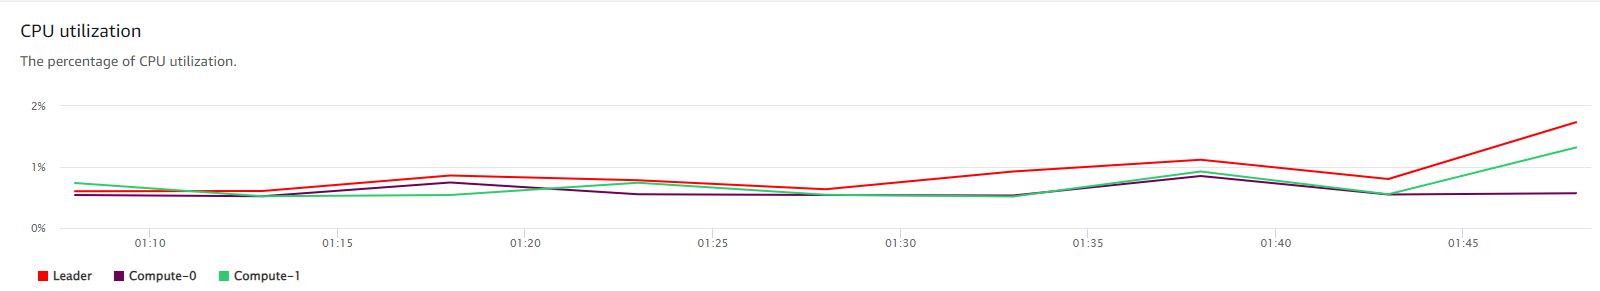
Utilizzo della CPU del nostro cluster
Alcuni fattori chiave che impattano le prestazioni di Redshift includono:
Per ottimizzare le prestazioni del nostro cluster è importante seguire le best practice nella progettazione delle tabelle e nella gestione dei dati. Anche con un dataset piccolo, applicarle pone basi solide per la crescita futura e l’efficienza.
Il monitoraggio e la manutenzione regolari del cluster sono essenziali per garantire prestazioni ottimali ed efficienza dei costi. L’immagine seguente mostra il dettaglio dei nostri costi mensili su Redshift, evidenziando opportunità di ottimizzazione.
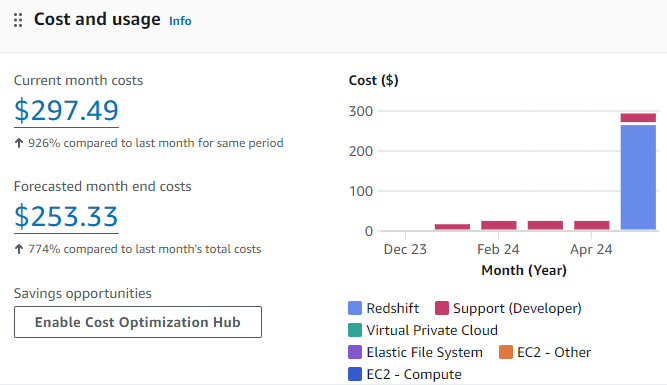
Grafico di costi e utilizzo per l’attuale caso d’uso Redshift
In base all’immagine sopra, il nostro cluster Redshift sembra sovradimensionato per il dataset attuale, con bassa utilizzazione e inefficienze sui costi.
Utilizzando strumenti AWS come Amazon CloudWatch e la Console di gestione AWS, possiamo monitorare metriche chiave come utilizzo della CPU e prestazioni delle query. Queste informazioni aiutano a individuare problemi e a prendere decisioni data-driven per l’ottimizzazione del cluster.
Dato il basso utilizzo del cluster, possiamo considerare le seguenti strategie di ottimizzazione dei costi:
Con l’aumentare del volume dei dati e l’evoluzione del carico, monitora continuamente le prestazioni del cluster e rivaluta dimensionamento e strategie di ottimizzazione di conseguenza.
Quando si lavora con dati sensibili in Amazon Redshift, garantire i più alti standard di sicurezza e conformità è importante. Con requisiti normativi in crescita e la necessità di proteggere informazioni sensibili, implementare solide misure di sicurezza e rispettare le linee guida di conformità diventa cruciale nella gestione del cluster Redshift.
La conformità a normative specifiche di settore e leggi sulla protezione dei dati è una priorità per le organizzazioni che trattano dati sensibili. Amazon Redshift offre funzionalità e capacità per aiutarci a soddisfare efficacemente tali requisiti.
Oltre alla conformità, implementare best practice per la sicurezza dei dati in Amazon Redshift è fondamentale per proteggere le informazioni sensibili da accessi non autorizzati e potenziali violazioni.
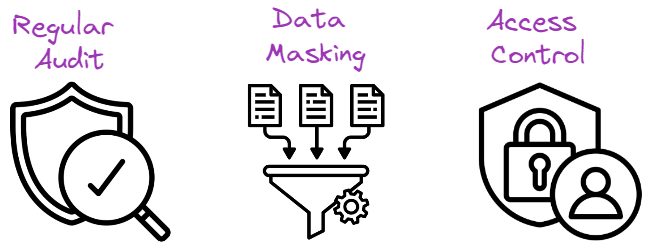
Best practice per la sicurezza dei dati
Eseguire audit di sicurezza regolari è essenziale per identificare vulnerabilità, valutare l’efficacia delle misure esistenti e garantire la conformità continua. Prendi in considerazione le seguenti pratiche di audit:
Il data masking è una tecnica che prevede l’offuscamento di elementi sensibili mantenendo la struttura e il formato dei dati. Mascherando le informazioni sensibili, possiamo proteggerle da accessi non autorizzati e preservare la privacy. Ecco alcuni approcci per il masking dei dati in Amazon Redshift:
Implementare solidi meccanismi di controllo degli accessi è fondamentale per garantire che solo gli utenti autorizzati possano accedere ai dati sensibili nel nostro cluster Amazon Redshift. Tali meccanismi possono essere applicati così:
In questo articolo abbiamo esplorato gli aspetti fondamentali e avanzati dell’uso di Amazon Redshift per il data warehousing. Siamo partiti dall’importanza del data warehousing e da come Amazon Redshift offra una soluzione potente, scalabile ed economica per analizzare grandi dataset con SQL.
Abbiamo poi visto il processo di configurazione di un cluster Amazon Redshift, inclusi prerequisiti, creazione del cluster e impostazioni di configurazione. Abbiamo approfondito anche il caricamento dei dati in Redshift usando AWS S3 e il comando COPY, con esempi di sintassi e spiegazioni.
Inoltre, abbiamo trattato le basi dell’interrogazione dei dati in Redshift, dalle query SQL di base a tecniche avanzate come funzioni finestra e join complessi. Abbiamo discusso anche il tuning delle prestazioni, evidenziando best practice per ottimizzare le query, come stili di distribuzione, sort key ed encoding di compressione.
Infine, abbiamo sottolineato l’importanza di sicurezza e conformità in Amazon Redshift, trattando funzionalità come crittografia e controllo degli accessi, oltre agli aspetti di compliance.
Se vuoi ampliare conoscenze e competenze su Amazon Redshift e AWS, vale la pena esplorare le seguenti risorse DataCamp:
Padroneggiando Amazon Redshift e sfruttandone le capacità, potrai ottenere insight di valore dai tuoi dati e prendere decisioni guidate dai dati.
Continua oggi il tuo percorso in Data Engineering!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min




