
Kurs
Grundlagen von Data Engineering
2 Std.
372.7K
Daten sind das Fundament moderner Unternehmen, doch die schiere Menge an Informationen, die gesammelt und gespeichert wird, ist schwer zu bändigen. Der Schlüssel zum Erfolg liegt darin, Daten so zu organisieren und zu analysieren, dass daraus echte Erkenntnisse für fundierte Entscheidungen entstehen.
Genau hier setzt Data Warehousing an. Es ist eine leistungsstarke Lösung, mit der Unternehmen ihre Daten konsolidieren und für effiziente Analysen aufbereiten. Und bei Data Warehousing ist AWS Redshift eine der ersten Adressen.
In diesem Artikel tauchen wir in AWS Redshift ein: Funktionen, Vorteile und Best Practices für Setup, Datenladen, Abfragen, Performance-Tuning, Sicherheit und Integrationen.
Ob Datenprofi oder Business-Verantwortliche:r, der das Maximum aus Daten herausholen will – dieser Artikel liefert dir das Wissen und die Tools, um mit AWS Redshift durchzustarten.
Data Warehousing umfasst das Sammeln, Speichern und Verwalten großer Mengen strukturierter Daten aus verschiedenen Quellen innerhalb einer Organisation.
Das Hauptziel eines Data Warehouse ist ein zentraler Informationsspeicher, auf den sich leicht zugreifen, der sich analysieren und für Reporting und Entscheidungen nutzen lässt.
Data Warehouses sind auf komplexe Abfragen und Analysen ausgelegt und ermöglichen es Unternehmen, wertvolle Erkenntnisse aus ihren Daten zu gewinnen.
Ein Data Warehouse bringt Unternehmen zahlreiche Vorteile:
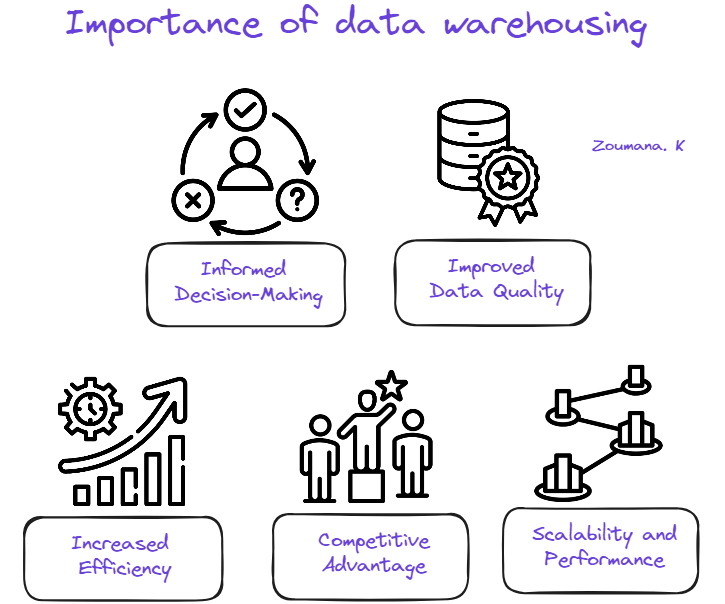
Wichtigkeit von Data Warehousing
AWS Redshift ist ein vollständig verwalteter, cloudbasierter Data-Warehousing-Service für die Speicherung und Analyse von Datensätzen im Petabyte-Bereich. Mit AWS Redshift Serverless kannst du Daten nutzen und analysieren, ohne ein bereitgestelltes Data Warehouse manuell konfigurieren zu müssen.
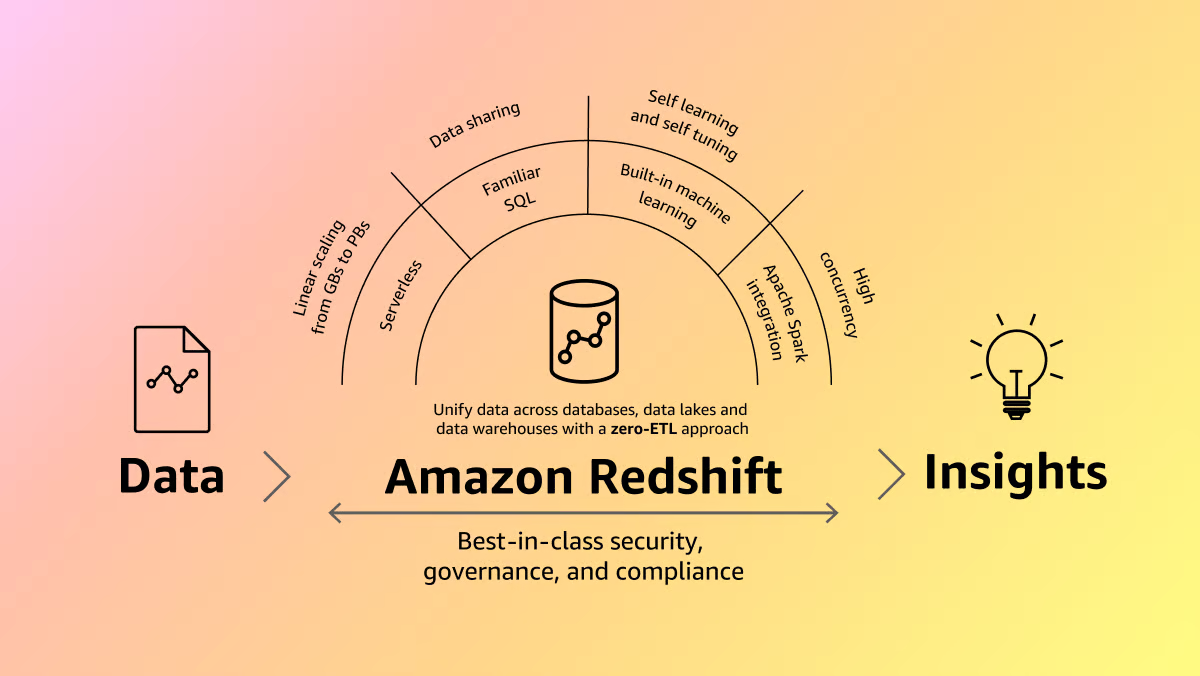
Amazon Redshift (Quelle)
Der Service stellt Ressourcen automatisch bereit und skaliert die Warehouse-Kapazität intelligent, um auch bei anspruchsvollen und unvorhersehbaren Workloads schnelle Performance sicherzustellen. Du zahlst nur, was du nutzt – im Leerlauf fallen keine Kosten an.
AWS Redshift ermöglicht es dir, Daten zu laden und sofort mit dem Abfragen zu beginnen – über den Amazon Redshift Query Editor v2 oder dein bevorzugtes Business-Intelligence-(BI-)Tool. Du profitierst von einem starken Preis-Leistungs-Verhältnis und vertrauten SQL-Funktionen in einer einfach zu nutzenden, administrativen Nullumgebung.
Unabhängig von der Datensatzgröße liefert AWS Redshift schnelle Abfragen – mit denselben SQL-basierten Tools und BI-Anwendungen, die du heute schon nutzt.
AWS Redshift bietet zahlreiche Funktionen und Vorteile, um große Datenmengen effizient zu speichern, zu verwalten und zu analysieren. Einige der wichtigsten sind unten dargestellt:
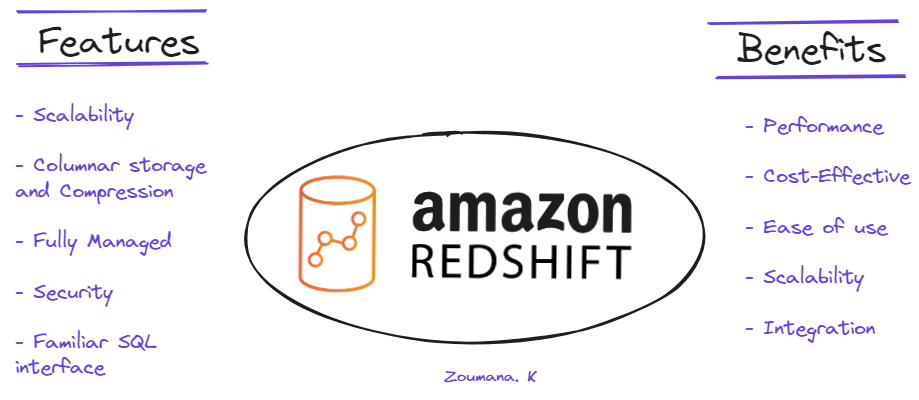
Funktionen und Vorteile von AWS Redshift
Bisher lag der Fokus auf dem Gesamtverständnis von Redshift. Jetzt geht es an die Technik.
Zuerst zeigen wir die wichtigsten Voraussetzungen für ein erfolgreiches Setup. Anschließend führen wir dich Schritt für Schritt durch die Erstellung eines Redshift-Clusters. Zum Schluss erklären wir zentrale Cluster-Einstellungen wie Knotentypen, Knotenzahl und Sicherheitskonfiguration im Detail.
Bevor wir in den Use Case eintauchen, schauen wir uns die Voraussetzungen für eine erfolgreiche Umsetzung an:
Hier findest du alle Schritte, um in 11 einfachen Schritten über die AWS Management Console einen Redshift-Cluster zu erstellen:
1. Suche in der Konsole nach Redshift und wähle „Amazon Redshift“:
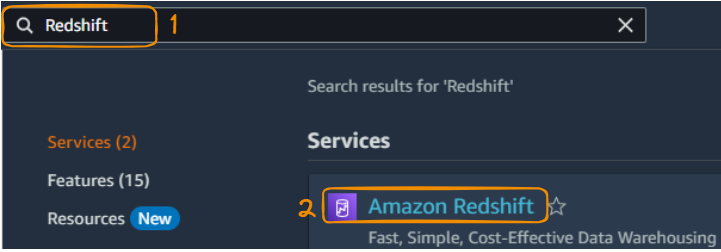
Redshift in der Management Console suchen und auswählen
2. Klicke auf „Create Cluster“, um einen Cluster anzulegen.
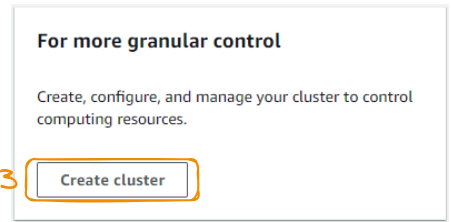
Button „Create cluster“
3. Konfiguriere den Cluster: Identifier, Größe, Knotentyp, Availability Zone und Knotenzahl.
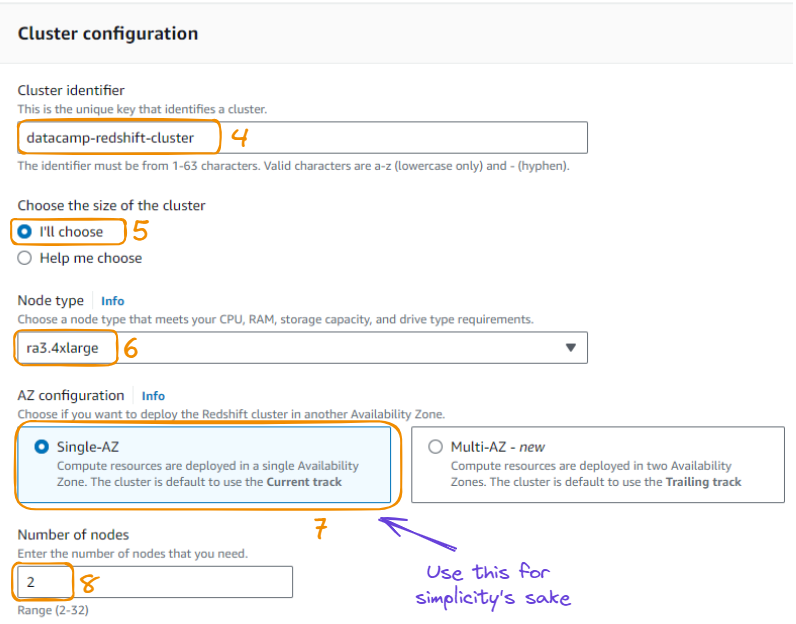
Clusterkonfiguration in acht Schritten
4. Anstelle der Beispiel-Daten auf derselben Seite nutzen wir Daten aus einem S3-Bucket, um Redshift zu befüllen.
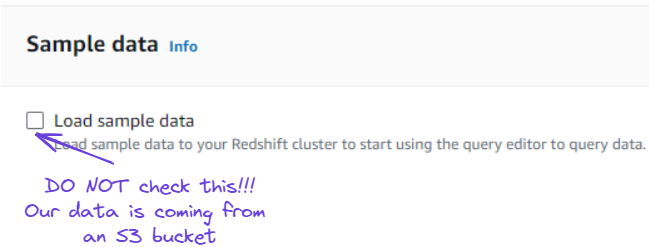
Option „Sample data laden“ ignorieren
5. Optional kannst du Cluster-Berechtigungen über IAM-Rollen setzen. Diesen Schritt kannst du zunächst überspringen.
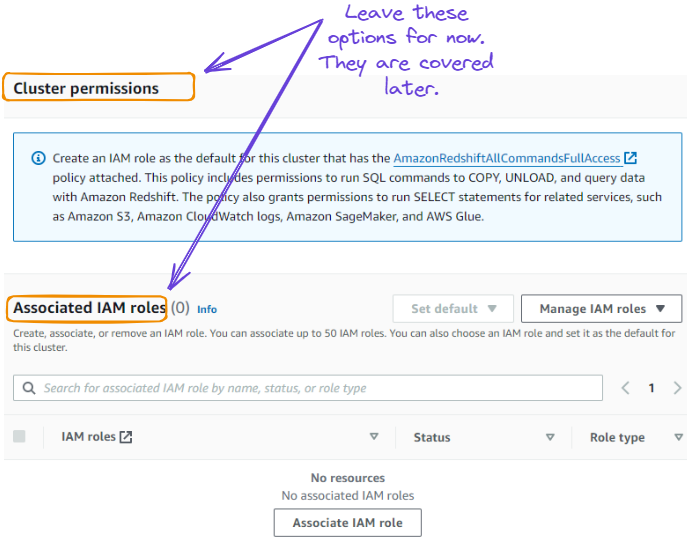
Clusterberechtigungen und IAM-Rollen vorerst ignorieren
6. Belasse Netzwerk-, Sicherheits-, Backup- und Wartungseinstellungen auf Standard und klicke auf „Create cluster“.
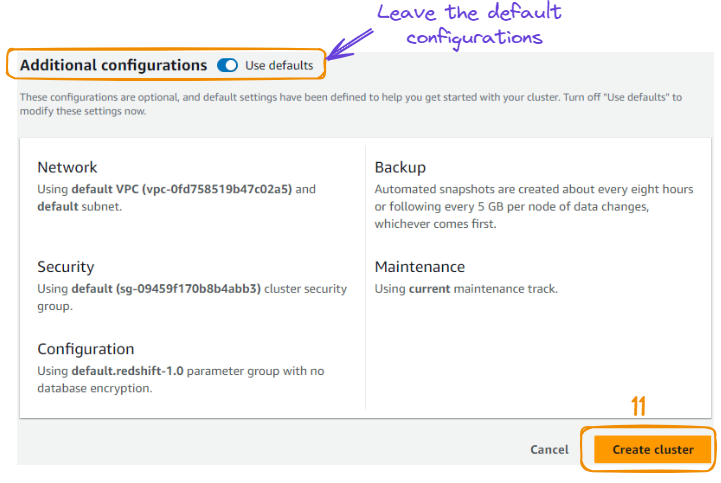
Clustererstellung
7. Nach dem Anlegen wirst du auf die Detailseite des neuen Clusters weitergeleitet. Die Erstellung dauert ein paar Minuten. Im Feld „Status“ siehst du zunächst „Creating“ und später „Available“.
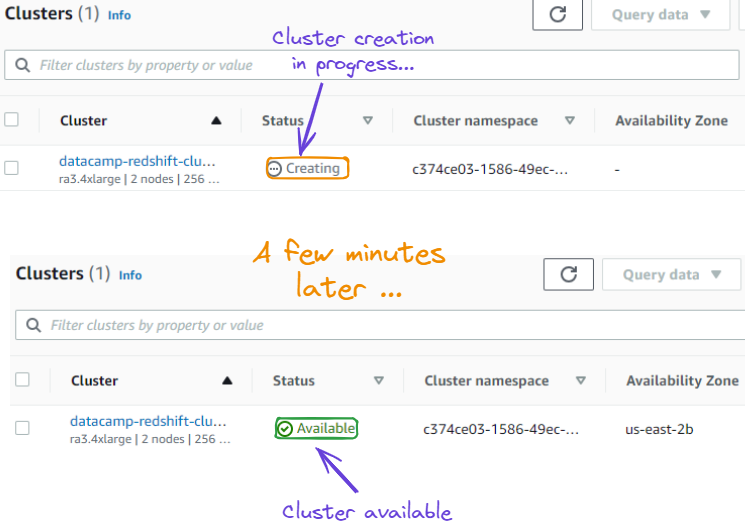
Clusterstatus von „Creating“ zu „Available“
Der Cluster steht. Jetzt führen wir dich von der Auswahl des Länder-, Regionen- und Welt-BIP-Datensatzes (Bruttoinlandsprodukt) in unserem DataLab bis zum Upload in einen S3-Bucket.
Unsere Daten stammen ursprünglich von der Weltbank. Sie enthalten BIP-Werte für Länder, Regionen und die Welt in aktuellen US-Dollar ($). Regionen sind Ländersammlungen wie Europa oder Zentralasien.
Die ersten zehn Zeilen sehen so aus:
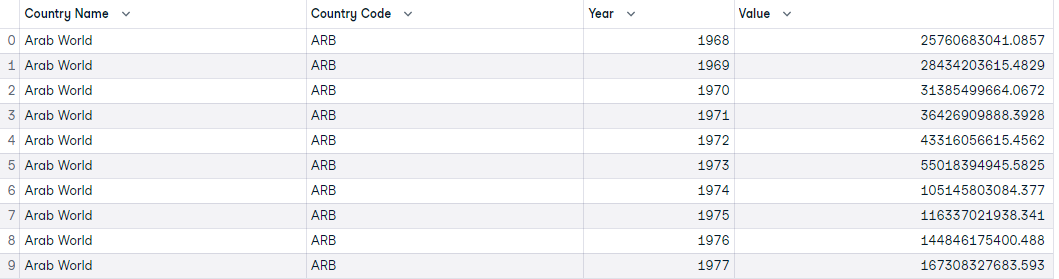
Die ersten zehn Beobachtungen des BIP-Datensatzes
Für die reibungslose Verbindung zwischen S3 und Redshift erstellen wir zuerst eine IAM-Rolle, dann einen S3-Bucket zum Speichern der Daten.
Die IAM-Rolle verbindet unseren Redshift-Cluster mit dem S3-Bucket, in dem die Daten liegen.
So erstellst du die Rolle:
Suche in der Management Console nach „IAM“ und wähle das „IAM“-Logo aus den Treffern.
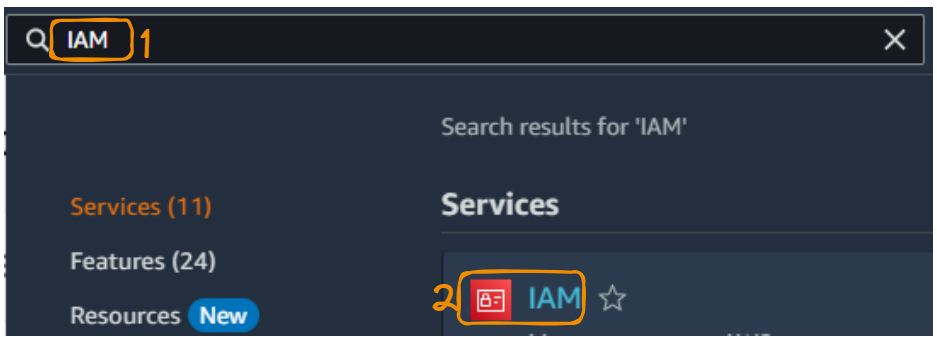
IAM-Service in der Management Console
Wähle „Roles“, um alle Rollen anzuzeigen, und klicke auf „Create role“.
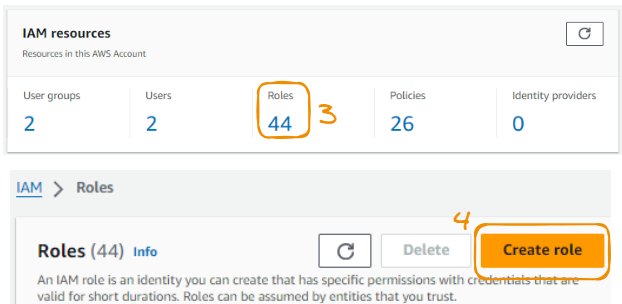
Neue Rolle erstellen
Wähle als „Trusted entity type“ „AWS service“, als „Use case“ „Redshift“ und klicke auf „Next“.
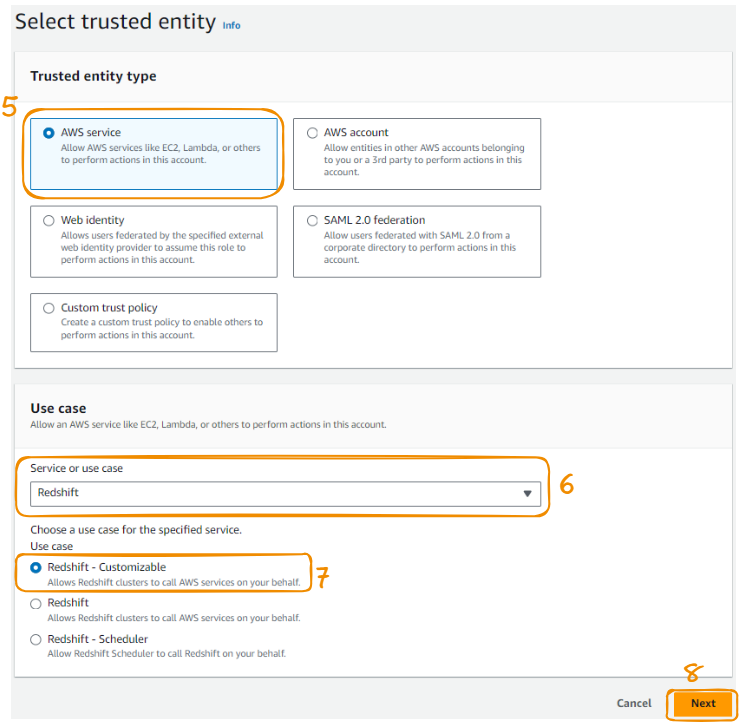
Schritte 5 bis 8 bei der IAM-Rollenerstellung
Suche nach „S3FullAccess“, aktiviere die Option und klicke auf „Next“.
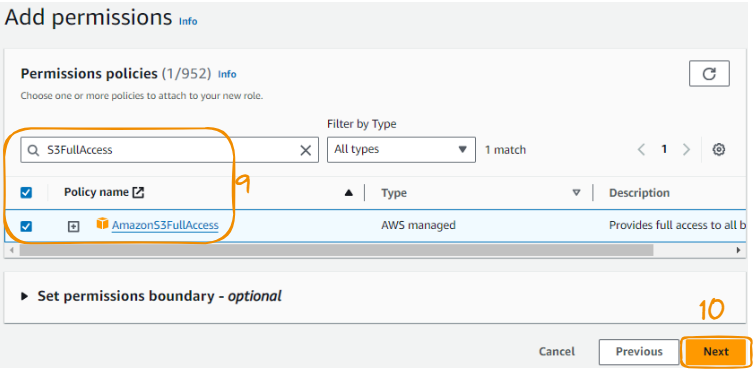
Schritte 9 bis 10 bei der IAM-Rollenerstellung
Vergib einen Namen, prüfe die Angaben und klicke auf „Create role“, um die Rolle zu erstellen.
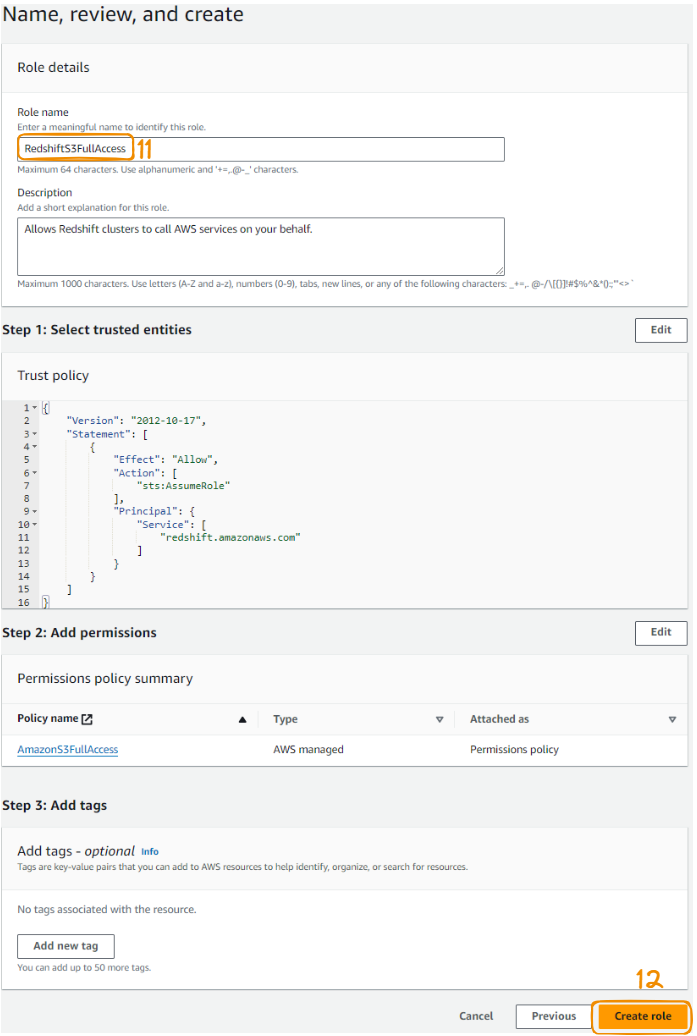
Schritte 11 bis 12 bei der IAM-Rollenerstellung
Nach erfolgreicher Erstellung erscheint oben rechts eine grüne Bestätigungsmeldung.
Bestätigung der Rollenerstellung
Jetzt verknüpfen wir die IAM-Rolle mit dem zuvor erstellten Redshift-Cluster:
Wähle im Bereich „Clusters“ den erstellten Datacamp-Cluster und klicke unter „Actions“ auf „Manage IAM roles“.
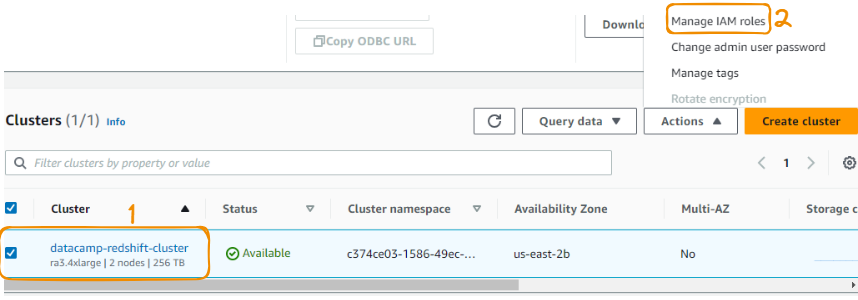
IAM-Rolle mit Redshift verknüpfen – Schritte 1 bis 2
Wähle die eben erstellte IAM-Rolle aus und speichere die Änderungen.
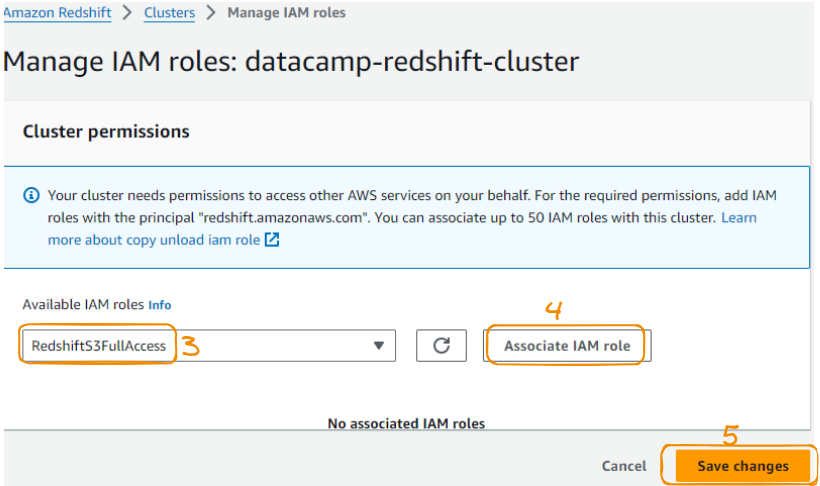
IAM-Rolle mit Redshift verknüpfen – Schritte 3 bis 4
Für Abfragen auf Redshift kannst du verschiedene Tools nutzen – AWS-intern oder extern. In diesem Tutorial verwenden wir den Query Editor im Redshift-Dashboard.
Dafür legen wir zunächst eine Verbindung im Query Editor an. Starte über „Query in query editor“ im Tab „Query data“:
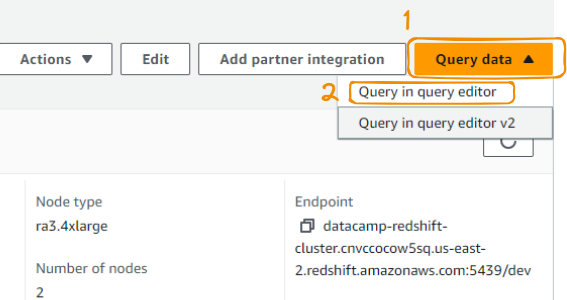
Query Editor aus „Query data“
Danach gelangst du auf diese Seite. Vergib einen Namen und einen Benutzernamen und stelle die Verbindung her:
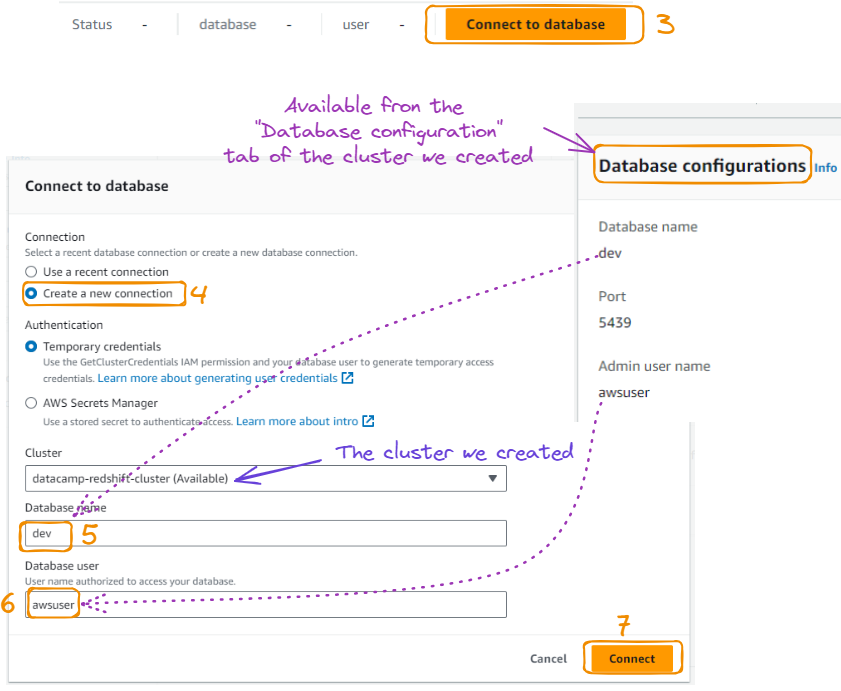
Datenbankverbindung im Query Editor
Nach dem Klick auf „Connect“ erscheint oben der grüne Status „Connected“, links siehst du die Datenbankdetails.
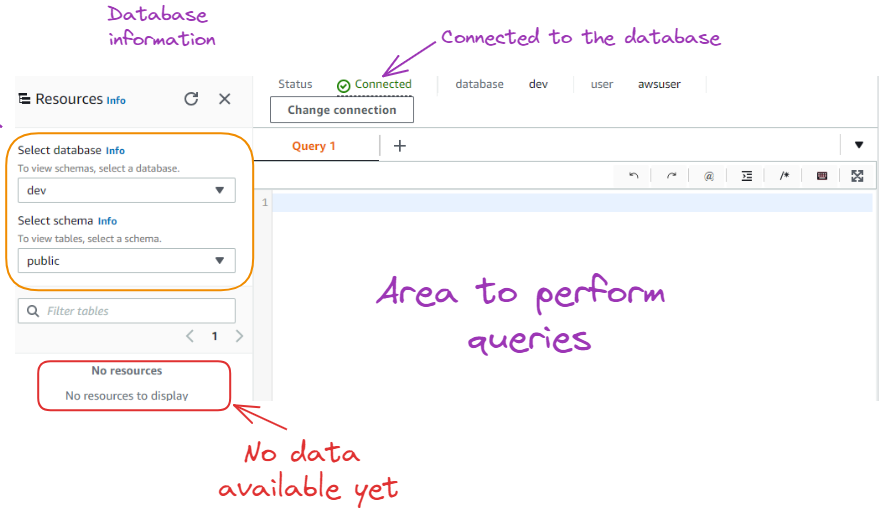
Erfolgreiche Verbindung zur Datenbank
Wie zu sehen, liegen noch keine Ressourcen/Daten in der Datenbank. Bevor wir Daten importieren, erstellen wir eine Tabelle mit denselben Merkmalen wie der Datensatz.
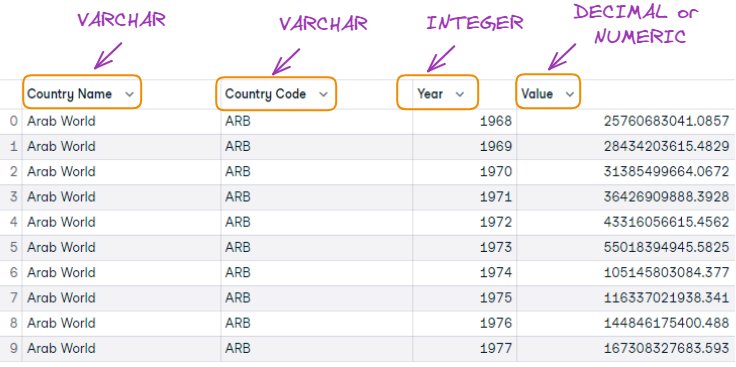
Abgleich der ersten 10 Zeilen mit den Tabellenspalten
Die Tabelle wird mit folgendem SQL-Statement angelegt:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
Kurz erklärt – Spalte für Spalte:
id INTEGER PRIMARY KEY: Erstellt die Spalte "id" als INTEGER und setzt sie als Primärschlüssel, damit jede Zeile eindeutig ist.country_name VARCHAR(255): Erstellt die Spalte "country_name" als VARCHAR für Zeichenketten bis 255 Zeichen.country_code VARCHAR(10): Erstellt die Spalte "country_code" als VARCHAR für Zeichenketten bis 10 Zeichen.year INTEGER: Erstellt die Spalte "year" als INTEGER, geeignet für ganze Zahlen (hier: Jahre).value DECIMAL(20,2): Erstellt die Spalte "value" als DECIMAL mit 20 Stellen und 2 Dezimalen.Jetzt führen wir die Query aus, um die Tabelle zu erstellen:
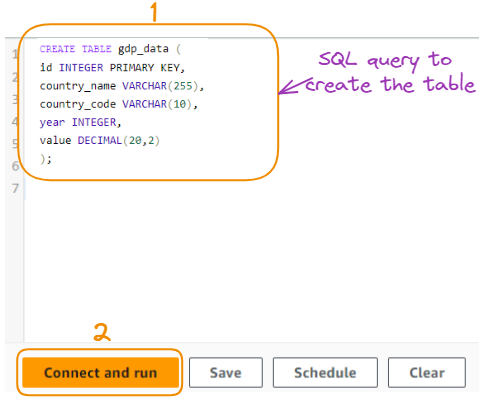
Query zur Tabellenerstellung
Damit wird die Tabelle „gdp_data“ mit den angegebenen Spalten für die BIP-Daten angelegt, wie hier zu sehen:
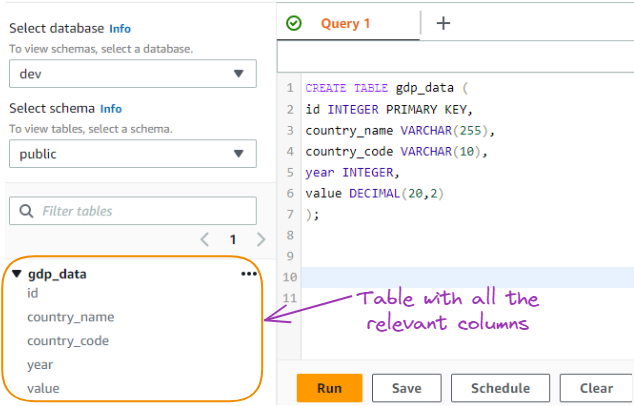
BIP-Tabelle aus der SQL-Query erstellt
Die Daten werden aus einem S3-Bucket in die Tabelle importiert. Hier findest du alle Schritte zum Erstellen des Buckets und Hochladen der Daten.
Suche in der Management Console nach dem S3-Service, wähle das Logo und vergib einen Namen. Alle weiteren Einstellungen bleiben standardmäßig bestehen:
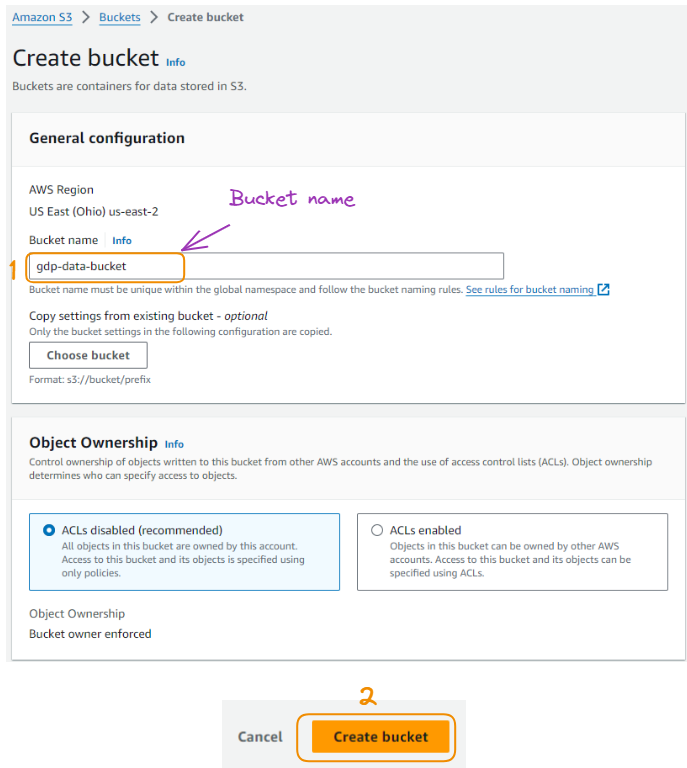
S3-Bucket erstellen
Nach der Erstellung erscheint der Bucket in der Liste aller vorhandenen Buckets.
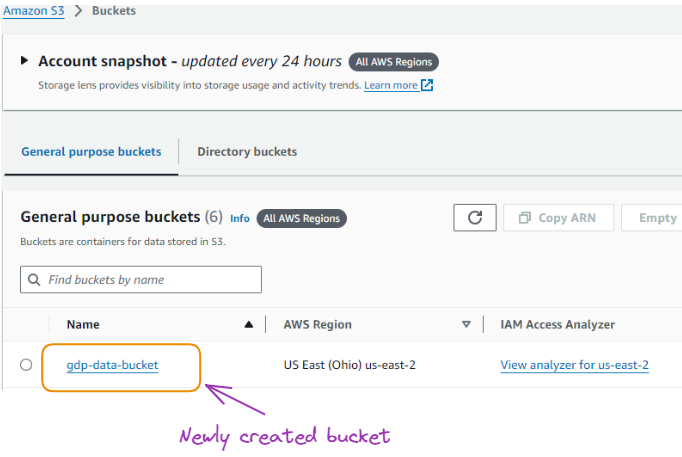
Der neu angelegte Bucket
Wähle den Bucket-Namen und lade die lokal gespeicherten BIP-Daten als CSV hoch.
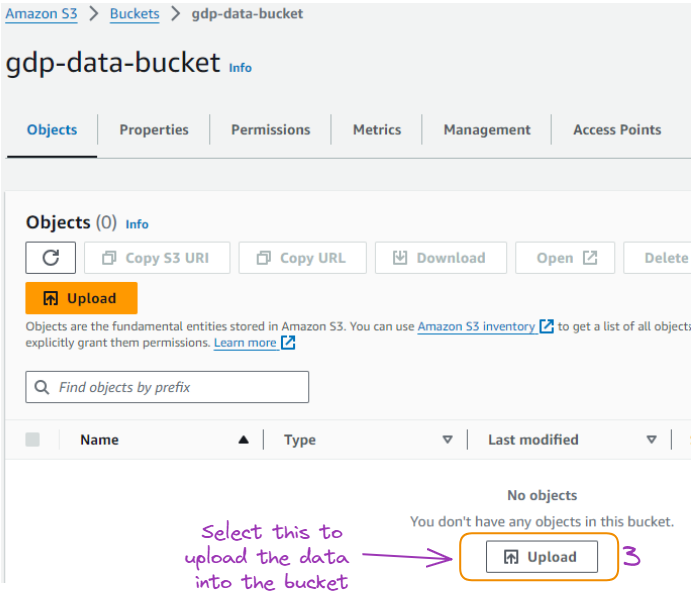
Upload-Seite für den Bucket
Nach erfolgreichem Upload stehen die Daten wie folgt bereit:
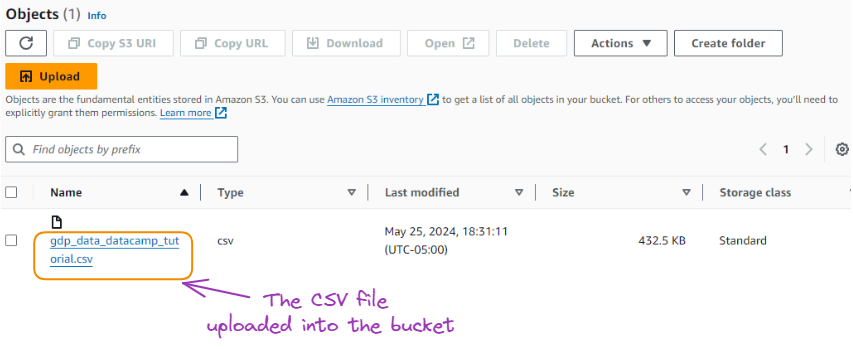
Die hochgeladene CSV im Bucket
Glückwunsch, du bist schon weit gekommen!
So kopierst du die Daten von S3 nach Redshift:
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Was passiert hier genau?
Im Editor sieht das so aus – der COPY-Lauf war nach wenigen Sekunden erfolgreich:
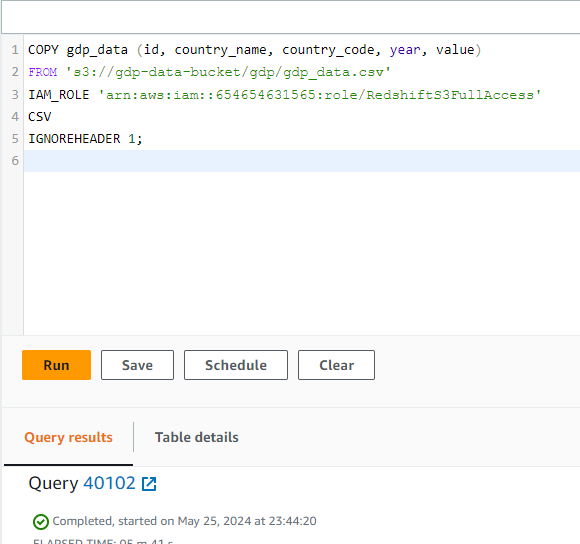
COPY-Auftrag abgeschlossen
Zur Vereinfachung haben wir statt aller Daten nur eine Zufallsstichprobe von 100 Zeilen geladen. Über „Preview data“ erhältst du eine Vorschau:
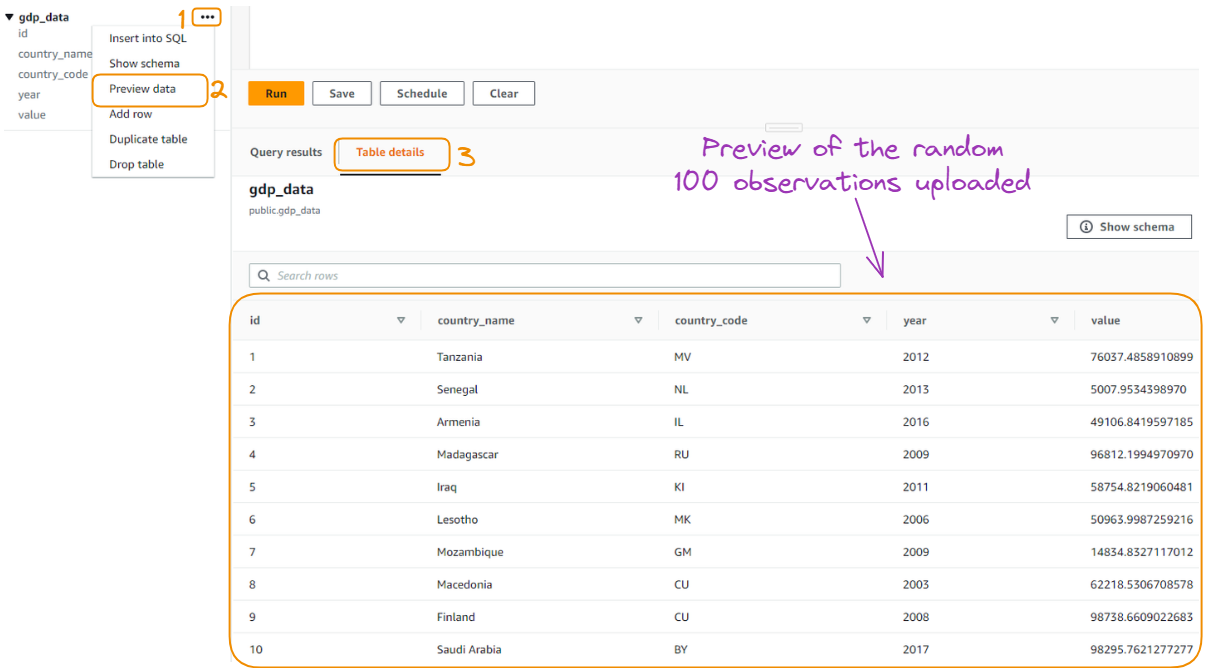
Vorschau auf die zufällig hochgeladenen 100 Zeilen
Die Vorschau zeigt nur die ersten zehn Zeilen. Für tiefere Einblicke brauchst du SQL – damit interagierst du flexibel mit den Daten.
In diesem Abschnitt erkunden wir die Daten mit einigen SQL-Abfragen.
Wir nutzen fünf SQL-Statements, beginnend mit der häufigsten Abfrage: Daten auswählen.
Alle Daten auswählen
SELECT *
FROM gdp_data;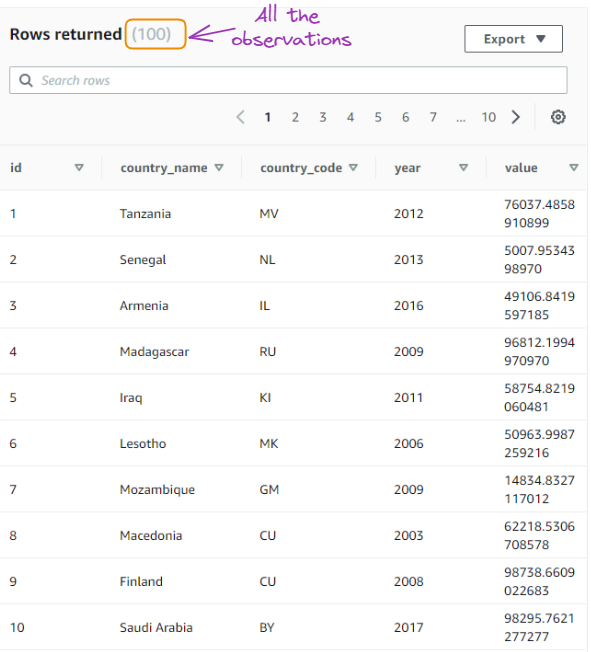
Ergebnis der ersten Abfrage
Daten für ein bestimmtes Land auswählen:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';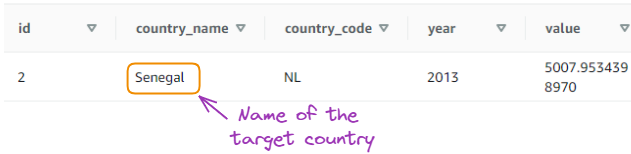
Ergebnis der zweiten Abfrage
Durchschnittliches BIP für ein bestimmtes Jahr berechnen:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;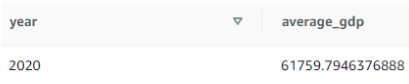
Ergebnis der dritten Abfrage
Top 5 Länder mit dem höchsten BIP in einem bestimmten Jahr finden:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;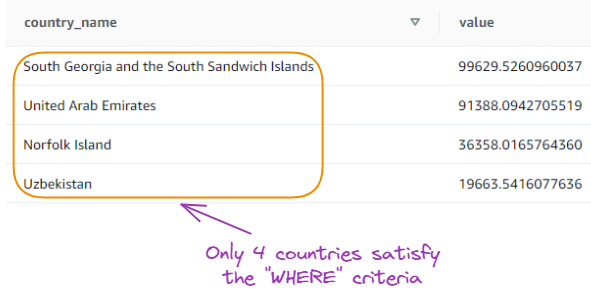
Ergebnis der vierten Abfrage
Anzahl der Datensätze pro Jahr zählen:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;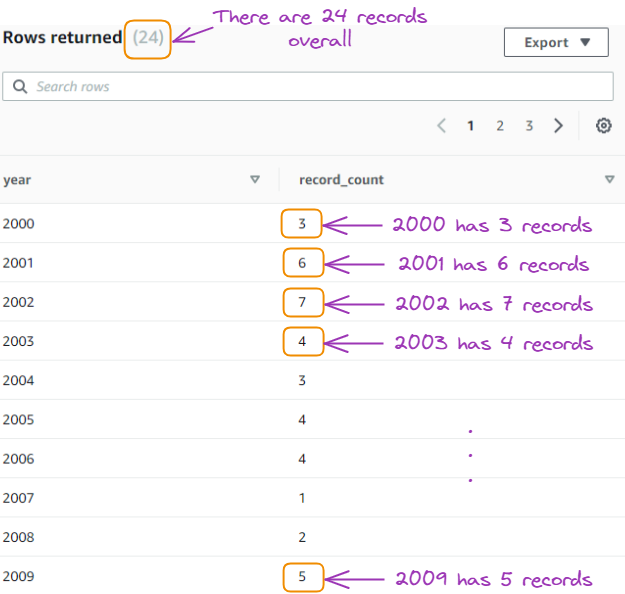
Ergebnis der fünften Abfrage
Die obigen Abfragen liefern ein Grundverständnis der Daten. Jetzt drei fortgeschrittene Techniken.
Laufende Summe berechnen: Diese Abfrage berechnet die laufende Summe der BIP-Werte je Land, nach Jahr sortiert.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;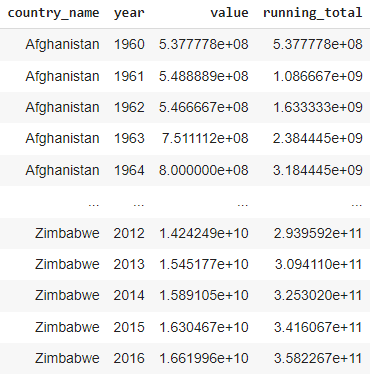
Ergebnis der laufenden Summe
CTEs zum Filtern und Aggregieren: Diese Abfrage nutzt eine CTE, um Daten ab 2020 zu filtern und anschließend den durchschnittlichen BIP-Wert je Land zu berechnen.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;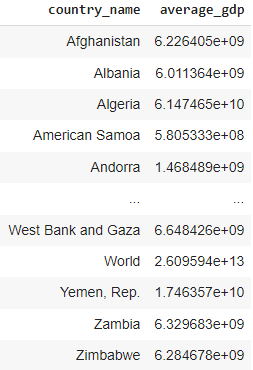
Ergebnis der CTE-Abfrage
Jährliches BIP-Wachstum berechnen: Mit dieser Abfrage berechnen wir das Year-over-Year-Wachstum je Land.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;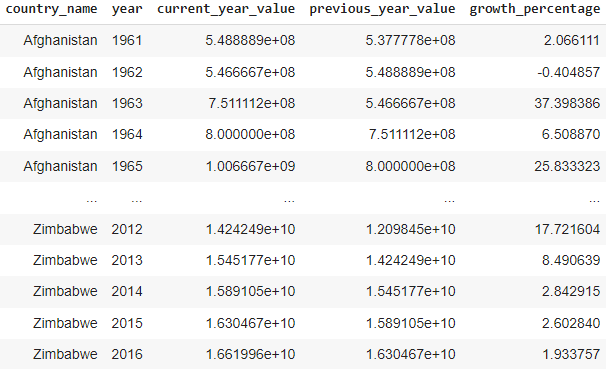
Ergebnis der Self-Join-Abfrage
Für optimale Performance und Kosteneffizienz ist es wichtig, die Einflussfaktoren auf Redshift zu verstehen und Best Practices für das Tuning des Clusters umzusetzen.
In diesem Abschnitt betrachten wir die wesentlichen Aspekte des Redshift-Tunings und leiten aus unseren Clusterinformationen Empfehlungen ab.
Die Performance in Amazon Redshift hängt von vielen Faktoren ab – von Hardwarekonfigurationen bis hin zu Abfrageoptimierung. Wer diese Faktoren versteht, erkennt Engpässe und trifft bessere Entscheidungen zur Verbesserung der Clusterleistung.
Wir haben einen Redshift-Cluster mit zwei ra3.4xlarge-Knoten konfiguriert, die genutzten Daten umfassen nur 391 KB.
Das folgende Diagramm zeigt zudem, dass die CPU-Auslastung über den gesamten Zeitraum nahe 0 % liegt. Der Cluster wird also kaum genutzt und ist für unsere aktuelle Last vermutlich überdimensioniert.
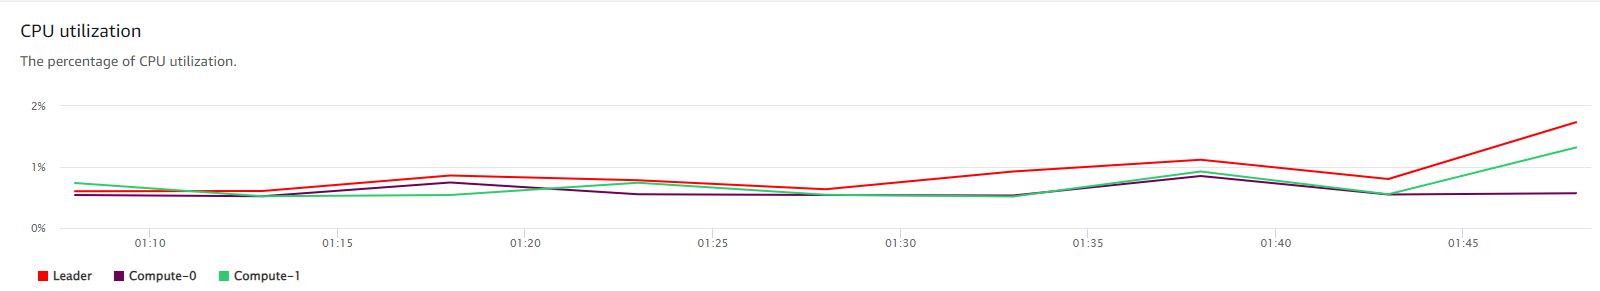
CPU-Auslastung unseres Clusters
Wichtige Einflussfaktoren auf die Redshift-Performance sind:
Für eine hohe Leistung solltest du Best Practices bei Tabellendesign und Datenmanagement befolgen. Auch bei kleinem Datensatz legst du so die Basis für Wachstum und Effizienz.
Regelmäßiges Monitoring und Wartung sichern Leistung und Kosten. Die folgende Grafik zeigt unsere monatlichen Redshift-Kosten – mit Potenzial zur Optimierung.
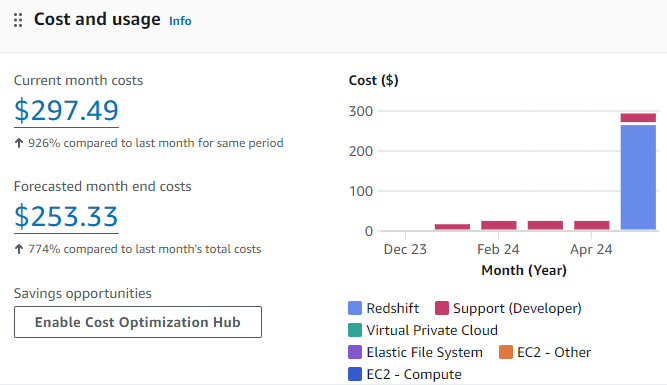
Kosten- und Nutzungsgrafik für den aktuellen Redshift-Use-Case
Unser Cluster ist für den kleinen Datensatz offenbar überdimensioniert: geringe Auslastung, unnötige Kosten.
Mit AWS-Tools wie Amazon CloudWatch und der AWS Management Console überwachst du Kennzahlen wie CPU-Auslastung und Abfrageleistung. So erkennst du Probleme früh und triffst datenbasierte Optimierungsentscheidungen.
Angesichts der geringen Auslastung bieten sich diese Maßnahmen an:
Mit steigendem Datenvolumen und veränderten Workloads solltest du die Clusterleistung kontinuierlich überwachen und Instanzgrößen sowie Optimierungsstrategien regelmäßig prüfen.
Beim Umgang mit sensiblen Daten in Amazon Redshift haben Sicherheit und Compliance oberste Priorität. Mit zunehmenden regulatorischen Anforderungen sind robuste Sicherheitsmaßnahmen und das Einhalten von Vorgaben entscheidend für den Betrieb deines Redshift-Clusters.
Die Einhaltung branchenspezifischer Regularien und Datenschutzgesetze ist für Organisationen mit sensiblen Daten essenziell. Amazon Redshift stellt Funktionen bereit, die dir helfen, diese Anforderungen zu erfüllen.
Neben Compliance ist die Umsetzung von Best Practices für Datensicherheit in Amazon Redshift zentral, um sensible Informationen vor unberechtigtem Zugriff und Datenpannen zu schützen.
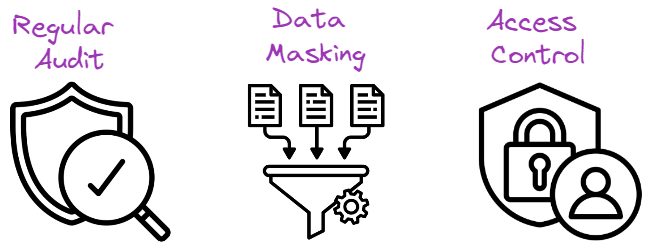
Best Practices für Datensicherheit
Regelmäßige Sicherheits-Audits identifizieren Schwachstellen, bewerten bestehende Maßnahmen und sichern kontinuierliche Compliance. Achte auf Folgendes:
Bei der Datenmaskierung werden sensible Elemente unkenntlich gemacht, Struktur und Format bleiben erhalten. So schützt du Daten vor unbefugtem Zugriff und wahrst die Privatsphäre. Ansätze in Amazon Redshift:
Starke Zugriffskontrollen stellen sicher, dass nur Berechtigte auf sensible Daten im Redshift-Cluster zugreifen:
In diesem Artikel haben wir die Grundlagen und fortgeschrittenen Aspekte von Amazon Redshift für Data Warehousing beleuchtet. Wir haben gezeigt, warum Data Warehousing wichtig ist und wie Redshift als leistungsstarke, skalierbare und kosteneffiziente SQL-Lösung für große Datensätze punktet.
Anschließend sind wir den Prozess zur Einrichtung eines Redshift-Clusters durchgegangen – von den Voraussetzungen über die Clustereinstellungen bis zur Konfiguration. Wir haben außerdem das Laden von Daten über AWS S3 und den COPY-Befehl im Detail erklärt – inklusive Syntax und Erläuterungen.
Darüber hinaus haben wir das Abfragen von Daten in Redshift behandelt – von Basis-SQL bis zu fortgeschrittenen Techniken wie Window-Funktionen und komplexen Joins. Beim Performance-Tuning haben wir Best Practices wie Distributionsstile, Sort Keys und Komprimierung hervorgehoben.
Abschließend haben wir die Bedeutung von Sicherheit und Compliance in Amazon Redshift betont – von Verschlüsselung und Zugriffskontrolle bis zu regulatorischen Anforderungen.
Wenn du dein Wissen und deine Fähigkeiten rund um Amazon Redshift und AWS ausbauen willst, sieh dir diese DataCamp-Ressourcen an:
Mit Amazon Redshift hebst du wertvolle Insights aus deinen Daten und triffst bessere, datenbasierte Entscheidungen.
Starte heute deine Data-Engineering-Reise!
Kurs
Lernpfad
Lernpfad
Blog
Zoumana Keita
15 Min.
Blog
Nisha Arya Ahmed
15 Min.
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Matt Crabtree
14 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Sejal Jaiswal
24 Min.







