Daftar Isi
- Pendahuluan
- Use case: Melatih Model Machine Learning di Dalam Database
- Database yang Mendukung Machine Learning di Dalam Database
- Microsoft SQL Server Machine Learning Services
- PyCaret: Pustaka Machine Learning Open-Source dan Low-Code dalam Python
- Demo Ujung-ke-Ujung Melatih Model ML di SQL
- Unduh dan instal SQL Server
- Buat database baru dan impor file CSV
- Konfigurasikan Lingkungan Python
- Latih model klastering unsupervised
- Kesimpulan
Pendahuluan
Python dan R adalah bahasa pemrograman yang banyak digunakan oleh data scientist, data engineer, dan machine learning engineer. Kemampuan menjalankan kode Python sebagai skrip SQL membuka banyak kemungkinan untuk operasi data, termasuk kapabilitas machine learning di dalam database saat berhadapan dengan data berukuran besar. Alat andalan untuk melakukan eksperimen machine learning biasanya adalah integrated development environment (IDE) seperti VS Code atau Notebook yang bersifat interaktif. Namun, alat-alat ini dapat membatasi saat ukuran data sangat besar, atau ketika model ML harus diproduksikan. Ada kebutuhan mendesak untuk dapat memrogram dan melatih model di tempat data berada; dalam tutorial ini, Anda akan mempelajari beberapa cara untuk mewujudkannya.
Use-Case: Melatih Model Machine Learning di Dalam Database
Banyak database saat ini dilengkapi layanan machine learning bawaan (lihat bagian berikutnya). Artinya, Anda tidak harus mencari platform data science terpisah, karena Anda dapat menggunakan kapabilitas machine learning di dalam database untuk melatih dan menerapkan model langsung di database. Alur kerja machine learning yang umum terlihat seperti ini:
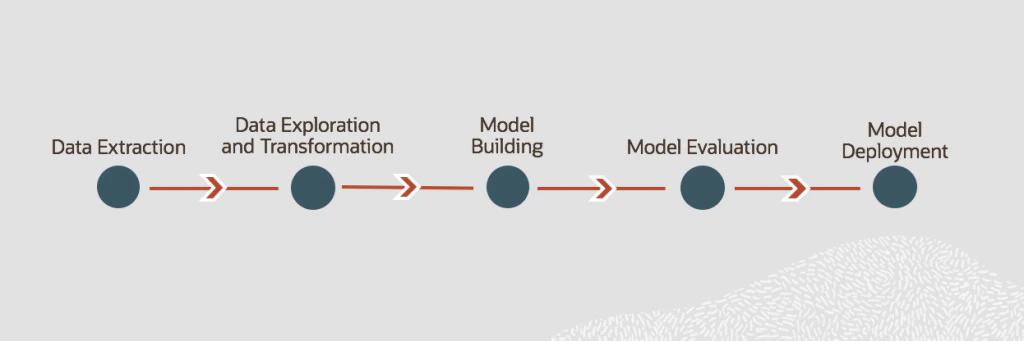
Saat Anda melatih model machine learning di dalam database, Anda tidak memerlukan proses ETL mandiri karena data Anda sudah berada di database. Ini menghemat banyak waktu. Untuk langkah selanjutnya seperti Pembangunan Model dan Penerapan, Anda juga tidak perlu memindahkan ke platform machine learning eksternal mana pun karena Anda akan menggunakan kapabilitas di dalam database untuk melatih dan menerapkan solusi ML. Menurut Oracle Big Data Blog, ada tiga manfaat melakukan ini:
Proses keseluruhan menjadi lebih sederhana
Sering kali butuh berjam-jam atau berhari-hari hanya untuk memindahkan data ke platform lain tempat algoritme berada. Meskipun proses ini memperkenalkan kerumitan seperti potensi kehilangan data, ini sebenarnya masih menjadi standar bagi sebagian besar perusahaan lainnya.
Hemat waktu/biaya
Lebih logis memindahkan algoritme ke database daripada memindahkan data ke algoritme. Jadi, memasangkan machine learning dengan database lebih praktis bukan hanya dari sisi kesederhanaan tetapi juga kecepatan. Anda menghemat waktu dan banyak upaya, yang pada akhirnya berdampak pada penghematan biaya.
Hasil (nilai) diperoleh lebih cepat
Faktanya, meskipun mungkin butuh banyak waktu dan upaya untuk membangun model machine learning, melatihnya, mendapatkan hasil, dan menganalisisnya, bisnis biasanya tidak tertarik pada machine learning sampai model diterapkan ke produksi sehingga departemen yang bertanggung jawab atas organisasi (Keuangan, HR, Rantai Pasok, Pemasaran, Penjualan, dll.) dapat memanfaatkan hasilnya.
Karena penerapan dan integrasi ke aplikasi seperti dasbor business intelligence (BI), call center, ATM, situs web, dan perangkat seluler bisa menjadi tantangan besar bagi TI, operasionalisasi bisa jadi sederhana atau sangat kompleks.
Jika model Anda sejak awal berada di dalam database, jumlah pekerjaan penerapan yang rumit akan sangat berkurang. Ini membuat proses jauh lebih mudah dan hasil diperoleh jauh lebih cepat.
Database yang Mendukung Machine Learning di Dalam Database
Microsoft SQL Server
Microsoft SQL Server Machine Learning Services mendukung R, Python, Java, perintah PREDICT T-SQL, dan prosedur tersimpan rx_Predict di SQL Server RDBMS, serta SparkML di SQL Server Big Data Clusters. Dalam bahasa R dan Python, Microsoft menyertakan beberapa paket dan pustaka untuk machine learning. Anda dapat menyimpan model terlatih di dalam database atau secara eksternal. Azure SQL Managed Instance mendukung Machine Learning Services untuk Python dan R sebagai pratinjau. Pelajari Selengkapnya.
Amazon Redshift
Amazon Redshift adalah layanan data warehouse terkelola berskala petabyte yang dirancang agar mudah dan hemat biaya untuk menganalisis semua data Anda menggunakan alat business intelligence yang sudah ada. Layanan ini dioptimalkan untuk himpunan data mulai dari beberapa ratus gigabita hingga satu petabyte atau lebih dan biayanya kurang dari $1.000 per terabyte per tahun. Pelajari Selengkapnya.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science adalah platform terkelola dan tanpa server untuk tim data science guna membangun, melatih, dan mengelola model machine learning menggunakan Oracle Cloud Infrastructure termasuk Oracle Autonomous Database dan Oracle Autonomous Data Warehouse. Platform ini mencakup alat, pustaka, dan paket berfokus Python yang dikembangkan oleh komunitas open source dan Oracle Accelerated Data Science (ADS) Library, yang mendukung siklus hidup end-to-end model prediktif. Pelajari Selengkapnya.
Google Cloud BigQuery
BigQuery adalah data warehouse terkelola berskala petabyte dari Google Cloud yang memungkinkan Anda menjalankan analitik atas jumlah data yang sangat besar hampir secara real time. BigQuery ML memungkinkan Anda membuat dan mengeksekusi model machine learning di BigQuery menggunakan kueri SQL. BigQuery ML mendukung regresi linear untuk peramalan; regresi logistik biner dan multikelas untuk klasifikasi; klastering K-means untuk segmentasi data; faktorisasi matriks untuk membuat sistem rekomendasi produk dan deret waktu untuk melakukan peramalan deret waktu. Pelajari Selengkapnya.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud adalah layanan cloud publik terkelola. Anda juga dapat menyiapkan IBM Db2 Warehouse di lingkungan on-premises dengan perangkat keras Anda sendiri atau di cloud privat. Sebagai data warehouse, layanan ini mencakup fitur seperti pemrosesan data in-memory dan tabel kolumnar untuk pemrosesan analitik daring. Teknologi Netezza-nya menyediakan serangkaian analitik yang tangguh yang dirancang untuk secara efisien membawa kueri ke data. Pelajari Selengkapnya.
BlazingSQL
BlazingSQL adalah mesin SQL yang dipercepat GPU yang dibangun di atas ekosistem RAPIDS; tersedia sebagai proyek open-source dan layanan berbayar. RAPIDS, yang menggunakan CUDA dan berbasis format memori kolumnar Apache Arrow, adalah rangkaian pustaka perangkat lunak dan API open-source yang diinkubasi oleh Nvidia - CuDF, bagian dari RAPIDS, adalah pustaka GPU DataFrame mirip Pandas untuk memuat, menggabungkan, mengagregasi, memfilter, dan memanipulasi data. Pelajari Selengkapnya.
Microsoft SQL Server Machine Learning Services
Machine Learning Services adalah fitur di SQL Server yang memberi Anda kemampuan untuk menjalankan skrip Python dan R dengan data relasional. Anda dapat menggunakan paket dan framework open-source, serta paket Python dan R dari Microsoft, untuk analitik prediktif dan machine learning. Skrip dieksekusi di dalam database tanpa memindahkan data keluar dari SQL Server atau melalui jaringan. Artikel ini menjelaskan dasar-dasar SQL Server Machine Learning Services dan cara memulainya.
SQL Server Machine Learning Services memungkinkan Anda mengeksekusi skrip Python dan R di dalam database. Anda dapat menggunakannya untuk menyiapkan dan membersihkan data, melakukan rekayasa fitur, serta melatih, mengevaluasi, dan menerapkan model machine learning di dalam database. Fitur ini menjalankan skrip Anda di tempat data berada dan menghilangkan kebutuhan untuk mentransfer data melalui jaringan ke server lain.
Versi Python dan R yang didukung
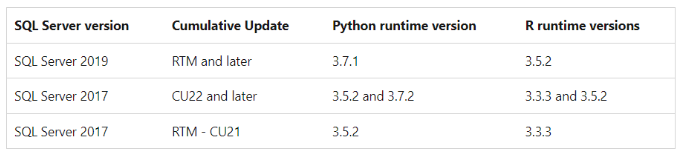
Saat ini, versi Python dan R berikut didukung di SQL Machine Learning Services.
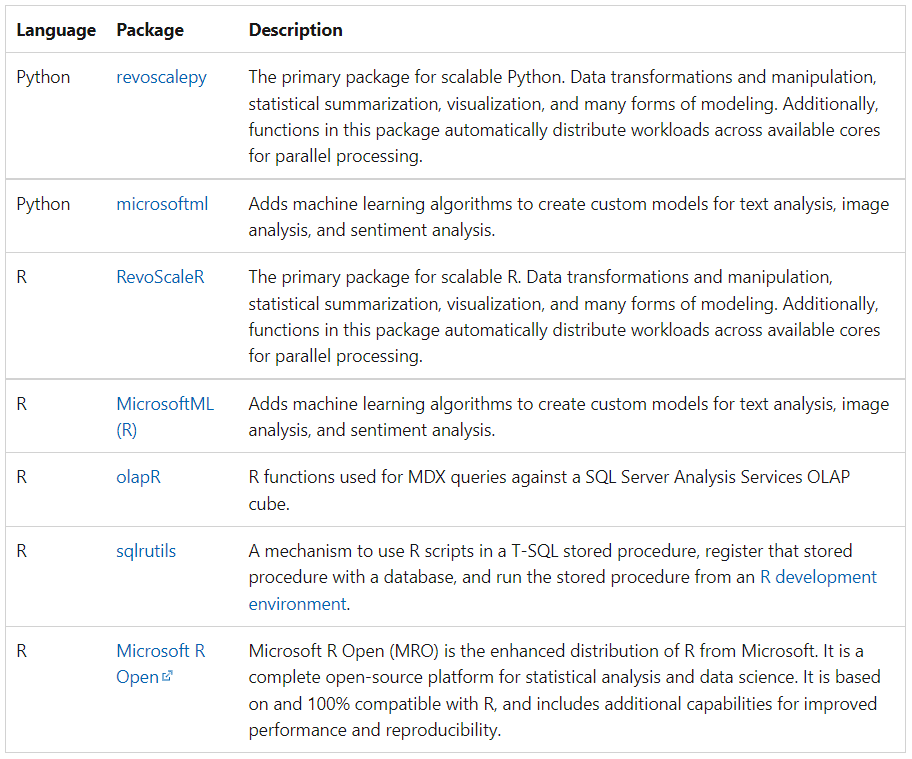
Pustaka Python dan R yang terpasang secara default
Anda dapat menggunakan paket dan framework open-source apa pun yang Anda suka, tetapi paket Python dan R berikut sudah terpasang secara default:
PyCaret: Pustaka ML Open-Source dan Low-Code
PyCaret adalah pustaka machine learning open-source dan low-code dalam Python yang mengotomatiskan alur kerja machine learning. Ini adalah alat end-to-end untuk machine learning dan manajemen model yang mempercepat siklus eksperimen secara eksponensial dan meningkatkan produktivitas.
Dibandingkan dengan pustaka machine learning open-source lainnya, PyCaret adalah pustaka low-code alternatif yang dapat menggantikan ratusan baris kode hanya dengan beberapa baris. Ini membuat eksperimen menjadi jauh lebih cepat dan efisien. PyCaret pada dasarnya adalah pembungkus Python untuk beberapa pustaka dan framework machine learning seperti scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, dan beberapa lainnya.
Desain dan kesederhanaan PyCaret terinspirasi oleh peran yang berkembang dari citizen data scientist, istilah yang pertama kali digunakan oleh Gartner. Citizen data scientist adalah pengguna andal yang dapat melakukan tugas analitis sederhana hingga menengah yang sebelumnya memerlukan keahlian teknis lebih. Kunjungi tautan ini untuk mempelajari lebih lanjut tentang PyCaret.
Pada bagian berikutnya, kita akan menginstal Microsoft SQL Server dan mengaktifkan SQL Machine Learning Services. Lalu kita akan mengaktifkan lingkungan Python, memasang PyCaret (pustaka ML), dan mulai melatih model. Mari kita lihat caranya.
Demo Ujung-ke-Ujung Melatih Model ML di SQL
Unduh dan instal SQL Server dan Microsoft SSMS
Microsoft SQL Server adalah sistem manajemen database relasional dari Microsoft. Sebagai server database, fungsinya utama adalah menyimpan dan mengambil data sesuai permintaan berbagai aplikasi. Dalam tutorial ini, kita akan menggunakan SQL Server 2019 Developer untuk melatih model machine learning unsupervised melalui PyCaret.
Jika Anda pernah menggunakan SQL Server sebelumnya, kemungkinan Anda sudah memasangnya dan memiliki akses ke database. Jika belum, klik di sini untuk mengunduh SQL Server 2019 edisi Developer.
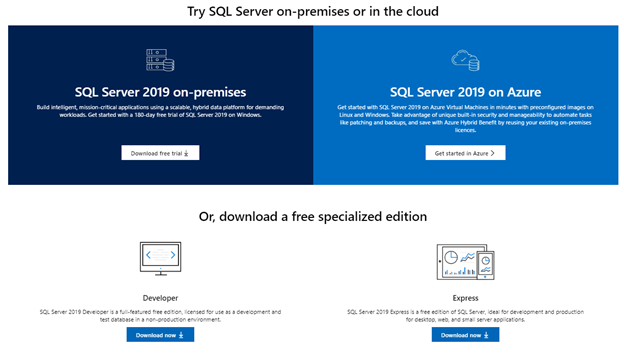
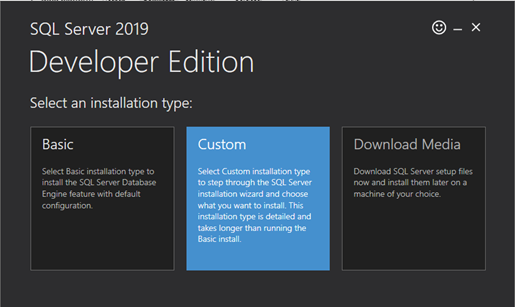
Klik tombol “Download now” di bawah edisi Developer dan buka berkas pemasang. Klik jenis pemasangan “Custom”.
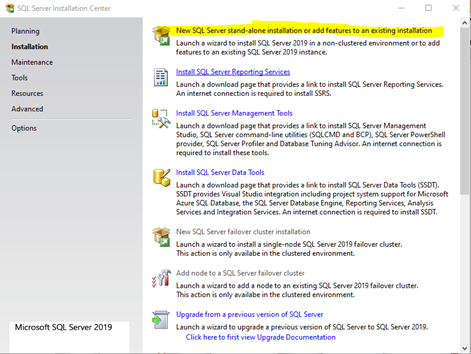
Pilih New SQL Server stand-alone installation.
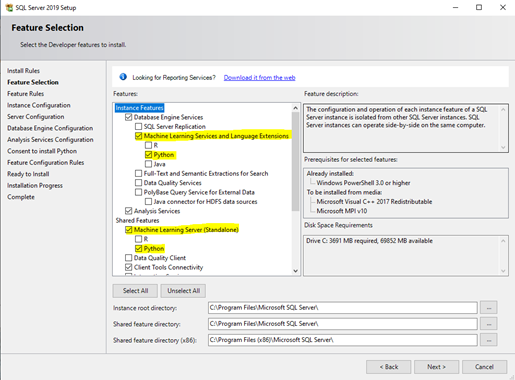
Pada opsi Instance Features, pilih fitur termasuk “Python” di bawah Machine Learning Services and Language Extensions dan Machine Learning Server.
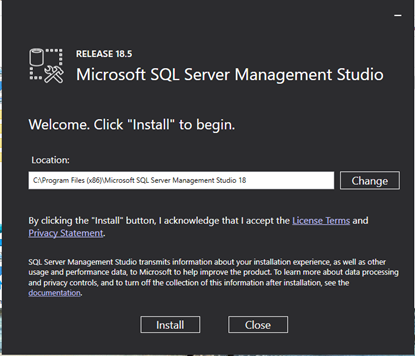
Setelah SQL Server berhasil dipasang, kita perlu bekerja dengan Integrated Development Environment (IDE). Ada banyak opsi yang tersedia; namun, dalam tutorial ini saya akan menggunakan Microsoft SQL Server Management Studio. Unduh pemasangnya dan ikuti petunjuknya. Pemasangan SSMS cukup mudah.
Buat database baru dan impor CSV
Setelah SQL Server dan SSMS terpasang, kita harus membuat database baru dan mengimpor berkas CSV untuk dikerjakan. Di panel Object Explorer, klik kanan pada Databases, lalu pilih “New Database”. Masukkan nama database dan informasi lainnya. Ini mungkin memakan waktu beberapa menit.
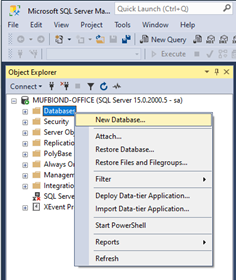
Setelah database berhasil dibuat, mari impor berkas CSV yang akan kita gunakan pada beberapa langkah berikutnya. Anda dapat mengunduh berkas contoh ke komputer Anda dan ikuti petunjuknya.
Klik kanan pada “Tables” → New → Table. Anda dapat menamainya apa pun yang Anda suka. Dalam contoh ini, saya menamai tabel ini “jewelry”.
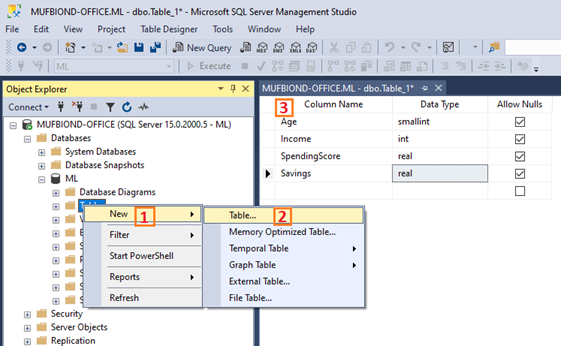
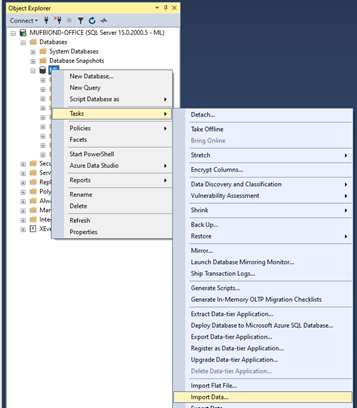
Sekarang tabel telah dibuat, kita dapat memberinya konten. Mari impor berkas CSV ke tabel ini. Klik kanan database dan pilih Tasks -> Import Data
Untuk Data Source, pilih “Flat File Source”, lalu gunakan tombol Browse untuk memilih berkas CSV. Luangkan waktu untuk mengonfigurasi impor data sebelum mengeklik tombol Next.
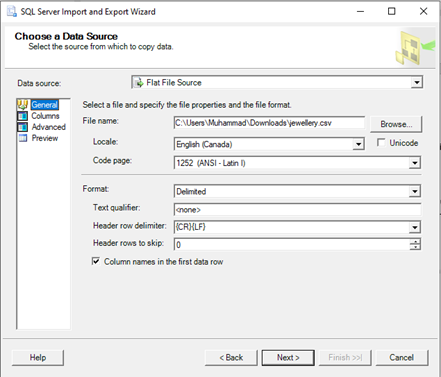
Klik Next dan masukkan detail database (nama server, nama pengguna, dan kata sandi) lalu ikuti petunjuk di layar selanjutnya. Terakhir, klik tombol Finish untuk menyelesaikan proses impor.
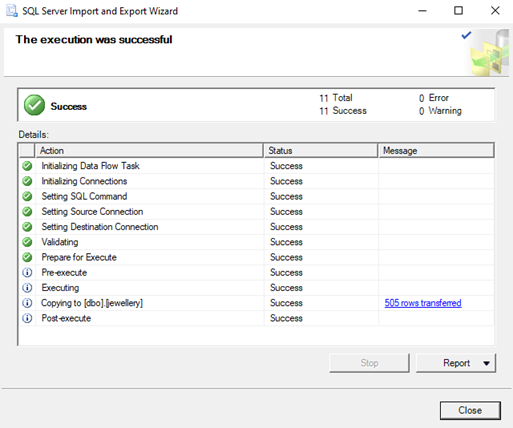
Sekarang, kita memiliki tabel “jewelry” dengan data yang telah diimpor.
Konfigurasikan Lingkungan Python
Sebelum mulai melatih model machine learning di SQL, kita harus mengonfigurasikan skrip Python di SQL. Kita akan menjalankan Python “di dalam” SQL Server dengan menggunakan prosedur tersimpan sistem sp_execute_external_script. Untuk memulai, klik “New Query” dan eksekusi kode berikut untuk mengaktifkan penggunaan prosedur untuk eksekusi skrip jarak jauh:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Mulai ulang server SQL sebelum melanjutkan lebih jauh.
Sekarang, mari atur bahasanya dan periksa path instalasi. Dengan Microsoft SQL Machine Learning Service, Anda memiliki dua opsi: R atau Python. Dalam contoh ini, kita akan menggunakan Python, atau lebih spesifiknya PyCaret (pustaka Python untuk machine learning), untuk melatih model klastering unsupervised pada dataset “jewelry”.
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’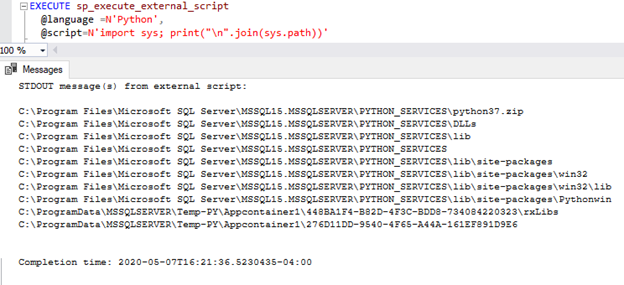
Langkah terakhir sebelum kita mulai melatih model adalah memasang pustaka PyCaret. Untuk memasang paket PyCaret, buka command prompt dan telusuri ke lokasi paket Python tempat SQL Server dipasang (lihat path di atas). Jalankan kode berikut di command prompt.
pip.exe install pycaret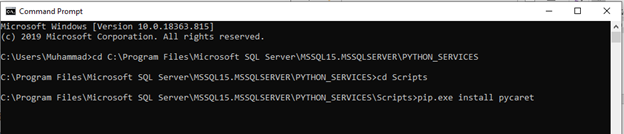
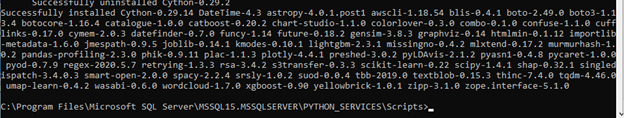
Proses pemasangan dapat memakan waktu 10–15 menit. Setelah selesai, tampilannya akan seperti ini:
Sekarang, kembali ke Microsoft SSMS.
Latih model klastering unsupervised
Klastering adalah teknik machine learning yang mengelompokkan titik data dengan karakteristik serupa. Pengelompokan ini berguna untuk mengeksplorasi data, mengidentifikasi pola, dan menganalisis subset data. Beberapa use case bisnis umum untuk klastering adalah:
- Segmentasi pelanggan untuk keperluan pemasaran.
- Analisis perilaku pembelian pelanggan untuk promosi dan diskon.
- Mengidentifikasi geo-cluster dalam wabah epidemi seperti COVID-19.
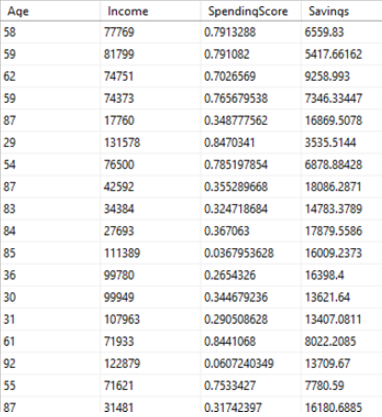
Kita memiliki empat titik data per pelanggan yang terlihat seperti ini:
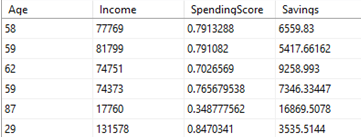
Tujuan kita adalah melatih model klastering KMeans pada dataset ini dan membuat kolom baru “Cluster” yang merepresentasikan kelompok pelanggan yang saling berkaitan.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Keluaran:
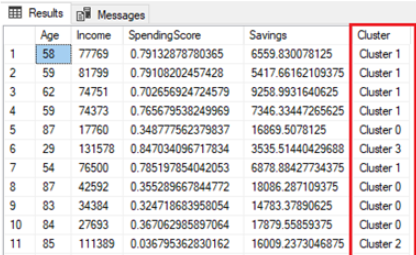
Perhatikan betapa mudahnya itu. Hanya dengan satu baris `pc.get_clusters(...)`, kita telah melakukan prapemrosesan data, melatih model KMeans unsupervised, dan menggunakan model terlatih untuk menghasilkan label klaster – semuanya tanpa harus keluar dari lingkungan SQL Server. Mirip dengan klastering, PyCaret juga mendukung deteksi anomali unsupervised dengan perintah ajaib `pc.get_anomaly`. Anda juga dapat melatih model machine learning supervised (Klasifikasi atau Regresi), menyimpan model dalam prosedur SQL, dan menggunakannya nanti untuk menghasilkan inferensi. Semua ini dapat dilakukan langsung dari database Anda.
Kesimpulan
Apa arti machine learning di dalam database bagi bisnis Anda? Artinya Anda dapat meminimalkan jumlah langkah yang perlu dilakukan untuk machine learning yang lebih efisien, lebih cepat, dan lebih mudah dioperasionalisasikan. Melatih model machine learning di dalam database meminimalkan perpindahan data, yang menghemat waktu dan biaya. Namun, ini bukan peluru perak. Apakah Anda menggunakannya atau tidak akan selalu bergantung pada use case. Semoga tutorial ini memberi Anda perspektif baru tentang kemungkinan machine learning di lingkungan perusahaan.
Jika Anda ingin mempelajari lebih lanjut tentang bagaimana Python dan SQL dapat digunakan bersama untuk meningkatkan analisis data dan efisiensi, saya merekomendasikan Anda mengambil kursus Introduction to Databases in Python. Dalam kursus ini, Anda akan mempelajari dasar-dasar menggunakan SQL dengan Python. Ini akan berguna karena database ada di mana-mana dan data scientist, analis, serta engineer harus selalu berinteraksi dengannya. Toolkit SQL Python, SQLAlchemy, menyediakan cara yang mudah diakses dan intuitif untuk melakukan kueri, membangun, dan menulis ke database penting, termasuk SQLite, MySQL, dan PostgreSQL.



