Índice de contenidos
- Introducción
- Caso de uso: entrenamiento de modelos de machine learning en la base de datos
- Bases de datos con machine learning in-database
- Microsoft SQL Server Machine Learning Services
- PyCaret: biblioteca de machine learning de código abierto y low-code en Python
- Demo de principio a fin: entrenar modelos de ML en SQL
- Descargar e instalar SQL Server
- Crear una base de datos nueva e importar un archivo CSV
- Configurar el entorno de Python
- Entrenar un modelo de clustering no supervisado
- Conclusión
Introducción
Python y R son lenguajes de programación muy usados por científicos de datos, ingenieros de datos y de machine learning. Poder ejecutar código de Python como script SQL abre un sinfín de posibilidades para las operaciones de datos, incluidas capacidades de machine learning in-database cuando trabajas con grandes volúmenes de información. Las herramientas habituales para experimentar con machine learning son los entornos de desarrollo integrados (IDE) como VS Code o los Notebooks, que son interactivos por naturaleza. Sin embargo, estas herramientas pueden quedarse cortas cuando el tamaño de los datos es muy grande o cuando hay que llevar el modelo de ML a producción. Cada vez es más necesario programar y entrenar modelos allí donde residen los datos; en este tutorial, verás varias formas de conseguirlo.
Caso de uso: entrenamiento de modelos de machine learning en la base de datos
Hoy en día, muchas bases de datos incluyen servicios de machine learning integrados (ver la siguiente sección). Esto significa que no necesitas adquirir una plataforma de data science externa, ya que puedes usar las capacidades de machine learning in-database para entrenar y desplegar tus modelos en la propia base de datos. Un flujo de trabajo típico de machine learning se ve así:
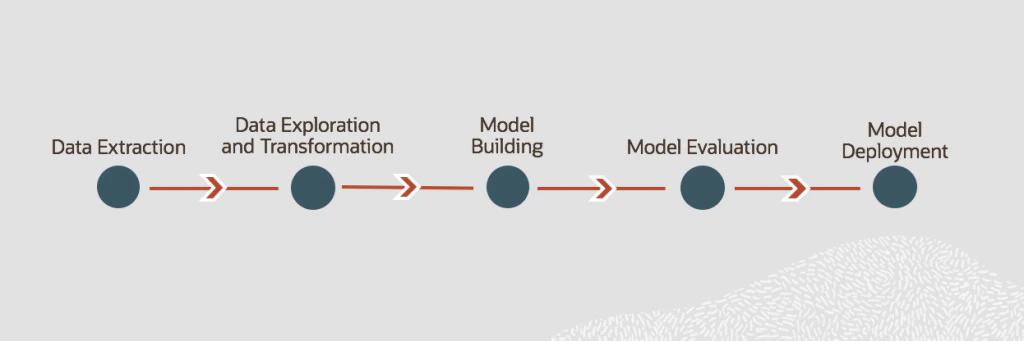
Cuando entrenas un modelo de machine learning dentro de la base de datos, no necesitas un proceso ETL independiente porque los datos ya están allí. Esto ahorra mucho tiempo. Para los pasos posteriores, como la construcción del modelo y su despliegue, tampoco tendrás que mover nada a una plataforma externa de machine learning, ya que usarás capacidades in-database para entrenar y desplegar la solución. Según el blog de Oracle Big Data, esto aporta tres beneficios:
El proceso global se simplifica
A veces se tardan horas o días solo en mover los datos a otra plataforma donde están los algoritmos. Aunque este proceso introduce complicaciones como una posible pérdida de datos, sigue siendo lo habitual en muchas empresas.
Ahorras tiempo y costes
Tiene más sentido llevar los algoritmos a la base de datos que mover los datos hasta los algoritmos. Unir machine learning y base de datos es más práctico no solo por simplicidad, sino también por velocidad. Ahorras tiempo y esfuerzo, lo que al final impacta en la cuenta de resultados al reducir costes.
Obtienes valor más rápido
Aunque construir un modelo de machine learning, entrenarlo, obtener resultados y analizarlos lleva tiempo y esfuerzo, el negocio normalmente no ve el valor hasta que el modelo se pone en producción y los departamentos (Finanzas, RR. HH., cadena de suministro, Marketing, Ventas, etc.) pueden aprovechar esos resultados.
Como el despliegue y la integración en aplicaciones como cuadros de mando de business intelligence (BI), call centers, cajeros, sitios web y móviles puede ser un gran reto para TI, la puesta en producción puede ser sencilla o muy compleja.
Si tu modelo ha estado en la base de datos desde el principio, la cantidad de trabajo complejo de despliegue se reduce drásticamente. El proceso se vuelve mucho más fácil y los resultados llegan antes.
Bases de datos con machine learning in-database
Microsoft SQL Server
Microsoft SQL Server Machine Learning Services admite R, Python, Java, el comando PREDICT de T-SQL y el procedimiento almacenado rx_Predict en el RDBMS de SQL Server, y SparkML en SQL Server Big Data Clusters. En R y Python, Microsoft incluye varios paquetes y librerías para machine learning. Puedes almacenar tus modelos entrenados en la base de datos o de forma externa. Azure SQL Managed Instance admite Machine Learning Services para Python y R en versión preliminar. Más información.
Amazon Redshift
Amazon Redshift es un servicio gestionado de data warehouse a escala de petabytes, diseñado para que analizar todos tus datos con tus herramientas de business intelligence actuales sea sencillo y rentable. Está optimizado para conjuntos de datos desde unos cientos de gigabytes hasta un petabyte o más y cuesta menos de 1.000 $ por terabyte al año. Más información.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science es una plataforma gestionada y sin servidores para que los equipos de data science creen, entrenen y gestionen modelos de machine learning usando Oracle Cloud Infrastructure, incluido Oracle Autonomous Database y Oracle Autonomous Data Warehouse. Incluye herramientas, librerías y paquetes centrados en Python desarrollados por la comunidad open source y la Oracle Accelerated Data Science (ADS) Library, que cubre el ciclo de vida completo de los modelos predictivos. Más información.
Google Cloud BigQuery
BigQuery es el data warehouse gestionado de Google Cloud, a escala de petabytes, que te permite ejecutar analítica sobre cantidades ingentes de datos casi en tiempo real. BigQuery ML te permite crear y ejecutar modelos de machine learning en BigQuery con consultas SQL. BigQuery ML admite regresión lineal para previsiones; regresión logística binaria y multiclase para clasificación; clustering K-means para segmentación; factorización de matrices para sistemas de recomendación y series temporales para pronósticos. Más información.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud es un servicio de nube pública gestionado. También puedes desplegar IBM Db2 Warehouse on premises con tu propio hardware o en una nube privada. Como data warehouse, incluye funciones como procesamiento en memoria y tablas columnares para análisis OLAP. Su tecnología Netezza ofrece un conjunto sólido de analítica diseñada para llevar la consulta a los datos de forma eficiente. Más información.
BlazingSQL
BlazingSQL es un motor SQL acelerado por GPU construido sobre el ecosistema RAPIDS; existe como proyecto open source y como servicio de pago. RAPIDS, que usa CUDA y se basa en el formato de memoria columnar Apache Arrow, es un conjunto de librerías y APIs de código abierto incubado por Nvidia. CuDF, parte de RAPIDS, es una librería de DataFrame en GPU similar a Pandas para cargar, unir, agregar, filtrar y manipular datos. Más información.
Microsoft SQL Server Machine Learning Services
Machine Learning Services es una funcionalidad de SQL Server que te permite ejecutar scripts de Python y R con datos relacionales. Puedes usar paquetes y frameworks open source, además de los paquetes de Python y R de Microsoft, para analítica predictiva y machine learning. Los scripts se ejecutan dentro de la base de datos sin mover los datos fuera de SQL Server ni por la red. Este artículo explica los conceptos básicos de SQL Server Machine Learning Services y cómo empezar.
SQL Server Machine Learning Services te permite ejecutar scripts de Python y R dentro de la base de datos. Puedes preparar y limpiar datos, hacer ingeniería de características y entrenar, evaluar y desplegar modelos de machine learning en la propia base de datos. La funcionalidad ejecuta tus scripts donde residen los datos y elimina la necesidad de transferirlos por la red a otro servidor.
Versiones de Python y R compatibles
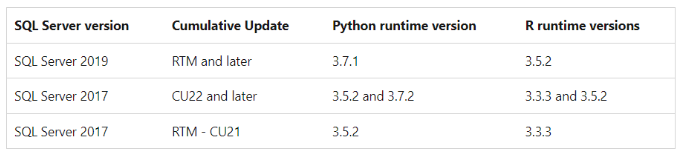
Actualmente, en SQL Machine Learning Services se admiten las siguientes versiones de Python y R.
Librerías de Python y R instaladas por defecto
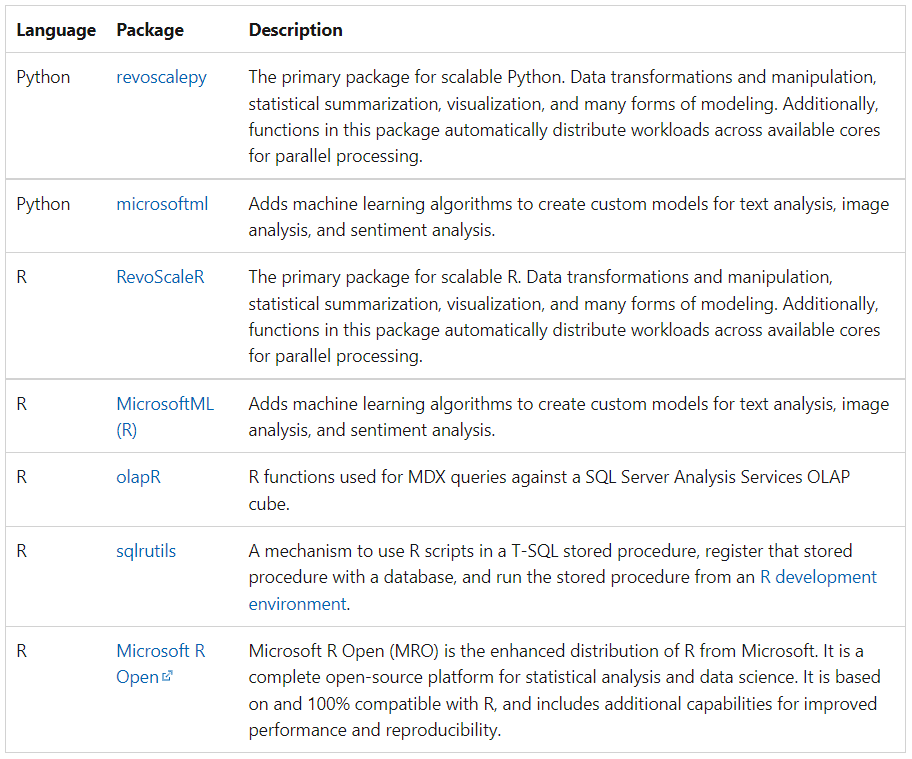
Puedes usar los paquetes y frameworks open source que prefieras, pero los siguientes paquetes de Python y R vienen instalados por defecto:
PyCaret: biblioteca de ML open source y low-code
PyCaret es una librería de machine learning en Python, de código abierto y low-code, que automatiza los flujos de trabajo de ML. Es una herramienta de extremo a extremo para machine learning y gestión de modelos que acelera exponencialmente el ciclo de experimentación y mejora la productividad.
Frente a otras librerías open source de machine learning, PyCaret es una alternativa low-code que te permite sustituir cientos de líneas de código por unas pocas. Así, los experimentos son mucho más rápidos y eficientes. PyCaret es, en esencia, un envoltorio en Python sobre varias librerías y frameworks de ML como scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray y algunas más.
El diseño y la sencillez de PyCaret se inspiraron en la figura emergente del citizen data scientist, un término acuñado por Gartner. Los citizen data scientists son usuarios avanzados capaces de realizar tareas analíticas sencillas y de complejidad media que antes requerían más especialización técnica. Consulta este enlace para saber más sobre PyCaret.
En la siguiente sección, instalaremos Microsoft SQL Server y habilitaremos SQL Machine Learning Services. Después activaremos el entorno de Python, instalaremos PyCaret (librería de ML) y pasaremos al entrenamiento del modelo. Vamos a ello.
Demo de principio a fin: entrenar modelos de ML en SQL
Descargar e instalar SQL Server y Microsoft SSMS
Microsoft SQL Server es un sistema de gestión de bases de datos relacional de Microsoft. Como servidor de bases de datos, su función principal es almacenar y recuperar datos según lo soliciten distintas aplicaciones. En este tutorial, usaremos SQL Server 2019 Developer para entrenar un modelo de machine learning no supervisado con PyCaret.
Si ya has usado SQL Server, probablemente lo tengas instalado y con acceso a la base de datos. Si no, haz clic aquí para descargar las ediciones Developer de SQL Server 2019.
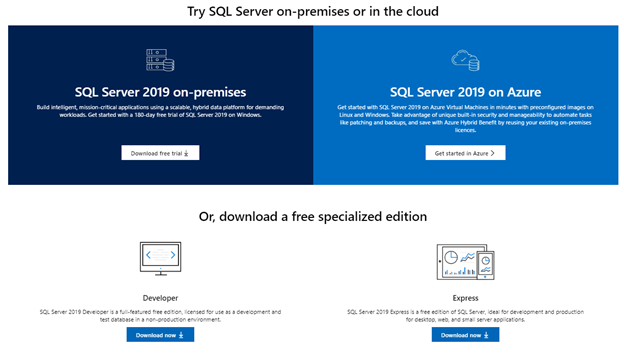
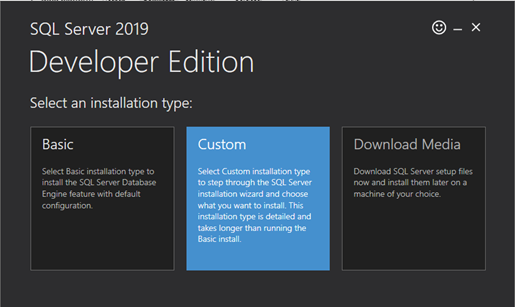
Haz clic en el botón «Download now» bajo la edición Developer y abre el instalador. Selecciona el tipo de instalación «Custom».
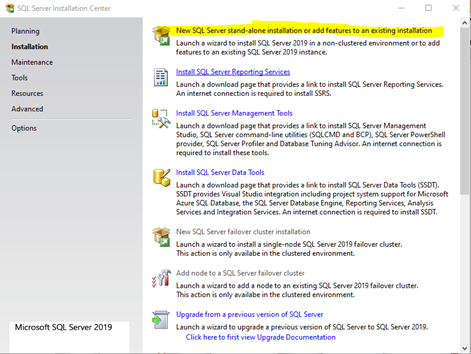
Elige New SQL Server stand-alone installation.
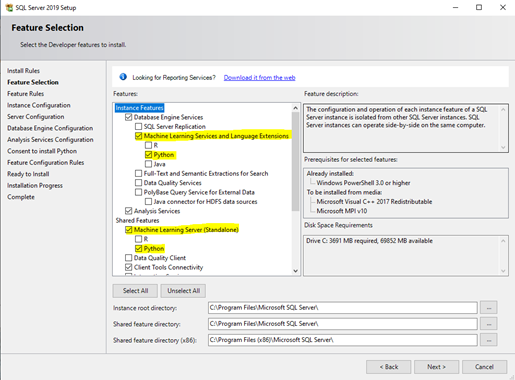
En Instance Features, selecciona las características, incluyendo «Python» en Machine Learning Services and Language Extensions y Machine Learning Server.
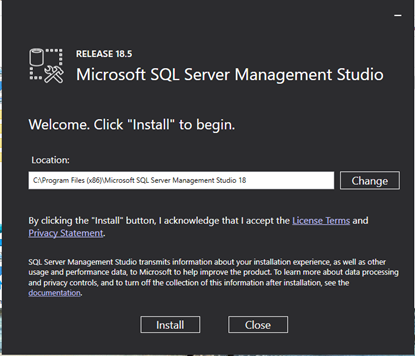
Una vez instalado SQL Server, necesitaremos trabajar con un entorno de desarrollo (IDE). Hay muchas opciones; en este tutorial usaré Microsoft SQL Server Management Studio. Descarga el instalador y sigue las instrucciones. La instalación de SSMS es sencilla.
Crear una base de datos nueva e importar CSV
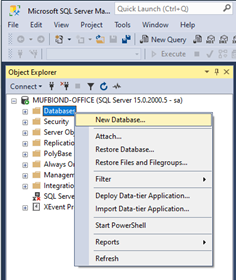
Cuando SQL Server y SSMS estén instalados, crearemos una base de datos nueva e importaremos un archivo CSV para trabajar con él. En el panel Object Explorer, haz clic derecho en Databases y elige «New Database». Introduce el nombre y el resto de información. Puede tardar unos minutos.
Con la base de datos creada, importemos un archivo CSV con el que trabajaremos en los siguientes pasos. Puedes descargar el archivo de ejemplo en tu equipo y seguir las instrucciones.
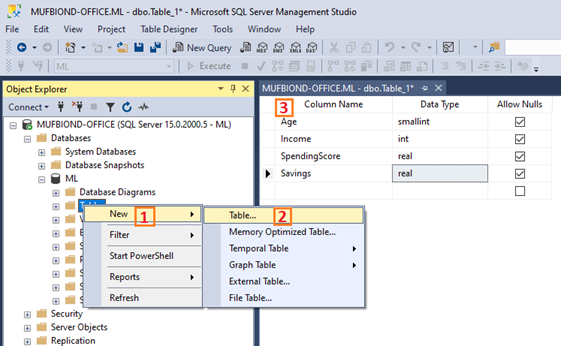
Clic derecho en «Tables» → New → Table. Ponle el nombre que quieras. En este ejemplo, la tabla se llama «jewelry».
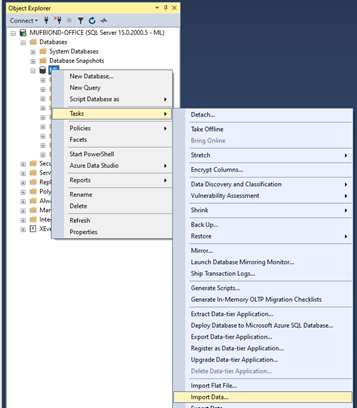
Ahora que la tabla está creada, vamos a darle contenido. Importa el archivo CSV en esta tabla. Haz clic derecho en la base de datos y selecciona Tasks -> Import Data
En Data Source, selecciona «Flat File Source» y usa Browse para elegir el archivo CSV. Dedica un momento a configurar la importación de datos antes de pulsar Next.
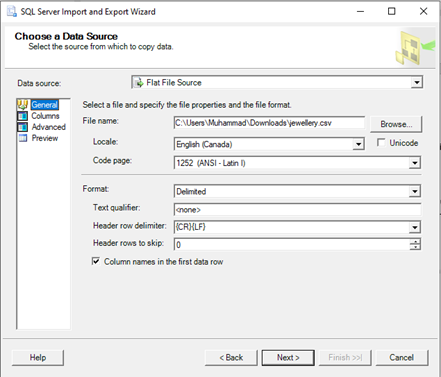
Haz clic en Next e introduce los detalles de la base de datos (nombre del servidor, usuario y contraseña) y sigue las instrucciones de las pantallas siguientes. Por último, haz clic en Finish para completar la importación.
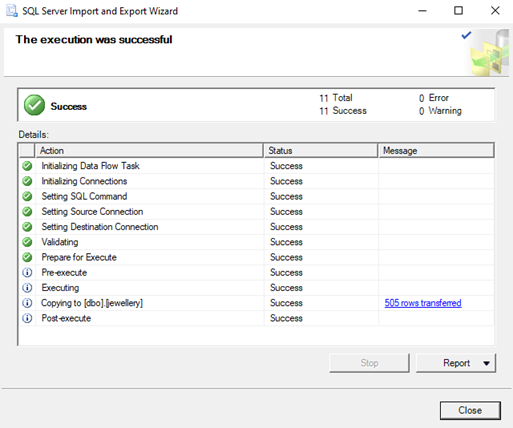
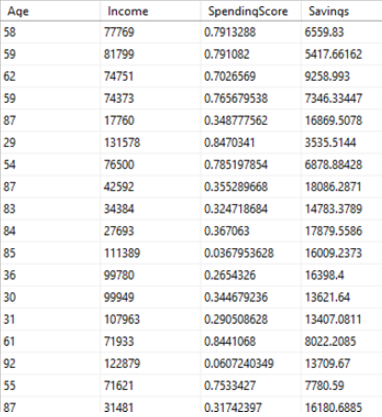
Ya tenemos la tabla «jewelry» con los datos importados.
Configurar el entorno de Python
Antes de entrenar modelos de machine learning en SQL, debemos configurar la ejecución de scripts de Python en SQL. Ejecutaremos Python «dentro» de SQL Server usando el procedimiento almacenado del sistema sp_execute_external_script. Para empezar, haz clic en «New Query» y ejecuta el siguiente código para habilitar el uso del procedimiento para ejecutar scripts externos:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Reinicia el servidor SQL antes de continuar.
Ahora, vamos a establecer el lenguaje y comprobar la ruta de la instalación. Con Microsoft SQL Machine Learning Service tienes dos opciones: R o Python. En este ejemplo usaremos Python, más concretamente PyCaret (una librería de Python para machine learning), para entrenar un modelo de clustering no supervisado sobre el conjunto «jewelry».
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’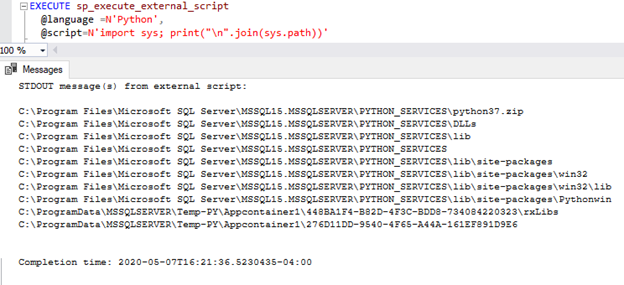
El último paso antes de empezar a entrenar el modelo es instalar la librería PyCaret. Para instalar el paquete PyCaret, abre una consola y navega hasta la ubicación de los paquetes de Python donde está instalado SQL Server (consulta la ruta anterior). Ejecuta el siguiente comando en la consola.
pip.exe install pycaret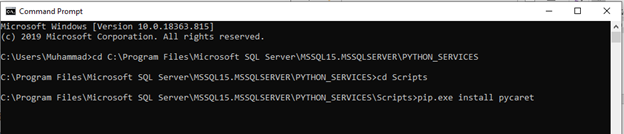
La instalación puede tardar 10-15 minutos. Al finalizar, verás algo así:
Vuelve ahora a Microsoft SSMS.
Entrenar un modelo de clustering no supervisado
El clustering es una técnica de machine learning que agrupa puntos de datos con características similares. Estos agrupamientos son útiles para explorar datos, identificar patrones y analizar subconjuntos. Algunos casos de uso habituales en negocio son:
- Segmentación de clientes con fines de marketing.
- Análisis del comportamiento de compra para promociones y descuentos.
- Identificación de geo-clústeres en brotes epidémicos como la COVID-19.
Tenemos cuatro puntos de datos por cliente, que se ven así:
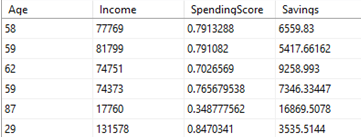
Nuestro objetivo es entrenar un modelo de clustering KMeans sobre este conjunto y crear una columna nueva «Cluster» que represente el grupo al que pertenece cada cliente.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Resultado:
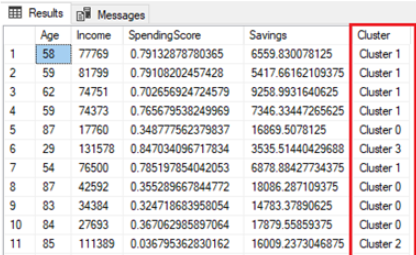
Fíjate en lo sencillo que ha sido. Con una sola línea, `pc.get_clusters(...)`, hemos preprocesado los datos, entrenado un modelo KMeans no supervisado y usado el modelo entrenado para generar las etiquetas de cluster, todo sin salir del entorno de SQL Server. Igual que con el clustering, PyCaret también admite la detección de anomalías no supervisada con el comando mágico `pc.get_anomaly`. También puedes entrenar modelos supervisados (clasificación o regresión), guardar el modelo en un procedimiento de SQL y usarlo después para generar inferencias. Todo esto puede hacerse directamente desde tu base de datos.
Conclusión
¿Qué supone el machine learning dentro de la base de datos para tu negocio? Que puedes reducir pasos para lograr un ML más eficiente, rápido y fácil de llevar a producción. Entrenar modelos en la base de datos minimiza el movimiento de datos, con el consiguiente ahorro de tiempo y costes. Ahora bien, no es una solución mágica: su adopción dependerá siempre del caso de uso. Esperamos que este tutorial te haya aportado una nueva perspectiva sobre lo que es posible en entornos empresariales.
Si quieres aprender más sobre cómo combinar Python y SQL para mejorar tu análisis de datos y tu eficiencia, te recomendamos el curso Introduction to Databases in Python. En él aprenderás las bases de usar SQL con Python. Te será útil porque las bases de datos están por todas partes y los científicos de datos, analistas e ingenieros interactúan con ellas constantemente. El toolkit SQLAlchemy de Python ofrece una forma accesible e intuitiva de consultar, construir y escribir en bases de datos esenciales como SQLite, MySQL y PostgreSQL.