İçindekiler
- Giriş
- Kullanım senaryosu: Veritabanı İçinde Makine Öğrenimi Modelleri Eğitimi
- Veritabanı İçi Makine Öğrenimini Destekleyen Veritabanları
- Microsoft SQL Server Machine Learning Services
- PyCaret: Python'da Açık Kaynak, Düşük Kodlu Bir Makine Öğrenimi Kütüphanesi
- SQL'de ML Modellerinin Eğitiminin Uçtan Uca Demosu
- SQL Server'ı indirin ve kurun
- Yeni bir veritabanı oluşturun ve CSV dosyası içe aktarın
- Python Ortamını Yapılandırın
- Denetimsiz bir kümeleme modeli eğitin
- Sonuç
Giriş
Python ve R, veri bilimciler, veri mühendisleri ve makine öğrenimi mühendisleri tarafından yaygın olarak kullanılan programlama dilleridir. Python kodunu bir SQL betiği olarak çalıştırabilmek, özellikle büyük miktarda verilerle uğraşırken veritabanı içi makine öğrenimi yetenekleri dahil olmak üzere veri işlemleri için sınırsız olanaklar sunar. Makine öğrenimi deneyleri yapmak için başvurulan araçlar, doğası gereği etkileşimli olan VS Code gibi tümleşik geliştirme ortamları (IDE) veya Notebooks'lardır. Ancak, bu araçlar veri boyutu çok büyüdüğünde veya ML modelinin üretime alınması gerektiğinde sınırlamalar yaratabilir. Verilerin bulunduğu yerde programlama yapma ve model eğitme ihtiyacı uzun süredir mevcuttur; bu eğitimde bunu başarmanın birkaç yolunu öğreneceksiniz.
Kullanım Senaryosu: Veritabanı İçinde Makine Öğrenimi Modelleri Eğitimi
Günümüzde birçok veritabanı yerleşik makine öğrenimi servisleriyle birlikte gelir (bkz. bir sonraki bölüm). Bu, harici bir veri bilimi platformu edinmenize gerek kalmadığı anlamına gelir; veritabanı içi makine öğrenimi yeteneklerini kullanarak modellerinizi veritabanında eğitip dağıtabilirsiniz. Tipik bir makine öğrenimi iş akışı şu şekildedir:
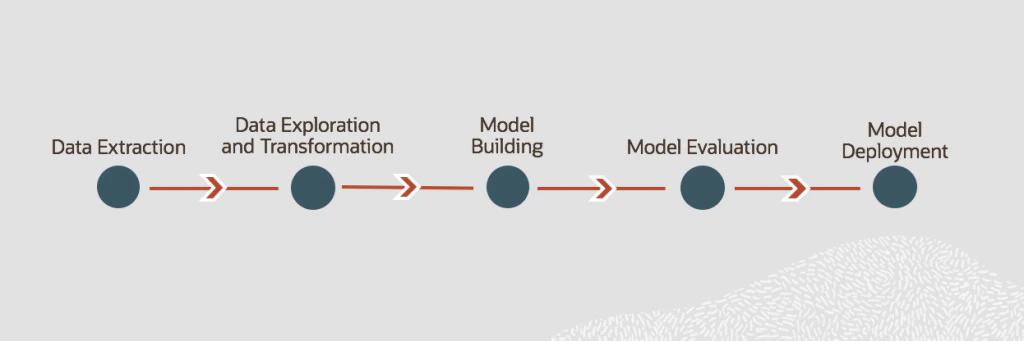
Bir makine öğrenimi modelini veritabanı içinde eğitirken, verileriniz zaten veritabanında olduğu için bağımsız bir ETL sürecine ihtiyacınız olmaz. Bu da çok zaman kazandırır. Model Oluşturma ve Dağıtım gibi sonraki adımlar için de herhangi bir harici makine öğrenimi platformuna veri aktarmanız gerekmez; çünkü bir ML çözümünü eğitmek ve dağıtmak için veritabanı içi yetenekleri kullanırsınız. Oracle Big Data Blogu'na göre bunun üç faydası vardır:
Genel süreç basitleşir
Verileri algoritmaların bulunduğu başka bir platforma taşımak bazen saatler veya günler sürebilir. Bu süreç olası veri kaybı gibi karmaşıklıklar getirse de, aslında çoğu şirket için hâlâ standarttır.
Zaman/maliyet tasarrufu sağlarsınız
Verileri algoritmalara taşımak yerine, algoritmaları veritabanına taşımak daha mantıklıdır. Bu nedenle, makine öğrenimi ile veritabanını eşleştirmek sadece sadelik açısından değil, hız açısından da daha pratiktir. Zaman ve ciddi efor tasarrufu sağlar, bu da nihayetinde maliyetleri düşürerek sonuca yansır.
Sonuçlara (değere) daha hızlı ulaşırsınız
Bir makine öğrenimi modelini oluşturmak, eğitmek, sonuçları almak ve analiz etmek çok zaman ve emek gerektirse de, işletmeler genellikle model üretime alınana kadar makine öğrenimiyle pek ilgilenmez; çünkü organizasyondan sorumlu birimler (Finans, İK, Tedarik Zinciri, Pazarlama, Satış vb.) sonuçlardan ancak o zaman yararlanabilir.
Dağıtım ve iş zekâsı (BI) panoları, çağrı merkezleri, ATM'ler, web siteleri ve mobil cihazlar gibi uygulamalara entegrasyon BT için çok büyük bir zorluk olabileceğinden, operasyonelleştirme süreci basit de olabilir, çok karmaşık da.
Modeliniz baştan beri veritabanında ise, karmaşık dağıtım işi ciddi ölçüde azalır. Bu da süreci çok daha kolay hale getirir ve sonuçlara daha hızlı ulaşılır.
Veritabanı İçi Makine Öğrenimini Destekleyen Veritabanları
Microsoft SQL Server
Microsoft SQL Server Machine Learning Services; SQL Server RDBMS içinde R, Python, Java, PREDICT T-SQL komutu ve rx_Predict saklı yordamını; SQL Server Big Data Clusters içinde ise SparkML'i destekler. Microsoft, R ve Python dillerinde makine öğrenimi için çeşitli paketler ve kütüphaneler sunar. Eğitilmiş modellerinizi veritabanında veya haricinde saklayabilirsiniz. Azure SQL Managed Instance, önizleme olarak Python ve R için Machine Learning Services'i destekler. Daha fazla bilgi.
Amazon Redshift
Amazon Redshift, mevcut iş zekâsı araçlarınızı kullanarak tüm verilerinizi basit ve uygun maliyetli biçimde analiz etmenizi sağlamak üzere tasarlanmış, yönetilen, petabayt ölçekli bir veri ambarı servisidir. Birkaç yüz gigabayttan petabaytlara kadar veri kümeleri için optimize edilmiştir ve yılda terabayt başına 1.000 $'dan daha az maliyetlidir. Daha fazla bilgi.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science, Oracle Autonomous Database ve Oracle Autonomous Data Warehouse dahil olmak üzere Oracle Cloud Infrastructure'ı kullanarak makine öğrenimi modelleri oluşturmak, eğitmek ve yönetmek için veri bilimi ekiplerine yönelik, yönetilen ve sunucusuz bir platformdur. Açık kaynak topluluğu tarafından geliştirilen Python odaklı araçlar, kütüphaneler ve paketlerin yanı sıra kestirimci modellerin uçtan uca yaşam döngüsünü destekleyen Oracle Accelerated Data Science (ADS) Library'yi içerir. Daha fazla bilgi.
Google Cloud BigQuery
BigQuery, Google Cloud'un yönetilen, petabayt ölçekli veri ambarıdır ve çok büyük miktardaki veriler üzerinde neredeyse gerçek zamanlı analiz yapmanıza olanak tanır. BigQuery ML, SQL sorguları kullanarak BigQuery içinde makine öğrenimi modelleri oluşturup çalıştırmanızı sağlar. BigQuery ML; tahminleme için doğrusal regresyonu; sınıflandırma için ikili ve çok sınıflı lojistik regresyonu; veri segmentasyonu için K-ortalamalar kümelemesini; ürün öneri sistemleri için matris ayrıştırmasını ve zaman serisi tahminleri için zaman serilerini destekler. Daha fazla bilgi.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud, yönetilen bir genel bulut servisidir. IBM Db2 Warehouse'u kendi donanımınızla şirket içinde veya özel bulutta da kurabilirsiniz. Bir veri ambarı olarak, bellek içi veri işleme ve çevrimiçi analitik işlem için sütunlu tablolar gibi özellikler içerir. Netezza teknolojisi, sorguyu veriye verimli bir şekilde taşıyacak güçlü bir analiz seti sunar. Daha fazla bilgi.
BlazingSQL
BlazingSQL, RAPIDS ekosistemi üzerinde inşa edilmiş, GPU hızlandırmalı bir SQL motorudur; hem açık kaynak bir proje hem de ücretli bir hizmet olarak mevcuttur. CUDA kullanan ve Apache Arrow sütunlu bellek formatına dayanan RAPIDS, Nvidia tarafından başlatılan bir açık kaynak yazılım kütüphane ve API paketidir - RAPIDS'in bir parçası olan CuDF, verileri yüklemek, birleştirmek, toplamak, filtrelemek ve çeşitli şekillerde işlemek için Pandas benzeri bir GPU DataFrame kütüphanesidir. Daha fazla bilgi.
Microsoft SQL Server Machine Learning Services
Machine Learning Services, SQL Server'da ilişkisel verilerle Python ve R betikleri çalıştırma olanağı sağlayan bir özelliktir. Tahmine dayalı analiz ve makine öğrenimi için açık kaynak paket ve çerçeveleri ile Microsoft'un Python ve R paketlerini kullanabilirsiniz. Betikler, verileri SQL Server dışına veya ağ üzerinden taşımadan veritabanı içinde yürütülür. Bu makale, SQL Server Machine Learning Services'in temellerini ve nasıl başlayacağınızı açıklar.
SQL Server Machine Learning Services, Python ve R betiklerini veritabanı içinde yürütmenizi sağlar. Verileri hazırlamak ve temizlemek, özellik mühendisliği yapmak ve makine öğrenimi modellerini veritabanı içinde eğitmek, değerlendirmek ve dağıtmak için kullanabilirsiniz. Özellik, betiklerinizi verilerin bulunduğu yerde çalıştırır ve verileri ağ üzerinden başka bir sunucuya aktarma gereğini ortadan kaldırır.
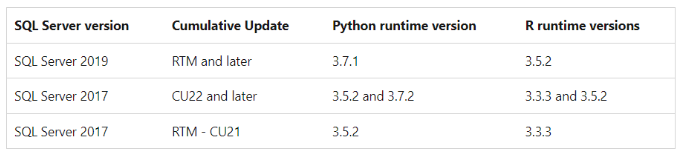
Desteklenen Python ve R sürümleri
Şu anda, SQL Machine Learning Services içinde aşağıdaki Python ve R sürümleri desteklenmektedir.
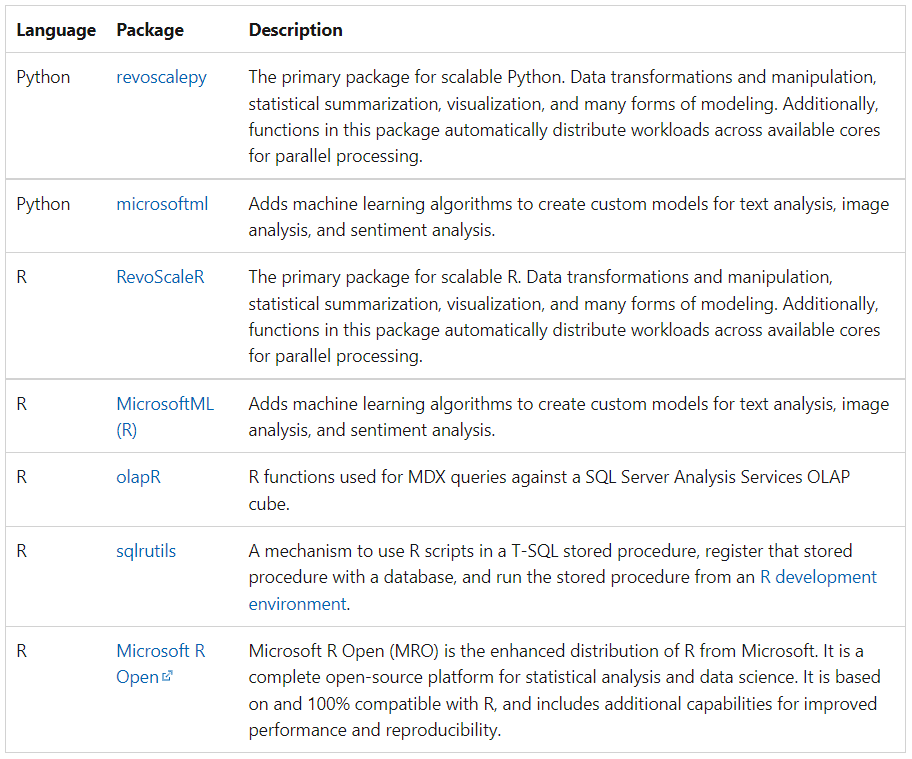
Varsayılan olarak kurulan Python ve R kütüphaneleri
İstediğiniz açık kaynak paket ve çerçeveyi kullanabilirsiniz; ancak aşağıdaki Python ve R paketleri varsayılan olarak kurulu gelir:
PyCaret: Açık Kaynak, Düşük Kodlu Bir ML Kütüphanesi
PyCaret, makine öğrenimi iş akışlarını otomatikleştiren, Python'da açık kaynaklı ve düşük kodlu bir makine öğrenimi kütüphanesidir. Deney döngüsünü katlanarak hızlandıran ve üretkenliği artıran uçtan uca bir makine öğrenimi ve model yönetimi aracıdır.
Diğer açık kaynak makine öğrenimi kütüphaneleriyle karşılaştırıldığında PyCaret, yüzlerce satır kodu yalnızca birkaç satırla değiştirebilen alternatif bir düşük kodlu kütüphanedir. Bu da deneyleri katlanarak daha hızlı ve verimli hale getirir. PyCaret özünde, scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray ve daha birkaç tane gibi birçok makine öğrenimi kütüphanesi ve çerçevesinin etrafında bir Python sarmalayıcısıdır.
PyCaret'in tasarımı ve sadeliği, ilk kez Gartner tarafından kullanılan bir terim olan vatandaş veri bilimcilerinin yükselen rolünden ilham almıştır. Vatandaş veri bilimciler, daha önce daha fazla teknik uzmanlık gerektiren basit ve orta derecede karmaşık analitik görevleri yerine getirebilen güçlü kullanıcılardır. PyCaret hakkında daha fazla bilgi edinmek için bu bağlantıya göz atın.
Bir sonraki bölümde Microsoft SQL Server'ı kuracak ve SQL Machine Learning Services'i etkinleştireceğiz. Ardından Python ortamını etkinleştirip PyCaret'i (ML kütüphanesi) kuracak ve model eğitimine geçeceğiz. Nasıl yapılacağına bakalım.
SQL'de ML Modellerinin Eğitiminin Uçtan Uca Demosu
SQL Server ve Microsoft SSMS'i indirin ve kurun
Microsoft SQL Server, Microsoft'un bir ilişkisel veritabanı yönetim sistemidir. Bir veritabanı sunucusu olarak, farklı uygulamaların talep ettiği şekilde verileri saklama ve getirme temel işlevini yerine getirir. Bu eğitimde, PyCaret aracılığıyla denetimsiz bir makine öğrenimi modeli eğitmek için SQL Server 2019 Developer sürümünü kullanacağız.
Daha önce SQL Server kullandıysanız, muhtemelen kurulu ve veritabanına erişiminiz vardır. Değilse, SQL Server 2019 Developer sürümlerini indirmek için buraya tıklayın.
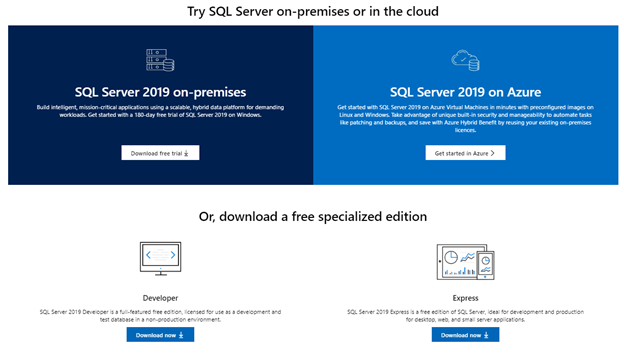
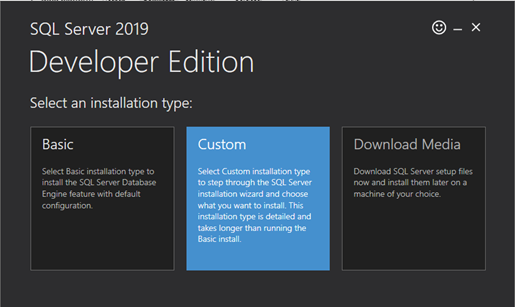
Geliştirici sürümünün altındaki “Download now” düğmesine tıklayın ve yükleyici dosyasını açın. “Custom” kurulum türünü seçin.
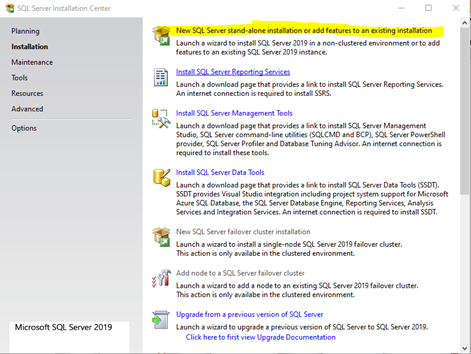
Yeni bir SQL Server bağımsız kurulumu (New SQL Server stand-alone installation) seçin.
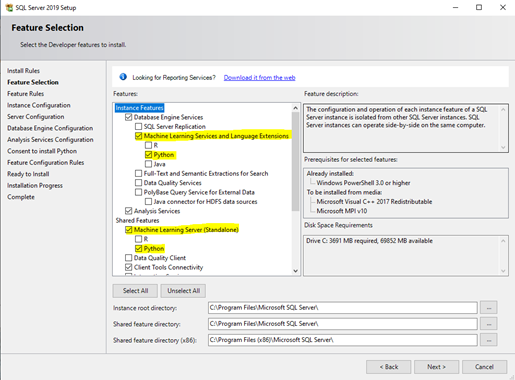
Instance Features seçeneğinde, Machine Learning Services and Language Extensions ve Machine Learning Server altında “Python” dahil özellikleri seçin.
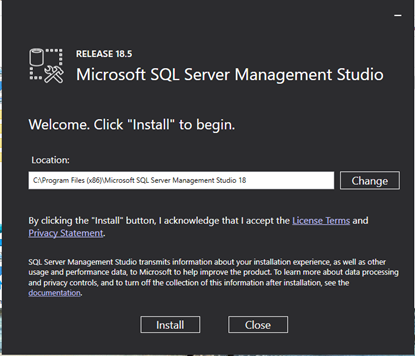
SQL Server başarıyla kurulduktan sonra bir Tümleşik Geliştirme Ortamı (IDE) ile çalışmamız gerekiyor. Birçok seçenek mevcut; ancak bu eğitimde Microsoft SQL Server Management Studio'yu kullanacağım. Yükleyiciyi indirin ve talimatları izleyin. SSMS'in kurulumu basittir.
Yeni bir veritabanı oluşturun ve CSV içe aktarın
SQL Server ve SSMS kurulduktan sonra, yeni bir veritabanı oluşturup onunla çalışmak üzere bir CSV dosyasını içe aktarmamız gerekecek. Object Explorer panelinde Databases'a sağ tıklayın ve “New Database” seçin. Veritabanı adını ve diğer bilgileri girin. Bu işlem birkaç dakika sürebilir.
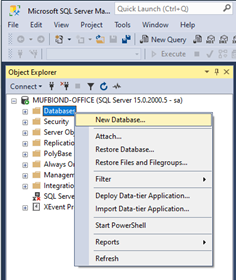
Veritabanı başarıyla oluşturulduktan sonra, sonraki birkaç adımda üzerinde çalışacağımız bir CSV dosyasını içe aktaralım. örnek dosyayı bilgisayarınıza indirebilir ve ardından talimatları izleyebilirsiniz.
“Tables” üzerine sağ tıklayın → New → Table. Dilediğiniz adı verebilirsiniz. Bu örnekte, bu tabloya “jewelry” adını veriyorum.
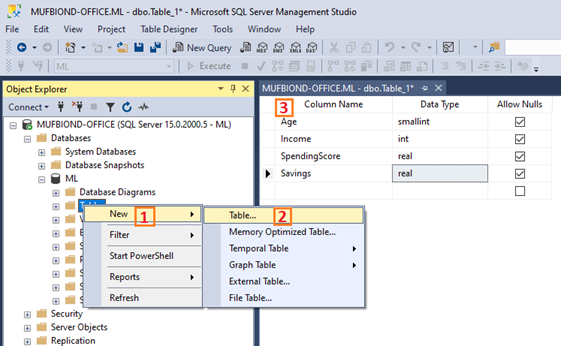
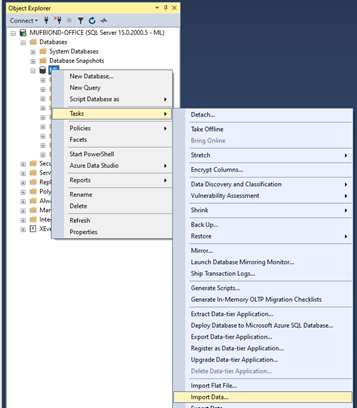
Artık tablo oluşturulduğuna göre ona içerik ekleyebiliriz. CSV dosyasını bu tabloya içe aktaralım. Veritabanına sağ tıklayın ve Görevler -> Veri Al (Tasks -> Import Data) seçin
Data Source için “Flat File Source” seçin, ardından CSV dosyasını seçmek için Gözat (Browse) düğmesini kullanın. İleri (Next) düğmesine tıklamadan önce veri alımını yapılandırmaya biraz zaman ayırın.
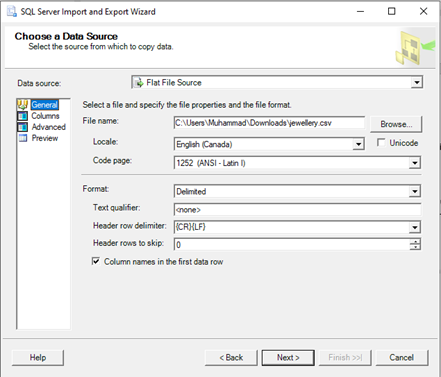
Next'e tıklayın ve veritabanı ayrıntılarını (sunucu adı, kullanıcı adı ve parola) girin ve sonraki ekranlardaki talimatları izleyin. Son olarak, içe aktarmayı tamamlamak için Finish düğmesine tıklayın.
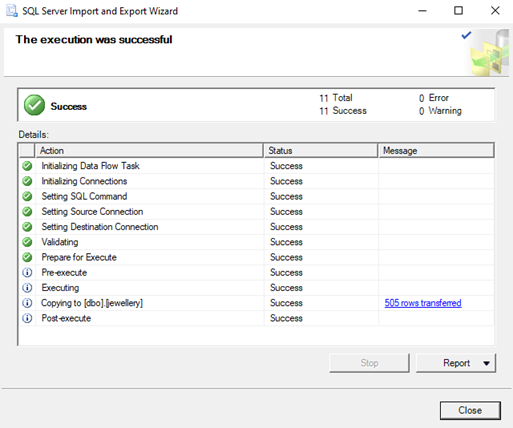
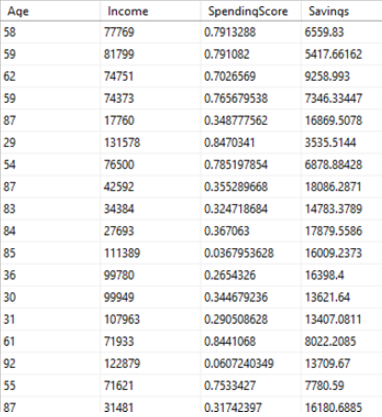
Artık içe aktarılmış verilerle “jewelry” adlı bir tablomuz var.
Python Ortamını Yapılandırın
SQL'de makine öğrenimi modellerini eğitmeye başlamadan önce, SQL içinde Python betiğini yapılandırmamız gerekecek. sp_execute_external_script sistem saklı yordamını kullanarak Python'u SQL Server'ın “içinde” çalıştıracağız. Başlamak için, “New Query” üzerine tıklayın ve uzaktan betik yürütme için yordam kullanımını etkinleştirmek üzere aşağıdaki kodu çalıştırın:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Devam etmeden önce SQL sunucusunu yeniden başlatın.
Şimdi dili ayarlayalım ve kurulumun yolunu kontrol edelim. Microsoft SQL Machine Learning Service ile iki seçeneğiniz vardır: R veya Python. Bu örnekte, Python'u, daha doğrusu PyCaret'i (makine öğrenimi için bir Python kütüphanesi) kullanarak “jewelry” veri kümesi üzerinde denetimsiz bir kümeleme modeli eğiteceğiz.
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’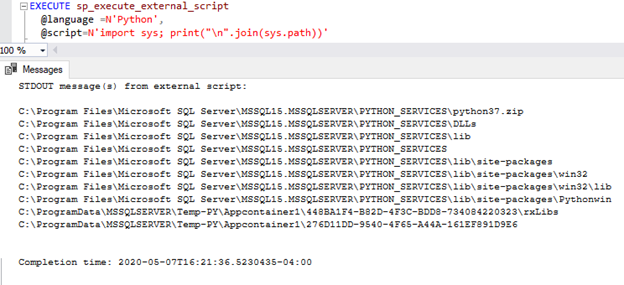
Modele başlamadan önceki son adım PyCaret kütüphanesini kurmaktır. PyCaret paketini kurmak için bir komut istemi açın ve SQL Server'ın kurulu olduğu Python paketlerinin konumuna gidin (yukarıdaki yola bakın). Komut isteminde aşağıdaki kodu çalıştırın.
pip.exe install pycaret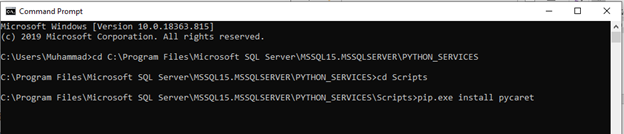
Kurulum 10-15 dakika sürebilir. Tamamlandığında şu şekilde görünecektir:
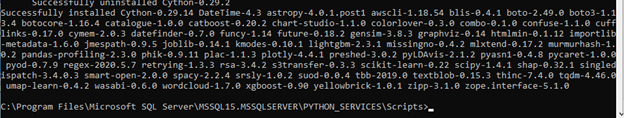
Şimdi, Microsoft SSMS'e geri dönün.
Denetimsiz bir kümeleme modeli eğitin
Kümeleme, benzer özelliklere sahip veri noktalarını gruplandıran bir makine öğrenimi tekniğidir. Bu gruplandırmalar, verileri keşfetmek, kalıpları belirlemek ve bir alt veri kümesini analiz etmek için kullanışlıdır. Kümelemenin yaygın bazı iş kullanım senaryoları şunlardır:
- Pazarlama amacıyla müşteri segmentasyonu.
- Promosyonlar ve indirimler için müşteri satın alma davranışı analizi.
- COVID-19 gibi bir salgında coğrafi kümeleri belirleme.
Müşteri başına şu şekilde görünen dört veri noktamız var:
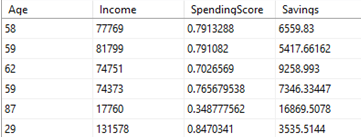
Amacımız, bu veri kümesinde KMeans kümeleme modelini eğitmek ve birlikte ait olan müşteri gruplarını temsil eden “Cluster” adlı yeni bir sütun oluşturmaktır.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Çıktı:
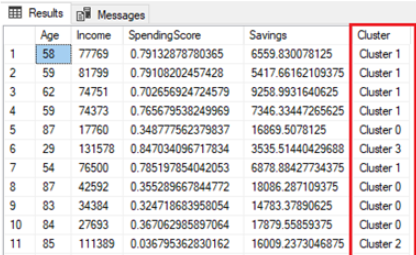
Ne kadar kolay olduğuna dikkat edin. Sadece tek satırlık `pc.get_clusters(...)` ile verileri ön işledik, denetimsiz bir KMeans modelini eğittik ve eğitilmiş modeli kullanarak küme etiketlerini ürettik – hem de SQL sunucu ortamından hiç çıkmadan. Kümelemenin benzeri şekilde, PyCaret `pc.get_anomaly` sihirli komutuyla denetimsiz anomali tespitini de destekler. Ayrıca denetimli makine öğrenimi modelleri (Sınıflandırma veya Regresyon) de eğitebilir, modeli bir SQL yordamında saklayabilir ve daha sonra çıkarım üretmek için kullanabilirsiniz. Tüm bunlar doğrudan veritabanınızdan yapılabilir.
Sonuç
Veritabanında makine öğrenimi işletmeniz için ne anlama gelir? Daha verimli, daha hızlı ve operasyonelleştirmesi daha kolay makine öğrenimi için atmanız gereken adımları en aza indirebileceğiniz anlamına gelir. Veritabanında makine öğrenimi modelleri eğitmek, veri hareketini en aza indirir; bu da zaman ve maliyet tasarrufu sağlar. Ancak, bu sihirli bir değnek değildir. Bunu kullanıp kullanmamak her zaman kullanım senaryosuna bağlı olacaktır. Umarız bu eğitim, kurumsal ortamlarda makine öğreniminin olanaklarına yeni bir bakış açısı kazandırmıştır.
Python ve SQL'in birlikte nasıl kullanılabileceğini ve veri analizinizi ve verimliliğinizi nasıl artırabileceğini daha fazla öğrenmek isterseniz, Introduction to Databases in Python kursunu öneririm. Bu kursta, Python ile SQL kullanmanın temellerini öğreneceksiniz. Bu faydalıdır; çünkü veritabanları her yerde ve veri bilimciler, analistler ve mühendisler onlarla sürekli etkileşim halindedir. Python SQL araç seti SQLAlchemy, SQLite, MySQL ve PostgreSQL dâhil temel veritabanlarını sorgulamak, oluşturmak ve onlara yazmak için erişilebilir ve sezgisel bir yol sağlar.




