Table des matières
- Introduction
- Cas d'usage : entraîner des modèles de machine learning dans la base
- Bases de données compatibles avec le machine learning in-database
- Microsoft SQL Server Machine Learning Services
- PyCaret : une bibliothèque de ML open source et low-code en Python
- Démo de bout en bout : entraîner des modèles de ML dans SQL
- Télécharger et installer SQL Server
- Créer une nouvelle base de données et importer un fichier CSV
- Configurer l'environnement Python
- Entraîner un modèle de clustering non supervisé
- Conclusion
Introduction
Python et R sont largement utilisés par les data scientists, data engineers et machine learning engineers. Pouvoir exécuter du code Python sous forme de script SQL ouvre un champ immense pour les opérations de données, y compris des capacités de machine learning in-database lorsque vous traitez de gros volumes. Les outils de référence pour mener des expérimentations en machine learning sont les environnements de développement (IDE) comme VS Code ou les Notebooks, pensés pour l'interactivité. Cependant, ces outils montrent leurs limites lorsque les données deviennent très volumineuses, ou lorsque le modèle doit passer en production. D'où un besoin fort de pouvoir programmer et entraîner les modèles là où résident les données. Dans ce tutoriel, vous verrez plusieurs façons d'y parvenir.
Cas d'usage : entraîner des modèles de machine learning dans la base
De nombreuses bases de données intègrent désormais des services de machine learning (voir la section suivante). Vous n'avez donc pas besoin d'acquérir une plateforme de data science externe : vous pouvez utiliser les capacités de ML in-database pour entraîner et déployer vos modèles directement dans la base. Un flux de travail type en machine learning ressemble à ceci :
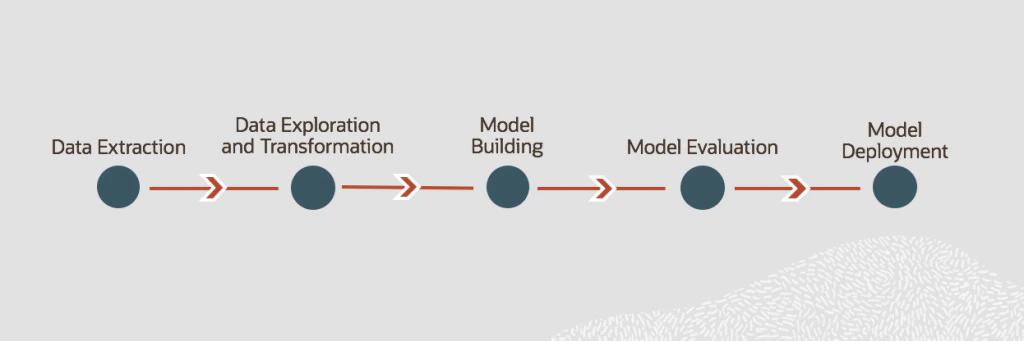
Lorsque vous entraînez un modèle de machine learning dans la base, vous n'avez pas besoin d'un processus ETL séparé, puisque vos données s'y trouvent déjà. C'est un gain de temps important. Pour les étapes suivantes comme la construction et le déploiement du modèle, vous n'avez pas non plus à transférer vers une plateforme externe : vous utilisez les fonctions in-database pour entraîner et déployer votre solution ML. Comme l'indique l'Oracle Big Data Blog, cela présente trois avantages :
Un processus global simplifié
Il peut falloir des heures, voire des jours, rien que pour déplacer les données vers une autre plateforme hébergeant les algorithmes. Malgré les complications que cela introduit (pertes potentielles, frictions), cette pratique reste encore la norme dans beaucoup d'entreprises.
Un gain de temps et de coûts
Il est plus logique d'amener les algorithmes vers la base de données plutôt que l'inverse. Associer machine learning et base de données est donc plus pertinent, non seulement en termes de simplicité mais aussi de rapidité. Vous gagnez du temps et des efforts, avec à la clé des économies substantielles.
Une création de valeur plus rapide
Même si concevoir un modèle, l'entraîner, obtenir et analyser les résultats peut prendre du temps, les métiers ne s'y intéressent réellement que lorsque le modèle est déployé en production et que les directions (Finance, RH, Supply Chain, Marketing, Ventes, etc.) peuvent exploiter les résultats.
Le déploiement et l'intégration dans des applications comme des tableaux de bord BI, des centres d'appels, des DAB, des sites web et des apps mobiles peuvent constituer un vrai défi pour l'IT : l'industrialisation peut être très simple ou très complexe.
Si votre modèle a toujours été dans la base, la charge de déploiement complexe est fortement réduite. Le processus est plus fluide et les résultats arrivent plus vite.
Bases de données compatibles avec le machine learning in-database
Microsoft SQL Server
Microsoft SQL Server Machine Learning Services prend en charge R, Python, Java, la commande PREDICT en T-SQL et la procédure stockée rx_Predict dans le SGBDR SQL Server, ainsi que SparkML dans SQL Server Big Data Clusters. Pour R et Python, Microsoft inclut plusieurs packages et bibliothèques dédiés au machine learning. Vous pouvez stocker vos modèles entraînés dans la base ou en externe. Azure SQL Managed Instance propose Machine Learning Services pour Python et R en préversion. En savoir plus.
Amazon Redshift
Amazon Redshift est un service managé d'entrepôt de données à l'échelle du pétaoctet, conçu pour analyser toutes vos données simplement et à moindre coût avec vos outils de business intelligence existants. Optimisé pour des jeux de données de quelques centaines de Go à plusieurs Po, il coûte moins de 1 000 $ par téraoctet et par an. En savoir plus.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science est une plateforme managée et serverless permettant aux équipes data science de créer, entraîner et gérer des modèles de machine learning avec Oracle Cloud Infrastructure, notamment Oracle Autonomous Database et Oracle Autonomous Data Warehouse. Elle inclut des outils, bibliothèques et packages axés sur Python issus de l'open source, ainsi que la bibliothèque Oracle Accelerated Data Science (ADS), qui prend en charge le cycle de vie complet des modèles prédictifs. En savoir plus.
Google Cloud BigQuery
BigQuery est l'entrepôt de données managé de Google Cloud, à l'échelle du pétaoctet, qui permet d'exécuter des analyses quasi temps réel sur de très grands volumes. BigQuery ML vous permet de créer et d'exécuter des modèles de machine learning dans BigQuery via des requêtes SQL. BigQuery ML prend en charge la régression linéaire (prévisions), la régression logistique binaire et multiclasse (classification), le clustering K-means (segmentation), la factorisation de matrices (systèmes de recommandation), ainsi que des modèles de séries temporelles pour les prévisions. En savoir plus.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud est un service cloud public managé. Vous pouvez aussi déployer IBM Db2 Warehouse on-premise sur votre propre matériel ou en cloud privé. En tant qu'entrepôt de données, il propose notamment le traitement en mémoire et des tables en colonnes pour l'OLAP. Sa technologie Netezza offre un jeu robuste d'analytique, conçu pour amener efficacement la requête aux données. En savoir plus.
BlazingSQL
BlazingSQL est un moteur SQL accéléré par GPU, bâti sur l'écosystème RAPIDS. Il existe en open source et en service payant. RAPIDS, qui s'appuie sur CUDA et le format colonne Apache Arrow, est une suite de bibliothèques et d'API open source incubée par Nvidia. CuDF, composant de RAPIDS, est une bibliothèque DataFrame GPU proche de Pandas pour charger, joindre, agréger, filtrer et manipuler les données. En savoir plus.
Microsoft SQL Server Machine Learning Services
Machine Learning Services est une fonctionnalité de SQL Server qui permet d'exécuter des scripts Python et R avec des données relationnelles. Vous pouvez utiliser des packages et frameworks open source ainsi que les packages Microsoft pour R et Python, afin de réaliser des analyses prédictives et du machine learning. Les scripts s'exécutent dans la base, sans déplacer les données hors de SQL Server ni sur le réseau. Cet article présente les bases de SQL Server Machine Learning Services et comment démarrer.
SQL Server Machine Learning Services vous permet d'exécuter des scripts Python et R in-database. Vous pouvez préparer et nettoyer les données, réaliser l'ingénierie des variables, entraîner, évaluer et déployer des modèles de machine learning au sein même de la base. La fonctionnalité exécute vos scripts là où résident les données, éliminant les transferts sur le réseau vers un autre serveur.
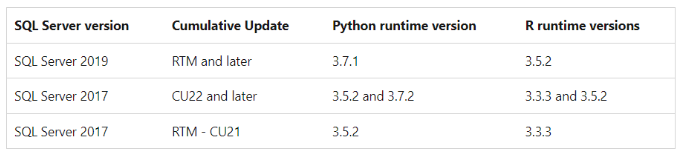
Versions de Python et R prises en charge
À ce jour, les versions suivantes de Python et R sont prises en charge par SQL Machine Learning Services.
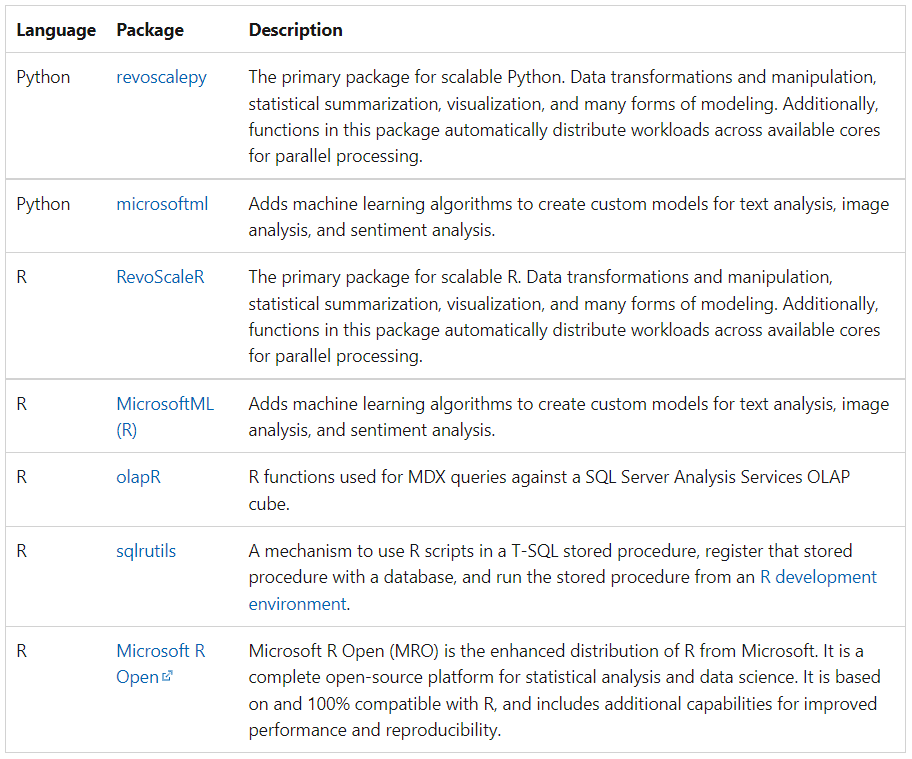
Bibliothèques Python et R installées par défaut
Vous pouvez utiliser n'importe quels packages et frameworks open source, mais les packages Python et R suivants sont installés par défaut :
PyCaret : une bibliothèque de ML open source et low-code
PyCaret est une bibliothèque de machine learning open source et low-code en Python qui automatise les flux de travail de ML. C'est un outil de bout en bout pour le machine learning et la gestion des modèles, qui accélère fortement les cycles d'expérimentation et améliore la productivité.
Comparée aux autres bibliothèques open source de machine learning, PyCaret est une alternative low-code qui remplace des centaines de lignes de code par quelques lignes seulement. Les expérimentations deviennent ainsi beaucoup plus rapides et efficaces. PyCaret est essentiellement un wrapper Python autour de plusieurs bibliothèques et frameworks de ML comme scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, et d'autres.
La conception et la simplicité de PyCaret s'inspirent de l'émergence des citizen data scientists, un terme popularisé par Gartner. Les citizen data scientists sont des utilisateurs avancés capables de mener des tâches analytiques simples à modérément complexes, qui nécessitaient auparavant plus d'expertise technique. Consultez ce lien pour en savoir plus sur PyCaret.
Dans la section suivante, nous allons installer Microsoft SQL Server et activer SQL Machine Learning Services. Nous activerons ensuite l'environnement Python, installerons PyCaret (bibliothèque de ML) et passerons à l'entraînement du modèle. Voyons comment procéder.
Démo de bout en bout : entraîner des modèles de ML dans SQL
Télécharger et installer SQL Server et Microsoft SSMS
Microsoft SQL Server est un système de gestion de base de données relationnelle (SGBDR) de Microsoft. En tant que serveur de base, il a pour fonction principale de stocker et restituer les données à la demande d'applications. Dans ce tutoriel, nous utiliserons SQL Server 2019 Developer pour entraîner un modèle de machine learning non supervisé via PyCaret.
Si vous avez déjà utilisé SQL Server, il est probable que vous l'ayez installé et que vous ayez accès à une base. Sinon, cliquez ici pour télécharger SQL Server 2019 Developer.
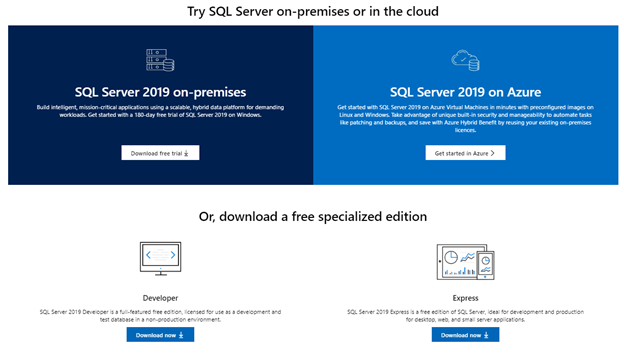
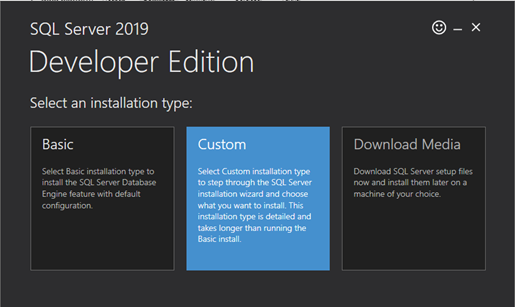
Cliquez sur le bouton « Download now » sous l'édition Developer et ouvrez le fichier d'installation. Choisissez le type d'installation « Custom ».
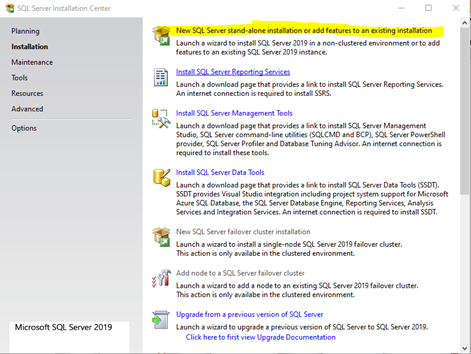
Choisissez « New SQL Server stand-alone installation ».
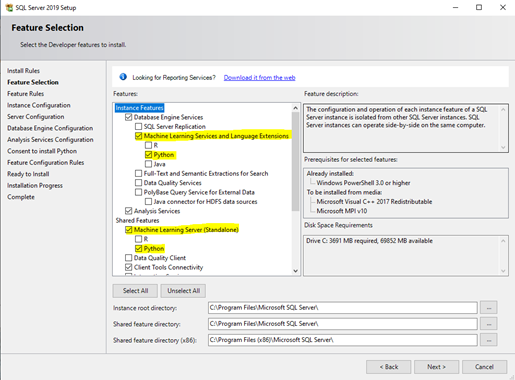
Dans « Instance Features », sélectionnez les fonctionnalités, notamment « Python » sous Machine Learning Services and Language Extensions et Machine Learning Server.
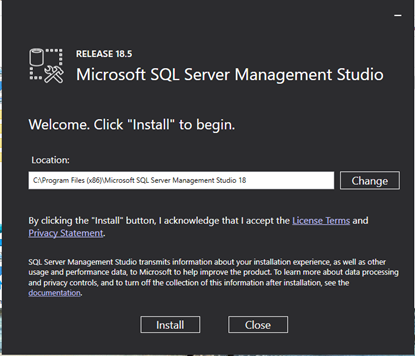
Une fois SQL Server installé, nous allons travailler avec un environnement de développement (IDE). Plusieurs options existent ; dans ce tutoriel, nous utiliserons Microsoft SQL Server Management Studio. Téléchargez l'installateur et suivez les instructions. L'installation de SSMS est simple.
Créer une nouvelle base de données et importer un CSV
Une fois SQL Server et SSMS installés, créons une nouvelle base et importons un fichier CSV pour travailler dessus. Dans le panneau Object Explorer, faites un clic droit sur Databases et choisissez « New Database ». Saisissez le nom de la base et les autres informations. Cela peut prendre quelques minutes.
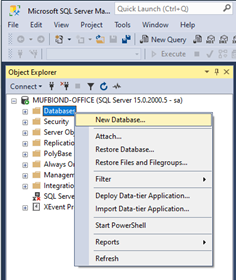
Une fois la base créée, importons un fichier CSV que nous utiliserons dans les étapes suivantes. Vous pouvez télécharger le fichier d'exemple sur votre ordinateur puis suivre les instructions.
Clic droit sur « Tables » → New → Table. Donnez-lui le nom de votre choix. Dans cet exemple, nous l'appellerons « jewelry ».
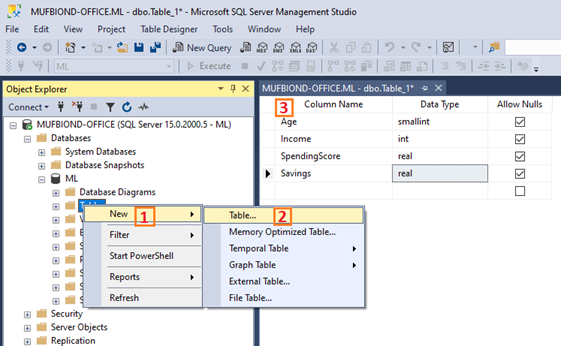
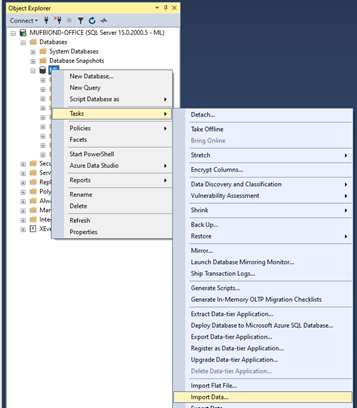
La table étant créée, nous pouvons l'alimenter. Importons le fichier CSV dans cette table. Faites un clic droit sur la base et sélectionnez Tasks -> Import Data
Pour la source des données, sélectionnez « Flat File Source », puis utilisez le bouton Browse pour choisir le CSV. Prenez le temps de configurer l'import avant de cliquer sur Next.
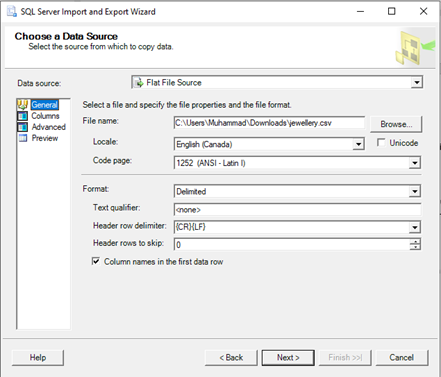
Cliquez sur Next et renseignez les détails de la base (nom du serveur, identifiant et mot de passe), puis suivez les écrans suivants. Enfin, cliquez sur Finish pour terminer l'import.
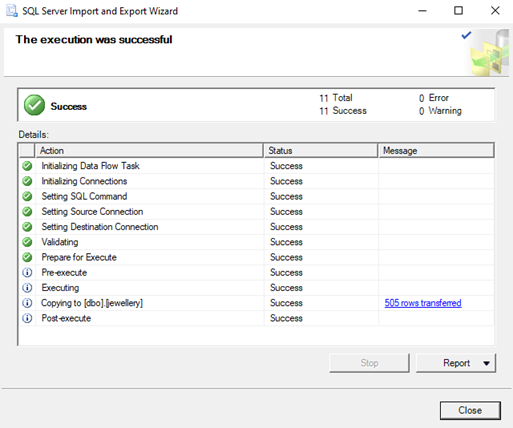
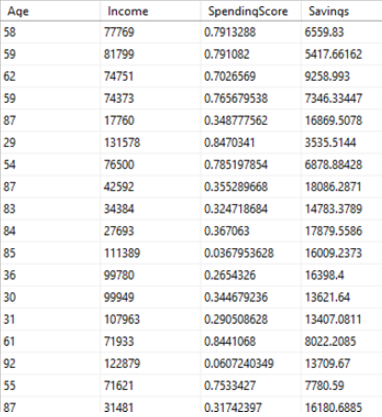
Nous avons maintenant une table « jewelry » avec les données importées.
Configurer l'environnement Python
Avant d'entraîner des modèles dans SQL, nous devons configurer l'exécution de scripts Python dans SQL. Nous exécuterons Python « à l'intérieur » de SQL Server via la procédure stockée système sp_execute_external_script. Pour commencer, cliquez sur « New Query » et exécutez le code suivant pour activer l'exécution de scripts externes :
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Redémarrez le serveur SQL avant de poursuivre.
Définissons maintenant le langage et vérifions le chemin d'installation. Avec Microsoft SQL Machine Learning Service, vous avez deux options : R ou Python. Dans cet exemple, nous utiliserons Python, et plus précisément PyCaret (une bibliothèque Python de machine learning), pour entraîner un modèle de clustering non supervisé sur le jeu de données « jewelry ».
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’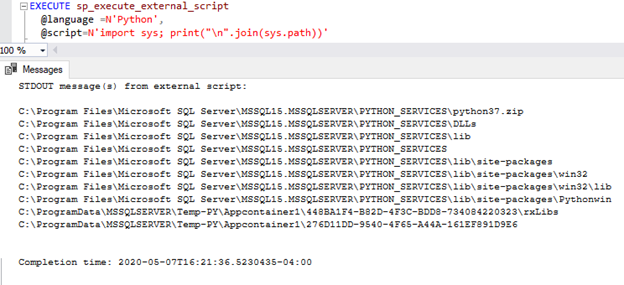
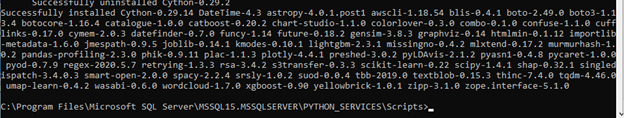
La dernière étape avant l'entraînement consiste à installer la bibliothèque PyCaret. Pour installer PyCaret, ouvrez un invite de commandes et placez-vous dans le répertoire des packages Python utilisé par l'installation de SQL Server (voir le chemin ci-dessus). Exécutez la commande suivante dans l'invite :
pip.exe install pycaret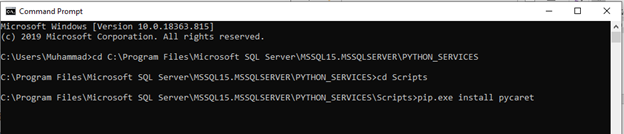
L'installation peut prendre 10 à 15 minutes. Une fois terminée, vous devriez voir ceci :
Retournez maintenant dans Microsoft SSMS.
Entraîner un modèle de clustering non supervisé
Le clustering est une technique de machine learning qui regroupe des points de données aux caractéristiques similaires. Ces regroupements sont utiles pour explorer les données, identifier des motifs et analyser des sous-ensembles. Quelques cas d'usage fréquents :
- Segmentation clients à des fins marketing.
- Analyse des comportements d'achat pour promotions et remises.
- Identification de géo-clusters lors d'une épidémie comme la COVID-19.
Nous disposons de quatre points de données par client, présentés ainsi :
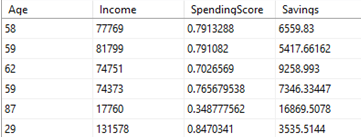
Notre objectif est d'entraîner un modèle KMeans sur ce jeu de données et de créer une nouvelle colonne « Cluster » représentant le groupe de clients auquel chaque enregistrement appartient.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Sortie :
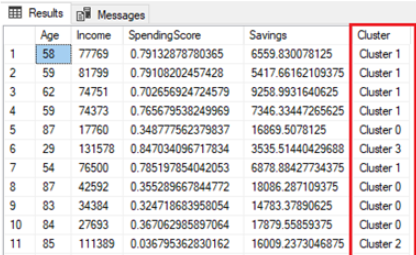
Vous voyez comme c'est simple. En une seule ligne `pc.get_clusters(...)`, nous avons prétraité les données, entraîné un modèle KMeans non supervisé et utilisé le modèle entraîné pour générer les labels de cluster — sans quitter l'environnement SQL Server. À l'instar du clustering, PyCaret prend aussi en charge la détection d'anomalies non supervisée avec la commande magique `pc.get_anomaly`. Vous pouvez également entraîner des modèles supervisés (classification ou régression), stocker le modèle dans une procédure SQL et l'utiliser ensuite pour l'inférence. Tout cela, directement depuis votre base de données.
Conclusion
Qu'implique le machine learning dans la base pour votre entreprise ? Moins d'étapes à réaliser pour un ML plus efficace, plus rapide et plus simple à opérationnaliser. L'entraînement de modèles dans la base minimise les mouvements de données, ce qui fait gagner du temps et réduit les coûts. Ce n'est toutefois pas une solution miracle : son adoption dépendra toujours du cas d'usage. Nous espérons que ce tutoriel vous aura donné un nouvel éclairage sur les possibilités du machine learning en environnement entreprise.
Si vous souhaitez approfondir la manière d'utiliser Python et SQL ensemble pour améliorer vos analyses et votre efficacité, nous vous recommandons le cours Introduction to Databases in Python. Vous y apprendrez les bases de l'utilisation de SQL avec Python. C'est utile, car les bases de données sont omniprésentes et les data scientists, analystes et ingénieurs interagissent avec elles en permanence. La boîte à outils SQLAlchemy offre une manière accessible et intuitive d'interroger, de construire et d'écrire vers des bases essentielles comme SQLite, MySQL et PostgreSQL.