Mục lục
- Giới thiệu
- Tình huống sử dụng: Huấn luyện mô hình Machine Learning ngay trong cơ sở dữ liệu
- Các cơ sở dữ liệu hỗ trợ Machine Learning trong cơ sở dữ liệu
- Dịch vụ Machine Learning của Microsoft SQL Server
- PyCaret: Thư viện Machine Learning mã nguồn mở, low-code bằng Python
- Demo end-to-end: Huấn luyện mô hình ML trong SQL
- Tải xuống và cài đặt SQL Server
- Tạo cơ sở dữ liệu mới và nhập tệp CSV
- Cấu hình môi trường Python
- Huấn luyện mô hình phân cụm không giám sát
- Kết luận
Giới thiệu
Python và R là các ngôn ngữ lập trình được đông đảo nhà khoa học dữ liệu, kỹ sư dữ liệu và kỹ sư máy học sử dụng. Khả năng chạy mã Python như một script SQL mở ra vô số khả năng cho các thao tác dữ liệu, bao gồm các năng lực máy học ngay trong cơ sở dữ liệu khi xử lý lượng dữ liệu lớn. Các công cụ quen thuộc để thực nghiệm máy học là môi trường phát triển tích hợp (IDE) như VS Code hoặc Notebooks mang tính tương tác. Tuy nhiên, khi kích thước dữ liệu rất lớn hoặc cần đưa mô hình ML vào sản xuất, các công cụ này có thể bộc lộ hạn chế. Nhu cầu cấp thiết là có thể lập trình và huấn luyện mô hình ngay tại nơi dữ liệu đang lưu trữ; trong hướng dẫn này, bạn sẽ tìm hiểu một số cách để thực hiện điều đó.
Tình huống sử dụng: Huấn luyện mô hình Machine Learning ngay trong cơ sở dữ liệu
Nhiều cơ sở dữ liệu hiện nay đi kèm các dịch vụ máy học tích hợp sẵn (xem phần tiếp theo). Điều này có nghĩa là bạn không cần phải tìm mua một nền tảng khoa học dữ liệu riêng, vì có thể dùng các năng lực máy học trong cơ sở dữ liệu để huấn luyện và triển khai mô hình ngay trong đó. Một quy trình máy học điển hình trông như sau:
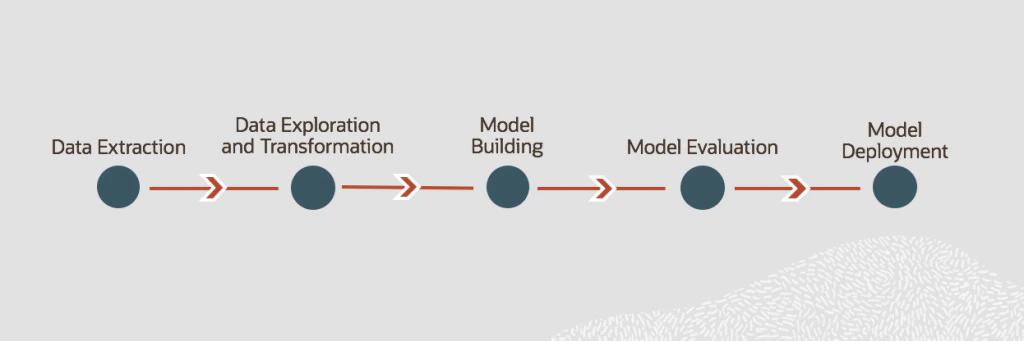
Khi bạn huấn luyện mô hình máy học ngay trong cơ sở dữ liệu, bạn không cần một quy trình ETL độc lập vì dữ liệu đã nằm sẵn trong cơ sở dữ liệu. Điều này tiết kiệm rất nhiều thời gian. Ở các bước tiếp theo như Xây dựng mô hình và Triển khai, bạn cũng không cần chuyển sang nền tảng máy học bên ngoài vì sẽ dùng các khả năng trong cơ sở dữ liệu để huấn luyện và triển khai giải pháp ML. Theo Oracle Big Data Blog, có ba lợi ích như sau:
Tổng thể quy trình được đơn giản hóa
Đôi khi chỉ riêng việc chuyển dữ liệu sang một nền tảng khác nơi có các thuật toán đã mất hàng giờ hoặc hàng ngày. Dù quy trình này dễ gây phức tạp như rủi ro mất dữ liệu, nó vẫn là tiêu chuẩn ở nhiều công ty khác.
Tiết kiệm thời gian/chi phí
Hợp lý hơn là chuyển các thuật toán đến gần cơ sở dữ liệu thay vì chuyển dữ liệu đến thuật toán. Do đó, kết hợp máy học với cơ sở dữ liệu thực tiễn hơn không chỉ ở sự đơn giản mà còn ở tốc độ. Bạn tiết kiệm thời gian và nhiều công sức, cuối cùng tác động tích cực đến chi phí.
Nhận kết quả (giá trị) nhanh hơn
Thực tế là dù có thể mất nhiều thời gian và công sức để xây dựng mô hình máy học, huấn luyện, lấy kết quả và phân tích, doanh nghiệp thường chỉ thực sự quan tâm khi mô hình được đưa vào sản xuất để các bộ phận (Tài chính, Nhân sự, Chuỗi cung ứng, Marketing, Bán hàng, v.v.) có thể sử dụng kết quả.
Vì việc triển khai và tích hợp vào các ứng dụng như dashboard BI, tổng đài, ATM, website và thiết bị di động có thể là thách thức lớn với IT, quá trình vận hành hóa có thể đơn giản hoặc rất phức tạp.
Nếu mô hình của bạn luôn ở trong cơ sở dữ liệu, khối lượng công việc triển khai phức tạp sẽ giảm đáng kể. Quy trình trở nên dễ dàng hơn và kết quả thu được nhanh hơn nhiều.
Các cơ sở dữ liệu hỗ trợ Machine Learning trong cơ sở dữ liệu
Microsoft SQL Server
Dịch vụ Machine Learning của Microsoft SQL Server hỗ trợ R, Python, Java, lệnh PREDICT T-SQL và thủ tục lưu trữ rx_Predict trong SQL Server RDBMS, và SparkML trong SQL Server Big Data Clusters. Với R và Python, Microsoft bao gồm một số gói và thư viện cho máy học. Bạn có thể lưu trữ mô hình đã huấn luyện trong cơ sở dữ liệu hoặc bên ngoài. Azure SQL Managed Instance hỗ trợ Machine Learning Services cho Python và R ở dạng bản xem trước. Tìm hiểu thêm.
Amazon Redshift
Amazon Redshift là dịch vụ kho dữ liệu được quản lý ở quy mô petabyte, được thiết kế để đơn giản và tiết kiệm chi phí khi phân tích toàn bộ dữ liệu của bạn bằng các công cụ BI hiện có. Nó tối ưu cho bộ dữ liệu từ vài trăm gigabyte đến một petabyte hoặc hơn, và có chi phí dưới $1,000 mỗi terabyte mỗi năm. Tìm hiểu thêm.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science là nền tảng được quản lý và không máy chủ (serverless) dành cho các nhóm khoa học dữ liệu xây dựng, huấn luyện và quản lý mô hình máy học bằng Oracle Cloud Infrastructure, bao gồm Oracle Autonomous Database và Oracle Autonomous Data Warehouse. Nền tảng bao gồm các công cụ, thư viện và gói tập trung vào Python do cộng đồng nguồn mở phát triển và Thư viện Oracle Accelerated Data Science (ADS), hỗ trợ vòng đời end-to-end của mô hình dự đoán. Tìm hiểu thêm.
Google Cloud BigQuery
BigQuery là kho dữ liệu được quản lý ở quy mô petabyte của Google Cloud, cho phép bạn chạy phân tích trên lượng dữ liệu khổng lồ gần như theo thời gian thực. BigQuery ML cho phép tạo và thực thi các mô hình máy học trong BigQuery bằng truy vấn SQL. BigQuery ML hỗ trợ hồi quy tuyến tính cho dự báo; hồi quy logistic nhị phân và đa lớp cho phân loại; phân cụm K-means để phân đoạn dữ liệu; phân rã ma trận để xây dựng hệ gợi ý sản phẩm và chuỗi thời gian để dự báo theo chuỗi thời gian. Tìm hiểu thêm.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud là dịch vụ đám mây công cộng được quản lý. Bạn cũng có thể thiết lập IBM Db2 Warehouse tại chỗ với phần cứng riêng hoặc trên đám mây riêng. Là một kho dữ liệu, nó bao gồm các tính năng như xử lý dữ liệu trong bộ nhớ và bảng dạng cột cho xử lý phân tích trực tuyến. Công nghệ Netezza của nó cung cấp bộ phân tích mạnh mẽ được thiết kế để đưa truy vấn đến dữ liệu một cách hiệu quả. Tìm hiểu thêm.
BlazingSQL
BlazingSQL là một công cụ SQL tăng tốc bằng GPU xây dựng trên hệ sinh thái RAPIDS; tồn tại như dự án nguồn mở và dịch vụ trả phí. RAPIDS sử dụng CUDA và dựa trên định dạng bộ nhớ dạng cột Apache Arrow, là bộ thư viện và API phần mềm nguồn mở do Nvidia ươm tạo - CuDF, một phần của RAPIDS, là thư viện DataFrame GPU giống Pandas dùng để tải, nối, tổng hợp, lọc và thao tác dữ liệu. Tìm hiểu thêm.
Dịch vụ Machine Learning của Microsoft SQL Server
Machine Learning Services là một tính năng trong SQL Server cho phép bạn chạy các script Python và R với dữ liệu quan hệ. Bạn có thể sử dụng các gói và khung nguồn mở, cũng như các gói Python và R của Microsoft, cho phân tích dự đoán và máy học. Các script được thực thi ngay trong cơ sở dữ liệu mà không cần chuyển dữ liệu ra ngoài SQL Server hoặc qua mạng. Bài viết này giải thích những điều cơ bản về SQL Server Machine Learning Services và cách bắt đầu.
SQL Server Machine Learning Services cho phép bạn thực thi các script Python và R trong cơ sở dữ liệu. Bạn có thể dùng nó để chuẩn bị và làm sạch dữ liệu, thực hiện kỹ thuật đặc trưng, và huấn luyện, đánh giá, triển khai mô hình máy học ngay trong cơ sở dữ liệu. Tính năng này chạy script tại nơi dữ liệu lưu trữ, loại bỏ nhu cầu chuyển dữ liệu qua mạng sang máy chủ khác.
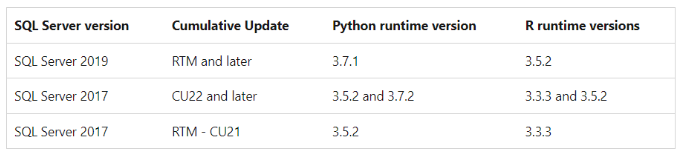
Các phiên bản Python và R được hỗ trợ
Hiện tại, các phiên bản Python và R sau được hỗ trợ trong SQL Machine Learning Services.
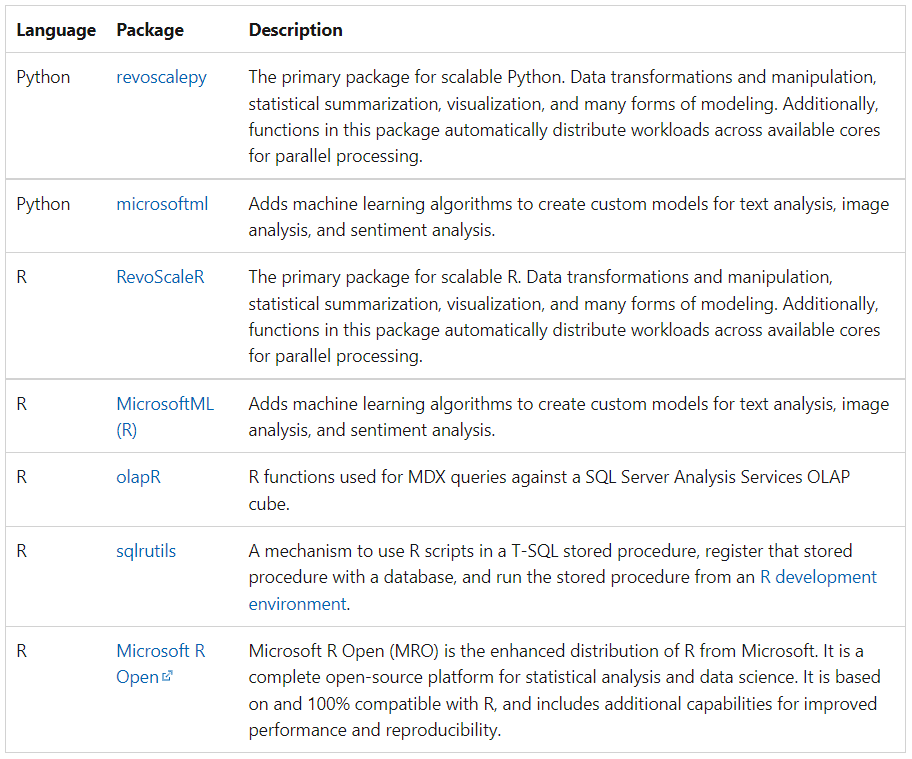
Các thư viện Python và R cài sẵn mặc định
Bạn có thể dùng bất kỳ gói và framework nguồn mở nào bạn thích, nhưng các gói Python và R sau được cài đặt sẵn theo mặc định:
PyCaret: Thư viện ML mã nguồn mở, low-code
PyCaret là thư viện máy học low-code mã nguồn mở bằng Python tự động hóa các quy trình máy học. Đây là công cụ end-to-end cho máy học và quản lý mô hình, giúp tăng tốc chu kỳ thực nghiệm và nâng cao năng suất.
So với các thư viện máy học nguồn mở khác, PyCaret là thư viện low-code thay thế có thể rút gọn hàng trăm dòng mã xuống chỉ vài dòng. Điều này giúp thí nghiệm nhanh và hiệu quả vượt trội. Về bản chất, PyCaret là một lớp bao bọc Python quanh nhiều thư viện và framework máy học như scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray và một vài thư viện khác.
Thiết kế và sự đơn giản của PyCaret lấy cảm hứng từ vai trò đang nổi lên của citizen data scientist, thuật ngữ do Gartner đề xuất. Citizen data scientist là những người dùng thành thạo có thể thực hiện các tác vụ phân tích đơn giản đến mức trung bình vốn trước đây đòi hỏi chuyên môn kỹ thuật cao hơn. Xem liên kết này để tìm hiểu thêm về PyCaret.
Trong phần tiếp theo, chúng ta sẽ cài đặt Microsoft SQL Server và bật SQL Machine Learning Services. Sau đó, chúng ta sẽ kích hoạt môi trường Python, cài đặt PyCaret (thư viện ML) và bắt đầu huấn luyện mô hình. Hãy cùng xem cách làm.
Demo end-to-end: Huấn luyện mô hình ML trong SQL
Tải xuống và cài đặt SQL Server và Microsoft SSMS
Microsoft SQL Server là hệ quản trị cơ sở dữ liệu quan hệ của Microsoft. Với vai trò máy chủ cơ sở dữ liệu, nó thực hiện chức năng chính là lưu trữ và truy xuất dữ liệu theo yêu cầu từ các ứng dụng khác nhau. Trong hướng dẫn này, chúng ta sẽ dùng SQL Server 2019 Developer để huấn luyện một mô hình máy học không giám sát thông qua PyCaret.
Nếu bạn đã dùng SQL Server trước đây, có thể bạn đã cài đặt và có quyền truy cập cơ sở dữ liệu. Nếu chưa, bấm vào đây để tải SQL Server 2019 bản Developer.
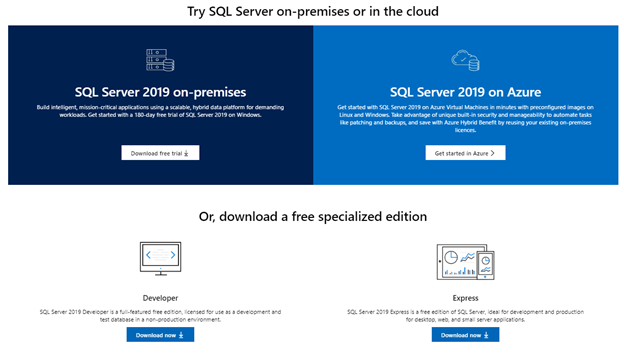
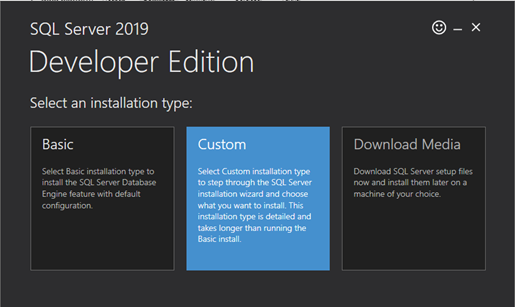
Bấm nút “Download now” bên dưới bản Developer và mở tệp cài đặt. Chọn kiểu cài đặt “Custom”.
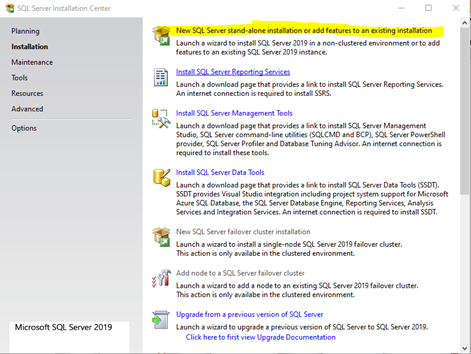
Chọn New SQL Server stand-alone installation.
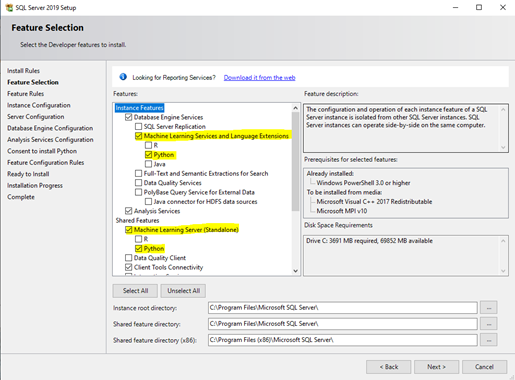
Trong tùy chọn Instance Features, chọn các tính năng bao gồm “Python” dưới Machine Learning Services and Language Extensions và Machine Learning Server.
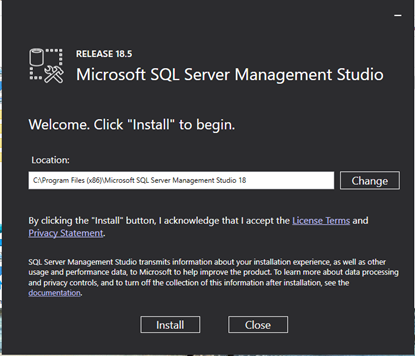
Sau khi cài đặt SQL Server thành công, chúng ta cần làm việc với một Môi trường Phát triển Tích hợp (IDE). Có nhiều lựa chọn; tuy nhiên, trong hướng dẫn này tôi sẽ dùng Microsoft SQL Server Management Studio. Tải trình cài đặt và làm theo hướng dẫn. Việc cài đặt SSMS khá đơn giản.
Tạo cơ sở dữ liệu mới và nhập CSV
Sau khi cài đặt SQL Server và SSMS, chúng ta sẽ tạo một cơ sở dữ liệu mới và nhập một tệp CSV để làm việc. Trong bảng Object Explorer, nhấp chuột phải vào Databases và chọn “New Database”. Nhập tên cơ sở dữ liệu và các thông tin khác. Có thể mất vài phút.
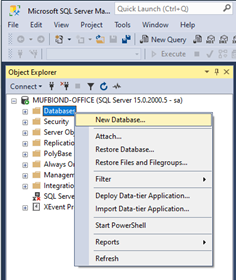
Khi cơ sở dữ liệu đã được tạo thành công, hãy nhập tệp CSV mà chúng ta sẽ dùng ở các bước tiếp theo. Bạn có thể tải tệp mẫu về máy và làm theo hướng dẫn.
Nhấp chuột phải vào “Tables” → New → Table. Bạn có thể đặt tên tùy ý. Trong ví dụ này, tôi đặt tên bảng là “jewelry”.
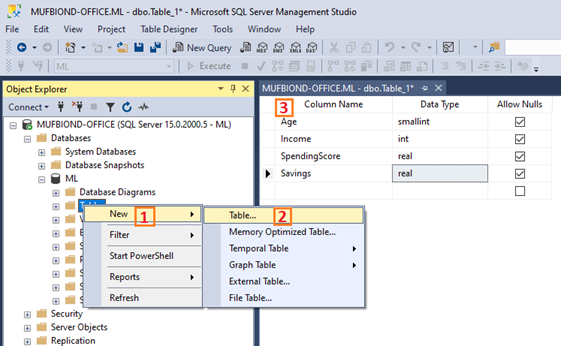
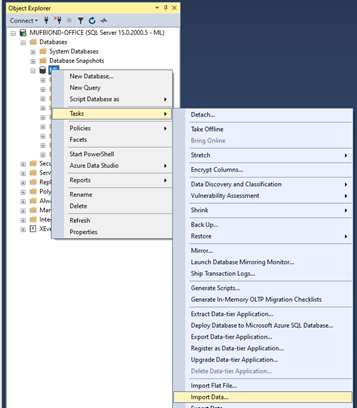
Sau khi bảng đã được tạo, chúng ta sẽ nạp dữ liệu cho nó. Hãy nhập tệp CSV vào bảng này. Nhấp chuột phải vào cơ sở dữ liệu và chọn Tasks -> Import Data
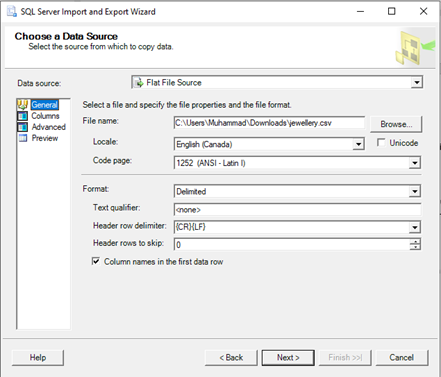
Ở Data Source, chọn “Flat File Source”, rồi dùng nút Browse để chọn tệp CSV. Dành thời gian cấu hình việc nhập dữ liệu trước khi bấm nút Next.
Bấm Next và nhập thông tin cơ sở dữ liệu (tên máy chủ, tên người dùng và mật khẩu) rồi làm theo hướng dẫn ở các màn hình tiếp theo. Cuối cùng, bấm nút Finish để hoàn tất việc nhập.
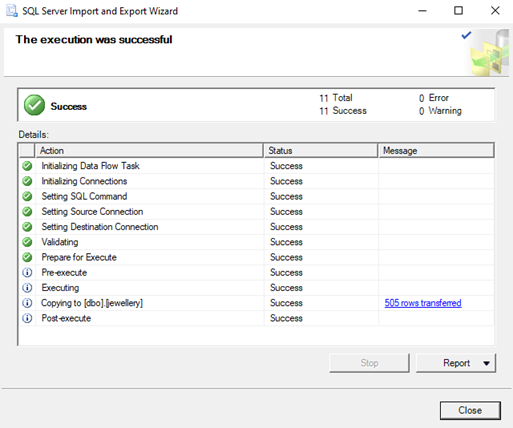
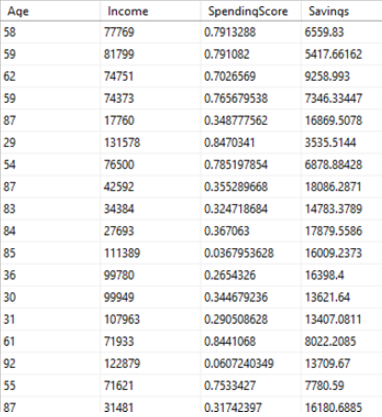
Bây giờ, chúng ta đã có bảng “jewelry” với dữ liệu đã nhập.
Cấu hình môi trường Python
Trước khi bắt đầu huấn luyện mô hình máy học trong SQL, chúng ta cần cấu hình script Python trong SQL. Chúng ta sẽ chạy Python “bên trong” SQL Server bằng cách dùng thủ tục hệ thống sp_execute_external_script. Để bắt đầu, nhấn “New Query” và thực thi đoạn mã sau để bật việc dùng thủ tục cho thực thi script từ xa:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Khởi động lại SQL Server trước khi tiếp tục.
Bây giờ, hãy đặt ngôn ngữ và kiểm tra đường dẫn cài đặt. Với Microsoft SQL Machine Learning Service, bạn có hai lựa chọn: R hoặc Python. Trong ví dụ này, chúng ta sẽ dùng Python, cụ thể là PyCaret (một thư viện Python cho máy học), để huấn luyện mô hình phân cụm không giám sát trên bộ dữ liệu “jewelry”.
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’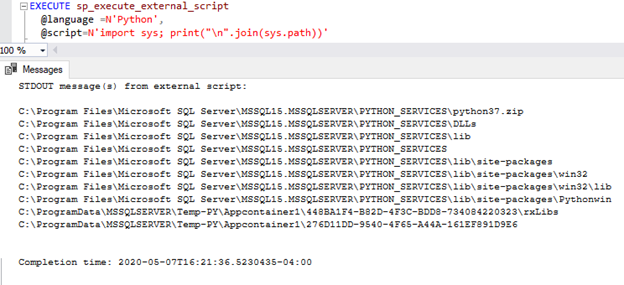
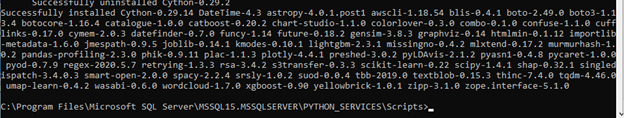
Bước cuối cùng trước khi bắt đầu huấn luyện mô hình là cài đặt thư viện PyCaret. Để cài đặt gói PyCaret, mở Command Prompt và điều hướng tới vị trí các gói Python nơi SQL Server được cài đặt (xem đường dẫn ở trên). Chạy lệnh sau trong Command Prompt.
pip.exe install pycaret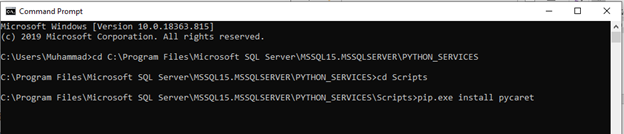
Việc cài đặt có thể mất 10–15 phút. Sau khi xong, nó sẽ trông như thế này:
Bây giờ, quay lại Microsoft SSMS.
Huấn luyện mô hình phân cụm không giám sát
Phân cụm là kỹ thuật máy học nhóm các điểm dữ liệu có đặc điểm tương đồng. Các nhóm này hữu ích cho việc khám phá dữ liệu, nhận diện mẫu và phân tích các tập con dữ liệu. Một số tình huống sử dụng phổ biến trong kinh doanh cho phân cụm gồm:
- Phân khúc khách hàng cho mục đích marketing.
- Phân tích hành vi mua sắm của khách hàng để phục vụ khuyến mãi và giảm giá.
- Nhận diện các cụm địa lý trong đợt bùng phát dịch như COVID-19.
Chúng ta có bốn điểm dữ liệu cho mỗi khách hàng như sau:
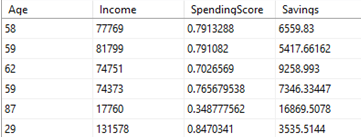
Mục tiêu của chúng ta là huấn luyện mô hình phân cụm KMeans trên bộ dữ liệu này và tạo một cột mới “Cluster” đại diện cho nhóm khách hàng thuộc cùng một cụm.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Kết quả:
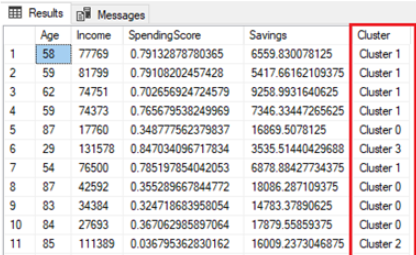
Hãy để ý xem mọi thứ đơn giản thế nào. Chỉ với một dòng `pc.get_clusters(...)`, chúng ta đã tiền xử lý dữ liệu, huấn luyện mô hình KMeans không giám sát và dùng mô hình đã huấn luyện để tạo nhãn cụm – tất cả đều thực hiện ngay trong môi trường SQL Server. Tương tự phân cụm, PyCaret cũng hỗ trợ phát hiện bất thường không giám sát với lệnh magic `pc.get_anomaly`. Bạn cũng có thể huấn luyện các mô hình máy học có giám sát (Phân loại hoặc Hồi quy), lưu mô hình trong thủ tục SQL và dùng sau để suy luận. Tất cả có thể thực hiện trực tiếp từ cơ sở dữ liệu của bạn.
Kết luận
Máy học trong cơ sở dữ liệu mang lại điều gì cho doanh nghiệp của bạn? Điều đó có nghĩa là bạn có thể tối giản số bước cần thực hiện để việc triển khai máy học hiệu quả hơn, nhanh hơn và dễ vận hành hơn. Huấn luyện mô hình máy học ngay trong cơ sở dữ liệu giảm thiểu việc di chuyển dữ liệu, giúp tiết kiệm thời gian và chi phí. Tuy nhiên, đây không phải là “thuốc tiên”. Việc áp dụng hay không luôn phụ thuộc vào trường hợp sử dụng. Hy vọng hướng dẫn này đã mang đến cho bạn góc nhìn mới về khả năng của máy học trong môi trường doanh nghiệp.
Nếu bạn muốn tìm hiểu thêm về cách Python và SQL có thể kết hợp để cải thiện phân tích dữ liệu và hiệu suất làm việc, tôi khuyến nghị khóa học Introduction to Databases in Python. Trong khóa học này, bạn sẽ học những điều cơ bản về cách dùng SQL với Python. Điều này hữu ích vì cơ sở dữ liệu ở khắp nơi và các nhà khoa học dữ liệu, nhà phân tích, kỹ sư phải tương tác với chúng liên tục. Bộ công cụ SQL cho Python là SQLAlchemy cung cấp cách tiếp cận dễ hiểu và trực quan để truy vấn, xây dựng và ghi vào các cơ sở dữ liệu thiết yếu, bao gồm SQLite, MySQL và PostgreSQL.
