Índice
- Introdução
- Caso de uso: treinando modelos de machine learning no banco de dados
- Bancos de dados com suporte a machine learning in-database
- Microsoft SQL Server Machine Learning Services
- PyCaret: uma biblioteca de machine learning em Python, open source e low-code
- Demo completa: treinando modelos de ML em SQL
- Baixar e instalar o SQL Server
- Criar um novo banco de dados e importar um arquivo CSV
- Configurar o ambiente Python
- Treinar um modelo de clusterização não supervisionado
- Conclusão
Introdução
Python e R são linguagens de programação amplamente usadas por cientistas de dados, engenheiros de dados e engenheiros de machine learning. Conseguir executar código Python como script SQL abre inúmeras possibilidades para operações de dados, incluindo recursos de machine learning no próprio banco (in-database) quando se lida com grandes volumes de dados. As ferramentas preferidas para experimentos de machine learning são ambientes de desenvolvimento integrados (IDEs), como o VS Code, ou Notebooks, que são interativos por natureza. Porém, essas ferramentas podem apresentar limitações quando o volume de dados fica muito grande ou quando o modelo de ML precisa ir para produção. Existe uma necessidade clara de programar e treinar modelos onde os dados residem; neste tutorial, você vai conhecer várias formas de fazer isso.
Caso de uso: treinando modelos de machine learning no banco de dados
Muitos bancos de dados hoje já vêm com serviços de machine learning integrados (veja a próxima seção). Isso significa que você não precisa adquirir uma plataforma de data science: é possível usar recursos de machine learning in-database para treinar e fazer o deploy dos seus modelos no próprio banco. Um fluxo típico de machine learning se parece com isto:
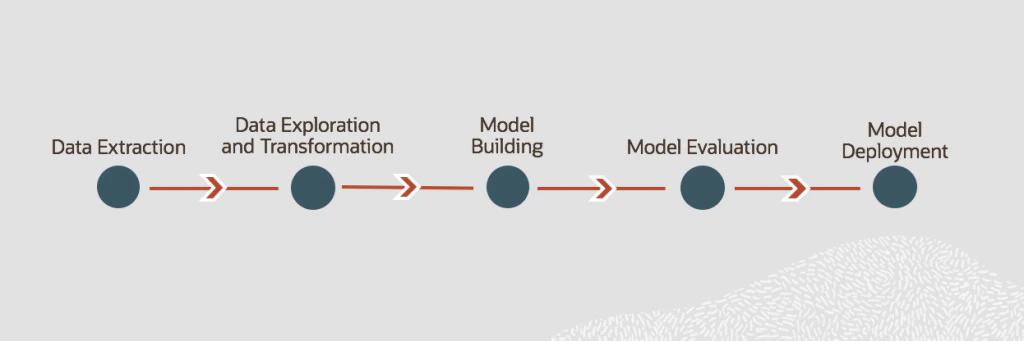
Ao treinar um modelo de machine learning dentro do banco de dados, você não precisa de um processo ETL separado, já que os dados já estão lá. Isso economiza bastante tempo. Para as etapas seguintes, como construção e deploy do modelo, você também não precisa migrar para uma plataforma externa de machine learning, pois vai usar as capacidades in-database para treinar e colocar em produção uma solução de ML. Segundo o Oracle Big Data Blog, há três benefícios principais nisso:
O processo geral fica mais simples
Muitas vezes, leva horas ou dias só para mover os dados para outra plataforma onde os algoritmos estão. Apesar de esse processo introduzir complicações, como possível perda de dados, ele ainda é padrão em muitas empresas.
Você economiza tempo e custos
É mais lógico levar os algoritmos até o banco de dados do que mover os dados até os algoritmos. Assim, combinar machine learning com o banco é mais prático não só pela simplicidade, mas também pela velocidade. Você economiza tempo e esforço, o que impacta diretamente no resultado final reduzindo custos.
Você obtém resultados (valor) mais rápido
Embora possa exigir tempo e esforço para construir um modelo de machine learning, treiná-lo, obter e analisar resultados, as áreas de negócio geralmente só se interessam por ML quando o modelo está em produção e as áreas responsáveis (Finanças, RH, Supply Chain, Marketing, Vendas etc.) podem usar os resultados.
Como o deploy e a integração em aplicações como painéis de BI, call centers, caixas eletrônicos, sites e dispositivos móveis podem ser um grande desafio para TI, a operacionalização pode ser simples ou muito complexa.
Se o seu modelo já está no banco desde o início, a quantidade de trabalho complexo de deploy cai bastante. Isso facilita o processo e acelera a geração de resultados.
Bancos de dados com suporte a machine learning in-database
Microsoft SQL Server
O Microsoft SQL Server Machine Learning Services oferece suporte a R, Python, Java, ao comando PREDICT em T-SQL e ao procedimento armazenado rx_Predict no SQL Server RDBMS, além do SparkML em SQL Server Big Data Clusters. Em R e Python, a Microsoft inclui diversos pacotes e bibliotecas para machine learning. Você pode armazenar seus modelos treinados no banco ou externamente. O Azure SQL Managed Instance oferece suporte prévio (preview) ao Machine Learning Services para Python e R. Saiba mais.
Amazon Redshift
O Amazon Redshift é um data warehouse gerenciado em escala de petabytes, projetado para simplificar e baratear a análise de todos os seus dados usando suas ferramentas atuais de business intelligence. Ele é otimizado para conjuntos de dados de algumas centenas de gigabytes até um petabyte ou mais e custa menos de US$ 1.000 por terabyte ao ano. Saiba mais.
Oracle Database
O Oracle Cloud Infrastructure (OCI) Data Science é uma plataforma gerenciada e serverless para times de data science construírem, treinarem e gerenciarem modelos de machine learning usando Oracle Cloud Infrastructure, incluindo o Oracle Autonomous Database e o Oracle Autonomous Data Warehouse. Inclui ferramentas, bibliotecas e pacotes centrados em Python desenvolvidos pela comunidade open source e a Oracle Accelerated Data Science (ADS) Library, que dá suporte ao ciclo de vida completo de modelos preditivos. Saiba mais.
Google Cloud BigQuery
O BigQuery é o data warehouse gerenciado do Google Cloud, em escala de petabytes, que permite executar análises sobre enormes volumes de dados quase em tempo real. O BigQuery ML permite criar e executar modelos de machine learning no BigQuery usando consultas SQL. O BigQuery ML dá suporte a regressão linear para previsão; regressão logística binária e multiclasse para classificação; clusterização K-means para segmentação de dados; fatoração de matrizes para sistemas de recomendação de produtos e séries temporais para previsões de time series. Saiba mais.
IBM Db2 Warehouse
O IBM Db2 Warehouse on Cloud é um serviço de nuvem pública gerenciado. Você também pode configurar o IBM Db2 Warehouse on-premises, com seu próprio hardware ou em nuvem privada. Como data warehouse, inclui recursos como processamento de dados em memória e tabelas colunares para processamento analítico online. Sua tecnologia Netezza oferece um conjunto robusto de análises projetadas para levar a consulta até o dado de forma eficiente. Saiba mais.
BlazingSQL
O BlazingSQL é um mecanismo de SQL acelerado por GPU, construído sobre o ecossistema RAPIDS; existe como projeto open source e como serviço pago. O RAPIDS, que usa CUDA e é baseado no formato de memória colunar Apache Arrow, é um conjunto de bibliotecas e APIs open source incubado pela Nvidia. O CuDF, parte do RAPIDS, é uma biblioteca de DataFrame em GPU, semelhante ao Pandas, para carregar, juntar, agregar, filtrar e manipular dados em geral. Saiba mais.
Microsoft SQL Server Machine Learning Services
O Machine Learning Services é um recurso do SQL Server que permite executar scripts em Python e R com dados relacionais. Você pode usar pacotes e frameworks open source, além dos pacotes de Python e R da Microsoft, para análises preditivas e machine learning. Os scripts são executados dentro do banco de dados, sem mover dados para fora do SQL Server ou pela rede. Este artigo explica o básico do SQL Server Machine Learning Services e como começar.
O SQL Server Machine Learning Services permite executar scripts em Python e R no próprio banco. Você pode usá-lo para preparar e limpar dados, fazer engenharia de atributos e treinar, avaliar e implantar modelos de machine learning dentro do banco de dados. O recurso executa seus scripts onde os dados residem e elimina a necessidade de transferi-los pela rede para outro servidor.
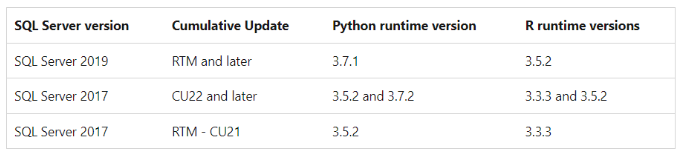
Versões de Python e R compatíveis
No momento, as seguintes versões de Python e R são compatíveis com o SQL Machine Learning Services.
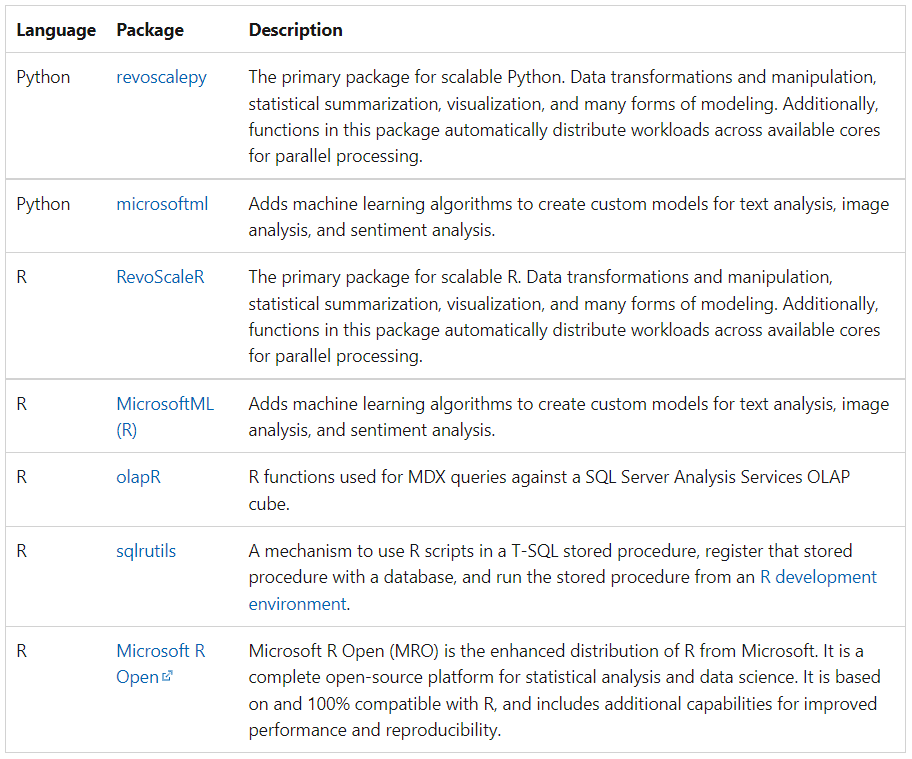
Bibliotecas de Python e R instaladas por padrão
Você pode usar quaisquer pacotes e frameworks open source que preferir, mas os seguintes pacotes de Python e R já vêm instalados por padrão:
PyCaret: uma biblioteca de ML open source e low-code
O PyCaret é uma biblioteca de machine learning em Python, open source e low-code, que automatiza fluxos de trabalho de ML. É uma ferramenta de ponta a ponta para machine learning e gestão de modelos que acelera exponencialmente o ciclo de experimentos e aumenta a produtividade.
Comparado a outras bibliotecas open source de machine learning, o PyCaret é uma alternativa low-code que substitui centenas de linhas de código por apenas algumas. Isso torna os experimentos muito mais rápidos e eficientes. Na prática, o PyCaret é um wrapper em Python sobre várias bibliotecas e frameworks de ML, como scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray e outras.
O design e a simplicidade do PyCaret foram inspirados no papel emergente do citizen data scientist, termo cunhado pela Gartner. Citizen data scientists são usuários avançados que conseguem executar tarefas analíticas simples e moderadamente complexas que antes exigiam mais conhecimento técnico. Confira este link para saber mais sobre o PyCaret.
Na próxima seção, vamos instalar o Microsoft SQL Server e habilitar o SQL Machine Learning Services. Em seguida, vamos configurar o ambiente Python, instalar o PyCaret (biblioteca de ML) e partir para o treinamento do modelo. Vamos lá.
Demo completa: treinando modelos de ML em SQL
Baixar e instalar o SQL Server e o Microsoft SSMS
O Microsoft SQL Server é um sistema de gerenciamento de banco de dados relacional da Microsoft. Como servidor de banco de dados, tem a função principal de armazenar e recuperar dados conforme solicitado por diferentes aplicações. Neste tutorial, vamos usar o SQL Server 2019 Developer para treinar um modelo de machine learning não supervisionado usando o PyCaret.
Se você já usou o SQL Server antes, é provável que ele já esteja instalado e você tenha acesso ao banco. Caso contrário, clique aqui para baixar o SQL Server 2019 Developer.
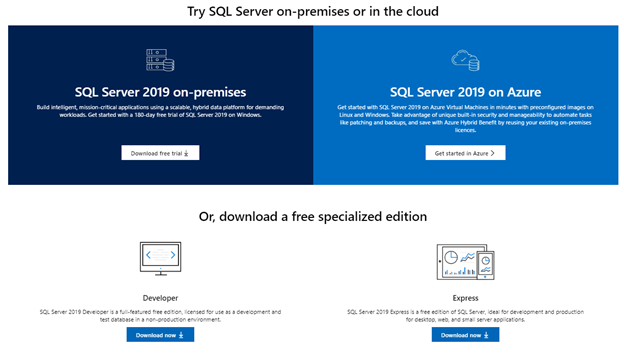
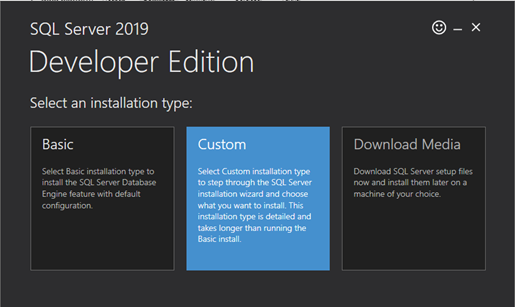
Clique no botão "Download now" abaixo da edição Developer e abra o instalador. Selecione o tipo de instalação "Custom".
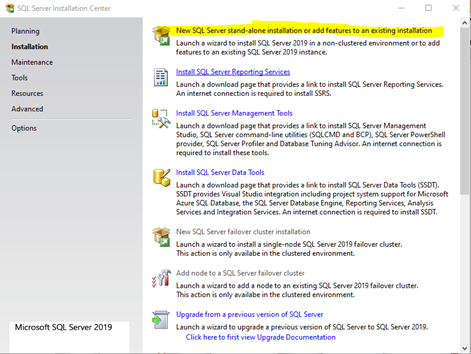
Escolha "New SQL Server stand-alone installation".
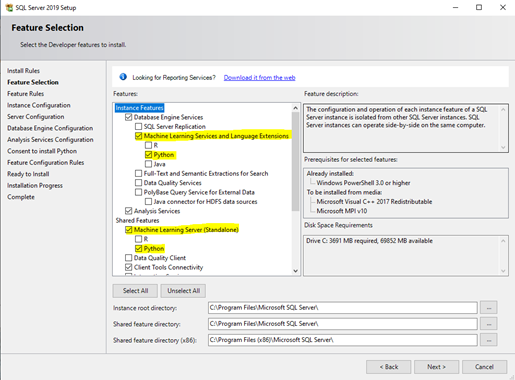
Em Instance Features, selecione os recursos, incluindo "Python" em Machine Learning Services and Language Extensions e Machine Learning Server.
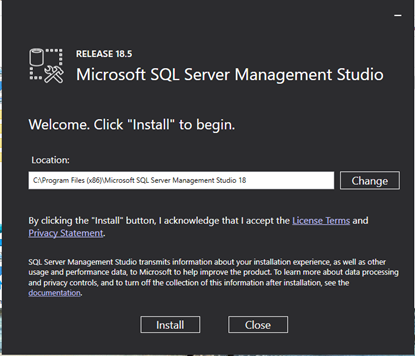
Depois que o SQL Server for instalado com sucesso, vamos usar um ambiente de desenvolvimento integrado (IDE). Existem várias opções; neste tutorial, vou usar o Microsoft SQL Server Management Studio. Baixe o instalador e siga as instruções. A instalação do SSMS é simples.
Criar um novo banco de dados e importar CSV
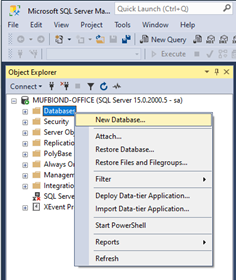
Com o SQL Server e o SSMS instalados, vamos criar um novo banco de dados e importar um arquivo CSV para trabalhar com ele. No painel Object Explorer, clique com o botão direito em Databases e escolha "New Database". Digite o nome do banco e as demais informações. Isso pode levar alguns minutos.
Depois que o banco for criado, vamos importar um arquivo CSV que usaremos nas próximas etapas. Você pode baixar o arquivo de exemplo no seu computador e seguir as instruções.
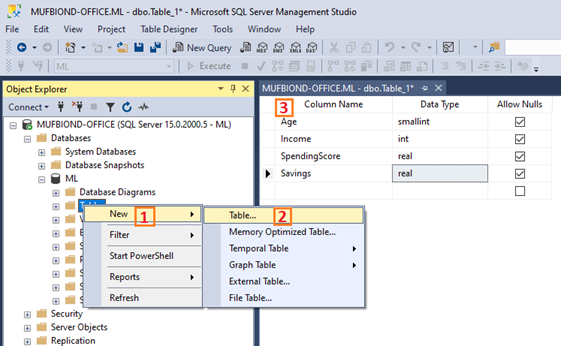
Clique com o botão direito em "Tables" → New → Table. Dê o nome que preferir. Neste exemplo, vou chamar a tabela de "jewelry".
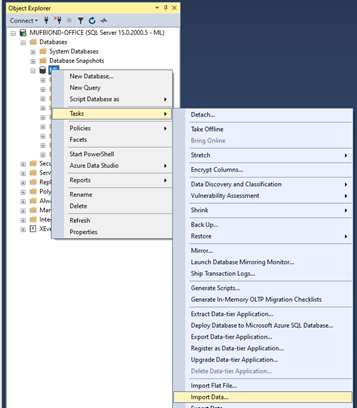
Agora que a tabela foi criada, vamos adicionar conteúdo. Vamos importar o arquivo CSV para essa tabela. Clique com o botão direito no banco e selecione Tasks -> Import Data
Em Data Source, selecione "Flat File Source" e clique em Browse para escolher o arquivo CSV. Dedique um tempo para configurar a importação antes de clicar em Next.
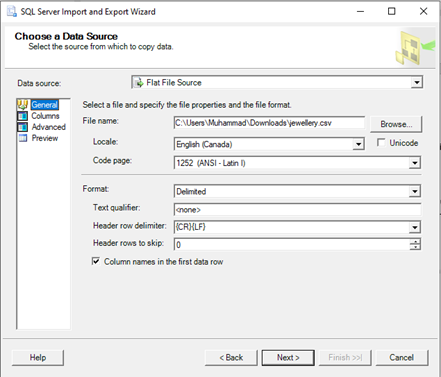
Clique em Next e informe os detalhes do banco (nome do servidor, usuário e senha) e siga as instruções das telas seguintes. Por fim, clique em Finish para concluir a importação.
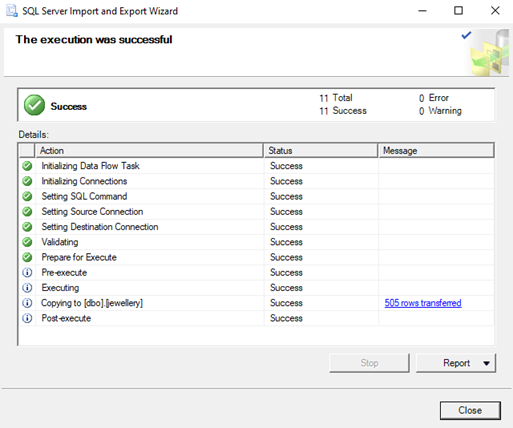
Pronto: agora temos a tabela "jewelry" com os dados importados.
Configurar o ambiente Python
Antes de começar a treinar modelos de machine learning em SQL, vamos configurar a execução de scripts Python no SQL. Vamos rodar Python "dentro" do SQL Server usando o procedimento armazenado do sistema sp_execute_external_script. Para começar, clique em "New Query" e execute o código abaixo para habilitar o uso do procedimento para execução remota de scripts:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Reinicie o servidor SQL antes de prosseguir.
Agora, vamos definir a linguagem e verificar o caminho da instalação. Com o Microsoft SQL Machine Learning Service, você tem duas opções: R ou Python. Neste exemplo, vamos usar Python — mais especificamente o PyCaret (uma biblioteca de machine learning em Python) — para treinar um modelo de clusterização não supervisionado no dataset "jewelry".
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’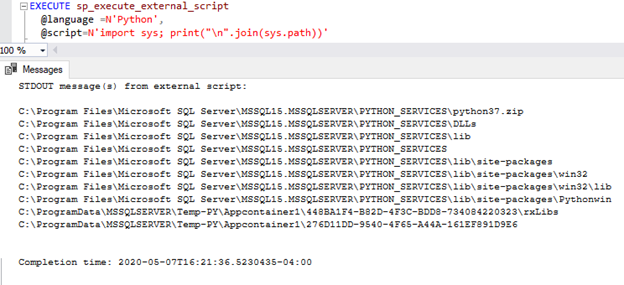
O último passo antes de começar a treinar o modelo é instalar a biblioteca PyCaret. Para instalar o pacote PyCaret, abra o Prompt de Comando e navegue até a pasta de pacotes do Python onde o SQL Server está instalado (veja o caminho acima). Execute o comando abaixo no prompt:
pip.exe install pycaret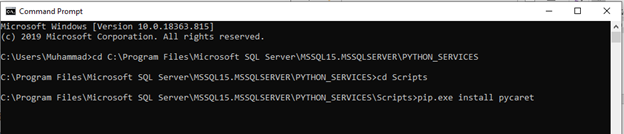
A instalação pode levar de 10 a 15 minutos. Quando terminar, vai aparecer assim:
Volte agora para o Microsoft SSMS.
Treinar um modelo de clusterização não supervisionado
Clusterização é uma técnica de machine learning que agrupa pontos de dados com características semelhantes. Esses agrupamentos são úteis para explorar dados, identificar padrões e analisar subconjuntos. Alguns casos de uso comuns de negócio são:
- Segmentação de clientes para ações de marketing.
- Análise de comportamento de compra para promoções e descontos.
- Identificação de geo-clusters em surtos epidêmicos como a COVID-19.
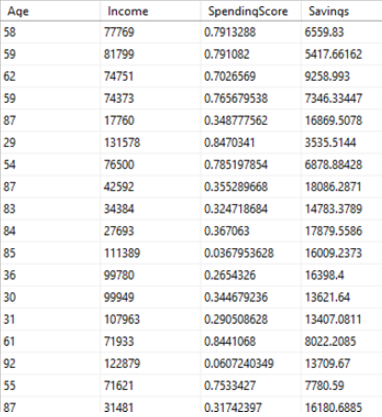
Temos quatro pontos de dados por cliente, que se parecem com isto:
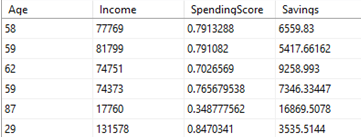
Nosso objetivo é treinar um modelo de clusterização KMeans nesse conjunto de dados e criar uma nova coluna "Cluster", que representa o grupo de clientes com características em comum.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Saída:
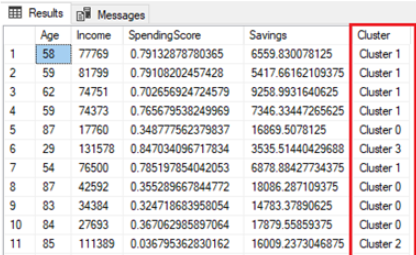
Perceba como foi simples. Com apenas uma linha, pc.get_clusters(...), fizemos o pré-processamento dos dados, treinamos um modelo KMeans não supervisionado e usamos o modelo treinado para gerar os rótulos de cluster — tudo sem sair do ambiente do SQL Server. Assim como a clusterização, o PyCaret também oferece detecção de anomalias não supervisionada com o comando mágico pc.get_anomaly. Você também pode treinar modelos supervisionados (classificação ou regressão), armazenar o modelo em um procedimento no SQL e usá-lo depois para gerar inferências. Tudo isso direto do seu banco de dados.
Conclusão
O que o machine learning dentro do banco de dados significa para o seu negócio? Significa reduzir etapas para tornar o ML mais eficiente, mais rápido e mais fácil de operacionalizar. Treinar modelos no banco minimiza a movimentação de dados, economizando tempo e custos. Porém, não é uma solução mágica: adotar ou não vai depender sempre do caso de uso. Esperamos que este tutorial tenha trazido uma nova perspectiva sobre as possibilidades de machine learning em ambientes corporativos.
Se você quiser aprender mais sobre como Python e SQL podem ser usados juntos para melhorar sua análise de dados e eficiência, recomendamos o curso Introduction to Databases in Python. Nele, você vai aprender o básico de como usar SQL com Python. Isso é útil porque bancos de dados estão em todo lugar, e cientistas de dados, analistas e engenheiros precisam interagir com eles o tempo todo. O toolkit SQLAlchemy do Python oferece uma forma acessível e intuitiva de consultar, construir e escrever em bancos essenciais, como SQLite, MySQL e PostgreSQL.