Table of Contents
- परिचय
- उपयोग-परिदृश्य: इन-डेटाबेस मशीन लर्निंग मॉडल का प्रशिक्षण
- इन-डेटाबेस मशीन लर्निंग को सपोर्ट करने वाले डेटाबेस
- Microsoft SQL Server Machine Learning Services
- PyCaret: Python में एक ओपन-सोर्स, लो-कोड मशीन लर्निंग लाइब्रेरी
- SQL में ML मॉडल प्रशिक्षण का एंड-टू-एंड डेमो
- SQL Server डाउनलोड और इंस्टॉल करें
- नया डेटाबेस बनाएँ और CSV फ़ाइल इम्पोर्ट करें
- Python वातावरण कॉन्फ़िगर करें
- एक अनसुपरवाइज़्ड क्लस्टरिंग मॉडल प्रशिक्षित करें
- निष्कर्ष
Introduction
Python और R ऐसे व्यापक रूप से प्रयुक्त प्रोग्रामिंग भाषाएँ हैं जिन्हें डेटा वैज्ञानिक, डेटा इंजीनियर, और मशीन लर्निंग इंजीनियर अपनाते हैं। SQL स्क्रिप्ट के रूप में Python कोड चलाने की क्षमता डेटा ऑपरेशंस के असीमित अवसर खोलती है, जिनमें बड़े पैमाने के डेटा के साथ काम करते समय इन-डेटाबेस मशीन लर्निंग क्षमताएँ भी शामिल हैं। मशीन लर्निंग प्रयोगों के लिए प्रचलित टूल इंटरैक्टिव प्रकृति वाले IDE जैसे VS Code या Notebooks हैं। हालाँकि, जब डेटा का आकार बहुत बड़ा हो जाता है, या जब ML मॉडल को प्रोडक्शन में लगाना होता है, तो ये टूल सीमाएँ पैदा कर सकते हैं। डेटा जहाँ स्थित है, वहीं प्रोग्राम करने और मॉडल ट्रेन करने की क्षमता की सख्त ज़रूरत रही है; इस ट्यूटोरियल में, आप इसे हासिल करने के कई तरीकों के बारे में जानेंगे।
Use-Case: Training Machine Learning Models In-Database
आजकल कई डेटाबेस बिल्ट-इन मशीन लर्निंग सेवाओं के साथ आते हैं (अगला सेक्शन देखें)। इसका अर्थ है कि आपको अलग से कोई डेटा साइंस प्लेटफ़ॉर्म लेने की ज़रूरत नहीं है, क्योंकि आप इन-डेटाबेस मशीन लर्निंग क्षमताओं का उपयोग करके अपने मॉडल को डेटाबेस के भीतर ही ट्रेन और डिप्लॉय कर सकते हैं। एक सामान्य मशीन लर्निंग वर्कफ़्लो कुछ इस प्रकार दिखता है:
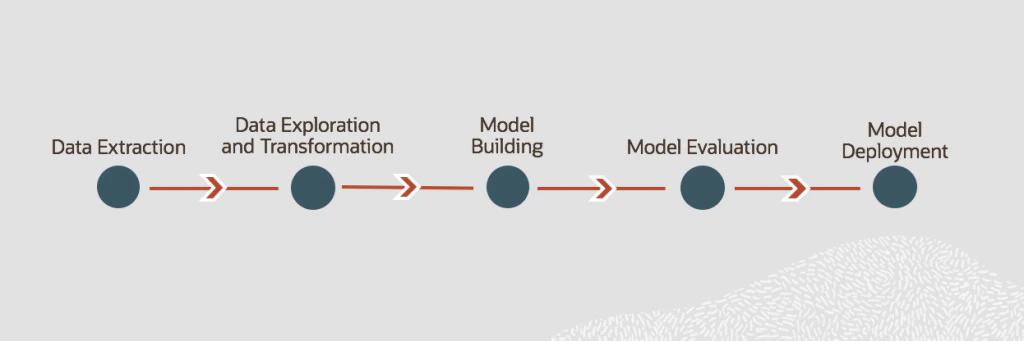
जब आप इन-डेटाबेस मशीन लर्निंग मॉडल ट्रेन करते हैं, तो अलग ETL प्रक्रिया की आवश्यकता नहीं होती क्योंकि आपका डेटा पहले से ही डेटाबेस में मौजूद है। इससे काफ़ी समय बचता है। आगे के चरण, जैसे Model Building और Deployment के लिए भी, आपको किसी बाहरी मशीन लर्निंग प्लेटफ़ॉर्म पर ट्रांसफ़र करने की ज़रूरत नहीं है क्योंकि आप इन-डेटाबेस क्षमताओं का उपयोग करके ही ML समाधान को ट्रेन और डिप्लॉय करेंगे। Oracle Big Data Blog के अनुसार, ऐसा करने के तीन लाभ हैं:
समग्र प्रक्रिया सरल हो जाती है
केवल डेटा को उस प्लेटफ़ॉर्म पर ले जाने में, जहाँ एल्गोरिदम मौजूद हैं, घंटों या दिनों का समय लग सकता है। इस प्रक्रिया से संभावित डेटा हानि जैसी जटिलताएँ जुड़ने के बावजूद, यह आज भी कई कंपनियों के लिए मानक है।
आप समय/लागत बचाते हैं
डेटा को एल्गोरिदम तक ले जाने के बजाय, एल्गोरिदम को डेटाबेस तक ले जाना अधिक तार्किक है। इस प्रकार, मशीन लर्निंग को डेटाबेस के साथ जोड़ना न केवल सरलता बल्कि गति के लिहाज़ से भी अधिक व्यावहारिक है। आप समय और बहुत सारा प्रयास बचाते हैं, जो अंततः लागतों में बचत करके निचली पंक्ति पर असर डालता है।
आपको परिणाम (मूल्य) तेज़ी से मिलते हैं
हक़ीक़त यह है कि मशीन लर्निंग मॉडल बनाना, उसे ट्रेन करना, परिणाम प्राप्त करना और उनका विश्लेषण करना भले ही समय और मेहनत माँगता हो, व्यवसाय आम तौर पर तब तक मशीन लर्निंग में रुचि नहीं लेते जब तक मॉडल प्रोडक्शन में न लग जाए ताकि संगठन की जिम्मेदार इकाइयाँ (Finance, HR, Supply Chain, Marketing, Sales, आदि) परिणामों का उपयोग कर सकें।
क्योंकि BI डैशबोर्ड, कॉल सेंटर्स, एटीएम, वेबसाइट, और मोबाइल डिवाइसेज़ जैसी एप्लिकेशनों में डिप्लॉयमेंट और इंटीग्रेशन IT के लिए बहुत बड़ी चुनौती हो सकती है, ऑपरेशनलाइज़ेशन सरल भी हो सकता है और बहुत जटिल भी।
यदि आपका मॉडल शुरू से ही डेटाबेस में है, तो जटिल डिप्लॉयमेंट कार्य काफ़ी हद तक कम हो जाता है। इससे प्रक्रिया बहुत आसान हो जाती है और परिणाम बहुत तेज़ी से मिलते हैं।
Databases Supporting In-Database Machine Learning
Microsoft SQL Server
Microsoft SQL Server Machine Learning Services, SQL Server RDBMS में R, Python, Java, PREDICT T-SQL कमांड, और rx_Predict स्टोर्ड प्रोसीजर, तथा SQL Server Big Data Clusters में SparkML को सपोर्ट करता है। R और Python भाषाओं में, Microsoft मशीन लर्निंग के लिए कई पैकेज और लाइब्रेरी शामिल करता है। आप अपने प्रशिक्षित मॉडलों को डेटाबेस में या बाहरी रूप से स्टोर कर सकते हैं। Azure SQL Managed Instance, Python और R के लिए Machine Learning Services को प्रीव्यू के रूप में सपोर्ट करता है। और जानें.
Amazon Redshift
Amazon Redshift एक मैनेज्ड, पेटाबाइट-स्केल डेटा वेयरहाउस सेवा है, जिसे आपके मौजूदा बिज़नेस इंटेलिजेंस टूल्स का उपयोग करके आपके समस्त डेटा का विश्लेषण सरल और किफ़ायती बनाने के लिए डिज़ाइन किया गया है। यह कुछ सौ गीगाबाइट से लेकर एक पेटाबाइट या उससे अधिक तक के डेटासेट के लिए अनुकूलित है और प्रति वर्ष प्रति टेराबाइट $1,000 से कम लागत आती है। और जानें.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science डेटा साइंस टीमों के लिए एक मैनेज्ड और सर्वरलेस प्लेटफ़ॉर्म है, जो Oracle Autonomous Database और Oracle Autonomous Data Warehouse सहित Oracle Cloud Infrastructure का उपयोग करके मशीन लर्निंग मॉडल बनाने, ट्रेन करने और प्रबंधित करने देता है। इसमें ओपन सोर्स समुदाय और Oracle Accelerated Data Science (ADS) लाइब्रेरी द्वारा विकसित Python-केंद्रित टूल्स, लाइब्रेरी और पैकेज शामिल हैं, जो प्रेडिक्टिव मॉडलों के एंड-टू-एंड लाइफसाइकल को सपोर्ट करते हैं। और जानें.
Google Cloud BigQuery
BigQuery, Google Cloud का मैनेज्ड, पेटाबाइट-स्केल डेटा वेयरहाउस है, जो आपको बहुत बड़े डेटा पर लगभग रीयल-टाइम में एनालिटिक्स चलाने देता है। BigQuery ML, SQL क्वेरी का उपयोग करके BigQuery में मशीन लर्निंग मॉडल बनाने और निष्पादित करने देता है। BigQuery ML पूर्वानुमान के लिए लीनियर रिग्रेशन; क्लासिफिकेशन के लिए बाइनरी और मल्टी-क्लास लॉजिस्टिक रिग्रेशन; डेटा सेगमेंटेशन के लिए K-means क्लस्टरिंग; प्रोडक्ट रिकमेंडेशन सिस्टम बनाने के लिए मैट्रिक्स फैक्टराइज़ेशन और टाइम-सीरीज़ पूर्वानुमान के लिए टाइम-सीरीज़ को सपोर्ट करता है। और जानें.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud एक मैनेज्ड पब्लिक क्लाउड सेवा है। आप IBM Db2 Warehouse को अपने हार्डवेयर के साथ ऑन-प्रिमाइसेस या निजी क्लाउड में भी सेटअप कर सकते हैं। एक डेटा वेयरहाउस के रूप में, इसमें इन-मेमोरी डेटा प्रोसेसिंग और ऑनलाइन एनालिटिकल प्रोसेसिंग के लिए कॉलमनर टेबल जैसी विशेषताएँ शामिल हैं। इसकी Netezza तकनीक एक मज़बूत एनालिटिक्स सेट प्रदान करती है, जिसे डेटा तक क्वेरी को कुशलतापूर्वक पहुँचाने के लिए डिज़ाइन किया गया है। और जानें.
BlazingSQL
BlazingSQL, RAPIDS इकोसिस्टम पर निर्मित एक GPU-त्वरित SQL इंजन है; यह एक ओपन-सोर्स प्रोजेक्ट और एक सशुल्क सेवा के रूप में मौजूद है। RAPIDS, जो CUDA का उपयोग करता है और Apache Arrow कॉलमनर मेमोरी फ़ॉर्मेट पर आधारित है, Nvidia द्वारा इनक्यूबेटेड ओपन-सोर्स सॉफ़्टवेयर लाइब्रेरी और API का एक सूट है — CuDF, जो RAPIDS का हिस्सा है, डेटा लोडिंग, जॉइनिंग, एग्रीगेटिंग, फ़िल्टरिंग और अन्य हेरफेर के लिए Pandas जैसी GPU DataFrame लाइब्रेरी है। और जानें.
Microsoft SQL Server Machine Learning Services
Machine Learning Services, SQL Server में एक फ़ीचर है जो आपको रिलेशनल डेटा के साथ Python और R स्क्रिप्ट चलाने की क्षमता देता है। आप प्रेडिक्टिव एनालिटिक्स और मशीन लर्निंग के लिए ओपन-सोर्स पैकेज और फ़्रेमवर्क, तथा Microsoft के Python और R पैकेज का उपयोग कर सकते हैं। स्क्रिप्ट्स इन-डेटाबेस निष्पादित होती हैं, बिना डेटा को SQL Server से बाहर या नेटवर्क पर भेजे। यह लेख SQL Server Machine Learning Services की मूल बातें और शुरुआत करने का तरीका समझाता है।
SQL Server Machine Learning Services आपको इन-डेटाबेस Python और R स्क्रिप्ट्स निष्पादित करने देता है। आप इसका उपयोग डेटा तैयार करने और साफ़ करने, फीचर इंजीनियरिंग करने, तथा डेटाबेस के भीतर ही मशीन लर्निंग मॉडल ट्रेन, मूल्यांकन और डिप्लॉय करने के लिए कर सकते हैं। यह फ़ीचर आपकी स्क्रिप्ट्स को वहीं चलाता है जहाँ डेटा स्थित है और डेटा को नेटवर्क पर किसी अन्य सर्वर पर ट्रांसफ़र करने की आवश्यकता समाप्त कर देता है।
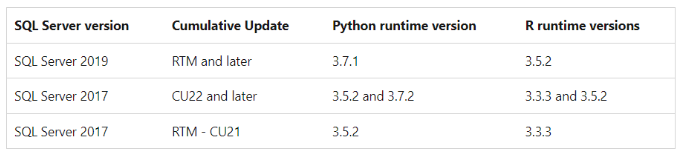
समर्थित Python और R संस्करण
वर्तमान में, SQL Machine Learning Services में निम्नलिखित Python और R संस्करण समर्थित हैं।
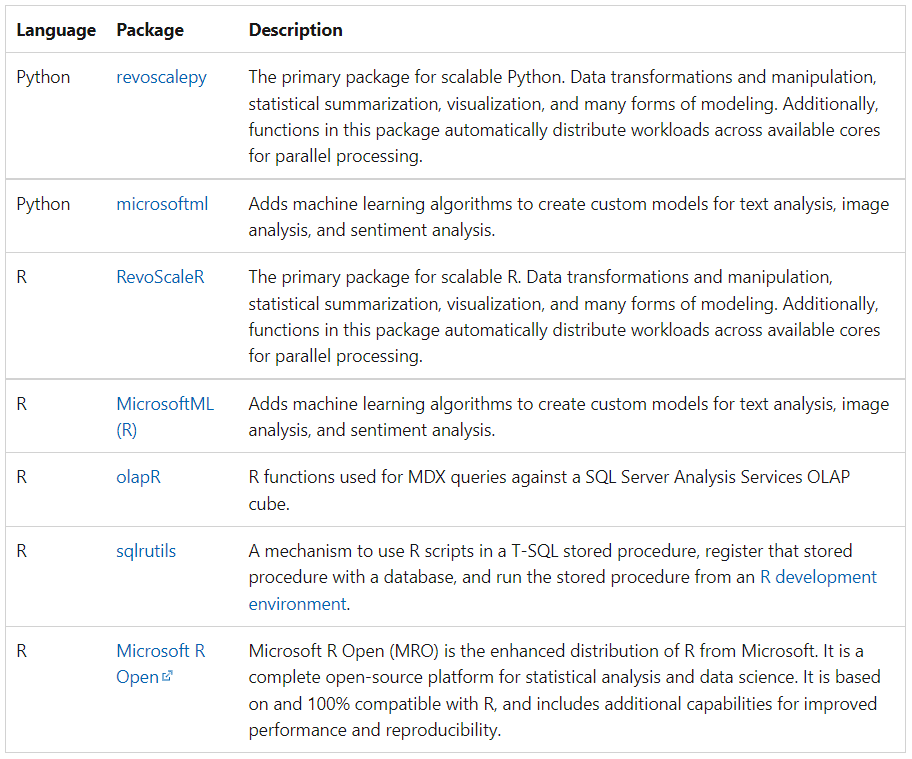
डिफ़ॉल्ट रूप से इंस्टॉल की जाने वाली Python और R लाइब्रेरी
आप अपनी पसंद के किसी भी ओपन-सोर्स पैकेज और फ़्रेमवर्क का उपयोग कर सकते हैं, परंतु निम्नलिखित Python और R पैकेज डिफ़ॉल्ट रूप से इंस्टॉल होते हैं:
PyCaret: An Open-Source, Low-Code ML Library
PyCaret, Python में एक ओपन-सोर्स, लो-कोड मशीन लर्निंग लाइब्रेरी है जो मशीन लर्निंग वर्कफ़्लो को ऑटोमेट करती है। यह एक एंड-टू-एंड मशीन लर्निंग और मॉडल प्रबंधन टूल है जो प्रयोग चक्र को कई गुना तेज़ करता है और उत्पादकता बढ़ाता है।
अन्य ओपन-सोर्स मशीन लर्निंग लाइब्रेरी की तुलना में, PyCaret एक वैकल्पिक लो-कोड लाइब्रेरी है, जो सैकड़ों पंक्तियों के कोड को कुछ पंक्तियों से बदल सकती है। इससे प्रयोग अत्यंत तेज़ और कुशल बनते हैं। मूलतः PyCaret कई मशीन लर्निंग लाइब्रेरी और फ़्रेमवर्क जैसे scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray, और कुछ अन्य के चारों ओर बना एक Python रैपर है।
PyCaret के डिज़ाइन और सादगी को Gartner द्वारा गढ़े गए उभरते हुए रोल “सिटिजन डेटा साइंटिस्ट” से प्रेरणा मिली। सिटिजन डेटा साइंटिस्ट ऐसे पावर यूज़र होते हैं जो पहले अधिक तकनीकी विशेषज्ञता की माँग करने वाले सरल से मध्यम जटिल विश्लेषणात्मक कार्य कर सकते हैं। PyCaret के बारे में अधिक जानने के लिए यह लिंक देखें।
अगले सेक्शन में, हम Microsoft SQL Server इंस्टॉल करेंगे और SQL Machine Learning Services सक्षम करेंगे। फिर हम Python वातावरण सक्षम करेंगे, PyCaret (ML लाइब्रेरी) इंस्टॉल करेंगे और मॉडल प्रशिक्षण शुरू करेंगे। आइए देखें कैसे।
End-to-End Demo of Training ML Models in SQL
Download and install SQL Server and Microsoft SSMS
Microsoft SQL Server, Microsoft का रिलेशनल डेटाबेस मैनेजमेंट सिस्टम है। एक डेटाबेस सर्वर के रूप में, यह विभिन्न एप्लिकेशनों द्वारा अनुरोधित डेटा को स्टोर और रिट्रीव करने का मुख्य कार्य करता है। इस ट्यूटोरियल में, हम PyCaret के माध्यम से एक अनसुपरवाइज़्ड मशीन लर्निंग मॉडल प्रशिक्षित करने के लिए SQL Server 2019 Developer का उपयोग करेंगे।
यदि आपने पहले SQL Server उपयोग किया है, तो संभव है कि यह आपके पास इंस्टॉल हो और डेटाबेस तक पहुँचना उपलब्ध हो। यदि नहीं, तो SQL Server 2019 Developer एडिशन्स डाउनलोड करने के लिए यहाँ क्लिक करें।
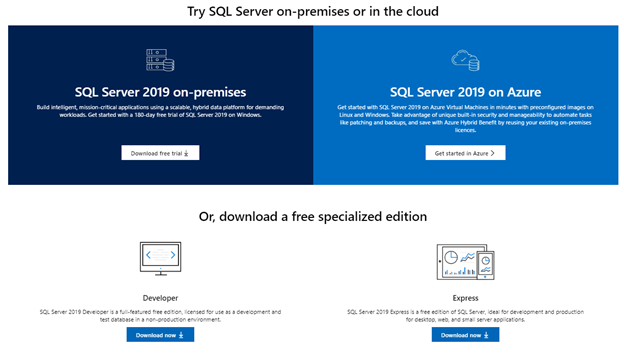
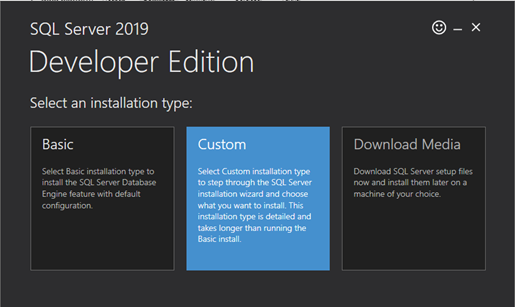
Developer एडिशन के नीचे “Download now” बटन पर क्लिक करें और इंस्टॉलर फ़ाइल खोलें। “Custom” इंस्टॉलेशन प्रकार पर क्लिक करें।
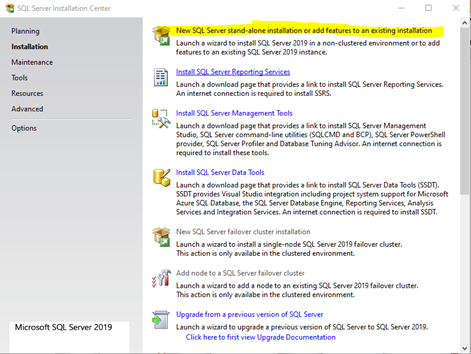
New SQL Server stand-alone installation चुनें।
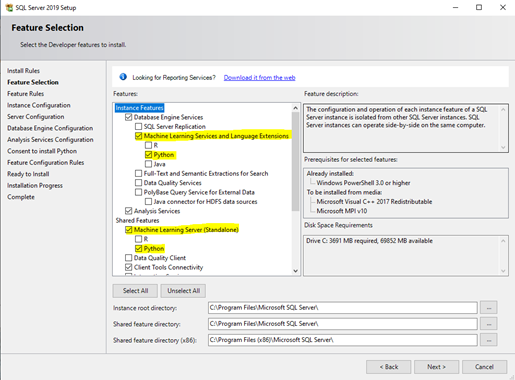
Instance Features विकल्प में, Machine Learning Services and Language Extensions तथा Machine Learning Server के अंतर्गत “Python” सहित फ़ीचर्स चुनें।
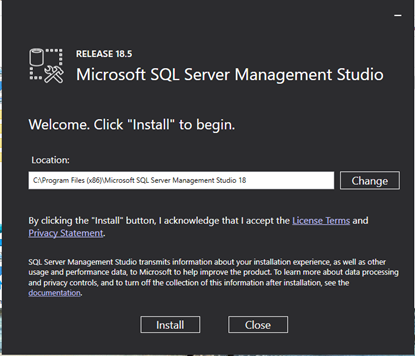
SQL Server सफलतापूर्वक इंस्टॉल हो जाने के बाद, हमें एक Integrated Development Environment (IDE) के साथ काम करना होगा। कई विकल्प उपलब्ध हैं; हालाँकि, इस ट्यूटोरियल में मैं Microsoft SQL Server Management Studio का उपयोग करूँगा। इंस्टॉलर डाउनलोड करें और निर्देशों का पालन करें। SSMS इंस्टॉल करना सीधा-सादा है।
Create a new database and import CSV
SQL Server और SSMS इंस्टॉल हो जाने के बाद, हमें एक नया डेटाबेस बनाना होगा और उसके साथ काम करने के लिए एक CSV फ़ाइल इम्पोर्ट करनी होगी। Object Explorer पैनल में, Databases पर राइट-क्लिक करें, और “New Database” चुनें। डेटाबेस का नाम और अन्य जानकारी दर्ज करें। इसमें कुछ मिनट लग सकते हैं।
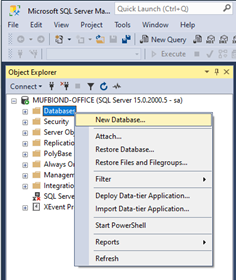
डेटाबेस सफलतापूर्वक बन जाने के बाद, आइए वह CSV फ़ाइल इम्पोर्ट करें जिस पर हम अगले कुछ चरणों में काम करेंगे। आप अपने कंप्यूटर पर नमूना फ़ाइल डाउनलोड कर सकते हैं और फिर निर्देशों का पालन करें।
“Tables” पर राइट-क्लिक करें → New → Table। आप इसे अपनी पसंद से नाम दे सकते हैं। इस उदाहरण में, मैं इस टेबल का नाम “jewelry” रख रहा हूँ।
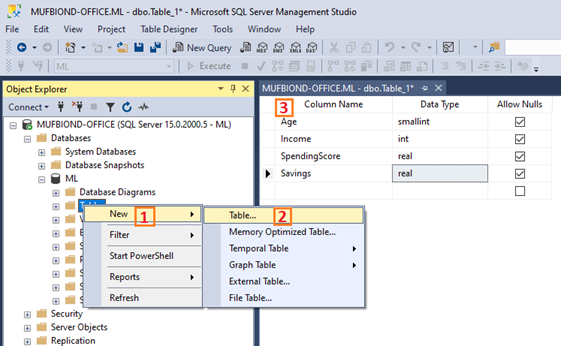
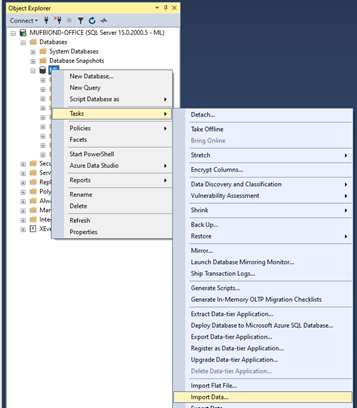
अब जब टेबल बना ली गई है, तो हम इसमें कुछ सामग्री जोड़ सकते हैं। आइए इस टेबल में CSV फ़ाइल इम्पोर्ट करें। डेटाबेस पर राइट-क्लिक करें और Tasks -> Import Data चुनें
Data Source के लिए “Flat File Source” चुनें, फिर CSV फ़ाइल चुनने के लिए Browse बटन का उपयोग करें। Next बटन पर क्लिक करने से पहले डेटा इम्पोर्ट कॉन्फ़िगर करने में कुछ समय दें।
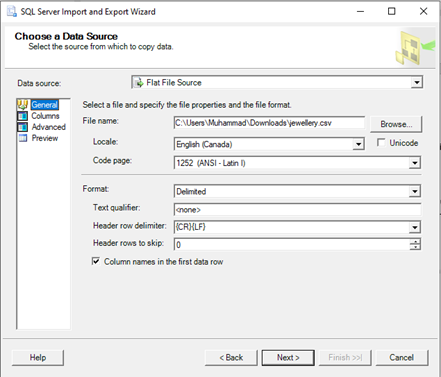
Next पर क्लिक करें और डेटाबेस विवरण (सर्वर नाम, उपयोगकर्ता नाम और पासवर्ड) दर्ज करें और अगली स्क्रीन पर दिए गए निर्देशों का पालन करें। अंत में, इम्पोर्ट पूरा करने के लिए Finish बटन पर क्लिक करें।
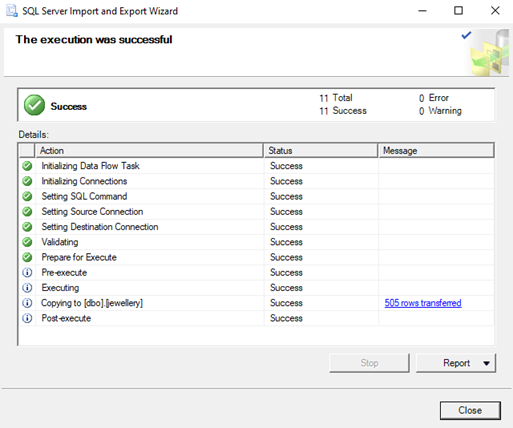
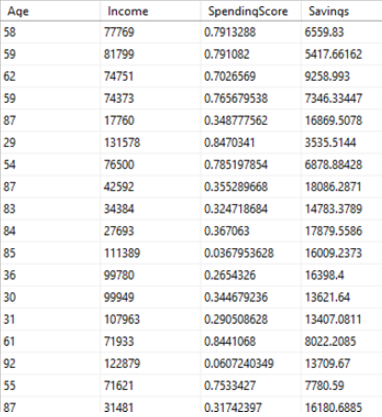
अब, हमारे पास “jewelry” नामक टेबल है जिसमें डेटा इम्पोर्ट हो चुका है।
Configure Python Environment
SQL में मशीन लर्निंग मॉडल ट्रेन करना शुरू करने से पहले, हमें SQL में Python स्क्रिप्ट कॉन्फ़िगर करनी होगी। हम sp_execute_external_script सिस्टम स्टोर्ड प्रोसीजर का उपयोग करके SQL Server के “अंदर” Python चलाएँगे। शुरू करने के लिए, “New Query” पर क्लिक करें और रिमोट स्क्रिप्ट निष्पादन के लिए इस प्रोसीजर के उपयोग को सक्षम करने हेतु निम्न कोड चलाएँ:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
आगे बढ़ने से पहले SQL Server को रीस्टार्ट करें।
अब, भाषा सेट करें और इंस्टॉलेशन का पाथ जाँचें। Microsoft SQL Machine Learning Service के साथ, आपके पास दो विकल्प हैं: R या Python। इस उदाहरण में, हम Python, या अधिक विशेष रूप से PyCaret (मशीन लर्निंग के लिए एक Python लाइब्रेरी) का उपयोग करेंगे, ताकि “jewelry” डेटासेट पर एक अनसुपरवाइज़्ड क्लस्टरिंग मॉडल ट्रेन किया जा सके।
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’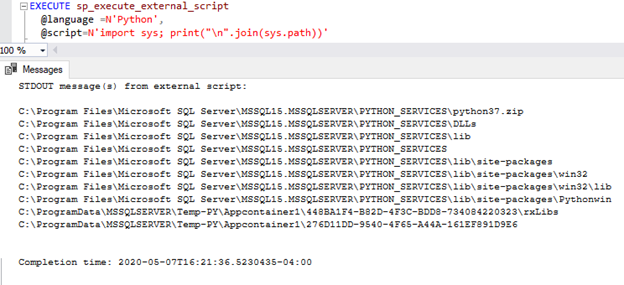
मॉडल ट्रेन करना शुरू करने से पहले अंतिम चरण PyCaret लाइब्रेरी इंस्टॉल करना है। PyCaret पैकेज इंस्टॉल करने के लिए, कमांड प्रॉम्प्ट खोलें और उस लोकेशन पर जाएँ जहाँ SQL Server में Python पैकेज इंस्टॉल हैं (ऊपर दिए गए पाथ देखें)। कमांड प्रॉम्प्ट पर निम्न कोड चलाएँ।
pip.exe install pycaret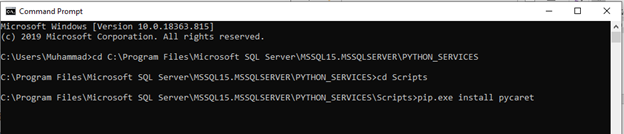
इंस्टॉलेशन में 10-15 मिनट लग सकते हैं। पूरा हो जाने पर यह कुछ ऐसा दिखेगा:
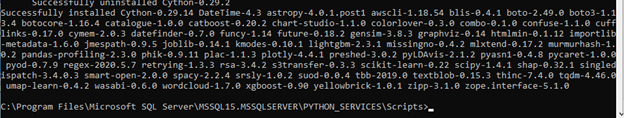
अब, Microsoft SSMS पर वापस चलें।
Train an unsupervised clustering model
क्लस्टरिंग एक मशीन लर्निंग तकनीक है जो समान विशेषताओं वाले डेटा पॉइंट्स को समूहित करती है। ये समूह डेटा को खोजने, पैटर्न पहचानने और डेटा के उपसमुच्चय का विश्लेषण करने में उपयोगी होते हैं। क्लस्टरिंग के कुछ सामान्य व्यावसायिक उपयोग-केस हैं:
- मार्केटिंग के उद्देश्य से ग्राहक सेगमेंटेशन।
- प्रमोशन्स और डिस्काउंट्स के लिए ग्राहक खरीद व्यवहार का विश्लेषण।
- COVID-19 जैसी महामारी के प्रकोप में जियो-क्लस्टर्स की पहचान।
हमारे पास प्रति ग्राहक चार डेटा पॉइंट्स हैं जो इस प्रकार दिखते हैं:
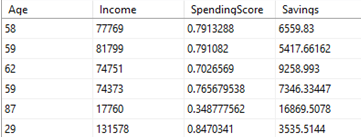
हमारा लक्ष्य इस डेटासेट पर KMeans क्लस्टरिंग मॉडल ट्रेन करना और “Cluster” नाम का एक नया कॉलम बनाना है जो उन ग्राहकों के समूह का प्रतिनिधित्व करता है जो एक साथ आते हैं।
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Output:
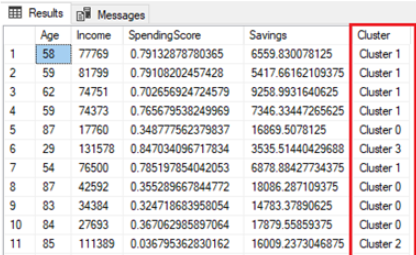
ध्यान दें यह कितना आसान था। केवल एक पंक्ति `pc.get_clusters(...)` से, हमने डेटा को प्रीप्रोसेस किया, एक अनसुपरवाइज़्ड KMeans मॉडल प्रशिक्षित किया, और प्रशिक्षित मॉडल का उपयोग करके क्लस्टर लेबल जनरेट किए — वह भी SQL Server वातावरण छोड़े बिना। क्लस्टरिंग की तरह ही, PyCaret `pc.get_anomaly` मैजिक कमांड के साथ अनसुपरवाइज़्ड एनोमली डिटेक्शन भी सपोर्ट करता है। आप सुपरवाइज़्ड मशीन लर्निंग मॉडल (Classification या Regression) भी ट्रेन कर सकते हैं, मॉडल को SQL प्रोसीजर में स्टोर कर सकते हैं, और बाद में इन्फ़रेंस जनरेट करने के लिए उपयोग कर सकते हैं। यह सब सीधे आपके डेटाबेस से किया जा सकता है।
Conclusion
इन-डेटाबेस मशीन लर्निंग का आपके व्यवसाय के लिए क्या मतलब है? इसका मतलब है कि आप ऑपरेशनलाइज़ करने में अधिक कुशल, तेज़ और आसान मशीन लर्निंग के लिए आवश्यक चरणों की संख्या को न्यूनतम कर सकते हैं। डेटाबेस में मशीन लर्निंग मॉडल ट्रेन करने से डेटा मूवमेंट कम से कम होता है, जिससे समय और लागत बचती है। हालाँकि, यह कोई जादुई समाधान नहीं है। इसे अपनाना या नहीं अपनाना हमेशा उपयोग-परिदृश्य पर निर्भर करेगा। उम्मीद है, इस ट्यूटोरियल ने आपको एंटरप्राइज़ वातावरण में मशीन लर्निंग की संभावनाओं पर नया दृष्टिकोण दिया होगा।
यदि आप यह जानना चाहते हैं कि डेटा विश्लेषण और दक्षता में सुधार के लिए Python और SQL को साथ में कैसे उपयोग किया जा सकता है, तो मैं Introduction to Databases in Python कोर्स लेने की सलाह देता हूँ। इस कोर्स में, आप Python के साथ SQL का उपयोग करने की बुनियाद सीखेंगे। यह उपयोगी होगा क्योंकि डेटाबेस सर्वव्यापी हैं और डेटा वैज्ञानिकों, विश्लेषकों और इंजीनियरों को उनसे लगातार इंटरैक्ट करना पड़ता है। Python SQL टूलकिट SQLAlchemy, SQLite, MySQL और PostgreSQL सहित आवश्यक डेटाबेस को क्वेरी करने, बनाने और उन पर लिखने का सुलभ और सहज तरीका प्रदान करता है।