Indice dei contenuti
- Introduzione
- Caso d'uso: addestrare modelli di machine learning nel database
- Database che supportano il machine learning in-database
- Microsoft SQL Server Machine Learning Services
- PyCaret: una libreria open source e low-code per il machine learning in Python
- Demo end-to-end di addestramento di modelli ML in SQL
- Scarica e installa SQL Server
- Crea un nuovo database e importa un file CSV
- Configura l'ambiente Python
- Addestra un modello di clustering non supervisionato
- Conclusione
Introduzione
Python e R sono linguaggi di programmazione ampiamente utilizzati da data scientist, data engineer e machine learning engineer. Poter eseguire codice Python come script SQL apre possibilità infinite per le operazioni sui dati, incluse funzionalità di machine learning in-database quando si lavora con grandi moli di dati. Gli strumenti di riferimento per condurre esperimenti di machine learning sono gli ambienti di sviluppo integrati (IDE) come VS Code o i Notebooks, che sono per natura interattivi. Tuttavia, questi strumenti possono porre dei limiti quando i dati sono molto grandi o quando il modello di ML deve essere messo in produzione. C'è stato un forte bisogno di poter programmare e addestrare i modelli là dove risiedono i dati; in questo tutorial vedrai diversi modi per riuscirci.
Caso d'uso: addestrare modelli di machine learning nel database
Molti database oggi includono servizi di machine learning integrati (vedi la sezione successiva). Questo significa che non devi procurarti una piattaforma di data science esterna, perché puoi usare le funzionalità di machine learning in-database per addestrare e distribuire i tuoi modelli direttamente nel database. Un tipico workflow di machine learning è questo:
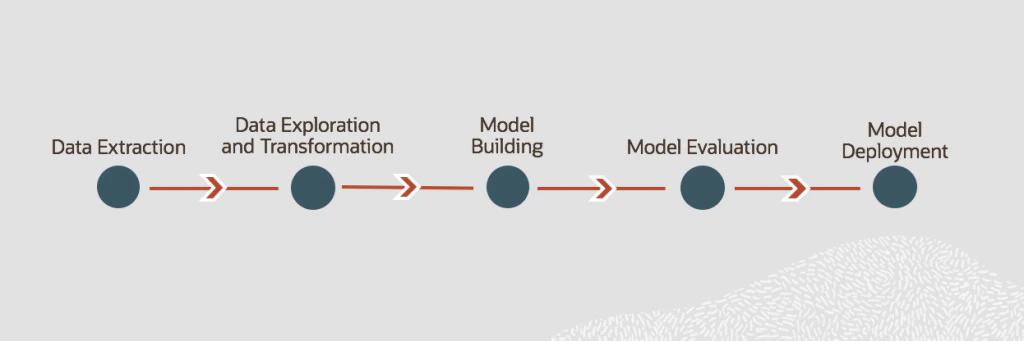
Quando addestri un modello di machine learning in-database, non ti serve un processo ETL stand-alone, perché i dati sono già nel database. Questo fa risparmiare molto tempo. Per i passaggi successivi come la costruzione del modello e la messa in produzione, non devi trasferire nulla a una piattaforma esterna di machine learning, poiché userai le funzionalità in-database per addestrare e distribuire una soluzione di ML. Secondo l'Oracle Big Data Blog, ci sono tre benefici in questo approccio:
L'intero processo è semplificato
Può spesso volerci da ore a giorni solo per spostare i dati su un'altra piattaforma dove risiedono gli algoritmi. Nonostante questo processo introduca complicazioni come potenziali perdite di dati, è ancora lo standard per molte aziende.
Risparmi tempo e costi
Ha più senso spostare gli algoritmi verso il database, invece di spostare i dati verso gli algoritmi. Abbinare il machine learning al database è quindi più pratico non solo in termini di semplicità ma anche di velocità. Risparmi tempo e molto sforzo, con un impatto positivo sul conto economico grazie alla riduzione dei costi.
Ottieni risultati (valore) più velocemente
Il fatto è che, sebbene possa richiedere molto tempo e impegno costruire un modello di machine learning, addestrarlo, ottenere i risultati e analizzarli, le aziende in genere non sono interessate al machine learning finché il modello non è in produzione, in modo che i reparti che governano l'organizzazione (Finanza, HR, Supply Chain, Marketing, Vendite, ecc.) possano usare i risultati.
Poiché la distribuzione e l'integrazione in applicazioni come dashboard di business intelligence (BI), call center, ATM, siti web e dispositivi mobili possono essere una grande sfida per l'IT, l'operativizzazione può essere semplice oppure molto complessa.
Se il tuo modello è sempre rimasto nel database, la quantità di lavoro di distribuzione complicata si riduce notevolmente. Questo rende il processo molto più facile e i risultati arrivano molto più rapidamente.
Database che supportano il machine learning in-database
Microsoft SQL Server
Microsoft SQL Server Machine Learning Services supporta R, Python, Java, il comando PREDICT T-SQL e la stored procedure rx_Predict nel RDBMS di SQL Server, e SparkML nei Big Data Clusters di SQL Server. Nei linguaggi R e Python, Microsoft include diversi pacchetti e librerie per il machine learning. Puoi archiviare i modelli addestrati nel database o esternamente. Azure SQL Managed Instance supporta Machine Learning Services per Python e R in anteprima. Scopri di più.
Amazon Redshift
Amazon Redshift è un servizio di data warehouse gestito e a scala petabyte, progettato per rendere semplice ed economicamente conveniente analizzare tutti i tuoi dati usando i tuoi strumenti di business intelligence esistenti. È ottimizzato per dataset che vanno da poche centinaia di gigabyte a un petabyte o più e costa meno di 1.000 $ per terabyte all'anno. Scopri di più.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science è una piattaforma gestita e serverless per i team di data science per sviluppare, addestrare e gestire modelli di machine learning usando Oracle Cloud Infrastructure, inclusi Oracle Autonomous Database e Oracle Autonomous Data Warehouse. Include strumenti, librerie e pacchetti incentrati su Python sviluppati dalla community open source e la Oracle Accelerated Data Science (ADS) Library, che supporta l'intero ciclo di vita dei modelli predittivi. Scopri di più.
Google Cloud BigQuery
BigQuery è il data warehouse gestito di Google Cloud, a scala petabyte, che ti consente di eseguire analisi su enormi quantità di dati in quasi tempo reale. BigQuery ML ti permette di creare ed eseguire modelli di machine learning in BigQuery usando query SQL. BigQuery ML supporta la regressione lineare per il forecasting; la regressione logistica binaria e multi-classe per la classificazione; il clustering K-means per la segmentazione dei dati; la fattorizzazione di matrici per creare sistemi di raccomandazione di prodotti e le serie temporali per effettuare previsioni su time series. Scopri di più.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud è un servizio pubblico cloud gestito. Puoi anche configurare IBM Db2 Warehouse on-premise con il tuo hardware o in un cloud privato. In quanto data warehouse, include funzionalità come l'elaborazione dati in-memory e tabelle colonnari per l'online analytical processing. La tecnologia Netezza fornisce un set robusto di funzionalità analitiche progettate per portare in modo efficiente la query ai dati. Scopri di più.
BlazingSQL
BlazingSQL è un motore SQL accelerato su GPU costruito sopra l'ecosistema RAPIDS; esiste come progetto open source e come servizio a pagamento. RAPIDS, che usa CUDA ed è basato sul formato di memoria colonnare Apache Arrow, è una suite di librerie software e API open source incubata da Nvidia. CuDF, parte di RAPIDS, è una libreria GPU DataFrame in stile Pandas per caricare, unire, aggregare, filtrare e in generale manipolare i dati. Scopri di più.
Microsoft SQL Server Machine Learning Services
Machine Learning Services è una funzionalità di SQL Server che ti dà la possibilità di eseguire script Python e R con dati relazionali. Puoi usare pacchetti e framework open source, oltre ai pacchetti Microsoft per Python e R, per l'analisi predittiva e il machine learning. Gli script vengono eseguiti in-database senza spostare i dati fuori da SQL Server o attraverso la rete. Questo articolo spiega le basi di SQL Server Machine Learning Services e come iniziare.
SQL Server Machine Learning Services ti permette di eseguire script Python e R in-database. Puoi usarlo per preparare e pulire i dati, fare feature engineering e addestrare, valutare e distribuire modelli di machine learning all'interno di un database. La funzionalità esegue i tuoi script dove risiedono i dati, eliminando la necessità di trasferirli su rete verso un altro server.
Versioni di Python e R supportate
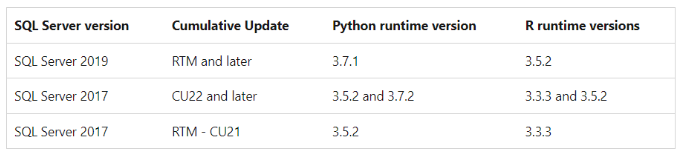
Ad oggi, le seguenti versioni di Python e R sono supportate in SQL Machine Learning Services.
Librerie Python e R installate di default
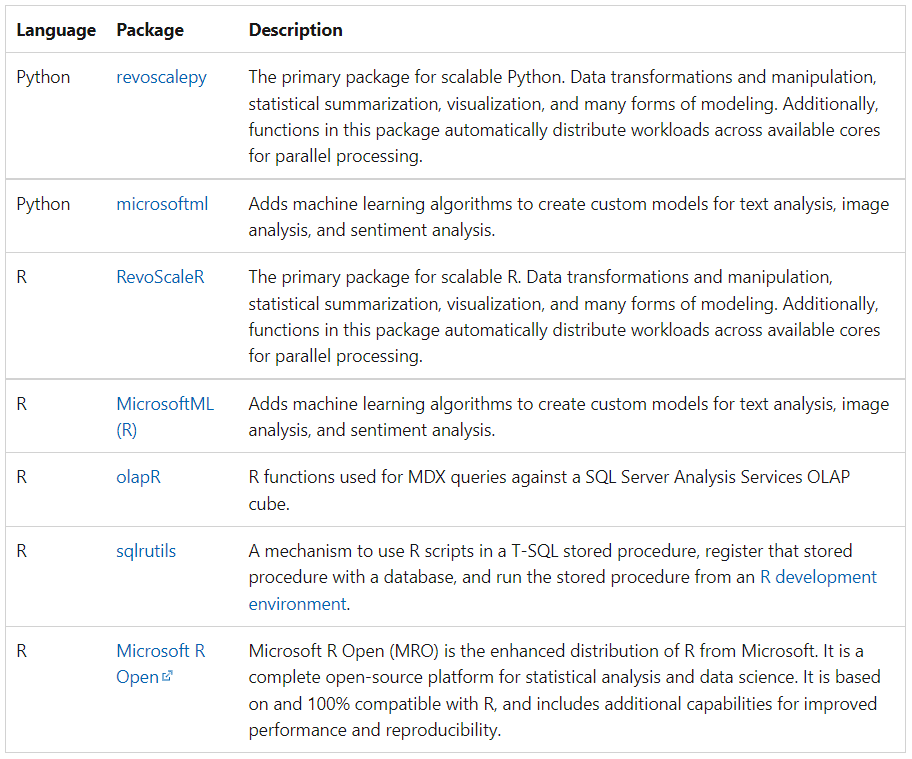
Puoi usare qualsiasi pacchetto e framework open source preferisci, ma i seguenti pacchetti Python e R sono installati di default:
PyCaret: una libreria open source e low-code per il ML
PyCaret è una libreria open source e low-code per il machine learning in Python che automatizza i workflow di machine learning. È uno strumento end-to-end per il machine learning e la gestione dei modelli che accelera esponenzialmente il ciclo degli esperimenti e migliora la produttività.
Rispetto ad altre librerie open source di machine learning, PyCaret è una libreria low-code alternativa che può sostituire centinaia di righe di codice con poche righe. Questo rende gli esperimenti esponenzialmente più veloci ed efficienti. PyCaret è essenzialmente un wrapper Python attorno a diverse librerie e framework di machine learning come scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray e altri.
Il design e la semplicità di PyCaret sono stati ispirati dal ruolo emergente dei citizen data scientist, un termine coniato per la prima volta da Gartner. I citizen data scientist sono utenti esperti che possono svolgere attività analitiche semplici e moderatamente sofisticate che in precedenza avrebbero richiesto competenze più tecniche. Dai un'occhiata a questo link per saperne di più su PyCaret.
Nella sezione seguente, installeremo Microsoft SQL Server e abiliteremo SQL Machine Learning Services. Poi abiliteremo l'ambiente Python, installeremo PyCaret (libreria di ML) e passeremo all'addestramento del modello. Vediamo come fare.
Demo end-to-end di addestramento di modelli ML in SQL
Scarica e installa SQL Server e Microsoft SSMS
Microsoft SQL Server è un sistema di gestione di database relazionali di Microsoft. In quanto server di database, svolge la funzione primaria di archiviare e recuperare dati su richiesta di diverse applicazioni. In questo tutorial useremo SQL Server 2019 Developer per addestrare un modello di machine learning non supervisionato tramite PyCaret.
Se hai già usato SQL Server, è probabile che tu lo abbia installato e abbia accesso al database. In caso contrario, clicca qui per scaricare le edizioni SQL Server 2019 Developer.
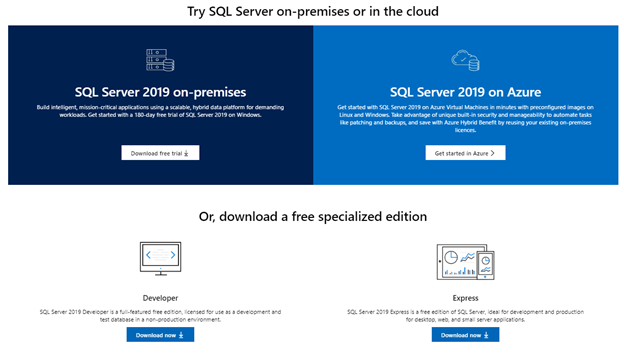
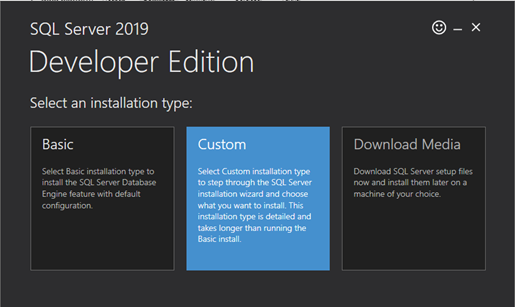
Fai clic sul pulsante “Download now” sotto l'edizione Developer e apri il file di installazione. Seleziona il tipo di installazione “Custom”.
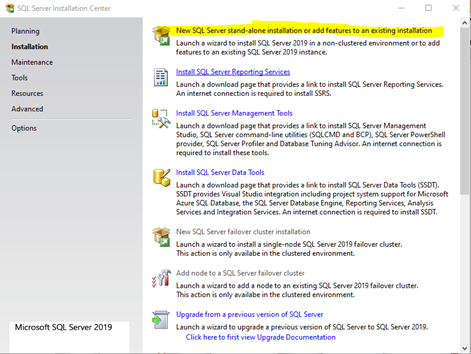
Scegli New SQL Server stand-alone installation.
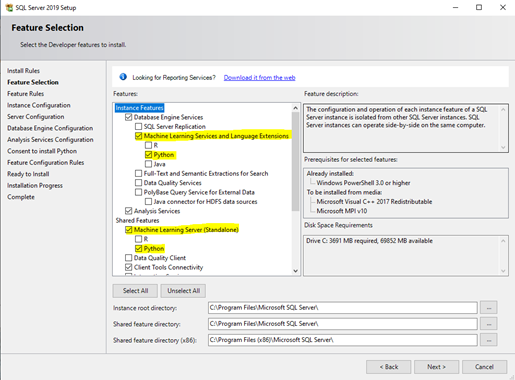
Nell'opzione Instance Features, seleziona le funzionalità, inclusa “Python” sotto Machine Learning Services and Language Extensions e Machine Learning Server.
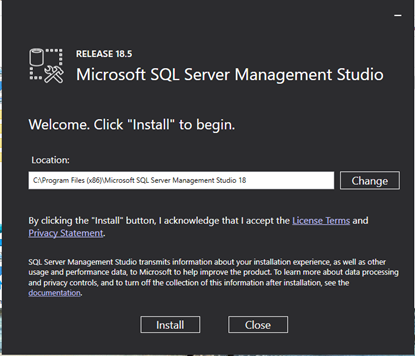
Una volta installato correttamente SQL Server, dobbiamo lavorare con un Integrated Development Environment (IDE). Ci sono molte opzioni disponibili; in questo tutorial userò però Microsoft SQL Server Management Studio. Scarica l'installer e segui le istruzioni. Installare SSMS è semplice.
Crea un nuovo database e importa un CSV
Una volta installati SQL Server e SSMS, dovremo creare un nuovo database e importare un file CSV con cui lavorare. Nel pannello Object Explorer, fai clic con il tasto destro su Databases e scegli “New Database”. Inserisci il nome del database e le altre informazioni. Potrebbero volerci alcuni minuti.
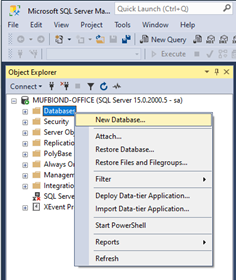
Dopo aver creato correttamente il database, importiamo un file CSV con cui lavoreremo nei prossimi passaggi. Puoi scaricare il file di esempio sul tuo computer e poi seguire le istruzioni.
Fai clic con il tasto destro su “Tables” → New → Table. Puoi chiamarla come preferisci. In questo esempio, chiamerò questa tabella “jewelry”.
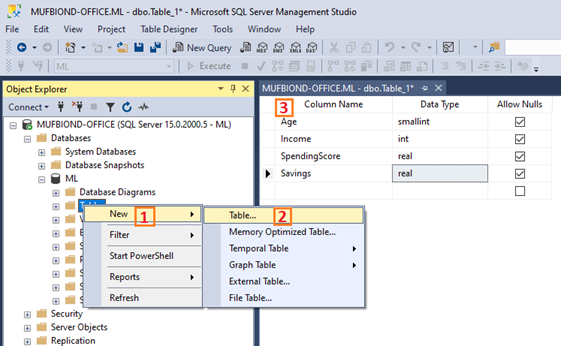
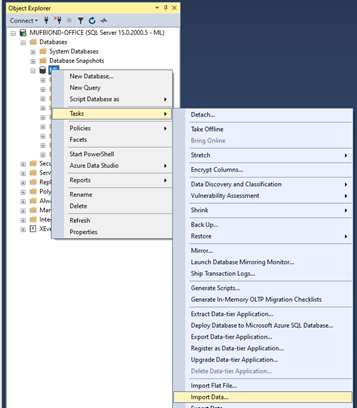
Ora che la tabella è stata creata, possiamo popolarla. Importiamo il file CSV in questa tabella. Fai clic con il tasto destro sul database e seleziona Tasks -> Import Data
Per Data Source, seleziona “Flat File Source”, quindi usa il pulsante Browse per selezionare il file CSV. Dedica un po' di tempo a configurare l'import prima di fare clic su Next.
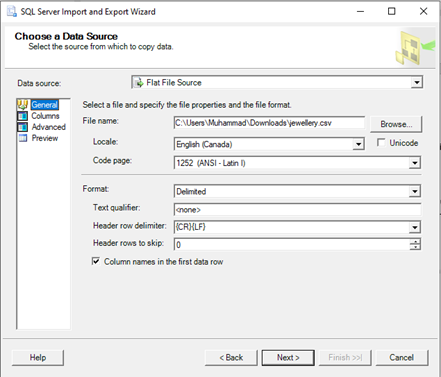
Fai clic su Next e inserisci i dettagli del database (nome server, username e password) e segui le istruzioni nelle schermate successive. Infine, fai clic sul pulsante Finish per completare l'import.
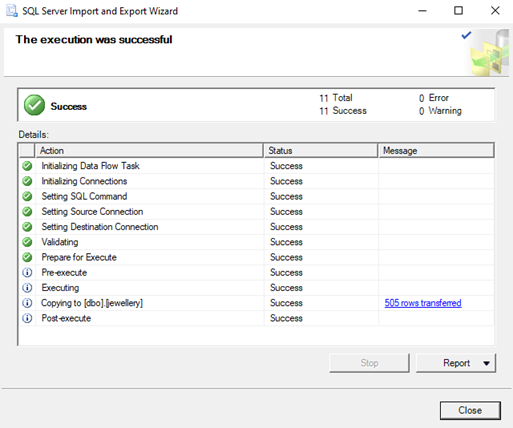
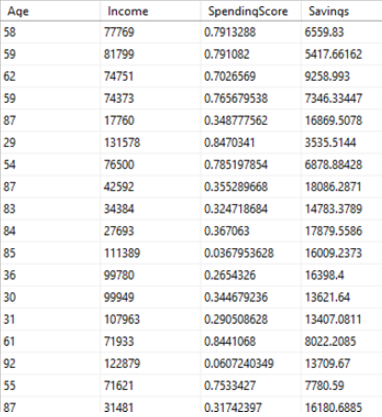
Ora abbiamo una tabella “jewelry” con i dati importati.
Configura l'ambiente Python
Prima di iniziare ad addestrare modelli di machine learning in SQL, dovremo configurare gli script Python in SQL. Eseguiremo Python “all'interno” di SQL Server usando la stored procedure di sistema sp_execute_external_script. Per iniziare, fai clic su “New Query” ed esegui il seguente codice per abilitare l'uso della procedura per l'esecuzione remota di script:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Riavvia il server SQL prima di procedere oltre.
Ora impostiamo il linguaggio e controlliamo il percorso dell'installazione. Con Microsoft SQL Machine Learning Service hai due opzioni: R o Python. In questo esempio useremo Python, più precisamente PyCaret (una libreria Python per il machine learning), per addestrare un modello di clustering non supervisionato sul dataset “jewelry”.
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’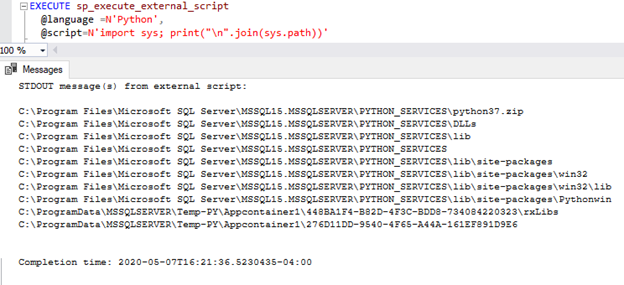
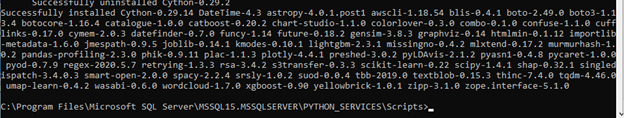
L'ultimo passaggio prima di iniziare ad addestrare il modello è installare la libreria PyCaret. Per installare il pacchetto PyCaret, apri un prompt dei comandi e vai nella posizione dei pacchetti Python dove è installato SQL Server (vedi il percorso sopra). Esegui il seguente comando nel prompt.
pip.exe install pycaret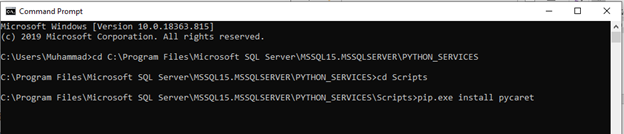
L'installazione può richiedere 10-15 minuti. Una volta terminata, apparirà così:
Ora torna a Microsoft SSMS.
Addestra un modello di clustering non supervisionato
Il clustering è una tecnica di machine learning che raggruppa i punti dati con caratteristiche simili. Questi raggruppamenti sono utili per esplorare i dati, identificare pattern e analizzare un sottoinsieme di dati. Alcuni comuni casi d'uso aziendali del clustering sono:
- Segmentazione dei clienti a fini di marketing.
- Analisi del comportamento d'acquisto dei clienti per promozioni e sconti.
- Identificazione di geo-cluster in un'epidemia come il COVID-19.
Abbiamo quattro punti dati per cliente, che appaiono così:
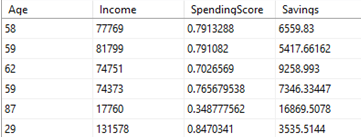
Il nostro obiettivo è addestrare un modello di clustering KMeans su questo dataset e creare una nuova colonna “Cluster” che rappresenta il gruppo di clienti a cui ciascuno appartiene.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Output:
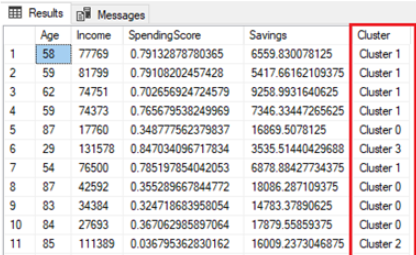
Nota quanto è stato semplice. Con una sola riga `pc.get_clusters(...)` abbiamo preprocessato i dati, addestrato un modello KMeans non supervisionato e usato il modello addestrato per generare le etichette dei cluster, il tutto senza uscire dall'ambiente di SQL Server. Analogamente al clustering, PyCaret supporta anche il rilevamento di anomalie non supervisionato con il comando magico `pc.get_anomaly`. Puoi anche addestrare modelli di machine learning supervisionati (Classificazione o Regressione), archiviare il modello in una procedura SQL e usarlo in seguito per generare inferenza. Tutto questo può essere fatto direttamente dal tuo database.
Conclusione
Cosa significa il machine learning nel database per il tuo business? Significa che puoi ridurre al minimo i passaggi necessari per un machine learning più efficiente, veloce e facile da operativizzare. Addestrare modelli di machine learning nel database riduce gli spostamenti di dati, facendo risparmiare tempo e costi. Tuttavia, non è una bacchetta magica: la scelta di adottarlo dipende sempre dal caso d'uso. Speriamo che questo tutorial ti abbia dato una nuova prospettiva sulle possibilità del machine learning negli ambienti enterprise.
Se vuoi approfondire come Python e SQL possano essere usati insieme per migliorare l'analisi dei dati e l'efficienza, ti consiglio il corso Introduction to Databases in Python. In questo corso imparerai le basi dell'uso di SQL con Python. Ti sarà utile perché i database sono onnipresenti e data scientist, analisti e ingegneri devono interagire con essi continuamente. Il toolkit SQL per Python, SQLAlchemy, offre un modo accessibile e intuitivo per interrogare, creare e scrivere sui principali database, inclusi SQLite, MySQL e PostgreSQL.



