Inhaltsverzeichnis
- Einführung
- Use Case: ML-Modelle direkt in der Datenbank trainieren
- Datenbanken mit In-Database-Machine-Learning
- Microsoft SQL Server Machine Learning Services
- PyCaret: Open-Source-Low-Code-Bibliothek für Machine Learning in Python
- End-to-End-Demo: ML-Modelle in SQL trainieren
- SQL Server herunterladen und installieren
- Neue Datenbank erstellen und CSV importieren
- Python-Umgebung konfigurieren
- Unüberwachtes Clustering-Modell trainieren
- Fazit
Einführung
Python und R sind weit verbreitete Programmiersprachen, die von Data Scientists, Data Engineers und Machine-Learning-Engineers eingesetzt werden. Python-Code als SQL-Skript ausführen zu können, eröffnet enorme Möglichkeiten für Datenprozesse – inklusive In-Database-Machine-Learning, wenn sehr große Datenmengen anfallen. Für ML-Experimente sind meist interaktive Umgebungen wie IDEs (z. B. VS Code) oder Notebooks die erste Wahl. Bei sehr großen Datenmengen oder wenn ein ML-Modell in Produktion gehen soll, stoßen diese Tools jedoch an Grenzen. Es besteht ein klarer Bedarf, Modelle dort zu entwickeln und zu trainieren, wo die Daten liegen. In diesem Tutorial lernst du mehrere Wege kennen, genau das zu erreichen.
Use-Case: ML-Modelle direkt in der Datenbank trainieren
Viele Datenbanken bringen heute integrierte Machine-Learning-Services mit (siehe nächster Abschnitt). Das bedeutet: Du brauchst nicht zwingend eine separate Data-Science-Plattform, sondern kannst ML-Funktionen in der Datenbank nutzen, um Modelle direkt dort zu trainieren und zu deployen. Ein typischer Machine-Learning-Workflow sieht so aus:
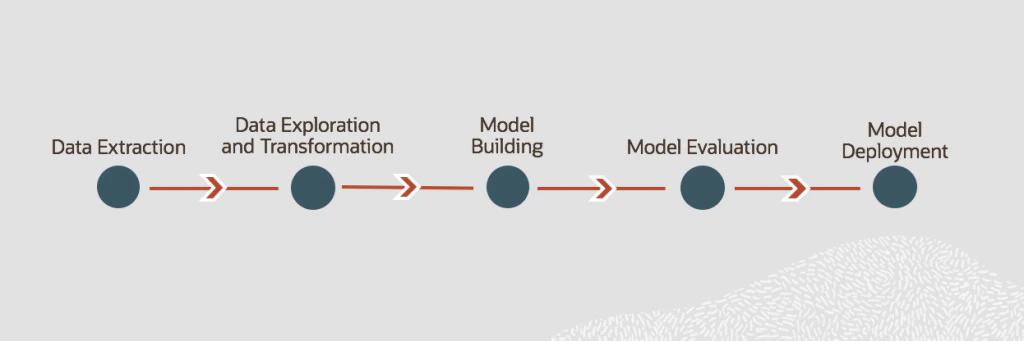
Wenn du ein ML-Modell in der Datenbank trainierst, entfällt ein separater ETL-Prozess, denn deine Daten sind bereits dort. Das spart viel Zeit. Auch für die nächsten Schritte wie Model Building und Deployment musst du nicht auf eine externe ML-Plattform wechseln, da du In-Database-Funktionen zum Trainieren und Deployen nutzt. Laut dem Oracle Big Data Blog ergeben sich daraus drei Vorteile:
Der Gesamtprozess wird einfacher
Es kann Stunden oder Tage dauern, Daten auf eine andere Plattform zu verschieben, auf der die Algorithmen laufen. Trotz Risiken wie möglichem Datenverlust ist das bei vielen Unternehmen immer noch Standard.
Du sparst Zeit und Kosten
Es ist sinnvoller, die Algorithmen zur Datenbank zu bringen statt die Daten zu den Algorithmen. Die Kopplung von Machine Learning und Datenbank ist daher nicht nur einfacher, sondern auch schneller. Du sparst Zeit und Aufwand – und am Ende Kosten.
Du kommst schneller zu Ergebnissen
Auch wenn das Bauen, Trainieren und Auswerten eines Modells Zeit braucht, zählt für das Business oft erst der produktive Einsatz, damit Fachbereiche (Finance, HR, Supply Chain, Marketing, Sales usw.) die Ergebnisse nutzen können.
Weil das Deployment und die Integration in Anwendungen wie BI-Dashboards, Callcenter, Geldautomaten, Websites und Mobile Apps für die IT eine große Herausforderung sein können, ist die Operationalisierung entweder sehr einfach oder sehr komplex.
Wenn dein Modell von Anfang an in der Datenbank liegt, verringert sich der Aufwand für komplexes Deployment deutlich. Der Prozess wird einfacher und Ergebnisse liegen schneller vor.
Datenbanken mit In-Database-Machine-Learning
Microsoft SQL Server
Die Microsoft SQL Server Machine Learning Services unterstützen R, Python, Java, den PREDICT-T-SQL-Befehl und die gespeicherte Prozedur rx_Predict im SQL-Server-RDBMS sowie SparkML in SQL Server Big Data Clusters. Für R und Python stellt Microsoft diverse Pakete und Bibliotheken für Machine Learning bereit. Trainierte Modelle können in der Datenbank oder extern gespeichert werden. Azure SQL Managed Instance unterstützt Machine Learning Services für Python und R als Preview. Mehr erfahren.
Amazon Redshift
Amazon Redshift ist ein verwaltetes, petabytefähiges Data-Warehouse, mit dem du all deine Daten kostengünstig und einfach mit bestehenden BI-Tools analysieren kannst. Es ist für Datensätze von einigen hundert Gigabyte bis zu einem Petabyte und mehr optimiert und kostet weniger als 1.000 $ pro Terabyte und Jahr. Mehr erfahren.
Oracle Database
Oracle Cloud Infrastructure (OCI) Data Science ist eine verwaltete, serverlose Plattform, auf der Data-Science-Teams ML-Modelle mit Oracle Cloud Infrastructure entwickeln, trainieren und verwalten können – inklusive Oracle Autonomous Database und Oracle Autonomous Data Warehouse. Enthalten sind Python-zentrierte Tools, Bibliotheken und Pakete aus der Open-Source-Community sowie die Oracle Accelerated Data Science (ADS) Library für den kompletten Lebenszyklus prädiktiver Modelle. Mehr erfahren.
Google Cloud BigQuery
BigQuery ist das verwaltete, petabytefähige Data-Warehouse von Google Cloud für nahezu Echtzeitanalysen über große Datenmengen. Mit BigQuery ML kannst du ML-Modelle per SQL direkt in BigQuery erstellen und ausführen. Unterstützt werden u. a. lineare Regression für Forecasting, binäre und Multiclass-Logistic-Regression für Klassifikation, K-Means-Clustering für Segmentierung, Matrixfaktorisierung für Produktempfehlungen sowie Zeitreihenprognosen. Mehr erfahren.
IBM Db2 Warehouse
IBM Db2 Warehouse on Cloud ist ein verwalteter Public-Cloud-Service. Alternativ lässt es sich On-Premises auf eigener Hardware oder in einer Private Cloud betreiben. Als Data-Warehouse bietet es u. a. In-Memory-Verarbeitung und spaltenorientierte Tabellen für OLAP. Die Netezza-Technologie stellt einen umfangreichen Analytics-Funktionsumfang bereit, der Abfragen effizient zur den Daten bringt. Mehr erfahren.
BlazingSQL
BlazingSQL ist eine GPU-beschleunigte SQL-Engine auf Basis des RAPIDS-Ökosystems – verfügbar als Open Source und als bezahlter Service. RAPIDS nutzt CUDA und basiert auf dem spaltenorientierten Speicherformat Apache Arrow. Es umfasst Open-Source-Bibliotheken und APIs, initiiert von Nvidia. CuDF, Teil von RAPIDS, ist eine Pandas-ähnliche GPU-DataFrame-Bibliothek zum Laden, Joinen, Aggregieren, Filtern und Transformieren von Daten. Mehr erfahren.
Microsoft SQL Server Machine Learning Services
Machine Learning Services ist ein Feature in SQL Server, mit dem du Python- und R-Skripte mit relationalen Daten ausführen kannst. Du kannst Open-Source-Pakete und -Frameworks sowie Microsoft-Pakete für prädiktive Analysen und Machine Learning nutzen. Die Skripte laufen in der Datenbank, ohne Daten aus SQL Server heraus oder über das Netzwerk zu bewegen. Dieser Abschnitt erklärt die Grundlagen der SQL Server Machine Learning Services und den Einstieg.
Mit SQL Server Machine Learning Services kannst du Python- und R-Skripte in der Datenbank ausführen. Damit bereitest du Daten auf, bereinigst sie, führst Feature Engineering durch und trainierst, bewertest und deployest ML-Modelle direkt in der Datenbank. Die Skripte laufen dort, wo die Daten liegen – ein Transfer über das Netzwerk entfällt.
Unterstützte Python- und R-Versionen
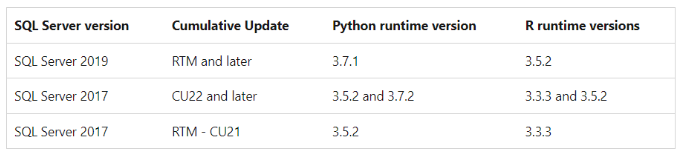
Aktuell werden in SQL Machine Learning Services die folgenden Python- und R-Versionen unterstützt.
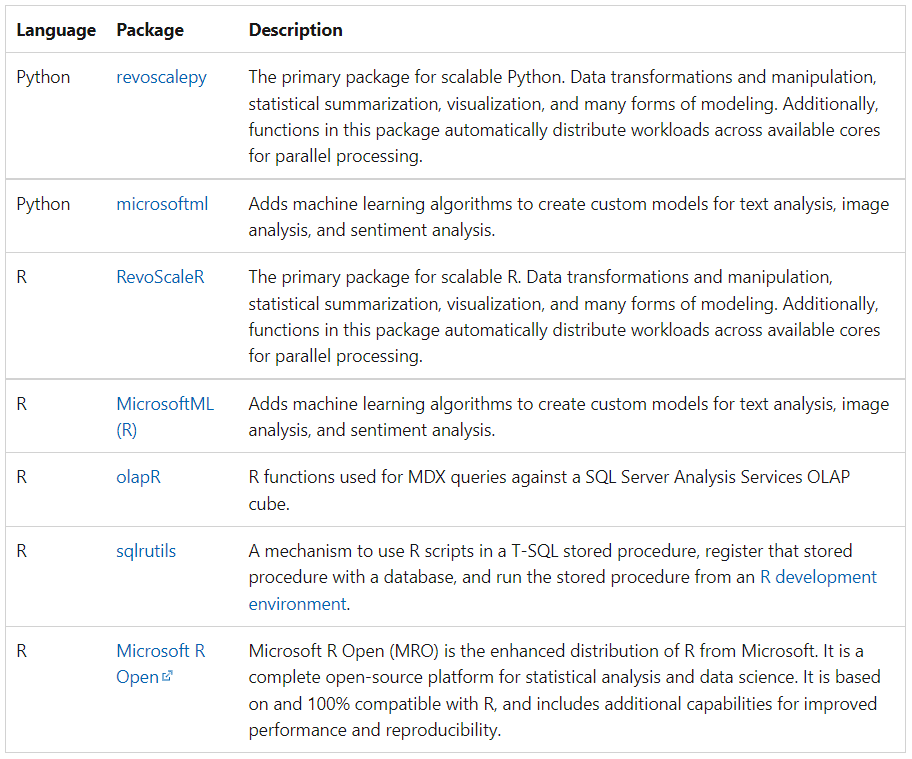
Standardmäßig installierte Python- und R-Bibliotheken
Du kannst beliebige Open-Source-Pakete und -Frameworks einsetzen, aber die folgenden Python- und R-Pakete sind standardmäßig installiert:
PyCaret: Eine Open-Source-Low-Code-ML-Bibliothek
PyCaret ist eine Open-Source-Low-Code-Bibliothek für Machine Learning in Python, die ML-Workflows automatisiert. Als End-to-End-Tool für Machine Learning und Modellmanagement beschleunigt es Experimente massiv und steigert die Produktivität.
Im Vergleich zu anderen Open-Source-ML-Bibliotheken ist PyCaret eine Low-Code-Alternative, die Hunderte Zeilen Code durch wenige Zeilen ersetzt. Das macht Experimente deutlich schneller und effizienter. PyCaret ist im Kern ein Python-Wrapper um verschiedene ML-Bibliotheken und -Frameworks wie scikit-learn, XGBoost, LightGBM, CatBoost, spaCy, Optuna, Hyperopt, Ray und weitere.
Design und Einfachheit von PyCaret sind von der wachsenden Rolle sogenannter Citizen Data Scientists inspiriert – ein Begriff, der erstmals von Gartner geprägt wurde. Citizen Data Scientists sind Power-User, die einfache bis mittelkomplexe analytische Aufgaben erledigen können, für die früher mehr technische Expertise nötig war. Mehr zu PyCaret findest du hier.
Im nächsten Abschnitt installieren wir Microsoft SQL Server und aktivieren die SQL Machine Learning Services. Danach richten wir die Python-Umgebung ein, installieren PyCaret (ML-Bibliothek) und starten mit dem Modelltraining. Los geht’s.
End-to-End-Demo: ML-Modelle in SQL trainieren
SQL Server und Microsoft SSMS herunterladen und installieren
Microsoft SQL Server ist ein relationales Datenbankmanagementsystem von Microsoft. Als Datenbankserver übernimmt er vor allem das Speichern und Abrufen von Daten für unterschiedliche Anwendungen. In diesem Tutorial verwenden wir SQL Server 2019 Developer, um mit PyCaret ein unüberwachtes ML-Modell zu trainieren.
Wenn du SQL Server bereits genutzt hast, ist er vermutlich installiert und du hast Zugriff auf eine Datenbank. Falls nicht, kannst du die Developer Edition von SQL Server 2019 hier herunterladen.
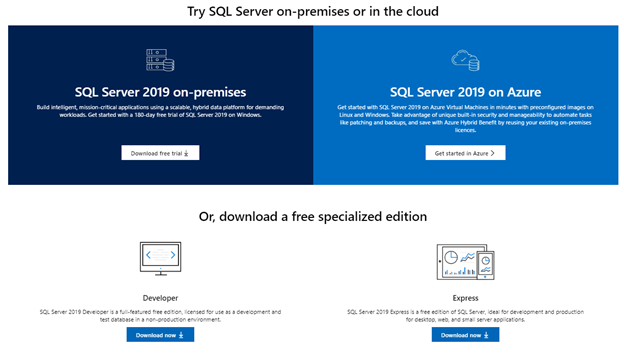
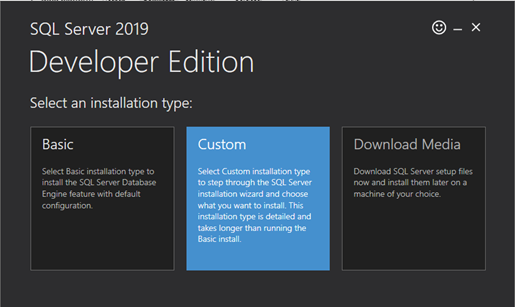
Klicke unter der Developer Edition auf "Download now" und öffne die Installationsdatei. Wähle den Installationstyp "Custom".
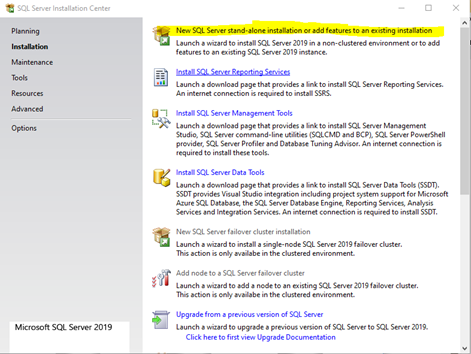
Wähle "New SQL Server stand-alone installation".
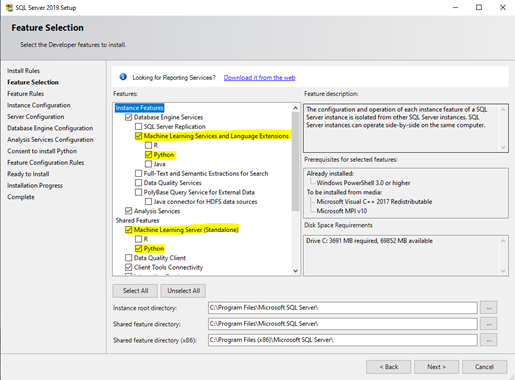
Wähle unter Instance Features die Optionen inklusive "Python" in Machine Learning Services and Language Extensions sowie Machine Learning Server.
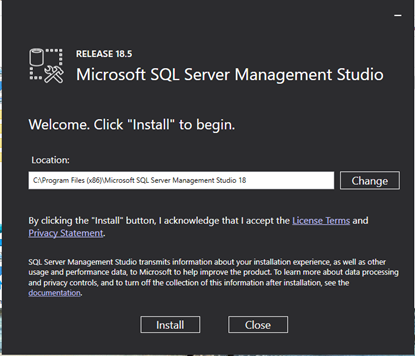
Nach erfolgreicher Installation von SQL Server brauchen wir eine integrierte Entwicklungsumgebung (IDE). Es gibt viele Optionen; in diesem Tutorial nutze ich Microsoft SQL Server Management Studio. Lade den Installer herunter und folge den Anweisungen. Die Installation von SSMS ist unkompliziert.
Neue Datenbank erstellen und CSV importieren
Nachdem SQL Server und SSMS installiert sind, erstellen wir eine neue Datenbank und importieren eine CSV-Datei. Klicke im Object Explorer mit der rechten Maustaste auf Databases und wähle "New Database". Vergib einen Namen und fülle die weiteren Felder aus. Das kann ein paar Minuten dauern.
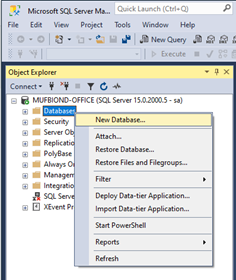
Wenn die Datenbank erstellt ist, importieren wir die CSV-Datei, mit der wir in den nächsten Schritten arbeiten. Lade dir die Beispieldatei herunter und folge dann den Anweisungen.
Klicke mit der rechten Maustaste auf "Tables" → New → Table. Du kannst den Namen frei wählen. Im Beispiel nenne ich die Tabelle "jewelry".
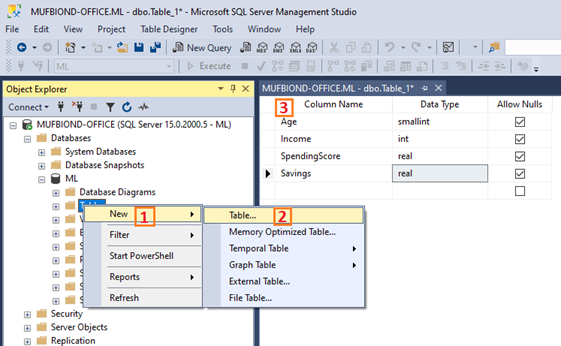
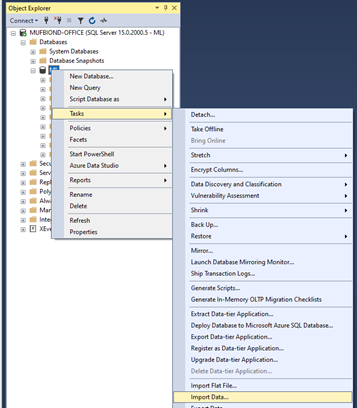
Jetzt, da die Tabelle erstellt ist, füllen wir sie mit Inhalten. Importiere die CSV-Datei in diese Tabelle. Klicke mit der rechten Maustaste auf die Datenbank und wähle Tasks -> Import Data.
Wähle als Data Source "Flat File Source" und suche über Browse die CSV-Datei aus. Nimm dir kurz Zeit für die Konfiguration, bevor du auf Next klickst.
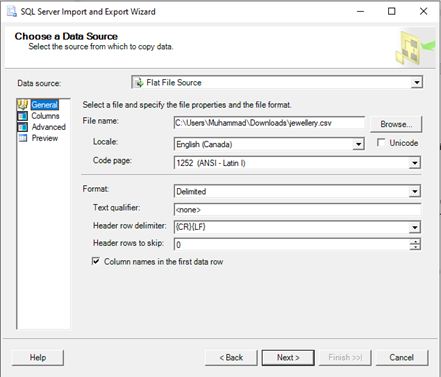
Klicke auf Next, gib die Datenbankdetails ein (Servername, Benutzername, Passwort) und folge den weiteren Schritten. Zum Schluss klickst du auf Finish, um den Import abzuschließen.
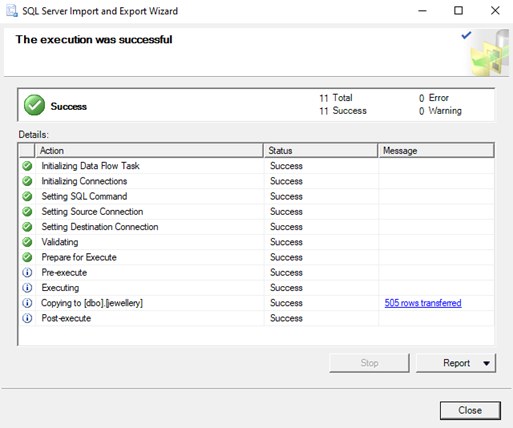
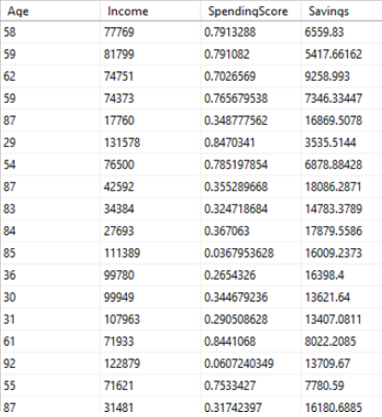
Jetzt haben wir eine Tabelle "jewelry" mit importierten Daten.
Python-Umgebung konfigurieren
Bevor wir ML-Modelle in SQL trainieren, müssen wir Python in SQL konfigurieren. Wir führen Python "innerhalb" des SQL Servers über die Systemprozedur sp_execute_external_script aus. Starte mit "New Query" und führe folgenden Code aus, um die externe Skriptausführung zu aktivieren:
EXEC sp_configure ‘external scripts enabled’, 1

RECONFIGURE WITH OVERRIDE
Starte den SQL Server neu, bevor du fortfährst.
Jetzt legen wir die Sprache fest und prüfen den Installationspfad. Mit Microsoft SQL Machine Learning Service hast du zwei Optionen: R oder Python. In diesem Beispiel verwenden wir Python bzw. konkret PyCaret (eine Python-Bibliothek für Machine Learning), um ein unüberwachtes Clustering-Modell auf dem "jewelry"-Datensatz zu trainieren.
EXECUTE sp_execute_external_script

@language =N’Python’,

@script=N’import sys; print(“\n”.join(sys.path))’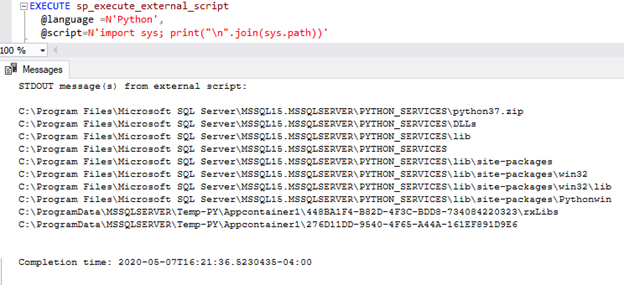
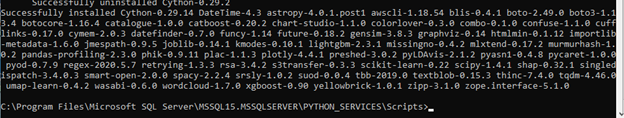
Der letzte Schritt vor dem Training ist die Installation der PyCaret-Bibliothek. Öffne dazu eine Eingabeaufforderung und wechsle in das Verzeichnis der Python-Pakete der SQL-Server-Installation (siehe Pfad oben). Führe folgenden Befehl aus:
pip.exe install pycaret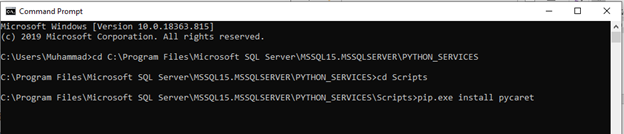
Die Installation kann 10–15 Minuten dauern. Anschließend sieht es so aus:
Wechsle nun zurück in Microsoft SSMS.
Unüberwachtes Clustering-Modell trainieren
Clustering gruppiert Datenpunkte mit ähnlichen Merkmalen. Solche Gruppen helfen beim Explorieren der Daten, beim Erkennen von Mustern und bei Analysen auf Teilmengen. Häufige Business-Use-Cases für Clustering sind:
- Kundensegmentierung für Marketingzwecke.
- Analyse des Kaufverhaltens für Aktionen und Rabatte.
- Identifikation von geografischen Clustern bei Ausbrüchen wie COVID-19.
Pro Kundin/Kunde liegen vier Datenpunkte vor, die so aussehen:
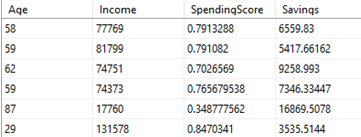
Unser Ziel ist es, ein KMeans-Clustering-Modell auf diesem Datensatz zu trainieren und eine neue Spalte "Cluster" zu erzeugen, die die jeweilige Kundengruppe angibt.
EXECUTE sp_execute_external_script

@language = N’Python’,

@script = N’dataset = InputDataSet

import pycaret.clustering as pc

dataset = pc.get_clusters(data = dataset, num_clusters=4)

OutputDataSet = dataset’,

@input_data_1 = N’SELECT [Age], [Income], [SpendingScore], [Savings] FROM [jewellery]’

WITH RESULT SETS(([Age] INT, [Income] INT, [SpendingScore] FLOAT, [Savings] FLOAT, [Cluster] varchar(15)));
Ausgabe:
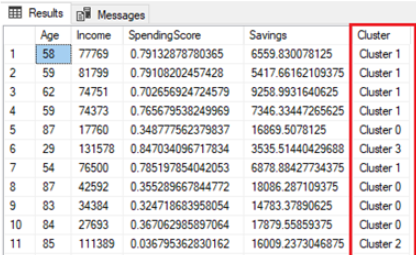
Beachte, wie einfach das war. Mit nur einer Zeile `pc.get_clusters(...)` haben wir die Daten vorverarbeitet, ein unüberwachtes KMeans-Modell trainiert und die Clusterlabels erzeugt – und das alles, ohne die SQL-Server-Umgebung zu verlassen. Analog zum Clustering unterstützt PyCaret auch unüberwachte Anomalieerkennung mit dem `pc.get_anomaly`-Befehl. Du kannst zudem überwachte ML-Modelle (Klassifikation oder Regression) trainieren, das Modell in einer SQL-Prozedur speichern und es später für Inferenz verwenden – direkt aus deiner Datenbank heraus.
Fazit
Was bedeutet Machine Learning in der Datenbank für dein Unternehmen? Du reduzierst die Anzahl notwendiger Schritte für schnelleres, effizienteres und einfacher zu operationalisierendes Machine Learning. Das Training in der Datenbank minimiert Datenbewegungen – das spart Zeit und Kosten. Eine Allzwecklösung ist es dennoch nicht. Ob du diesen Ansatz wählst, hängt immer vom Use Case ab. Hoffentlich hat dir dieses Tutorial neue Perspektiven auf die Möglichkeiten von Machine Learning in Enterprise-Umgebungen eröffnet.
Wenn du mehr darüber lernen willst, wie Python und SQL zusammen deine Datenanalyse und Effizienz verbessern, empfehle ich dir den Kurs Introduction to Databases in Python. Darin lernst du die Grundlagen der Arbeit mit SQL in Python. Das ist wertvoll, weil Datenbanken allgegenwärtig sind und Data Scientists, Analystinnen/Analysten und Engineers ständig mit ihnen arbeiten. Das Python-SQL-Toolkit SQLAlchemy bietet einen einfachen, intuitiven Weg, um essenzielle Datenbanken wie SQLite, MySQL und PostgreSQL abzufragen, aufzubauen und zu beschreiben.