Saat membuat keputusan berbasis data, banyak pakar industri masih ragu bahwa algoritma prediksi yang lazim digunakan tidak selalu andal. Misalnya, jumlah cokelat yang dikonsumsi per kapita sangat prediktif terhadap jumlah peraih Nobel di suatu negara, dan ada korelasi antara penjualan es krim dan serangan hiu. Namun, ini tidak berarti bahwa mengundang banyak hiu ke pantai adalah ide bagus untuk mendongkrak bisnis es krim kita.
Taruhan di sini, tentu saja, adalah konsep yang sudah akrab: “korelasi tidak menyiratkan kausalitas.” Hanya karena dua variabel berkorelasi, bukan berarti kita dapat menggunakan yang satu untuk memengaruhi yang lain. Keduanya bisa jadi didorong oleh variabel ketiga, seperti “cuaca cerah” pada contoh serangan hiu dan penjualan es krim, yang bertindak sebagai penyebab umum bagi keduanya. Di saat yang sama, memahami akar penyebab suatu fenomena dan menggunakan analitik data untuk mendorong perubahan adalah tugas krusial bagi bisnis mana pun. Itulah sebabnya banyak pemimpin industri, seperti Microsoft, Amazon, Uber, Spotify, McKinsey, dan banyak lainnya mulai berinvestasi besar-besaran pada kapabilitas AI kausal mereka.
Tutorial ini membahas beberapa konsep dan gagasan fundamental AI kausal menggunakan pustaka DoWhy di Python. Inferensi kausal secara konseptual cukup berbeda dari pembelajaran mesin standar, sehingga kebanyakan orang memulai dengan bekal pengetahuan terbatas. Namun, pengetahuan dasar analisis regresi dan pemodelan statistik akan membantu Anda mengikuti pembahasan. Jika Anda baru dalam analisis regresi atau perlu penyegaran, pertimbangkan mengikuti kursus DataCamp Introduction to Linear Modeling in Python.
Anda juga dapat mengeksplorasi perbedaan antara model prediktif dan kausal dalam kursus DataCamp, Machine Learning for Business.
Komponen Penyusun AI Kausal
Saat berbicara tentang inferensi kausal, kita perlu mengadopsi pola pikir yang berbeda dari pembelajaran mesin standar dan analitik prediktif.
Filsuf Nancy Cartwright mencetuskan frasa: “No causes in, no causes out.” Artinya, kita perlu membuat asumsi tentang struktur kausal yang mendasari fenomena yang kita pelajari agar bisa mendapatkan jawaban kausal. Pendekatan yang murni berbasis data tidak akan cukup.
Ini mungkin terdengar sirkular pada awalnya, tetapi sebenarnya tidak.
Jika kita ingin tahu apakah korelasi antara konsumsi cokelat dan peraih Nobel bersifat kausal, kita perlu menepis penjelasan alternatif. Penjelasan alternatif itu merupakan pengetahuan kausal yang tidak selalu kita temukan dalam data itu sendiri, melainkan harus kita bawa dari luar.
Misalkan kita sedang mempertimbangkan untuk memperkenalkan kebijakan bekerja dari rumah (WFH) dan ingin tahu apakah itu akan memengaruhi produktivitas karyawan. Analisis awal menunjukkan bahwa anggota tim yang bekerja dari rumah menyelesaikan lebih banyak tugas setiap hari.
Namun, bisakah kita yakin bahwa korelasi ini akan tetap ada setelah kebijakan diterapkan untuk semua orang? Dengan kata lain, bisakah kita memastikan bahwa hubungan antara WFH dan produktivitas bersifat kausal?
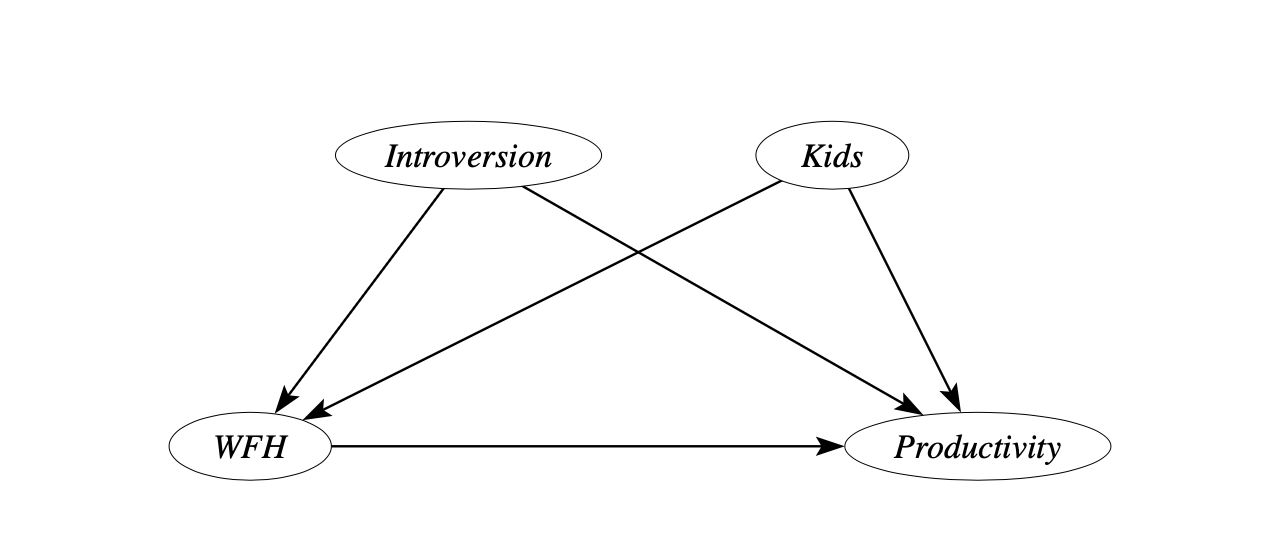
Catatan: Grafik dibuat oleh causalfusion.net
Model kausal sederhana untuk konteks ini bisa terlihat seperti ini.
Kita berasumsi bahwa bekerja dari rumah memiliki efek pada produktivitas, tetapi kita tidak tahu arah atau kekuatan efek tersebut. Pada saat yang sama, bisa ada alasan lain mengapa kita melihat tingkat produktivitas yang lebih tinggi pada orang yang bekerja dari rumah.
Karyawan dengan anak atau mereka yang cukup introvert, dan tidak tahan dengan kebisingan di kantor berkonsep ruang terbuka besar, mungkin memutuskan untuk lebih sering bekerja dari rumah karena lebih nyaman bagi mereka. Variabel-variabel ini sendiri mungkin terkait dengan produktivitas, yang menjadikannya kemungkinan penyebab umum yang juga bisa menjadi sumber korelasi.
Untuk membuat semua asumsi ini eksplisit, kita menggambarkannya dalam apa yang disebut sebagai grafik kausal, yaitu representasi grafis yang digunakan untuk memodelkan hubungan antarvariabel dalam suatu sistem, dengan fokus khusus pada hubungan kausal.
Anda akan mendapati bahwa beberapa asumsi ini bisa jadi cukup kuat dalam skenario dunia nyata. Keuntungan besar dari grafik kausal adalah membuat asumsi dan pengetahuan awal menjadi sangat eksplisit, tetapi kita harus selalu siap menantang dan menyempurnakannya agar analisis kita kredibel.
Memulai dengan DoWhy di Python
Pustaka DoWhy dari Microsoft, yang dikembangkan bersama Amazon Web Services sebagai bagian dari ekosistem PyWhy, dengan cepat menjadi standar industri untuk analisis kausal di ekosistem Python. Kita dapat menggunakan DoWhy untuk mensimulasikan set data sesuai model kausal di atas, menggambarkan beberapa langkah fundamental dalam alur kerja inferensi kausal. Pertama, kita perlu memasang DoWhy di lingkungan kita.
!pip install git+https://github.com/microsoft/dowhy.gitSetelah selesai, kita dapat memuat pustaka yang diperlukan.
import numpy as np
import pandas as pd
import dowhy
Sekarang, mari kita buat dataset sendiri. Keuntungan utama bekerja dengan data tersimulasikan saat mempelajari AI kausal adalah kita memiliki kendali penuh atas proses pembangkitan data dan mengetahui “kebenaran dasar” (ground truth), yang tidak akan terjadi pada data dunia nyata.
Kita menetapkan efek kausal sebenarnya sama dengan satu (beta=1), menentukan dua penyebab umum, dan membuat sepuluh ribu sampel menurut hubungan linear sederhana antarvariabel dalam model.
Variabel yang kita amati sebagai perlakuan (treatment) diatur menjadi biner, artinya bisa nol atau satu.
Sebelumnya, kita menetapkan titik awal tetap untuk pembangkitan angka acak — using np.random.seed(1) — agar memungkinkan reproduksi dataset secara presisi.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy memberikan label sebagai berikut:
Tabel 1
|
Label |
Variabel |
Jenis |
Rata-rata |
|
v0 |
Variabel perlakuan, yang merupakan variabel utama dalam analisis kita (bekerja dari rumah) |
Biner |
0.608 |
|
y |
Hasil yang diminati (produktivitas) |
Kontinu |
1.583 |
|
W0 |
Keintrovertan |
Kontinu |
-0.148 |
|
W1 |
Jumlah Anak |
Kategorikal |
1.5 |
|
Z0 |
Variabel instrumental yang hanya memengaruhi v0, bukan y (penutupan kereta bawah tanah) |
Biner |
0.281 |
Di sini, kita secara implisit telah mendefinisikan grafik kausal dengan menetapkan jenis perlakuan dan jumlah penyebab umum. DoWhy menyimpan objek grafik dalam bahasa DOT, yang memberi kita cara yang mudah untuk menentukan grafik kausal berarah (digraph) kita sendiri saat bekerja dengan data dunia nyata.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Akhirnya, kita menggabungkan semua informasi ini ke dalam satu model kausal tunggal.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Membuka Daya AI Kausal
Sebelum kita melakukan analisis kausal, mari membandingkannya dengan apa yang akan dikatakan pendekatan naif berbasis algoritma prediksi linear sederhana.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
Koefisien kemiringan pada regresi bivariat sama dengan 1,298. Namun, kita tahu bahwa efek kausal sebenarnya sama dengan satu, karena kita membangkitkan data dengan cara tersebut.
Ini menyiratkan bahwa dua penyebab umum, keintrovertan dan memiliki anak, yang keduanya memengaruhi produktivitas dan kemungkinan bekerja dari rumah, menyebabkan estimasi berlebih hampir 30% dalam kasus ini.
Untungnya, selama kita memiliki data tentang variabel-variabel ini, kita dapat dengan mudah mengatasi bias ini dengan memasukkan penyebab umum dalam analisis multivariat.
Dalam literatur AI kausal, ini dikenal sebagai kriteria backdoor. Kita ingin mengontrol semua variabel dalam grafik kausal yang mengarah ke variabel perlakuan. Mereka “masuk melalui pintu belakang” dan karenanya berpotensi menciptakan korelasi semu antara perlakuan dan hasil yang bukan kausal. Dalam contoh kita, ini berlaku untuk keintrovertan dan jumlah anak.
WFH <— Keintrovertan —> Produktivitas
WFH <— Anak —> Produktivitas
DoWhy menawarkan berbagai algoritma yang dapat digunakan untuk menentukan apakah efek kausal yang diinginkan dapat diidentifikasi ketika diberikan model kausal tertentu.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Tak mengherankan, dalam model kausal sederhana kita untuk efek bekerja dari rumah, identifikasi kausal dimungkinkan.
Selanjutnya, kita dapat fokus pada estimasi, yaitu proses mengukur efek target menggunakan data yang tersedia.
DoWhy menawarkan sejumlah algoritma untuk dipilih, termasuk estimator regresi, pencocokan, stratifikasi, dan pembobotan. Karena data dasar yang kita simulasikan didasarkan pada hubungan linear, regresi sederhana sudah memadai. Jika Anda perlu penyegaran, kursus DataCamp Intro to Regression with statsmodels in Python dapat membantu.
Namun, untuk membuat analisis kita lebih umum, kita akan menggunakan inverse probability weighting, yang juga mampu menangani data nonlinier.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy menghasilkan estimasi efek kausal sebesar 1,001. Tentu saja, angka sebenarnya tidak terlalu bermakna dalam konteks simulasi ini. Namun, yang penting adalah kita sangat dekat dengan kebenaran dasar, yaitu satu. Dibandingkan dengan regresi yang kita jalankan sebelumnya, biasnya berkurang hingga 99,6%.
Uji Ketahanan Hasil Anda
Semua itu sangat mengesankan, tetapi kita tidak boleh berhenti di sana.
Prinsip “no causes in, no causes out” memberi tahu kita bahwa analisis kausal apa pun hanya sebaik asumsi yang kita bawa ke meja.
Misalnya, bagaimana kita bisa yakin bahwa hanya keintrovertan dan anak yang memengaruhi WFH, seperti yang ditetapkan oleh model kausal sederhana kita?
Untuk meningkatkan keyakinan pada asumsi kita, DoWhy menyediakan serangkaian uji bantahan yang memungkinkan kita melakukan stress test pada analisis, termasuk namun tidak terbatas pada pengujian dengan subsampel atau perlakuan plasebo.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
Mari kita lihat apa yang terjadi jika kita menambahkan satu lagi penyebab umum selain keintrovertan dan anak.
Kali ini, kita tidak memiliki data tentang variabel ini, sehingga tetap tidak teramati. Seberapa andal estimasi kita? Sayangnya, jawabannya kurang meyakinkan.
Grafik pada Gambar 2 menggambarkan pengaruh besar yang dapat dimiliki penyebab umum yang tidak teramati terhadap efek kausal yang diestimasi, berkisar dari -0,222 hingga 1,003. Rentang ini begitu lebar sehingga berpotensi menggandakan efek yang diestimasi.
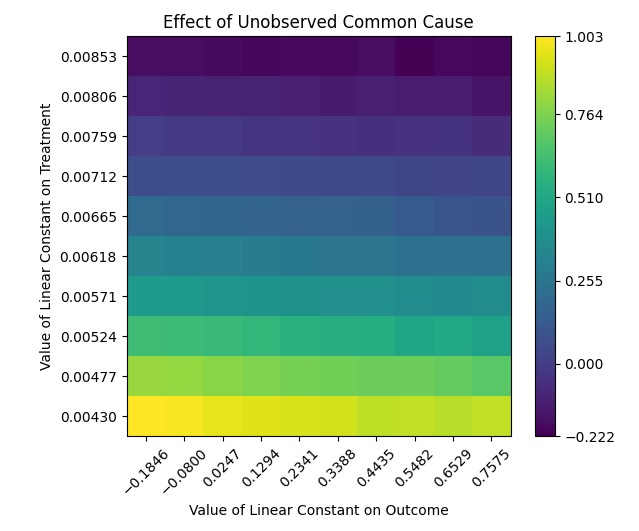
Namun itu tidak terlalu mengejutkan. Mekanisme kausal alternatif yang melibatkan variabel tak teramati yang tidak dapat kita perhitungkan dalam analisis selalu menjadi masalah dalam studi kausal.
Untungnya, ada cara alternatif untuk mencapai identifikasi dalam konteks ini, dan DoWhy cukup cerdas untuk menemukannya bagi kita.
Menemukan Strategi Kausal Alternatif
Meskipun karyawan yang introvert dan yang memiliki anak mungkin lebih sering bekerja dari rumah, mungkin ada penentu WFH lain yang tidak terkait dengan produktivitas.
Misalnya terjadi gangguan besar pada transportasi publik, dan salah satu jalur kereta bawah tanah di kota kita harus ditutup selama tiga bulan. Akibatnya, karyawan yang tinggal di distrik dekat jalur tersebut lebih mungkin untuk bekerja dari rumah, meskipun mereka sebenarnya lebih suka datang ke kantor.
Kita dapat menggambarkan model kausal yang ditambah ini sebagai berikut.
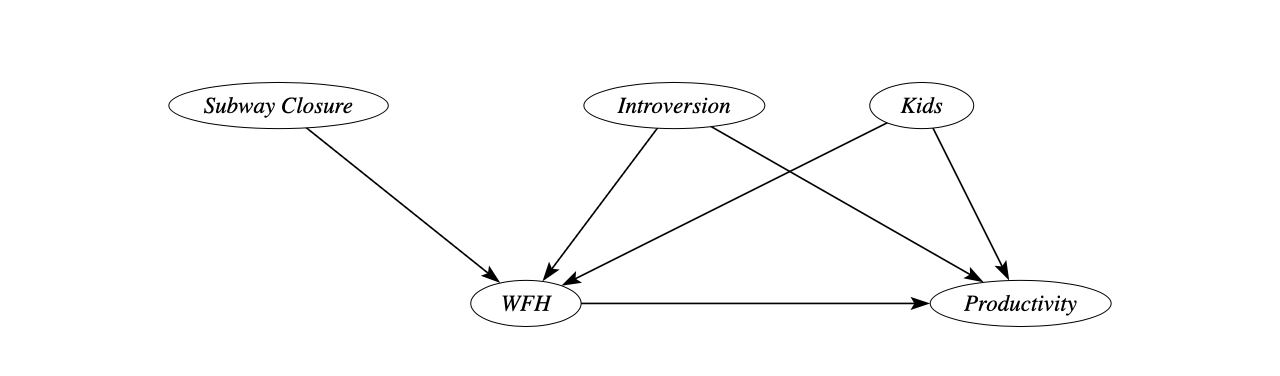
Dalam kasus ini, penutupan kereta bawah tanah bertindak sebagai variabel instrumental.
Secara intuitif, penutupan itu bertindak sebagai guncangan terhadap jadwal perjalanan orang, menciptakan semacam eksperimen alamiah.
Selama tiga bulan, mereka yang tinggal dekat jalur yang terganggu akan lebih sering bekerja dari rumah, tetapi ini tidak memiliki hubungan lain dengan produktivitas mereka. Anda mungkin menyadari bahwa kita sudah menyertakan variabel instrumental seperti itu, Z0, dalam pembuatan set data simulasi di atas dengan menetapkan opsi num_instruments=1. Fungsi DoWhy identify_effect() kemudian mampu secara otomatis menemukan variabel instrumental yang sesuai dalam grafik kausal.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Setelah mengestimasi, kita dapati bahwa efek kausalnya 0,920. Ini sedikit kurang akurat dibanding strategi backdoor tetapi masih jauh lebih akurat daripada prediksi naif.
Estimasi variabel instrumental menguntungkan karena tidak bergantung pada asumsi tentang jumlah penyebab umum tak teramati dari WFH dan produktivitas.
Dengan demikian, meskipun estimasi kita mungkin kurang presisi, estimasi tersebut lebih tangguh karena asumsinya lebih lemah. Ini adalah pertukaran umum dalam analisis kausal.
Langkah Selanjutnya?
DoWhy adalah tempat yang sangat baik untuk memulai dengan AI kausal. Ini adalah pustaka end-to-end yang kuat yang menyediakan alur kerja inferensi kausal serbaguna, membimbing pengguna melalui langkah-langkah penting.
Setelah Anda memahami alur kerja fundamental, Anda dapat melangkah ke topik yang lebih maju seperti penemuan kausal dan memperkuat analisis dengan pustaka tambahan seperti DoubleML, atau daggity, ggdag, dan pcalg di R. Setelah Anda nyaman dengan dasar-dasarnya, Anda mungkin ingin mengeksplorasi topik yang lebih lanjut dalam inferensi kausal. Kursus DataCamp Advanced Causal Inference with R adalah langkah lanjutan yang bagus.
Inferensi kausal menawarkan sudut pandang baru terhadap analisis data. Sebagian besar pendekatan bergantung pada pemahaman tentang grafik kausal atau asumsi kausal lainnya. Kuncinya adalah memilih teknik dan asumsi yang sesuai dengan situasi Anda. Ini memerlukan pengetahuan eksternal dan keahlian domain.
Karena itu, sebaiknya berkonsultasi dengan pakar pemasaran atau spesialis SDM Anda untuk mendapatkan pandangan mereka tentang suatu isu dan melihat apakah mereka dapat membantu Anda menyusun model yang sesuai.
Pengetahuan kausal sangat penting dalam banyak konteks bisnis. Kita perlu memahami, misalnya, apakah peluncuran produk baru kita berhasil atau seberapa efektif strategi periklanan kita.
Memperoleh jawaban kausal dari data mungkin lebih sulit daripada melatih algoritma prediksi sederhana, tetapi upaya tersebut sepadan. Dan pustaka seperti DoWhy menyediakan seperangkat alat hebat yang akan membantu Anda menemukan solusi yang paling sesuai dengan kebutuhan Anda.
Jika Anda merasa tutorial ini mencerahkan dan ingin menerapkan teknik AI kausal dalam proyek Anda sendiri, tidak ada waktu yang lebih baik untuk memperdalam pemahaman. Dalam kursus komprehensif Machine Learning for Business, Anda akan mempelajari bukan hanya model prediktif tetapi juga model kausal yang dapat membantu Anda membuat keputusan bisnis yang lebih baik.