Quando o assunto é tomar decisões baseadas em dados, muitos especialistas do mercado ficam com a pulga atrás da orelha: os algoritmos de predição mais usados não são sempre confiáveis. Por exemplo, a quantidade de chocolate consumido per capita é altamente preditiva do número de vencedores do Prêmio Nobel em um país, e existe correlação entre vendas de sorvete e ataques de tubarão. Mas isso não significa que faz sentido atrair um monte de tubarões para a praia para bombar nosso negócio de sorvetes.
O ponto aqui é o velho conhecido “correlação não implica causalidade”. Só porque duas variáveis estão correlacionadas, não quer dizer que podemos usar uma para afetar a outra. As duas podem ser impulsionadas por uma terceira variável, como “tempo ensolarado” no exemplo dos tubarões e do sorvete, que atua como causa comum. Ao mesmo tempo, entender as causas-raiz dos fenômenos e usar análise de dados para promover mudanças é essencial para qualquer negócio. Por isso muitas líderes do mercado, como Microsoft, Amazon, Uber, Spotify, McKinsey e várias outras, estão investindo pesado em capacidades de IA causal.
Este tutorial apresenta alguns dos conceitos e ideias fundamentais de IA causal usando a biblioteca DoWhy em Python. A inferência causal é conceitualmente bem diferente do machine learning padrão, então muita gente começa com pouca base. No entanto, conhecimentos básicos de análise de regressão e modelagem estatística ajudam bastante a acompanhar. Se você é novo em regressão ou quer relembrar, confira o curso da DataCamp Introduction to Linear Modeling in Python.
Você também pode explorar as diferenças entre modelos preditivos e causais no curso da DataCamp Machine Learning for Business.
Os blocos de construção da IA causal
Quando falamos de inferência causal, precisamos adotar uma mentalidade diferente do machine learning e da análise preditiva convencionais.
A filósofa Nancy Cartwright cunhou a frase: “Sem causas na entrada, sem causas na saída.” Isso significa que precisamos fazer suposições sobre a estrutura causal por trás do fenômeno estudado para obter respostas causais. Uma abordagem puramente orientada por dados não basta.
Pode soar circular à primeira vista, mas não é.
Se quisermos saber se a correlação entre consumo de chocolate e laureados com Nobel é causal, precisamos descartar explicações alternativas. Essas explicações alternativas constituem conhecimento causal que nem sempre está nos dados em si, mas que precisamos trazer de fora.
Digamos que estamos cogitando adotar uma política de trabalho remoto (WFH) e queremos saber se isso vai afetar a produtividade. Uma análise inicial mostrou que quem trabalha de casa conclui mais tarefas por dia.
No entanto, podemos ter certeza de que essa correlação vai se manter quando a política for implantada para todos? Em outras palavras, podemos afirmar que a relação entre WFH e produtividade é causal?
Observação: gráfico criado por causalfusion.net
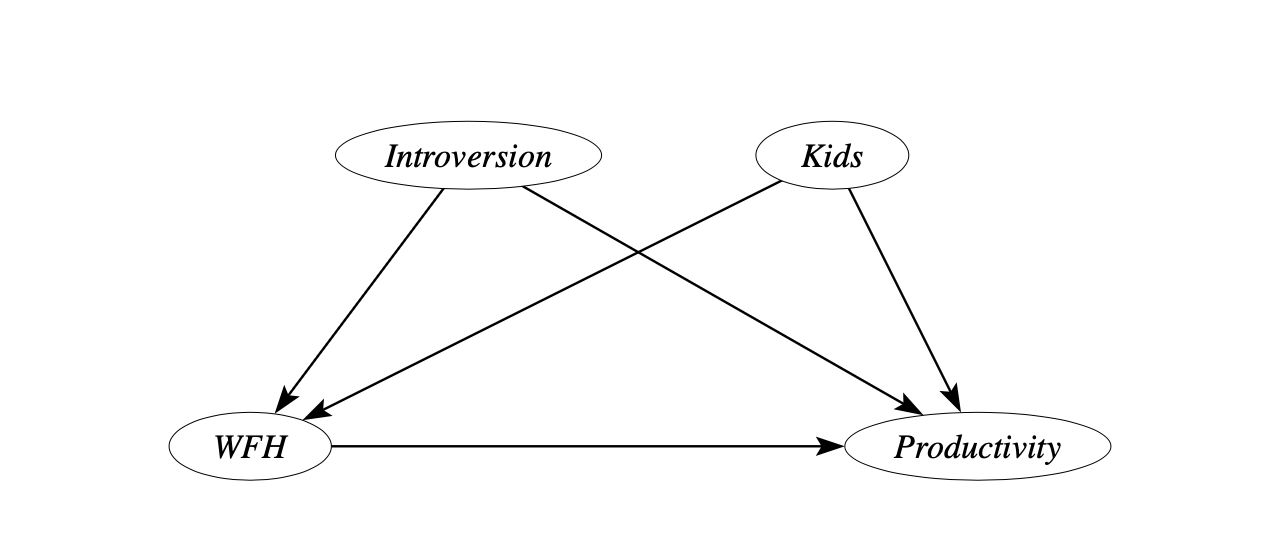
Um modelo causal simples para esse contexto poderia ser assim.
Presumimos que trabalhar de casa tem efeito sobre a produtividade, mas não sabemos a direção nem a intensidade. Ao mesmo tempo, podem existir outros motivos para vermos maior produtividade entre quem trabalha de casa.
Funcionários com filhos, ou mais introvertidos, que não lidam bem com o barulho dos nossos escritórios em open space, podem decidir trabalhar mais de casa por ser mais conveniente. Essas variáveis podem estar ligadas à produtividade, tornando-se causas comuns e também origem da correlação.
Para deixar todas essas suposições explícitas, representamos tudo em um grafo causal, uma representação gráfica usada para modelar as relações entre variáveis em um sistema, com foco específico nas relações causais.
Você vai notar que algumas suposições podem ser bem fortes em cenários reais. A grande vantagem é que grafos causais tornam suposições e conhecimento prévio muito explícitos, mas é preciso sempre estar pronto para questioná-los e refiná-los para dar credibilidade às análises.
Começando com o DoWhy em Python
A biblioteca DoWhy, da Microsoft e desenvolvida em colaboração com a Amazon Web Services como parte do ecossistema PyWhy, está se tornando padrão do mercado para análise causal no universo Python. Podemos usar o DoWhy para simular um conjunto de dados de acordo com nosso modelo causal acima, ilustrando etapas fundamentais do pipeline de inferência causal. Primeiro, precisamos instalar o DoWhy no ambiente.
!pip install git+https://github.com/microsoft/dowhy.gitFeito isso, carregamos as bibliotecas necessárias.
import numpy as np
import pandas as pd
import dowhy
Agora, vamos criar nosso próprio dataset. O grande benefício de trabalhar com dados simulados ao estudar IA causal é ter controle total sobre o processo gerador de dados e conhecer a “verdade de base” (ground truth), o que não acontece com dados do mundo real.
Definimos o efeito causal verdadeiro igual a 1 (beta=1), especificamos duas causas comuns e criamos dez mil amostras segundo relações lineares simples entre as variáveis do modelo.
A variável de tratamento que estamos analisando é binária, podendo ser zero ou um.
Antes, definimos um ponto de origem fixo para a geração de números aleatórios — using np.random.seed(1) — para permitir a reprodução exata do nosso dataset.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
O DoWhy atribui os seguintes rótulos:
Tabela 1
|
Rótulo |
Variável |
Tipo |
Média |
|
v0 |
Variável de tratamento, principal variável de interesse na análise (trabalho remoto) |
Binária |
0,608 |
|
y |
Desfecho de interesse (produtividade) |
Contínua |
1,583 |
|
W0 |
Introversão |
Contínua |
-0,148 |
|
W1 |
Número de filhos |
Categórica |
1,5 |
|
Z0 |
Uma variável instrumental que afeta apenas v0, não y (interdição do metrô) |
Binária |
0,281 |
Aqui, definimos implicitamente um grafo causal ao configurar o tipo de tratamento e o número de causas comuns. O DoWhy armazena objetos de grafo na linguagem DOT, o que nos dá uma forma prática de especificar nosso próprio grafo causal direcionado (digraph) quando estivermos trabalhando com dados reais.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Por fim, juntamos tudo em um único modelo causal.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Liberando o potencial da IA causal
Antes de rodarmos a análise causal, vamos fazer um benchmark com o que uma abordagem ingênua, baseada em uma predição linear simples, diria.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
O coeficiente angular em uma regressão bivariada é igual a 1,298. No entanto, sabemos que o efeito causal verdadeiro é 1, pois geramos os dados assim.
Isso implica que as duas causas comuns — introversão e ter filhos —, que influenciam tanto a produtividade quanto a probabilidade de trabalhar de casa, levam a uma superestimação de quase 30% neste caso.
Felizmente, enquanto tivermos dados sobre essas variáveis, podemos corrigir facilmente esse viés incluindo as causas comuns em uma análise multivariada.
Na literatura de IA causal, isso é conhecido como critério do backdoor. Queremos controlar todas as variáveis no grafo causal que apontam para a variável de tratamento. Elas “entram pela porta dos fundos” e podem criar uma correlação espúria entre tratamento e desfecho que não é causal. No nosso exemplo, isso se aplica à introversão e ao número de filhos.
WFH <— Introversão —> Produtividade
WFH <— Filhos —> Produtividade
O DoWhy oferece uma série de algoritmos para verificar se um efeito causal desejado pode ser identificado dado um determinado modelo causal.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Como esperado, em nosso modelo causal simples para o efeito do trabalho remoto, a identificação causal é possível.
Em seguida, focamos na estimação, que é o processo de quantificar o efeito-alvo usando os dados disponíveis.
O DoWhy oferece diversos algoritmos, incluindo regressão, pareamento, estratificação e ponderação. Como os dados simulados foram baseados em relações lineares, uma simples regressão já resolveria. Se precisar relembrar, o curso da DataCamp Intro to Regression with statsmodels in Python pode ajudar.
No entanto, para tornar nossa análise mais geral, vamos usar a ponderação por probabilidade inversa, que também lida bem com dados não lineares.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
O DoWhy retorna uma estimativa de efeito causal igual a 1,001. Claro, os números em si não são tão relevantes neste contexto simulado. O importante é estarmos muito próximos da verdade de base igual a 1. Comparado à regressão anterior, o viés caiu impressionantes 99,6%.
Colocando seus resultados à prova
Tudo muito bom, mas não devemos parar por aqui.
O princípio “sem causas na entrada, sem causas na saída” nos lembra que qualquer análise causal só é tão boa quanto as suposições que trazemos para a mesa.
Por exemplo, como ter certeza de que só introversão e filhos afetam o WFH, como nosso modelo simples supõe?
Para ganhar mais confiança nas suposições, o DoWhy oferece uma série de testes de refutação para estressar a análise, incluindo testes com subamostras ou tratamentos placebo.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
Vamos ver o que acontece se adicionarmos outra causa comum, além de introversão e filhos.
Desta vez, não temos dados sobre essa variável, então ela permanece não observada. Quão confiáveis são nossas estimativas? Infelizmente, a resposta não é muito animadora.
O gráfico da Figura 2 ilustra a influência substancial que causas comuns não observadas podem ter sobre o efeito causal estimado, variando de -0,222 a 1,003. Essa faixa é tão ampla que pode até dobrar o efeito estimado.
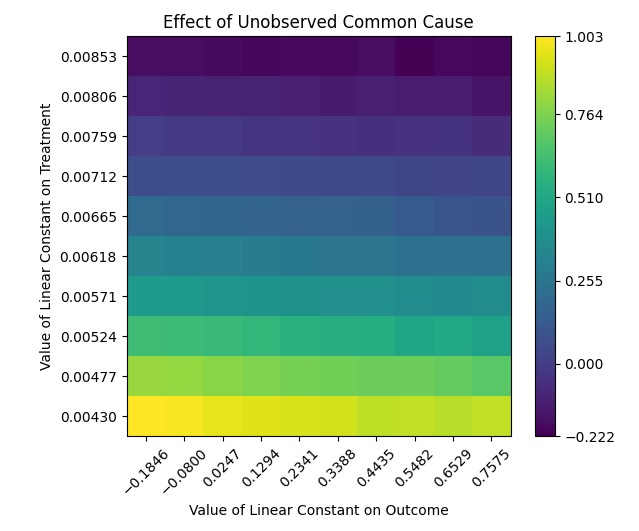
Nada surpreendente. Mecanismos causais alternativos envolvendo variáveis não observadas, que não conseguimos considerar na análise, sempre serão um problema em estudos causais.
Felizmente, há uma forma alternativa de obter identificação nesse contexto, e o DoWhy é esperto o suficiente para descobri-la.
Encontrando estratégias causais alternativas
Embora colaboradores introvertidos e com filhos possam trabalhar mais de casa, podem existir outros determinantes de WFH que não têm relação com produtividade.
Suponha que houve um grande problema no transporte público e uma das linhas de metrô da cidade ficou fechada por três meses. Como resultado, quem mora perto da linha passou a trabalhar mais de casa, mesmo que preferisse vir ao escritório.
Podemos ilustrar esse modelo causal ampliado assim:
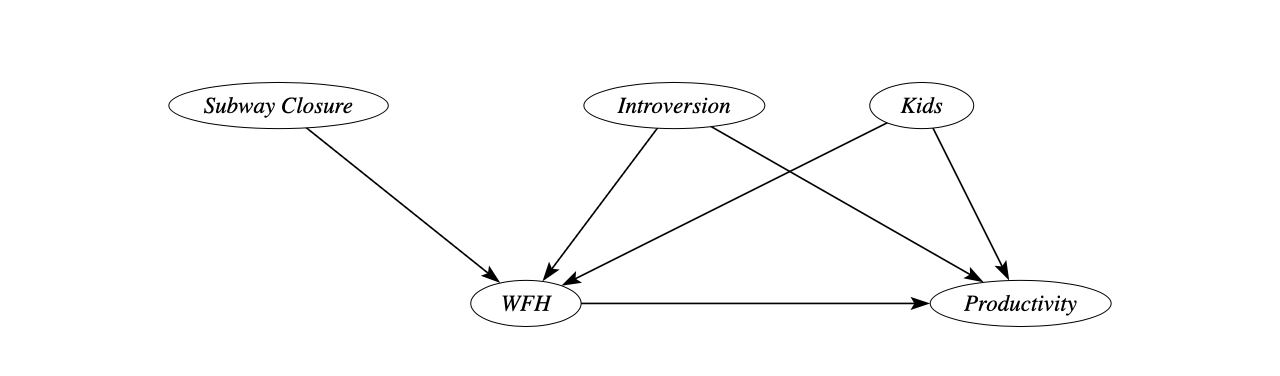
Nesse caso, a interdição do metrô atua como uma variável instrumental.
De forma intuitiva, o fechamento funciona como um choque nos deslocamentos, criando um tipo de experimento natural.
Durante três meses, quem mora próximo à linha afetada trabalhará mais de casa, mas isso não tem outra relação com sua produtividade. Você deve ter notado que já incluímos uma variável instrumental, Z0, na criação do dataset simulado acima ao definir num_instruments=1. A função identify_effect() do DoWhy consegue encontrar automaticamente variáveis instrumentais adequadas no grafo causal.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Após a estimação, encontramos um efeito causal de 0,920. É um pouco menos preciso que a estratégia do backdoor, mas ainda bem mais preciso que a predição ingênua.
A estimação por variável instrumental é vantajosa porque não depende de suposições sobre o número de causas comuns não observadas de WFH e produtividade.
Assim, embora nossas estimativas possam ser menos precisas, elas são mais robustas devido às suposições mais fracas. Esse é um trade-off comum em análise causal.
Próximos passos
O DoWhy é um ótimo ponto de partida para IA causal. É uma biblioteca completa que oferece um pipeline versátil de inferência causal e guia o usuário pelas etapas essenciais.
Depois de dominar o fluxo de trabalho fundamental, você pode avançar para tópicos como descoberta causal e turbinar sua análise com bibliotecas como DoubleML ou, em R, daggity, ggdag e pcalg. Quando estiver à vontade com o básico, vale explorar tópicos avançados em inferência causal. O curso da DataCamp Advanced Causal Inference with R é um excelente próximo passo.
A inferência causal oferece um novo olhar para a análise de dados. A maioria das abordagens depende de compreender o grafo causal ou outras suposições causais. O segredo é escolher as técnicas e suposições adequadas ao seu contexto. Isso requer conhecimento externo e expertise de domínio.
Por isso, é uma boa ideia consultar especialistas de marketing ou RH para ouvir suas opiniões sobre o problema e ver se podem ajudar a elaborar um modelo adequado.
Conhecimento causal é crucial em muitos contextos de negócios. Precisamos entender, por exemplo, se nosso novo produto está tendo sucesso ou quão eficaz é nossa estratégia de mídia.
Obter respostas causais a partir de dados pode ser mais difícil do que treinar um algoritmo preditivo simples, mas o esforço vale muito a pena. E bibliotecas como o DoWhy colocam à sua disposição um excelente conjunto de ferramentas para encontrar as soluções que melhor se encaixam nas suas necessidades.
Se este tutorial te ajudou a clarear as ideias e você quer aplicar técnicas de IA causal nos seus projetos, este é o momento de aprofundar. No curso completo Machine Learning for Business, você vai aprender não só sobre modelos preditivos, mas também modelos causais que ajudam a tomar decisões de negócio melhores.