Veriye dayalı karar vermeye gelince, pek çok sektör uzmanının aklında yaygın olarak kullanılan tahmin algoritmalarının her zaman güvenilir olmadığına dair bir şüphe vardır. Örneğin, kişi başına tüketilen çikolata miktarı, bir ülkedeki Nobel Ödüllü sayısını yüksek ölçüde tahmin eder ve dondurma satışları ile köpek balığı saldırıları arasında bir korelasyon vardır. Ancak bu, dondurma işimizi artırmak için sahile çok sayıda köpek balığı çekmenin iyi bir fikir olduğu anlamına gelmez.
Burada söz konusu olan elbette tanıdık bir kavram: “korelasyon nedensellik anlamına gelmez.” İki değişken arasında korelasyon olması, birini kullanarak diğerini etkileyebileceğimiz anlamına gelmez. Her iki olayı da “güneşli hava” örneğinde olduğu gibi üçüncü bir değişken yönlendiriyor olabilir; bu değişken, her iki olgunun da ortak nedenidir. Aynı zamanda, olguların temel nedenlerini anlamak ve değişimi teşvik etmek için veri analitiğini kullanmak her işletme için kritik bir görevdir. Bu nedenle Microsoft, Amazon, Uber, Spotify, McKinsey ve daha birçok lider kuruluş nedensel yapay zeka yetkinliklerine ciddi yatırımlar yapmaya başladı.
Bu eğitim, Python'da DoWhy kütüphanesini kullanarak nedensel yapay zekanın bazı temel kavram ve fikirlerini kapsar. Nedensel çıkarım, kavramsal olarak standart makine öğreniminden oldukça farklıdır; bu nedenle çoğu kişi sınırlı bir ön bilgiyle başlar. Ancak regresyon analizi ve istatistiksel modelleme konusunda temel bilgi sahibi olmak, konuyu takip etmenize yardımcı olur. Regresyon analizine yeniyseniz ya da hızlı bir hatırlatmaya ihtiyacınız varsa DataCamp'in Python ile Doğrusal Modellemede Giriş kursunu düşünebilirsiniz.
Ayrıca DataCamp'teki İş Dünyası için Makine Öğrenimi kursunda, kestirimsel ve nedensel modeller arasındaki farkları da inceleyebilirsiniz.
Nedensel Yapay Zekanın Yapı Taşları
Nedensel çıkarım söz konusu olduğunda, standart makine öğrenimi ve kestirimsel analitikten farklı bir zihniyet benimsememiz gerekir.
Nancy Cartwright şu ifadeyi ortaya atmıştır: “No causes in, no causes out.” Bu, incelediğimiz olgunun altında yatan nedensel yapıya dair bazı varsayımlar yapmamız gerektiği ve ancak bu şekilde nedensel yanıtlar elde edebileceğimiz anlamına gelir. Salt veri odaklı bir yaklaşım yeterli olmayacaktır.
Bu ilk bakışta kısır döngü gibi gelebilir; ama aslında öyle değil.
Çikolata tüketimi ile Nobel ödülleri arasındaki korelasyonun nedensel olup olmadığını bilmek istiyorsak, alternatif açıklamaları ortadan kaldırmamız gerekir. Bu alternatif açıklamalar, her zaman verinin kendisinde bulamayabileceğimiz, dışarıdan getirmemiz gereken nedensel bilgiyi oluşturur.
Diyelim ki yeni bir evden çalışma (WFH) politikası uygulamayı düşünüyoruz ve bunun çalışan üretkenliğini etkileyip etkilemeyeceğini bilmek istiyoruz. İlk analiz, evden çalışan ekip üyelerinin günlük daha fazla görev tamamladığını gösterdi.
Ancak bu politikanın herkes için uygulanmasının ardından bu korelasyonun devam edeceğinden emin olabilir miyiz? Başka bir deyişle, WFH ile üretkenlik arasındaki ilişkinin nedensel olduğundan emin miyiz?
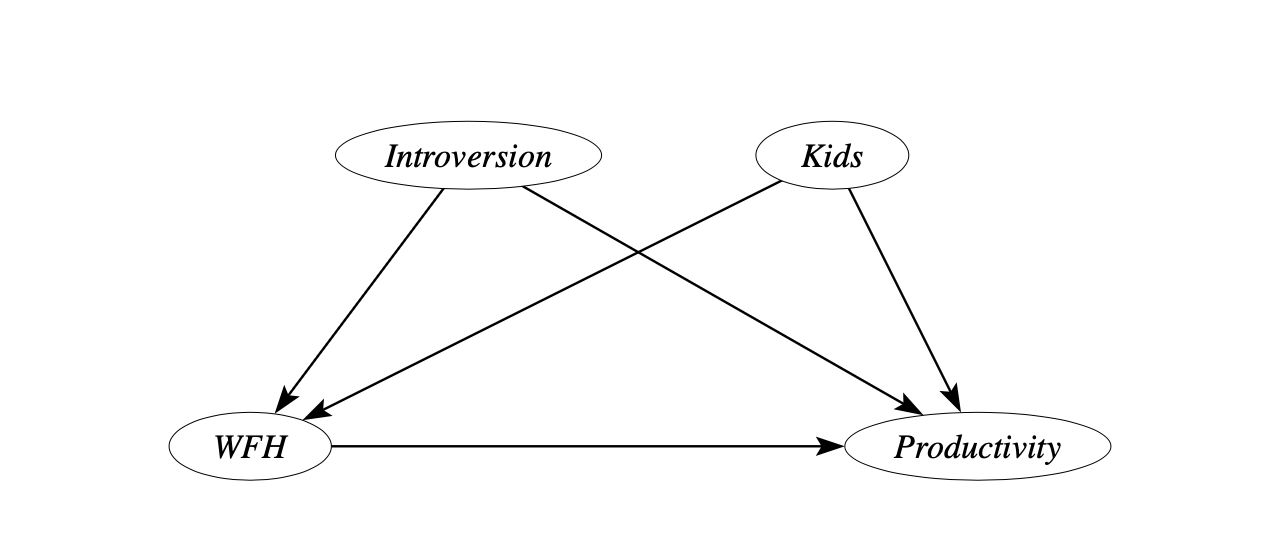
Not: Grafik causalfusion.net tarafından oluşturulmuştur
Bu bağlam için basit bir nedensel model şu şekilde görünebilir.
Evden çalışmanın üretkenlik üzerinde bir etkisi olduğunu varsayıyoruz; ancak etkinin yönünü veya gücünü bilmiyoruz. Aynı zamanda, evden çalışan kişiler için daha yüksek üretkenlik düzeyleri görmemizin başka nedenleri de olabilir.
Çocuk sahibi çalışanlar veya içe dönük olup geniş açık ofislerimizdeki gürültüyle iyi başa çıkamayanlar, kendileri için daha uygun olduğu için daha sık evden çalışmayı tercih edebilir. Bu değişkenlerin kendileri de üretkenlikle bağlantılı olabilir; bu da onları gözlenen korelasyonun kaynağı olabilecek ortak nedenler haline getirir.
Tüm bu varsayımları açık hale getirmek için, bunları nedensel grafik olarak bilinen ve bir sistemdeki değişkenler arasındaki ilişkileri, özellikle de nedensel ilişkileri modellemek için kullanılan grafiksel bir gösterimde tasvir ederiz.
Gerçek dünya senaryolarında bu varsayımların bazılarının oldukça güçlü olabileceğini göreceksiniz. En büyük avantaj, nedensel grafiklerin varsayımları ve ön bilgiyi çok açık hale getirmesidir; ancak analizlerimizin güvenilirliğini artırmak için onları sürekli sorgulamaya ve iyileştirmeye hazır olmalıyız.
Python'da DoWhy ile Başlarken
Microsoft’un, DoWhy kütüphanesi Amazon Web Services ile iş birliğiyle PyWhy ekosisteminin bir parçası olarak geliştirildi ve Python dünyasında hızla nedensel analiz için sektör standardı haline geliyor. Nedensel çıkarım hattındaki bazı temel adımları göstermek için yukarıdaki nedensel modelimize göre bir veri setini simüle etmekte DoWhy'dan yararlanabiliriz. Önce, DoWhy'ı ortamımıza kurmamız gerekiyor.
!pip install git+https://github.com/microsoft/dowhy.gitBu işlem tamamlandıktan sonra gerekli kütüphaneleri yükleyebiliriz.
import numpy as np
import pandas as pd
import dowhy
Şimdi, kendi veri setimizi oluşturalım. Nedensel yapay zekayı çalışırken simüle edilmiş verilerle çalışmanın en büyük faydası, veri üretim süreci üzerinde tam kontrole ve gerçek dünyada sahip olamayacağımız “gerçek durumu” bilme ayrıcalığına sahip olmamızdır.
Gerçek nedensel etkiyi bire eşitliyoruz (beta=1), iki ortak neden belirliyoruz ve modeldeki değişkenler arasında basit doğrusal ilişkilere göre on bin örnek oluşturuyoruz.
İncelediğimiz tedavi değişkenini ikili (binary) olarak ayarlıyoruz; yani değerleri sıfır veya bir olabiliyor.
Daha önce, veri setimizin birebir tekrarlanabilmesi için rastgele sayı üretimi için sabit bir başlangıç noktası belirlemiştik - using np.random.seed(1).
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy aşağıdaki etiketleri atar:
Tablo 1
|
Etiket |
Değişken |
Tip |
Ortalama |
|
v0 |
Analizimizde ana ilgi konusu olan tedavi değişkeni (evden çalışma) |
İkili |
0.608 |
|
y |
İlgi duyulan sonuç (üretkenlik) |
Sürekli |
1.583 |
|
W0 |
İçe dönüklük |
Sürekli |
-0.148 |
|
W1 |
Çocuk Sayısı |
Kategorik |
1.5 |
|
Z0 |
Yalnızca v0'ı etkileyip y'yi etkilemeyen araçsal değişken (metro hattının kapanması) |
İkili |
0.281 |
Burada, tedavi tipini ve ortak nedenlerin sayısını belirleyerek zımnen bir nedensel grafik tanımlamış olduk. DoWhy, grafik nesnelerini DOT dilinde saklar; bu da gerçek dünya verileriyle çalışırken kendi yönlendirilmiş nedensel grafiğimizi (digraph) belirtmemiz için kullanışlı bir yol sunar.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Son olarak, tüm bu bilgileri tek bir nedensel modelde birleştiriyoruz.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Nedensel Yapay Zekanın Gücünü Ortaya Çıkarmak
Nedensel analizimizi gerçekleştirmeden önce, basit bir doğrusal tahmin algoritmasına dayalı naif bir yaklaşımın bize ne söyleyeceğini kıyaslayalım.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
İkili değişkenli bir regresyondaki eğim katsayısı 1.298'e eşittir. Ancak veriyi bu şekilde ürettiğimiz için gerçek nedensel etkinin aslında bire eşit olduğunu biliyoruz.
Bu, üretkenliği ve evden çalışma olasılığını birlikte etkileyen iki ortak neden olan içe dönüklük ve çocuk sahibi olmanın, bu durumda neredeyse %30’luk bir aşırı tahmine yol açtığı anlamına gelir.
Neyse ki bu değişkenlere dair verimiz olduğu sürece, ortak nedenleri çok değişkenli bir analize dahil ederek bu önyargıyı kolayca giderebiliriz.
Nedensel yapay zeka literatüründe bu durum arka kapı kriteri olarak bilinir. Nedensel grafikte tedavi değişkenine okla giren tüm değişkenleri kontrol etmek isteriz. Bunlar “arka kapıdan girer” ve böylece tedavi ile sonuç arasında nedensel olmayan sahte bir korelasyon yaratabilir. Bizim örneğimizde bu, içe dönüklük ve çocuk sayısı için geçerlidir.
WFH <— İçe dönüklük —> Üretkenlik
WFH <— Çocuklar —> Üretkenlik
DoWhy, belirli bir nedensel model verildiğinde istenen nedensel etkinin tanımlanıp tanımlanamayacağını belirlemek için kullanılabilecek çeşitli algoritmalar sunar.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Şaşırtıcı olmayan bir şekilde, evden çalışmanın etkisine ilişkin basit nedensel modelimizde nedensel tanımlama mümkündür.
Sonraki adımda, mevcut verileri kullanarak hedef etkiyi niceliksel olarak belirleme süreci olan tahmine odaklanabiliriz.
DoWhy, regresyon, eşleştirme, tabakalaştırma ve ağırlıklandırma tahminleyicileri dahil olmak üzere çeşitli algoritmalar sunar. Temel aldığımız veriler doğrusal ilişkilere göre simüle edildiğinden, basit bir regresyon yeterlidir. Hatırlatmaya ihtiyacınız varsa DataCamp'in Python'da statsmodels ile Regresyona Giriş kursu yardımcı olabilir.
Ancak analizimizi daha genel kılmak için, doğrusal olmayan verileri de ele alabilen ters olasılık ağırlıklandırması kullanacağız.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy, 1.001'e eşit bir nedensel etki tahmini döndürür. Elbette, bu simülasyon bağlamında gerçek sayılar çok anlamlı değildir. Ancak önemli olan, bir olan gerçeğe çok yakın olmamızdır. Daha önce çalıştırdığımız regresyona kıyasla önyargı %99,6 gibi çarpıcı bir oranda azalmıştır.
Sonuçlarınızı Dayanıklılık Testine Tabi Tutma
Tüm bunlar etkileyici; ama burada durmamalıyız.
“No causes in, no causes out” ilkesi, her nedensel analizin ancak masaya getirdiğimiz varsayımlar kadar iyi olabileceğini söyler.
Örneğin, basit nedensel modelimizin önerdiği gibi WFH'yi etkileyen yalnızca içe dönüklük ve çocuklar olduğundan nasıl emin olabiliriz?
Varsayımlarımıza daha fazla güven duymak için, DoWhy bize analizimizi alt örneklerle ya da plasebo tedavilerle test etmek de dahil olmak üzere bir dizi çürütme testi sunar.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
İçe dönüklük ve çocuklara ek olarak başka bir ortak neden daha eklersek ne olur, bakalım.
Bu kez, bu değişken hakkında verimiz yok; dolayısıyla bizim için gözlemlenemeyecek. Tahminlerimiz ne kadar güvenilir? Ne yazık ki yanıt pek iç açıcı değil.
Şekil 2'deki grafik, gözlemlenmeyen ortak nedenlerin tahmin edilen nedensel etki üzerinde -0.222 ile 1.003 arasında değişen kayda değer bir etkiye sahip olabileceğini gösterir. Bu aralık o kadar geniştir ki tahmini etkiyi ikiye katlayabilir.
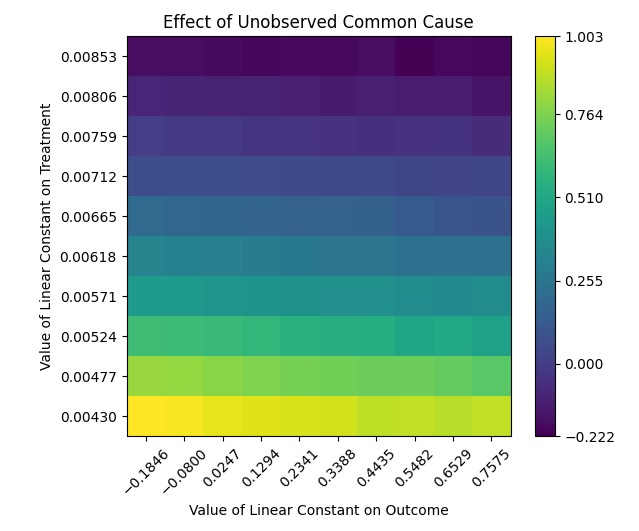
Ancak bu çok da şaşırtıcı değildir. Analizde hesaba katamadığımız gözlemlenmeyen değişkenleri içeren alternatif nedensel mekanizmalar, nedensel çalışmalarda her zaman bir sorun teşkil eder.
Neyse ki bu bağlamda tanımlamaya ulaşmanın alternatif bir yolu vardır ve DoWhy bunu bizim için bulacak kadar akıllıdır.
Alternatif Nedensel Stratejiler Bulma
İçe dönük çalışanlar ve çocuğu olanlar daha sık evden çalışıyor olsalar da, üretkenlikle ilişkili olmayan başka WFH belirleyicileri de olabilir.
Diyelim ki büyük bir toplu taşıma aksaması yaşandı ve şehrimizdeki metro hatlarından biri üç ay boyunca kapatılmak zorunda kaldı. Sonuç olarak, hattın yakınındaki semtlerde oturan çalışanlar, aksi halde ofise gelmeyi tercih etseler bile, evden çalışmaya daha meyilli olacaklardı.
Bu genişletilmiş nedensel modeli şu şekilde gösterebiliriz.
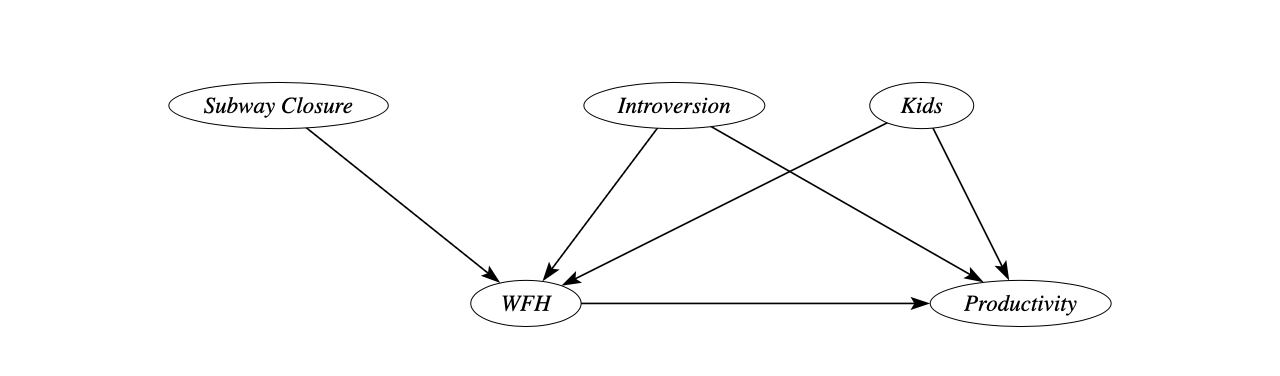
Bu durumda metro hattının kapanması, sözde bir araçsal değişken işlevi görür.
Sezgisel olarak, kapanma insanların işe gidiş geliş programlarında bir şok etkisi yaratır ve bir tür doğal deney oluşturur.
Üç ay boyunca, aksaklıktan etkilenen hat yakınında yaşayanlar daha sık evden çalışacak, ancak bunun üretkenlikleriyle başka bir ilişkisi olmayacaktır. Fark etmiş olabileceğiniz gibi, yukarıda simüle edilmiş veri setini oluştururken num_instruments=1 seçeneğini ayarlayarak Z0 adlı böyle bir araçsal değişkeni zaten dahil ettik. DoWhy’ın identify_effect() fonksiyonu daha sonra nedensel grafikte bizim için uygun araçsal değişkenleri otomatik olarak bulabilir.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Tahmin sonrası, nedensel etkinin 0.920 olduğunu buluyoruz. Bu, arka kapı stratejisinden biraz daha az isabetlidir; ancak naif tahminden çok daha doğrudur.
Araçsal değişken tahmini, WFH ve üretkenliğin gözlemlenmeyen ortak nedenlerinin sayısına ilişkin varsayımlara dayanmadığı için avantajlıdır.
Dolayısıyla tahminlerimiz daha az hassas olabilir; ama daha zayıf varsayımlar sayesinde daha dayanıklıdır. Bu, nedensel analizde yaygın bir değiş tokuştur.
Sırada Ne Var?
DoWhy, nedensel yapay zekaya başlamak için harika bir noktadır. Kullanıcıları temel adımlar boyunca yönlendiren, esnek bir nedensel çıkarım hattı sunan güçlü ve uçtan uca bir kütüphanedir.
Temel iş akışını kavradıktan sonra, nedensel keşif gibi daha ileri konulara geçebilir ve analizlerinizi DoubleML gibi ek kütüphanelerle ya da R'de daggity, ggdag ve pcalg ile güçlendirebilirsiniz. Temellerde kendinizi rahat hissettiğinizde, nedensel çıkarımda daha ileri konuları keşfetmek isteyebilirsiniz. DataCamp'in R ile İleri Düzey Nedensel Çıkarım kursu iyi bir sonraki adımdır.
Nedensel çıkarım, veri analizine taze bir bakış açısı sunar. Çoğu yaklaşım, nedensel grafiğin ya da diğer nedensel varsayımların anlaşılmasına dayanır. Püf noktası, belirli durumunuza uygun teknik ve varsayımları seçmektir. Bu da harici bilgi ve alan uzmanlığı gerektirir.
Bu nedenle, belirli bir konuda pazarlama uzmanlarınız veya İK uzmanlarınızla görüşmek, görüşlerini almak ve uygun bir model geliştirmede size yardımcı olup olamayacaklarını görmek iyi bir fikirdir.
Nedensel bilgi, birçok iş bağlamında kritik öneme sahiptir. Örneğin, yeni ürün lansmanımızın başarılı olup olmadığını ya da reklam stratejimizin ne kadar etkili olduğunu anlamamız gerekir.
Veriden nedensel yanıtlar elde etmek, basit bir tahmin algoritması eğitmekten daha zor olabilir; ancak çabaya değer. Ve DoWhy gibi kütüphaneler, ihtiyaçlarınıza en iyi uyan çözümleri bulmanıza yardımcı olacak harika bir araç seti sunar.
Bu eğitimi aydınlatıcı bulduysanız ve kendi projelerinizde nedensel yapay zeka tekniklerini uygulamaya hevesliyseniz, bilginizi derinleştirmek için bundan daha iyi bir zaman yok. İş Dünyası için Makine Öğrenimi adlı kapsamlı kursta yalnızca kestirimsel modelleri değil, daha iyi iş kararları almanıza yardımcı olabilecek nedensel modelleri de öğreneceksiniz.