जब डेटा के आधार पर निर्णय लेने की बात आती है, तो कई उद्योग विशेषज्ञों के मन में यह शंका बनी रहती है कि आमतौर पर उपयोग किए जाने वाले प्रेडिक्शन एल्गोरिद्म हमेशा भरोसेमंद नहीं होते। उदाहरण के लिए, किसी देश में प्रति व्यक्ति चॉकलेट की खपत की मात्रा नोबेल पुरस्कार विजेताओं की संख्या का काफ़ी अच्छा पूर्वानुमान देती है, और आइसक्रीम की बिक्री और शार्क हमलों के बीच सहसंबंध है। हालांकि, इसका मतलब यह नहीं है कि अपनी आइसक्रीम बिक्री बढ़ाने के लिए समुद्र तट पर बड़ी संख्या में शार्क को आकर्षित करना अच्छा विचार होगा।
यहाँ मुद्दा, स्वाभाविक रूप से, वह परिचित अवधारणा है कि “सहसंबंध कारण नहीं बताता।” केवल इसलिए कि दो चर सहसंबद्ध हैं, इसका अर्थ यह नहीं है कि हम एक का उपयोग करके दूसरे को प्रभावित कर सकते हैं। दोनों घटनाएँ किसी तीसरे चर द्वारा संचालित हो सकती हैं, जैसे शार्क और आइसक्रीम बिक्री के उदाहरण में “धूप वाला मौसम,” जो दोनों का सामान्य कारण है। साथ ही, घटनाओं के मूल कारणों को समझना और डेटा एनालिटिक्स का उपयोग करके बदलाव लाना किसी भी व्यवसाय के लिए एक महत्वपूर्ण कार्य है। यही कारण है कि Microsoft, Amazon, Uber, Spotify, McKinsey और कई अन्य ने अपनी causal AI क्षमताओं में भारी निवेश करना शुरू कर दिया है।
यह ट्यूटोरियल Python में DoWhy लाइब्रेरी का उपयोग करते हुए causal AI की कुछ बुनियादी अवधारणाओं और विचारों को कवर करता है। कारणात्मक निष्कर्षण मानक मशीन लर्निंग से वैचारिक रूप से काफ़ी भिन्न है, इसलिए अधिकांश लोग सीमित पृष्ठभूमि ज्ञान के साथ शुरुआत करेंगे। हालांकि, रिग्रेशन विश्लेषण और सांख्यिकीय मॉडलिंग का बुनियादी ज्ञान साथ चलने में सहायक होगा। यदि आप रिग्रेशन विश्लेषण में नए हैं या ताज़ाकरण चाहते हैं, तो DataCamp का Introduction to Linear Modeling in Python कोर्स देखें।
आप DataCamp के Machine Learning for Business कोर्स में प्रेडिक्टिव और causal मॉडलों के बीच के अंतर भी समझ सकते हैं।
Causal AI के निर्माण खंड
कारणात्मक निष्कर्षण के संदर्भ में, हमें मानक मशीन लर्निंग और प्रेडिक्टिव एनालिटिक्स से अलग मानसिकता अपनाने की आवश्यकता होती है।
दार्शनिक नैंसी कार्टराइट ने यह कथन गढ़ा: “No causes in, no causes out.” इसका मतलब है कि जिस परिघटना का हम अध्ययन कर रहे हैं, उसके अंतर्निहित कारणात्मक ढाँचे के बारे में हमें धारणाएँ बनानी होंगी, ताकि हमें कारणात्मक उत्तर मिल सकें। केवल डेटा-चालित दृष्टिकोण पर्याप्त नहीं होगा।
यह पहली नज़र में परिपत्र लग सकता है, लेकिन वास्तव में ऐसा नहीं है।
यदि हम जानना चाहते हैं कि चॉकलेट की खपत और नोबेल पुरस्कार विजेताओं के बीच का सहसंबंध कारणात्मक है या नहीं, तो हमें वैकल्पिक व्याख्याओं को ख़ारिज करना होगा। वे वैकल्पिक व्याख्याएँ कारणात्मक ज्ञान बनाती हैं, जो हमें हमेशा डेटा में नहीं मिलतीं बल्कि बाहर से लानी पड़ती हैं।
मान लीजिए हम नया वर्किंग-फ्रॉम-होम (WFH) नीति लागू करने पर विचार कर रहे हैं और जानना चाहते हैं कि क्या इससे कर्मचारियों की उत्पादकता प्रभावित होगी। प्रारंभिक विश्लेषण से पता चला है कि जो टीम सदस्य घर से काम करते हैं, वे दैनिक आधार पर अधिक कार्य पूरे करते हैं।
हालाँकि, क्या हम आश्वस्त हो सकते हैं कि एक बार जब नीति सभी के लिए लागू हो जाएगी, तब भी यह सहसंबंध बना रहेगा? दूसरे शब्दों में, क्या हम सुनिश्चित हो सकते हैं कि WFH और उत्पादकता के बीच संबंध कारणात्मक है?
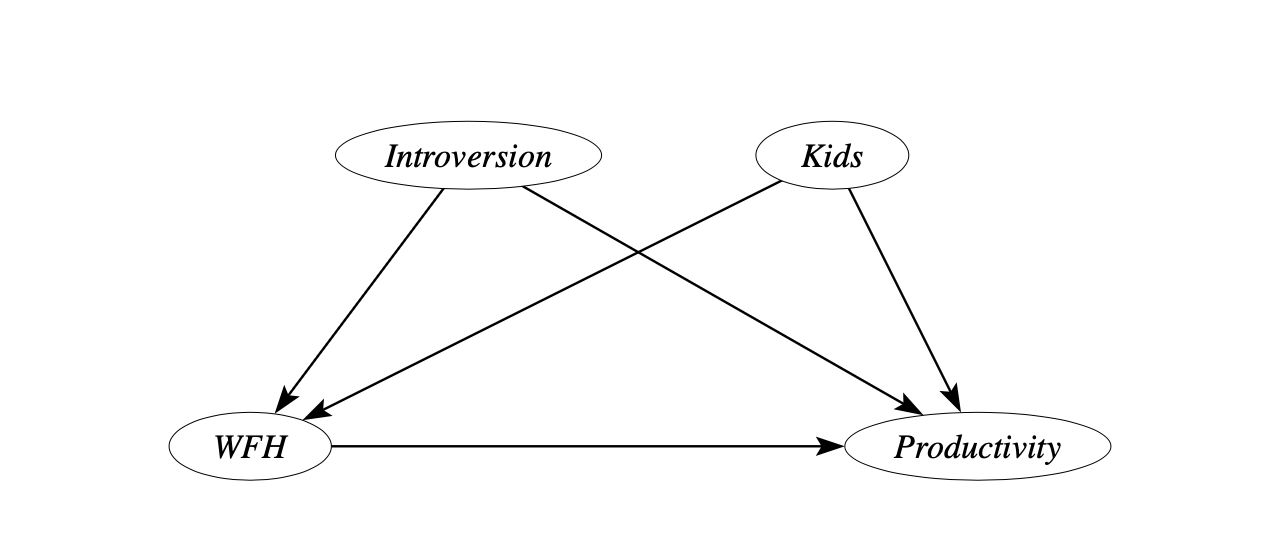
नोट: ग्राफ causalfusion.net द्वारा बनाया गया
इस संदर्भ के लिए एक सरल कारणात्मक मॉडल ऐसा दिख सकता है।
हम मानते हैं कि घर से काम करना उत्पादकता पर प्रभाव डालता है, लेकिन हमें प्रभाव की दिशा या शक्ति का पता नहीं है। साथ ही, घर से काम करने वाले लोगों में उच्चतर उत्पादकता स्तर दिखने के अन्य कारण भी हो सकते हैं।
जिन कर्मचारियों के बच्चे हैं या जो काफ़ी अंतर्मुखी हैं और हमारे बड़े ओपन-प्लान कार्यालयों के शोर-शराबे से अच्छी तरह नहीं निपटते, वे सुविधा के कारण अधिक बार घर से काम करना चुन सकते हैं। ये चर स्वयं उत्पादकता से जुड़े हो सकते हैं, जिससे वे संभावित सामान्य कारण बन जाते हैं जो सहसंबंध का स्रोत भी हो सकते हैं।
इन सभी धारणाओं को स्पष्ट करने के लिए, हम उन्हें एक तथाकथित कारणात्मक ग्राफ़ में दर्शाते हैं—यह एक ग्राफ़िकल निरूपण है जिसका उपयोग किसी प्रणाली में चरों के बीच संबंधों को मॉडल करने के लिए किया जाता है, विशेष रूप से कारणात्मक संबंधों पर ध्यान केंद्रित करते हुए।
आप पाएँगे कि वास्तविक दुनिया के परिदृश्यों में इनमें से कुछ धारणाएँ काफ़ी सशक्त हो सकती हैं। बड़ा लाभ यह है कि कारणात्मक ग्राफ़ धारणाओं और पूर्व-ज्ञान को बहुत स्पष्ट कर देते हैं, लेकिन हमें हमेशा उन्हें चुनौती देने और परिष्कृत करने के लिए तैयार रहना चाहिए ताकि हमारे विश्लेषण विश्वसनीय बनें।
Python में DoWhy के साथ शुरुआत करना
Microsoft की DoWhy लाइब्रेरी, जिसे Amazon Web Services के साथ मिलकर PyWhy इकोसिस्टम के हिस्से के रूप में विकसित किया गया है, Python जगत में कारणात्मक विश्लेषण के लिए तेज़ी से उद्योग मानक बनती जा रही है। हम DoWhy का उपयोग ऊपर दिए गए अपने कारणात्मक मॉडल के अनुसार एक डेटा सेट सिम्युलेट करने के लिए कर सकते हैं, ताकि कारणात्मक निष्कर्षण पाइपलाइन के कुछ मौलिक चरणों को दर्शाया जा सके। सबसे पहले, हमें अपने वातावरण में DoWhy स्थापित करना होगा।
!pip install git+https://github.com/microsoft/dowhy.gitएक बार यह हो जाने पर, हम आवश्यक लाइब्रेरीज़ लोड कर सकते हैं।
import numpy as np
import pandas as pd
import dowhy
अब, आइए हम स्वयं एक डेटा सेट बनाते हैं। causal AI का अध्ययन करते समय सिम्युलेटेड डेटा के साथ काम करने का बड़ा लाभ यह है कि हमारे पास डेटा-जनन प्रक्रिया पर पूरा नियंत्रण होता है और “ग्राउंड ट्रुथ” का ज्ञान होता है, जो वास्तविक दुनिया के डेटा के साथ नहीं होगा।
हम वास्तविक कारणात्मक प्रभाव को एक के बराबर सेट करते हैं (beta=1), दो सामान्य कारण निर्दिष्ट करते हैं, और मॉडल में चरों के बीच सरल रैखिक संबंधों के अनुसार दस हज़ार सैम्पल बनाते हैं।
हम जिस चर का उपचार के रूप में परीक्षण कर रहे हैं, उसे बाइनरी सेट किया गया है, यानी यह या तो शून्य या एक हो सकता है।
पहले, हमने अपने रैंडम नंबर जेनरेशन के लिए एक स्थिर आरंभिक बिंदु स्थापित किया—using np.random.seed(1)—ताकि अपने डेटा सेट की सटीक पुनरुत्पत्ति सक्षम हो सके।
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy निम्नलिखित लेबल निर्दिष्ट करता है:
तालिका 1
|
लेबल |
चर |
प्रकार |
औसत |
|
v0 |
उपचार चर, जो हमारे विश्लेषण में मुख्य रुचि का विषय है (घर से काम करना) |
बाइनरी |
0.608 |
|
y |
रुचि का परिणाम (उत्पादकता) |
सतत |
1.583 |
|
W0 |
अंतर्मुखता |
सतत |
-0.148 |
|
W1 |
बच्चों की संख्या |
श्रेणीबद्ध |
1.5 |
|
Z0 |
एक औज़ारी चर जो केवल v0 को प्रभावित करता है, y को नहीं (मेट्रो लाइन का बंद होना) |
बाइनरी |
0.281 |
यहाँ, हमने उपचार के प्रकार और सामान्य कारणों की संख्या निर्धारित करके परोक्ष रूप से एक कारणात्मक ग्राफ़ परिभाषित किया है। DoWhy ग्राफ़ ऑब्जेक्ट्स को DOT भाषा में संग्रहीत करता है, जो हमें वास्तविक दुनिया के डेटा के साथ काम करते समय अपना निर्देशित कारणात्मक ग्राफ़ (digraph) सुविधाजनक तरीके से निर्दिष्ट करने की अनुमति देता है।
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}अंत में, हम इस सारी जानकारी को एक एकल कारणात्मक मॉडल में संयोजित करते हैं।
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Causal AI की शक्ति को अनलॉक करना
कारणात्मक विश्लेषण करने से पहले, आइए देखें कि एक सरल रैखिक प्रेडिक्शन एल्गोरिद्म पर आधारित एक भोला-भाला दृष्टिकोण हमें क्या बताता है।
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
द्विवेरीय रिग्रेशन में ढाल गुणांक 1.298 के बराबर है। हालाँकि, हम जानते हैं कि वास्तविक कारणात्मक प्रभाव वास्तव में एक के बराबर है, क्योंकि हमने डेटा को इसी तरह उत्पन्न किया है।
इसका अर्थ है कि दो सामान्य कारण—अंतर्मुखता और बच्चों का होना—जो दोनों ही उत्पादकता और घर से काम करने की संभावना को प्रभावित करते हैं, इस मामले में लगभग 30% की अधिक-आकलन की ओर ले जाते हैं।
सौभाग्य से, जब तक हमारे पास इन चरों पर डेटा है, हम बहुवेरीय विश्लेषण में सामान्य कारणों को शामिल करके इस पक्षपात का आसानी से समाधान कर सकते हैं।
causal AI साहित्य में, इसे backdoor criterion के रूप में जाना जाता है। हम कारणात्मक ग्राफ़ में उन सभी चरों को नियंत्रित करना चाहते हैं जो उपचार चर में इंगित करते हैं। वे “बैकडोर से प्रवेश” करते हैं और इस प्रकार उपचार और परिणाम के बीच एक झूठा सहसंबंध बना सकते हैं जो कारणात्मक नहीं है। हमारे उदाहरण में, यह अंतर्मुखता और बच्चों की संख्या पर लागू होता है।
WFH <— अंतर्मुखता —> उत्पादकता
WFH <— बच्चे —> उत्पादकता
DoWhy कई एल्गोरिद्म प्रदान करता है जिनका उपयोग यह निर्धारित करने के लिए किया जा सकता है कि किसी दिए गए कारणात्मक मॉडल में वांछित कारणात्मक प्रभाव की पहचान की जा सकती है या नहीं।
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
हैरानी की बात नहीं है कि घर से काम करने के प्रभाव के हमारे सरल कारणात्मक मॉडल में कारणात्मक पहचान संभव है।
अगले चरण में, हम आकलन पर ध्यान केंद्रित कर सकते हैं, जो उपलब्ध डेटा का उपयोग करके लक्षित प्रभाव को मात्रात्मक बनाने की प्रक्रिया है।
DoWhy कई एल्गोरिद्म का विकल्प देता है, जिनमें रिग्रेशन, मैचिंग, स्तरीकरण और वेटिंग एस्टीमेटर शामिल हैं। चूँकि हमने जो अंतर्निहित डेटा सिम्युलेट किया वह रैखिक संबंधों पर आधारित था, एक सरल रिग्रेशन पर्याप्त होगा। यदि आपको ताज़ाकरण चाहिए, तो DataCamp का Intro to Regression with statsmodels in Python कोर्स सहायक हो सकता है।
हालाँकि, अपने विश्लेषण को अधिक सामान्य बनाने के लिए, हम inverse probability weighting का उपयोग करेंगे, जो गैर-रैखिक डेटा को भी संभाल सकता है।
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy एक कारणात्मक प्रभाव का आकलन 1.001 के बराबर लौटाता है। बेशक, इस सिम्युलेटेड संदर्भ में वास्तविक संख्याएँ बहुत सार्थक नहीं हैं। हालाँकि, महत्वपूर्ण यह है कि हम ग्राउंड ट्रुथ एक के काफ़ी क़रीब हैं। पहले चलाए गए रिग्रेशन की तुलना में पक्षपात 99.6% तक कम हो गया है।
अपने परिणामों का स्ट्रेस टेस्ट करना
यह सब काफ़ी प्रभावशाली है, लेकिन हमें यहीं नहीं रुकना चाहिए।
“No causes in, no causes out” सिद्धांत हमें बताता है कि कोई भी कारणात्मक विश्लेषण उतना ही अच्छा हो सकता है जितनी अच्छी धारणाएँ हम साथ लाते हैं।
उदाहरण के लिए, हम कैसे सुनिश्चित करें कि केवल अंतर्मुखता और बच्चे ही WFH को प्रभावित करते हैं, जैसा कि हमारे सरल कारणात्मक मॉडल में कहा गया है?
अपनी धारणाओं में अधिक भरोसा हासिल करने के लिए, DoWhy हमें रेफ़्यूटेशन परीक्षणों का एक संपूर्ण सूट देता है, जो हमें अपने विश्लेषण का स्ट्रेस टेस्ट करने की अनुमति देता है, जिनमें उप-नमूनों या प्लेसीबो उपचारों के साथ परीक्षण करना भी शामिल है लेकिन इन्हीं तक सीमित नहीं है।
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
आइए देखें कि यदि हम अंतर्मुखता और बच्चों के अतिरिक्त एक और सामान्य कारण जोड़ दें तो क्या होता है।
इस बार, हमारे पास इस चर पर डेटा नहीं है, इसलिए यह हमारे लिए अप्रेक्षणीय रहेगा। हमारे आकलन कितने भरोसेमंद हैं? दुर्भाग्य से, उत्तर बहुत आश्वस्त करने वाला नहीं है।
आकृति 2 में दिया गया ग्राफ़ दर्शाता है कि अप्रेक्षणीय सामान्य कारण अनुमानित कारणात्मक प्रभाव पर कितना बड़ा प्रभाव डाल सकते हैं—यह -0.222 से 1.003 तक जा सकता है। यह दायरा इतना व्यापक है कि यह अनुमानित प्रभाव को संभावित रूप से दुगना कर सकता है।
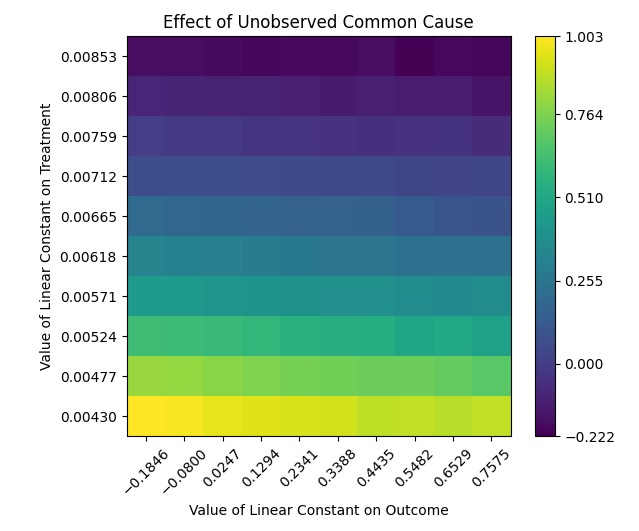
हालाँकि, यह बहुत चौंकाने वाला भी नहीं है। वैकल्पिक कारणात्मक तंत्र जिनमें अप्रेक्षणीय चर शामिल हैं और जिन्हें हम विश्लेषण में शामिल नहीं कर सकते, वे कारणात्मक अध्ययनों में हमेशा समस्या पैदा करेंगे।
सौभाग्य से, इस संदर्भ में पहचान प्राप्त करने का एक वैकल्पिक तरीका है, और DoWhy इसे हमारे लिए खोजने के लिए पर्याप्त स्मार्ट है।
वैकल्पिक कारणात्मक रणनीतियाँ खोजना
भले ही अंतर्मुखी कर्मचारी और जिनके बच्चे हैं वे अधिक बार घर से काम करें, WFH के ऐसे अन्य निर्धारक हो सकते हैं जिनका उत्पादकता से संबंध न हो।
मान लीजिए हमें सार्वजनिक परिवहन में बड़ा व्यवधान झेलना पड़ा और हमारे शहर में मेट्रो की एक लाइन को तीन महीनों के लिए बंद करना पड़ा। नतीजतन, उस लाइन के पास के इलाक़ों में रहने वाले कर्मचारी, भले ही वे अन्यथा दफ़्तर आना पसंद करते, अधिक संभावना से घर से काम करेंगे।
हम इस संवर्धित कारणात्मक मॉडल को निम्नानुसार दर्शा सकते हैं।
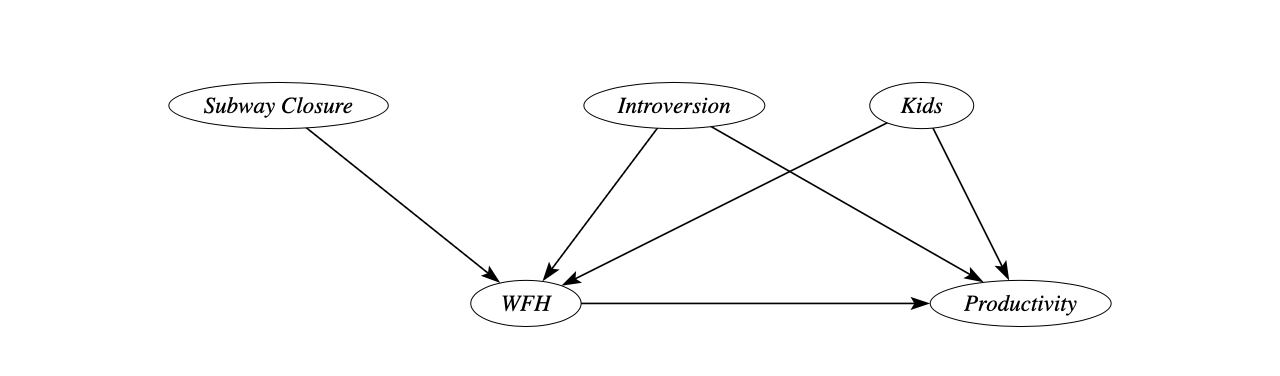
इस मामले में, मेट्रो का बंद होना तथाकथित औज़ारी चर के रूप में कार्य करता है।
सहज रूप से, यह बंद होना लोगों की आवागमन समय-सारिणी पर एक झटका की तरह कार्य करता है, जो एक प्रकार का प्राकृतिक प्रयोग बनाता है।
तीन महीनों तक, बाधित लाइन के पास रहने वाले लोग अधिक बार घर से काम करेंगे, लेकिन इसका उनकी उत्पादकता से अन्यथा कोई संबंध नहीं है। आपने ध्यान दिया होगा कि हमने ऊपर सिम्युलेटेड डेटा सेट बनाते समय पहले से ही ऐसा एक औज़ारी चर Z0 शामिल किया है, विकल्प num_instruments=1 सेट करके। इसके बाद DoWhy का identify_effect() फ़ंक्शन कारणात्मक ग्राफ़ में हमारे लिए स्वतः उपयुक्त औज़ारी चर खोजने में सक्षम है।
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
आकलन के बाद, हमें कारणात्मक प्रभाव 0.920 मिलता है। यह backdoor रणनीति से थोड़ा कम सटीक है, लेकिन फिर भी भोले-भाले प्रेडिक्शन की तुलना में कहीं अधिक सटीक है।
औज़ारी चर आकलन का लाभ यह है कि यह WFH और उत्पादकता के अप्रेक्षणीय सामान्य कारणों की संख्या के बारे में धारणाओं पर निर्भर नहीं करता।
इस प्रकार, यद्यपि हमारे आकलन कम सटीक हो सकते हैं, वे कमजोर धारणाओं के कारण अधिक मज़बूत होते हैं। कारणात्मक विश्लेषण में यह एक सामान्य समझौता है।
आगे क्या?
DoWhy causal AI के साथ शुरुआत करने के लिए उत्कृष्ट साधन है। यह एक शक्तिशाली एंड-टू-एंड लाइब्रेरी है जो एक बहुमुखी कारणात्मक निष्कर्षण पाइपलाइन प्रदान करती है और उपयोगकर्ताओं को आवश्यक चरणों से गुज़रने में मार्गदर्शन करती है।
एक बार जब आप मूल वर्कफ़्लो समझ लेते हैं, तो आप causal discovery जैसे उन्नत विषयों की ओर बढ़ सकते हैं और DoubleML, या R में daggity, ggdag, और pcalg जैसी अतिरिक्त लाइब्रेरीज़ से अपने विश्लेषण को और सशक्त बना सकते हैं। बुनियादी बातों में सहज होने के बाद, आप कारणात्मक निष्कर्षण के अधिक उन्नत विषयों का अन्वेषण करना चाहेंगे। DataCamp का Advanced Causal Inference with R कोर्स अगला बेहतरीन कदम है।
कारणात्मक निष्कर्षण डेटा विश्लेषण पर नया दृष्टिकोण देता है। अधिकांश तरीक़े कारणात्मक ग्राफ़ या अन्य कारणात्मक धारणाओं की समझ पर निर्भर करते हैं। तरकीब यह है कि अपनी विशेष परिस्थिति के लिए उपयुक्त तकनीकों और धारणाओं का चयन करें। इसके लिए बाहरी ज्ञान और डोमेन विशेषज्ञता आवश्यक है।
इसलिए, अपने मार्केटिंग विशेषज्ञों या HR विशेषज्ञों से परामर्श करना अच्छा विचार है, ताकि किसी विशेष मुद्दे पर उनकी राय मिल सके और देखें कि क्या वे आपको उपयुक्त मॉडल तैयार करने में मदद कर सकते हैं।
कई व्यावसायिक संदर्भों में कारणात्मक ज्ञान अत्यंत महत्वपूर्ण है। उदाहरण के लिए, हमें समझने की आवश्यकता है कि हमारा नया उत्पाद लॉन्च सफल है या हमारी विज्ञापन रणनीति कितनी प्रभावी है।
डेटा से कारणात्मक उत्तर प्राप्त करना, एक सरल प्रेडिक्शन एल्गोरिद्म को प्रशिक्षित करने की तुलना में अधिक कठिन हो सकता है, लेकिन यह प्रयास निश्चित ही सार्थक है। और DoWhy जैसी लाइब्रेरीज़ आपको उत्कृष्ट टूलसेट प्रदान करती हैं, जो आपकी आवश्यकताओं के लिए सर्वश्रेष्ठ समाधान खोजने में मदद करेंगी।
यदि आपको यह ट्यूटोरियल ज्ञानवर्धक लगा है और आप अपने प्रोजेक्ट्स में causal AI तकनीकों को लागू करने के इच्छुक हैं, तो अपनी समझ को गहरा करने का इससे बेहतर समय नहीं। व्यापक Machine Learning for Business कोर्स में, आप न केवल प्रेडिक्टिव मॉडलों के बारे में, बल्कि causal मॉडलों के बारे में भी सीखेंगे जो आपको बेहतर व्यावसायिक निर्णय लेने में मदद कर सकते हैं।