Quando si tratta di prendere decisioni basate sui dati, molti professionisti del settore hanno il dubbio persistente che gli algoritmi di previsione comunemente usati non siano sempre affidabili. Ad esempio, la quantità di cioccolato consumato pro capite è altamente predittiva del numero di vincitori del Premio Nobel in un paese, e c'è una correlazione tra le vendite di gelati e gli attacchi di squali. Tuttavia, questo non significa che abbia senso attirare un gran numero di squali sulla spiaggia per far decollare il nostro business dei gelati.
Qui entra in gioco, ovviamente, il concetto ben noto secondo cui "correlazione non implica causalità". Solo perché due variabili sono correlate non significa che possiamo usare una per influenzare l'altra. Entrambi gli eventi potrebbero essere guidati da una terza variabile, come il "bel tempo" nell'esempio degli squali e delle vendite di gelati, che agisce come causa comune di entrambi. Allo stesso tempo, comprendere le cause profonde dei fenomeni e usare l'analisi dei dati per promuovere il cambiamento è un compito cruciale per qualsiasi azienda. Ecco perché molti leader del settore, come Microsoft, Amazon, Uber, Spotify, McKinsey e molti altri, hanno iniziato a investire pesantemente nelle loro capacità di causal AI.
Questo tutorial copre alcuni dei concetti e delle idee fondamentali della causal AI utilizzando la libreria DoWhy in Python. L'inferenza causale è concettualmente piuttosto diversa dal machine learning standard, quindi la maggior parte delle persone parte con conoscenze di base limitate. Tuttavia, è utile avere nozioni di base sull'analisi di regressione e sulla modellazione statistica per seguire al meglio. Se sei alle prime armi con l'analisi di regressione o hai bisogno di un ripasso, valuta il corso di DataCamp Introduction to Linear Modeling in Python.
Puoi anche esplorare le differenze tra modelli predittivi e causali nel corso DataCamp Machine Learning for Business.
I mattoni della Causal AI
Quando si parla di inferenza causale, dobbiamo adottare un mindset diverso dal machine learning standard e dalla predictive analytics.
La filosofa Nancy Cartwright ha coniato l'espressione: "No causes in, no causes out." Significa che per ottenere risposte causali dobbiamo fare assunzioni sulla struttura causale alla base del fenomeno che stiamo studiando. Un approccio puramente data-driven non è sufficiente.
Può sembrare circolare a prima vista, ma non lo è.
Se vogliamo sapere se la correlazione tra consumo di cioccolato e premi Nobel è causale, dobbiamo escludere spiegazioni alternative. Queste spiegazioni alternative costituiscono conoscenza causale che non sempre troviamo nei dati stessi, ma che dobbiamo integrare con informazioni esterne.
Poniamo di voler introdurre una nuova policy di lavoro da casa (WFH) e di voler capire se inciderà sulla produttività dei dipendenti. Un'analisi iniziale ha mostrato che chi lavora da casa completa più task quotidianamente.
Tuttavia, possiamo essere certi che questa correlazione resterà tale una volta applicata la policy a tutti? In altre parole, possiamo essere sicuri che la relazione tra WFH e produttività sia causale?
Nota: grafico creato da causalfusion.net
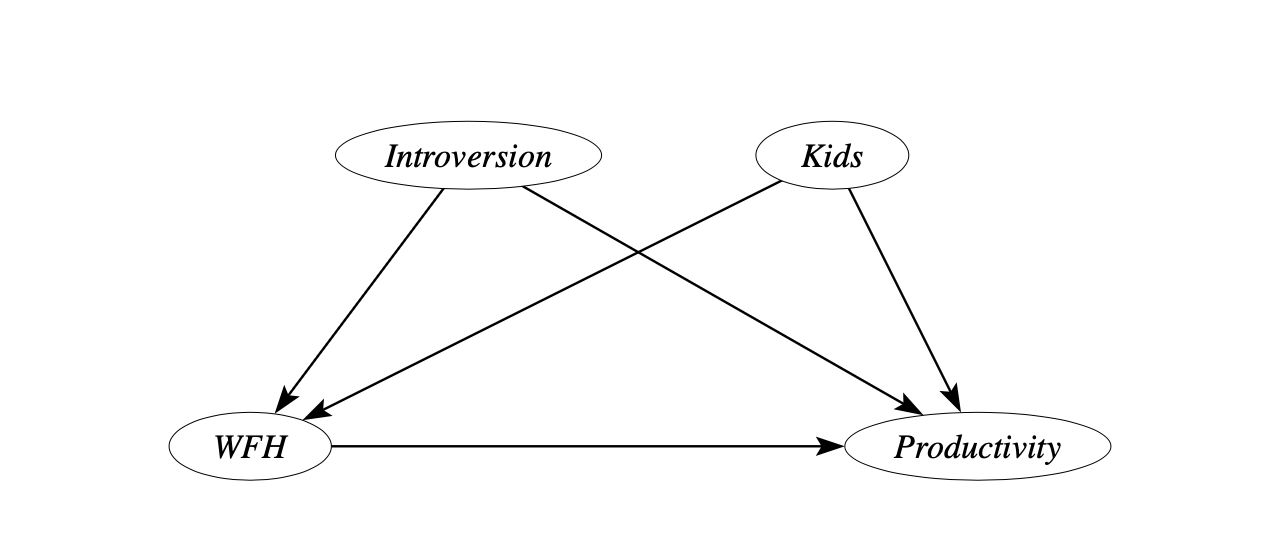
Un semplice modello causale per questo contesto potrebbe apparire così.
Supponiamo che lavorare da casa abbia un effetto sulla produttività, ma non conosciamo la direzione o l'intensità dell'effetto. Allo stesso tempo, potrebbero esserci altre ragioni per cui osserviamo livelli di produttività più alti per chi lavora da casa.
Dipendenti con figli o persone molto introverse, che non tollerano bene il rumore dei nostri grandi open space, potrebbero decidere di lavorare più spesso da casa perché per loro è più comodo. Queste variabili potrebbero a loro volta essere collegate alla produttività, rendendole possibili cause comuni che potrebbero essere anche la fonte della correlazione.
Per rendere esplicite tutte queste assunzioni, le rappresentiamo in quello che viene chiamato grafo causale, una rappresentazione grafica usata per modellare le relazioni tra variabili in un sistema, concentrandosi specificamente sulle relazioni causali.
Scoprirai che alcune di queste assunzioni possono essere piuttosto forti in scenari reali. Il grande vantaggio è che i grafi causali rendono molto esplicite assunzioni e conoscenze pregresse, ma dobbiamo essere sempre pronti a metterle in discussione e a perfezionarle per dare credibilità alle nostre analisi.
Prime mosse con DoWhy in Python
La libreria DoWhy di Microsoft, sviluppata in collaborazione con Amazon Web Services come parte dell'ecosistema PyWhy, sta rapidamente diventando lo standard di settore per l'analisi causale nel mondo Python. Possiamo usare DoWhy per simulare un dataset in base al modello causale sopra, illustrando alcuni passaggi fondamentali della pipeline di inferenza causale. Per prima cosa, dobbiamo installare DoWhy nel nostro ambiente.
!pip install git+https://github.com/microsoft/dowhy.gitUna volta fatto, possiamo caricare le librerie necessarie.
import numpy as np
import pandas as pd
import dowhy
Ora, creiamo noi stessi un dataset. Il grande vantaggio di lavorare con dati simulati quando si studia la causal AI è che abbiamo il pieno controllo sul processo di generazione dei dati e conosciamo la "ground truth", cosa che non avverrebbe con dati reali.
Impostiamo l'effetto causale vero uguale a uno (beta=1), specifichiamo due cause comuni e creiamo diecimila campioni secondo relazioni lineari semplici tra le variabili del modello.
La variabile che esaminiamo come trattamento è impostata come binaria, cioè può essere zero o uno.
In precedenza abbiamo fissato un punto di origine per la generazione di numeri casuali - using np.random.seed(1) - per poter riprodurre esattamente il nostro dataset.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy assegna le seguenti etichette:
Tabella 1
|
Etichetta |
Variabile |
Tipo |
Media |
|
v0 |
La variabile di trattamento, ovvero la principale variabile di interesse nella nostra analisi (lavoro da casa) |
Binaria |
0.608 |
|
y |
L'outcome di interesse (produttività) |
Continua |
1.583 |
|
W0 |
Introversione |
Continua |
-0.148 |
|
W1 |
Numero di figli |
Categorica |
1.5 |
|
Z0 |
Una variabile strumentale che influisce solo su v0 ma non su y (chiusura della metropolitana) |
Binaria |
0.281 |
Qui abbiamo implicitamente definito un grafo causale impostando il tipo di trattamento e il numero di cause comuni. DoWhy memorizza gli oggetti grafo nel linguaggio DOT, che ci offre un modo pratico per specificare il nostro grafo causale diretto (digraph) quando lavoriamo con dati reali.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Infine, combiniamo tutte queste informazioni in un unico modello causale.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Sbloccare la potenza della Causal AI
Prima di condurre la nostra analisi causale, facciamo un benchmark rispetto a ciò che ci direbbe un approccio ingenuo basato su un semplice algoritmo di previsione lineare.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
Il coefficiente angolare in una regressione bivariata è pari a 1.298. Tuttavia, sappiamo che il vero effetto causale è in realtà pari a uno, dato che abbiamo generato i dati in questo modo.
Ciò implica che le due cause comuni, introversione e avere figli, che influenzano sia la produttività sia la probabilità di lavorare da casa, portano in questo caso a una sovrastima di quasi il 30%.
Fortunatamente, finché abbiamo dati su queste variabili, possiamo affrontare facilmente questo bias includendo le cause comuni in un'analisi multivariata.
Nella letteratura sulla causal AI, questo è noto come criterio del backdoor. Vogliamo controllare tutte le variabili nel grafo causale che puntano alla variabile di trattamento. Entrano "dalla porta di servizio" e possono quindi creare una correlazione spuriosa tra trattamento e outcome che non è causale. Nel nostro esempio, ciò vale per introversione e numero di figli.
WFH <— Introversione —> Produttività
WFH <— Figli —> Produttività
DoWhy offre una serie di algoritmi che possono essere utilizzati per determinare se un effetto causale desiderato è identificabile dato un particolare modello causale.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Non sorprende che, nel nostro semplice modello causale per l'effetto del lavoro da casa, l'identificazione causale sia possibile.
Successivamente, possiamo concentrarci sulla stima, ovvero il processo di quantificazione dell'effetto target utilizzando i dati disponibili.
DoWhy offre diversi algoritmi tra cui scegliere, tra cui regressione, matching, stratificazione e metodi di ponderazione. Poiché i dati sottostanti che abbiamo simulato si basavano su relazioni lineari, una semplice regressione sarebbe sufficiente. Se ti serve un ripasso, il corso di DataCamp Intro to Regression with statsmodels in Python può aiutarti.
Tuttavia, per rendere la nostra analisi più generale, useremo il ponderamento per probabilità inversa, che è in grado di gestire anche dati non lineari.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy restituisce una stima dell'effetto causale pari a 1.001. Ovviamente, i numeri in sé non sono molto significativi in questo contesto simulato. Ciò che conta, però, è che siamo molto vicini alla ground truth pari a uno. Rispetto alla regressione eseguita prima, il bias è stato ridotto di un incredibile 99,6%.
Mettere alla prova i tuoi risultati
Tutto molto impressionante, ma non dovremmo fermarci qui.
Il principio "no causes in, no causes out" ci dice che qualsiasi analisi causale può essere valida solo quanto le assunzioni che portiamo al tavolo.
Ad esempio, come possiamo essere sicuri che siano solo introversione e figli a influenzare il WFH, come stabilisce il nostro semplice modello causale?
Per aumentare la fiducia nelle nostre assunzioni, DoWhy ci mette a disposizione un'intera suite di test di confutazione che ci consentono di stressare la nostra analisi, inclusi, ma non solo, test con sottocampioni o trattamenti placebo.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
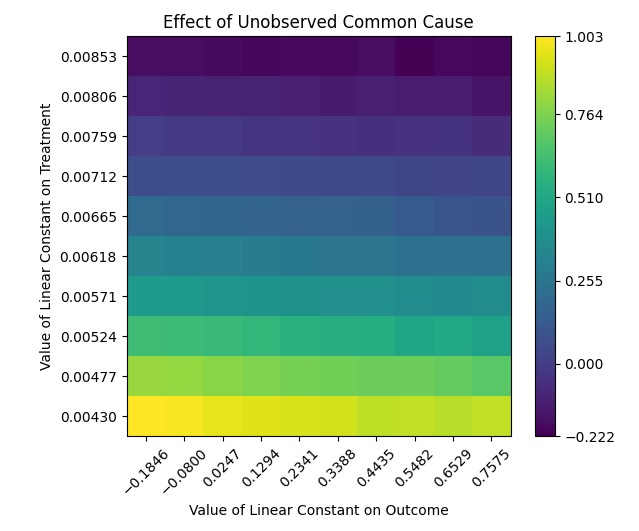
Vediamo cosa succede se aggiungiamo un'altra causa comune oltre a introversione e figli.
Questa volta non abbiamo dati su questa variabile, quindi per noi resterà non osservabile. Quanto sono affidabili le nostre stime? Purtroppo, la risposta non è molto rassicurante.
Il grafico in Figura 2 illustra l'influenza sostanziale che le cause comuni non osservate possono avere sull'effetto causale stimato, variando da -0,222 a 1,003. Questo intervallo è talmente ampio da poter potenzialmente raddoppiare l'effetto stimato.
Non è però molto sorprendente. Meccanismi causali alternativi che coinvolgono variabili non osservate e che non possiamo considerare nell'analisi rappresenteranno sempre un problema negli studi causali.
Fortunatamente, in questo contesto esiste un modo alternativo per ottenere l'identificazione, e DoWhy è abbastanza intelligente da individuarlo per noi.
Trovare strategie causali alternative
Anche se i dipendenti introversi e quelli con figli potrebbero lavorare da casa più spesso, potrebbero esserci altri determinanti del WFH che non sono collegati alla produttività.
Poniamo di aver avuto una grossa interruzione del trasporto pubblico e che una delle linee della metropolitana della nostra città sia stata chiusa per tre mesi. Di conseguenza, i dipendenti che vivevano in quartieri vicini alla linea hanno lavorato più spesso da casa, anche se altrimenti avrebbero preferito venire in ufficio.
Possiamo illustrare così questo modello causale ampliato.
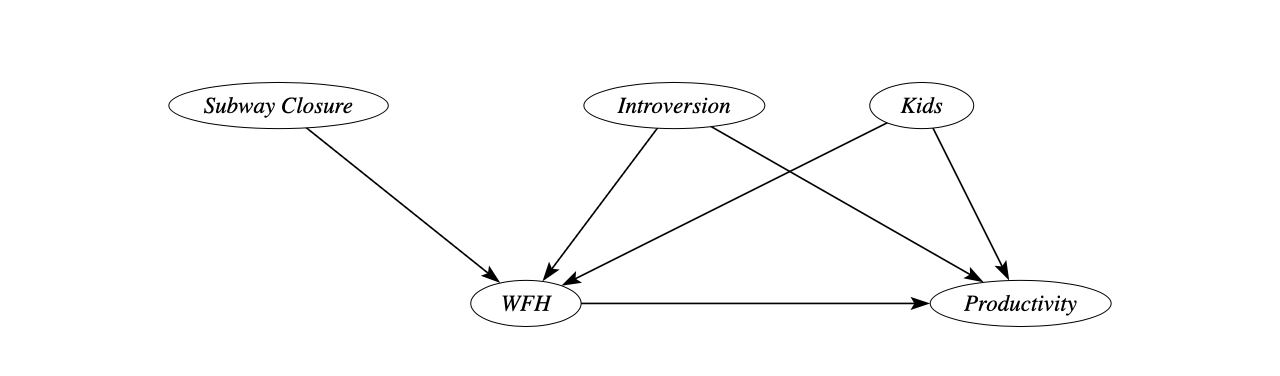
In questo caso, la chiusura della metropolitana funge da cosiddetta variabile strumentale.
Intuitivamente, la chiusura agisce come uno shock sugli orari di pendolarismo delle persone, creando una sorta di esperimento naturale.
Per tre mesi, chi vive vicino alla linea interrotta lavorerà più spesso da casa, ma ciò non ha altra relazione con la loro produttività. Avrai notato che abbiamo già incluso una variabile strumentale, Z0, nella creazione del dataset simulato sopra impostando l'opzione num_instruments=1. La funzione identify_effect() di DoWhy è quindi in grado di trovare automaticamente variabili strumentali adatte nel grafo causale.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Dopo la stima, troviamo che l'effetto causale è 0.920. È leggermente meno accurato della strategia backdoor, ma comunque molto più accurato della previsione ingenua.
La stima con variabili strumentali è vantaggiosa perché non si basa su assunzioni sul numero di cause comuni non osservate del WFH e della produttività.
Quindi, anche se le nostre stime possono essere meno precise, sono più robuste grazie alle assunzioni più deboli. Questo è un trade-off comune nell'analisi causale.
E adesso?
DoWhy è un ottimo punto di partenza per la causal AI. È una potente libreria end-to-end che offre una pipeline di inferenza causale versatile, guidando l'utente attraverso i passaggi essenziali.
Una volta compreso il workflow di base, puoi passare a temi più avanzati come la scoperta causale e potenziare la tua analisi con librerie aggiuntive come DoubleML o daggity, ggdag e pcalg in R. Quando ti sentirai a tuo agio con le basi, potresti esplorare argomenti più avanzati di inferenza causale. Il corso di DataCamp Advanced Causal Inference with R è un ottimo passo successivo.
L'inferenza causale offre una prospettiva nuova sull'analisi dei dati. La maggior parte degli approcci dipende dalla comprensione del grafo causale o da altre assunzioni causali. Il trucco sta nello scegliere le tecniche e le assunzioni adatte alla tua situazione specifica. Questo richiede conoscenza esterna ed esperienza nel dominio.
Perciò, è una buona idea confrontarti con i tuoi esperti di marketing o con gli specialisti HR per avere la loro opinione su un problema specifico e vedere se possono aiutarti a costruire un modello adeguato.
La conoscenza causale è cruciale in molti contesti di business. Dobbiamo capire, ad esempio, se il lancio di un nuovo prodotto è efficace o quanto è valida la nostra strategia pubblicitaria.
Ottenere risposte causali dai dati può essere più difficile che addestrare un semplice algoritmo predittivo, ma ne vale la pena. E librerie come DoWhy ti mettono a disposizione un ottimo set di strumenti per trovare le soluzioni più adatte alle tue esigenze.
Se hai trovato questo tutorial illuminante e non vedi l'ora di applicare tecniche di causal AI ai tuoi progetti, non c'è momento migliore per approfondire. Nel corso completo Machine Learning for Business imparerai non solo i modelli predittivi ma anche quelli causali che possono aiutarti a prendere decisioni di business migliori.