A la hora de tomar decisiones basadas en datos, muchos expertos del sector tienen la sospecha de que los algoritmos de predicción que se usan habitualmente no siempre son fiables. Por ejemplo, la cantidad de chocolate consumido per cápita predice muy bien el número de premios Nobel en un país, y existe una correlación entre las ventas de helado y los ataques de tiburón. Sin embargo, eso no significa que tenga sentido atraer muchos tiburones a la playa para impulsar nuestro negocio de helados.
Lo que está en juego aquí es, por supuesto, la conocida idea de que «correlación no implica causalidad». Que dos variables estén correlacionadas no quiere decir que podamos usar una para influir en la otra. Ambos sucesos pueden venir dados por una tercera variable, como el «tiempo soleado» en el ejemplo de los tiburones y los helados, que actúa como causa común de ambos. Al mismo tiempo, entender las causas de fondo de los fenómenos y usar el análisis de datos para impulsar cambios es clave para cualquier negocio. Por eso muchos líderes del sector, como Microsoft, Amazon, Uber, Spotify, McKinsey y muchos más, han empezado a invertir fuertemente en capacidades de IA causal.
Este tutorial cubre algunos de los conceptos e ideas fundamentales de la IA causal usando la biblioteca DoWhy en Python. La inferencia causal es conceptualmente distinta del aprendizaje automático estándar, así que la mayoría empezará con poca base previa. No obstante, tener conocimientos básicos de análisis de regresión y modelado estadístico te ayudará a seguirlo. Si eres nuevo en regresión o quieres refrescar conceptos, echa un vistazo al curso de DataCamp Introduction to Linear Modeling in Python.
También puedes explorar las diferencias entre modelos predictivos y causales en el curso de DataCamp Machine Learning for Business.
Los bloques de construcción de la IA causal
Cuando hablamos de inferencia causal, necesitamos adoptar una mentalidad distinta a la de machine learning y analítica predictiva.
La filósofa Nancy Cartwright acuñó la frase: «Sin causas a la entrada, no hay causas a la salida». Es decir, tenemos que hacer supuestos sobre la estructura causal que subyace al fenómeno que estudiamos para poder obtener respuestas causales. Un enfoque puramente basado en datos no basta.
Puede sonar circular, pero no lo es.
Si queremos saber si la correlación entre consumo de chocolate y premios Nobel es causal, debemos descartar explicaciones alternativas. Esas explicaciones alternativas son conocimiento causal que no siempre hallarás en los datos y que hay que aportar desde fuera.
Imagina que estamos valorando implantar una política de teletrabajo (WFH) y queremos saber si afectará a la productividad. Un análisis inicial muestra que quienes trabajan desde casa completan más tareas al día.
Ahora bien, ¿podemos estar seguros de que esa correlación se mantendrá cuando la política se aplique a todo el mundo? En otras palabras, ¿podemos asegurar que la relación entre WFH y productividad es causal?
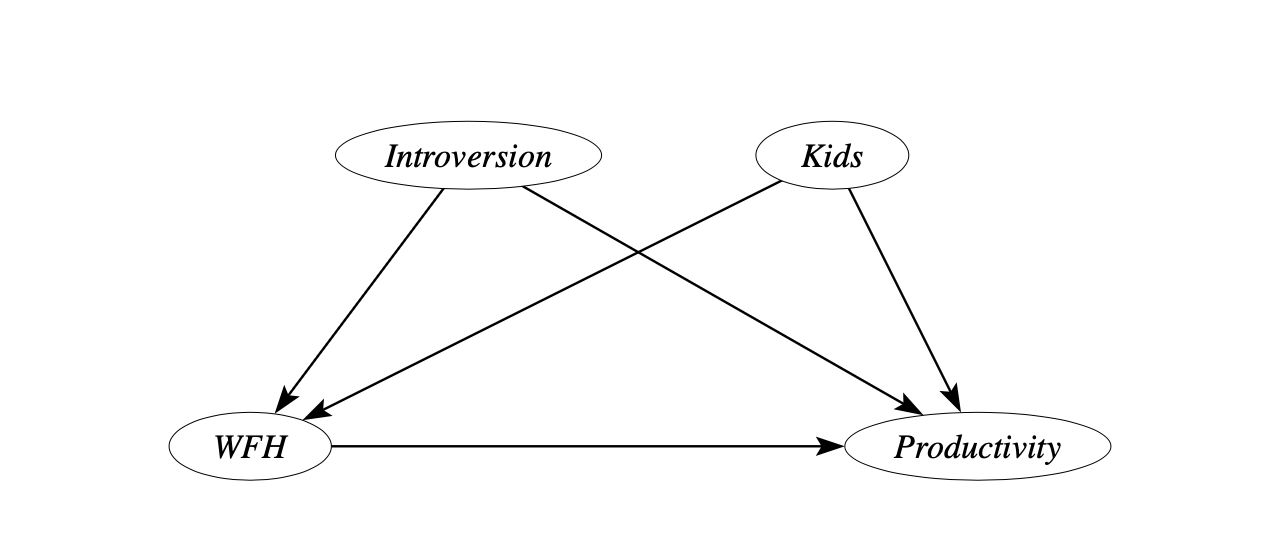
Nota: gráfico creado por causalfusion.net
Un modelo causal sencillo para este contexto podría ser así.
Suponemos que trabajar desde casa afecta a la productividad, pero no conocemos la dirección ni la intensidad del efecto. A la vez, puede haber otros motivos por los que veamos mayor productividad entre quienes teletrabajan.
Personas con hijos o muy introvertidas, que no llevan bien el ruido de una oficina diáfana, pueden optar por trabajar más desde casa porque les resulta más cómodo. Estas variables podrían estar a su vez relacionadas con la productividad, lo que las convierte en causas comunes potenciales que también pueden explicar la correlación.
Para hacer explícitas todas estas hipótesis, las plasmamos en lo que se conoce como grafo causal, una representación gráfica que modela las relaciones entre variables de un sistema, con foco en las relaciones causales.
Verás que algunos de estos supuestos pueden ser fuertes en escenarios reales. La gran ventaja es que los grafos causales hacen muy explícitas las hipótesis y el conocimiento previo, pero siempre debemos estar listos para cuestionarlos y afinarlos para dar credibilidad a nuestros análisis.
Primeros pasos con DoWhy en Python
La biblioteca DoWhy de Microsoft, desarrollada junto con Amazon Web Services como parte del ecosistema PyWhy, se está convirtiendo rápidamente en el estándar del sector para el análisis causal en Python. Podemos usar DoWhy para simular un conjunto de datos según nuestro modelo causal y así ilustrar pasos fundamentales del flujo de inferencia causal. Primero, instala DoWhy en tu entorno.
!pip install git+https://github.com/microsoft/dowhy.gitUna vez hecho, cargamos las bibliotecas necesarias.
import numpy as np
import pandas as pd
import dowhy
Ahora, creemos un conjunto de datos propio. La gran ventaja de trabajar con datos simulados al estudiar IA causal es que controlamos por completo el proceso generador de datos y conocemos la «realidad subyacente», algo que con datos reales no ocurre.
Fijamos el efecto causal verdadero en uno (beta=1), especificamos dos causas comunes y creamos diez mil observaciones según relaciones lineales sencillas entre las variables del modelo.
La variable de tratamiento que analizamos es binaria: solo puede valer cero o uno.
Antes, establecimos un punto de partida fijo para la generación aleatoria —using np.random.seed(1)— para poder reproducir exactamente el conjunto de datos.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy asigna las siguientes etiquetas:
Tabla 1
|
Etiqueta |
Variable |
Tipo |
Media |
|
v0 |
Variable de tratamiento, la principal variable de interés en nuestro análisis (teletrabajo) |
Binaria |
0.608 |
|
y |
Resultado de interés (productividad) |
Continua |
1.583 |
|
W0 |
Introversión |
Continua |
-0.148 |
|
W1 |
Número de hijos |
Categoría |
1.5 |
|
Z0 |
Variable instrumental que solo afecta a v0 y no a y (cierre del metro) |
Binaria |
0.281 |
Aquí hemos definido implícitamente un grafo causal al fijar el tipo de tratamiento y el número de causas comunes. DoWhy almacena los grafos en el lenguaje DOT, lo que nos da una forma cómoda de especificar nuestro propio grafo causal dirigido (digraph) cuando trabajemos con datos reales.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Por último, combinamos toda esta información en un único modelo causal.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Aprovechar la potencia de la IA causal
Antes de ejecutar nuestro análisis causal, comparemos con lo que nos diría un enfoque ingenuo basado en una regresión lineal simple.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
El coeficiente de la pendiente en una regresión bivariada es 1.298. Sin embargo, sabemos que el efecto causal verdadero es uno, porque así generamos los datos.
Esto implica que las dos causas comunes, introversión y tener hijos, que influyen tanto en la productividad como en la probabilidad de teletrabajar, llevan a una sobreestimación de casi el 30% en este caso.
Por suerte, mientras tengamos datos de estas variables, podemos corregir este sesgo fácilmente añadiendo las causas comunes en un análisis multivariante.
En la literatura de IA causal, esto se conoce como el criterio de la puerta trasera. Queremos controlar todas las variables del grafo causal que apuntan a la variable de tratamiento. Entran por la «puerta trasera» y pueden crear una correlación espuria entre tratamiento y resultado que no es causal. En nuestro ejemplo, aplica a la introversión y al número de hijos.
WFH <— Introversión —> Productividad
WFH <— Hijos —> Productividad
DoWhy ofrece varios algoritmos para determinar si un efecto causal deseado es identificable dado un modelo causal concreto.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Como era de esperar, en nuestro modelo sencillo del efecto del teletrabajo, la identificación causal es posible.
A continuación, pasamos a la estimación, el proceso de cuantificar el efecto objetivo con los datos disponibles.
DoWhy ofrece varios algoritmos entre los que elegir, como regresión, emparejamiento, estratificación y ponderación. Dado que los datos simulados se basan en relaciones lineales, una regresión simple bastaría. Si necesitas un repaso, el curso de DataCamp Intro to Regression with statsmodels in Python puede ayudarte.
Sin embargo, para hacer el análisis más general, usaremos la ponderación por probabilidad inversa, que también maneja datos no lineales.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy devuelve una estimación del efecto causal igual a 1.001. Obviamente, las cifras concretas no son muy relevantes en este contexto simulado. Lo importante es que estamos muy cerca de la verdad subyacente, que es uno. En comparación con la regresión previa, el sesgo se ha reducido en un asombroso 99,6%.
Poner a prueba tus resultados
Está muy bien, pero no deberíamos quedarnos ahí.
El principio de «sin causas a la entrada, no hay causas a la salida» nos recuerda que cualquier análisis causal es tan bueno como los supuestos en los que se apoya.
Por ejemplo, ¿cómo sabemos que solo la introversión y los hijos afectan al WFH, como estipula nuestro modelo causal sencillo?
Para ganar confianza en nuestros supuestos, DoWhy nos ofrece toda una batería de tests de refutación para someter el análisis a estrés, como pruebas con submuestras o tratamientos placebo, entre otros.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
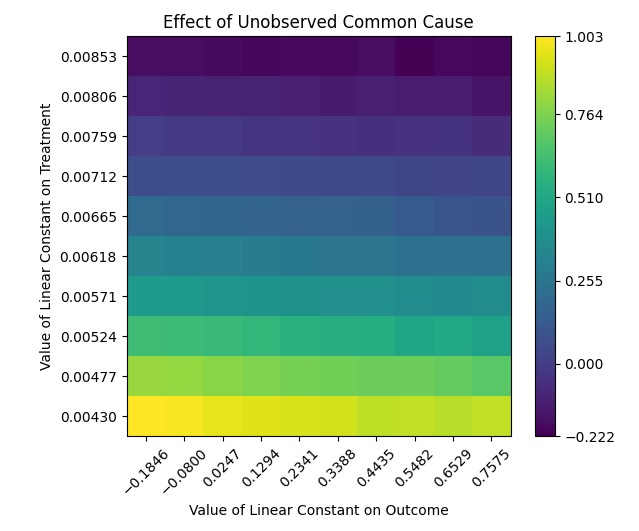
Veamos qué pasa si añadimos otra causa común además de introversión e hijos.
Esta vez no tenemos datos de esa variable, por lo que seguirá siendo no observable. ¿Qué tan fiables son nuestras estimaciones? Por desgracia, la respuesta no es muy tranquilizadora.
El gráfico de la figura 2 ilustra la gran influencia que pueden tener causas comunes no observadas en el efecto causal estimado, con un rango de -0.222 a 1.003. Es tan amplio que podría incluso duplicar el efecto estimado.
No es sorprendente. Los mecanismos causales alternativos que implican variables no observadas y que no podemos incorporar al análisis siempre son un problema en los estudios causales.
Afortunadamente, existe una vía alternativa para lograr la identificación en este contexto, y DoWhy es lo bastante inteligente como para detectarla.
Encontrar estrategias causales alternativas
Aunque las personas introvertidas o con hijos pueden teletrabajar más a menudo, puede haber otros determinantes del WFH que no estén relacionados con la productividad.
Imagina una gran interrupción del transporte público y que una línea de metro de la ciudad se cierra durante tres meses. Como resultado, quienes viven cerca de esa línea tenderán a trabajar más desde casa, aunque en otras circunstancias preferirían ir a la oficina.
Podemos ilustrar este modelo causal ampliado así.
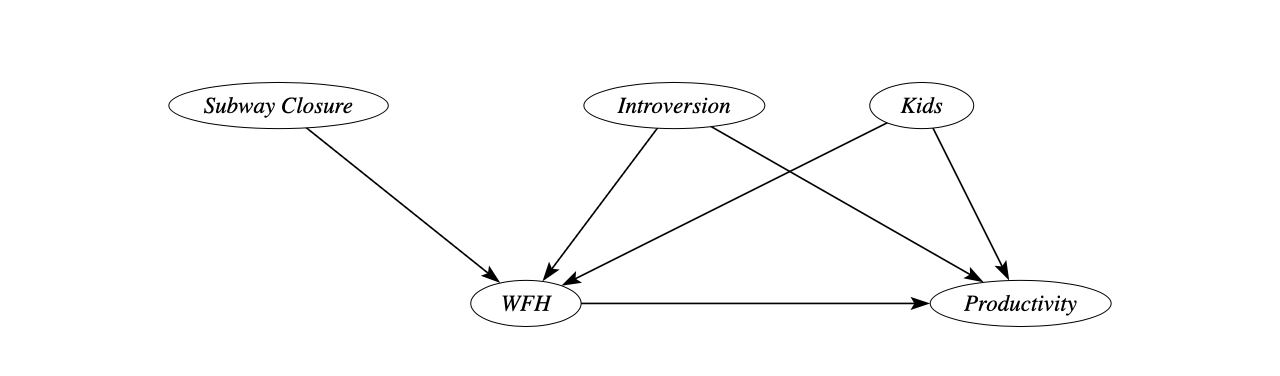
En este caso, el cierre del metro actúa como una variable instrumental.
Intuitivamente, el cierre es un shock sobre los patrones de desplazamiento, creando una especie de experimento natural.
Durante tres meses, quienes viven cerca de la línea afectada trabajarán más desde casa, pero eso no guarda otra relación con su productividad. Quizá te hayas fijado en que ya incluimos una variable instrumental, Z0, al crear el conjunto de datos simulado más arriba con la opción num_instruments=1. La función identify_effect() de DoWhy puede encontrar automáticamente variables instrumentales adecuadas en el grafo causal.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Tras la estimación, obtenemos un efecto causal de 0.920. Es un poco menos preciso que la estrategia de puerta trasera, pero mucho más preciso que la predicción ingenua.
La estimación con variables instrumentales tiene la ventaja de que no depende de supuestos sobre el número de causas comunes no observadas de WFH y productividad.
Por tanto, aunque nuestras estimaciones puedan ser menos precisas, son más robustas porque requieren supuestos más débiles. Este es un compromiso habitual en análisis causal.
¿Y ahora qué?
DoWhy es un excelente punto de partida para la IA causal. Es una biblioteca potente de extremo a extremo que ofrece un flujo de inferencia causal versátil y te guía por los pasos esenciales.
Una vez domines el flujo básico, puedes pasar a temas más avanzados como el descubrimiento causal y potenciar tu análisis con bibliotecas como DoubleML, o daggity, ggdag y pcalg en R. Cuando te sientas cómodo con las bases, quizá quieras explorar temas avanzados de inferencia causal. El curso de DataCamp Advanced Causal Inference with R es un gran siguiente paso.
La inferencia causal ofrece una nueva forma de mirar los datos. La mayoría de enfoques dependen de comprender el grafo causal u otros supuestos causales. La clave está en elegir las técnicas y supuestos adecuados para tu situación. Esto requiere conocimiento externo y experiencia de dominio.
Por ello, es buena idea consultar con tus especialistas de marketing o RR. HH. para conocer su opinión sobre un problema concreto y ver si pueden ayudarte a plantear un modelo adecuado.
El conocimiento causal es crucial en muchos contextos de negocio. Necesitamos entender, por ejemplo, si el lanzamiento de un nuevo producto está funcionando o cuán eficaz es nuestra estrategia publicitaria.
Obtener respuestas causales de los datos puede ser más difícil que entrenar un algoritmo de predicción sencillo, pero merece la pena. Y bibliotecas como DoWhy te ofrecen un gran conjunto de herramientas para encontrar las soluciones que mejor se ajusten a tus necesidades.
Si este tutorial te ha resultado útil y tienes ganas de aplicar técnicas de IA causal en tus proyectos, es un gran momento para profundizar. En el curso completo de Machine Learning for Business aprenderás no solo modelos predictivos, sino también modelos causales que te ayudarán a tomar mejores decisiones de negocio.