Wenn es darum geht, Entscheidungen auf Basis von Daten zu treffen, bleibt bei vielen Branchenprofis ein Restzweifel: Vorhersagealgorithmen sind nicht immer zuverlässig. So sagt etwa der Pro-Kopf-Schokoladenkonsum erstaunlich gut die Zahl der Nobelpreisträger eines Landes voraus, und es gibt eine Korrelation zwischen Eisverkäufen und Haiangriffen. Das heißt aber nicht, dass es eine gute Idee wäre, möglichst viele Haie an den Strand zu locken, um unser Eisgeschäft anzukurbeln.
Worum es hier geht, ist das bekannte Prinzip: „Korrelation ist nicht Kausalität.“ Nur weil zwei Variablen zusammenhängen, können wir nicht die eine nutzen, um die andere zu beeinflussen. Beides kann von einer dritten Größe angetrieben werden – im Beispiel von Haien und Eisverkäufen etwa das „Sonnenwetter“ als gemeinsame Ursache. Gleichzeitig ist es für jedes Unternehmen entscheidend, Ursachen zu verstehen und Datenanalysen gezielt für Veränderungen einzusetzen. Deshalb investieren viele Vorreiter wie Microsoft, Amazon, Uber, Spotify, McKinsey und zahlreiche weitere massiv in ihre kausalen KI-Fähigkeiten.
Dieses Tutorial führt in einige der zentralen Konzepte und Ideen kausaler KI mit der DoWhy-Bibliothek in Python ein. Kausale Inferenz unterscheidet sich grundlegend von klassischem Machine Learning, daher starten viele mit wenig Vorwissen. Grundkenntnisse in Regressionsanalyse und statistischer Modellierung helfen jedoch beim Mitmachen. Wenn du neu in der Regressionsanalyse bist oder eine Auffrischung brauchst, schau dir den DataCamp-Kurs Introduction to Linear Modeling in Python an.
Die Unterschiede zwischen prädiktiven und kausalen Modellen kannst du auch im DataCamp-Kurs Machine Learning for Business erkunden.
Die Bausteine kausaler KI
Für die kausale Inferenz brauchen wir ein anderes Mindset als für klassisches Machine Learning und prädiktive Analytik.
Die Philosophin Nancy Cartwright prägte den Satz: „No causes in, no causes out.“ Das heißt: Wir müssen Annahmen über die kausale Struktur des Phänomens treffen, das wir untersuchen, um kausale Antworten zu bekommen. Ein rein datengetriebener Ansatz reicht nicht aus.
Das klingt zunächst zirkulär, ist es aber nicht.
Wenn wir wissen wollen, ob der Zusammenhang zwischen Schokoladenkonsum und Nobelpreisen kausal ist, müssen wir alternative Erklärungen ausschließen. Diese Alternativen sind kausales Wissen, das nicht zwingend in den Daten steckt, sondern das wir von außen einbringen müssen.
Angenommen, wir denken über eine neue Homeoffice-(WFH)-Regelung nach und wollen wissen, ob sie die Produktivität der Mitarbeitenden beeinflusst. Eine erste Analyse zeigt: Wer von zu Hause arbeitet, erledigt täglich mehr Aufgaben.
Können wir aber sicher sein, dass dieser Zusammenhang bestehen bleibt, wenn die Regelung für alle gilt? Mit anderen Worten: Ist die Beziehung zwischen WFH und Produktivität wirklich kausal?
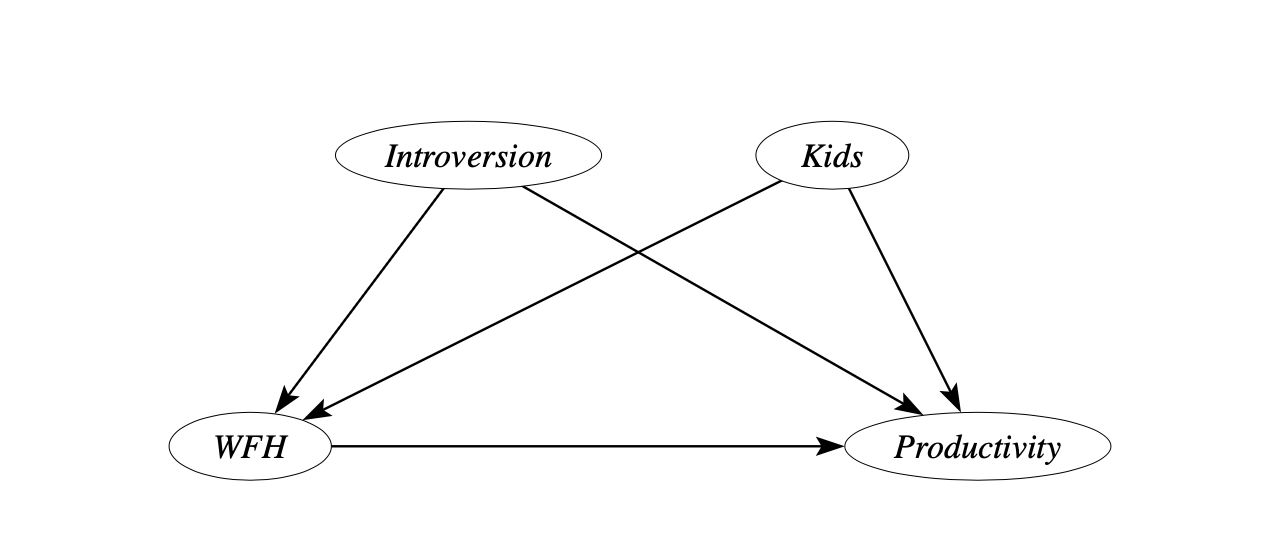
Hinweis: Graph erstellt von causalfusion.net
Ein einfaches Kausalmodell für diesen Kontext könnte so aussehen.
Wir vermuten, dass Homeoffice die Produktivität beeinflusst, kennen aber weder Richtung noch Stärke des Effekts. Zugleich kann es andere Gründe für die höhere Produktivität bei Heimarbeit geben.
Beschäftigte mit Kindern oder sehr introvertierte Personen, die sich im Großraum schwer konzentrieren, arbeiten häufiger zu Hause, weil es für sie praktischer ist. Diese Variablen können selbst mit Produktivität zusammenhängen und damit als gemeinsame Ursachen die beobachtete Korrelation erklären.
Um all diese Annahmen explizit zu machen, stellen wir sie in einem sogenannten Kausalgraphen dar – einer grafischen Repräsentation, die Beziehungen zwischen Variablen eines Systems modelliert, mit Fokus auf Kausalzusammenhänge.
Du wirst feststellen, dass manche Annahmen in der Praxis recht stark sind. Der große Vorteil: Kausalgraphen machen Annahmen und Vorwissen sehr transparent. Trotzdem sollten wir sie immer wieder hinterfragen und verfeinern, um unseren Analysen Glaubwürdigkeit zu geben.
Erste Schritte mit DoWhy in Python
Microsofts DoWhy-Bibliothek, gemeinsam mit Amazon Web Services als Teil des PyWhy-Ökosystems entwickelt, wird schnell zum Branchenstandard für Kausalanalysen in Python. Mit DoWhy können wir entsprechend unserem obigen Kausalmodell einen Datensatz simulieren und die grundlegenden Schritte der kausalen Inferenz veranschaulichen. Zuerst installieren wir DoWhy in unserer Umgebung.
!pip install git+https://github.com/microsoft/dowhy.gitAnschließend laden wir die benötigten Bibliotheken.
import numpy as np
import pandas as pd
import dowhy
Jetzt erstellen wir selbst einen Datensatz. Der große Vorteil simulierte Daten für kausale KI zu nutzen: Wir kontrollieren den Daten-Generierungsprozess vollständig und kennen die „Ground Truth“ – bei Realweltdaten wäre das nicht der Fall.
Wir setzen den wahren kausalen Effekt auf eins (beta=1), definieren zwei gemeinsame Ursachen und erzeugen zehntausend Stichproben basierend auf einfachen linearen Beziehungen zwischen den Variablen.
Die Behandlungsvariable, die wir betrachten, ist binär, sie kann also den Wert null oder eins annehmen.
Zuvor haben wir für die Zufallszahlengenerierung einen festen Startpunkt gesetzt – using np.random.seed(1) – damit wir unseren Datensatz exakt reproduzieren können.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy vergibt dabei folgende Labels:
Tabelle 1
|
Label |
Variable |
Typ |
Mittelwert |
|
v0 |
Die Behandlungsvariable, also die zentrale Variable unserer Analyse (Homeoffice) |
Binär |
0.608 |
|
y |
Das interessierende Ergebnis (Produktivität) |
Stetig |
1.583 |
|
W0 |
Introversion |
Stetig |
-0.148 |
|
W1 |
Anzahl der Kinder |
Kategorisch |
1.5 |
|
Z0 |
Eine Instrumentvariable, die nur v0, nicht aber y beeinflusst (U-Bahn-Sperrung) |
Binär |
0.281 |
Hier haben wir implizit einen Kausalgraphen definiert, indem wir Typ der Behandlung und die Zahl gemeinsamer Ursachen festgelegt haben. DoWhy speichert Graphobjekte in der DOT-Sprache. Das erleichtert es uns, mit Realweltdaten einen eigenen gerichteten Kausalgraphen (Digraph) zu spezifizieren.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Zum Schluss fassen wir alle Informationen in einem Kausalmodell zusammen.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Die Kraft kausaler KI nutzen
Bevor wir die Kausalanalyse durchführen, vergleichen wir sie mit einem naiven Ansatz auf Basis einer einfachen linearen Regression.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
Der Steigungskoeffizient in der bivariaten Regression beträgt 1.298. Wir wissen jedoch, dass der wahre kausale Effekt eins ist, da wir die Daten so generiert haben.
Das bedeutet: Die beiden gemeinsamen Ursachen, Introversion und Kinder, die sowohl Produktivität als auch die Wahrscheinlichkeit für Homeoffice beeinflussen, führen hier zu einer Überschätzung von fast 30%.
Zum Glück können wir diese Verzerrung leicht beheben, solange wir Daten zu diesen Variablen haben: Wir nehmen die gemeinsamen Ursachen in eine multivariate Analyse auf.
In der Literatur zur kausalen KI ist das als Backdoor-Kriterium bekannt. Wir wollen alle Variablen kontrollieren, die im Kausalgraphen in die Behandlungsvariable hineinzeigen. Sie „kommen durch die Hintertür“ und können so eine Scheinkorrelation zwischen Behandlung und Ergebnis erzeugen. In unserem Beispiel betrifft das Introversion und die Anzahl der Kinder.
WFH <— Introversion —> Produktivität
WFH <— Kinder —> Produktivität
DoWhy bietet eine Reihe von Algorithmen, um zu prüfen, ob sich ein gewünschter kausaler Effekt für ein gegebenes Kausalmodell identifizieren lässt.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Wenig überraschend ist in unserem einfachen Kausalmodell zum Effekt von Homeoffice die kausale Identifikation möglich.
Als Nächstes geht es um die Schätzung, also darum, den Zieleffekt mit den verfügbaren Daten zu quantifizieren.
DoWhy bietet zahlreiche Verfahren wie Regression, Matching, Stratifizierung und Gewichtung. Da unsere simulierten Daten auf linearen Beziehungen beruhen, würde eine einfache Regression reichen. Falls du eine Auffrischung brauchst, hilft der DataCamp-Kurs Intro to Regression with statsmodels in Python.
Um die Analyse allgemeiner zu halten, verwenden wir jedoch Inverse-Probability-Weighting, das auch mit nichtlinearen Daten umgehen kann.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy liefert eine Kausaleffektschätzung von 1.001. Die genaue Zahl ist im simulierten Kontext nicht entscheidend. Wichtig ist: Wir liegen sehr nahe an der Ground Truth von eins. Gegenüber der zuvor geschätzten Regression ist die Verzerrung um beeindruckende 99,6% gesunken.
Ergebnisse auf Belastungsprobe stellen
Das ist beachtlich, aber wir sollten hier nicht aufhören.
Das Prinzip „No causes in, no causes out“ besagt: Jede Kausalanalyse ist nur so gut wie ihre Annahmen.
Woher wissen wir zum Beispiel, dass wirklich nur Introversion und Kinder WFH beeinflussen, wie es unser einfaches Modell vorsieht?
Um mehr Vertrauen in unsere Annahmen zu gewinnen, stellt DoWhy eine ganze Suite an Widerlegungstests bereit, mit denen wir die Analyse stärken können – etwa Tests mit Teilstichproben oder Placebo-Behandlungen.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
Schauen wir, was passiert, wenn wir neben Introversion und Kindern eine weitere gemeinsame Ursache hinzufügen.
Diesmal haben wir zu dieser Variablen keine Daten, sie bleibt also unbeobachtet. Wie belastbar sind unsere Schätzungen? Leider nicht sehr beruhigend.
Die Grafik in Abbildung 2 zeigt, wie stark unbeobachtete gemeinsame Ursachen den geschätzten Kausaleffekt beeinflussen können – von -0.222 bis 1.003. Die Spannweite ist so groß, dass sich der Effekt potenziell verdoppeln könnte.
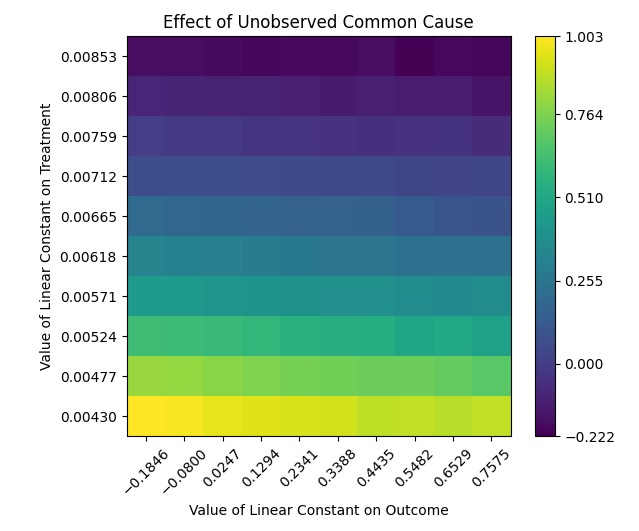
Das ist allerdings nicht überraschend. Alternative kausale Mechanismen mit unbeobachteten Variablen, die wir in der Analyse nicht berücksichtigen können, bleiben in kausalen Studien immer ein Problem.
Zum Glück gibt es in diesem Kontext eine alternative Strategie für die Identifikation – und DoWhy ist klug genug, sie zu finden.
Alternative Kausalstrategien finden
Auch wenn introvertierte Mitarbeitende und solche mit Kindern häufiger im Homeoffice sind, kann es weitere Determinanten von WFH geben, die nichts mit Produktivität zu tun haben.
Angenommen, es kommt zu einer massiven Störung im öffentlichen Nahverkehr und eine U-Bahn-Linie in unserer Stadt wird für drei Monate gesperrt. Mitarbeitende aus den betroffenen Vierteln arbeiten in der Folge häufiger von zu Hause, selbst wenn sie sonst ins Büro gekommen wären.
Dieses erweiterte Kausalmodell lässt sich wie folgt darstellen.
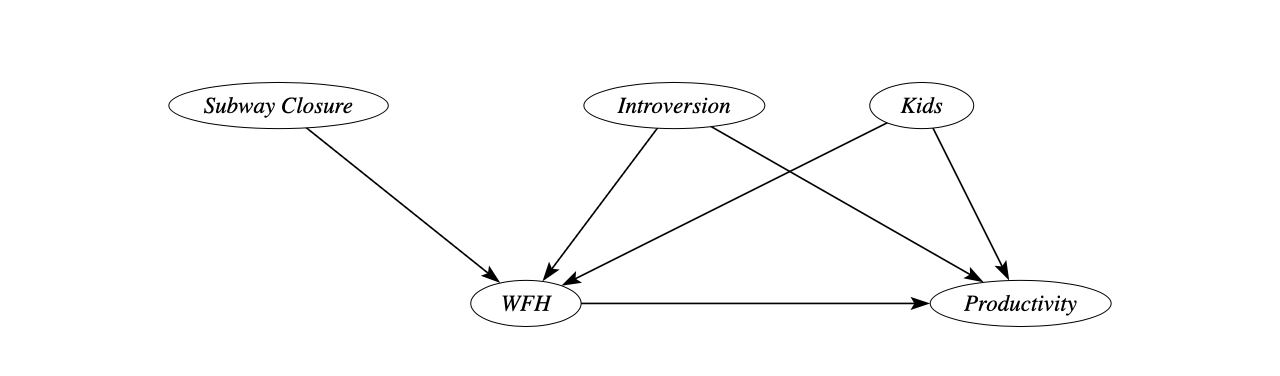
In diesem Fall fungiert die U-Bahn-Sperrung als sogenannte Instrumentvariable.
Anschaulich wirkt die Sperrung wie ein Schock auf die Pendelroutinen und erzeugt eine Art natürliches Experiment.
Drei Monate lang arbeiten Menschen nahe der betroffenen Linie häufiger von zu Hause, ohne dass dies sonst etwas mit ihrer Produktivität zu tun hätte. Du hast vielleicht bemerkt, dass wir eine solche Instrumentvariable Z0 bereits bei der Simulation eingebaut haben – mit der Option num_instruments=1. Die Funktion identify_effect() von DoWhy kann dann automatisch geeignete Instrumente im Kausalgraphen finden.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Die Schätzung ergibt einen Kausaleffekt von 0.920. Das ist etwas weniger präzise als die Backdoor-Strategie, aber deutlich besser als die naive Vorhersage.
Der Vorteil der Instrumentvariablen-Schätzung: Sie hängt nicht von Annahmen über die Zahl unbeobachteter gemeinsamer Ursachen von WFH und Produktivität ab.
Unsere Schätzungen sind damit zwar mitunter weniger präzise, aber aufgrund schwächerer Annahmen robuster. Dieser Trade-off ist in der Kausalanalyse typisch.
Wie geht es weiter?
DoWhy ist ein hervorragender Einstieg in kausale KI. Die Bibliothek deckt die gesamte Pipeline ab und führt dich durch die wichtigsten Schritte.
Wenn du den grundlegenden Workflow verinnerlicht hast, kannst du dich an fortgeschrittene Themen wie Causal Discovery wagen und deine Analysen mit weiteren Libraries wie DoubleML erweitern oder in R mit daggity, ggdag und pcalg. Wenn du dich mit den Grundlagen sicher fühlst, ist DataCamps Kurs Advanced Causal Inference with R ein starker nächster Schritt.
Kausale Inferenz eröffnet einen neuen Blick auf Datenanalyse. Die meisten Ansätze setzen ein Verständnis des Kausalgraphen oder andere kausale Annahmen voraus. Entscheidend ist, Verfahren und Annahmen zu wählen, die zu deinem Kontext passen. Dafür brauchst du externes Wissen und Fachexpertise.
Hol dir daher die Meinungen deiner Marketing- oder HR-Expertinnen und -Experten ein, um ein passendes Modell zu entwickeln.
Kausales Wissen ist in vielen Business-Kontexten zentral. Wir müssen zum Beispiel verstehen, ob unser Produktlaunch erfolgreich war oder wie wirkungsvoll unsere Werbestrategie ist.
Kausale Antworten aus Daten zu gewinnen ist anspruchsvoller als das Training eines simplen Vorhersagemodells, aber die Mühe lohnt sich. Und Bibliotheken wie DoWhy geben dir ein starkes Toolset an die Hand, um die für dich passenden Lösungen zu finden.
Wenn dir dieses Tutorial weitergeholfen hat und du kausale KI in deinen eigenen Projekten anwenden willst, ist jetzt der ideale Zeitpunkt, dein Verständnis zu vertiefen. Im umfassenden Kurs Machine Learning for Business lernst du nicht nur prädiktive, sondern auch kausale Modelle kennen, die dir helfen, bessere geschäftliche Entscheidungen zu treffen.