50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Als het gaat om beslissingen nemen op basis van data, hebben veel professionals in de sector het knagende gevoel dat gangbare voorspelalgoritmen niet altijd betrouwbaar zijn. Zo is de hoeveelheid geconsumeerde chocolade per hoofd van de bevolking sterk voorspellend voor het aantal Nobelprijswinnaars in een land, en is er een correlatie tussen ijsverkoop en haaienaanvallen. Dat betekent echter niet dat het een goed idee is om veel haaien naar het strand te lokken om onze ijsverkoop een boost te geven.
Waar het hier om draait, is natuurlijk het bekende idee dat "correlatie geen causaliteit impliceert". Dat twee variabelen correleren, betekent niet dat we de ene kunnen gebruiken om de andere te beïnvloeden. Beide verschijnselen kunnen worden gedreven door een derde variabele, zoals "zonnig weer" in het voorbeeld van haaien en ijsverkoop, die als gemeenschappelijke oorzaak van beide fungeert. Tegelijkertijd is het begrijpen van de oorzaken van verschijnselen en het inzetten van data-analyse om verandering te stimuleren een cruciale taak voor elk bedrijf. Daarom investeren veel marktleiders, zoals Microsoft, Amazon, Uber, Spotify, McKinsey en veel meer, volop in hun causale AI-capaciteiten.
Deze tutorial behandelt enkele van de basisconcepten en -ideeën van causale AI met de DoWhy-bibliotheek in Python. Causale inferentie verschilt conceptueel behoorlijk van standaard machine learning, dus de meeste mensen beginnen met beperkte voorkennis. Basiskennis van regressieanalyse en statistische modellering is wel behulpzaam om mee te kunnen doen. Als regressieanalyse nieuw voor je is of je een opfrisser kunt gebruiken, bekijk dan DataCamp's cursus Introduction to Linear Modeling in Python.
Je kunt de verschillen tussen voorspellende en causale modellen ook verkennen in de DataCamp-cursus Machine Learning for Business.
Als het om causale inferentie gaat, moeten we een andere mindset aannemen dan bij standaard machine learning en voorspellende analytics.
De filosoof Nancy Cartwright muntte de uitdrukking: "No causes in, no causes out." Dit betekent dat we aannames moeten doen over de causale structuur achter het fenomeen dat we bestuderen om er causale antwoorden uit te krijgen. Een puur datagedreven aanpak is niet genoeg.
Dat klinkt misschien cirkelredenerend, maar dat is het niet.
Als we willen weten of de correlatie tussen chocoladeconsumptie en Nobelprijswinnaars causaal is, moeten we alternatieve verklaringen uitsluiten. Die alternatieve verklaringen vormen causale kennis die we niet altijd in de data zelf vinden, maar van buitenaf moeten inbrengen.
Stel, we overwegen een nieuw beleid voor thuiswerken (WFH) en willen weten of dit de productiviteit van medewerkers beïnvloedt. Een eerste analyse laat zien dat teamleden die thuiswerken dagelijks meer taken afronden.
Maar kunnen we er zeker van zijn dat die correlatie blijft bestaan zodra het beleid voor iedereen wordt ingevoerd? Met andere woorden: kunnen we zeker zijn dat de relatie tussen WFH en productiviteit causaal is?
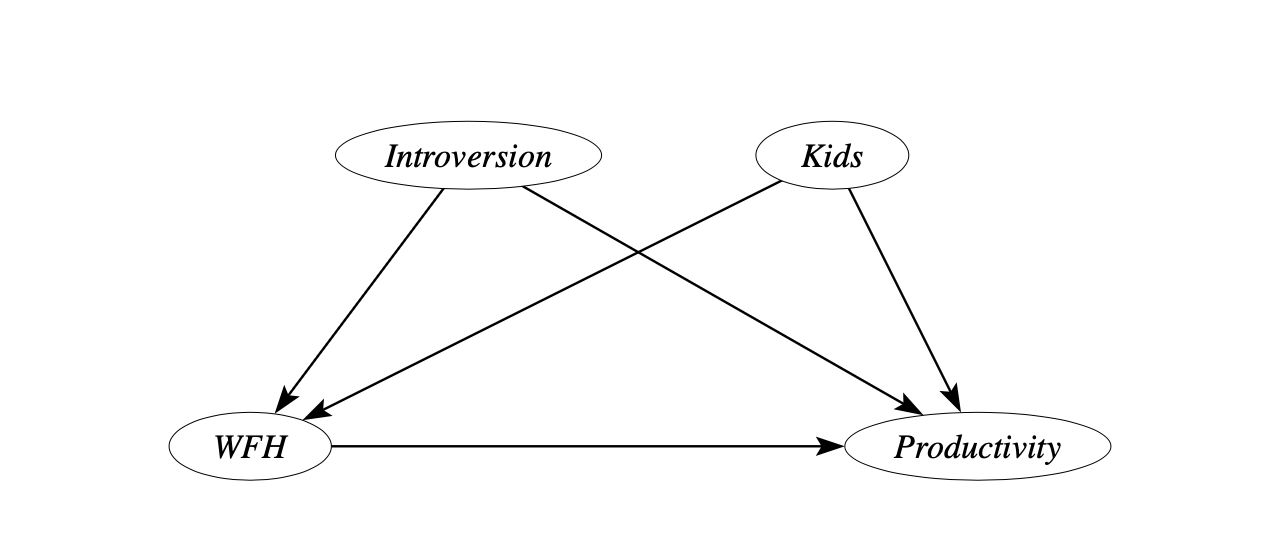
Let op: grafiek gemaakt door causalfusion.net
Een eenvoudig causaal model voor deze context kan er zo uitzien.
We nemen aan dat thuiswerken effect heeft op productiviteit, maar we kennen de richting of sterkte van het effect niet. Tegelijkertijd kunnen er andere redenen zijn waarom we hogere productiviteitsniveaus zien bij mensen die thuiswerken.
Medewerkers met kinderen of mensen die erg introvert zijn en niet goed tegen de drukte in onze grote kantoortuinen kunnen, besluiten misschien vaker thuis te werken omdat dat voor hen makkelijker is. Deze variabelen kunnen op zichzelf samenhangen met productiviteit, waardoor het mogelijke gemeenschappelijke oorzaken zijn die ook de bron van de correlatie kunnen zijn.
Om al deze aannames expliciet te maken, beelden we ze af in wat bekendstaat als een causale grafiek, een grafische weergave om de relaties tussen variabelen in een systeem te modelleren, met specifieke focus op causale relaties.
Je zult merken dat sommige van deze aannames in de echte wereld best stevig kunnen zijn. Het grote voordeel is dat causale grafieken aannames en voorkennis heel expliciet maken, maar we moeten altijd bereid zijn ze ter discussie te stellen en te verfijnen om onze analyses geloofwaardig te maken.
Microsoft's DoWhy-bibliotheek, ontwikkeld in samenwerking met Amazon Web Services als onderdeel van het PyWhy-ecosysteem, is hard op weg de industriestandaard te worden voor causale analyse in het Python-universum. We kunnen DoWhy gebruiken om een dataset te simuleren volgens ons bovenstaande causale model en zo enkele fundamentele stappen in de causale-inferentie-pijplijn te illustreren. Eerst moeten we DoWhy in onze omgeving installeren.
!pip install git+https://github.com/microsoft/dowhy.gitAls dat klaar is, kunnen we de benodigde bibliotheken laden.
import numpy as np
import pandas as pd
import dowhy
Laten we nu zelf een dataset maken. Het grote voordeel van werken met gesimuleerde data bij het bestuderen van causale AI is dat we volledige controle hebben over het datageneratieproces en kennis van de "ground truth", wat bij echte data niet zo is.
We zetten het ware causale effect gelijk aan één (beta=1), specificeren twee gemeenschappelijke oorzaken en maken tienduizend steekproeven volgens eenvoudige lineaire relaties tussen de variabelen in het model.
De variabele die we in onze behandeling onderzoeken, is binair ingesteld, wat betekent dat deze nul of één kan zijn.
Eerder hebben we een vast beginpunt ingesteld voor onze willekeurige getalgeneratie - using np.random.seed(1) - om onze dataset exact te kunnen reproduceren.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy kent de volgende labels toe:
Tabel 1
|
Label |
Variabele |
Type |
Gemiddelde |
|
v0 |
De behandelvariabele, de hoofdvariabele in onze analyse (thuiswerken) |
Binair |
0.608 |
|
y |
De uitkomst van interesse (productiviteit) |
Continu |
1.583 |
|
W0 |
Introversie |
Continu |
-0.148 |
|
W1 |
Aantal kinderen |
Categorieel |
1.5 |
|
Z0 |
Een instrumentele variabele die alleen v0 beïnvloedt en niet y (metrootsluiting) |
Binair |
0.281 |
Hier hebben we impliciet een causale grafiek gedefinieerd door het type behandeling en het aantal gemeenschappelijke oorzaken in te stellen. DoWhy slaat grafiekobjecten op in de DOT-taal, wat ons een handige manier geeft om onze eigen gerichte causale grafiek (digraph) te specificeren zodra we met echte data werken.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Tot slot combineren we al deze informatie in één enkel causaal model.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
)Voordat we onze causale analyse uitvoeren, zetten we er een benchmark naast: wat zou een naïeve aanpak op basis van een eenvoudig lineair voorspelalgoritme ons vertellen?
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
De hellingscoëfficiënt in een bivariate regressie is gelijk aan 1.298. We weten echter dat het ware causale effect in werkelijkheid gelijk is aan één, omdat we de data zo hebben gegenereerd.
Dit impliceert dat de twee gemeenschappelijke oorzaken, introversie en kinderen hebben, die zowel de productiviteit als de kans op thuiswerken beïnvloeden, in dit geval leiden tot een overschatting van bijna 30%.
Gelukkig kunnen we, zolang we data over deze variabelen hebben, deze bias eenvoudig aanpakken door de gemeenschappelijke oorzaken mee te nemen in een multivariate analyse.
In de literatuur over causale AI staat dit bekend als het backdoor-criterium. We willen alle variabelen in de causale grafiek controleren die naar de behandelvariabele wijzen. Ze "komen via de achterdeur binnen" en kunnen zo een schijncorrelatie creëren tussen behandeling en uitkomst die niet causaal is. In ons voorbeeld geldt dit voor introversie en het aantal kinderen.
WFH <— Introversie —> Productiviteit
WFH <— Kinderen —> Productiviteit
DoWhy biedt een reeks algoritmen die kunnen bepalen of een gewenst causaal effect identificeerbaar is gegeven een bepaald causaal model.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Niet verrassend is in ons eenvoudige causale model voor het effect van thuiswerken causale identificatie mogelijk.
Vervolgens kunnen we ons richten op schatten: het kwantificeren van het doeleffect met de beschikbare data.
DoWhy biedt een aantal algoritmen om uit te kiezen, waaronder regressie-, matching-, stratificatie- en weegschatters. Omdat de onderliggende data die we simuleerden gebaseerd was op lineaire relaties, zou een eenvoudige regressie volstaan. Als je een opfrisser nodig hebt: de DataCamp-cursus Intro to Regression with statsmodels in Python kan helpen.
Om onze analyse algemener te maken, gebruiken we echter inverse probability weighting, dat ook niet-lineaire data aankan.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy geeft een schatting van het causale effect gelijk aan 1.001. Natuurlijk zijn de exacte getallen in deze gesimuleerde context niet heel betekenisvol. Belangrijk is dat we zeer dicht bij de ground truth van één zitten. Vergeleken met de regressie die we eerder uitvoerden, is de bias met maar liefst 99,6% verminderd.
Dat is allemaal indrukwekkend, maar daar moeten we niet stoppen.
Het principe "no causes in, no causes out" vertelt ons dat elke causale analyse slechts zo goed kan zijn als de aannames die we meenemen.
Hoe weten we bijvoorbeeld zeker dat alleen introversie en kinderen WFH beïnvloeden, zoals ons eenvoudige causale model stelt?
Om meer vertrouwen te krijgen in onze aannames biedt DoWhy een hele suite aan weerleggingstesten waarmee we onze analyse kunnen stresstesten, waaronder, maar niet beperkt tot, testen met deelsteekproeven of placebobehandelingen.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
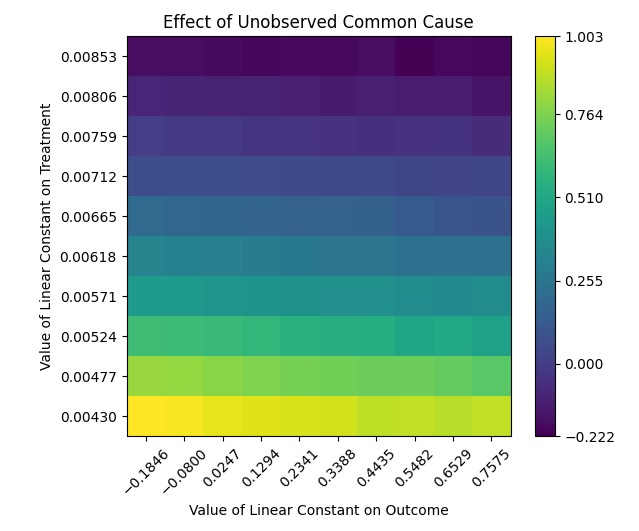
Laten we eens kijken wat er gebeurt als we naast introversie en kinderen nog een gemeenschappelijke oorzaak toevoegen.
Dit keer hebben we geen data over deze variabele, dus die blijft voor ons onobserveerbaar. Hoe betrouwbaar zijn onze schattingen dan? Helaas is het antwoord niet erg geruststellend.
De grafiek in Figuur 2 illustreert de aanzienlijke invloed die onobserveerbare gemeenschappelijke oorzaken kunnen hebben op het geschatte causale effect, variërend van -0.222 tot 1.003. Dit bereik is zo groot dat het het geschatte effect mogelijk zou kunnen verdubbelen.
Dat is overigens niet heel verrassend. Alternatieve causale mechanismen met onobserveerbare variabelen die we niet kunnen meenemen in de analyse, vormen altijd een probleem in causale studies.
Gelukkig is er in deze context een alternatieve manier om tot identificatie te komen, en DoWhy is slim genoeg om die voor ons te vinden.
Hoewel introverte medewerkers en medewerkers met kinderen misschien vaker thuiswerken, kunnen er andere determinanten van WFH zijn die niet samenhangen met productiviteit.
Stel dat er een grote verstoring in het openbaar vervoer was en een van de metrolijnen in onze stad drie maanden dicht moest. Daardoor waren medewerkers die in wijken vlak bij de lijn woonden, eerder geneigd om thuis te werken, ook als ze anders liever naar kantoor waren gekomen.
We kunnen dit aangevulde causale model als volgt illustreren.
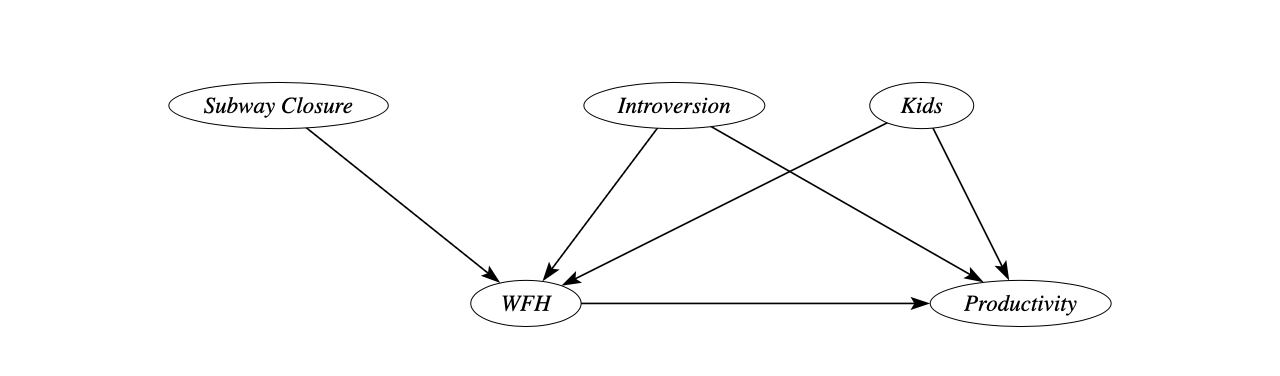
In dit geval fungeert de metrootsluiting als een zogeheten instrumentele variabele.
Intuïtief werkt de sluiting als een schok voor iemands woon-werkpatroon en creëert zo een soort natuurlijk experiment.
Gedurende drie maanden zullen mensen die dicht bij de verstoorde lijn wonen vaker thuiswerken, maar dat staat verder los van hun productiviteit. Je hebt misschien gemerkt dat we zo'n instrumentele variabele, Z0, al hebben opgenomen bij het maken van de gesimuleerde dataset hierboven door de optie num_instruments=1 in te stellen. De functie identify_effect() van DoWhy kan vervolgens automatisch geschikte instrumentele variabelen voor ons vinden in de causale grafiek.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Na de schatting vinden we dat het causale effect 0.920 is. Dit is iets minder nauwkeurig dan de backdoor-strategie, maar nog altijd veel nauwkeuriger dan de naïeve voorspelling.
Een voordeel van schatten met instrumentele variabelen is dat het niet berust op aannames over het aantal onobserveerbare gemeenschappelijke oorzaken van WFH en productiviteit.
Dus hoewel onze schattingen minder precies kunnen zijn, zijn ze robuuster dankzij de zwakkere aannames. Dit is een gebruikelijke trade-off in causale analyse.
DoWhy is een uitstekende plek om te beginnen met causale AI. Het is een krachtige end-to-end-bibliotheek die een veelzijdige pijplijn voor causale inferentie biedt en gebruikers door de essentiële stappen leidt.
Zodra je de basisworkflow in de vingers hebt, kun je doorgaan naar meer geavanceerde onderwerpen zoals causal discovery en je analyse versterken met extra bibliotheken zoals DoubleML, of daggity, ggdag en pcalg in R. Als je je prettig voelt bij de basis, wil je misschien meer geavanceerde onderwerpen in causale inferentie verkennen. De DataCamp-cursus Advanced Causal Inference with R is een goede volgende stap.
Causale inferentie biedt een frisse kijk op data-analyse. De meeste benaderingen steunen op inzicht in de causale grafiek of andere causale aannames. De kunst is de technieken en aannames te kiezen die geschikt zijn voor jouw specifieke situatie. Dat vergt externe kennis en domeinexpertise.
Het is daarom een goed idee om je marketingexperts of HR-specialisten te raadplegen om hun mening over een bepaald vraagstuk te horen en te kijken of ze je kunnen helpen een passend model op te stellen.
Causale kennis is cruciaal in veel bedrijfscontexten. We moeten bijvoorbeeld begrijpen of onze nieuwe productlancering succesvol is of hoe effectief onze advertentiecampagne is.
Causale antwoorden uit data halen is misschien lastiger dan een eenvoudig voorspelalgoritme trainen, maar de moeite meer dan waard. En bibliotheken zoals DoWhy geven je een uitstekende set tools om de oplossingen te vinden die het best bij je behoeften passen.
Als je deze tutorial verhelderend vond en graag causale AI-technieken in je eigen projecten wilt toepassen, is dit het moment om je kennis te verdiepen. In de uitgebreide cursus Machine Learning for Business leer je niet alleen over voorspellende modellen, maar ook over causale modellen die je helpen betere zakelijke beslissingen te nemen.
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min