Lorsqu’il s’agit de prendre des décisions à partir des données, de nombreux experts du secteur gardent en tête un doute persistant : les algorithmes prédictifs couramment utilisés ne sont pas toujours fiables. Par exemple, la quantité de chocolat consommé par habitant prédit fortement le nombre de lauréats du prix Nobel dans un pays, et il existe une corrélation entre les ventes de glace et les attaques de requins. Cela ne signifie pas pour autant qu’attirer un grand nombre de requins sur la plage soit une bonne idée pour doper notre commerce de glaces.
L’enjeu ici, c’est bien sûr l’adage bien connu : « corrélation n’implique pas causalité ». Ce n’est pas parce que deux variables sont corrélées que l’on peut agir sur l’une pour influencer l’autre. Les deux phénomènes peuvent être entraînés par une troisième variable, comme le « beau temps » dans l’exemple des requins et des ventes de glaces, qui joue le rôle de cause commune. Dans le même temps, comprendre les causes profondes des phénomènes et utiliser l’analytique pour favoriser le changement est une mission clé pour toute entreprise. C’est pourquoi de nombreux leaders du secteur, tels que Microsoft, Amazon, Uber, Spotify, McKinsey, et bien d’autres, ont commencé à investir massivement dans leurs capacités en IA causale.
Ce tutoriel couvre certains des concepts et idées fondamentaux de l’IA causale en utilisant la bibliothèque DoWhy en Python. L’inférence causale diffère conceptuellement de l’apprentissage automatique classique, donc la plupart des personnes démarrent avec peu de bagage. En revanche, des bases en régression et en modélisation statistique vous aideront à suivre. Si vous découvrez l’analyse de régression ou avez besoin d’une remise à niveau, pensez au cours de DataCamp Introduction to Linear Modeling in Python.
Vous pouvez aussi explorer les différences entre modèles prédictifs et causaux dans le cours DataCamp Machine Learning for Business.
Les briques de base de l’IA causale
En matière d’inférence causale, il faut adopter un état d’esprit différent de celui de l’apprentissage automatique et de l’analytique prédictive.
La philosophe Nancy Cartwright a forgé l’expression : « No causes in, no causes out. » Autrement dit, nous devons formuler des hypothèses sur la structure causale du phénomène étudié pour en tirer des réponses causales. Une approche purement pilotée par les données ne suffit pas.
Cela peut sembler circulaire au premier abord, mais ça ne l’est pas.
Si nous voulons savoir si la corrélation entre consommation de chocolat et lauréats du Nobel est causale, nous devons écarter des explications alternatives. Ces explications relèvent d’un savoir causal que l’on ne trouve pas toujours dans les données elles-mêmes et qu’il faut apporter de l’extérieur.
Supposons que nous envisagions une nouvelle politique de télétravail (WFH) et que nous voulions savoir si elle aura un impact sur la productivité. Une première analyse montre que les membres de l’équipe qui télétravaillent bouclent plus de tâches au quotidien.
Cependant, peut-on être certain que cette corrélation persistera une fois la politique appliquée à tout le monde ? En d’autres termes, peut-on être sûr que la relation entre télétravail et productivité est causale ?
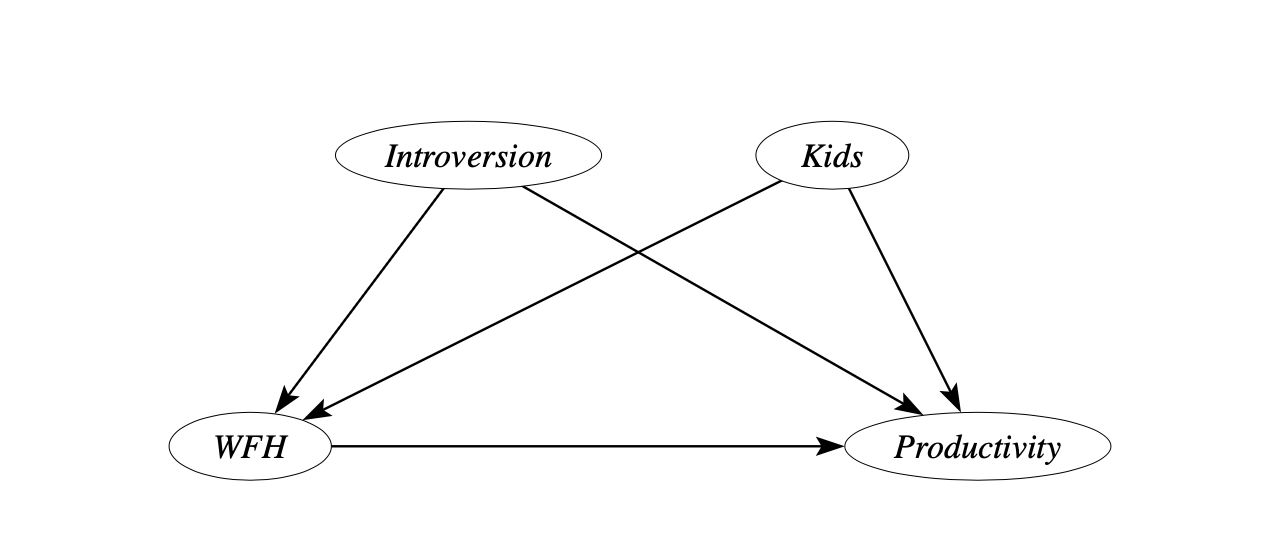
Remarque : Graphique créé par causalfusion.net
Un modèle causal simple pour ce contexte pourrait ressembler à ceci.
Nous supposons que le télétravail a un effet sur la productivité, sans en connaître le sens ni l’ampleur. Parallèlement, d’autres facteurs peuvent expliquer pourquoi nous observons une productivité plus élevée chez les personnes en télétravail.
Les employés avec des enfants, ou très introvertis et peu à l’aise avec le bruit de nos grands open spaces, peuvent décider de travailler plus souvent de chez eux, car c’est plus pratique. Ces variables peuvent elles-mêmes être liées à la productivité, ce qui en fait des causes communes possibles à l’origine de la corrélation.
Pour expliciter toutes ces hypothèses, nous les représentons dans ce que l’on appelle un graphe causal, une représentation graphique utilisée pour modéliser les relations entre variables d’un système, en se concentrant sur les liens de causalité.
Vous constaterez que certaines hypothèses peuvent être fortes dans des situations réelles. Le grand avantage des graphes causaux est de rendre explicites hypothèses et connaissances préalables, mais il faut être prêt à les remettre en question et à les affiner pour crédibiliser nos analyses.
Premiers pas avec DoWhy en Python
La bibliothèque DoWhy de Microsoft, développée avec Amazon Web Services au sein de l’écosystème PyWhy, s’impose rapidement comme la référence de l’analyse causale dans l’univers Python. Nous pouvons utiliser DoWhy pour simuler un jeu de données selon notre modèle causal ci-dessus et illustrer les étapes clés d’un pipeline d’inférence causale. Commençons par installer DoWhy dans notre environnement.
!pip install git+https://github.com/microsoft/dowhy.gitUne fois l’installation terminée, chargeons les bibliothèques nécessaires.
import numpy as np
import pandas as pd
import dowhy
Créons maintenant un jeu de données. L’avantage majeur des données simulées pour étudier l’IA causale est de contrôler entièrement le processus de génération et de connaître la « vérité terrain », ce qui n’est pas le cas avec des données réelles.
Nous fixons l’effet causal vrai à un (beta=1), spécifions deux causes communes et créons dix mille observations selon des relations linéaires simples entre les variables du modèle.
La variable que nous traitons est binaire : elle prend la valeur zéro ou un.
Au préalable, nous avons défini un point d’origine fixe pour la génération aléatoire — using np.random.seed(1) — afin de pouvoir reproduire exactement notre jeu de données.
from dowhy import CausalModel
import dowhy.datasets

# Set seed to enable exact replication
np.random.seed(1)

# Simulate sample data
data = dowhy.datasets.linear_dataset(
    beta=1,
    num_common_causes=2,
    num_discrete_common_causes=1,
    num_instruments=1,
    num_samples=10000,
    treatment_is_binary=True)

df = data['df']
DoWhy attribue les libellés suivants :
Tableau 1
|
Libellé |
Variable |
Type |
Moyenne |
|
v0 |
La variable de traitement, principale variable d’intérêt (télétravail) |
Binaire |
0,608 |
|
y |
Le résultat d’intérêt (productivité) |
Continue |
1,583 |
|
W0 |
Introversion |
Continue |
-0,148 |
|
W1 |
Nombre d’enfants |
Catégorielle |
1,5 |
|
Z0 |
Une variable instrumentale n’affectant que v0 et non y (fermeture du métro) |
Binaire |
0,281 |
Nous avons ici défini implicitement un graphe causal en fixant le type de traitement et le nombre de causes communes. DoWhy stocke les graphes au format DOT, ce qui nous offre un moyen pratique de spécifier notre propre graphe causal orienté (digraph) lorsque nous travaillerons avec des données réelles.
digraph {v0->y;W0-> v0; W1-> v0;Z0-> v0;W0-> y; W1-> y;}Enfin, nous regroupons toutes ces informations dans un modèle causal unique.
# Create a causal model from the data and given graph.
model=CausalModel(
        data = df,
        treatment=data['treatment_name'],
        outcome=data['outcome_name'],
        graph=data['gml_graph']
        )
Libérer la puissance de l’IA causale
Avant de mener notre analyse causale, comparons-la à ce que dirait une approche naïve basée sur une simple régression linéaire prédictive.
# Run a linear regression of column y on v0 in df
import statsmodels.api as sm

X = df['v0'].astype(float)
y = df['y'].astype(float)

X = sm.add_constant(X)

ols = sm.OLS(y, X).fit()

# Display a more parsimonious results summary
print(ols.summary().tables[1])
Le coefficient de pente dans une régression bivariée est égal à 1,298. Pourtant, nous savons que l’effet causal vrai vaut un, puisque nous avons généré les données ainsi.
Cela signifie que les deux causes communes — l’introversion et le fait d’avoir des enfants — qui influencent à la fois la productivité et la probabilité de télétravailler, conduisent ici à une surestimation de près de 30 %.
Heureusement, tant que nous disposons de données sur ces variables, nous pouvons facilement corriger ce biais en incluant les causes communes dans une analyse multivariée.
Dans la littérature sur l’IA causale, on parle du critère du backdoor. Il s’agit de contrôler toutes les variables du graphe causal qui pointent vers la variable de traitement. Elles « entrent par la porte de derrière » et peuvent créer une corrélation fallacieuse entre traitement et résultat qui n’est pas causale. Dans notre exemple, cela concerne l’introversion et le nombre d’enfants.
WFH <— Introversion —> Productivité
WFH <— Enfants —> Productivité
DoWhy propose une série d’algorithmes permettant de déterminer si l’effet causal recherché est identifiable à partir d’un modèle causal donné.
# Check whether causal effect is identified and return target estimands
identified_estimand = model.identify_effect()
Sans surprise, dans notre modèle causal simple de l’effet du télétravail, l’identification causale est possible.
Nous pouvons ensuite passer à l’estimation, qui consiste à quantifier l’effet cible à partir des données disponibles.
DoWhy propose plusieurs algorithmes, dont la régression, l’appariement, la stratification et le pondérage. Comme nos données simulées reposent sur des relations linéaires, une simple régression suffirait. Si vous souhaitez réviser, le cours DataCamp Intro to Regression with statsmodels in Python peut vous aider.
Cependant, pour généraliser notre analyse, nous utiliserons le pondérage par probabilité inverse, qui gère aussi des données non linéaires.
# Estimate the causal effect using inverse probability weighting
estimate = model.estimate_effect(identified_estimand,
                                 method_name="backdoor.propensity_score_weighting")
DoWhy renvoie un estimateur d’effet causal égal à 1,001. Bien sûr, la valeur précise importe peu dans ce contexte simulé. L’important est d’être très proche de la vérité terrain égale à un. Par rapport à la régression précédente, le biais est réduit de 99,6 %.
Mettre vos résultats à l’épreuve
C’est très convaincant, mais ne nous arrêtons pas là.
Le principe « no causes in, no causes out » nous rappelle que toute analyse causale n’est bonne que dans la mesure des hypothèses que nous formulons.
Par exemple, comment être sûr que seuls l’introversion et les enfants influencent le télétravail, comme le postule notre modèle causal simple ?
Pour renforcer notre confiance dans ces hypothèses, DoWhy met à disposition toute une suite de tests de réfutation pour éprouver l’analyse, notamment via des sous-échantillons ou des traitements placebo.
# Check sensitivity of obtained estimate to unobserved confounders
refute_results = model.refute_estimate(identified_estimand, estimate,
                                       method_name="add_unobserved_common_cause")
Voyons ce qui se passe si l’on ajoute une autre cause commune en plus de l’introversion et des enfants.
Cette fois, nous n’avons pas de données sur cette variable : elle restera non observée. Quelle est la fiabilité de nos estimations ? Malheureusement, la réponse n’est pas très rassurante.
Le graphique de la figure 2 illustre l’influence substantielle que des causes communes non observées peuvent avoir sur l’effet causal estimé, avec une fourchette allant de -0,222 à 1,003. Une plage si large qu’elle pourrait pratiquement doubler l’effet estimé.
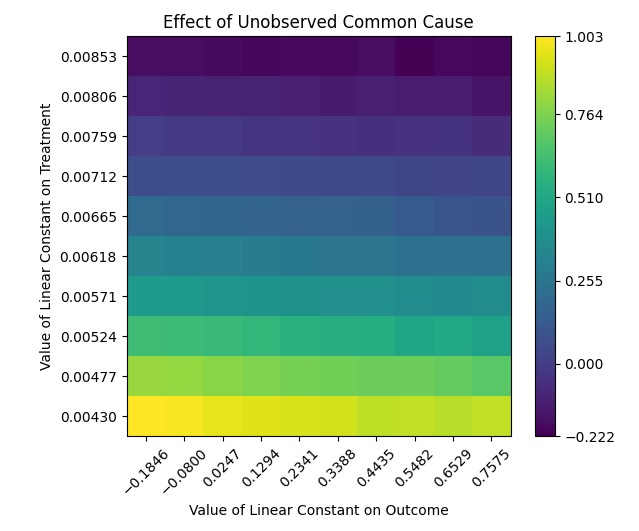
Ce n’est toutefois pas très surprenant. Des mécanismes causaux alternatifs impliquant des variables non observées que nous ne pouvons pas intégrer à l’analyse constituent toujours un écueil en étude causale.
Heureusement, il existe un autre moyen d’identifier l’effet dans ce contexte, et DoWhy est suffisamment malin pour le déceler.
Trouver des stratégies causales alternatives
Même si les employés introvertis et ceux ayant des enfants télétravaillent plus souvent, d’autres déterminants du télétravail peuvent n’avoir aucun lien avec la productivité.
Imaginons une forte perturbation des transports en commun et la fermeture, pendant trois mois, d’une ligne de métro. Les employés résidant à proximité de cette ligne seront alors plus enclins à télétravailler, même s’ils auraient préféré venir au bureau autrement.
Nous pouvons illustrer ce modèle causal enrichi comme suit.
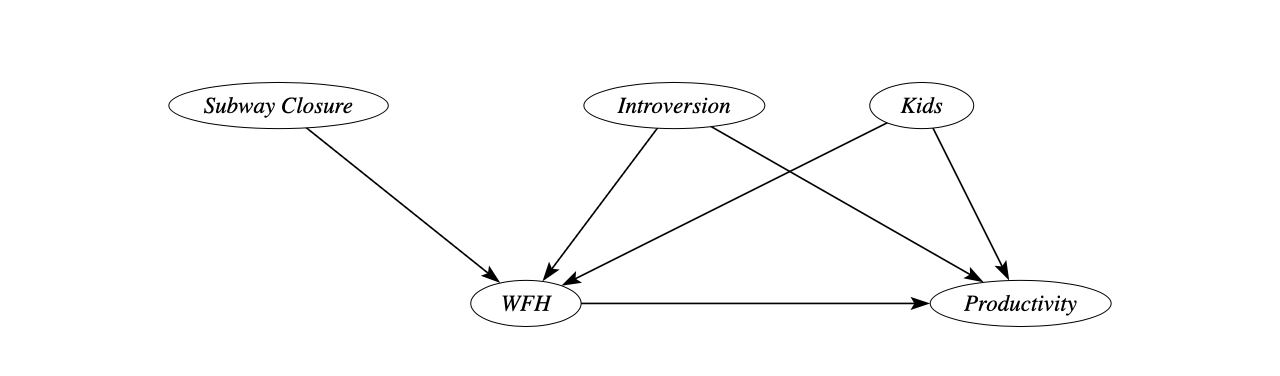
Dans ce cas, la fermeture du métro joue le rôle de variable instrumentale.
Intuitivement, cette fermeture constitue un choc sur les trajets domicile–travail, créant une forme d’expérience naturelle.
Pendant trois mois, les personnes vivant près de la ligne perturbée télétravailleront davantage, sans autre lien avec leur productivité. Vous aurez remarqué que nous avons déjà inclus une telle variable instrumentale, Z0, lors de la création du jeu de données simulé ci-dessus via l’option num_instruments=1. La fonction identify_effect() de DoWhy peut alors détecter automatiquement des variables instrumentales adaptées dans le graphe causal.
iv_estimate = model.estimate_effect(identified_estimand,
                                    method_name="iv.instrumental_variable")
Après estimation, nous trouvons un effet causal de 0,920. C’est légèrement moins précis que la stratégie du backdoor, mais bien plus précis que l’approche naïve.
L’estimation par variable instrumentale a l’avantage de ne pas reposer sur des hypothèses concernant le nombre de causes communes non observées du télétravail et de la productivité.
Ainsi, même si les estimations peuvent être moins précises, elles sont plus robustes grâce à des hypothèses plus faibles. C’est un arbitrage classique en analyse causale.
Et ensuite ?
DoWhy est un excellent point de départ pour l’IA causale. C’est une bibliothèque puissante de bout en bout qui propose un pipeline d’inférence causale polyvalent et guide les utilisateurs à travers les étapes essentielles.
Une fois le flux de travail fondamental maîtrisé, vous pouvez passer à des sujets plus avancés comme la découverte causale et enrichir votre analyse avec d’autres bibliothèques telles que DoubleML, ou daggity, ggdag et pcalg sous R. Lorsque vous serez à l’aise avec les bases, vous pourrez explorer des thèmes plus avancés en inférence causale. Le cours de DataCamp Advanced Causal Inference with R est une excellente étape suivante.
L’inférence causale offre une nouvelle perspective sur l’analyse des données. La plupart des approches reposent sur la compréhension du graphe causal ou sur d’autres hypothèses causales. L’enjeu est de choisir les techniques et hypothèses adaptées à votre contexte. Cela suppose des connaissances externes et une expertise métier.
Il est donc judicieux d’échanger avec vos experts marketing ou vos spécialistes RH pour recueillir leurs avis sur une problématique donnée et voir s’ils peuvent vous aider à construire un modèle pertinent.
La connaissance causale est déterminante dans de nombreux contextes business. Il faut par exemple comprendre si notre nouveau lancement produit est un succès ou mesurer l’efficacité de notre stratégie publicitaire.
Obtenir des réponses causales à partir des données est plus exigeant que d’entraîner un simple algorithme prédictif, mais l’effort en vaut la peine. Et des bibliothèques comme DoWhy vous offrent un excellent ensemble d’outils pour trouver les solutions les mieux adaptées à vos besoins.
Si ce tutoriel vous a éclairé et que vous souhaitez appliquer les techniques d’IA causale à vos propres projets, c’est le moment idéal pour approfondir vos connaissances. Dans le cours complet Machine Learning for Business, vous apprendrez non seulement les modèles prédictifs, mais aussi les modèles causaux qui vous aideront à prendre de meilleures décisions business.