Kurs
Einführung in Data Science mit Python
4 Std.
502.2K
Im Einzelhandel erzeugen Filialketten täglich enorme Datenmengen. Diese Daten fallen in allen Stores an und wachsen von Tag zu Tag. Diese umfangreiche Datenbasis aus Transaktionen muss analysiert werden, um profitable Strategien zu entwickeln.
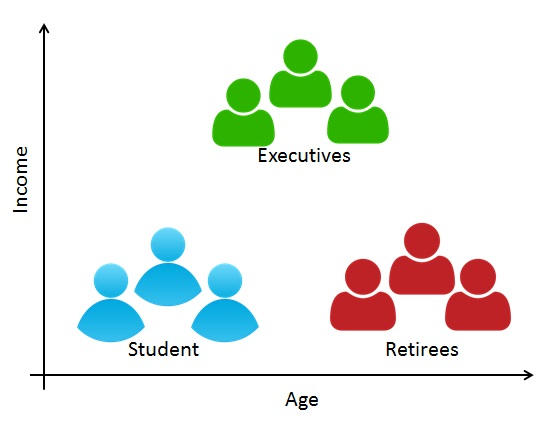
Alle Kundinnen und Kunden haben unterschiedliche Bedürfnisse. Mit wachsender Kundenbasis und mehr Transaktionen wird es immer schwieriger, die Anforderungen jeder einzelnen Person zu verstehen. Die Identifizierung potenzieller Käufergruppen verbessert Kampagnen und steigert letztlich den Umsatz. Segmentierung hilft, Kundinnen und Kunden in sinnvolle Gruppen einzuteilen.
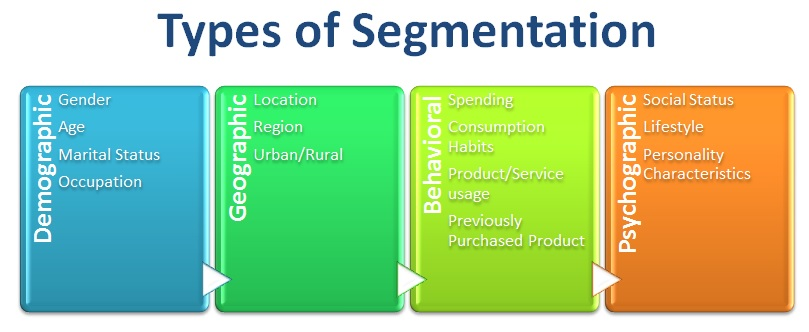
Kundensegmentierung ist die Einteilung von Kundinnen und Kunden in Gruppen oder Cluster anhand gemeinsamer Merkmale. Im B2C-Bereich können Marktforschende nach demografischen Merkmalen wie Beruf, Geschlecht, Alter, Standort und Familienstand segmentieren. Dazu kommen psychografische Merkmale wie soziale Schicht, Lebensstil und Persönlichkeit sowie Verhaltensmerkmale wie Ausgaben, Konsumgewohnheiten, Produkt-/Service-Nutzung und bisherige Käufe. Im B2B-Umfeld bieten sich Unternehmensmerkmale an, zum Beispiel Unternehmensgröße, Branche und Standort.
Die RFM-Analyse (Recency, Frequency, Monetary) ist ein verhaltensbasiertes Verfahren zur Gruppierung von Kundinnen und Kunden. Sie segmentiert anhand vergangener Käufe: Wie kürzlich, wie häufig und wie viel wurde eingekauft? RFM filtert Kundinnen und Kunden für bessere Betreuung in verschiedene Gruppen. So lassen sich besonders wertvolle Zielgruppen für profitableres Geschäft identifizieren. Es gibt zum Beispiel Großkundinnen und -kunden, aber was, wenn sie nur einmal oder schon lange her gekauft haben? Kaufen sie regelmäßig? Außerdem unterstützt RFM personalisierte und wirksame Promotions.
Jede der drei Variablen (Recency, Frequency, Monetary) wird in vier gleich große Gruppen unterteilt. So entstehen 64 (4x4x4) verschiedene Kundensegmente.
Schritte der RFM-Analyse (Recency, Frequency, Monetary):
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Lass uns zuerst das benötigte HR-Dataset mit der pandas-Funktion read_csv laden. Du kannst die Daten über diesen Link herunterladen.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
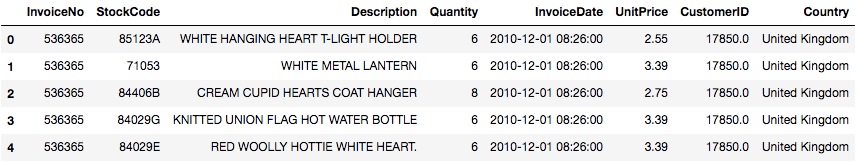
data.tail()
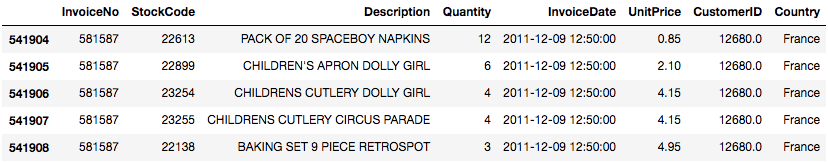
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
Manchmal sind Datensätze unaufgeräumt. Duplikate können die Analyse verzerren. In Python bietet pandas die Funktion drop_duplicates(), um doppelte Einträge zu entfernen.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
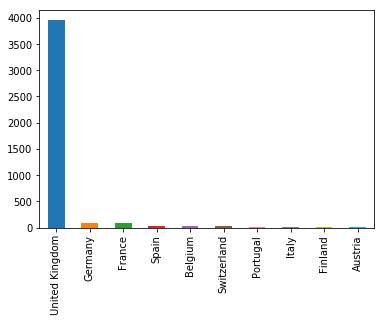
Im vorliegenden Datensatz stammen die meisten Kundinnen und Kunden aus dem "United Kingdom". Du kannst also die Daten auf Kundinnen und Kunden aus dem Vereinigten Königreich filtern.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
Die describe()-Funktion in pandas liefert schnell diverse Kennzahlen. Sie gibt Anzahl, Mittelwert, Standardabweichung, Minimum und Maximum sowie die Quantile zurück.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Hier fällt auf, dass einige Bestellungen negative Mengen aufweisen – das ist nicht plausibel. Filtere daher Quantity größer als null.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Für die RFM-Analyse reichen fünf Spalten: CustomerID, InvoiceDate, InvoiceNo, Quantity und UnitPrice. CustomerID identifiziert eindeutig, InvoiceDate ermöglicht die Recency-Berechnung, InvoiceNo zählt die Bestellungen (Frequency). Quantity pro Transaktion und UnitPrice je Einheit erlauben die Ermittlung des Gesamtumsatzes.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Du führst folgende Schritte aus:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
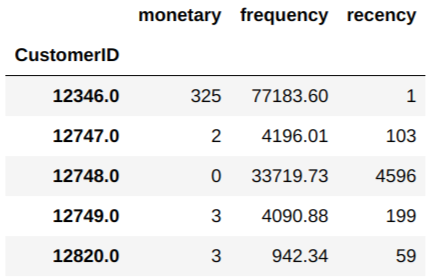
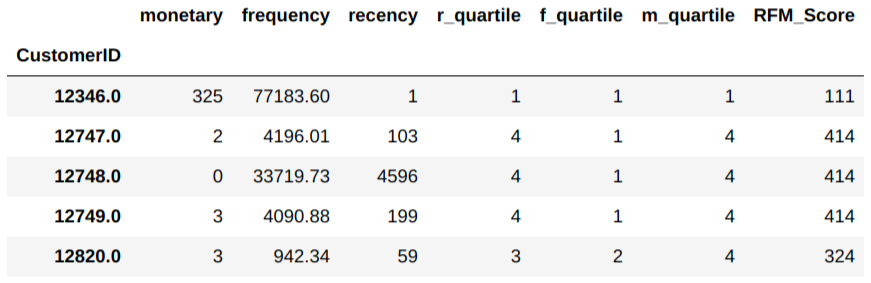
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
Kundinnen und Kunden mit der niedrigsten Recency sowie der höchsten Frequency und dem höchsten Monetary-Wert gelten als Top-Kundschaft.
qcut() ist eine quantilbasierte Diskretisierungsfunktion. Sie teilt Daten anhand von Stichprobenquantilen in Bins ein. Beispiel: 1000 Werte in 4 Quantilen ergeben eine kategoriale Zuordnung der Quantil-Mitgliedschaft je Kundin bzw. Kunde.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
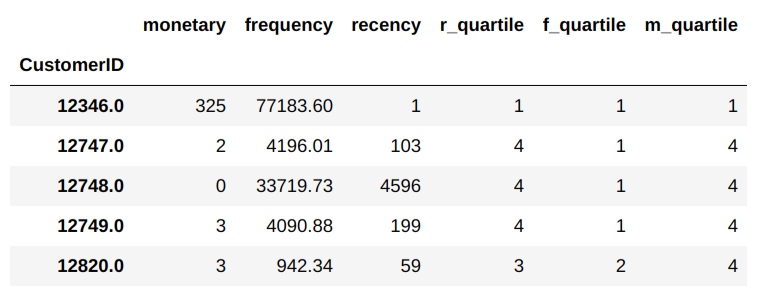
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
Kombiniere alle drei Quartile (r_quartile, f_quartile, m_quartile) in einer Spalte. Dieser Rang hilft dir, Kundinnen und Kunden treffsicher zu segmentieren.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Glückwunsch, du hast das Ende dieses Tutorials erreicht!
Du hast die wichtigsten Aspekte der Kundensegmentierung kennengelernt: Was Segmentierung ist, warum sie gebraucht wird, welche Arten es gibt, die RFM-Analyse und deren Umsetzung von Grund auf in Python. Außerdem hast du grundlegende pandas-Konzepte wie den Umgang mit Duplikaten, groupby und qcut() für quantilbasierte Bins wiederholt.
Idealerweise kannst du die Methoden nun auf eigene Datensätze anwenden. Danke fürs Lesen!
Wenn du mehr über Python lernen willst, starte mit DataCamps kostenlosem Kurs Intro to Python for Data Science.
Erfahre mehr über Python
Kurs
Kurs
Kurs