
Last chance! 50% off DataCamp Premium
Sale ends in
In de retailsector genereren de verschillende hypermarktketens een uitzonderlijk grote hoeveelheid data. Deze data wordt dagelijks in de winkels verzameld. Deze uitgebreide database met klanttransacties moet worden geanalyseerd om winstgevende strategieën te ontwikkelen.
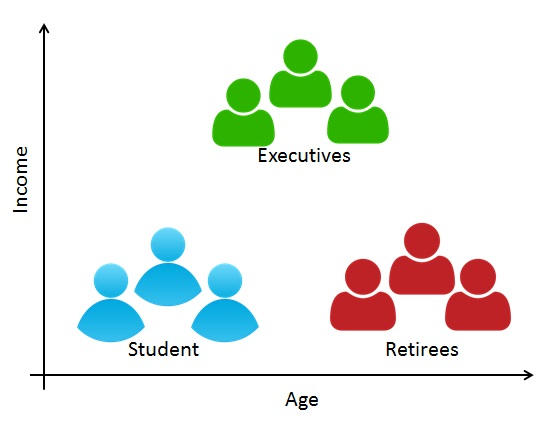
Alle klanten hebben verschillende soorten behoeften. Met de groei van het klantenbestand en het aantal transacties is het niet eenvoudig om de wensen van elke klant te begrijpen. Het identificeren van potentiële klanten kan de marketingcampagne verbeteren, wat uiteindelijk de verkoop verhoogt. Segmentatie kan helpen door die klanten in verschillende segmenten te groeperen.
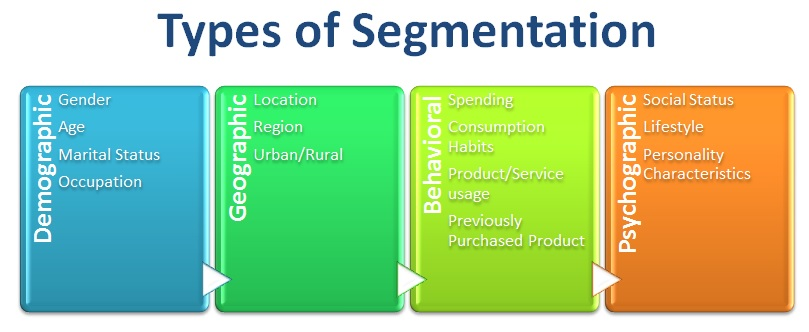
Klantsegmentatie is een methode om klanten in groepen of clusters te verdelen op basis van gemeenschappelijke kenmerken. Marktonderzoekers kunnen klanten in het B2C-model segmenteren op basis van diverse demografische kenmerken zoals beroep, geslacht, leeftijd, locatie en burgerlijke staat. Psychografische kenmerken zoals sociale klasse, levensstijl en persoonlijkheidskenmerken, en gedragskenmerken zoals bestedings- en consumptiegewoonten, gebruik van producten/diensten en eerder gekochte producten. In het B2B-model gebeurt segmentatie op basis van kenmerken van bedrijven, zoals de omvang van het bedrijf, het type industrie en de locatie.
RFM-analyse (Recency, Frequency, Monetary) is een gedragsgebaseerde aanpak om klanten in segmenten te groeperen. Het groepeert klanten op basis van hun eerdere aankooptransacties. Hoe recent, hoe vaak en hoeveel heeft een klant gekocht. RFM filtert klanten in verschillende groepen met het oog op betere service. Het helpt managers potentiële klanten te identificeren om winstgevender zaken te doen. Er is een segment klanten dat veel uitgeeft, maar wat als ze slechts één keer hebben gekocht of hoe recent hebben ze gekocht? Kopen ze vaak ons product? Ook helpt het managers om een effectieve promotiecampagne te voeren voor gepersonaliseerde service.
Hier bestaat elk van de drie variabelen (Recency, Frequency en Monetary) uit vier gelijke groepen, wat 64 (4x4x4) verschillende klantsegmenten oplevert.
Stappen van RFM (Recency, Frequency, Monetary):
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Laten we eerst de vereiste HR-dataset laden met de pandas-functie read CSV. Je kunt de data via deze link downloaden.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
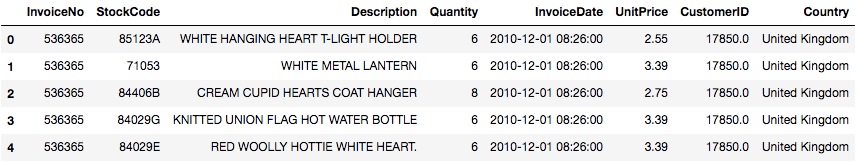
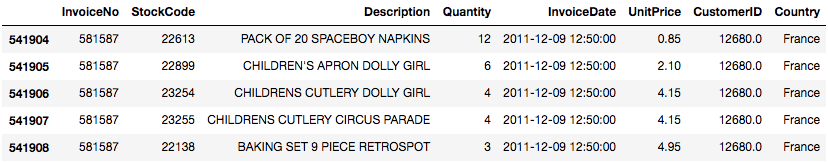
data.tail()
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
Soms krijg je een rommelige dataset. Je kunt te maken krijgen met dubbelen, die je analyse vertekenen. In python biedt pandas de functie drop_duplicates(), die herhaalde of dubbele records verwijdert.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
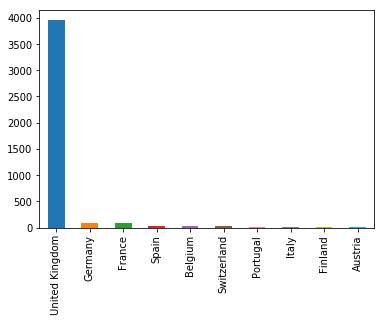
In de gegeven dataset zie je dat de meeste klanten uit het "United Kingdom" komen. Je kunt de data dus filteren voor klanten uit het Verenigd Koninkrijk.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
De functie describe() in pandas is handig om verschillende samenvattende statistieken op te vragen. Deze functie retourneert het aantal waarden, het gemiddelde, de standaarddeviatie, de minimale en maximale waarden en de kwartielen van de data.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Hier zie je dat sommige klanten een negatieve hoeveelheid hebben besteld, wat niet mogelijk is. Je moet dus filteren op Quantity groter dan nul.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Hier kun je de noodzakelijke kolommen voor RFM-analyse filteren. Je hebt slechts vijf kolommen nodig: CustomerID, InvoiceDate, InvoiceNo, Quantity en UnitPrice. CustomerID identificeert je klanten uniek, InvoiceDate helpt je de recentheid van de aankoop te berekenen, InvoiceNo helpt je het aantal transacties te tellen (frequentie). Quantity die bij elke transactie is gekocht en UnitPrice van elke eenheid die door de klant is gekocht, helpen je om het totale aankoopbedrag te berekenen.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Hier ga je de volgende handelingen uitvoeren:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
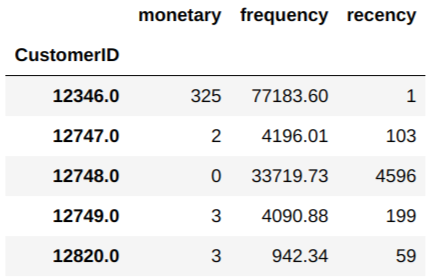
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
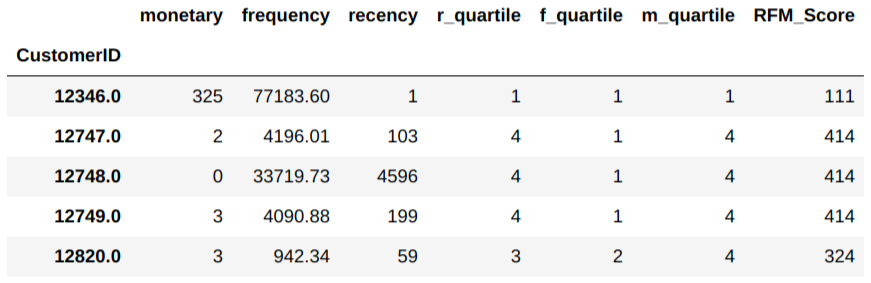
Klanten met de laagste recency en de hoogste frequentie en monetaire bedragen worden beschouwd als topklanten.
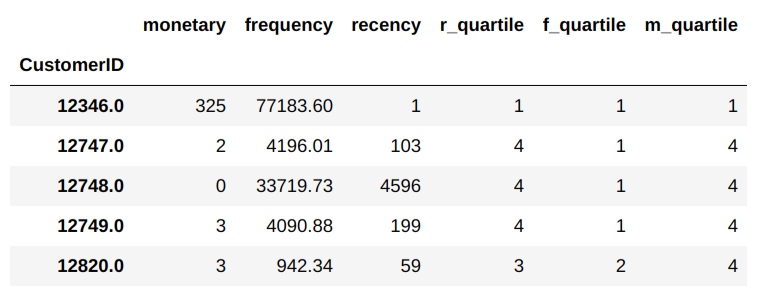
qcut() is een op kwartielen gebaseerde discretisatiefunctie. qcut plaatst de data in bakken op basis van steekproefkwartielen. Bijvoorbeeld: 1000 waarden voor 4 kwartielen leveren een categorisch object op dat voor elke klant het bijbehorende kwartiel aangeeft.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
Combineer alle drie de kwartielen (r_quartile, f_quartile, m_quartile) in één kolom; deze ranking helpt je om klanten goed te segmenteren.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Gefeliciteerd, je bent tot het einde van deze tutorial gekomen!
In deze tutorial heb je veel details over klantsegmentatie behandeld. Je hebt geleerd wat klantsegmentatie is, waarom het nodig is, typen segmentatie, RFM-analyse en de implementatie van RFM vanaf nul in Python. Ook heb je enkele basisconcepten van pandas behandeld, zoals het omgaan met dubbelen, groupby en qcut() voor bakken op basis van steekproefkwartielen.
Hopelijk kun je nu topic modeling gebruiken om je eigen datasets te analyseren. Bedankt voor het lezen van deze tutorial!
Wil je meer leren over Python? Volg dan de gratis cursus Intro to Python for Data Science van DataCamp.
Leer meer over Python
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

