Kurs
Python ile Veri Bilimine Giriş
4 sa
503.3K
Perakende sektöründe, farklı hipermarket zincirleri olağanüstü büyük miktarda veri üretmektedir. Bu veriler mağazalar genelinde günlük olarak oluşur. Bu kapsamlı müşteri işlem veritabanının, kârlı stratejiler tasarlamak için analiz edilmesi gerekir.
Tüm müşterilerin ihtiyaçları farklıdır. Müşteri tabanı ve işlem sayısı arttıkça, her bir müşterinin gereksinimlerini anlamak kolay değildir. Potansiyel müşterileri belirlemek, pazarlama kampanyasını iyileştirerek nihayetinde satışları artırabilir. Segmentasyon, bu müşterileri çeşitli segmentler halinde gruplamakta daha iyi bir rol oynayabilir.
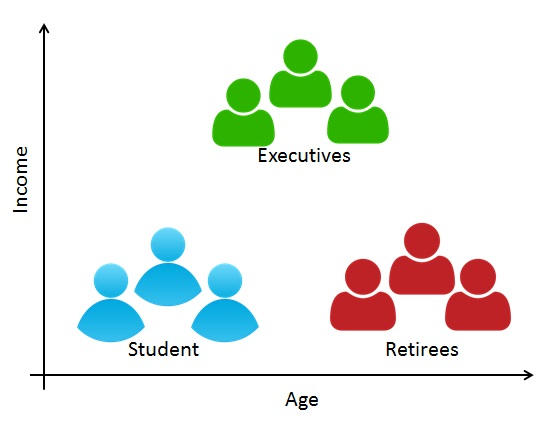
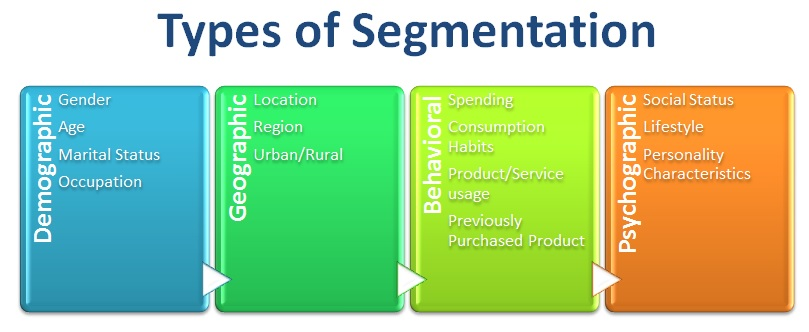
Müşteri segmentasyonu, müşterileri ortak özelliklere göre gruplara veya kümelere ayırma yöntemidir. Pazar araştırmacısı, B2C modelinde müşterileri; meslek, cinsiyet, yaş, konum ve medeni durum gibi çeşitli demografik özelliklere göre segmentlere ayırabilir. Sosyo-psikolojik özellikler olarak sosyal sınıf, yaşam tarzı ve kişilik özellikleri ile harcama, tüketim alışkanlıkları, ürün/hizmet kullanımı ve daha önce satın alınan ürünler gibi davranışsal özellikler de kullanılabilir. B2B modelinde ise şirket büyüklüğü, sektör türü ve konum gibi çeşitli şirket özellikleri kullanılır.
RFM (Recency, Frequency, Monetary) analizi, müşterileri segmentlere ayıran davranış temelli bir yaklaşımdır. Müşterileri önceki satın alma işlemlerine göre gruplar. Bir müşteri ne kadar yakın zamanda, ne sıklıkla ve ne kadar tutarda satın aldı? RFM, daha iyi hizmet sunma amacıyla müşterileri çeşitli gruplara ayırır. Yöneticilerin daha kârlı iş yapmak için potansiyel müşterileri belirlemesine yardımcı olur. Yüksek harcama yapan bir müşteri segmenti vardır, peki ya sadece bir kez mi satın aldılar ya da en son ne zaman satın aldılar? Ürünümüzü sık sık satın alıyorlar mı? Ayrıca, kişiselleştirilmiş hizmet için etkili bir promosyon kampanyası yürütmelerine yardımcı olur.
Burada, üç değişkenin (Recency, Frequency ve Monetary) her biri dört eşit gruptan oluşur ve bu da 64 (4x4x4) farklı müşteri segmenti oluşturur.
RFM (Recency, Frequency, Monetary) adımları:
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Önce pandas read CSV fonksiyonunu kullanarak gerekli İK veri setini yükleyelim. Veriyi bu bağlantıdan indirebilirsiniz.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
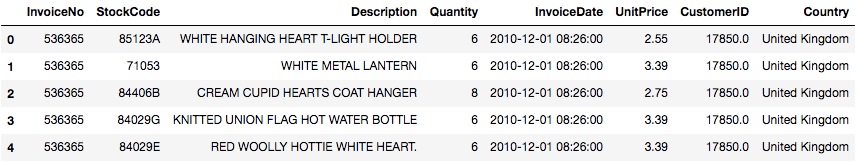
data.tail()
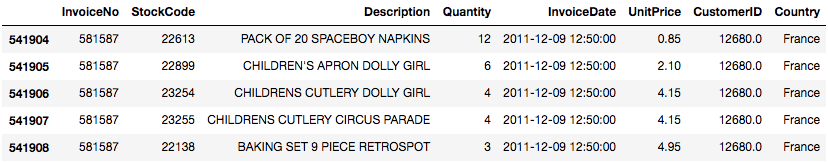
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
Bazen dağınık bir veri kümesi elde edersiniz. Analizinizi çarpıtacak yinelenen kayıtlarla uğraşmanız gerekebilir. python içinde, pandas tekrar eden veya mükerrer kayıtları düşüren drop_duplicates() fonksiyonunu sunar.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
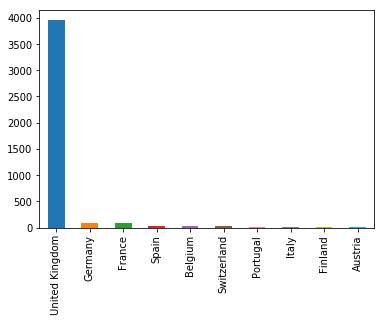
Verilen veri kümesinde, müşterilerin çoğunun "United Kingdom"dan olduğunu görebilirsiniz. Bu nedenle Birleşik Krallık müşterileri için veriyi filtreleyebilirsiniz.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
pandas içindeki describe() fonksiyonu, çeşitli özet istatistikleri elde etmede kullanışlıdır. Bu fonksiyon, sayım, ortalama, standart sapma, minimum ve maksimum değerler ile verinin çeyrekliklerini döndürür.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Burada, bazı müşterilerin negatif miktarda sipariş verdiğini gözlemleyebilirsiniz; bu mümkün değildir. Bu nedenle, Quantity değerini sıfırdan büyük olacak şekilde filtrelemeniz gerekir.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Burada, RFM analizi için gerekli sütunları filtreleyebilirsiniz. Yalnızca beş sütuna ihtiyacınız var: CustomerID, InvoiceDate, InvoiceNo, Quantity ve UnitPrice. CustomerID müşterilerinizi benzersiz olarak tanımlar, InvoiceDate satın almanın yakınlığını (recency) hesaplamanıza yardımcı olur, InvoiceNo ise yapılan işlem sayısını (frequency) saymanıza yardımcı olur. Her işlemde satın alınan Quantity ve müşterinin satın aldığı her birimin UnitPrice değeri, toplam satın alma tutarını hesaplamanıza yardımcı olur.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Burada aşağıdaki işlemleri gerçekleştireceksiniz:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
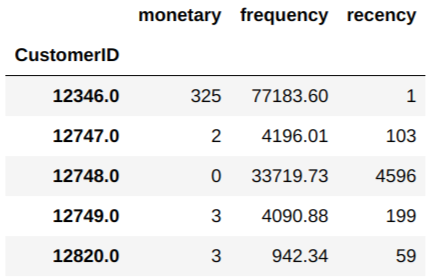
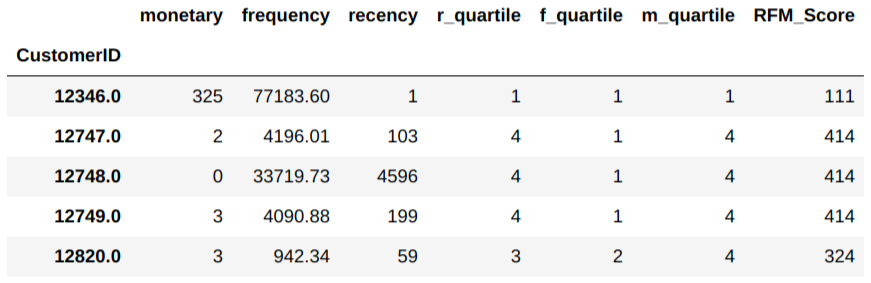
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
En düşük recency, en yüksek frequency ve monetary tutarlarına sahip müşteriler en iyi müşteriler olarak kabul edilir.
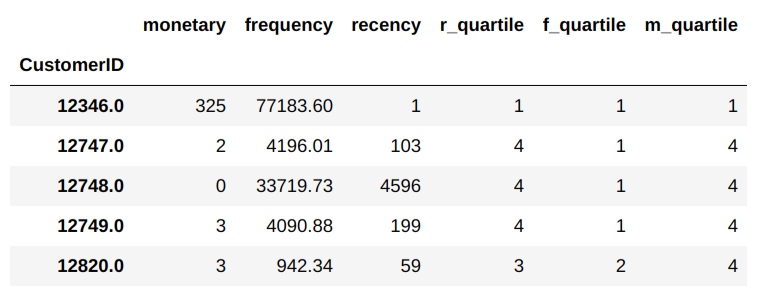
qcut(), çeyreklik temelli ayrıştırma fonksiyonudur. qcut, veriyi örnek çeyrekliklerine göre kutulara yerleştirir. Örneğin, 4 çeyreklik için 1000 değer, her müşteri için çeyreklik üyeliğini belirten kategorik bir nesne üretir.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
Üç çeyrekliği (r_quartile, f_quartile, m_quartile) tek bir sütunda birleştirin; bu sıralama, müşterileri iyi gruplamanıza yardımcı olacaktır.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Tebrikler, bu eğitimin sonuna geldiniz!
Bu eğitimde Müşteri Segmentasyonu hakkında birçok ayrıntıyı ele aldınız. Müşteri segmentasyonunun ne olduğunu, müşteri segmentasyonuna neden ihtiyaç duyulduğunu, segmentasyon türlerini, RFM analizini ve Python’da sıfırdan RFM uygulamasını öğrendiniz. Ayrıca pandas’ın yinelenenleri ele alma, groupby ve örnek çeyrekliklere dayalı kutular için qcut() gibi bazı temel kavramlarını da gördünüz.
Umarız artık kendi veri kümelerinizi analiz etmek için konu modellemeden yararlanabilirsiniz. Bu eğitimi okuduğunuz için teşekkürler!
Daha fazla Python öğrenmek isterseniz, DataCamp’in ücretsiz Intro to Python for Data Science kursunu alın.
Python hakkında daha fazla bilgi edinin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




