{count, plural, one {कोर्स} other {कोर्स}}
Python में Data Science परिचय
{hours} घंटा
503.6K
रिटेल सेक्टर में, हाइपरमार्केट की विभिन्न चेन अपार मात्रा में डेटा उत्पन्न कर रही हैं। यह डेटा स्टोर्स में रोज़ाना उत्पन्न होता है। ग्राहकों के इस विस्तृत ट्रांज़ैक्शन डेटाबेस का विश्लेषण लाभदायक रणनीतियाँ बनाने के लिए आवश्यक है।
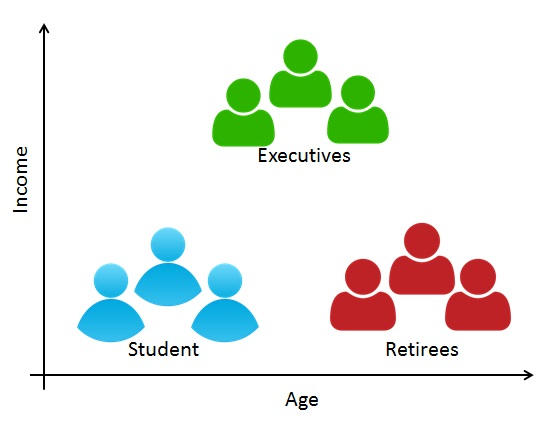
सभी ग्राहकों की ज़रूरतें अलग-अलग होती हैं। ग्राहक आधार और लेनदेन बढ़ने के साथ, प्रत्येक ग्राहक की आवश्यकता को समझना आसान नहीं रहता। संभावित ग्राहकों की पहचान करने से मार्केटिंग अभियान बेहतर हो सकता है, जिससे अंततः बिक्री बढ़ती है। विभाजन इन ग्राहकों को विभिन्न खंडों में समूहित करने में बेहतर भूमिका निभा सकता है।
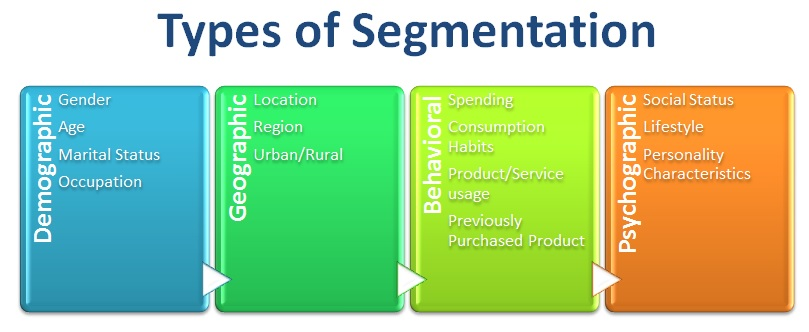
ग्राहक विभाजन एक विधि है जिसमें ग्राहकों को सामान्य विशेषताओं के आधार पर समूहों या क्लस्टर्स में बाँटा जाता है। मार्केट रिसर्चर B2C मॉडल में ग्राहकों को विभिन्न जनसांख्यिकीय विशेषताओं जैसे व्यवसाय, लिंग, आयु, स्थान, और वैवाहिक स्थिति के आधार पर विभाजित कर सकते हैं। मनोवैज्ञानिक विशेषताएँ जैसे सामाजिक वर्ग, जीवनशैली और व्यक्तित्व गुण, तथा व्यवहारगत विशेषताएँ जैसे खर्च करने की आदतें, उपभोग पैटर्न, उत्पाद/सेवा का उपयोग, और पहले खरीदे गए उत्पाद। B2B मॉडल में, कंपनी के आकार, उद्योग के प्रकार, और स्थान जैसी कंपनी-स्तरीय विशेषताओं का उपयोग किया जाता है।
RFM (Recency, Frequency, Monetary) विश्लेषण एक व्यवहार-आधारित तरीका है जिसमें ग्राहकों को सेगमेंट्स में समूहित किया जाता है। यह ग्राहकों को उनकी पिछली खरीद लेनदेन के आधार पर समूहित करता है—ग्राहक ने कितनी हाल में, कितनी बार, और कितनी राशि की खरीदारी की। RFM बेहतर सेवा के उद्देश्य से ग्राहकों को विभिन्न समूहों में फ़िल्टर करता है। यह प्रबंधकों को अधिक लाभदायक व्यवसाय के लिए संभावित ग्राहकों की पहचान करने में मदद करता है। कुछ ग्राहक बड़े खर्च करने वाले होते हैं, लेकिन यदि उन्होंने केवल एक बार खरीदा हो या उन्होंने हाल में कब खरीदा? क्या वे अक्सर हमारा उत्पाद खरीदते हैं? यह व्यक्तिगत सेवा के लिए प्रभावी प्रोमोशनल अभियान चलाने में भी मदद करता है।
यहाँ, तीनों वेरिएबल्स (Recency, Frequency, और Monetary) में चार-चार समान समूह होते हैं, जो मिलकर 64 (4x4x4) अलग-अलग ग्राहक सेगमेंट बनाते हैं।
RFM (Recency, Frequency, Monetary) के चरण:
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
पहले pandas की read CSV फ़ंक्शन का उपयोग करके आवश्यक HR डेटासेट लोड करते हैं। आप यह डेटा इस लिंक से डाउनलोड कर सकते हैं।
data = pd.read_excel("Online_Retail.xlsx")
data.head()
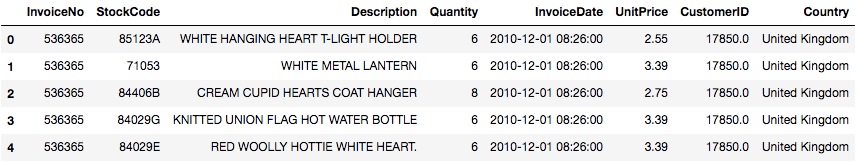
data.tail()
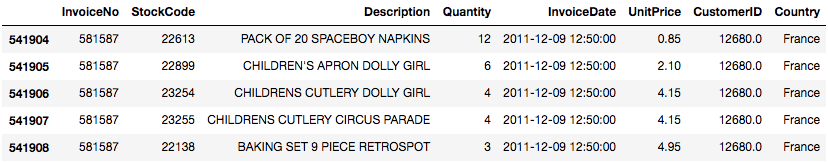
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
कभी-कभी आपको उलझा हुआ डेटासेट मिलता है। आपको डुप्लिकेट्स से निपटना पड़ सकता है, जो आपके विश्लेषण को बिगाड़ देंगे। python में, pandas का drop_duplicates() फ़ंक्शन दोहराए गए या डुप्लिकेट रिकॉर्ड्स को हटा देता है।
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
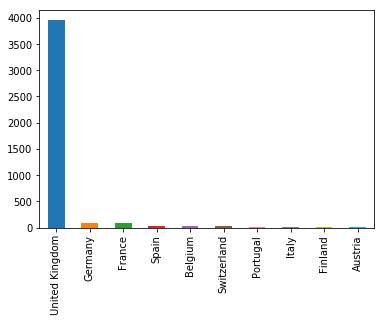
दिए गए डेटासेट में, आप देख सकते हैं कि अधिकांश ग्राहक "United Kingdom" से हैं। इसलिए, आप United Kingdom के ग्राहकों के लिए डेटा फ़िल्टर कर सकते हैं।
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
pandas में describe() फ़ंक्शन विभिन्न संक्षिप्त सांख्यिकी प्राप्त करने में सहायक है। यह फ़ंक्शन डेटा की गणना, औसत, मानक विचलन, न्यूनतम और अधिकतम मान, तथा क्वांटाइल्स लौटाता है।
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
यहाँ, आप देख सकते हैं कि कुछ ग्राहकों ने नकारात्मक मात्रा में ऑर्डर किया है, जो संभव नहीं है। इसलिए, आपको Quantity को शून्य से अधिक पर फ़िल्टर करना होगा।
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
यहाँ, आप RFM विश्लेषण के लिए आवश्यक कॉलम फ़िल्टर कर सकते हैं। आपको केवल पाँच कॉलम चाहिए: CustomerID, InvoiceDate, InvoiceNo, Quantity, और UnitPrice। CustomerID आपके ग्राहकों को अद्वितीय रूप से परिभाषित करेगा, InvoiceDate आपको खरीद की हालियत (recency) गणना में मदद करेगा, InvoiceNo लेनदेन की संख्या (frequency) गिनने में मदद करेगा। प्रत्येक लेनदेन में खरीदी गई Quantity और ग्राहक द्वारा खरीदे गए प्रत्येक यूनिट का UnitPrice कुल खरीदी गई राशि की गणना में मदद करेगा।
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
यहाँ, आप निम्नलिखित क्रियाएँ करेंगे:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
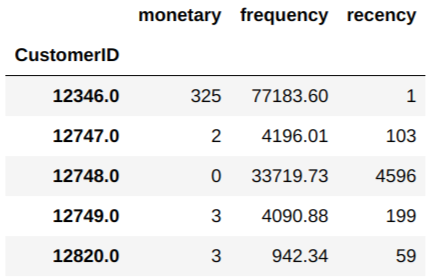
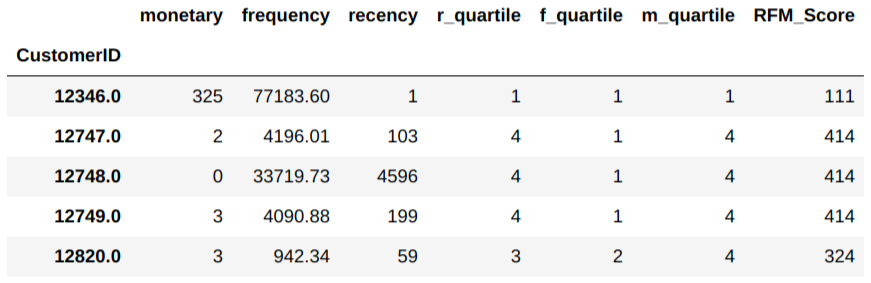
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
सबसे कम recency और सबसे अधिक frequency तथा monetary राशि वाले ग्राहक शीर्ष ग्राहकों के रूप में माने जाते हैं।
qcut() क्वांटाइल-आधारित डिस्क्रीटाइज़ेशन फ़ंक्शन है। qcut नमूना क्वांटाइल्स के आधार पर डेटा को बिन्स में बाँटता है। उदाहरण के लिए, 4 क्वांटाइल्स के लिए 1000 मान प्रत्येक ग्राहक के लिए क्वांटाइल सदस्यता दर्शाने वाला एक श्रेणीबद्ध ऑब्जेक्ट बनाएंगे।
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
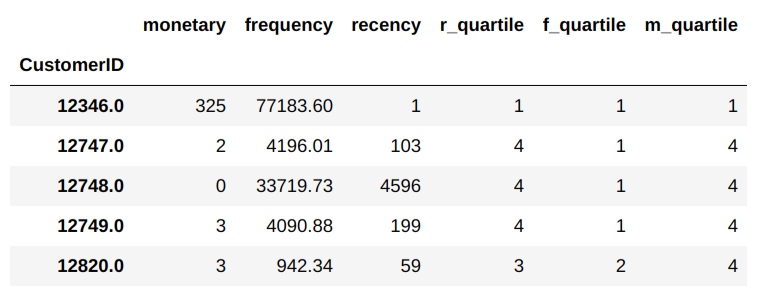
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
सभी तीन क्वार्टाइल्स (r_quartile, f_quartile, m_quartile) को एक ही कॉलम में जोड़ें; यह रैंक आपको ग्राहकों को बेहतर तरीके से सेगमेंट करने में मदद करेगा।
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
बधाई हो, आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं!
इस ट्यूटोरियल में, आपने Customer Segmentation के बारे में कई विवरण कवर किए। आपने सीखा कि ग्राहक विभाजन क्या है, इसकी आवश्यकता, विभाजन के प्रकार, RFM विश्लेषण, और Python में RFM का शून्य से इम्प्लीमेंटेशन। साथ ही, आपने pandas के कुछ बुनियादी कॉन्सेप्ट्स जैसे डुप्लिकेट हैंडल करना, groupby, और नमूना क्वांटाइल्स के आधार पर बिन्स बनाने के लिए qcut() भी कवर किया।
आशा है, अब आप अपने स्वयं के डेटासेट का विश्लेषण करने के लिए टॉपिक मॉडलिंग का उपयोग कर पाएंगे। इस ट्यूटोरियल को पढ़ने के लिए धन्यवाद!
यदि आप Python के बारे में और सीखना चाहते हैं, तो DataCamp का निःशुल्क Intro to Python for Data Science कोर्स करें।
Python के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}