{count, plural, one {Corso} other {Corsi}}
Introduzione alla Data Science in Python
{hours} ore
503.6K
Nel settore Retail, le varie catene di ipermercati generano una quantità di dati eccezionalmente ampia. Questi dati vengono prodotti quotidianamente nei diversi punti vendita. Questo vasto database di transazioni dei clienti deve essere analizzato per progettare strategie profittevoli.
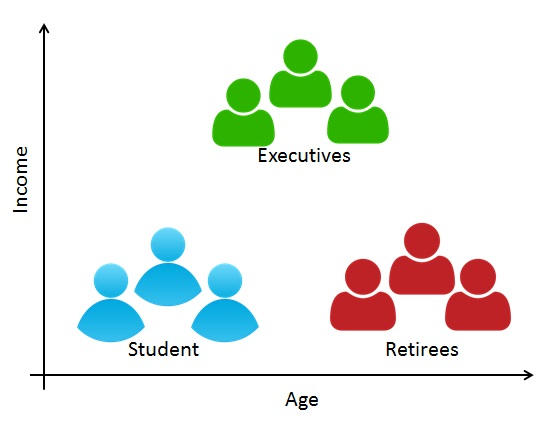
Tutti i clienti hanno esigenze diverse. Con l’aumentare della base clienti e delle transazioni, non è facile capire le necessità di ciascuno. Identificare i clienti potenziali può migliorare le campagne di marketing, con un conseguente aumento delle vendite. La segmentazione può svolgere un ruolo chiave nel raggruppare questi clienti in vari segmenti.
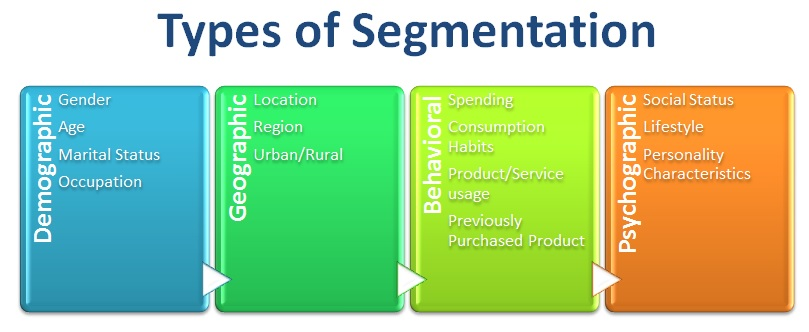
La segmentazione dei clienti è un metodo per suddividere i clienti in gruppi o cluster sulla base di caratteristiche comuni. Il ricercatore di mercato può segmentare i clienti nel modello B2C usando varie caratteristiche demografiche dei clienti come occupazione, genere, età, posizione e stato civile. Caratteristiche psicografiche come classe sociale, stile di vita e caratteristiche della personalità e caratteristiche comportamentali come spesa, abitudini di consumo, uso di prodotti/servizi e prodotti acquistati in precedenza. Nel modello B2B si utilizzano varie caratteristiche dell’azienda, come dimensioni, tipo di settore e sede.
L’analisi RFM (Recency, Frequency, Monetary) è un approccio basato sui comportamenti che raggruppa i clienti in segmenti. Raggruppa i clienti sulla base delle loro precedenti transazioni di acquisto: quanto di recente, quanto spesso e quanto ha speso un cliente. RFM filtra i clienti in vari gruppi con l’obiettivo di offrire un servizio migliore. Aiuta i responsabili a identificare i clienti potenziali per fare business più profittevole. Esiste un segmento di clienti che spende molto, ma cosa succede se hanno acquistato una sola volta o quanto recentemente hanno acquistato? Acquistano spesso i nostri prodotti? Inoltre, aiuta i responsabili a eseguire campagne promozionali efficaci per un servizio personalizzato.
Qui, ciascuna delle tre variabili (Recency, Frequency e Monetary) è suddivisa in quattro gruppi uguali, creando 64 (4x4x4) segmenti di clienti diversi.
Passaggi dell’analisi RFM (Recency, Frequency, Monetary):
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Per prima cosa carichiamo il dataset HR richiesto usando la funzione read CSV di pandas. Puoi scaricare i dati da questo link.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
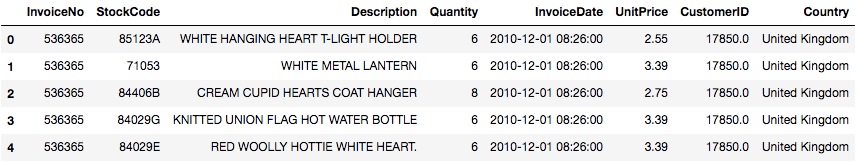
data.tail()
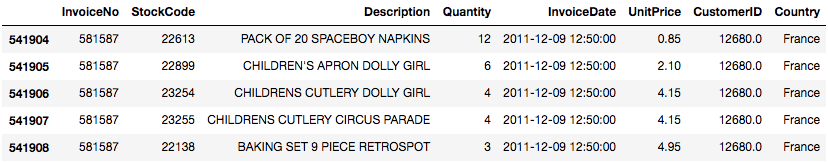
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
A volte ti capita un dataset disordinato. Potresti dover gestire i duplicati, che alterano l’analisi. In python, pandas offre la funzione drop_duplicates(), che elimina i record ripetuti o duplicati.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
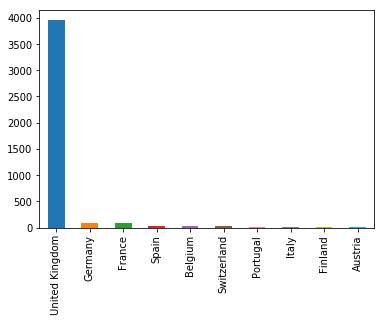
Nel dataset fornito, puoi osservare che la maggior parte dei clienti proviene dal "United Kingdom". Quindi, puoi filtrare i dati per i clienti del Regno Unito.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
La funzione describe() di pandas è utile per ottenere diverse statistiche descrittive. Questa funzione restituisce conteggio, media, deviazione standard, valori minimo e massimo e i quantili dei dati.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Qui puoi osservare che alcuni clienti hanno ordinato con quantità negativa, cosa impossibile. Quindi è necessario filtrare le righe con Quantity maggiore di zero.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Qui puoi filtrare le colonne necessarie per l’analisi RFM. Ti servono solo cinque colonne: CustomerID, InvoiceDate, InvoiceNo, Quantity e UnitPrice. CustomerId identifica in modo univoco i tuoi clienti; InvoiceDate ti aiuta a calcolare la recency dell’acquisto; InvoiceNo ti aiuta a contare quante volte è stata effettuata la transazione (frequenza). La Quantity acquistata in ogni transazione e l’UnitPrice di ogni unità acquistata dal cliente ti aiutano a calcolare l’importo totale acquistato.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Qui andrai a svolgere le seguenti operazioni:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
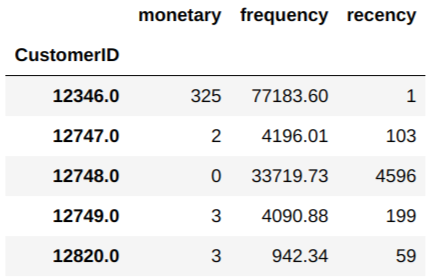
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
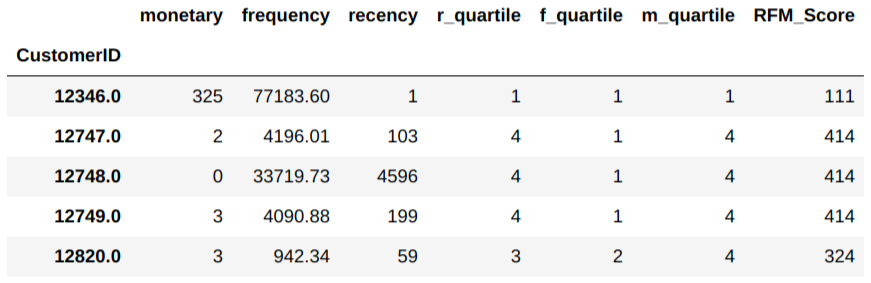
I clienti con recency più bassa e frequency e monetary più alte sono considerati i top customer.
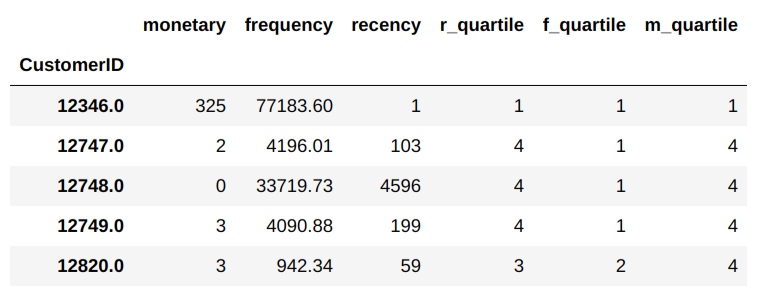
qcut() è una funzione di discretizzazione basata sui quantili. qcut suddivide i dati in bin basati sui quantili del campione. Ad esempio, 1000 valori per 4 quantili produrrebbero un oggetto categorico che indica l’appartenenza al quantile per ciascun cliente.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
Combina tutti e tre i quartili (r_quartile, f_quartile, m_quartile) in un’unica colonna: questo ranking ti aiuterà a segmentare al meglio i clienti in gruppi.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Congratulazioni, sei arrivato alla fine di questo tutorial!
In questo tutorial hai visto molti dettagli sulla segmentazione dei clienti. Hai imparato cos’è la segmentazione dei clienti, perché è necessaria, i tipi di segmentazione, l’analisi RFM e l’implementazione di RFM da zero in Python. Inoltre, hai coperto alcuni concetti di base di pandas come la gestione dei duplicati, groupby e qcut() per creare bin basati sui quantili del campione.
Si spera che ora tu possa utilizzare il topic modeling per analizzare i tuoi dataset. Grazie per aver letto questo tutorial!
Se vuoi saperne di più su Python, segui il corso gratuito di DataCamp Intro to Python for Data Science.
Scopri di più su Python
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



