Curso
Introdução à Ciência de Dados em Python
4 h
502.2K
No varejo, redes de hipermercados geram uma quantidade enorme de dados. Esses dados são criados diariamente em todas as lojas. Esse grande volume de transações de clientes precisa ser analisado para desenhar estratégias mais lucrativas.
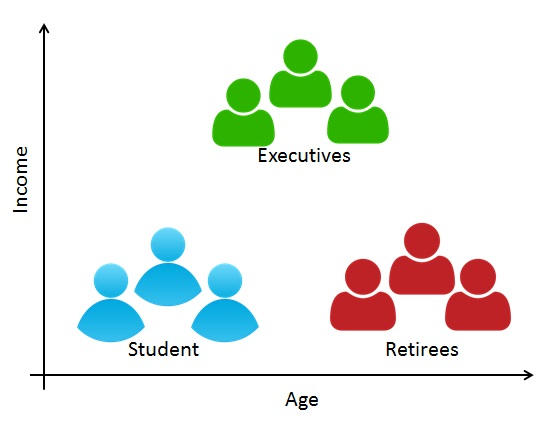
Todo cliente tem necessidades diferentes. Com o crescimento da base e do volume de transações, não é simples entender a demanda de cada pessoa. Identificar clientes com maior potencial melhora as campanhas de marketing e, no fim, aumenta as vendas. A segmentação ajuda a agrupar clientes em diferentes perfis para ações mais efetivas.
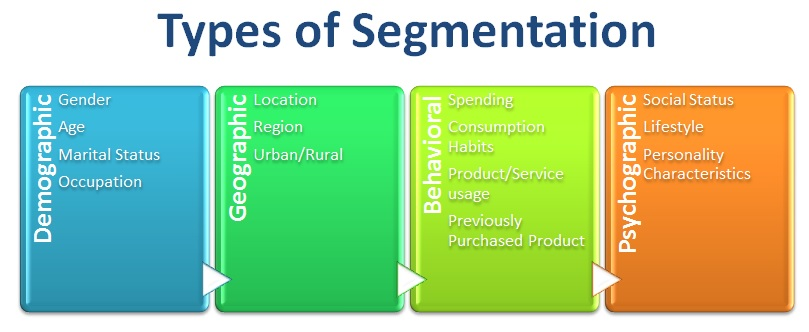
Segmentação de clientes é o método de dividir clientes em grupos ou clusters com base em características em comum. No modelo B2C, o pesquisador de mercado pode segmentar clientes usando características demográficas como ocupação, gênero, idade, localização e estado civil; psicográficas, como classe social, estilo de vida e traços de personalidade; e comportamentais, como gastos, hábitos de consumo, uso de produtos/serviços e histórico de compras. No modelo B2B, é comum usar características da empresa, como porte, setor e localização.
RFM (Recência, Frequência, Valor monetário) é uma abordagem comportamental que agrupa clientes em segmentos. Ela os classifica com base nas transações passadas: quão recentemente, com que frequência e quanto cada cliente comprou. A RFM distribui os clientes em grupos para aprimorar o serviço e ajuda gestores a identificar clientes com maior potencial para gerar negócios mais lucrativos. Há clientes que gastam muito, mas e se compraram apenas uma vez, ou há quanto tempo foi a última compra? Eles compram com frequência? A RFM também apoia campanhas promocionais mais eficazes e personalizadas.
Aqui, cada uma das três variáveis (Recência, Frequência e Valor monetário) é dividida em quatro grupos iguais, criando 64 (4x4x4) segmentos de clientes diferentes.
Passos da RFM (Recency, Frequency, Monetary):
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Vamos carregar o dataset de varejo com a função read_excel do pandas. Você pode baixar os dados por este link.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
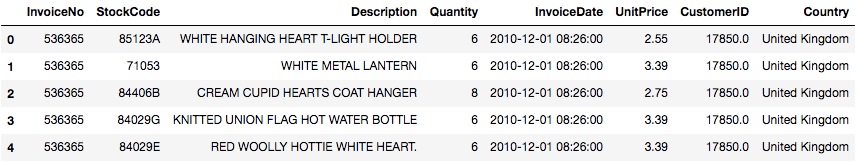
data.tail()
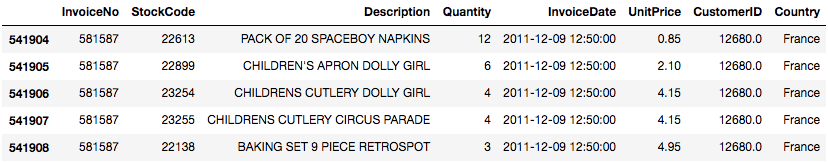
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
Algumas vezes o dataset vem desorganizado. É comum lidar com duplicatas, que distorcem a análise. Em Python, o pandas oferece a função drop_duplicates(), que remove registros repetidos.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
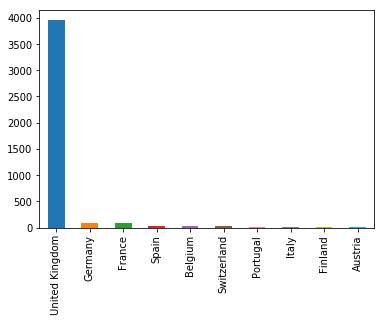
Neste dataset, a maioria dos clientes é do "United Kingdom". Então, podemos filtrar os dados apenas para clientes do Reino Unido.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
A função describe() do pandas é prática para obter estatísticas descritivas. Ela retorna contagem, média, desvio padrão, valores mínimo e máximo e os quartis dos dados.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Aqui dá para notar que alguns clientes têm quantidade negativa, o que não faz sentido. Então precisamos filtrar Quantity maior que zero.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Aqui vamos manter apenas as colunas essenciais para a análise RFM. Você precisa de cinco colunas: CustomerID, InvoiceDate, InvoiceNo, Quantity e UnitPrice. CustomerID identifica cada cliente; InvoiceDate permite calcular a recência; InvoiceNo ajuda a contar quantas transações foram feitas (frequência). Quantity e UnitPrice permitem calcular o valor total comprado.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Nesta etapa, vamos realizar as seguintes operações:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
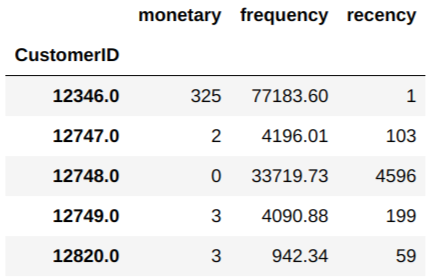
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
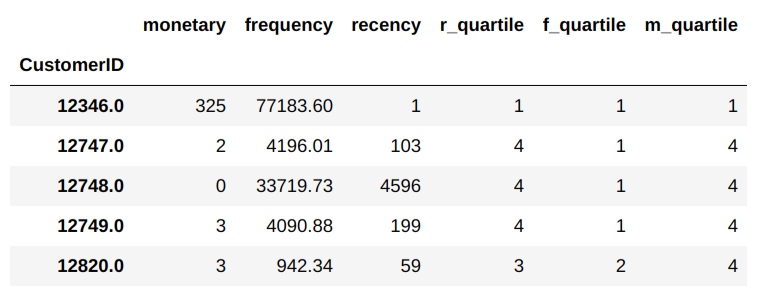
Clientes com menor recência e maiores frequência e valor monetário são considerados os melhores clientes.
qcut() é uma função de discretização baseada em quantis. Ela cria faixas de dados com base nos quantis amostrais. Por exemplo, 1000 valores divididos em 4 quantis geram uma coluna categórica indicando a qual quantil cada cliente pertence.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
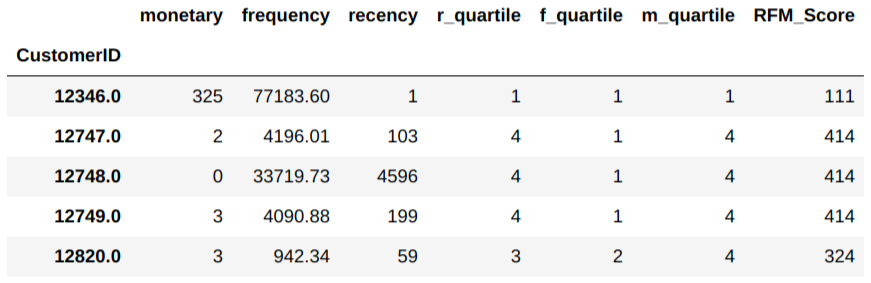
Combine os três quartis (r_quartile, f_quartile, m_quartile) em uma única coluna. Essa classificação ajuda a segmentar melhor os clientes.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Parabéns, você chegou ao fim deste tutorial!
Neste conteúdo, você viu em detalhes o que é segmentação de clientes, por que ela é importante, os tipos de segmentação, a análise RFM e como implementá-la do zero em Python. Também revisamos conceitos básicos de pandas, como tratamento de duplicatas, groupby e qcut() para criar faixas com base em quantis.
Agora você já pode aplicar a análise de segmentação comportamental nos seus próprios dados. Obrigado por ler!
Se quiser aprender mais sobre Python, faça o curso gratuito da DataCamp Intro to Python for Data Science.
Saiba mais sobre Python
Curso
Curso
Curso
Tutorial
Kevin Babitz
8 min
Tutorial
Karlijn Willems
14 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Moez Ali
14 min
Tutorial
Joleen Bothma
9 min
Tutorial
Satyam Tripathi
9 min