Curso
Introducción a la ciencia de datos con Python
4 h
502.2K
En el sector retail, las cadenas de hipermercados generan una cantidad de datos enorme. Estos datos se producen a diario en todas las tiendas. Esta base de datos tan extensa de transacciones de clientes debe analizarse para diseñar estrategias rentables.
Cada cliente tiene necesidades distintas. A medida que crece la base de clientes y el volumen de transacciones, no es fácil comprender lo que necesita cada uno. Identificar a los clientes con mayor potencial puede mejorar las campañas de marketing y, en última instancia, aumentar las ventas. La segmentación ayuda a agrupar a los clientes en distintos segmentos para poder abordarlos mejor.
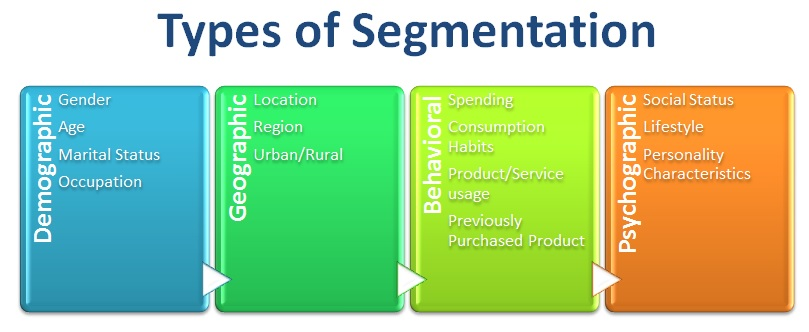
La segmentación de clientes es un método para dividir a los clientes en grupos o clústeres en función de características comunes. En el modelo B2C, la investigación de mercado puede segmentar clientes según características demográficas como ocupación, género, edad, ubicación y estado civil; características psicográficas como clase social, estilo de vida y personalidad; y características de comportamiento como gasto, hábitos de consumo, uso de productos/servicios y compras anteriores. En el modelo B2B, puede basarse en características de la empresa como tamaño, tipo de industria y ubicación.
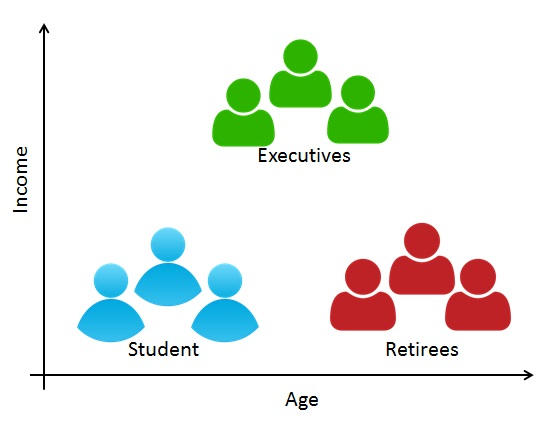
El análisis RFM (Recency, Frequency, Monetary) es un enfoque basado en el comportamiento que agrupa a los clientes en segmentos. Los agrupa según sus transacciones de compra anteriores: cuán reciente, con qué frecuencia y cuánto ha comprado un cliente. RFM clasifica a los clientes en distintos grupos para poder darles un mejor servicio. Ayuda a los responsables a identificar clientes con potencial para hacer el negocio más rentable. Por ejemplo, puede haber clientes que gastan mucho, pero ¿y si solo han comprado una vez o hace mucho? ¿Compran con frecuencia nuestros productos? Además, ayuda a ejecutar campañas promocionales eficaces y personalizadas.
Aquí, cada una de las tres variables (Recency, Frequency y Monetary) se divide en cuatro grupos iguales, lo que crea 64 (4x4x4) segmentos de clientes diferentes.
Pasos del análisis RFM (Recency, Frequency, Monetary):
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Primero vamos a cargar el dataset de HR necesario con la función read CSV de pandas. Puedes descargar los datos desde este enlace.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
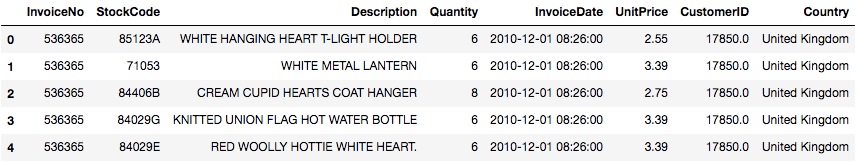
data.tail()
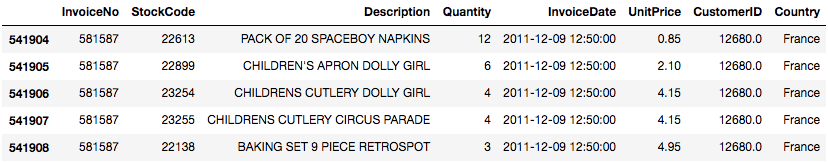
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
A veces el dataset viene desordenado. Puede haber duplicados que distorsionen el análisis. En python, pandas ofrece la función drop_duplicates(), que elimina los registros repetidos o duplicados.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
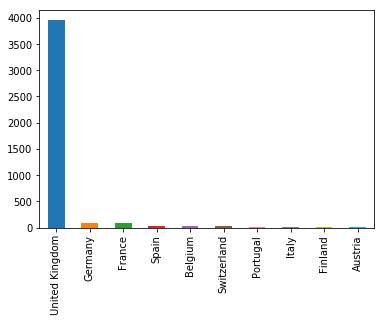
En el dataset proporcionado, se observa que la mayoría de clientes son del "United Kingdom". Por tanto, puedes filtrar los datos para clientes del United Kingdom.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
La función describe() de pandas es muy útil para obtener estadísticas descriptivas. Devuelve el recuento, media, desviación estándar, valores mínimo y máximo, y los cuantiles de los datos.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
Aquí se observa que algunos clientes han realizado pedidos con cantidad negativa, lo cual no es posible. Por tanto, filtra Quantity para que sea mayor que cero.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Aquí vas a filtrar las columnas imprescindibles para el análisis RFM. Solo necesitas cinco: CustomerID, InvoiceDate, InvoiceNo, Quantity y UnitPrice. CustomerID identifica de forma única a cada cliente; InvoiceDate te permite calcular la recencia; InvoiceNo te ayuda a contar cuántas transacciones se han realizado (frecuencia). La cantidad comprada en cada transacción y el precio unitario de cada artículo te permiten calcular el importe total comprado.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Aquí vas a realizar las siguientes operaciones:
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
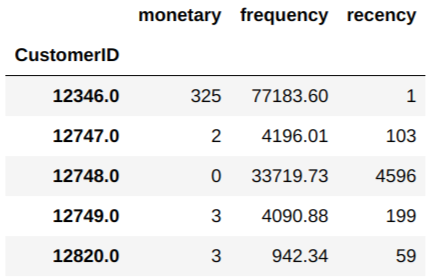
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
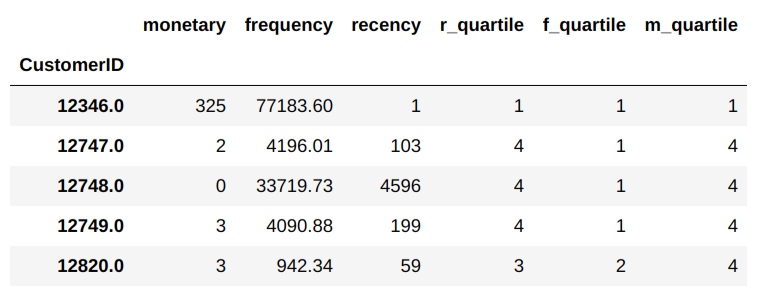
Los clientes con menor recencia y mayor frecuencia y valor monetario se consideran los mejores.
qcut() es una función de discretización basada en cuantiles. Divide los datos en bins según los cuantiles de la muestra. Por ejemplo, 1000 valores en 4 cuantiles producirán un objeto categórico que indica a qué cuantil pertenece cada cliente.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
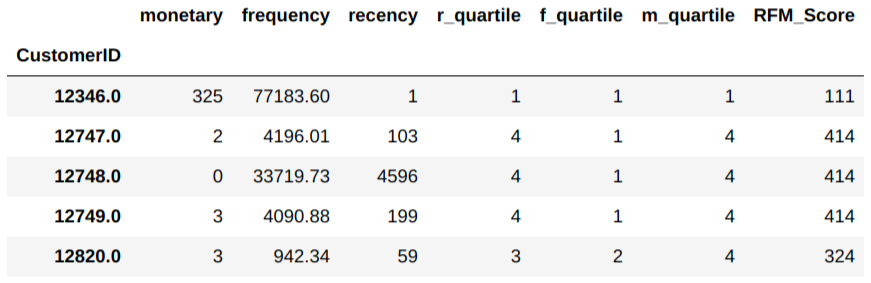
Combina los tres cuartiles (r_quartile, f_quartile, m_quartile) en una sola columna. Este rango te ayudará a segmentar mejor a tus clientes.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
¡Enhorabuena, has llegado al final de este tutorial!
En este tutorial has visto en detalle la segmentación de clientes: qué es, por qué la necesitas, los tipos de segmentación, el análisis RFM y cómo implementarlo desde cero en python. También repasaste conceptos básicos de pandas como la gestión de duplicados, groupby y qcut() para crear bins basados en cuantiles de muestra.
Esperamos que ahora puedas aplicar el modelado de temas para analizar tus propios datasets. ¡Gracias por leer!
Si quieres aprender más sobre Python, haz el curso gratuito de DataCamp Intro to Python for Data Science.
Más sobre Python
Curso
Curso
Curso
Tutorial
Kevin Babitz
8 min
Tutorial
Karlijn Willems
14 min
Tutorial
Moez Ali
14 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Duong Vu
11 min