Cours
Introduction à la Data Science en Python
4 h
502.3K
Dans le retail, les chaînes d’hypermarchés génèrent des volumes de données considérables, au quotidien et dans tous les magasins. Cette masse de transactions clients doit être analysée pour élaborer des stratégies rentables.
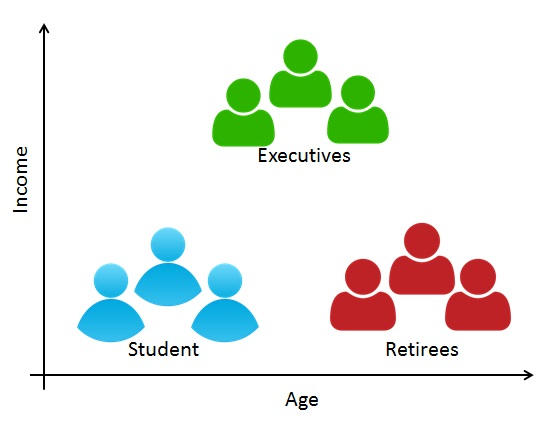
Tous les clients n’ont pas les mêmes besoins. Avec l’accroissement de la base clients et des transactions, il devient difficile de comprendre les attentes de chacun. Identifier les clients à fort potentiel améliore l’efficacité des campagnes marketing et, in fine, les ventes. La segmentation permet de regrouper ces clients en ensembles homogènes.
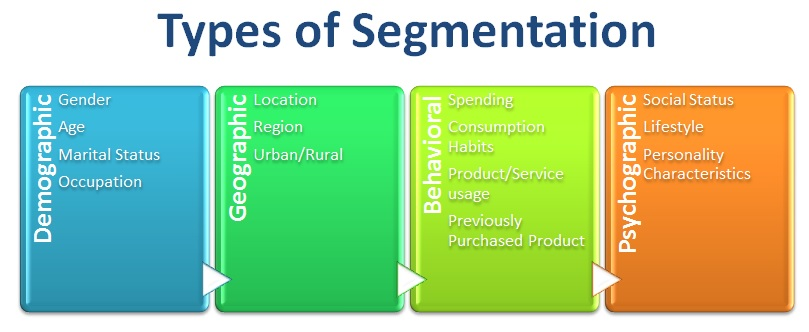
La segmentation client consiste à diviser des clients en groupes ou clusters selon des caractéristiques communes. En B2C, on peut segmenter à partir de critères démographiques (profession, genre, âge, localisation, situation matrimoniale), psychographiques (classe sociale, style de vie, traits de personnalité) ou comportementaux (dépenses, habitudes de consommation, usage des produits/services, achats antérieurs). En B2B, on utilise des critères propres à l’entreprise (taille, secteur d’activité, localisation).
RFM (Récence, Fréquence, Montant) est une approche comportementale qui regroupe les clients selon leurs transactions passées : depuis quand ont-ils acheté (récence), à quelle fréquence achètent-ils (fréquence), et pour quels montants (monétaire). RFM classe les clients dans différents groupes pour offrir un meilleur service. Cela aide les managers à repérer les clients à fort potentiel et à piloter des actions plus rentables. Par exemple, un « gros acheteur » n’est pas forcément fidèle s’il n’a commandé qu’une fois ou il y a longtemps. L’analyse RFM éclaire ces nuances et facilite des campagnes promotionnelles personnalisées et efficaces.
Ici, chacune des trois variables (Récence, Fréquence, Montant) est découpée en quatre groupes de taille égale, ce qui crée 64 (4x4x4) segments clients.
Étapes de l’analyse RFM (Récence, Fréquence, Montant) :
#import modules
import pandas as pd # for dataframes
import matplotlib.pyplot as plt # for plotting graphs
import seaborn as sns # for plotting graphs
import datetime as dt
Chargeons d’abord le jeu de données avec la fonction read_excel de pandas. Vous pouvez télécharger les données depuis ce lien.
data = pd.read_excel("Online_Retail.xlsx")
data.head()
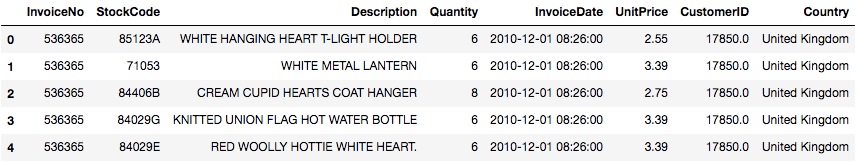
data.tail()
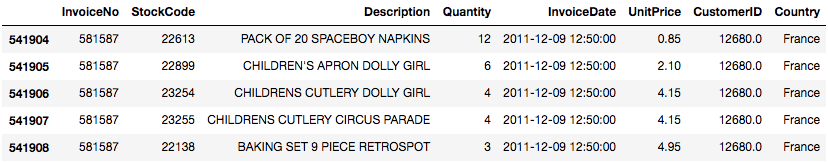
data.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 541909 entries, 0 to 541908
Data columns (total 8 columns):
InvoiceNo      541909 non-null object
StockCode      541909 non-null object
Description    540455 non-null object
Quantity       541909 non-null int64
InvoiceDate    541909 non-null datetime64[ns]
UnitPrice      541909 non-null float64
CustomerID     406829 non-null float64
Country        541909 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 33.1+ MB
data= data[pd.notnull(data['CustomerID'])]
Il arrive d’avoir un jeu de données « bruité ». Vous devrez alors gérer les doublons, qui biaisent l’analyse. En python, pandas propose la fonction drop_duplicates(), qui supprime les enregistrements répétés.
filtered_data=data[['Country','CustomerID']].drop_duplicates()
#Top ten country's customer
filtered_data.Country.value_counts()[:10].plot(kind='bar')
<matplotlib.axes._subplots.AxesSubplot at 0x7fd81725dfd0>
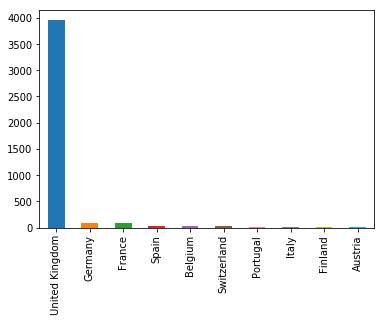
Dans ce jeu de données, la majorité des clients provient du « United Kingdom ». Vous pouvez donc filtrer les données sur les clients du Royaume-Uni.
uk_data=data[data.Country=='United Kingdom']
uk_data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 361878 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo      361878 non-null object
StockCode      361878 non-null object
Description    361878 non-null object
Quantity       361878 non-null int64
InvoiceDate    361878 non-null datetime64[ns]
UnitPrice      361878 non-null float64
CustomerID     361878 non-null float64
Country        361878 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.8+ MB
La fonction describe() de pandas permet d’obtenir rapidement des statistiques descriptives : effectifs, moyenne, écart-type, valeurs minimale et maximale, et quantiles.
uk_data.describe()
| Quantity | UnitPrice | CustomerID | |
|---|---|---|---|
| count | 361878.000000 | 361878.000000 | 361878.000000 |
| mean | 11.077029 | 3.256007 | 15547.871368 |
| std | 263.129266 | 70.654731 | 1594.402590 |
| min | -80995.000000 | 0.000000 | 12346.000000 |
| 25% | 2.000000 | 1.250000 | 14194.000000 |
| 50% | 4.000000 | 1.950000 | 15514.000000 |
| 75% | 12.000000 | 3.750000 | 16931.000000 |
| max | 80995.000000 | 38970.000000 | 18287.000000 |
On observe des quantités négatives, ce qui n’a pas de sens. Filtrons donc les lignes avec Quantity strictement positive.
uk_data = uk_data[(uk_data['Quantity']>0)]In: # Change the name of columns rfm.columns=['monetary','frequency','recency']
uk_data.info() <class 'pandas.core.frame.DataFrame'>
Int64Index: 354345 entries, 0 to 541893
Data columns (total 8 columns):
InvoiceNo 354345 non-null object
StockCode 354345 non-null object
Description 354345 non-null object
Quantity 354345 non-null int64
InvoiceDate 354345 non-null datetime64[ns]
UnitPrice 354345 non-null float64
CustomerID 354345 non-null float64
Country 354345 non-null object
dtypes: datetime64[ns](1), float64(2), int64(1), object(4)
memory usage: 24.3+ MB
Ici, nous gardons les colonnes utiles à l’analyse RFM : CustomerID, InvoiceDate, InvoiceNo, Quantity et UnitPrice. CustomerID identifie chaque client, InvoiceDate sert à calculer la récence, InvoiceNo à compter le nombre de transactions (fréquence). Quantity et UnitPrice permettent de calculer le montant total acheté.
uk_data=uk_data[['CustomerID','InvoiceDate','InvoiceNo','Quantity','UnitPrice']]
uk_data['TotalPrice'] = uk_data['Quantity'] * uk_data['UnitPrice']
uk_data['InvoiceDate'].min(),uk_data['InvoiceDate'].max()
(Timestamp('2010-12-01 08:26:00'), Timestamp('2011-12-09 12:49:00'))
PRESENT = dt.datetime(2011,12,10)
uk_data['InvoiceDate'] = pd.to_datetime(uk_data['InvoiceDate'])
uk_data.head()
| CustomerID | InvoiceDate | InvoiceNo | Quantity | UnitPrice | TotalPrice | |
|---|---|---|---|---|---|---|
| 0 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 2.55 | 15.30 |
| 1 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 2 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 8 | 2.75 | 22.00 |
| 3 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
| 4 | 17850.0 | 2010-12-01 08:26:00 | 536365 | 6 | 3.39 | 20.34 |
Nous allons réaliser les opérations suivantes :
rfm= uk_data.groupby('CustomerID').agg({'InvoiceDate': lambda date: (PRESENT - date.max()).days,
                                        'InvoiceNo': lambda num: len(num),
                                        'TotalPrice': lambda price: price.sum()})
rfm.columns
Index(['InvoiceDate', 'TotalPrice', 'InvoiceNo'], dtype='object')
# Change the name of columns
rfm.columns=['recency', 'monetary', 'frequency']
rfm['recency'] = rfm['recency'].astype(int)
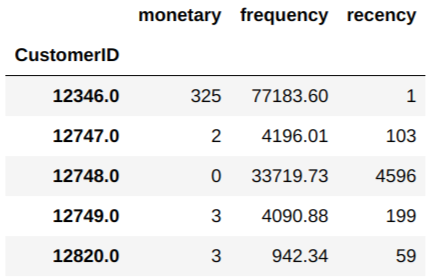
rfm.head()
| monetary | frequency | recency | |
|---|---|---|---|
| CustomerID | |||
| 12346.0 | 325 | 77183.60 | 1 |
| 12747.0 | 2 | 4196.01 | 103 |
| 12748.0 | 0 | 33719.73 | 4596 |
| 12749.0 | 3 | 4090.88 | 199 |
| 12820.0 | 3 | 942.34 | 59 |
Les meilleurs clients sont ceux avec une récence faible, une fréquence élevée et des montants importants.
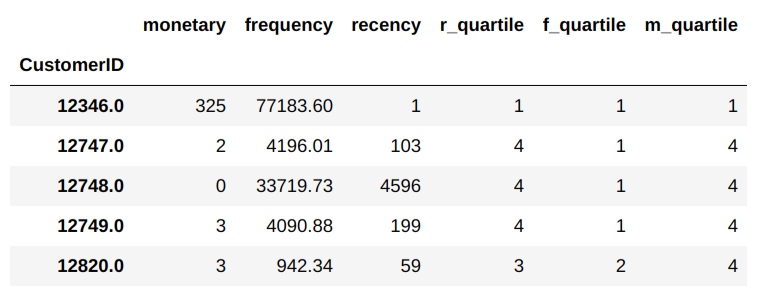
qcut() est une fonction de discrétisation par quantiles : elle répartit les données selon les quantiles de l’échantillon. Par exemple, 1 000 valeurs réparties en 4 quantiles produisent une variable catégorielle indiquant l’appartenance de chaque client à un quartile.
rfm['r_quartile'] = pd.qcut(rfm['recency'], 4, ['1','2','3','4'])
rfm['f_quartile'] = pd.qcut(rfm['frequency'], 4, ['4','3','2','1'])
rfm['m_quartile'] = pd.qcut(rfm['monetary'], 4, ['4','3','2','1'])
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | |
|---|---|---|---|---|---|---|
| CustomerID | ||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 |
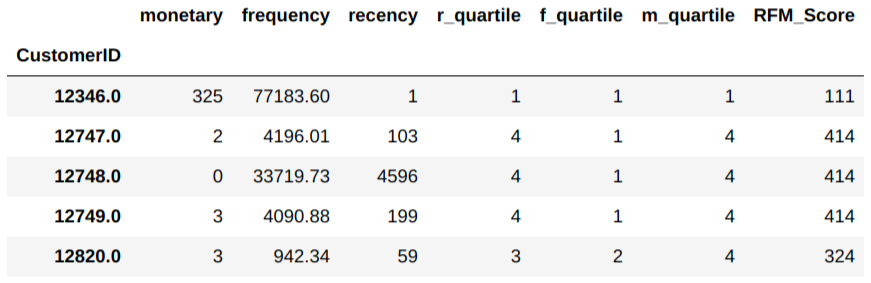
Combinez les trois quartiles (r_quartile, f_quartile, m_quartile) dans une seule colonne : ce score facilite la segmentation des clients en groupes pertinents.
rfm['RFM_Score'] = rfm.r_quartile.astype(str)+ rfm.f_quartile.astype(str) + rfm.m_quartile.astype(str)
rfm.head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 12346.0 | 325 | 77183.60 | 1 | 1 | 1 | 1 | 111 |
| 12747.0 | 2 | 4196.01 | 103 | 4 | 1 | 4 | 414 |
| 12748.0 | 0 | 33719.73 | 4596 | 4 | 1 | 4 | 414 |
| 12749.0 | 3 | 4090.88 | 199 | 4 | 1 | 4 | 414 |
| 12820.0 | 3 | 942.34 | 59 | 3 | 2 | 4 | 324 |
# Filter out Top/Best cusotmers
rfm[rfm['RFM_Score']=='111'].sort_values('monetary', ascending=False).head()
| monetary | frequency | recency | r_quartile | f_quartile | m_quartile | RFM_Score | |
|---|---|---|---|---|---|---|---|
| CustomerID | |||||||
| 16754.0 | 372 | 2002.4 | 2 | 1 | 1 | 1 | 111 |
| 12346.0 | 325 | 77183.6 | 1 | 1 | 1 | 1 | 111 |
| 15749.0 | 235 | 44534.3 | 10 | 1 | 1 | 1 | 111 |
| 16698.0 | 226 | 1998.0 | 5 | 1 | 1 | 1 | 111 |
| 13135.0 | 196 | 3096.0 | 1 | 1 | 1 | 1 | 111 |
Félicitations, vous êtes arrivé au bout de ce tutoriel !
Vous avez vu en détail la segmentation client : définition, enjeux, types de segmentation, analyse RFM et implémentation from scratch en Python. Vous avez aussi revu des notions pandas essentielles : gestion des doublons, groupby et qcut() pour créer des classes selon les quantiles.
Vous pouvez désormais appliquer ces techniques pour analyser vos propres jeux de données. Merci de votre lecture !
Pour aller plus loin en Python, suivez le cours gratuit de DataCamp : Intro to Python for Data Science.
En savoir plus sur Python
Cours
Cours
Cours