
Last chance! 50% off DataCamp Premium
Sale ends in
Agar dapat sepenuhnya memahami isi artikel tentang Falcon 40B ini, pembaca sebaiknya memiliki pemahaman dasar tentang konsep machine learning dan pemrosesan bahasa alami. Keakraban dengan model transformer dan komponennya, seperti mekanisme attention dan positional embedding, akan sangat berguna.
Jika Anda baru mengenal AI dan ingin mempelajari dasar-dasarnya, ikuti jalur keterampilan AI Fundamentals kami. Anda akan mempelajari ChatGPT, Machine Learning, LLM, Generative AI, dan etika AI.
Falcon 40B adalah bagian dari keluarga model bahasa besar (LLM) Falcon yang dikembangkan oleh Technology Innovation Institute (TII), yang juga mencakup Falcon 7B dan Falcon 180B. Sebagai model causal decoder-only, Falcon 40B dirancang untuk berbagai tugas generasi bahasa alami.
Kemampuan multibahasa Falcon 40B mencakup bahasa Inggris, Jerman, Spanyol, dan Prancis, dengan kemahiran terbatas dalam beberapa bahasa lain, termasuk Italia, Portugis, Polandia, Belanda, Rumania, Ceko, dan Swedia.
Arsitektur Falcon 40B diadaptasi dari GPT-3 namun dengan modifikasi kunci untuk meningkatkan performa. Model ini menggunakan rotary positional embedding untuk pemahaman urutan yang lebih baik. Mekanisme attention diperkaya dengan multi-query attention dan FlashAttention. Blok decoder menghadirkan attention paralel dan struktur Multi-Layer Perceptron (MLP) dengan skema normalisasi dua lapis, menyeimbangkan efisiensi komputasi.
Falcon 40B dilatih pada 1 triliun token dari RefinedWeb, suatu korpus internet yang disaring untuk kualitas, serta dataset kurasi tambahan. Alih-alih menghimpun sumber kurasi yang tersebar, TII meningkatkan kualitas data web dengan melakukan deduplikasi skala besar dan penyaringan ketat, sehingga menghasilkan dataset pelatihan berkualitas tinggi yang berkontribusi pada performa tinggi model Falcon.
Falcon 40B dilatih pada AWS SageMaker dengan 384 GPU A100 40GB, menggunakan strategi paralelisme 3D (TP=8, PP=4, DP=12) bersama ZeRO. Pelatihan dimulai pada Desember 2022 dan memakan waktu dua bulan untuk selesai.
Pelajari cara melatih model bahasa besar menggunakan PyTorch, dari penyiapan awal hingga implementasi akhir, dengan mengikuti tutorial How to Train a Large Language Model with PyTorch.
Berbeda dari skema multihead attention tradisional, Falcon 40B menggunakan Multi-Query Attention di mana satu key dan value dibagi oleh semua head attention. Mekanisme attention inovatif ini tidak berdampak signifikan pada pra-pelatihan namun secara drastis meningkatkan skalabilitas inferensi.
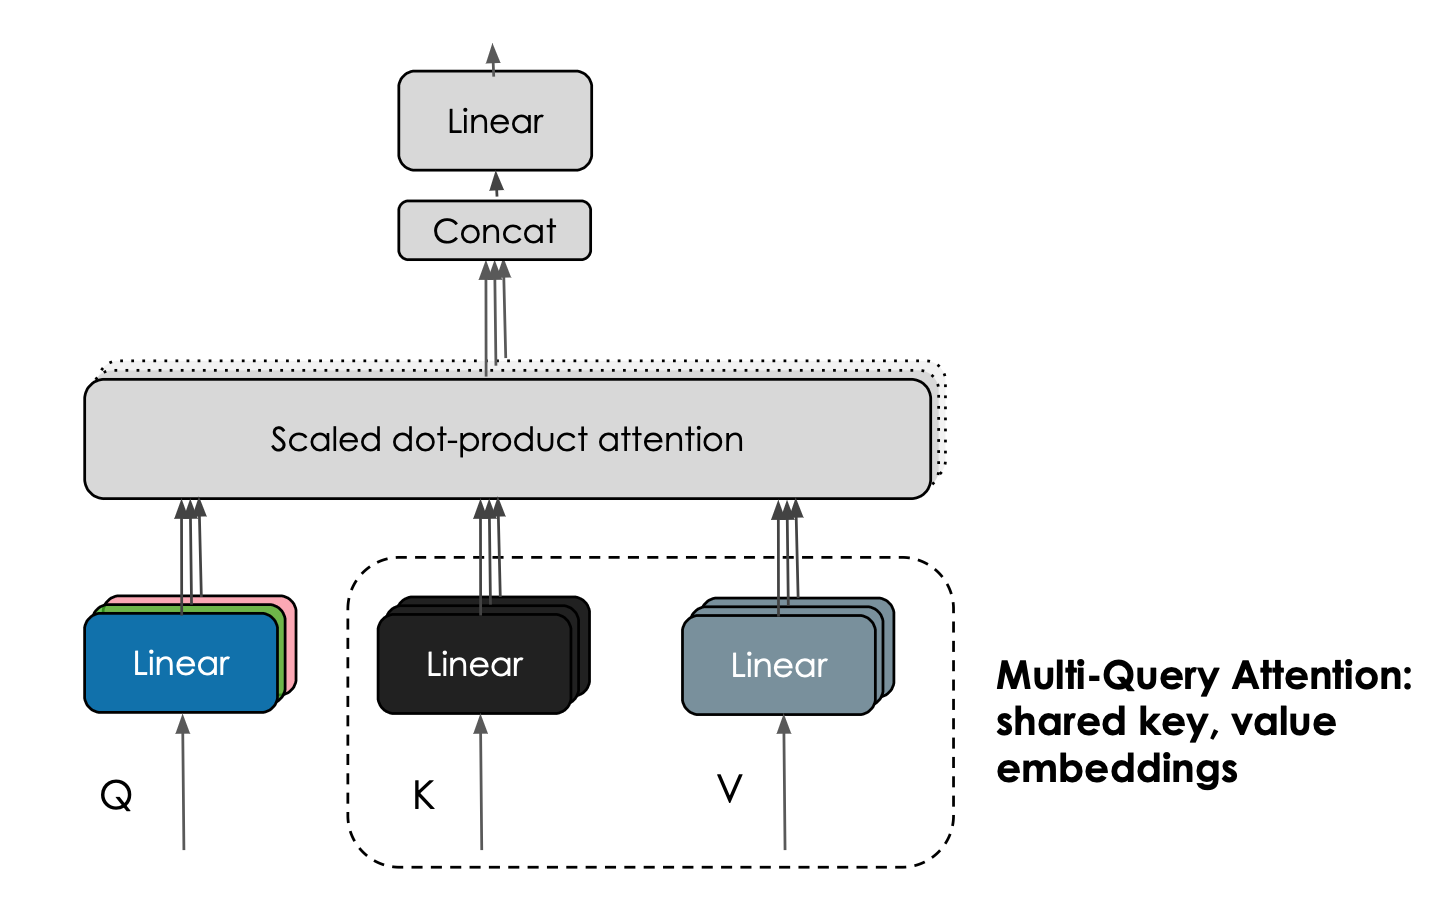
Gambar dari blog Falcon
TII juga memperkenalkan versi instruct dari model, yaitu Falcon-7B-Instruct dan Falcon 40B-Instruct, yang di-fine-tune pada instruksi dan data percakapan untuk kinerja lebih baik pada tugas bergaya asisten.
Meskipun Falcon 40B memerlukan memori GPU yang besar, Anda selalu dapat menggunakan kuantisasi agar model ini dapat diakses pada GPU yang lebih murah atau bahkan menjalankan versi yang lebih kecil, Falcon-7B, di Google Colab.
Falcon 40B melampaui model open-source lain seperti LLaMA, StableLM, RedPajama, dan MPT, sebagaimana terlihat pada OpenLLM Leaderboard. Performa unggulnya menjadikannya pilihan terdepan di antara model open-source yang tersedia.
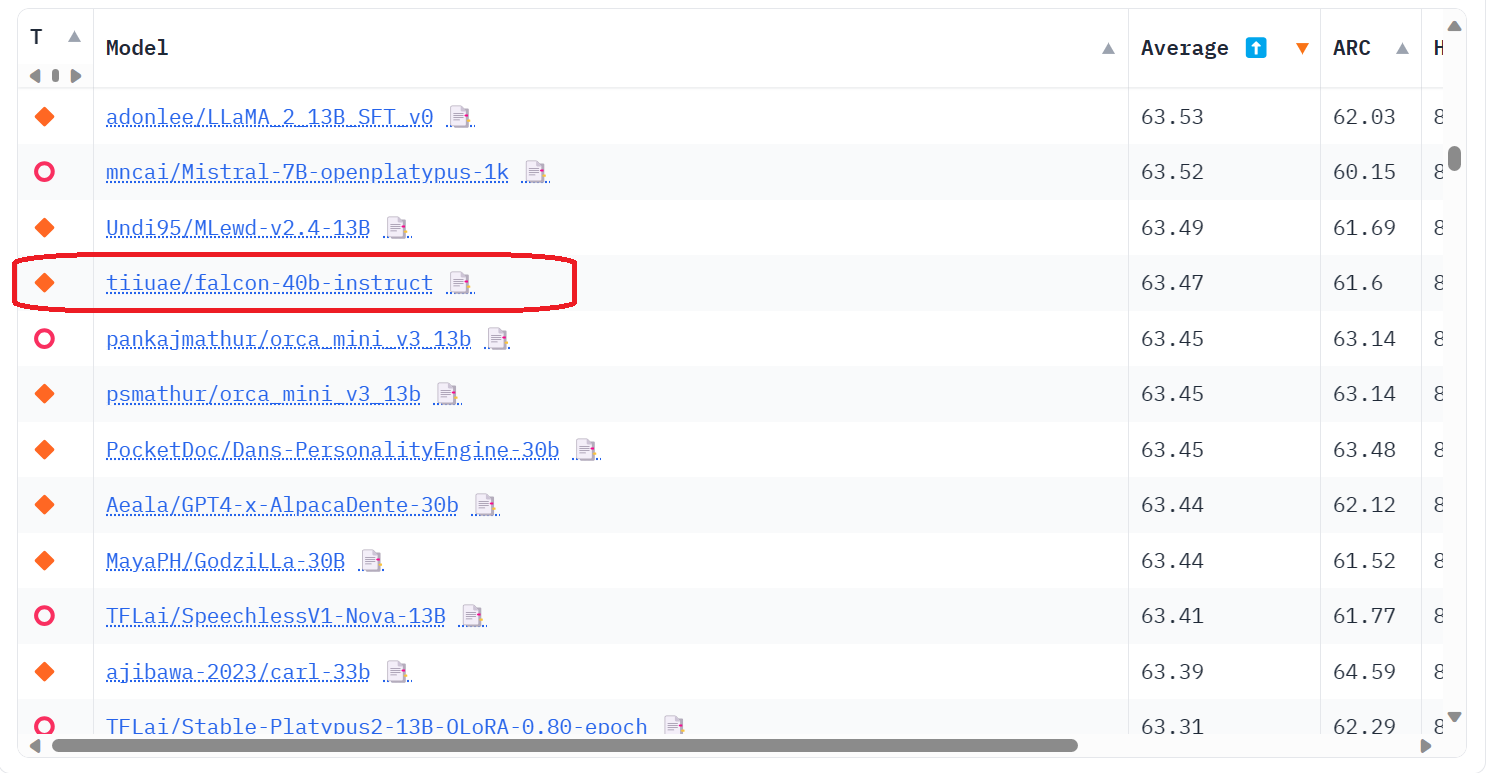
Gambar dari Open LLM Leaderboard
Arsitektur Falcon 40B dioptimalkan untuk inferensi yang efisien menggunakan fitur seperti FlashAttention dan multi-query attention, menghasilkan kecepatan inferensi yang lebih tinggi dan skalabilitas yang lebih baik. Ini adalah model bahasa pra-pelatihan mentah yang memerlukan fine-tuning lebih lanjut untuk sebagian besar kasus penggunaan.
Falcon 40B hadir dengan lisensi Apache 2.0, yang memungkinkan Anda menggunakan model dan dataset untuk keperluan komersial tanpa kewajiban royalti atau pembatasan.
Pada bagian ini, kita akan membahas proses memuat model Falcon 40B dan menjalankan inferensi. Selain itu, kita akan melihat cara menjalankan inferensi untuk versi lebih kecil Falcon 7B di Google Colab menggunakan Kuantisasi 4-bit. Terakhir, kita akan mempelajari penggunaan QLoRA dan SFT Trainer untuk melakukan fine-tuning model pada dataset baru.
Menjalankan model Falcon 40B dengan 40 miliar parameter menimbulkan tantangan memori. Model ini melampaui kapasitas memori satu GPU NVIDIA A100 dengan RAM 80 GB, bahkan saat menggunakan mode presisi rendah 8-bit, yang memerlukan sekitar 45 GB RAM.
Dengan menggunakan pemuatan presisi 4-bit menggunakan versi terbaru pustaka bitsandbytes, transformers, dan accelerate, jejak memori dapat dikurangi hingga sekitar 27 GB RAM. Ini memungkinkan Falcon-40B dimuat ke GPU A100 40 GB.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Memuat Falcon 40B dan menjalankan inferensi dengan kuantisasi 4-bit tidak memungkinkan pada GPU konsumen. Oleh karena itu, kita akan menggunakan versi yang lebih kecil, yaitu model Falcon 7B, yang dapat dengan mudah dijalankan pada Google Colab versi gratis.
Kita akan memasang semua pustaka Python yang diperlukan.
%pip install transformers bitsandbytes accelerate -qLalu memuat modul yang diperlukan untuk memuat model dan menjalankan inferensi.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Kita menggunakan BitsAndBytes untuk membuat kuantisasi 4-bit dengan konfigurasi tipe NF4. Ini mengurangi jejak memori, memungkinkan kita memuat model pada GPU Colab. Baca tentang kuantisasi 4-bit dan QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Kita akan memuat model dan tokenizer Falcon 7B serta membuat pipeline generasi teks menggunakan pustaka Transformers untuk menjalankan inferensi.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Dengan memberikan prompt ke pipeline, kita dapat menghasilkan respons.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Hasil kita mengesankan. Anda dapat bereksperimen dengan berbagai parameter di pipeline untuk lebih meningkatkan respons model.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Jika Anda mengalami kesulitan menjalankan Falcon 7B di Colab, Anda dapat menggunakan Colab Notebook sebagai panduan.
Dengan menggunakan pustaka TRL bersama QLoRA, kita dapat melakukan fine-tuning pada model. Kode berikut adalah bagian dari proses fine-tuning dan memungkinkan menjalankan SFTTrainer tanpa PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Anda dapat melihat notebook Falcon-Guanaco.ipynb untuk kode fine-tuning Falcon-7B pada dataset Guanaco. Untuk melatih model pada dataset Guanaco — subset berkualitas tinggi dari dataset Open Assistant yang berisi sekitar 10.000 dialog — kita dapat menggunakan pustaka PEFT bersama pendekatan QLoRA terbaru untuk melakukan fine-tuning adapter yang ditempatkan di atas model 4-bit yang dibekukan.
Saat menggunakan Low Rank Adapters (LoRA), hanya sebagian kecil dari model yang dapat dilatih, sehingga secara signifikan mengurangi jumlah parameter yang dipelajari dan ukuran artefak hasil pelatihan. Hal ini memungkinkan fine-tuning model yang lebih cepat sembari menghemat sumber daya memori.
Anda juga bisa melewatkan bagian fine-tuning dan menggunakan Retrieval Augmented Generation (RAG) untuk mempersonalisasi respons dengan memberikan akses ke dokumen pribadi Anda. Anda dapat melakukannya dengan mengikuti tutorial LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications.
Anda juga dapat Membangun Aplikasi LLM dengan LangChain menggunakan model yang baru saja Anda fine-tune, mirip seperti LlamaIndex.
Falcon-180B dilatih pada 3.500B token dari dataset RefinedWeb. Ini adalah model causal decoder-only dengan 180 miliar parameter yang dilisensikan di bawah Falcon-180B TII dan melampaui LLaMA-2, StableLM, RedPajama, MPT, serta model papan atas lainnya pada OpenLLM Leaderboard.
Kekurangan model Falcon 180B adalah bahwa menjalankan inferensi memerlukan setidaknya 400 GB memori. Singkatnya, Anda memerlukan sekitar 8xA100 80GB.
Aspek positif dari rilis ini adalah TII juga meluncurkan Falcon-180B-Chat, yang telah di-fine-tune pada gabungan dataset Ultrachat, Platypus, dan Airoboros. Model ini meraih popularitas besar di komunitas AI. Anda juga dapat mencoba demonya di Hugging Face Spaces dan merasakan kualitas responsnya.
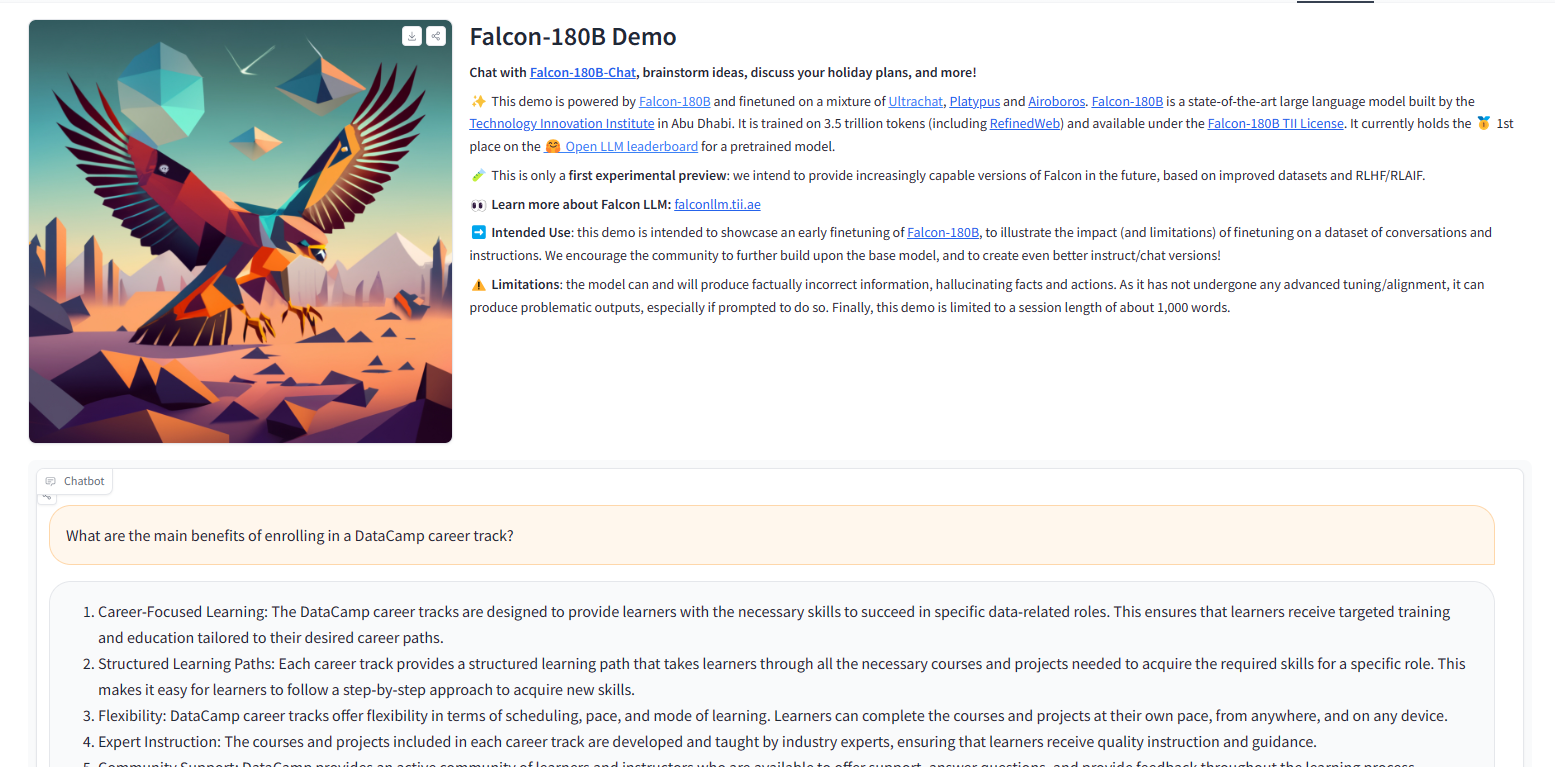
Gambar dari Demo Falcon-180B
Falcon 40B dari TII menunjukkan performa mengesankan sebagai model bahasa generatif open-source. Dengan 40 miliar parameter dan dilatih pada data web tersaring berkualitas tinggi, model ini mencapai hasil state-of-the-art pada OpenLLM Leaderboard.
Walau model Falcon 40B lengkap memerlukan sumber daya komputasi yang besar, versi 7B yang lebih kecil dapat dijalankan pada GPU Colab gratis menggunakan kuantisasi 4-bit. Fine-tuning dimungkinkan melalui QLoRA, PEFT, dan SFT Trainer. Versi Falcon 180B yang baru mendorong performa lebih jauh lagi, namun memerlukan 400 GB hanya untuk menjalankan inferensi.
Jika Anda tertarik berkarier di bidang machine learning dan ingin membangun model bahasa besar Anda sendiri, pertimbangkan untuk mengikuti jalur karier Machine Learning Scientist with Python.
Mulai Perjalanan Machine Learning Anda Hari Ini!
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt





