
Lộ trình
Chuyên gia Khoa học Học máy trong Python
85 giờ
Để nắm bắt trọn vẹn nội dung bài viết về Falcon 40B, bạn nên có hiểu biết nền tảng về học máy và các khái niệm xử lý ngôn ngữ tự nhiên. Việc quen thuộc với các mô hình transformer và các thành phần của chúng như cơ chế attention và positional embeddings sẽ rất hữu ích.
Nếu bạn mới bắt đầu với AI và muốn học các kiến thức căn bản, hãy tham gia lộ trình kỹ năng AI Fundamentals. Bạn sẽ hiểu về ChatGPT, Machine Learning, LLMs, Generative AI và đạo đức AI.
Falcon 40B là một phần của họ mô hình ngôn ngữ lớn (LLM) Falcon do Technology Innovation Institute (TII) phát triển, bao gồm cả Falcon 7B và Falcon 180B. Là một mô hình causal decoder-only, Falcon 40B được thiết kế cho nhiều tác vụ sinh ngôn ngữ tự nhiên.
Khả năng đa ngôn ngữ của Falcon 40B bao gồm tiếng Anh, Đức, Tây Ban Nha và Pháp, cùng mức độ thành thạo hạn chế ở một số ngôn ngữ khác như Ý, Bồ Đào Nha, Ba Lan, Hà Lan, Romania, Séc và Thụy Điển.
Kiến trúc của Falcon 40B được điều chỉnh từ GPT-3 với các sửa đổi quan trọng nhằm tăng hiệu năng. Mô hình sử dụng rotary positional embeddings để hiểu chuỗi tốt hơn. Cơ chế attention được tăng cường bằng multi-query attention và FlashAttention. Khối decoder có attention song song và cấu trúc Multi-Layer Perceptron (MLP) với sơ đồ chuẩn hóa hai lớp, cân bằng giữa hiệu quả tính toán và hiệu năng.
Falcon 40B được huấn luyện trên 1 nghìn tỷ token từ RefinedWeb, một tập hợp dữ liệu từ internet đã được lọc chất lượng, cùng các bộ dữ liệu tuyển chọn bổ sung. Thay vì thu thập các nguồn rải rác đã tuyển chọn, TII nâng chất lượng dữ liệu web bằng khử trùng lặp quy mô lớn và lọc nghiêm ngặt, tạo nên bộ dữ liệu huấn luyện chất lượng cao đóng góp vào hiệu năng nổi trội của các mô hình Falcon.
Falcon 40B được huấn luyện trên AWS SageMaker với 384 GPU A100 40GB, sử dụng chiến lược song song 3D (TP=8, PP=4, DP=12) kết hợp với ZeRO. Quá trình huấn luyện bắt đầu vào tháng 12 năm 2022 và kéo dài hai tháng.
Học cách huấn luyện các mô hình ngôn ngữ lớn bằng PyTorch, từ thiết lập ban đầu đến triển khai, qua hướng dẫn How to Train a Large Language Model with PyTorch.
Không giống sơ đồ multihead attention truyền thống, Falcon 40B dùng Multi-Query Attention, trong đó một cặp key và value được chia sẻ cho mọi head attention. Cơ chế attention đổi mới này không ảnh hưởng đáng kể đến giai đoạn tiền huấn luyện nhưng cải thiện đáng kể khả năng mở rộng khi suy luận.
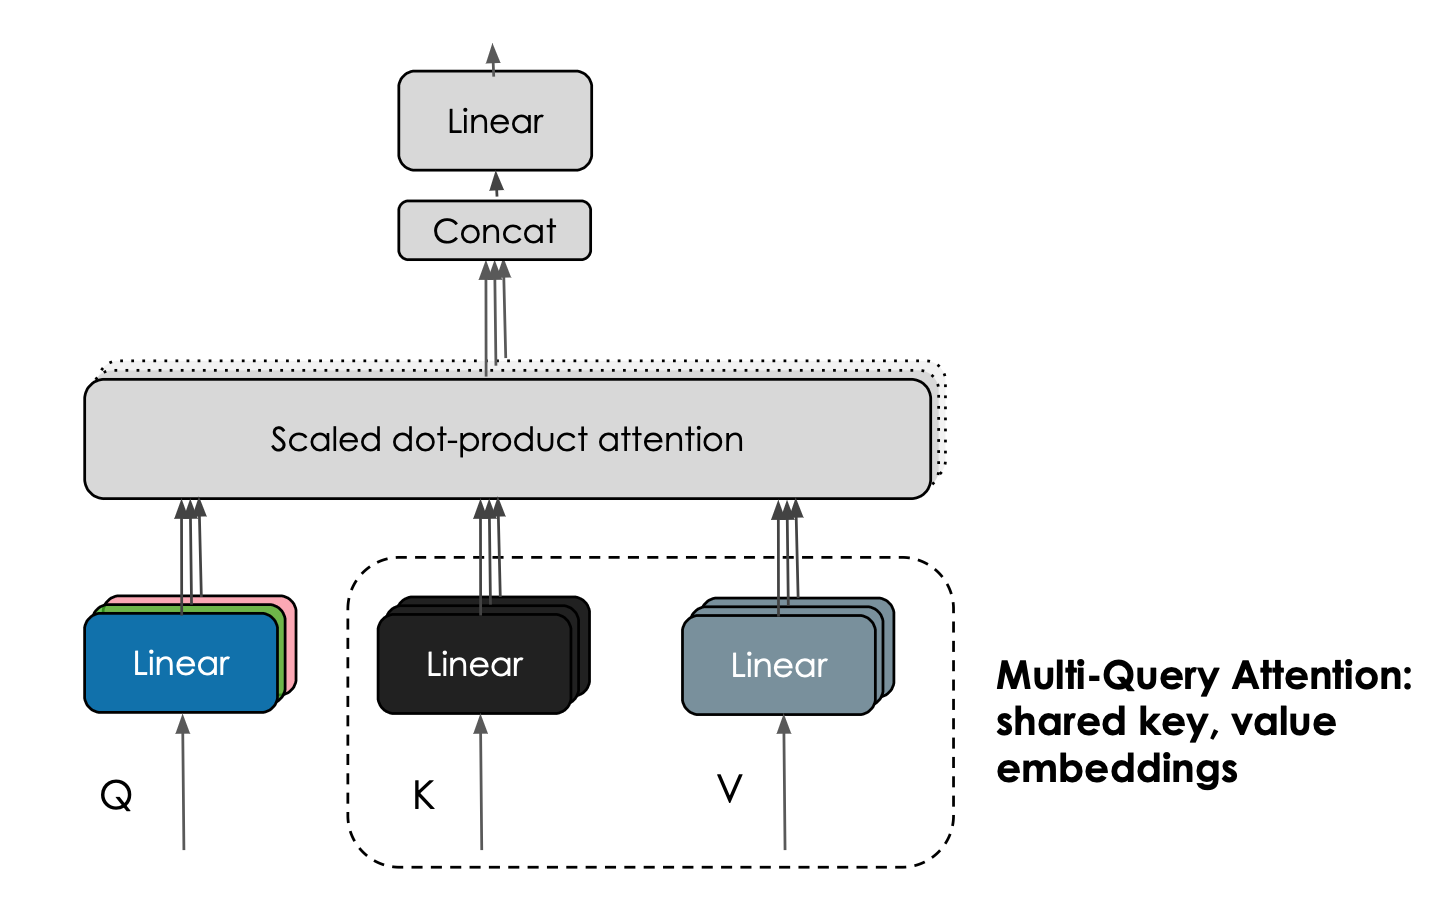
Hình ảnh từ blog Falcon
TII cũng đã giới thiệu các phiên bản instruct của mô hình, Falcon-7B-Instruct và Falcon 40B-Instruct, được tinh chỉnh trên dữ liệu hướng dẫn và hội thoại để cải thiện hiệu năng cho các tác vụ dạng trợ lý.
Dù Falcon 40B cần bộ nhớ GPU lớn, bạn có thể dùng lượng tử hóa để chạy mô hình này trên GPU rẻ hơn hoặc chạy phiên bản nhỏ hơn là Falcon-7B trên Google Colab.
Falcon 40B vượt trội so với các mô hình mã nguồn mở khác như LLaMA, StableLM, RedPajama và MPT, thể hiện trên OpenLLM Leaderboard. Hiệu năng vượt trội khiến nó trở thành lựa chọn hàng đầu trong số các mô hình mã nguồn mở hiện có.
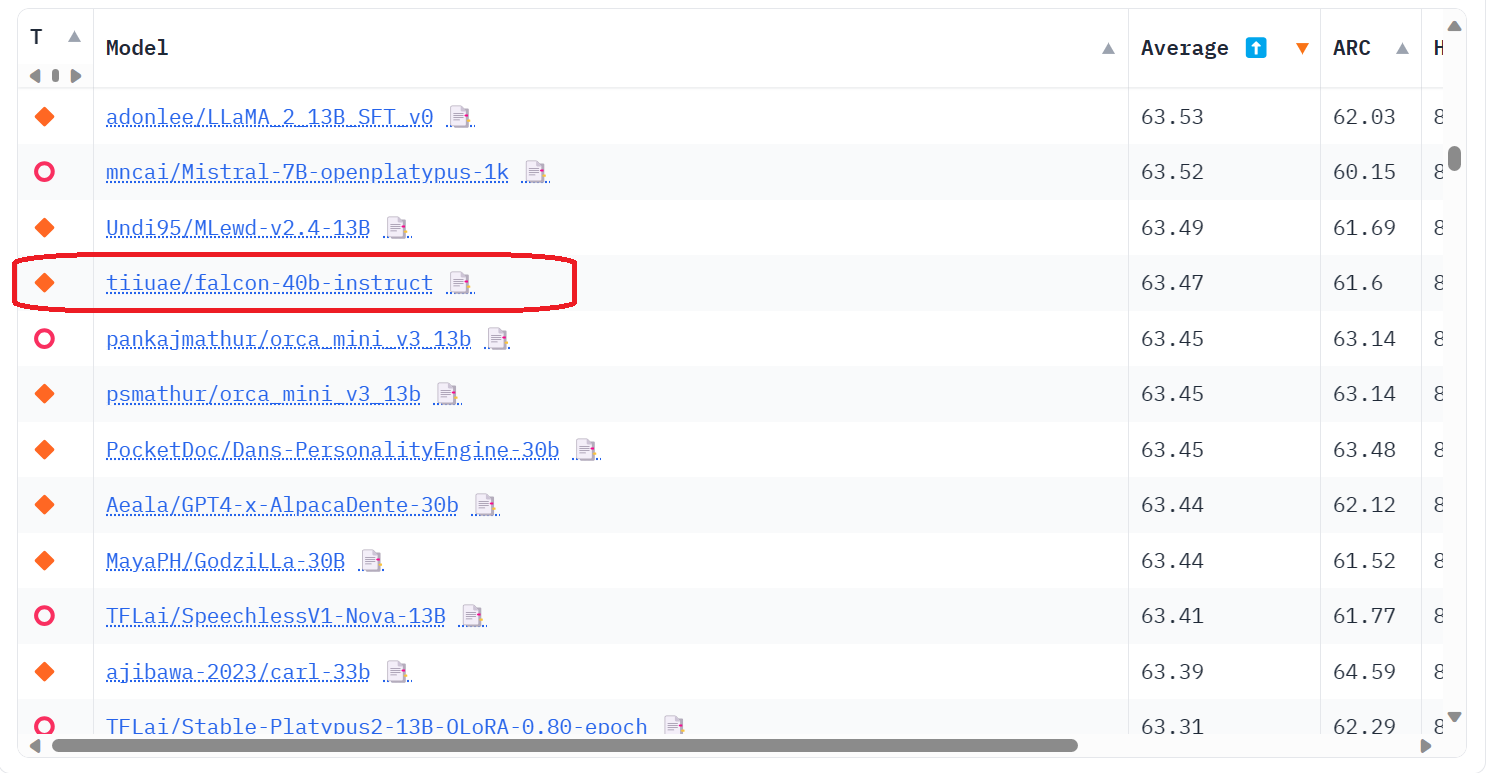
Hình ảnh từ Open LLM Leaderboard
Kiến trúc Falcon 40B được tối ưu cho suy luận hiệu quả nhờ các tính năng như FlashAttention và multi-query attention, giúp tăng tốc độ và khả năng mở rộng khi suy luận. Đây là một mô hình ngôn ngữ tiền huấn luyện thô, cần được tinh chỉnh thêm để phù hợp với hầu hết các trường hợp sử dụng.
Falcon 40B có giấy phép Apache 2.0, cho phép bạn dùng mô hình và bộ dữ liệu cho mục đích thương mại mà không chịu nghĩa vụ trả phí hay hạn chế.
Phần này sẽ hướng dẫn quy trình nạp mô hình Falcon 40B và chạy suy luận. Bên cạnh đó, chúng ta sẽ xem cách chạy suy luận cho phiên bản nhỏ hơn là Falcon 7B trên Google Colab với lượng tử hóa 4-bit. Cuối cùng, chúng ta sẽ học cách dùng QLoRA và SFT Trainer để tinh chỉnh mô hình trên một bộ dữ liệu mới.
Chạy mô hình Falcon 40B với 40 tỷ tham số đặt ra các thách thức về bộ nhớ. Mô hình vượt quá dung lượng của một GPU NVIDIA A100 80 GB đơn lẻ, ngay cả khi dùng chế độ độ chính xác giảm 8-bit, vốn cần khoảng 45 GB RAM.
Bằng cách nạp với độ chính xác 4-bit bằng các phiên bản mới nhất của thư viện bitsandbytes, transformers và accelerate, mức sử dụng bộ nhớ có thể giảm xuống khoảng 27 GB RAM. Điều này cho phép nạp Falcon-40B vào các GPU A100 40 GB.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Nạp Falcon 40B và chạy suy luận với lượng tử hóa 4-bit là không khả thi trên GPU phổ thông. Vì vậy, chúng ta sẽ dùng phiên bản nhỏ hơn là Falcon 7B, có thể chạy dễ dàng trên bản miễn phí của Google Colab.
Chúng ta sẽ cài đặt tất cả các thư viện Python cần thiết.
%pip install transformers bitsandbytes accelerate -qSau đó nạp các mô-đun cần thiết để nạp mô hình và chạy suy luận.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Chúng ta dùng BitsAndBytes để tạo lượng tử hóa 4-bit với cấu hình kiểu NF4. Cách này giảm sử dụng bộ nhớ, cho phép nạp mô hình vào GPU của Colab. Đọc thêm về lượng tử hóa 4-bit và QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Chúng ta sẽ nạp mô hình và tokenizer Falcon 7B, rồi tạo một pipeline sinh văn bản bằng thư viện Transformers để chạy suy luận.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Bằng cách cung cấp prompt cho pipeline, chúng ta có thể tạo phản hồi.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Kết quả của chúng ta rất ấn tượng. Bạn có thể thử nghiệm các tham số khác nhau trong pipeline để tiếp tục cải thiện phản hồi của mô hình.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Nếu bạn gặp khó khăn khi chạy Falcon 7B trên Colab, bạn có thể dùng Colab Notebook làm hướng dẫn.
Sử dụng thư viện TRL với QLoRA, chúng ta có thể tinh chỉnh mô hình. Đoạn mã sau là một phần của quy trình tinh chỉnh và cho phép chạy SFTTrainer mà không cần PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Bạn có thể xem notebook Falcon-Guanaco.ipynb để tham khảo mã tinh chỉnh Falcon-7B trên bộ dữ liệu Guanaco. Để huấn luyện mô hình trên bộ dữ liệu Guanaco — một tập con chất lượng cao của bộ dữ liệu Open Assistant chứa khoảng 10.000 đoạn hội thoại — chúng ta có thể dùng thư viện PEFT cùng phương pháp QLoRA gần đây để tinh chỉnh các adapter được đặt trên mô hình 4-bit đóng băng.
Khi dùng Low Rank Adapters (LoRA), chỉ một phần rất nhỏ của mô hình là có thể huấn luyện, giúp giảm đáng kể số tham số cần học và kích thước artifact đã huấn luyện. Điều này cho phép tinh chỉnh nhanh hơn đồng thời tiết kiệm bộ nhớ.
Bạn cũng có thể bỏ qua phần tinh chỉnh và dùng Retrieval Augmented Generation (RAG) để cá nhân hóa phản hồi bằng cách cấp quyền truy cập vào tài liệu riêng. Bạn có thể thực hiện theo hướng dẫn LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications.
Bạn cũng có thể xây dựng ứng dụng LLM với LangChain bằng mô hình vừa tinh chỉnh tương tự như LlamaIndex.
Falcon-180B được huấn luyện trên 3.500 tỷ token từ bộ dữ liệu RefinedWeb. Đây là mô hình causal decoder-only với 180 tỷ tham số, được cấp phép theo Falcon-180B TII, vượt trội so với LLaMA-2, StableLM, RedPajama, MPT và các mô hình hàng đầu khác trên OpenLLM Leaderboard.
Điểm hạn chế của Falcon 180B là chạy suy luận cần ít nhất 400GB bộ nhớ. Nói ngắn gọn, bạn cần khoảng 8xA100 80GB.
Điểm tích cực là TII cũng ra mắt Falcon-180B-Chat, đã được tinh chỉnh trên tổ hợp các bộ dữ liệu Ultrachat, Platypus và Airoboros. Mô hình đã trở nên rất phổ biến trong cộng đồng AI. Bạn cũng có thể thử bản demo trên Hugging Face Spaces và trải nghiệm chất lượng phản hồi cao.
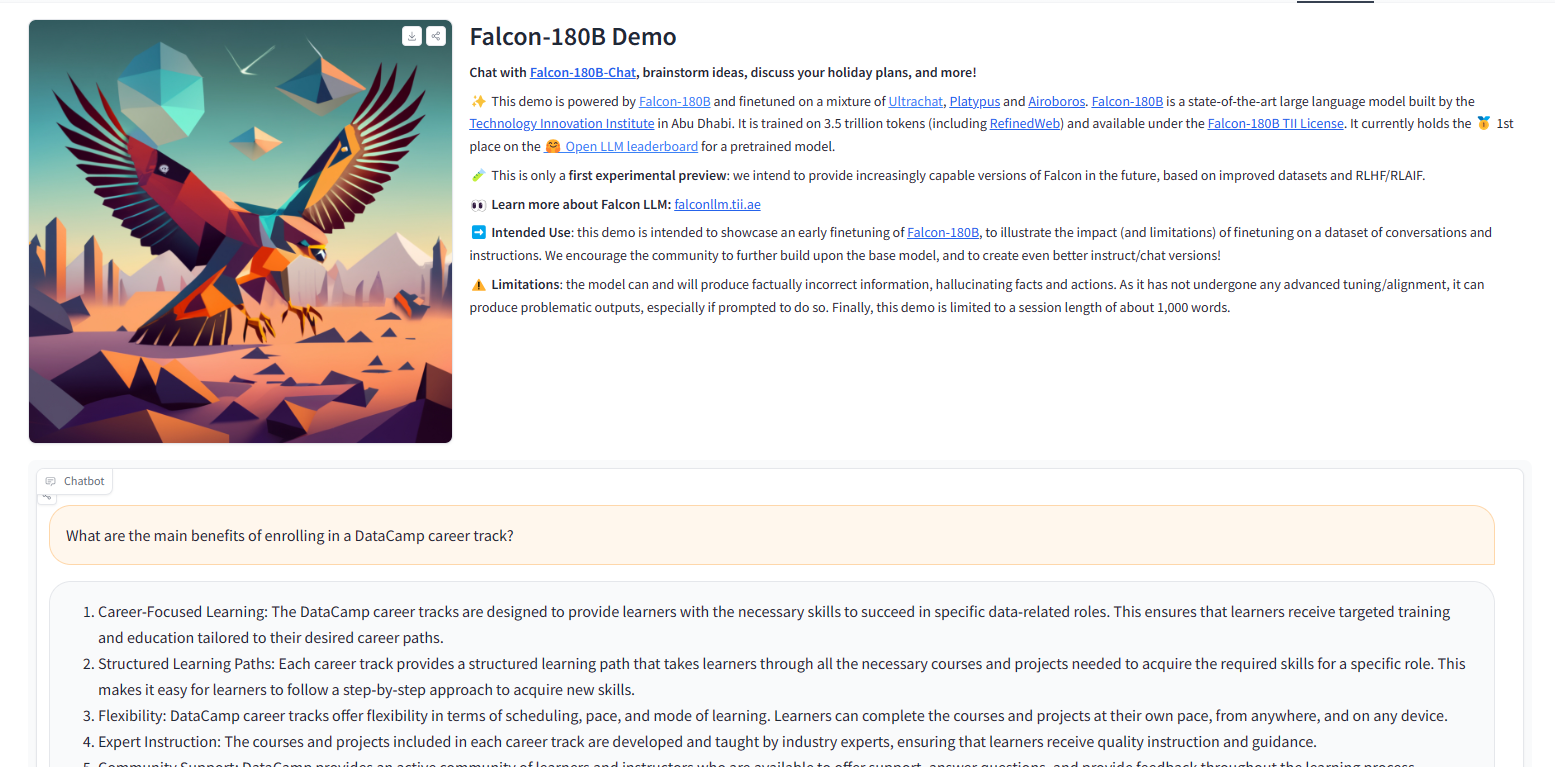
Hình ảnh từ Falcon-180B Demo
Falcon 40B từ TII thể hiện hiệu năng ấn tượng với tư cách là một mô hình ngôn ngữ sinh mã nguồn mở. Với 40 tỷ tham số và được huấn luyện trên dữ liệu web lọc chất lượng cao, mô hình đạt kết quả hàng đầu trên OpenLLM Leaderboard.
Trong khi phiên bản đầy đủ Falcon 40B đòi hỏi tài nguyên tính toán lớn, phiên bản 7B nhỏ hơn có thể chạy trên GPU Colab miễn phí với lượng tử hóa 4-bit. Tinh chỉnh khả thi qua QLoRA, PEFT và SFT Trainer. Phiên bản Falcon 180B mới còn đẩy hiệu năng đi xa hơn, nhưng cần 400GB chỉ để chạy suy luận.
Nếu bạn quan tâm theo đuổi sự nghiệp trong học máy và muốn tự xây dựng mô hình ngôn ngữ lớn, hãy cân nhắc lộ trình nghề nghiệp Machine Learning Scientist with Python.
Bắt đầu hành trình Machine Learning của bạn ngay hôm nay!
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
