
Last chance! 50% off DataCamp Premium
Sale ends in
Per apprezzare appieno i contenuti di questo articolo su Falcon 40B, è utile avere una conoscenza di base di machine learning e dei concetti di elaborazione del linguaggio naturale. È utile anche la familiarità con i modelli transformer e le loro componenti, come i meccanismi di attenzione e gli embedding posizionali.
Se sei alle prime armi con l'IA e vuoi imparare le basi, segui il percorso di competenze AI Fundamentals. Imparerai a conoscere ChatGPT, Machine Learning, LLM, Generative AI ed etica dell'IA.
Falcon 40B fa parte della famiglia Falcon di large language model (LLM) sviluppati dal Technology Innovation Institute (TII), che include anche Falcon 7B e Falcon 180B. In quanto modello causale solo-decoder, Falcon 40B è progettato per vari compiti di generazione del linguaggio naturale.
Le capacità multilingue di Falcon 40B comprendono inglese, tedesco, spagnolo e francese, con una competenza limitata in diverse altre lingue, tra cui italiano, portoghese, polacco, olandese, rumeno, ceco e svedese.
L'architettura di Falcon 40B è stata adattata da GPT-3 ma con modifiche chiave per migliorarne le prestazioni. Utilizza rotary positional embeddings per una migliore comprensione delle sequenze. I meccanismi di attenzione sono arricchiti con multi-query attention e FlashAttention. Il blocco decoder presenta strutture di attenzione parallela e MLP (Multi-Layer Perceptron) con uno schema di normalizzazione a due livelli, bilanciando efficienza computazionale e prestazioni.
Falcon 40B è stato addestrato su 1 trilione di token provenienti da RefinedWeb, un corpus internet filtrato per qualità, oltre a ulteriori dataset curati. Invece di raccogliere fonti curate sparse, TII ha migliorato la qualità dei dati web impiegando deduplicazione su larga scala e filtri rigorosi, ottenendo così un dataset di addestramento di alta qualità che contribuisce alle elevate prestazioni dei modelli Falcon.
Falcon 40B è stato addestrato su AWS SageMaker con 384 GPU A100 da 40 GB, utilizzando una strategia di parallelismo 3D (TP=8, PP=4, DP=12) insieme a ZeRO. L'addestramento è iniziato nel dicembre 2022 ed è durato due mesi.
Impara ad addestrare large language model con PyTorch, dalla configurazione iniziale all'implementazione finale, seguendo il tutorial How to Train a Large Language Model with PyTorch.
A differenza dello schema tradizionale di multihead attention, Falcon 40B impiega la Multi-Query Attention in cui una singola coppia chiave-valore è condivisa tra tutte le teste di attenzione. Questo meccanismo di attenzione innovativo non impatta in modo significativo il pretraining, ma migliora enormemente la scalabilità in inferenza.
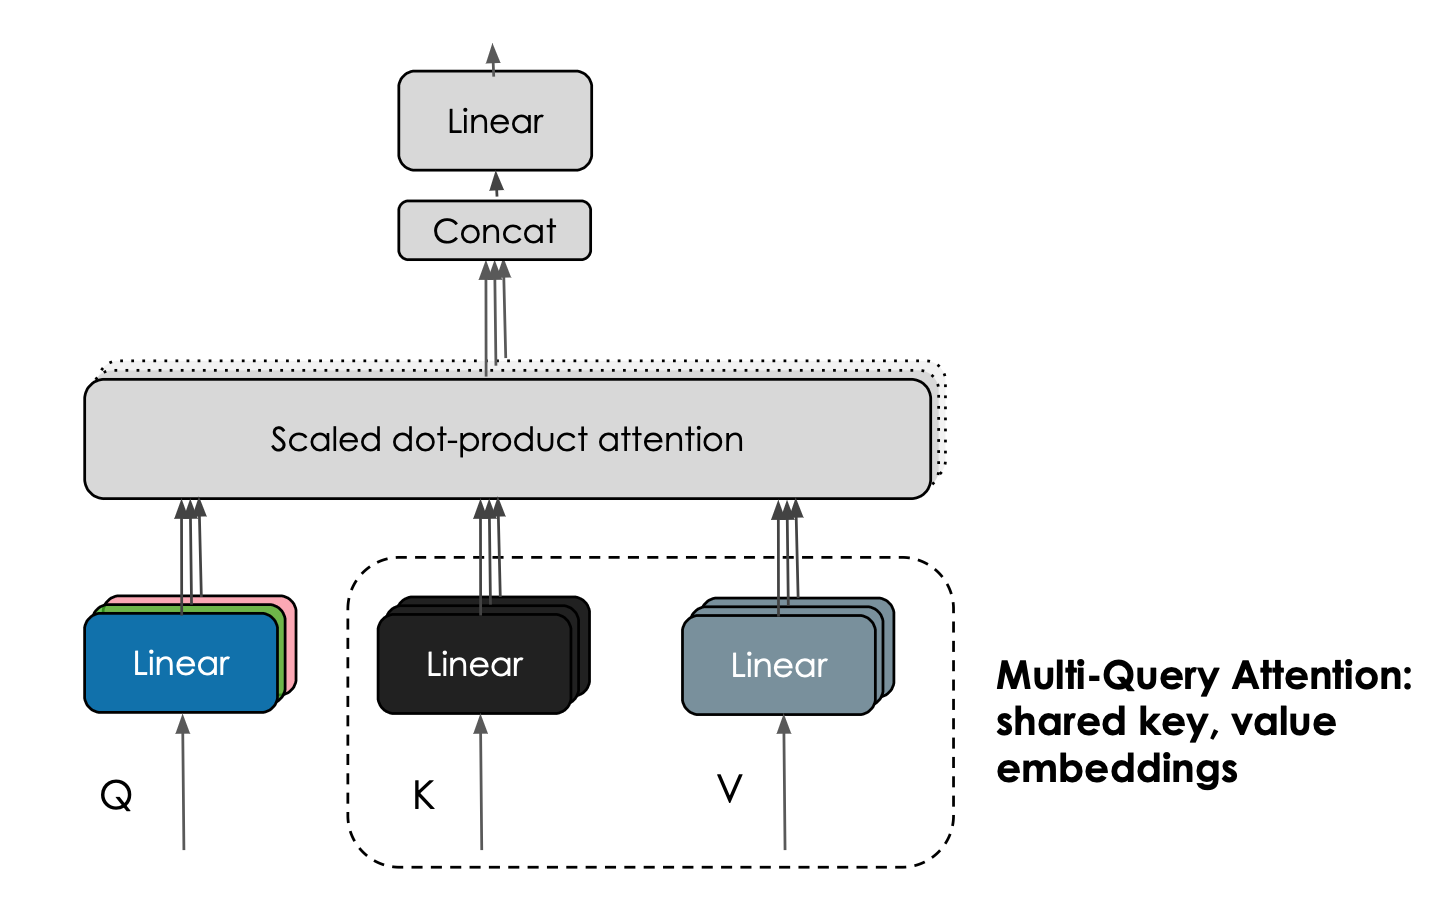
Immagine dal blog Falcon
TII ha introdotto anche versioni instruct dei modelli, Falcon-7B-Instruct e Falcon 40B-Instruct, ottimizzate su istruzioni e dati conversazionali per prestazioni migliori in compiti in stile assistente.
Sebbene Falcon 40B richieda una notevole memoria GPU, puoi sempre usare la quantizzazione per rendere il modello accessibile su GPU più economiche o persino eseguire una versione più piccola, Falcon-7B, su Google Colab.
Falcon 40B supera altri modelli open source come LLaMA, StableLM, RedPajama e MPT, come dimostrato nella OpenLLM Leaderboard. Le sue prestazioni superiori lo rendono una scelta di punta tra i modelli open source disponibili.
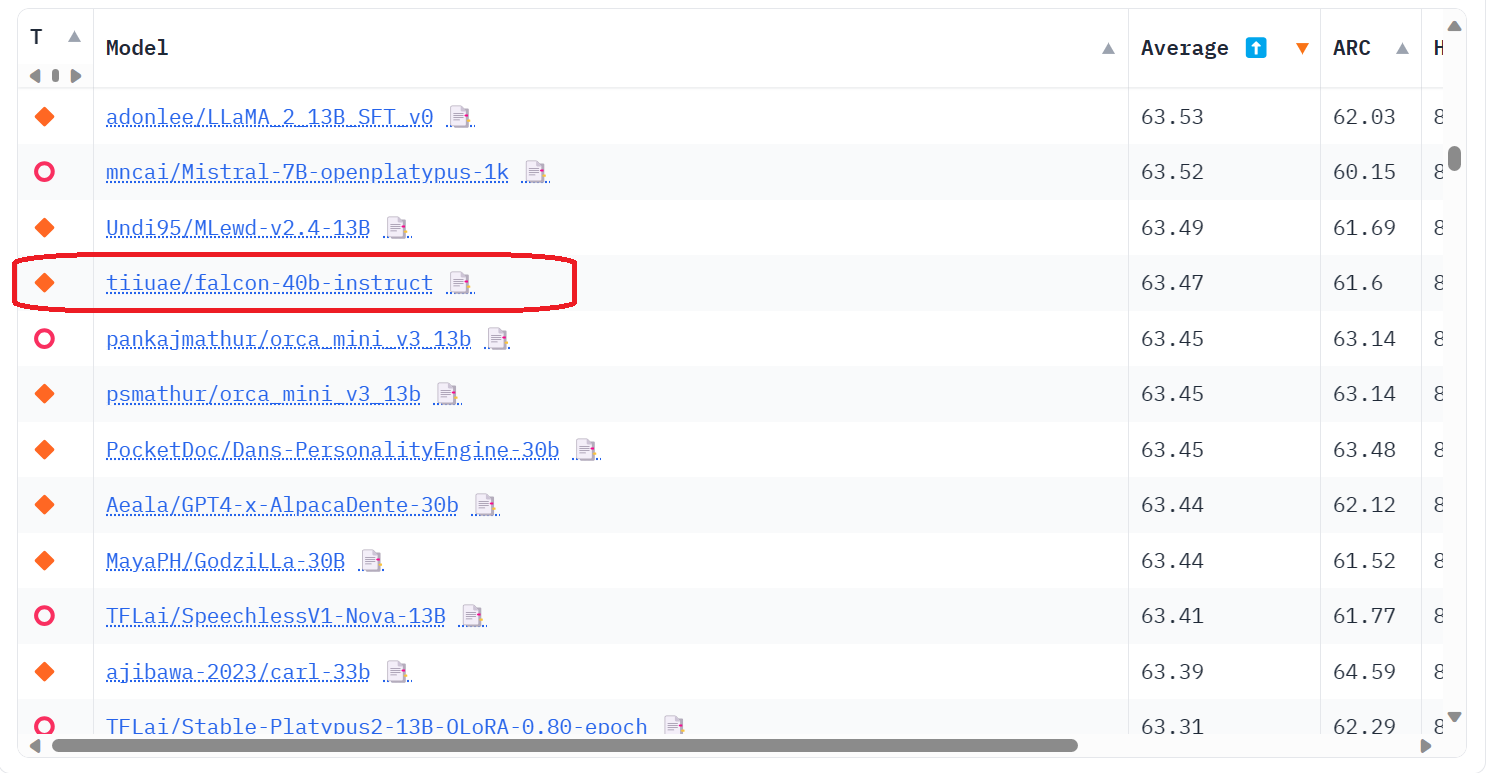
Immagine dalla Open LLM Leaderboard
L'architettura di Falcon 40B è ottimizzata per un'inferenza efficiente grazie a funzionalità come FlashAttention e multi-query attention, con conseguente maggiore velocità e scalabilità in inferenza. È un modello linguistico pre-addestrato grezzo che, nella maggior parte dei casi, richiede ulteriore fine-tuning prima dell'uso.
Falcon 40B è fornito con licenza Apache 2.0, che ti consente di usare il modello e il dataset per scopi commerciali senza obblighi di royalty o restrizioni.
In questa sezione vedremo come caricare il modello Falcon 40B ed eseguire l'inferenza. Inoltre, esploreremo come eseguire l'inferenza per la versione più piccola Falcon 7B su Google Colab usando la quantizzazione a 4 bit. Infine, impareremo a usare QLoRA e SFT Trainer per effettuare il fine-tuning del nostro modello su un nuovo dataset.
Eseguire il modello Falcon 40B da 40 miliardi di parametri pone sfide di memoria. Il modello supera la capacità di memoria di una singola GPU NVIDIA A100 con 80 GB di RAM, anche quando si usa la precisione ridotta in modalità a 8 bit, che richiede circa 45 GB di RAM.
Usando il caricamento a 4 bit con le versioni più recenti delle librerie bitsandbytes, transformers e accelerate, l'impronta di memoria può essere ridotta a circa 27 GB di RAM. Questo consente di caricare Falcon-40B su GPU A100 da 40 GB.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Caricare Falcon 40B ed eseguire l'inferenza con quantizzazione a 4 bit non è possibile su GPU consumer. Pertanto, useremo la versione più piccola del modello, Falcon 7B, che può essere eseguita facilmente sulla versione gratuita di Google Colab.
Installeremo tutte le librerie Python necessarie.
%pip install transformers bitsandbytes accelerate -qQuindi caricheremo i moduli necessari per caricare il modello ed eseguire l'inferenza.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Usiamo BitsAndBytes per creare una quantizzazione a 4 bit con configurazione di tipo NF4. Questo riduce l'impronta di memoria, consentendoci di caricare il modello sulla GPU di Colab. Leggi di più su quantizzazione a 4 bit e QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Caricheremo il modello e il tokenizer Falcon 7B e creeremo una pipeline di generazione del testo usando la libreria Transformers per eseguire l'inferenza.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Fornendo il prompt alla pipeline, possiamo generare la risposta.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Il nostro risultato è notevole. Puoi sperimentare con diversi parametri nella pipeline per migliorare ulteriormente la risposta del modello.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Se riscontri difficoltà a eseguire Falcon 7B su Colab, puoi usare il Colab Notebook come guida.
Usando la libreria TRL con QLoRA, possiamo effettuare il fine-tuning del modello. Il codice seguente fa parte del processo di fine-tuning e consente di eseguire l'SFTTrainer senza PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Puoi consultare il notebook Falcon-Guanaco.ipynb per il codice di fine-tuning di Falcon-7B sul dataset Guanaco. Per addestrare il modello sul dataset Guanaco - un sottoinsieme di alta qualità del dataset Open Assistant contenente circa 10.000 dialoghi - possiamo usare la libreria PEFT insieme al recente approccio QLoRA per ottimizzare degli adapter, posizionati sopra il modello congelato a 4 bit.
Quando si usano i Low Rank Adapters (LoRA), solo una piccola frazione del modello è addestrabile, con una riduzione significativa del numero di parametri appresi e della dimensione dell'artefatto addestrato. Questo consente un fine-tuning più rapido del modello, risparmiando risorse di memoria.
Puoi anche saltare la parte di fine-tuning e usare la Retrieval Augmented Generation (RAG) per personalizzare la risposta fornendo accesso ai tuoi documenti privati. Puoi farlo seguendo il tutorial LlamaIndex: un framework dati per applicazioni basate su Large Language Model (LLM).
Puoi anche sviluppare applicazioni LLM con LangChain usando il tuo modello appena ottimizzato, in modo simile a LlamaIndex.
Falcon-180B è stato addestrato su 3.500 miliardi di token del dataset RefinedWeb. È un modello causale solo-decoder da 180 miliardi di parametri con licenza Falcon-180B TII che supera LLaMA-2, StableLM, RedPajama, MPT e altri modelli di punta nella OpenLLM Leaderboard.
Lo svantaggio del modello Falcon 180B è che eseguire l'inferenza richiede almeno 400 GB di memoria. In breve, servono circa 8x A100 da 80 GB.
L'aspetto positivo di questo rilascio è che TII ha lanciato anche Falcon-180B-Chat, ottimizzato su una combinazione dei dataset Ultrachat, Platypus e Airoboros. Ha guadagnato grande popolarità nella community dell'IA. Puoi anche provare la demo su Hugging Face Spaces e testare la qualità delle risposte.
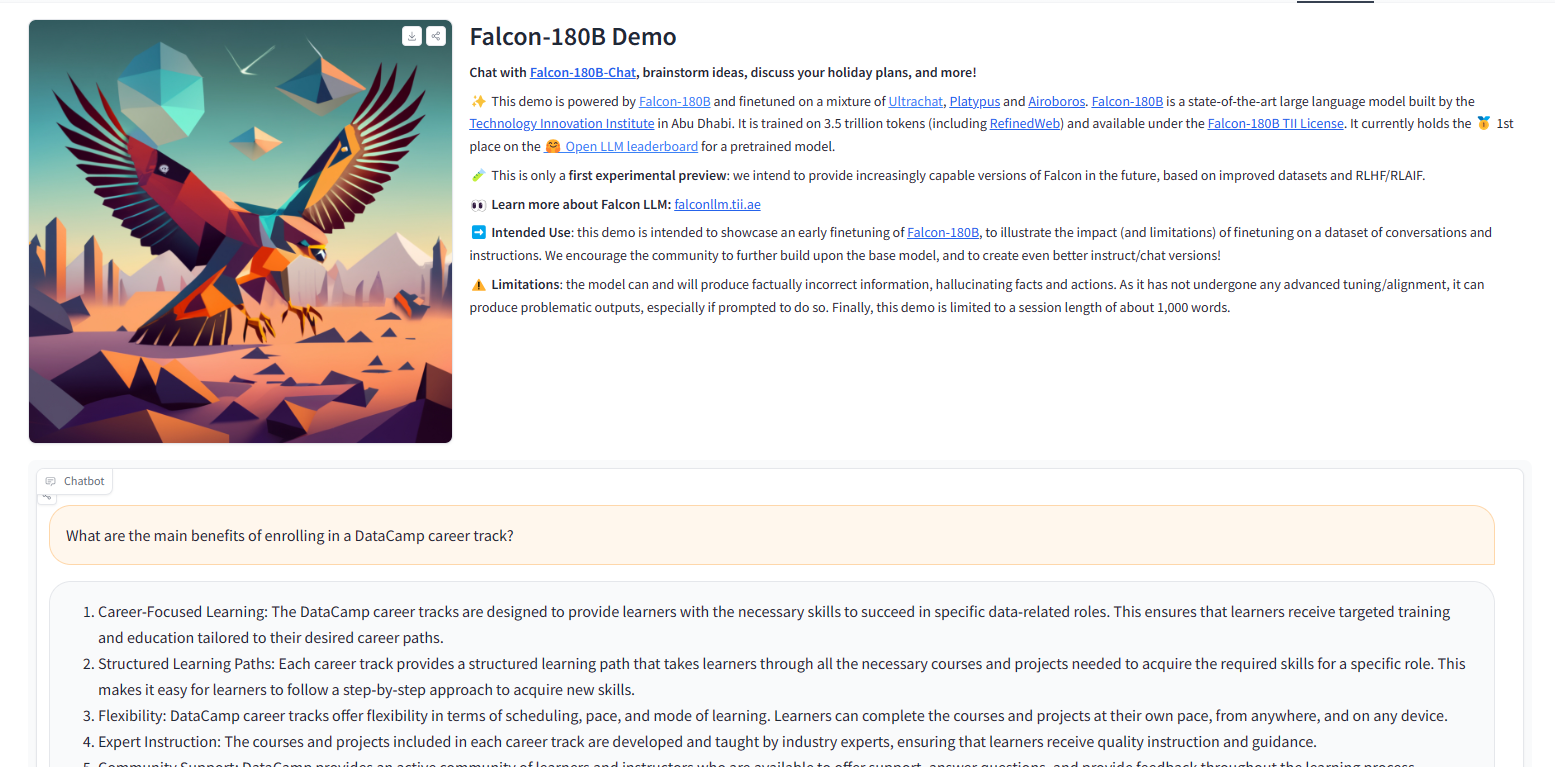
Immagine dalla demo Falcon-180B
Falcon 40B di TII mostra prestazioni notevoli come modello linguistico generativo open source. Con 40 miliardi di parametri e addestrato su dati web filtrati di alta qualità, raggiunge risultati all'avanguardia nella OpenLLM Leaderboard.
Sebbene il modello completo Falcon 40B richieda notevoli risorse di calcolo, la versione più piccola da 7B può essere eseguita su GPU Colab gratuite usando la quantizzazione a 4 bit. Il fine-tuning è possibile tramite QLoRA, PEFT e SFT Trainer. La nuova versione Falcon da 180B spinge le prestazioni ancora oltre, ma richiede 400 GB solo per eseguire l'inferenza.
Se ti interessa intraprendere una carriera nel machine learning e vuoi creare il tuo large language model, prendi in considerazione il percorso Machine Learning Scientist with Python.
Inizia oggi il tuo percorso nel Machine Learning!
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min




