Programa
Cientista de machine learning em Python
85 h
Para aproveitar ao máximo o conteúdo deste artigo sobre o Falcon 40B, é importante ter uma base em conceitos de machine learning e processamento de linguagem natural. Familiaridade com modelos do tipo transformer e seus componentes, como mecanismos de atenção e embeddings posicionais, é bem-vinda.
Se você está começando em IA e quer aprender os fundamentos, faça nossa trilha de habilidades AI Fundamentals. Você vai conhecer ChatGPT, machine learning, LLMs, IA generativa e ética em IA.
O Falcon 40B faz parte da família Falcon de modelos de linguagem de grande porte (LLMs) desenvolvidos pelo Technology Innovation Institute (TII), que também inclui o Falcon 7B e o Falcon 180B. Como um modelo causal apenas com decodificador, o Falcon 40B é projetado para diversas tarefas de geração de linguagem natural.
As capacidades multilíngues do Falcon 40B abrangem inglês, alemão, espanhol e francês, com proficiência limitada em outros idiomas, como italiano, português, polonês, holandês, romeno, tcheco e sueco.
A arquitetura do Falcon 40B é inspirada no GPT-3, mas com ajustes importantes para melhorar o desempenho. Ele utiliza rotary positional embeddings para uma compreensão de sequência superior. Os mecanismos de atenção contam com multi-query attention e FlashAttention. O bloco decodificador traz atenção paralela e estruturas de MLP (Perceptron Multicamadas) com um esquema de normalização em duas camadas, equilibrando eficiência computacional.
O Falcon 40B foi treinado em 1 trilhão de tokens do RefinedWeb, um corpus da internet filtrado por qualidade, além de outros conjuntos de dados curados. Em vez de reunir fontes curadas dispersas, o TII elevou a qualidade dos dados da web com desduplicação em larga escala e filtros rigorosos, resultando em um dataset de treinamento de alta qualidade que contribui para o ótimo desempenho da família Falcon.
O Falcon 40B foi treinado no AWS SageMaker com 384 GPUs A100 de 40 GB, utilizando uma estratégia de paralelismo 3D (TP=8, PP=4, DP=12) em conjunto com ZeRO. O treinamento começou em dezembro de 2022 e levou dois meses para ser concluído.
Aprenda a treinar modelos de linguagem de grande porte com PyTorch, do setup inicial à implementação final, seguindo o tutorial How to Train a Large Language Model with PyTorch.
Diferente do esquema tradicional de atenção multihead, o Falcon 40B adota a Multi-Query Attention, na qual uma única chave e um único valor são compartilhados entre todas as cabeças de atenção. Esse mecanismo inovador não impacta significativamente o pré-treinamento, mas melhora bastante a escalabilidade na inferência.
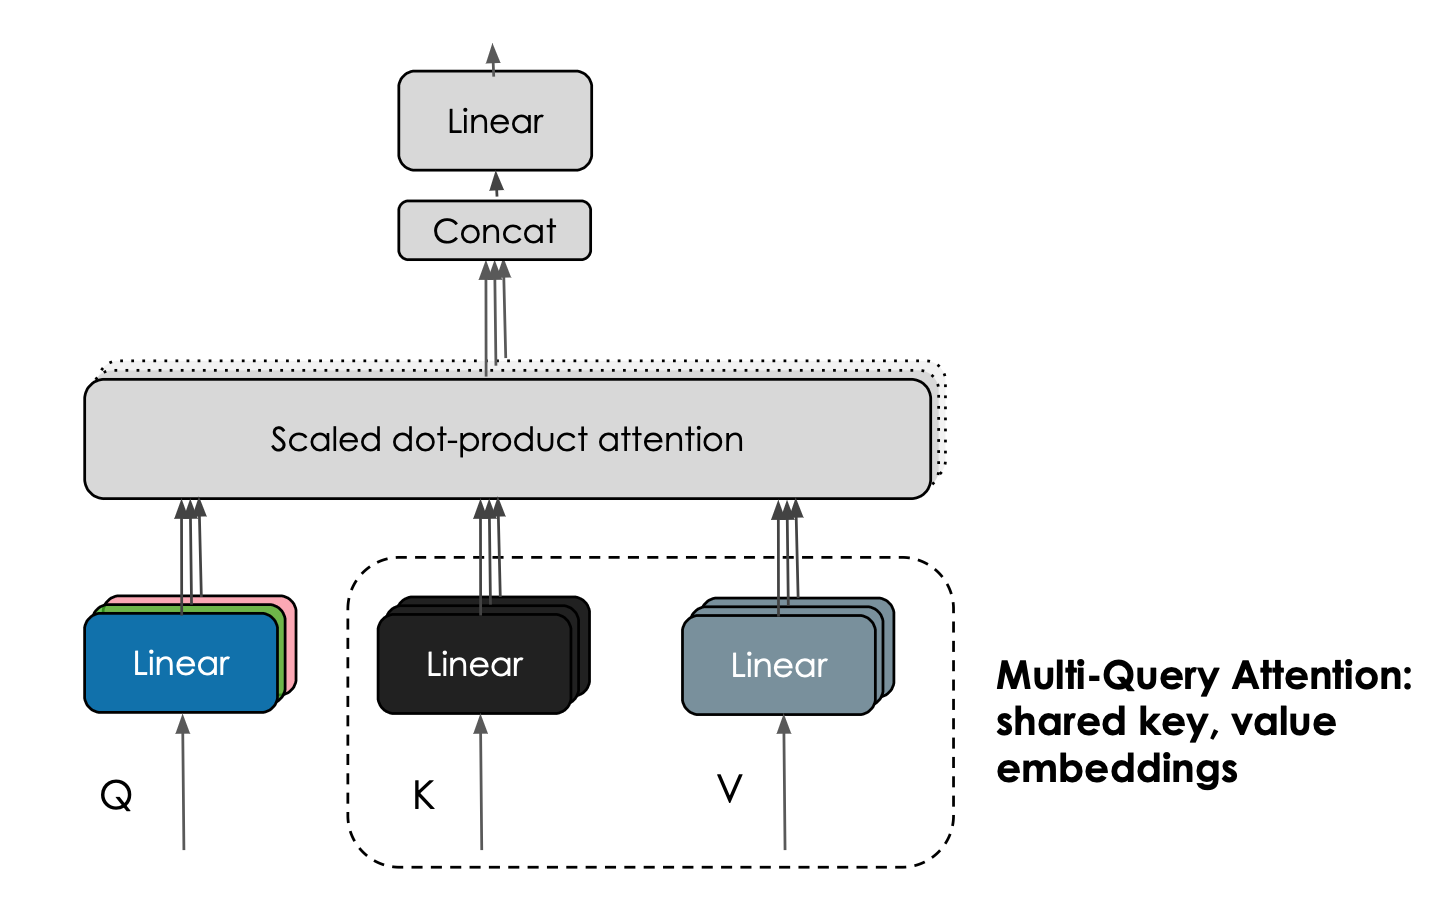
Imagem do blog do Falcon
O TII também lançou versões instruct dos modelos, Falcon-7B-Instruct e Falcon 40B-Instruct, ajustadas com dados de instruções e conversação para melhor desempenho em tarefas do tipo assistente.
Embora o Falcon 40B exija muita memória de GPU, você pode usar quantização para torná-lo viável em GPUs mais acessíveis ou até rodar a versão menor, Falcon-7B, no Google Colab.
O Falcon 40B supera outros modelos open source como LLaMA, StableLM, RedPajama e MPT, como mostrado no OpenLLM Leaderboard. Seu desempenho superior o coloca entre as principais opções entre os modelos abertos disponíveis.
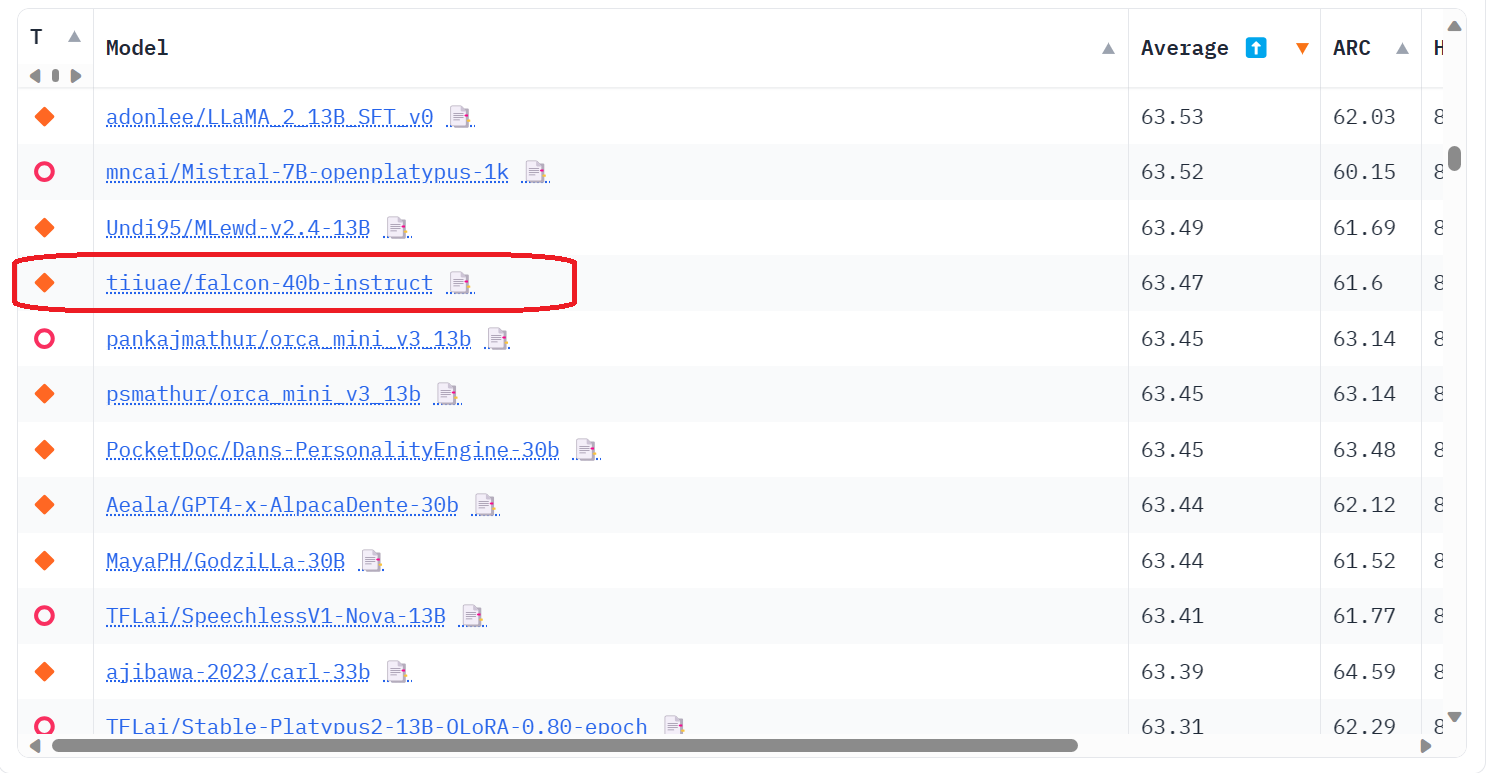
Imagem do Open LLM Leaderboard
A arquitetura do Falcon 40B é otimizada para inferência eficiente, com recursos como FlashAttention e multi-query attention, o que resulta em maior velocidade e escalabilidade. É um modelo de linguagem bruto pré-treinado que, para a maioria dos casos de uso, requer fine-tuning adicional.
O Falcon 40B vem com licença Apache 2.0, permitindo usar o modelo e o conjunto de dados comercialmente sem cobrança de royalties ou restrições.
Nesta seção, vamos ver como carregar o modelo Falcon 40B e executar a inferência. Além disso, vamos explorar como rodar a inferência da versão menor Falcon 7B no Google Colab usando quantização em 4 bits. Por fim, vamos aprender a usar QLoRA e SFT Trainer para fazer fine-tuning do modelo em um novo conjunto de dados.
Executar o Falcon 40B, com seus 40 bilhões de parâmetros, traz desafios de memória. O modelo ultrapassa a capacidade de uma única GPU NVIDIA A100 com 80 GB de RAM, mesmo usando precisão reduzida em 8 bits, que exige cerca de 45 GB de RAM.
Usando carregamento em 4 bits com as versões mais recentes das bibliotecas bitsandbytes, transformers e accelerate, a pegada de memória pode cair para cerca de 27 GB de RAM. Isso permite carregar o Falcon-40B em GPUs A100 de 40 GB.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Carregar o Falcon 40B e rodar a inferência com quantização em 4 bits não é viável em GPUs de consumidor. Por isso, vamos usar a versão menor, Falcon 7B, que roda facilmente na versão gratuita do Google Colab.
Vamos instalar todas as bibliotecas Python necessárias.
%pip install transformers bitsandbytes accelerate -qDepois, carregamos os módulos necessários para carregar o modelo e executar a inferência.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Usamos BitsAndBytes para criar uma quantização de 4 bits com configuração do tipo NF4. Isso reduz o uso de memória, possibilitando carregar o modelo na GPU do Colab. Leia mais sobre quantização em 4 bits e QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Vamos carregar o modelo e o tokenizer do Falcon 7B e criar um pipeline de geração de texto com a biblioteca Transformers para executar a inferência.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Ao passar o prompt para o pipeline, conseguimos gerar a resposta.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
O resultado é muito bom. Você pode experimentar diferentes parâmetros no pipeline para melhorar ainda mais a resposta do modelo.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Se estiver com dificuldade para rodar o Falcon 7B no Colab, você pode usar o Colab Notebook como guia.
Usando a biblioteca TRL com QLoRA, podemos ajustar o modelo. O código a seguir faz parte do processo de fine-tuning e permite executar o SFTTrainer sem PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Você também pode conferir o notebook Falcon-Guanaco.ipynb com o código para fazer fine-tuning do Falcon-7B no dataset Guanaco. Para treinar o modelo no Guanaco — um subconjunto de alta qualidade do dataset Open Assistant com aproximadamente 10.000 diálogos — podemos usar a biblioteca PEFT junto com a abordagem recente QLoRA para ajustar adaptadores posicionados sobre o modelo congelado em 4 bits.
Ao usar Low Rank Adapters (LoRA), apenas uma pequena fração do modelo é treinável, reduzindo significativamente o número de parâmetros aprendidos e o tamanho do artefato gerado. Isso permite um fine-tuning mais rápido, economizando recursos de memória.
Você também pode pular o fine-tuning e usar Retrieval Augmented Generation (RAG) para personalizar a resposta dando acesso aos seus documentos privados. Siga o tutorial LlamaIndex: um framework de dados para aplicações baseadas em Large Language Models (LLMs).
Você também pode construir aplicações de LLM com LangChain usando seu modelo recém-ajustado, em uma abordagem semelhante ao LlamaIndex.
O Falcon-180B foi treinado com 3.500 bilhões de tokens do dataset RefinedWeb. É um modelo causal apenas com decodificador, com 180 bilhões de parâmetros, licenciado sob a Falcon-180B TII, e supera LLaMA-2, StableLM, RedPajama, MPT e outros modelos de ponta no OpenLLM Leaderboard.
O lado negativo do Falcon 180B é que a inferência requer pelo menos 400 GB de memória. Em resumo, você precisa de aproximadamente 8× A100 de 80 GB.
O ponto positivo é que o TII também lançou o Falcon-180B-Chat, ajustado com uma combinação dos datasets Ultrachat, Platypus e Airoboros. Ele ganhou bastante popularidade na comunidade de IA. Você pode testar a demo no Hugging Face Spaces e conferir a qualidade das respostas.
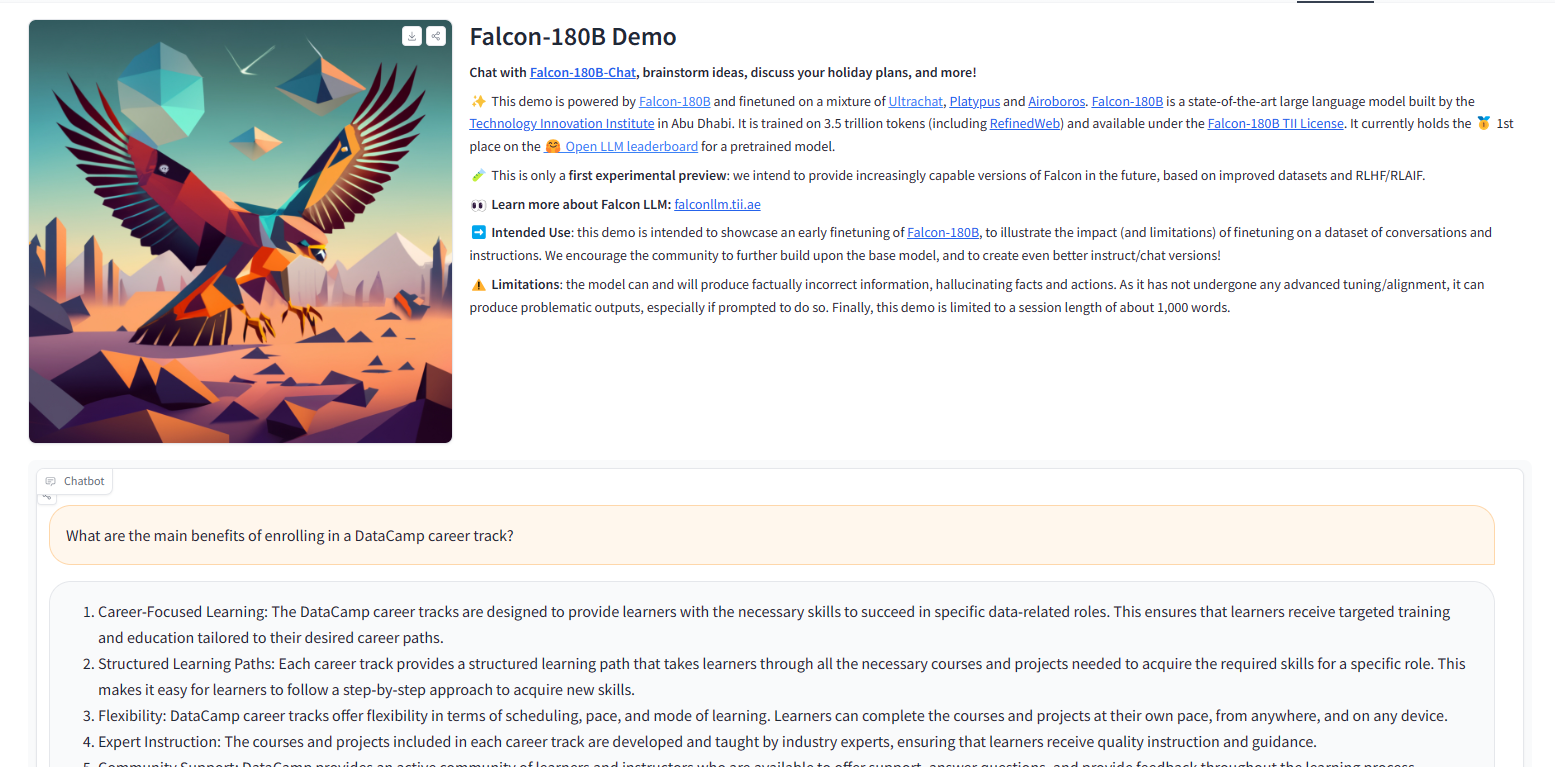
Imagem da demo do Falcon-180B
O Falcon 40B, do TII, mostra um desempenho impressionante como modelo de linguagem generativa open source. Com 40 bilhões de parâmetros e treinamento em dados da web filtrados com alta qualidade, atinge resultados de ponta no OpenLLM Leaderboard.
Enquanto o Falcon 40B completo exige muitos recursos computacionais, a versão menor, de 7B, roda em GPUs gratuitas do Colab usando quantização em 4 bits. O fine-tuning pode ser feito com QLoRA, PEFT e SFT Trainer. A nova versão Falcon 180B eleva ainda mais o desempenho, mas requer 400 GB apenas para executar a inferência.
Se você deseja construir carreira em machine learning e até criar seu próprio modelo de linguagem de grande porte, considere fazer a trilha de carreira Machine Learning Scientist with Python.
Comece sua jornada em machine learning hoje!
Programa
Curso
blog
Javier Canales Luna
11 min
blog
Richie Cotton
7 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
8 min
Tutorial
Josep Ferrer
11 min