
Last chance! 50% off DataCamp Premium
Sale ends in
Falcon 40B पर इस लेख की सामग्री को पूरी तरह समझने के लिए पाठकों को मशीन लर्निंग और नेचुरल लैंग्वेज प्रोसेसिंग की बुनियादी समझ होनी चाहिए। ट्रांसफॉर्मर मॉडलों और उनके घटकों—जैसे अटेंशन मैकेनिज़्म और पोज़िशनल एम्बेडिंग्स—से परिचित होना उपयोगी है।
यदि आप AI में नए हैं और बुनियादी बातें सीखना चाहते हैं, तो हमारा AI Fundamentals स्किल ट्रैक करें। आप ChatGPT, मशीन लर्निंग, LLMs, जनरेटिव AI, और AI नैतिकता के बारे में जानकारी हासिल करेंगे।
Falcon 40B, Technology Innovation Institute (TII) द्वारा विकसित Falcon परिवार के बड़े भाषा मॉडलों (LLMs) का हिस्सा है, जिसमें Falcon 7B और Falcon 180B भी शामिल हैं। एक causal decoder-only मॉडल के रूप में, Falcon 40B विभिन्न नेचुरल लैंग्वेज जनरेशन कार्यों के लिए बनाया गया है।
Falcon 40B की बहुभाषी क्षमताओं में अंग्रेज़ी, जर्मन, स्पेनिश और फ़्रेंच शामिल हैं, साथ ही कई अन्य भाषाओं—जैसे इतालवी, पुर्तगाली, पोलिश, डच, रोमानियाई, चेक, और स्वीडिश—में सीमित दक्षता है।
Falcon 40B का आर्किटेक्चर GPT-3 से अनुकूलित है, लेकिन बेहतर प्रदर्शन के लिए महत्वपूर्ण संशोधनों के साथ। यह बेहतर सीक्वेंस समझ के लिए रोटरी पोज़िशनल एम्बेडिंग्स का उपयोग करता है। अटेंशन मैकेनिज़्म को मल्टी-क्वेरी अटेंशन और FlashAttention से समृद्ध किया गया है। डिकोडर ब्लॉक में पैरेलल अटेंशन और मल्टी-लेयर परसेप्ट्रॉन (MLP) संरचनाएँ दो-लेयर नॉर्मलाइज़ेशन स्कीम के साथ हैं, जो संगणकीय दक्षता का संतुलन करती हैं।
Falcon 40B को 1 ट्रिलियन टोकन्स पर प्रशिक्षित किया गया, जिनमें RefinedWeb—गुणवत्ता-फ़िल्टर किया गया इंटरनेट कॉर्पस—और अतिरिक्त क्यूरेटेड डेटासेट शामिल हैं। बिखरे हुए क्यूरेटेड स्रोतों को इकट्ठा करने के बजाय, TII ने बड़े पैमाने पर डीडुप्लीकेशन और कड़े फ़िल्टरिंग का उपयोग करके वेब डेटा की गुणवत्ता बढ़ाई, जिससे उच्च-गुणवत्ता का प्रशिक्षण डेटासेट प्राप्त हुआ और Falcon मॉडलों के उच्च प्रदर्शन में योगदान मिला।
Falcon 40B को AWS SageMaker पर 384 A100 40GB GPUs का उपयोग कर, ZeRO के साथ 3D पैरेललिज़्म रणनीति (TP=8, PP=4, DP=12) के अंतर्गत प्रशिक्षित किया गया। प्रशिक्षण दिसंबर 2022 में शुरू हुआ और दो महीने में पूरा हुआ।
PyTorch का उपयोग करके बड़े भाषा मॉडलों को आरंभिक सेटअप से लेकर अंतिम इम्प्लीमेंटेशन तक कैसे प्रशिक्षित करें, यह सीखने के लिए How to Train a Large Language Model with PyTorch ट्यूटोरियल देखें।
पारंपरिक मल्टीहेड अटेंशन स्कीम के विपरीत, Falcon 40B Multi-Query Attention अपनाता है जिसमें सभी अटेंशन हेड्स के लिए एक ही key और value साझा होती है। यह अभिनव अटेंशन मैकेनिज़्म प्री-ट्रेनिंग पर विशेष प्रभाव नहीं डालता, लेकिन इंफेरेंस स्केलेबिलिटी को बहुत बढ़ाता है।
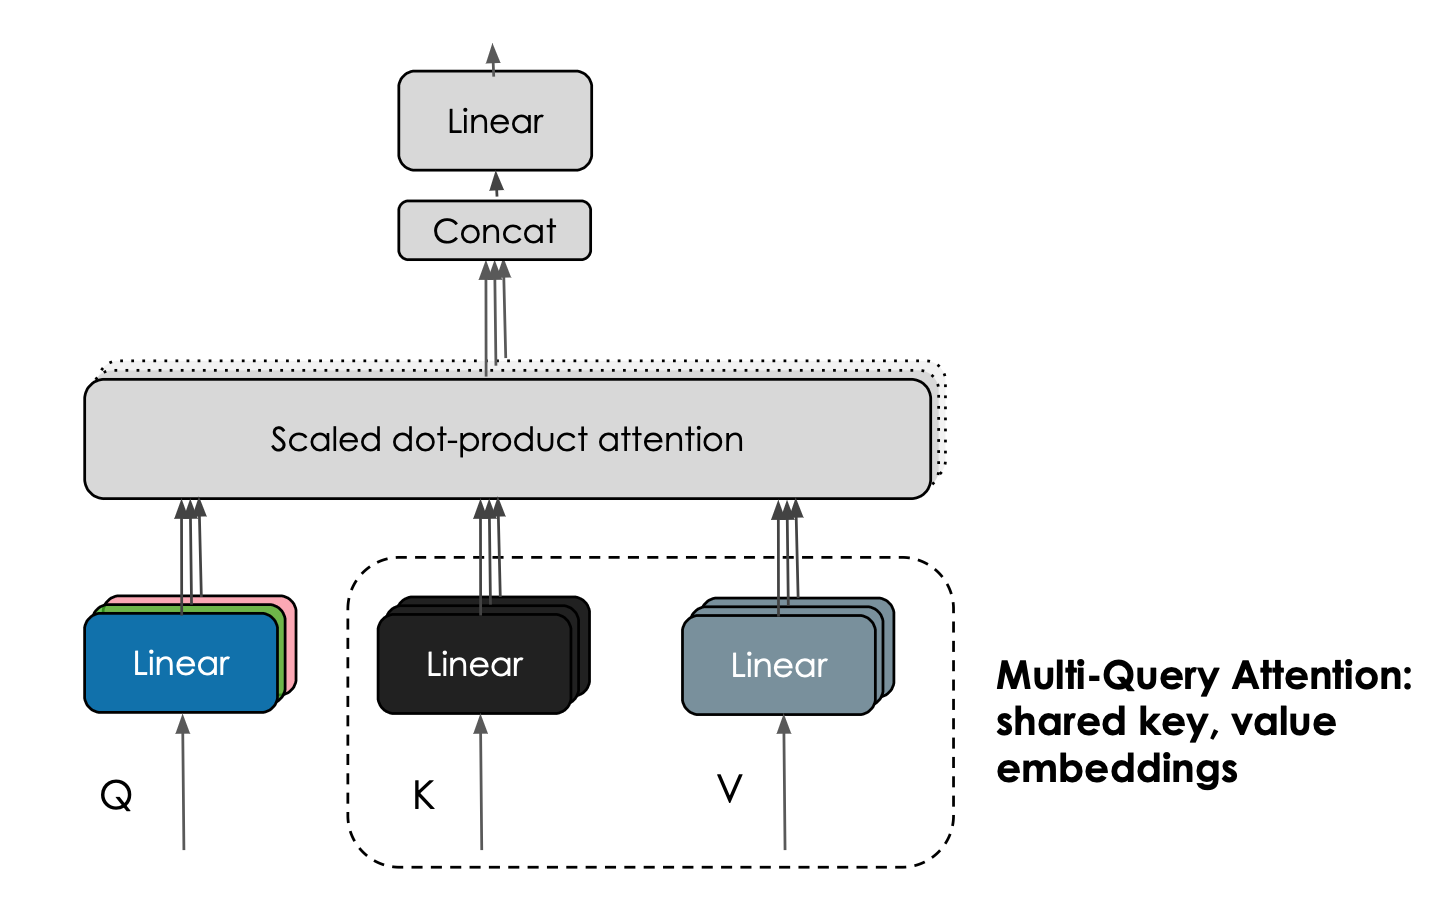
Falcon ब्लॉग से छवि
TII ने मॉडलों के instruct वर्शन भी पेश किए हैं—Falcon-7B-Instruct और Falcon 40B-Instruct—जिन्हें निर्देशों और वार्तालाप डेटा पर फाइन-ट्यून किया गया है ताकि असिस्टेंट-शैली के कार्यों पर बेहतर प्रदर्शन हो।
यद्यपि Falcon 40B को पर्याप्त GPU मेमोरी की आवश्यकता होती है, आप क्वांटाइज़ेशन का उपयोग करके मॉडल को सस्ते GPUs पर सुलभ बना सकते हैं या Google Colab पर मॉडल के छोटे वर्शन Falcon-7B को चला सकते हैं।
Falcon 40B अन्य ओपन-सोर्स मॉडलों जैसे LLaMA, StableLM, RedPajama, और MPT से बेहतर प्रदर्शन करता है, जैसा कि OpenLLM Leaderboard पर दर्शाया गया है। इसका श्रेष्ठ प्रदर्शन उपलब्ध ओपन-सोर्स मॉडलों में इसे अग्रणी विकल्प बनाता है।
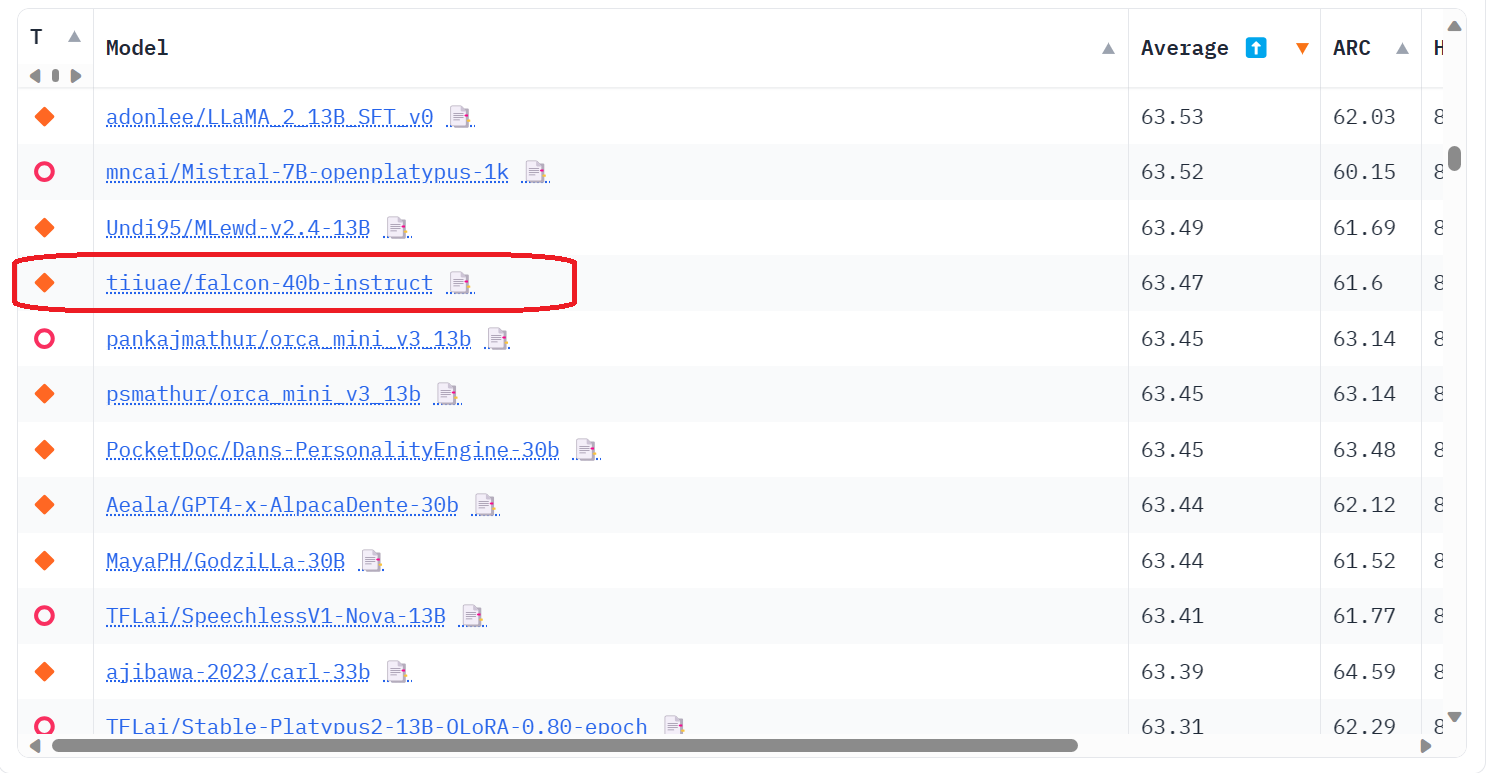
Open LLM Leaderboard से छवि
Falcon 40B का आर्किटेक्चर FlashAttention और मल्टी-क्वेरी अटेंशन जैसी विशेषताओं का उपयोग करके कुशल इंफेरेंस के लिए ऑप्टिमाइज़्ड है, जिससे इंफेरेंस गति और स्केलेबिलिटी अधिक होती है। यह एक कच्चा प्री-ट्रेन किया हुआ भाषा मॉडल है, जिसे अधिकांश मामलों में उपयोग के लिए आगे फाइन-ट्यून करने की आवश्यकता होती है।
Falcon 40B Apache 2.0 लाइसेंस के साथ आता है, जो आपको मॉडल और डेटासेट को व्यावसायिक उपयोग के लिए बिना किसी रॉयल्टी दायित्वों या प्रतिबंधों के उपयोग करने देता है।
इस खंड में, हम Falcon 40B मॉडल को लोड करने और इंफेरेंस चलाने की प्रक्रिया कवर करेंगे। इसके अतिरिक्त, हम Google Colab पर 4-बिट क्वांटाइज़ेशन का उपयोग करके छोटे Falcon 7B वर्शन के लिए इंफेरेंस चलाने का तरीका देखेंगे। अंत में, हम QLoRA और SFT Trainer का उपयोग करके अपने मॉडल को नए डेटासेट पर फाइन-ट्यून करना सीखेंगे।
40 बिलियन पैरामीटर वाला Falcon 40B मॉडल चलाना मेमोरी संबंधी चुनौतियाँ पैदा करता है। मॉडल एकल NVIDIA A100 GPU (80 GB RAM) की मेमोरी क्षमता से अधिक है, यहाँ तक कि 8-बिट कम-प्रेसिजन मोड में भी, जिसमें लगभग 45 GB RAM की आवश्यकता होती है।
bitsandbytes, transformers, और accelerate लाइब्रेरी के नवीनतम वर्शन के साथ 4-बिट प्रेसिजन लोडिंग का उपयोग करके, मेमोरी फुटप्रिंट को लगभग 27 GB RAM तक घटाया जा सकता है। इससे Falcon-40B को 40 GB A100 GPUs में लोड किया जा सकता है।
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")उपभोक्ता GPUs पर 4-बिट क्वांटाइज़ेशन के साथ Falcon 40B को लोड करना और इंफेरेंस चलाना संभव नहीं है। इसलिए, हम Falcon 7B मॉडल के छोटे वर्शन का उपयोग करेंगे, जिसे Google Colab के मुफ्त वर्शन पर आसानी से चलाया जा सकता है।
हम सभी आवश्यक Python लाइब्रेरी इंस्टॉल करेंगे।
%pip install transformers bitsandbytes accelerate -qऔर फिर मॉडल को लोड करने और इंफेरेंस चलाने के लिए आवश्यक मॉड्यूल लोड करेंगे।
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
हम BitsAndBytes का उपयोग करके NF4 प्रकार की कॉन्फ़िगरेशन के साथ 4-बिट क्वांटाइज़ेशन बनाते हैं। यह मेमोरी फुटप्रिंट को घटाता है, जिससे हम Colab GPU में मॉडल को लोड कर पाते हैं। 4-बिट क्वांटाइज़ेशन और QLoRA के बारे में पढ़ें।
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
हम Falcon 7B मॉडल और टोकनाइज़र लोड करेंगे और Transformers लाइब्रेरी का उपयोग करके इंफेरेंस चलाने के लिए टेक्स्ट जनरेशन पाइपलाइन बनाएंगे।
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
पाइपलाइन को प्रॉम्प्ट देकर हम प्रतिक्रिया जनरेट कर सकते हैं।
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
हमारा परिणाम प्रभावशाली है। आप पाइपलाइन में अलग-अलग पैरामीटर आज़माकर मॉडल की प्रतिक्रिया को और बेहतर बना सकते हैं।
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.यदि आपको Colab पर Falcon 7B चलाने में कठिनाई हो रही है, तो आप मार्गदर्शक के रूप में Colab Notebook का उपयोग कर सकते हैं।
QLoRA के साथ TRL लाइब्रेरी का उपयोग करके, हम मॉडल को फाइन-ट्यून कर सकते हैं। निम्न कोड फाइन-ट्यूनिंग प्रक्रिया का एक हिस्सा है और PEFT के बिना SFTTrainer चलाने में सक्षम बनाता है।
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
आप Falcon-Guanaco.ipynb नोटबुक देख सकते हैं, जिसमें Guanaco डेटासेट पर Falcon-7B को फाइन-ट्यून करने का कोड है। Guanaco डेटासेट—जो लगभग 10,000 संवादों वाला Open Assistant डेटासेट का उच्च-गुणवत्ता उपसमुच्चय है—पर मॉडल को प्रशिक्षित करने के लिए, हम PEFT लाइब्रेरी को हालिया QLoRA दृष्टिकोण के साथ उपयोग कर सकते हैं ताकि फ़्रोज़न 4-बिट मॉडल के ऊपर रखे गए एडेप्टर्स को फाइन-ट्यून किया जा सके।
Low Rank Adapters (LoRA) का उपयोग करते समय, मॉडल का केवल एक छोटा सा हिस्सा ट्रेन करने योग्य होता है, जिससे सीखे गए पैरामीटर्स की संख्या और प्रशिक्षित आर्टिफैक्ट का आकार काफी कम हो जाता है। यह मेमोरी संसाधनों की बचत करते हुए मॉडल को तेज़ी से फाइन-ट्यून करने की अनुमति देता है।
आप फाइन-ट्यूनिंग भाग को छोड़कर Retrieval Augmented Generation (RAG) का उपयोग भी कर सकते हैं, जिसमें अपने निजी दस्तावेज़ों तक पहुँच देकर प्रतिक्रिया को व्यक्तिगत बनाया जाता है। ऐसा करने के लिए LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications ट्यूटोरियल का पालन करें।
आप अपने हाल ही में फाइन-ट्यून किए गए मॉडल का उपयोग करके, LlamaIndex की तरह ही, LangChain के साथ LLM एप्लिकेशन बनाएं।
Falcon-180B को RefinedWeb डेटासेट के 3,500B टोकन्स पर प्रशिक्षित किया गया। यह 180 बिलियन पैरामीटर्स वाला causal decoder-only मॉडल है, जो Falcon-180B TII लाइसेंस के अंतर्गत है और OpenLLM Leaderboard पर LLaMA-2, StableLM, RedPajama, MPT, और अन्य शीर्ष मॉडलों से बेहतर प्रदर्शन करता है।
Falcon 180B मॉडल की कमी यह है कि इंफेरेंस चलाने के लिए कम से कम 400GB मेमोरी की आवश्यकता होती है। संक्षेप में, आपको लगभग 8xA100 80GB चाहिए।
इस रिलीज़ का सकारात्मक पहलू यह है कि TII ने Falcon-180B-Chat भी लॉन्च किया है, जिसे Ultrachat, Platypus, और Airoboros डेटासेट्स के संयोजन पर फाइन-ट्यून किया गया है। इसे AI समुदाय के बीच काफ़ी लोकप्रियता मिली है। आप Hugging Face Spaces पर डेमो भी आज़मा सकते हैं और उच्च-गुणवत्ता वाली प्रतिक्रिया का अनुभव कर सकते हैं।
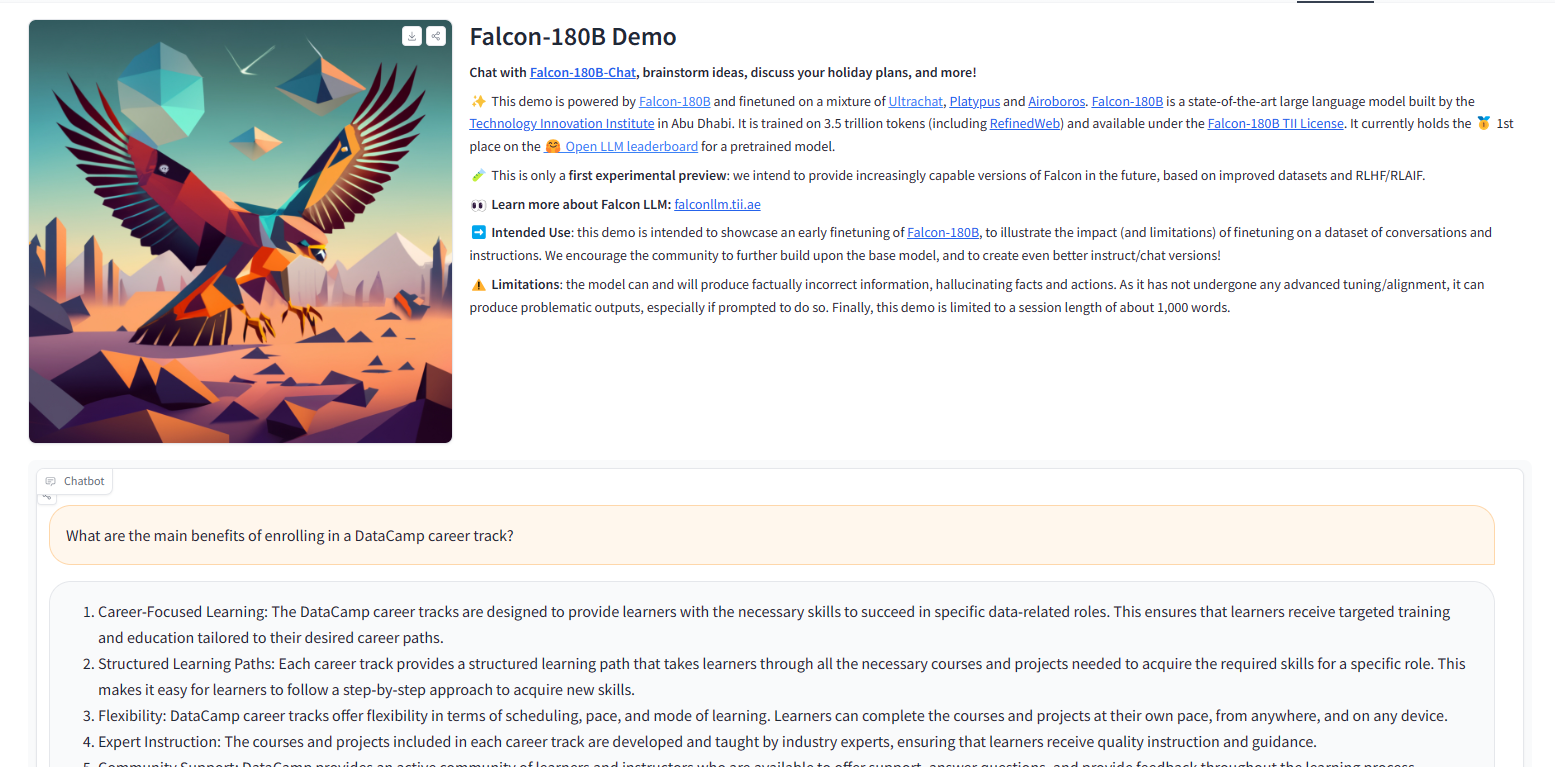
Falcon-180B डेमो से छवि
TII का Falcon 40B एक ओपन-सोर्स जनरेटिव भाषा मॉडल के रूप में प्रभावशाली प्रदर्शन दिखाता है। 40 बिलियन पैरामीटर्स और उच्च-गुणवत्ता, फ़िल्टर किए गए वेब डेटा पर प्रशिक्षण के साथ, यह OpenLLM Leaderboard पर अत्याधुनिक परिणाम प्राप्त करता है।
जहाँ पूर्ण Falcon 40B मॉडल को पर्याप्त कंप्यूट संसाधनों की आवश्यकता होती है, वहीं 7B का छोटा वर्शन 4-बिट क्वांटाइज़ेशन का उपयोग करके मुफ्त Colab GPUs पर चल सकता है। QLoRA, PEFT, और SFT Trainer के माध्यम से फाइन-ट्यूनिंग संभव है। नया 180B Falcon वर्शन प्रदर्शन को और आगे बढ़ाता है, लेकिन केवल इंफेरेंस चलाने के लिए 400GB की आवश्यकता होती है।
यदि आप मशीन लर्निंग में करियर बनाना चाहते हैं और अपना स्वयं का बड़ा भाषा मॉडल बनाना चाहते हैं, तो Machine Learning Scientist with Python करियर ट्रैक पर विचार करें।
आज ही अपनी मशीन लर्निंग यात्रा शुरू करें!
लर्निंग पाथ
कोर्स
