
Leerpad
Wetenschapper op het gebied van machine learning in Python
85 uur
Om de inhoud van dit artikel over Falcon 40B volledig te waarderen, is het handig als je een basisbegrip hebt van machine learning en natural language processing. Vertrouwdheid met transformermodellen en hun componenten, zoals attention-mechanismen en positionele embeddings, is waardevol.
Ben je nieuw in AI en wil je de basis leren? Volg dan onze skill track AI Fundamentals. Je krijgt kennis over ChatGPT, machine learning, LLM’s, generatieve AI en AI-ethiek.
Falcon 40B maakt deel uit van de Falcon-familie van large language models (LLM’s) ontwikkeld door het Technology Innovation Institute (TII), waar ook Falcon 7B en Falcon 180B toe behoren. Als een causal decoder-only model is Falcon 40B ontworpen voor diverse taken op het gebied van natuurlijke taal generatie.
De meertalige capaciteiten van Falcon 40B omvatten Engels, Duits, Spaans en Frans, met beperkte vaardigheid in meerdere andere talen, waaronder Italiaans, Portugees, Pools, Nederlands, Roemeens, Tsjechisch en Zweeds.
De architectuur van Falcon 40B is gebaseerd op GPT-3 maar bevat belangrijke aanpassingen voor betere prestaties. Het gebruikt rotatoire positionele embeddings voor een beter begrip van sequenties. Attention-mechanismen worden versterkt met multi-query attention en FlashAttention. Het decoderblok bevat parallelle attention en Multi-Layer Perceptron (MLP)-structuren met een schema van twee laagnormalisaties, wat de rekenefficiëntie in balans brengt.
Falcon 40B is getraind op 1 biljoen tokens uit RefinedWeb, een internetcorpus gefilterd op kwaliteit, aangevuld met extra gecureerde datasets. In plaats van verspreide gecureerde bronnen te verzamelen, verhoogde TII de kwaliteit van webdata door grootschalige deduplicatie en strikte filtering toe te passen, wat resulteerde in een hoogwaardige trainingsdataset die bijdraagt aan de sterke prestaties van Falcon-modellen.
Falcon 40B is getraind op AWS SageMaker met 384 A100 40GB GPU’s, met gebruik van een 3D-parallelismestrategie (TP=8, PP=4, DP=12) in combinatie met ZeRO. De training begon in december 2022 en duurde twee maanden.
Leer hoe je large language models traint met PyTorch, van de eerste setup tot de uiteindelijke implementatie, in de tutorial How to Train a Large Language Model with PyTorch.
In tegenstelling tot het traditionele multihead-attentionschema gebruikt Falcon 40B Multi-Query Attention, waarbij één key en value worden gedeeld door alle attention-heads. Dit innovatieve attention-mechanisme heeft geen significante impact op pretraining, maar verbetert de schaalbaarheid van inferentie enorm.
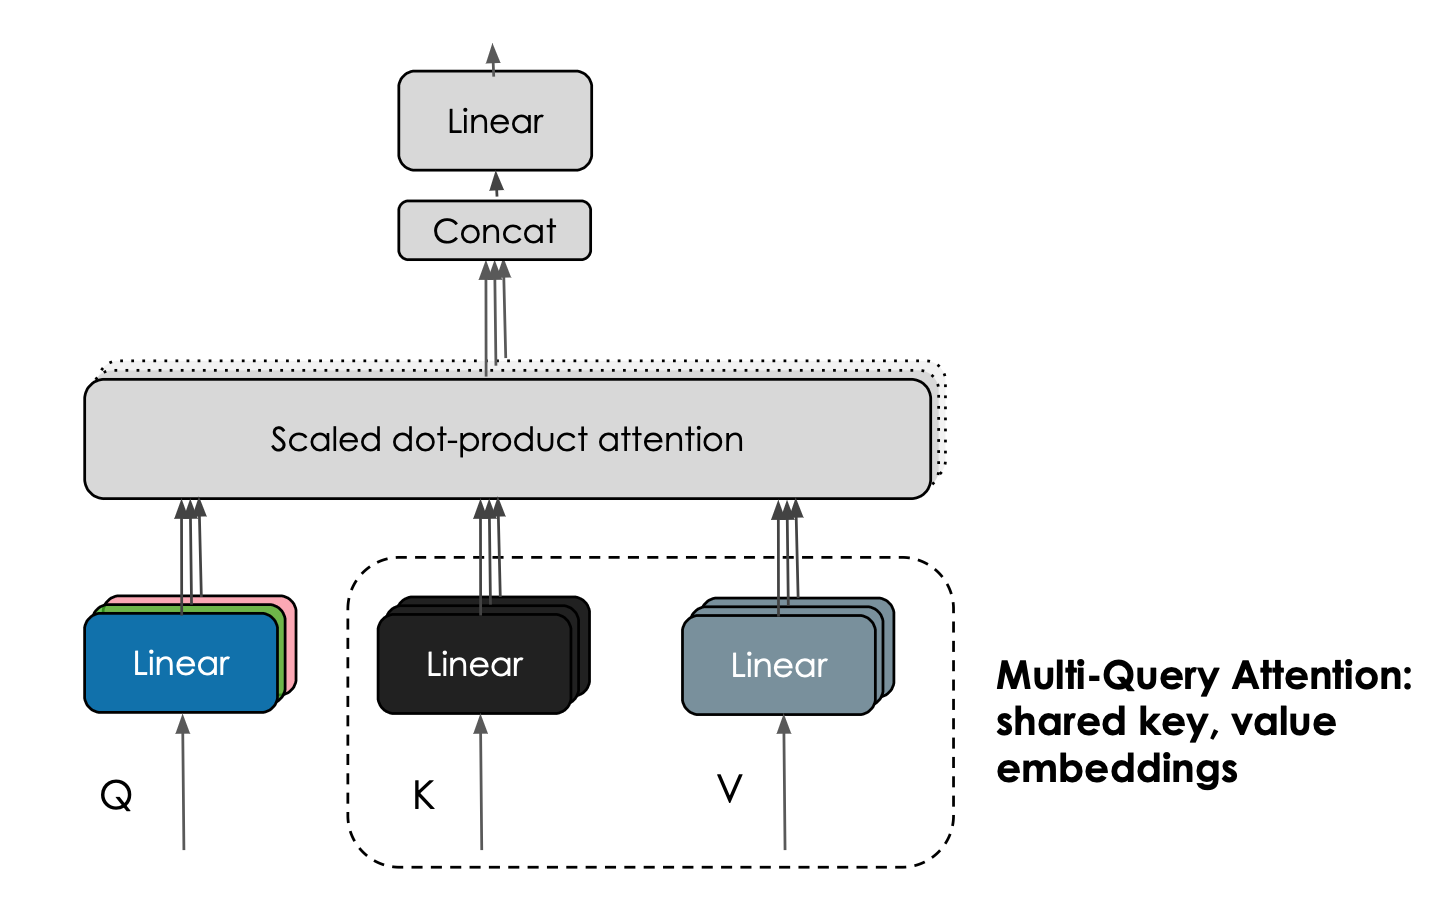
Afbeelding van de Falcon-blog
TII heeft ook instruct-versies van de modellen uitgebracht, Falcon-7B-Instruct en Falcon 40B-Instruct, die zijn fijn-afgesteld op instructies en conversatiedata voor betere prestaties bij assistent-achtige taken.
Hoewel Falcon 40B veel GPU-geheugen vereist, kun je altijd kwantisatie gebruiken om dit model toegankelijk te maken op goedkopere GPU’s of zelfs een kleinere versie van het model, Falcon-7B, op Google Colab draaien.
Falcon 40B overklast andere open-sourcemodellen zoals LLaMA, StableLM, RedPajama en MPT, zoals blijkt uit de OpenLLM Leaderboard. De superieure prestaties maken het een topkeuze onder de beschikbare open-sourcemodellen.
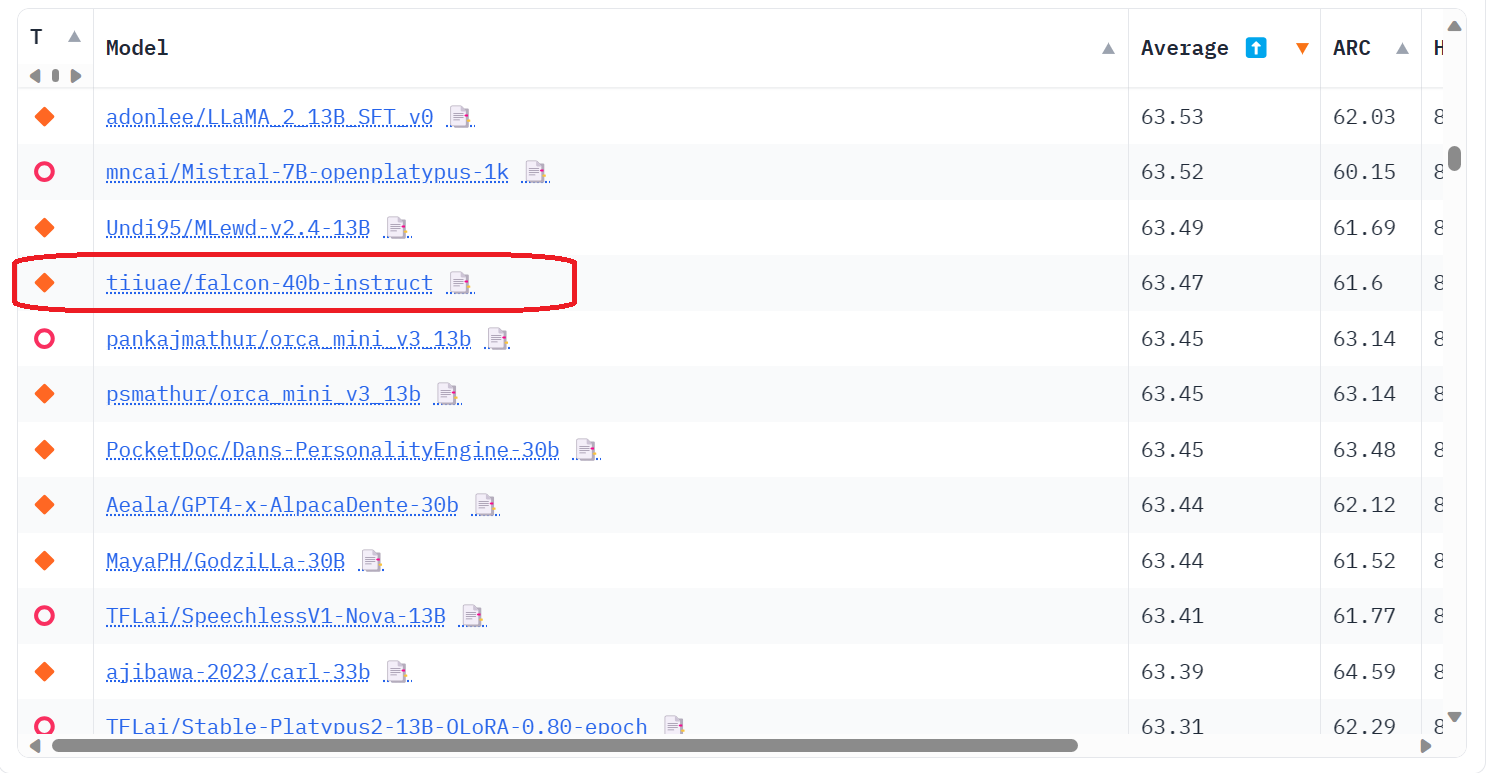
Afbeelding van Open LLM Leaderboard
De Falcon 40B-architectuur is geoptimaliseerd voor efficiënte inferentie met functies zoals FlashAttention en multi-query attention, wat resulteert in hogere inferentiesnelheid en schaalbaarheid. Het is een ruw, voorgetraind taalmodel dat voor de meeste toepassingen verdere fine-tuning vereist.
Falcon 40B wordt geleverd met een Apache 2.0-licentie, waardoor je het model en de dataset commercieel kunt gebruiken zonder royaltyverplichtingen of beperkingen.
In deze sectie behandelen we het laden van het Falcon 40B-model en het uitvoeren van inferentie. Daarnaast bekijken we hoe je inferentie kunt draaien voor de kleinere Falcon 7B-versie op Google Colab met 4-bit kwantisatie. Tot slot leren we QLoRA en SFT Trainer te gebruiken om ons model te fine-tunen op een nieuwe dataset.
Het draaien van het Falcon 40B-model met 40 miljard parameters brengt geheugenuitdagingen met zich mee. Het model overschrijdt de geheugencapaciteit van een enkele NVIDIA A100 GPU met 80 GB RAM, zelfs in 8-bit modus met verlaagde precisie, wat ongeveer 45 GB RAM vereist.
Door 4-bit precisieladen te gebruiken met de nieuwste versies van de libraries bitsandbytes, transformers en accelerate, kan de geheugenvraag worden teruggebracht tot circa 27 GB RAM. Hierdoor kan Falcon-40B worden geladen op A100 GPU’s van 40 GB.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Het laden van Falcon 40B en het uitvoeren van inferentie met 4-bit kwantisatie is niet mogelijk op consumenten-GPU’s. Daarom gebruiken we de kleinere versie van het Falcon 7B-model, die je eenvoudig kunt draaien op de gratis versie van Google Colab.
We installeren eerst alle benodigde Python-libraries.
%pip install transformers bitsandbytes accelerate -qEn vervolgens laden we de benodigde modules om het model te laden en de inferentie uit te voeren.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
We gebruiken BitsAndBytes om een 4-bit kwantisatie met NF4-configuratie te maken. Dit verkleint de geheugenvraag, zodat we het model in de Colab-GPU kunnen laden. Lees meer over 4-bit kwantisatie en QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
We laden het Falcon 7B-model en de tokenizer en maken een tekstgeneratiepipeline met de Transformers-bibliotheek om inferentie uit te voeren.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Door de prompt aan de pipeline te geven, kunnen we het antwoord genereren.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Ons resultaat is indrukwekkend. Je kunt met verschillende parameters in de pipeline experimenteren om het antwoord van het model verder te verbeteren.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Heb je moeite om Falcon 7B op Colab te draaien? Gebruik dan deze Colab Notebook als leidraad.
Met de TRL-bibliotheek en QLoRA kunnen we het model fine-tunen. De onderstaande code maakt deel uit van het fine-tuningproces en maakt het mogelijk om de SFTTrainer zonder PEFT te draaien.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Bekijk de notebook Falcon-Guanaco.ipynb voor de code om Falcon-7B te fine-tunen op de Guanaco-dataset. Om het model te trainen op de Guanaco-dataset — een hoogwaardige subset van de Open Assistant-dataset met ongeveer 10.000 dialogen — kunnen we de PEFT-bibliotheek gebruiken samen met de recente QLoRA-aanpak om adapters te fine-tunen die bovenop het bevroren 4-bit model worden geplaatst.
Bij gebruik van Low Rank Adapters (LoRA) is slechts een klein deel van het model trainbaar, wat leidt tot een sterke vermindering van het aantal te leren parameters en de grootte van het getrainde artefact. Dit maakt snellere fine-tuning mogelijk terwijl je geheugen bespaart.
Je kunt de fine-tuning ook overslaan en Retrieval Augmented Generation (RAG) gebruiken om het antwoord te personaliseren door toegang te geven tot je privédocumenten. Volg daarvoor de tutorial LlamaIndex: A Data Framework for the Large Language Models (LLMs) based applications.
Je kunt ook LLM-toepassingen bouwen met LangChain met je recent gefinetunede model, vergelijkbaar met LlamaIndex.
Falcon-180B is getraind op 3.500 miljard tokens van de RefinedWeb-dataset. Het is een causal decoder-only model met 180 miljard parameters, gelicenseerd onder de Falcon-180B TII, en het overtreft LLaMA-2, StableLM, RedPajama, MPT en andere topmodellen op de OpenLLM Leaderboard.
Het nadeel van het Falcon 180B-model is dat inferentie draaien minstens 400 GB geheugen vereist. Kortom, je hebt ongeveer 8× A100 80GB nodig.
Het positieve aan deze release is dat TII ook Falcon-180B-Chat heeft gelanceerd, dat is gefinetuned op een combinatie van de Ultrachat-, Platypus- en Airoboros-datasets. Het heeft grote populariteit verworven binnen de AI-community. Je kunt de demo ook uitproberen op Hugging Face Spaces en de hoge kwaliteit van de respons ervaren.
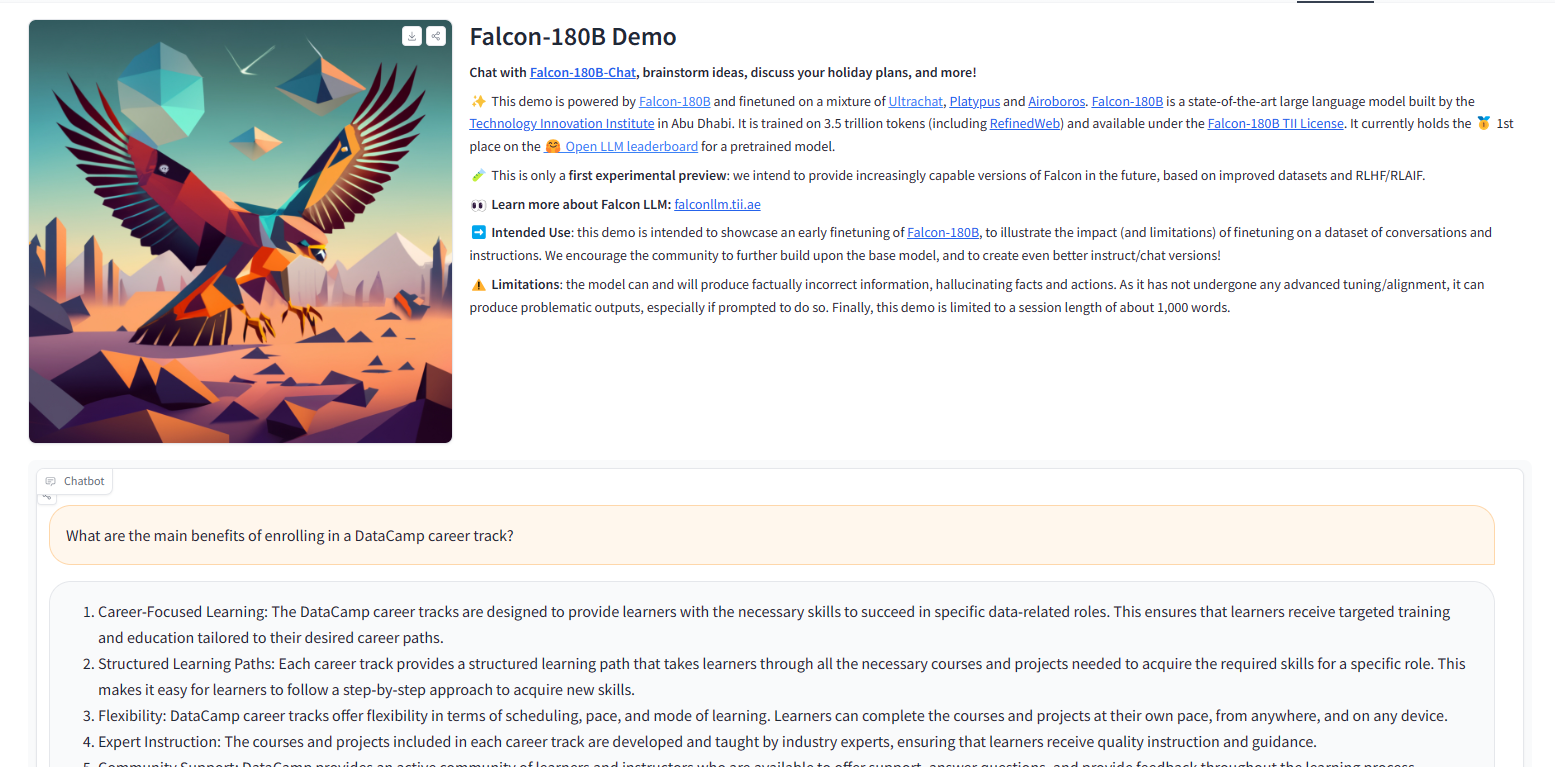
Afbeelding van Falcon-180B-demo
Falcon 40B van TII laat indrukwekkende prestaties zien als open-source generatief taalmodel. Met 40 miljard parameters en getraind op hoogwaardige gefilterde webdata behaalt het state-of-the-art resultaten op de OpenLLM Leaderboard.
Hoewel het volledige Falcon 40B-model aanzienlijke rekenmiddelen vereist, kan de kleinere 7B-versie op gratis Colab-GPU’s draaien met 4-bit kwantisatie. Fine-tuning is mogelijk via QLoRA, PEFT en SFT Trainer. De nieuwe 180B Falcon-versie stuwt de prestaties nog verder, maar heeft 400 GB nodig om alleen al inferentie te draaien.
Ben je geïnteresseerd in een carrière in machine learning en wil je je eigen large language model bouwen? Overweeg dan de career track Machine Learning Scientist with Python.
Begin vandaag nog aan je machinelearning-reis!
Leerpad
Cursus
blog
Adel Nehme
15 min

