
Lernpfad
Wissenschaftler für maschinelles Lernen in Python
85 Std.
Um den Inhalt dieses Artikels zu Falcon 40B voll zu würdigen, solltest du grundlegende Kenntnisse in Machine Learning und Natural Language Processing mitbringen. Vertrautheit mit Transformer-Modellen und ihren Bausteinen wie Attention-Mechanismen und positionalen Einbettungen ist hilfreich.
Wenn du neu in der KI bist und die Grundlagen lernen möchtest, starte mit unserem AI Fundamentals-Lernpfad. Du lernst mehr über ChatGPT, Machine Learning, LLMs, Generative KI und KI-Ethik.
Falcon 40B gehört zur Falcon-Familie großer Sprachmodelle (LLMs) des Technology Innovation Institute (TII), zu der auch Falcon 7B und Falcon 180B zählen. Als kausales Decoder-only-Modell ist Falcon 40B für vielfältige Aufgaben der natürlichen Textgenerierung ausgelegt.
Die mehrsprachigen Fähigkeiten von Falcon 40B umfassen Englisch, Deutsch, Spanisch und Französisch; in weiteren Sprachen wie Italienisch, Portugiesisch, Polnisch, Niederländisch, Rumänisch, Tschechisch und Schwedisch besteht eingeschränkte Kompetenz.
Die Architektur von Falcon 40B ist von GPT-3 abgeleitet, jedoch mit wichtigen Anpassungen für mehr Leistung. Das Modell nutzt rotatorische Positionsembeddings für ein besseres Sequenzverständnis. Die Attention-Mechanismen werden durch Multi-Query Attention und FlashAttention erweitert. Der Decoder-Block kombiniert parallele Attention und Multi-Layer-Perceptron-(MLP)-Strukturen mit einem zweistufigen Normalisierungsschema und sorgt so für effiziente Berechnungen.
Falcon 40B wurde auf 1 Billion Tokens aus RefinedWeb trainiert, einem qualitätsgefilterten Internetkorpus, ergänzt durch weitere kuratierte Datensätze. Anstatt verteilte, kuratierte Quellen zu sammeln, erhöhte TII die Qualität der Webdaten durch großangelegte Deduplizierung und strikte Filterung und erzielte so einen hochwertigen Trainingsdatensatz, der maßgeblich zur starken Performance der Falcon-Modelle beiträgt.
Falcon 40B wurde auf AWS SageMaker mit 384 A100-GPUs (40 GB) trainiert und nutzte 3D-Parallelisierung (TP=8, PP=4, DP=12) in Kombination mit ZeRO. Das Training begann im Dezember 2022 und dauerte zwei Monate.
Lerne in unserem Tutorial How to Train a Large Language Model with PyTorch, wie du große Sprachmodelle mit PyTorch vom Setup bis zur Umsetzung trainierst.
Im Gegensatz zum klassischen Multihead-Attention-Schema verwendet Falcon 40B Multi-Query Attention, bei der ein Key und ein Value über alle Attention-Heads geteilt werden. Diese innovative Mechanik beeinflusst das Pretraining kaum, verbessert aber die Skalierbarkeit der Inferenz erheblich.
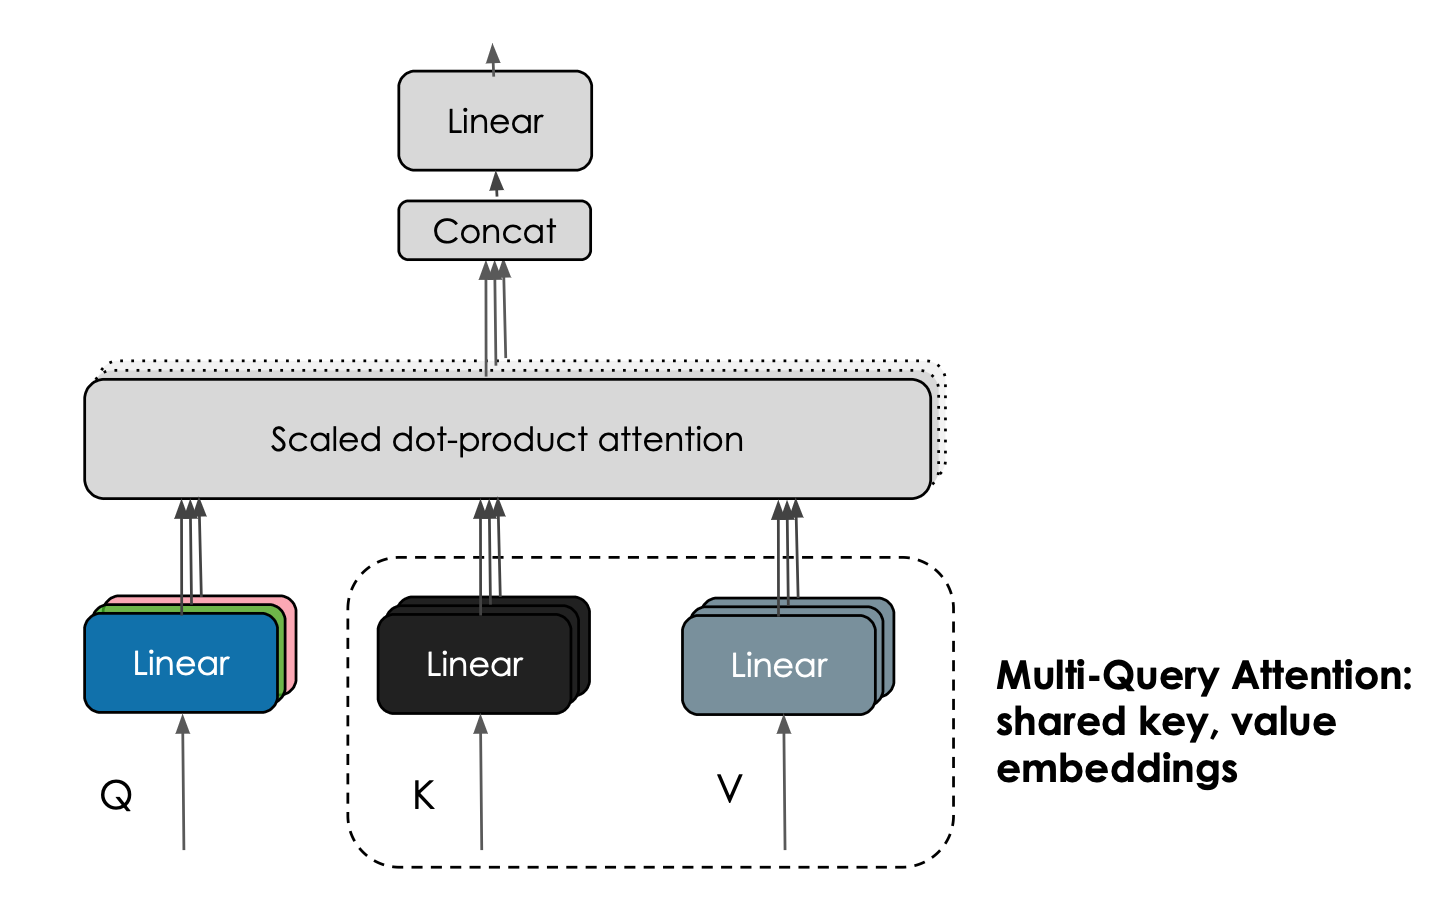
Image from Falcon blog
TII hat außerdem Instruct-Varianten veröffentlicht, Falcon-7B-Instruct und Falcon 40B-Instruct, die auf Anweisungen und Konversationsdaten feinabgestimmt wurden und dadurch bei Assistenzaufgaben besser abschneiden.
Obwohl Falcon 40B viel GPU-Speicher benötigt, kannst du Quantisierung einsetzen, um das Modell auf günstigeren GPUs nutzbar zu machen, oder die kleinere Variante Falcon-7B auf Google Colab ausführen.
Falcon 40B übertrifft andere Open-Source-Modelle wie LLaMA, StableLM, RedPajama und MPT, wie auf dem OpenLLM Leaderboard zu sehen ist. Dank der starken Leistung zählt es zu den besten frei verfügbaren Modellen.
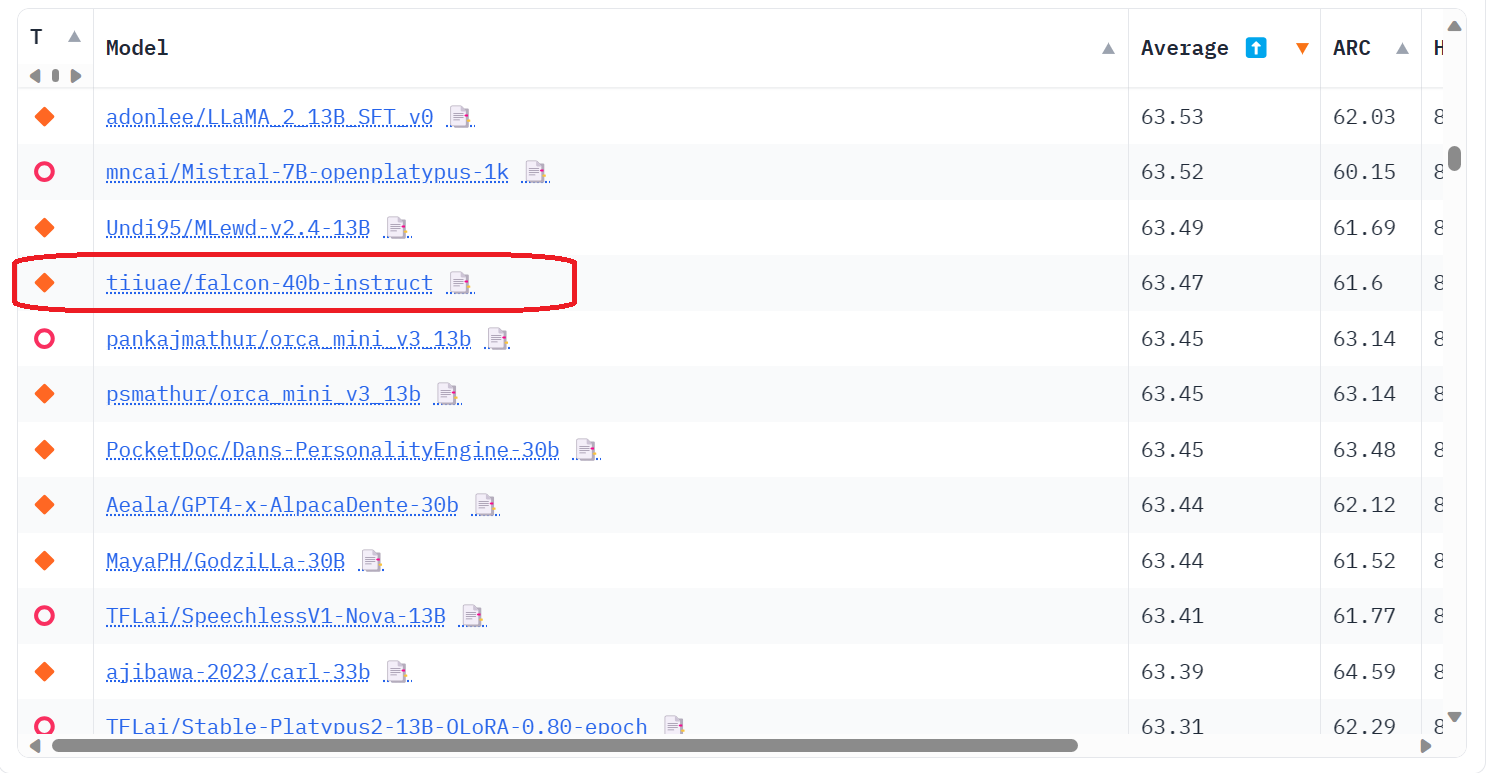
Image from Open LLM Leaderboard
Die Architektur von Falcon 40B ist für effiziente Inferenz optimiert, unter anderem durch FlashAttention und Multi-Query Attention. Das Ergebnis sind höhere Geschwindigkeit und bessere Skalierbarkeit. Es handelt sich um ein reines vortrainiertes Sprachmodell, das für die meisten Einsatzzwecke weiteres Finetuning benötigt.
Falcon 40B steht unter der Apache-2.0-Lizenz. Du kannst Modell und Datensatz kommerziell nutzen, ohne Lizenzgebühren oder weitere Einschränkungen.
In diesem Abschnitt zeigen wir, wie du das Falcon-40B-Modell lädst und Inferenz ausführst. Außerdem sehen wir uns an, wie du die kleinere Falcon-7B-Version auf Google Colab mit 4-Bit-Quantisierung laufen lässt. Abschließend lernst du, mit QLoRA und dem SFT Trainer ein Finetuning auf einem neuen Datensatz durchzuführen.
Das Ausführen des 40-Milliarden-Parameter-Modells Falcon 40B ist speicherintensiv. Selbst im 8-Bit-Modus mit reduzierter Präzision (ca. 45 GB RAM) passt das Modell nicht in den Speicher einer einzelnen NVIDIA A100 mit 80 GB.
Mit 4-Bit-Laden und aktuellen Versionen der Bibliotheken bitsandbytes, transformers und accelerate lässt sich der Speicherbedarf auf rund 27 GB RAM reduzieren. So kann Falcon-40B auf 40-GB-A100-GPUs geladen werden.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Falcon 40B mit 4-Bit-Quantisierung auf Consumer-GPUs zu laden und Inferenz auszuführen, ist nicht realistisch. Daher nutzen wir die kleinere Variante Falcon 7B, die sich problemlos in der kostenlosen Version von Google Colab betreiben lässt.
Zunächst installieren wir die nötigen Python-Bibliotheken.
%pip install transformers bitsandbytes accelerate -qAnschließend laden wir die benötigten Module, um das Modell zu laden und die Inferenz zu starten.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Wir verwenden BitsAndBytes, um eine 4-Bit-Quantisierung mit NF4-Konfiguration zu erstellen. Das reduziert den Speicherbedarf und ermöglicht das Laden des Modells auf der Colab-GPU. Lies mehr über 4-Bit-Quantisierung und QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Wir laden das Falcon-7B-Modell und den Tokenizer und erstellen mit der Transformers-Bibliothek eine Textgenerierungspipeline für die Inferenz.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
Gib der Pipeline einen Prompt, um eine Antwort zu generieren.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Das Ergebnis ist überzeugend. Du kannst mit verschiedenen Parametern der Pipeline experimentieren, um die Antworten weiter zu verbessern.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Wenn du Schwierigkeiten hast, Falcon 7B auf Colab auszuführen, kannst du dieses Colab-Notebook als Leitfaden nutzen.
Mit der TRL-Bibliothek und QLoRA kannst du das Modell feinabstimmen. Der folgende Code ist Teil des Finetuning-Prozesses und ermöglicht den Einsatz des SFTTrainer ohne PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Den vollständigen Code zum Finetuning von Falcon-7B auf dem Guanaco-Datensatz findest du im Notebook Falcon-Guanaco.ipynb. Für das Training auf dem Guanaco-Datensatz – einem hochwertigen Teil des Open-Assistant-Datensatzes mit rund 10.000 Dialogen – kannst du die PEFT-Bibliothek zusammen mit dem aktuellen QLoRA-Ansatz nutzen, um Adapter auf dem eingefrorenen 4-Bit-Modell zu finetunen.
Bei Low Rank Adapters (LoRA) ist nur ein sehr kleiner Teil des Modells trainierbar. Dadurch sinken sowohl die Anzahl der gelernten Parameter als auch die Größe des Trainingsartefakts deutlich. Das ermöglicht schnelleres Finetuning bei geringerem Speicherbedarf.
Du kannst das Finetuning auch überspringen und per Retrieval Augmented Generation (RAG) Antworten mit deinen eigenen Dokumenten personalisieren. Folge dazu dem Tutorial LlamaIndex: A Data Framework for Large Language Models (LLMs) based applications.
Außerdem kannst du mit deinem feinabgestimmten Modell LLM-Anwendungen mit LangChain bauen – ähnlich wie mit LlamaIndex.
Falcon-180B wurde auf 3.500 Milliarden Tokens des RefinedWeb-Datensatzes trainiert. Es ist ein kausales Decoder-only-Modell mit 180 Milliarden Parametern, lizenziert unter der Falcon-180B TII, und übertrifft LLaMA-2, StableLM, RedPajama, MPT und weitere Spitzenmodelle auf dem OpenLLM Leaderboard.
Der Nachteil von Falcon 180B: Für die Inferenz werden mindestens 400 GB Speicher benötigt. Kurz gesagt brauchst du etwa 8× A100 mit 80 GB.
Positiv ist, dass TII auch Falcon-180B-Chat veröffentlicht hat, feinabgestimmt auf eine Kombination aus Ultrachat-, Platypus- und Airoboros-Datensätzen. Das Modell erfreut sich in der KI-Community großer Beliebtheit. Du kannst außerdem die Demo auf Hugging Face Spaces ausprobieren und die hohe Antwortqualität selbst erleben.
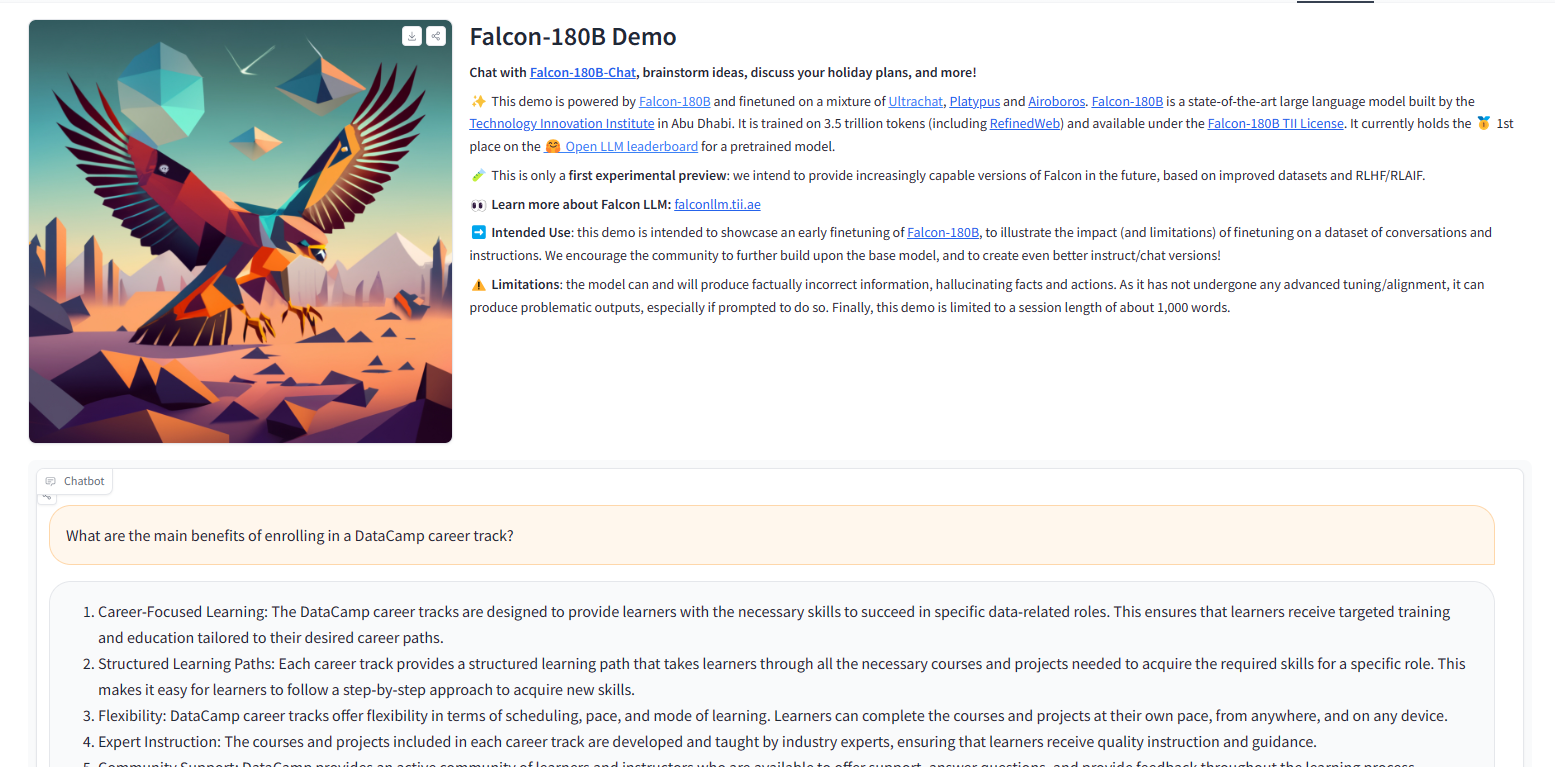
Image from Falcon-180B Demo
Falcon 40B von TII zeigt als Open-Source-Generator für Sprache beeindruckende Leistung. Mit 40 Milliarden Parametern und auf hochwertig gefilterten Webdaten trainiert, erreicht es Bestwerte auf dem OpenLLM Leaderboard.
Während das vollständige Falcon-40B-Modell erhebliche Rechenressourcen erfordert, lässt sich die kleinere 7B-Version mit 4-Bit-Quantisierung auf kostenlosen Colab-GPUs betreiben. Finetuning ist mit QLoRA, PEFT und dem SFT Trainer möglich. Die neue 180B-Variante legt bei der Performance noch einmal zu, benötigt für die Inferenz jedoch rund 400 GB Speicher.
Wenn du eine Karriere im Machine Learning anstrebst und dein eigenes großes Sprachmodell bauen möchtest, wirf einen Blick auf den Machine Learning Scientist with Python-Karrierepfad.
Starte heute deine Machine-Learning-Reise!
Lernpfad
Kurs