
Cursus
Chercheur en apprentissage automatique en Python
85 h
Pour tirer pleinement parti de cet article sur Falcon 40B, il est préférable d’avoir des bases en apprentissage automatique et en traitement du langage naturel. Une familiarité avec les modèles de type transformer et leurs composants, comme les mécanismes d’attention et les embeddings positionnels, sera un atout.
Si vous débutez en IA et souhaitez assimiler les fondamentaux, suivez notre parcours de compétences AI Fundamentals. Vous y découvrirez ChatGPT, le machine learning, les LLM, l’IA générative et l’éthique de l’IA.
Falcon 40B fait partie de la famille de grands modèles de langue (LLM) Falcon développée par le Technology Innovation Institute (TII), aux côtés de Falcon 7B et Falcon 180B. En tant que modèle causal de décodage uniquement, Falcon 40B est conçu pour différentes tâches de génération de texte.
Falcon 40B est multilingue : il gère l’anglais, l’allemand, l’espagnol et le français, avec une maîtrise plus limitée d’autres langues comme l’italien, le portugais, le polonais, le néerlandais, le roumain, le tchèque et le suédois.
L’architecture de Falcon 40B est adaptée de GPT-3 mais comporte des modifications clés pour améliorer les performances. Elle utilise des embeddings positionnels rotatifs pour une meilleure compréhension des séquences. Les mécanismes d’attention sont enrichis par la multi-query attention et FlashAttention. Le bloc décodeur combine une attention parallèle et des structures MLP (perceptron multicouche) avec une double normalisation, afin d’optimiser l’efficacité de calcul.
Falcon 40B a été entraîné sur 1 billion de jetons extraits de RefinedWeb, un corpus web filtré pour la qualité, complété par d’autres jeux de données sélectionnés. Plutôt que d’agréger des sources curatoriales éparses, TII a amélioré la qualité des données web par une déduplication à grande échelle et un filtrage strict, obtenant ainsi un jeu d’entraînement de haute qualité qui contribue aux performances élevées des modèles Falcon.
Falcon 40B a été entraîné sur AWS SageMaker avec 384 GPU A100 40 Go, en s’appuyant sur une parallélisation 3D (TP=8, PP=4, DP=12) couplée à ZeRO. L’entraînement a démarré en décembre 2022 et s’est achevé en deux mois.
Apprenez à entraîner des LLM avec PyTorch, de l’installation à la mise en œuvre finale, en suivant le tutoriel How to Train a Large Language Model with PyTorch.
Contrairement au schéma multi-têtes traditionnel, Falcon 40B utilise la multi-query attention, où une clé et une valeur sont partagées par toutes les têtes d’attention. Ce mécanisme innovant n’impacte pas significativement le pré-entraînement, mais améliore fortement la scalabilité en inférence.
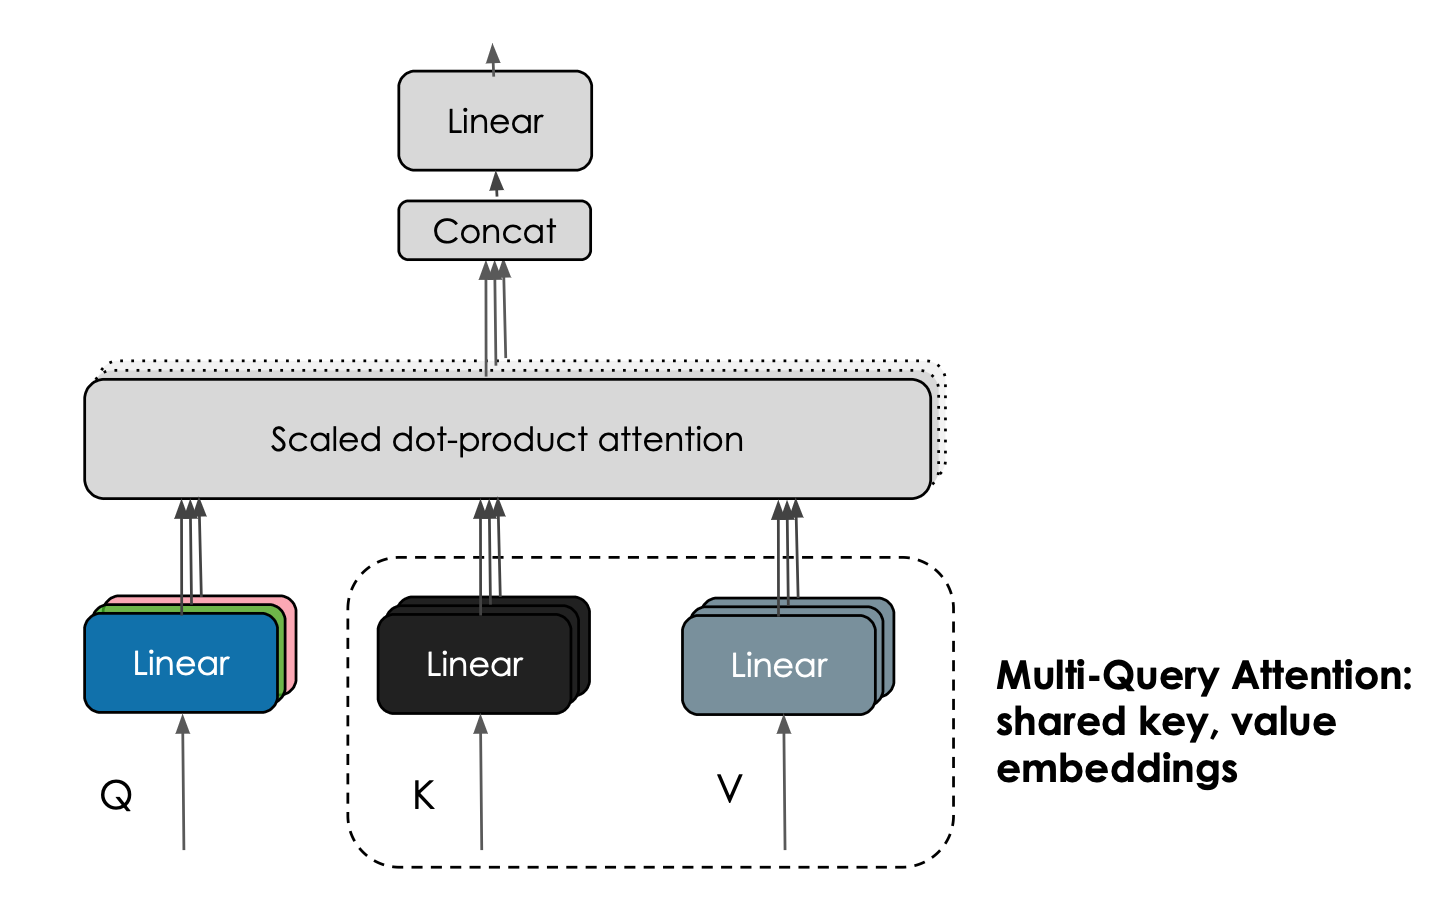
Image tirée du blog Falcon
TII a également publié des versions instruct des modèles, Falcon-7B-Instruct et Falcon 40B-Instruct, affinées sur des instructions et des données conversationnelles pour de meilleures performances sur les tâches de type assistant.
Même si Falcon 40B requiert une mémoire GPU importante, la quantification permet de le rendre accessible sur des GPU plus abordables ; vous pouvez également exécuter une version plus petite, Falcon-7B, sur Google Colab.
Falcon 40B surpasse d’autres modèles open source comme LLaMA, StableLM, RedPajama et MPT, comme l’indique le OpenLLM Leaderboard. Ses performances en font une référence parmi les modèles open source disponibles.
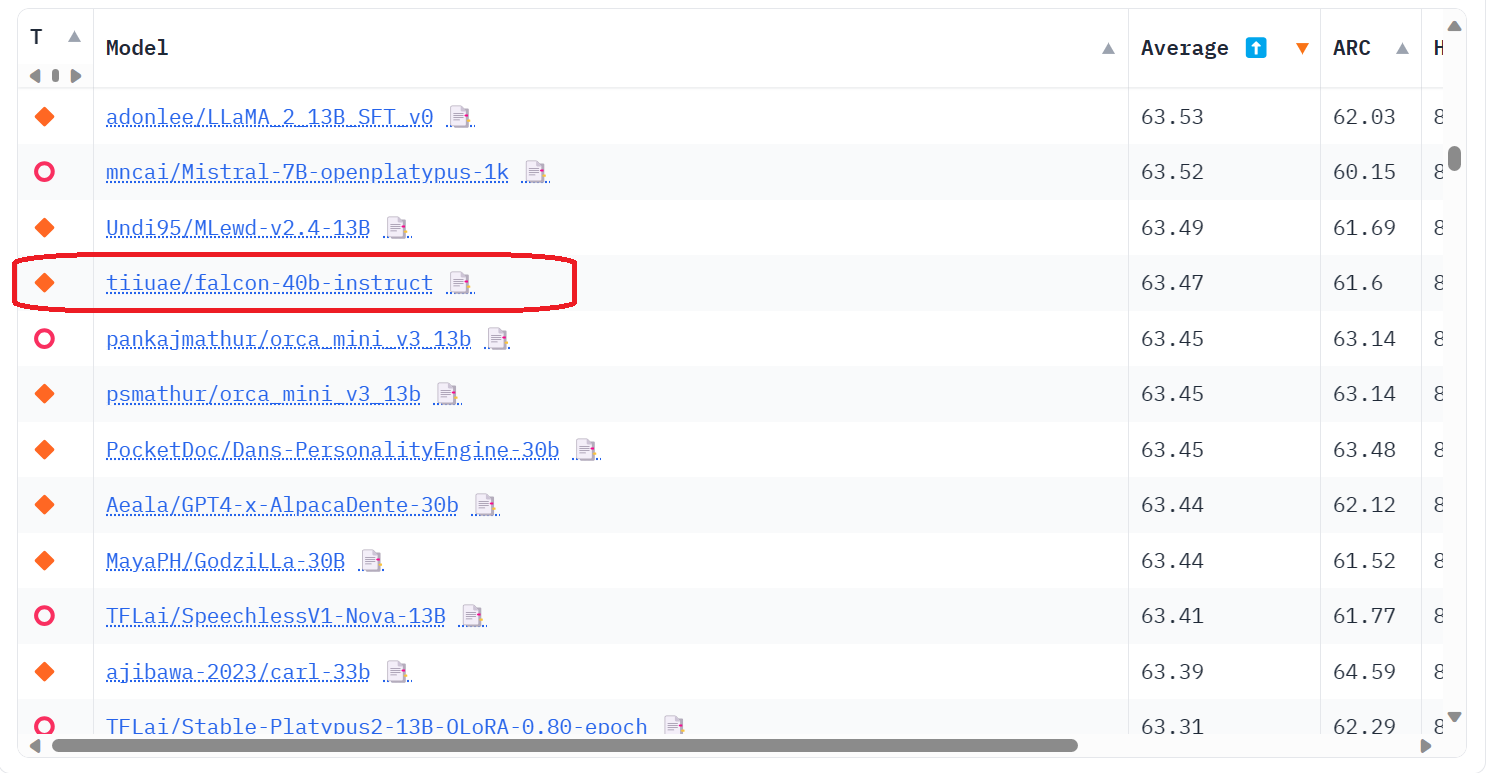
Image tirée de l’Open LLM Leaderboard
L’architecture de Falcon 40B est optimisée pour une inférence efficace grâce à des fonctionnalités comme FlashAttention et la multi-query attention, ce qui améliore la vitesse et la montée en charge. Il s’agit d’un modèle de langue brut pré-entraîné qui nécessite un affinage supplémentaire pour la plupart des cas d’usage.
Falcon 40B est distribué sous licence Apache 2.0, vous autorisant à utiliser le modèle et le jeu de données à des fins commerciales sans redevances ni restrictions.
Dans cette section, nous verrons comment charger le modèle Falcon 40B et exécuter l’inférence. Nous verrons également comment lancer l’inférence pour la version plus petite Falcon 7B sur Google Colab avec une quantification 4 bits. Enfin, nous apprendrons à utiliser QLoRA et SFT Trainer pour affiner le modèle sur un nouveau jeu de données.
L’exécution du modèle Falcon 40B (40 milliards de paramètres) pose des défis mémoire. Le modèle dépasse la capacité mémoire d’un seul GPU NVIDIA A100 80 Go, même en précision réduite 8 bits, qui nécessite environ 45 Go de RAM.
En chargeant en précision 4 bits avec les dernières versions des bibliothèques bitsandbytes, transformers et accelerate, l’empreinte mémoire peut être ramenée à environ 27 Go. Cela permet de charger Falcon-40B sur des GPU A100 40 Go.
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model = "tiiuae/falcon-40b"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    trust_remote_code=True,
    device_map="auto",
)

prompt = "What are the main benefits of enrolling in a DataCamp career track?"

sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
print(f"Result: {seq['generated_text']}")Charger Falcon 40B et exécuter l’inférence en quantification 4 bits n’est pas possible sur des GPU grand public. Nous utiliserons donc la version plus légère Falcon 7B, exécutable facilement sur la version gratuite de Google Colab.
Nous allons installer toutes les bibliothèques Python nécessaires.
%pip install transformers bitsandbytes accelerate -qPuis charger les modules requis pour charger le modèle et exécuter l’inférence.
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import transformers
import torch
Nous utilisons BitsAndBytes pour créer une quantification 4 bits avec une configuration de type NF4. Cela réduit l’empreinte mémoire et nous permet de charger le modèle sur le GPU de Colab. Lisez-en plus sur la quantification 4 bits et QLoRA.
compute_dtype = getattr(torch, "float16")

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=compute_dtype,
    bnb_4bit_use_double_quant=False,
)
Nous allons charger le modèle et le tokenizer Falcon 7B, puis créer un pipeline de génération de texte avec la bibliothèque Transformers pour lancer l’inférence.
model_name = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    quantization_config=bnb_config,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
En fournissant une invite au pipeline, nous pouvons générer une réponse.
prompt = "What are the main benefits of enrolling in a DataCamp career track?"
sequences = pipeline(
    prompt,
    max_length=100,
    do_sample=True,
    top_k=20,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Le résultat est convaincant. Vous pouvez expérimenter différents paramètres du pipeline pour améliorer encore la réponse du modèle.
Result: What are the main benefits of enrolling in a DataCamp career track? A: When you enroll in a DataCamp career track you have the opportunity to: - Build a solid foundation in one specific topic. - Learn new data science skills. - Gain valuable job search and interview prep tools. - Build a project portfolio that you can easily showcase to potential employers. - Network with thousands of like-minded people from diverse backgrounds.Si vous rencontrez des difficultés pour exécuter Falcon 7B sur Colab, vous pouvez utiliser le notebook Colab comme guide.
Avec la bibliothèque TRL et QLoRA, nous pouvons affiner le modèle. Le code suivant fait partie du processus de fine-tuning et permet d’exécuter SFTTrainer sans PEFT.
from datasets import load_dataset
from trl import SFTTrainer

dataset = load_dataset("timdettmers/openassistant-guanaco
", split="train")

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
Vous pouvez consulter le notebook Falcon-Guanaco.ipynb pour le code d’affinage de Falcon-7B sur le jeu de données Guanaco. Pour entraîner le modèle sur Guanaco — un sous-ensemble de haute qualité du jeu de données Open Assistant contenant environ 10 000 dialogues — nous pouvons utiliser la bibliothèque PEFT avec l’approche récente QLoRA pour affiner des adaptateurs placés au-dessus du modèle gelé en 4 bits.
Avec les adaptateurs de bas rang (LoRA), seule une petite fraction du modèle est entraînable, ce qui réduit fortement le nombre de paramètres appris et la taille de l’artefact entraîné. Le fine-tuning est ainsi plus rapide et moins gourmand en mémoire.
Vous pouvez aussi ignorer l’affinage et utiliser la Retrieval Augmented Generation (RAG) pour personnaliser la réponse en donnant accès à vos documents privés. Suivez pour cela le tutoriel LlamaIndex : un cadre de données pour les applications basées sur les LLM.
Vous pouvez également créer des applications LLM avec LangChain en utilisant votre modèle fraîchement affiné, sur le même principe que LlamaIndex.
Falcon-180B a été entraîné sur 3¥000 milliards de jetons du jeu de données RefinedWeb. Il s’agit d’un modèle causal de décodage uniquement comptant 180 milliards de paramètres, sous licence Falcon-180B TII, qui surpasse LLaMA-2, StableLM, RedPajama, MPT et d’autres modèles en tête de classement sur l’OpenLLM Leaderboard.
L’inconvénient de Falcon 180B est que l’inférence requiert au moins 400 Go de mémoire. En bref, il faut environ 8×A100 80 Go.
Point positif : TII a également lancé Falcon-180B-Chat, affuté sur un mix de jeux de données Ultrachat, Platypus et Airoboros. Il a rencontré un grand succès auprès de la communauté IA. Vous pouvez également tester la démo sur les Spaces Hugging Face et apprécier la qualité des réponses.
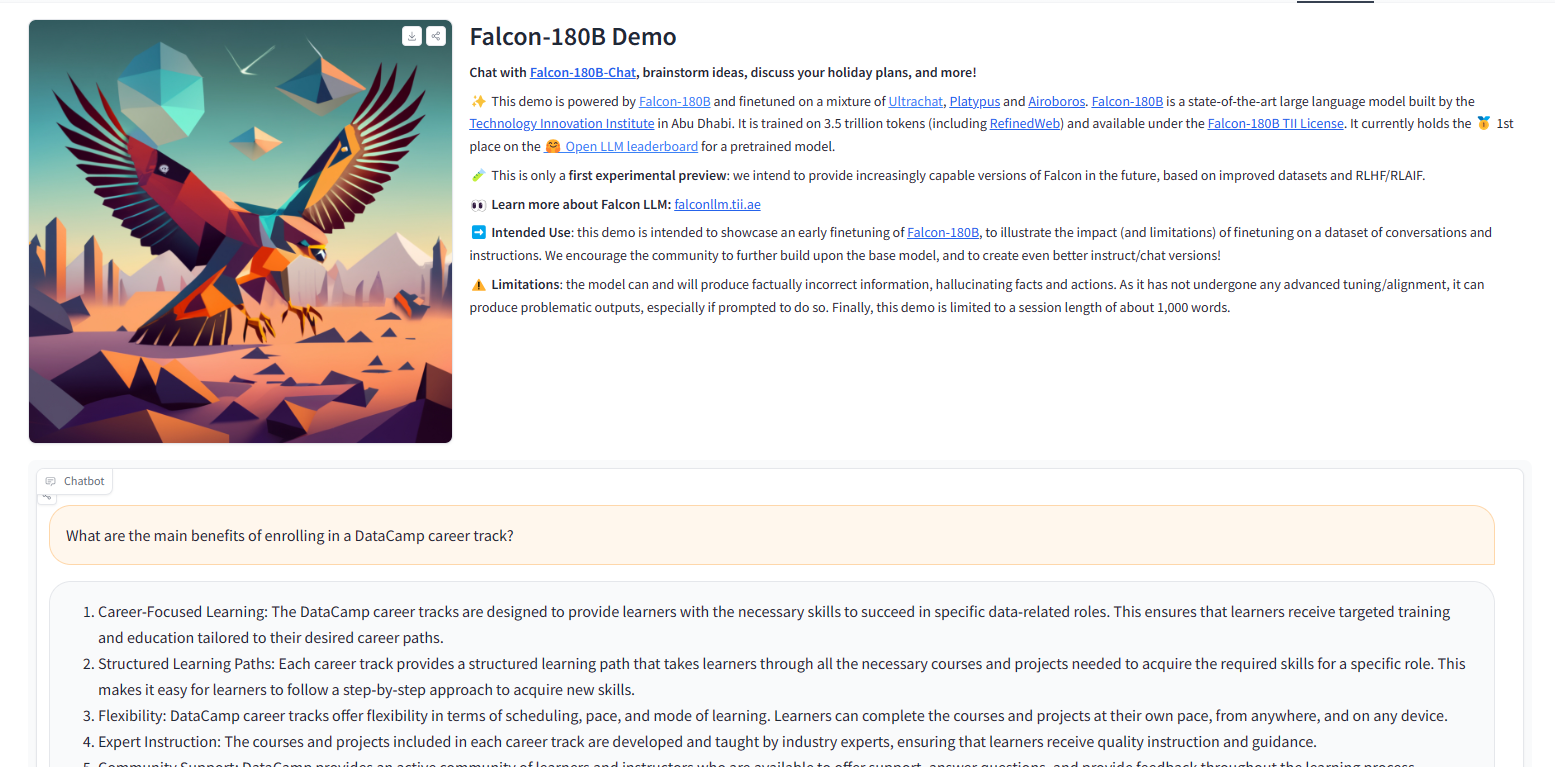
Image tirée de la démo Falcon-180B
Falcon 40B de TII offre des performances impressionnantes en tant que modèle génératif open source. Avec 40 milliards de paramètres et un entraînement sur des données web filtrées de haute qualité, il obtient des résultats de pointe sur l’OpenLLM Leaderboard.
Si la version complète Falcon 40B demande des ressources de calcul importantes, la version 7B peut être exécutée sur des GPU Colab gratuits via une quantification 4 bits. Le fine-tuning est possible avec QLoRA, PEFT et SFT Trainer. La nouvelle version Falcon 180B pousse les performances encore plus loin, mais requiert 400 Go rien que pour l’inférence.
Si vous envisagez une carrière en machine learning et souhaitez construire votre propre grand modèle de langue, envisagez le parcours métier Machine Learning Scientist with Python.
Débutez votre parcours en machine learning dès aujourd’hui !
Cursus
Cours