
Last chance! 50% off DataCamp Premium
Sale ends in
Baru-baru ini saya menemukan sebuah platform AI yang secara otomatis membuat kartu kilat dari berbagai jenis media. Karena saya suka menghafal konsep dengan pengulangan bertahap, saya langsung mengunggah tutorial XGBoost saya dan meminta AI membuat 50 kartu kilat darinya.
Namun, saya kecewa. Sebagian besar pertanyaannya terlalu mudah, dan sangat sedikit yang menyentuh sintaks kode. Lebih aneh lagi, 10% pertanyaannya identik dan sama sekali di luar konteks — “Apakah ibu kota Prancis?”
Jenis kesalahan seperti ini menunjukkan kurangnya evaluasi dan validasi yang layak terhadap keluaran layanan AI. Mungkin mereka belum tahu tentang LangSmith.
LangSmith adalah platform lengkap untuk menguji, men-debug, dan mengevaluasi aplikasi LLM. Mungkin fitur terpentingnya adalah evaluasi keluaran LLM dan pemantauan kinerja. Dalam tutorial ini, kita akan melihat kerangka kerjanya secara langsung dan mempelajari teknik untuk menerapkannya di proyek Anda sendiri.
Mari kita mulai!
Seperti yang saya sebutkan di atas, LangSmith adalah platform komprehensif untuk mengevaluasi aplikasi bahasa berskala besar. Berikut beberapa fiturnya dan manfaat nyata yang dibawanya:
Programmer dapat mulai bereksperimen dengan LangSmith dalam hitungan menit, bukan jam. Artinya, tim kecil atau pengembang solo dapat membuat prototipe aplikasi AI selama akhir pekan dan berpotensi merilis layanan berbayar pada hari Senin.
Dengan alat evaluasi yang ketat, perusahaan dapat menghindari rasa malu dan biaya akibat rilis AI yang cacat (seperti contoh yang saya berikan di pendahuluan). LangSmith memungkinkan Anda memeriksa keluaran LLM terhadap kriteria bawaan seperti kegunaan, koherensi, misogini, atau bahkan evaluasi kustom dalam bahasa alami seperti “Apakah konten keluarannya klise?” atau, dalam kasus pembuatan kartu kilat, “Apakah kartu berisi pertanyaan tentang pemrograman?”
LangSmith menggunakan jejak (trace) untuk mencatat hampir setiap aspek eksekusi LLM. Ini mencakup metrik seperti latensi, jumlah token, biaya eksekusi, dan semua jenis metadata. Antarmuka Web memungkinkan Anda memfilter eksekusi dengan cepat berdasarkan persentase kesalahan, latensi, tanggal, atau bahkan berdasarkan konten teks menggunakan bahasa alami. Artinya, jika misalnya tutor AI mulai bermasalah dalam merespons siswa sungguhan, Anda dapat merilis perbaikan dalam beberapa jam.
LangChain adalah kerangka kerja induk LangSmith yang berfokus khusus pada fase pengembangan LLM. Ia menawarkan desain perangkat lunak modular untuk merangkai banyak LLM (agen) dan mengintegrasikannya dengan API lain seperti YouTube, Google Search, dan sebagainya. LangSmith adalah lapisan pemungkas yang memastikan prototipe yang dibangun dengan LangChain berkinerja sesuai harapan melalui alat evaluasi dan pemantuan yang kuat.
Lihat tutorial Aplikasi LLM dengan LangChain kami untuk mempelajari lebih lanjut tentang LangChain.
Fitur hebat lain dari LangSmith adalah dataset. Dataset dapat digunakan untuk meningkatkan rantai, agen, atau model LangChain terhadap serangkaian contoh terstandar sebelum diterapkan. Misalnya, kita mungkin memiliki file CSV yang berisi dua kolom — pertanyaan dan jawaban untuk kartu kilat dalam format tertentu.
Dengan mengonversi file ini menjadi dataset referensi, kita dapat menginstruksikan LLM untuk mengevaluasi keluarannya sendiri menggunakan metrik penjaminan kualitas yang disebutkan sebelumnya.
Sekarang kita akan melihat semua fitur ini melalui contoh satu per satu.
Dalam pengembangan aplikasi ML, Anda mengumpulkan data, melatih, fine-tune, menguji, dan menerapkan model — langkah-langkahnya jelas. Namun, dengan aplikasi LLM, Anda sering memulai dengan model siap pakai dari vendor. Fine-tuning? Itu bisa mahal. Jadi, Anda akan banyak fokus pada perancangan prompt yang tepat — intinya adalah menanyakan pertanyaan yang tepat pada aplikasi LLM Anda. Anggap saja Anda membutuhkan banyak prompt untuk uji coba, sebagaimana Anda memerlukan banyak data untuk model ML yang bagus.
Namun, dengan prompt, Anda berurusan dengan teks yang masuk dan keluar, bukan angka. Jadi cara biasa untuk mengukur kesalahan atau akurasi, seperti MSE atau cross-entropy, tidak berlaku di sini. Selain itu, bayangkan harus membaca setiap input dan output untuk evaluasi — itu akan memakan waktu berhari-hari jika Anda punya ribuan prompt untuk dinilai.
Jadi, Anda memerlukan alur kerja yang berfokus pada pembuatan dan pengujian prompt secara efisien untuk melihat performa aplikasi LLM Anda, tanpa tenggelam dalam pemeriksaan manual. Kira-kira seperti inilah bentuknya:
Pada tahap ini, Anda akan membuat prototipe fondasi aplikasi menggunakan kerangka kerja seperti LangChain. Untuk proyek pembuat kartu kilat, prototipe Anda mungkin mencakup beberapa komponen di atas LLM pilihan Anda dari vendor. Misalnya, Anda mungkin perlu merangkainya dengan:
dan seterusnya (lihat jenis komponen yang bisa Anda tambahkan dari laman dokumentasi LangChain ini). Namun Anda bisa memangkas waktu pengembangan secara drastis dengan menggunakan rantai siap pakai yang ditawarkan LangChain untuk tugas tingkat tinggi yang umum.
Pada tahap ini, Anda akan menguji aplikasi terhadap sebanyak mungkin skenario. Artinya, Anda harus memastikan setiap komponen yang ditambahkan bekerja baik, tersusun dengan baik, dan menghasilkan keluaran yang konsisten serta berkualitas tinggi.
Mengingat LLM bersifat non-deterministik (mereka tidak menghasilkan keluaran yang sama untuk input yang sama) dan kompleksitas komponen yang ditambahkan, Anda akan menghabiskan sebagian besar waktu di tahap ini. Dan LangSmith dikembangkan dengan tujuan tunggal untuk membuat waktu itu sesingkat mungkin. Kita akan membahasnya lebih lanjut sepanjang tutorial.
Setelah Anda memiliki aplikasi yang layak, Anda dapat menerapkannya sebagai REST API. REST API pada dasarnya mengonversi rantai atau agen LangChain Anda yang ada menjadi tautan HTTPS yang bisa diberi permintaan oleh pihak lain untuk berinteraksi dengan model AI Anda. Sekarang, Anda akan membangun antarmuka pengguna layanan Anda seperti aplikasi desktop atau, yang lebih umum, situs web.
Saat ini, belum ada cara mudah untuk melakukan ini, tetapi pengembang LangChain akan merilis LangServe, yang akan terintegrasi dengan FastAPI (kedengarannya keren, bukan?). Lihat cuplikan awalnya di laman dokumentasi ini.
Sekarang, mari akhirnya mulai mengotak-atik LangSmith.
Kita akan mulai dengan memahami antarmuka web. Antarmuka tersedia melalui tautan smith.langchain.com. Untuk akses, Anda harus mendaftar dan menunggu persetujuan dari daftar tunggu, karena saat ini masih dalam beta tertutup.
Namun setelah masuk, halaman arahan akan terlihat seperti ini:
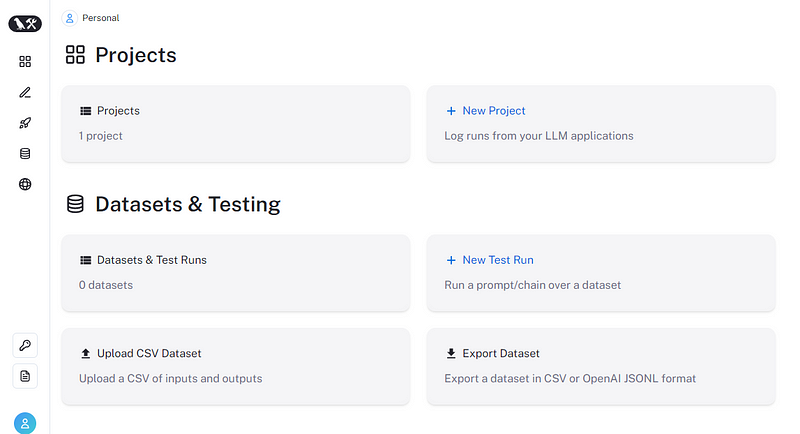
Dua bagian utama adalah projects dan datasets & testing, dan keduanya dapat dimanipulasi melalui Python SDK. Platform ini juga memiliki tab untuk deployment dan antrian anotasi, tetapi itu di luar cakupan artikel ini.
Mengelola proyek di LangSmith jauh lebih mudah dengan Python SDK-nya, yang terhubung ke platform melalui kunci API.
Untuk mendapatkan kunci, klik ikon kunci di platform dan simpan di tempat yang aman. Lalu, di direktori baru dengan lingkungan virtual baru yang sudah diinisialisasi, buat file .env. Di dalamnya, tempel dua baris berikut:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Selanjutnya, di terminal Anda, jalankan perintah berikut untuk memasang LangSmith dan python-dotenv untuk membaca variabel lingkungan:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Sekarang saatnya menulis kode:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
Kita mengimpor fungsi find_dotenv dan load_dotenv untuk membaca variabel lingkungan dan menyiapkannya dengan os:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Mengatur LANGCHAIN_TRACING_V2 ke True mengaktifkan tracing (pencatatan), yang penting untuk debugging LLM. Setelah itu, kita inisialisasi klien untuk berkomunikasi dengan platform LangSmith:
from langsmith import Client

# Initialize a client
client = Client()
client berisi perintah tingkat tinggi untuk memanipulasi proyek dan aset di LangSmith. Perintah pertama klien yang akan kita gunakan adalah membuat proyek baru:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
Setelah create_project berhasil dijalankan, Anda dapat melihat proyeknya tercantum di bagian Projects pada antarmuka web:
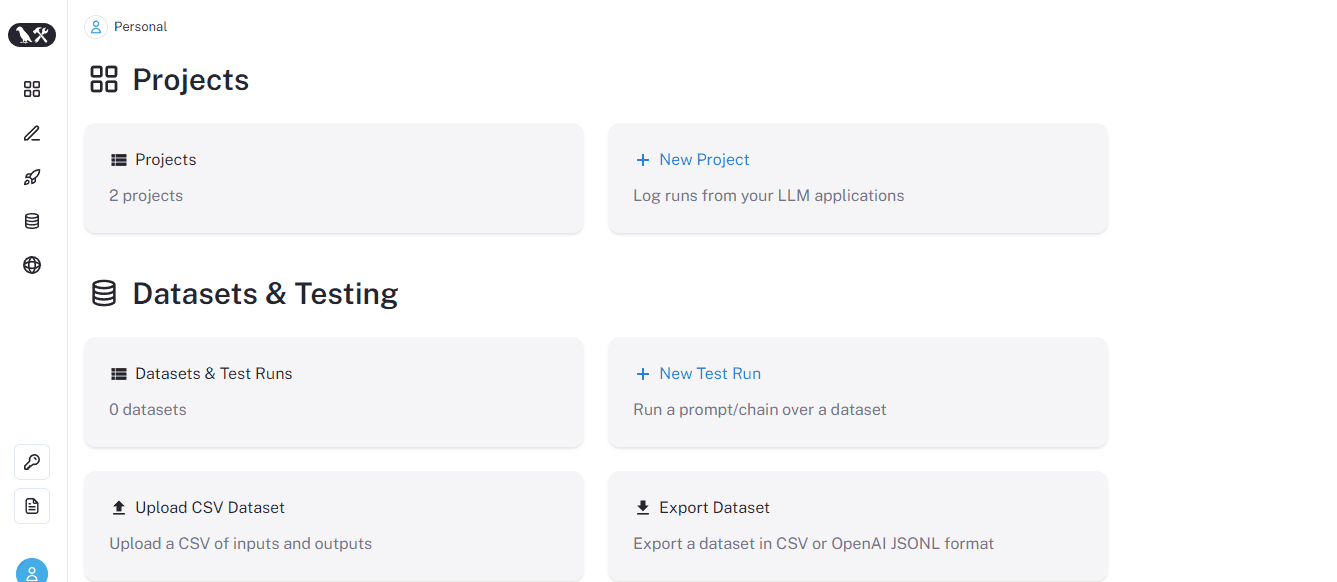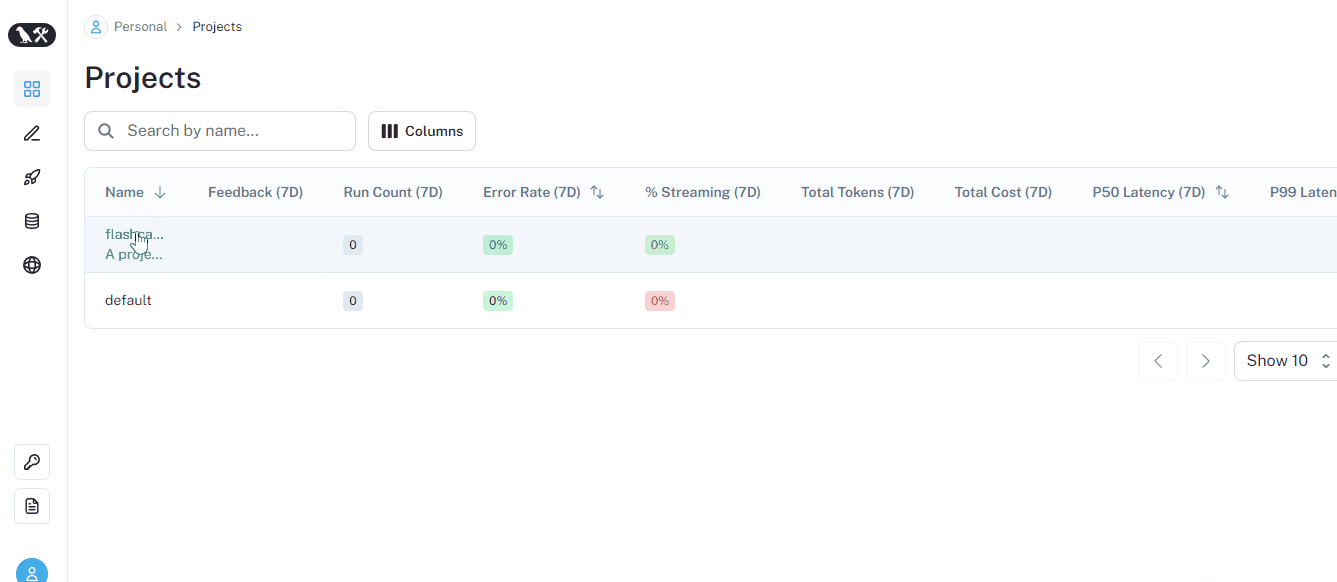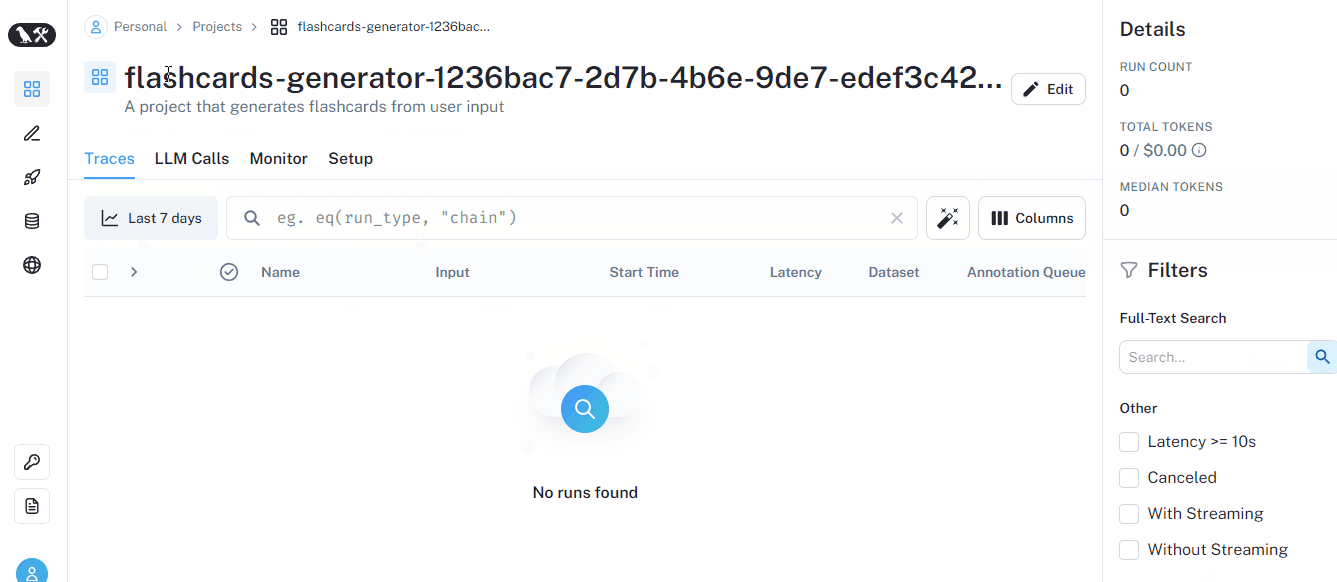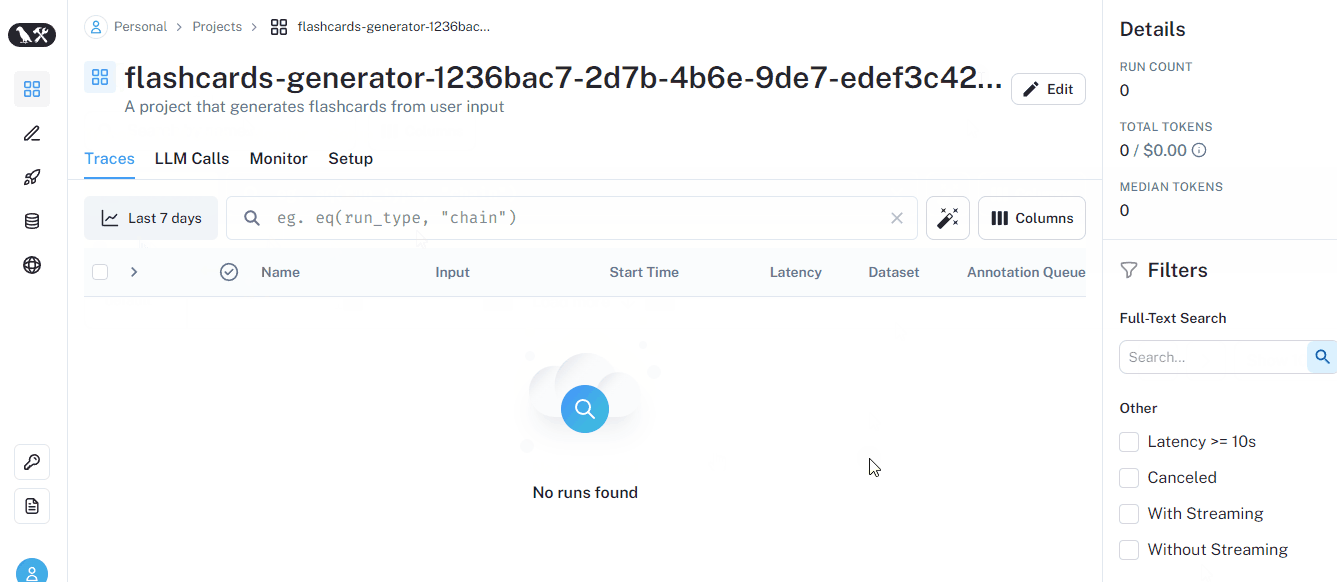
Berikutnya, kita perlu mengatur proyek baru sebagai bawaan dengan variabel lingkungan lain:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Sekarang, kita memerlukan LLM untuk proyek kita. Kita akan menggunakan GPT-3.5 turbo karena lebih murah, tetapi Anda dapat menggunakan banyak model lain yang tersedia melalui langchain. Model OpenAI diinisialisasi melalui kelas ChatOpenAI.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Mari lakukan eksekusi pertama kita:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
Jika Anda cepat memeriksa proyek dari antarmuka, Anda akan melihat eksekusi di atas terlacak (tercatat):
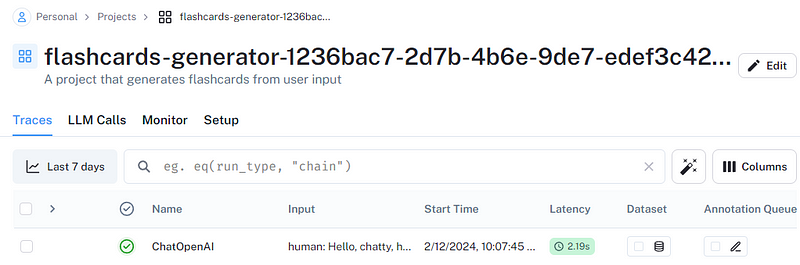
Saat kita menyiapkan variabel lingkungan dan klien, kita otomatis mengaktifkan pencatatan. Seperti yang Anda lihat, kita sudah memiliki banyak metadata tentang eksekusi tersebut.
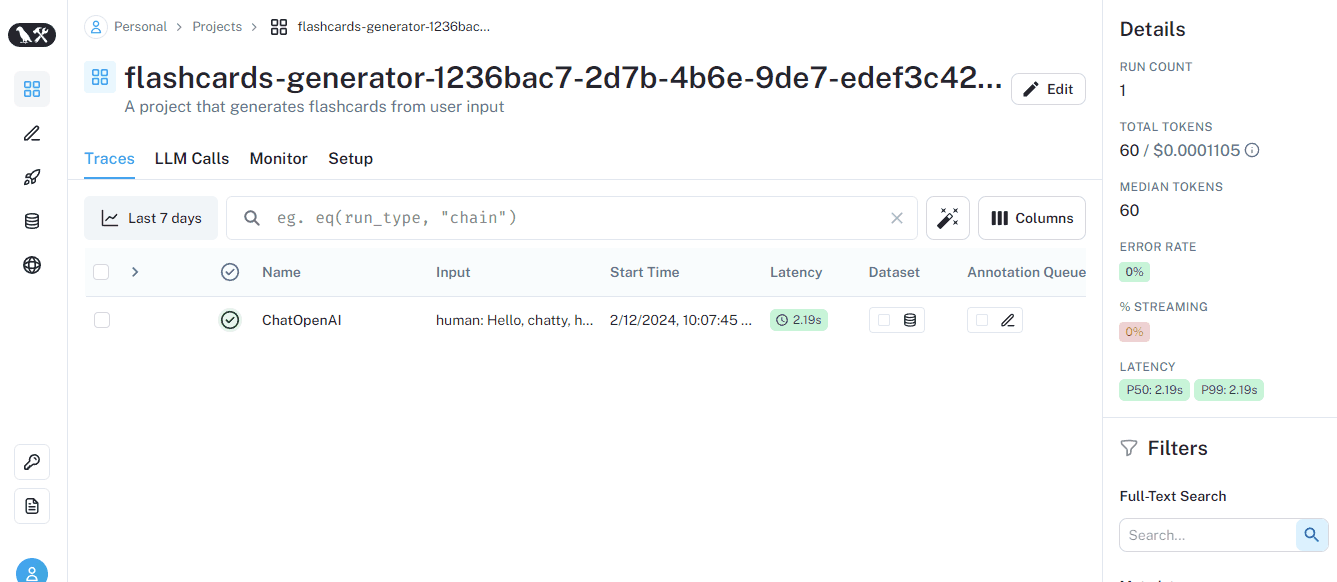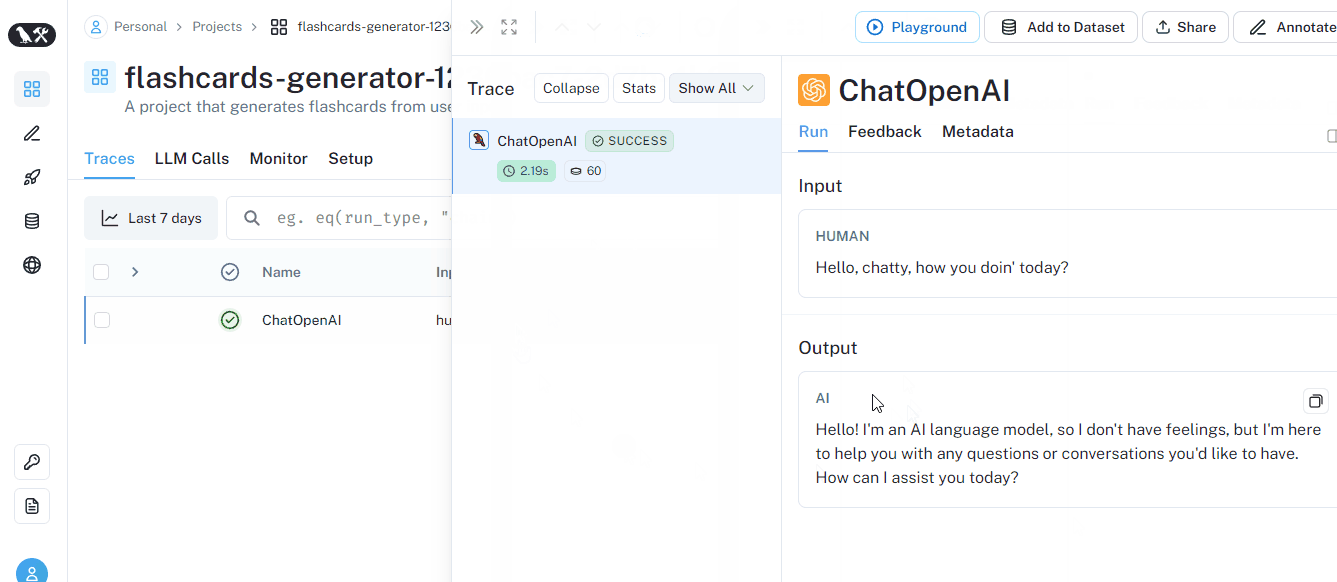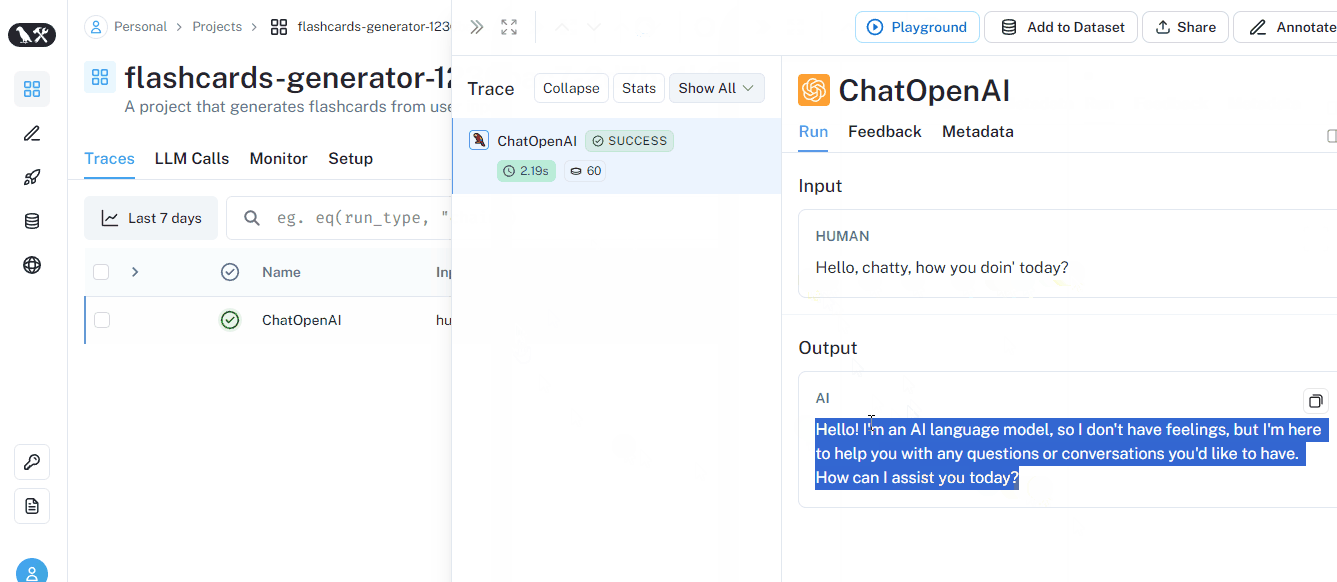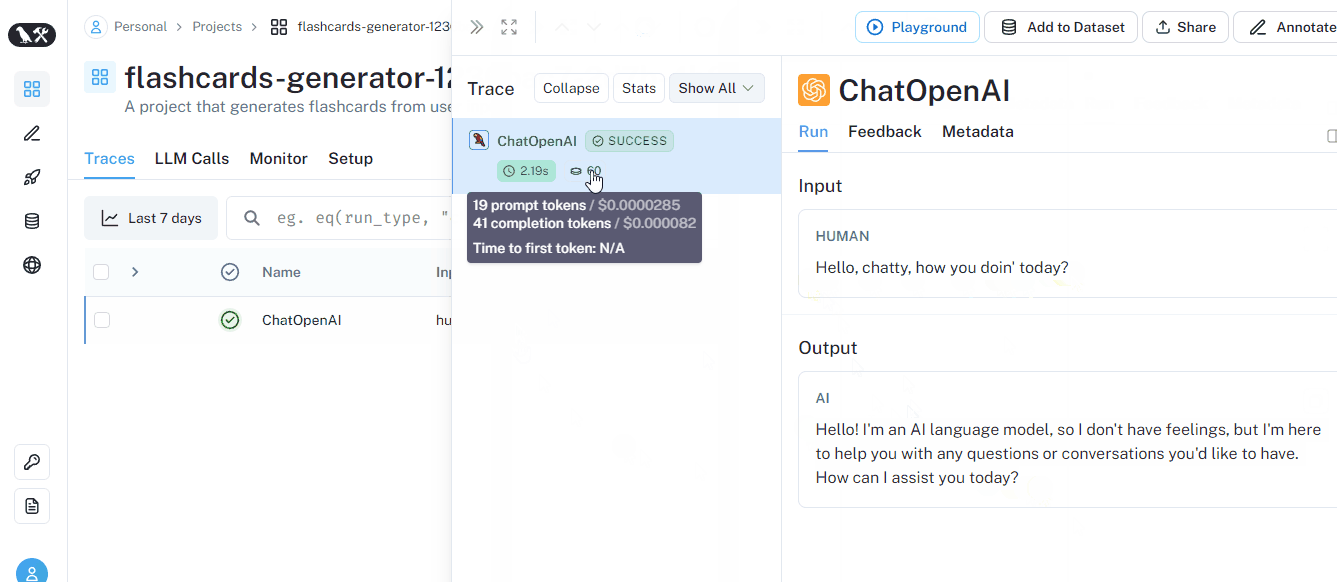
Mari jalankan beberapa prompt lagi:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Kita sudah bisa membuat peringkas teks dasar. Mari rangkum keluaran dari eksekusi terakhir:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Bagus, sekarang saatnya membuat dataset pertama kita.
Seperti yang saya sebutkan di bagian “Alur kerja pengembangan aplikasi LLM”, Anda kemungkinan perlu membuat atau mengumpulkan ribuan prompt untuk mengevaluasi model, rantai, atau agen LLM Anda. Jadi, menjalankannya satu per satu seperti di atas bukan praktik terbaik.
Karena itu, LangSmith menawarkan dataset dalam tiga tipe:
kv) - bawaan: Mendefinisikan input sebagai pasangan kunci-nilai arbitrer. Berguna saat mengevaluasi rantai dan agen yang memerlukan banyak input atau menghasilkan banyak output.llm): Input dan output didefinisikan dalam “gaya penyelesaian” oleh LLM — string masuk, string keluar.chat): Dataset yang dikonversi dari percakapan LLM dan didefinisikan menggunakan input terstruktur serta pesan terserialisasi.Pertama, mari lihat cara membuat dataset key-value tanpa output. Kita akan menggunakan fungsi create_dataset dari client:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Sekarang, mari tambahkan tiga input yang masing-masing meminta LLM untuk membuat satu kartu kilat:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
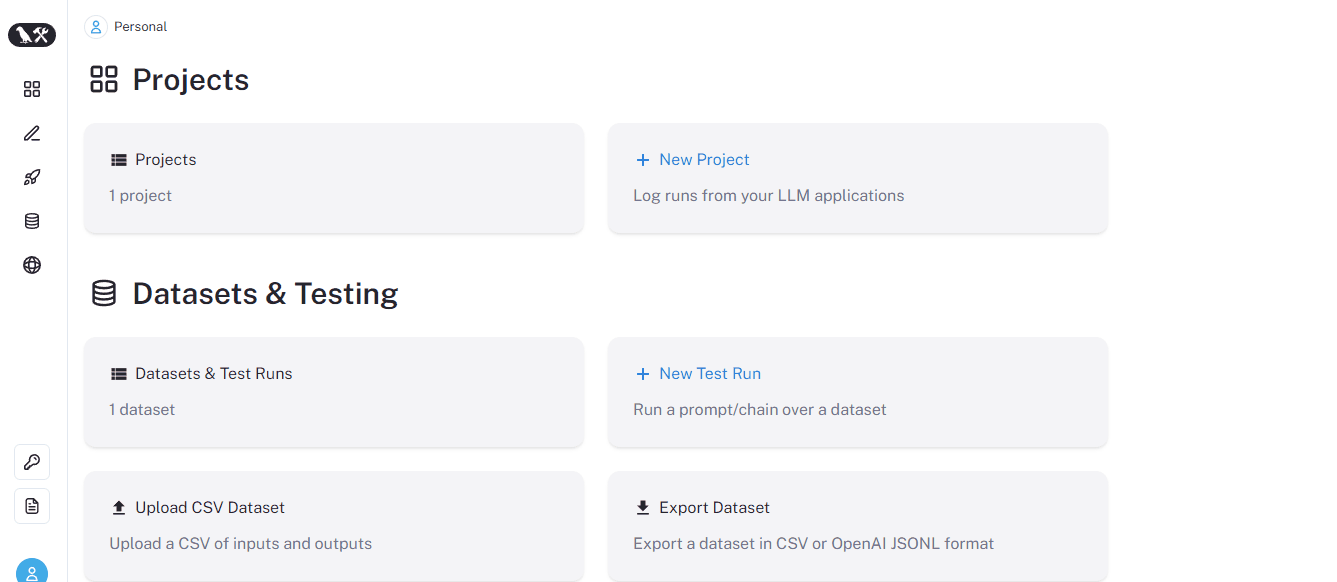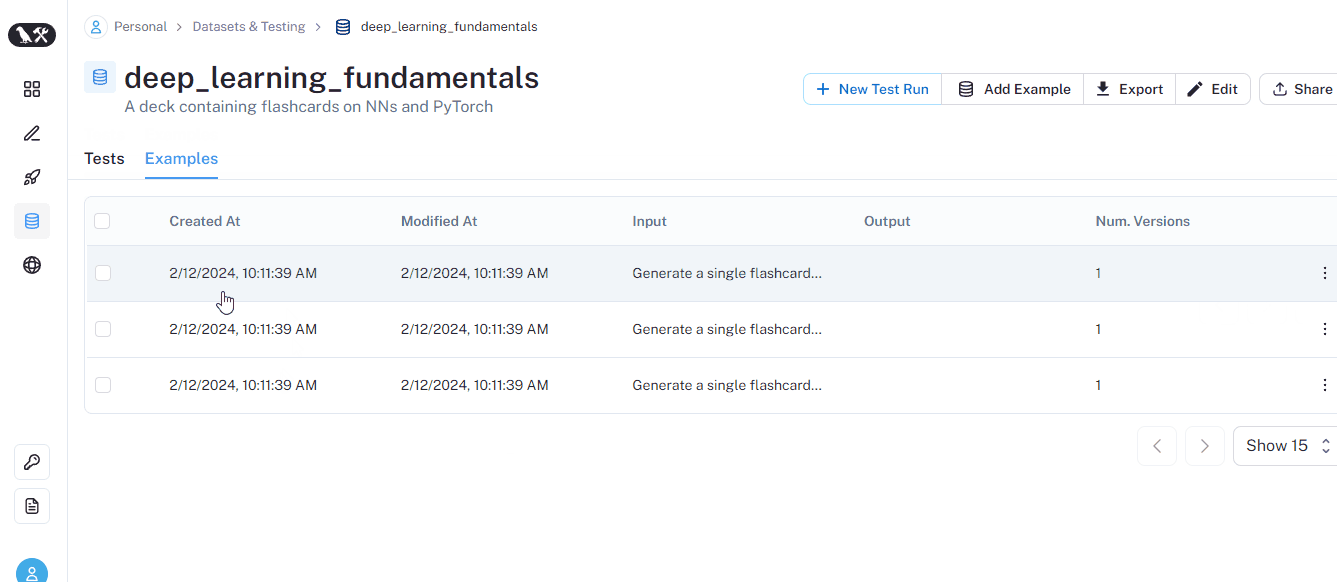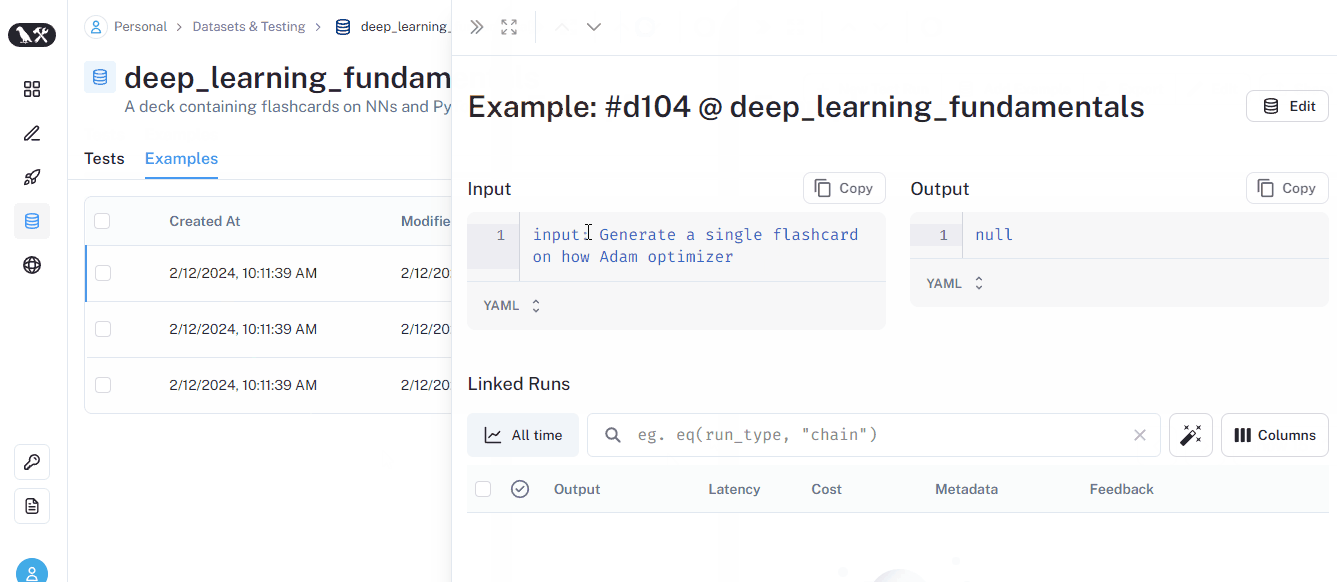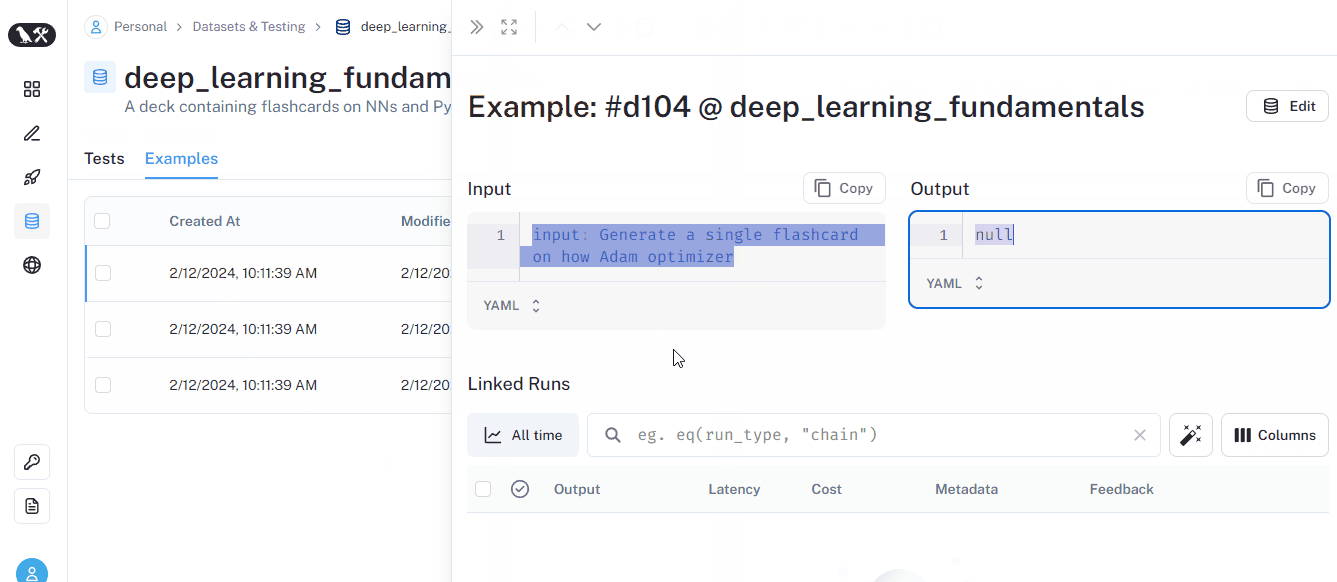
Jika Anda membuka tab dataset pada antarmuka, Anda akan melihat setiap prompt tercantum dengan output NULL:
Sekarang, mari jalankan semua prompt dalam satu baris kode menggunakan fungsi run_on_dataset:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
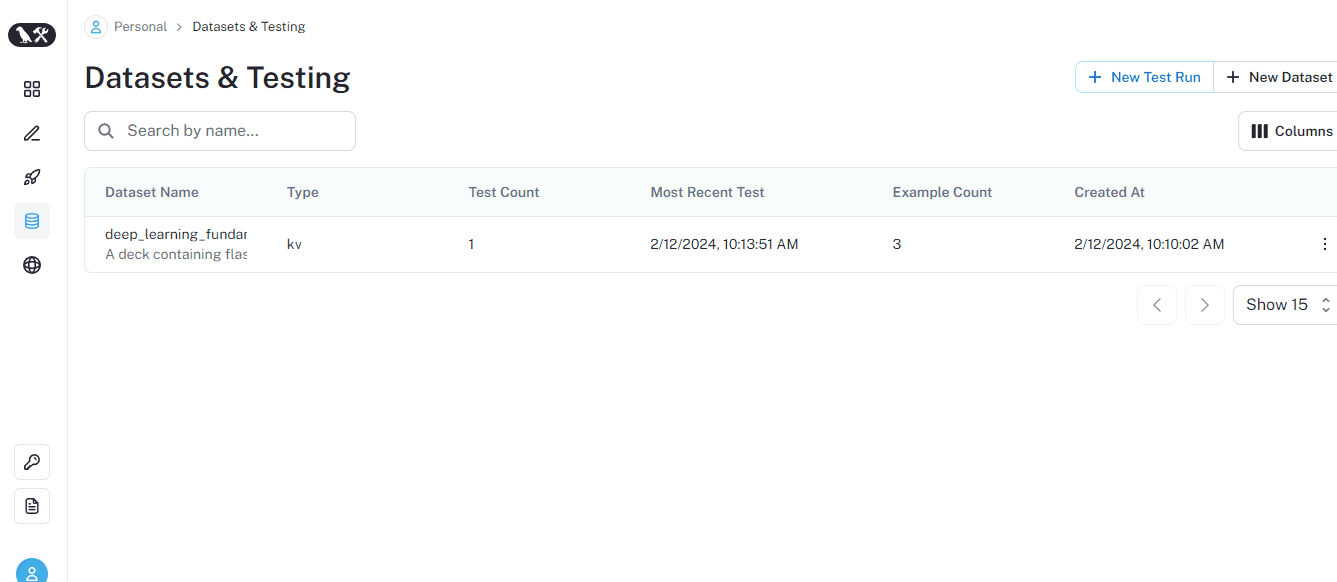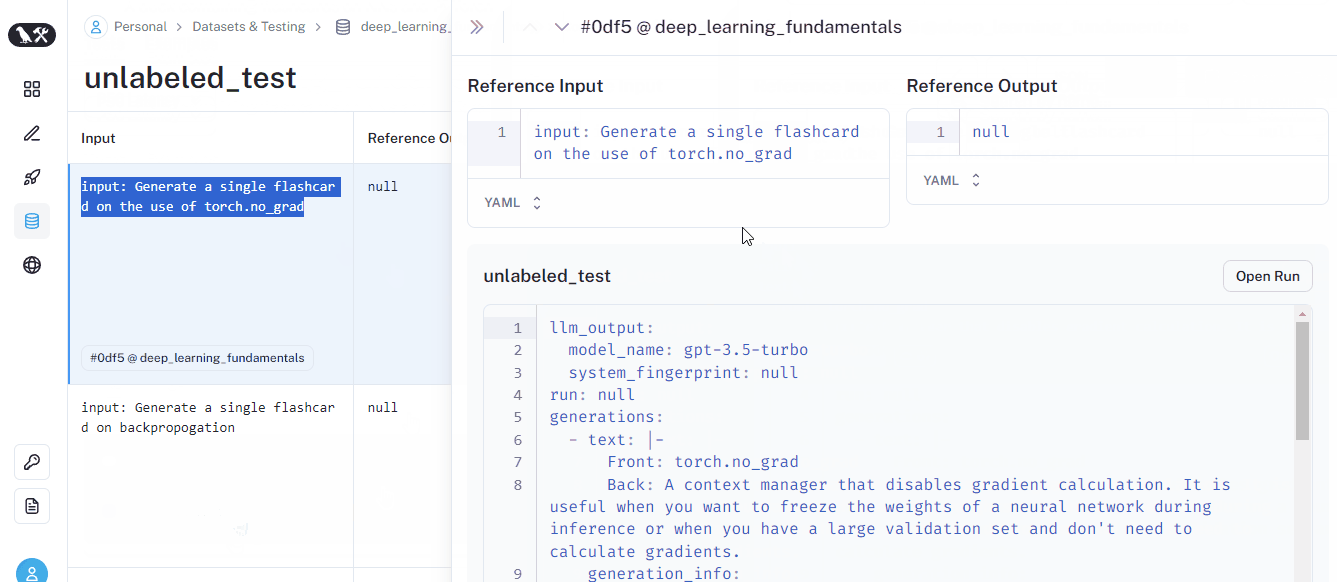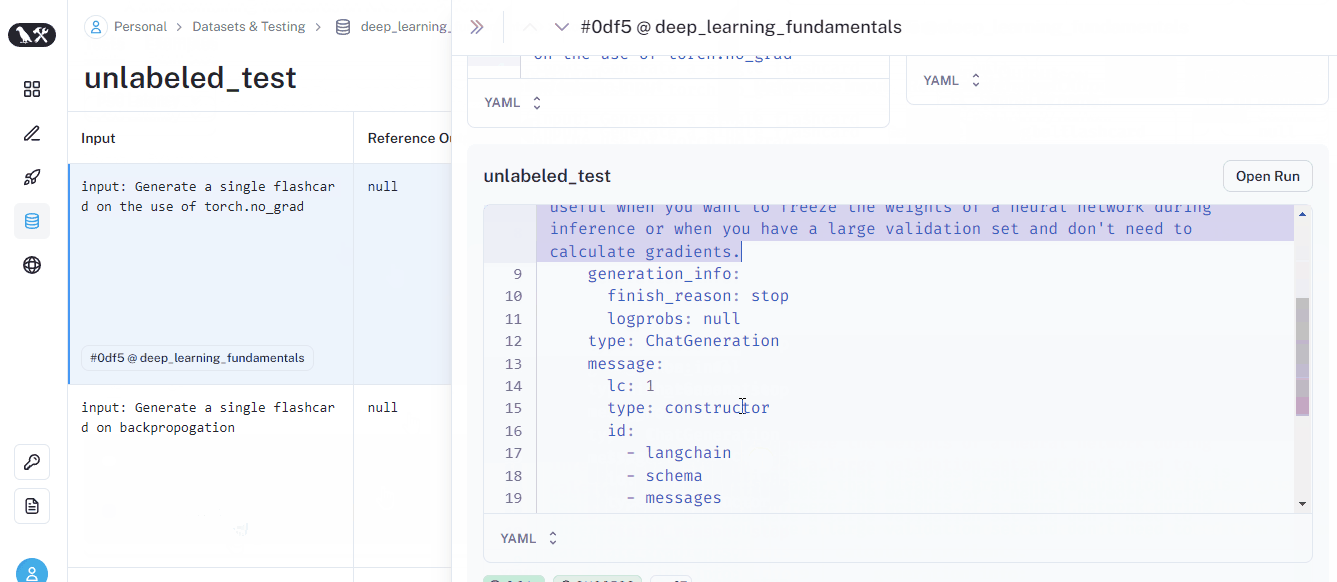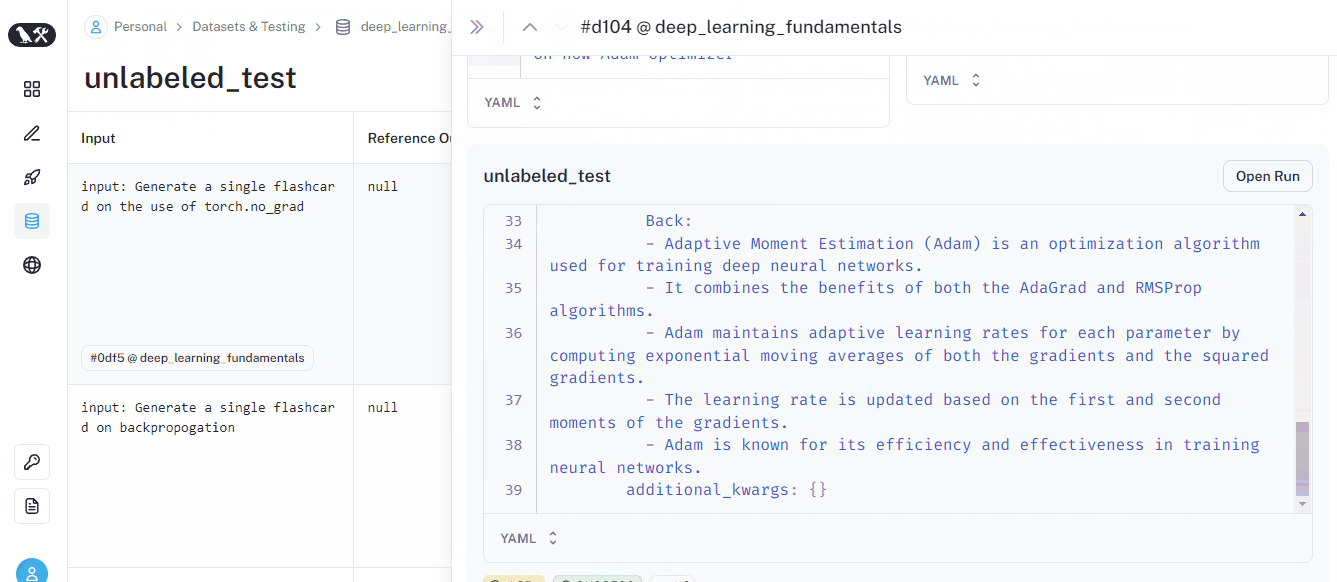
Setelah eksekusi selesai, hasilnya akan tercantum di halaman dataset. Beginilah tampilannya:
Kita baru saja melakukan uji coba pada dataset tanpa label — dataset dengan contoh prompt tetapi tanpa contoh output. Uji kita hanya menghasilkan respons untuk setiap prompt namun tidak melakukan evaluasi apa pun. Tetapi kita ingin melakukan pemeriksaan dasar seperti “Apakah keluaran itu bermanfaat?” atau “Apakah responsnya singkat atau panjang?”
LangSmith memungkinkan kita melakukan pemeriksaan seperti itu menggunakan evaluator bawaan.
Untuk menjalankan evaluasi conciseness dan coherence menggunakan tiga prompt yang kita miliki di dataset, kita dapat menggunakan kelas RunEvalConfig:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Di atas, kita mendefinisikan dua kriteria dalam sebuah daftar bernama evaluators. Kita meneruskan evaluator ini ke parameter evaluation dari fungsi run_on_dataset:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset adalah fungsi yang membantu untuk menjalankan semua prompt dalam dataset menggunakan LLM yang disediakan dan melakukan jenis evaluasi apa pun secara langsung. Hasilnya akan terlihat pada halaman khusus setiap dataset:
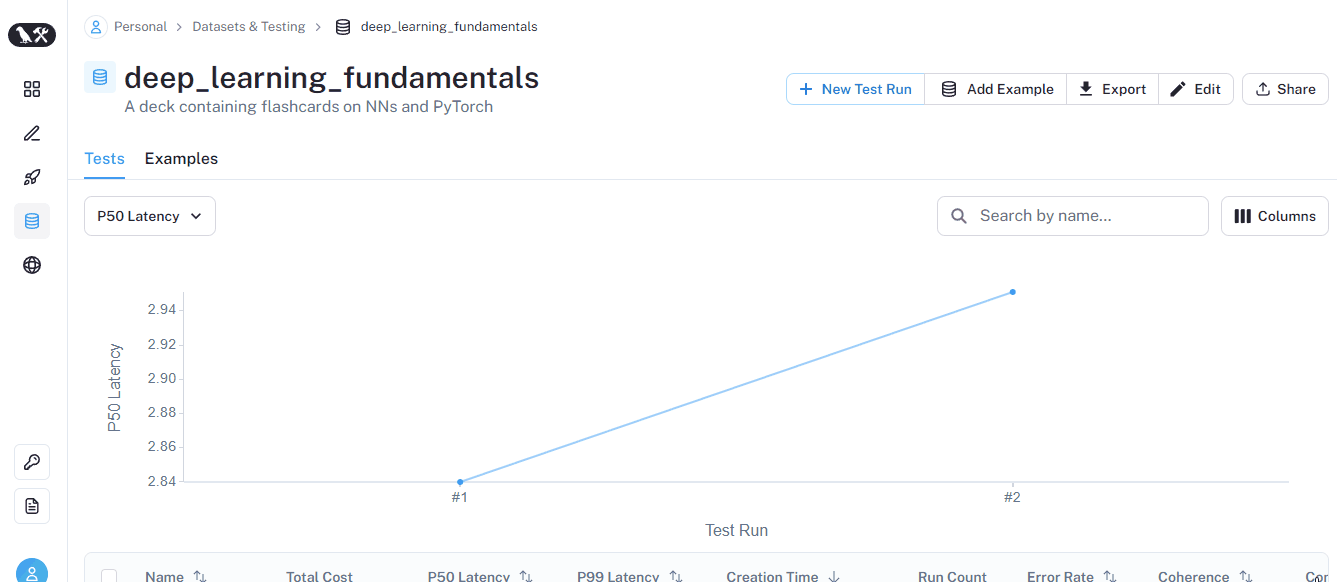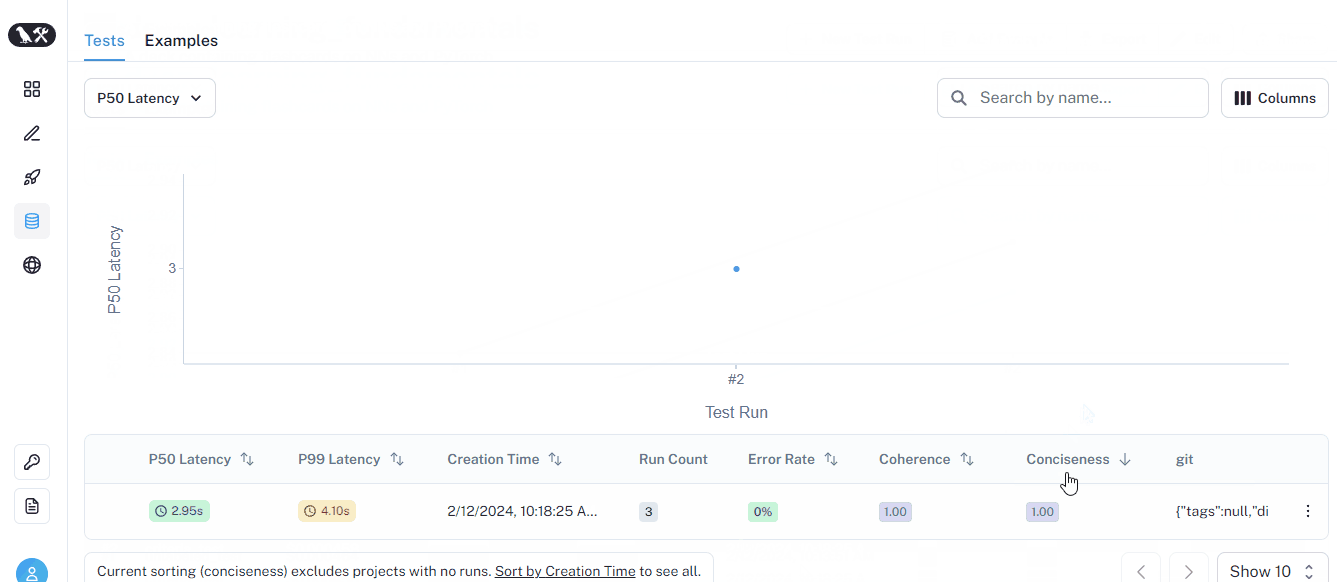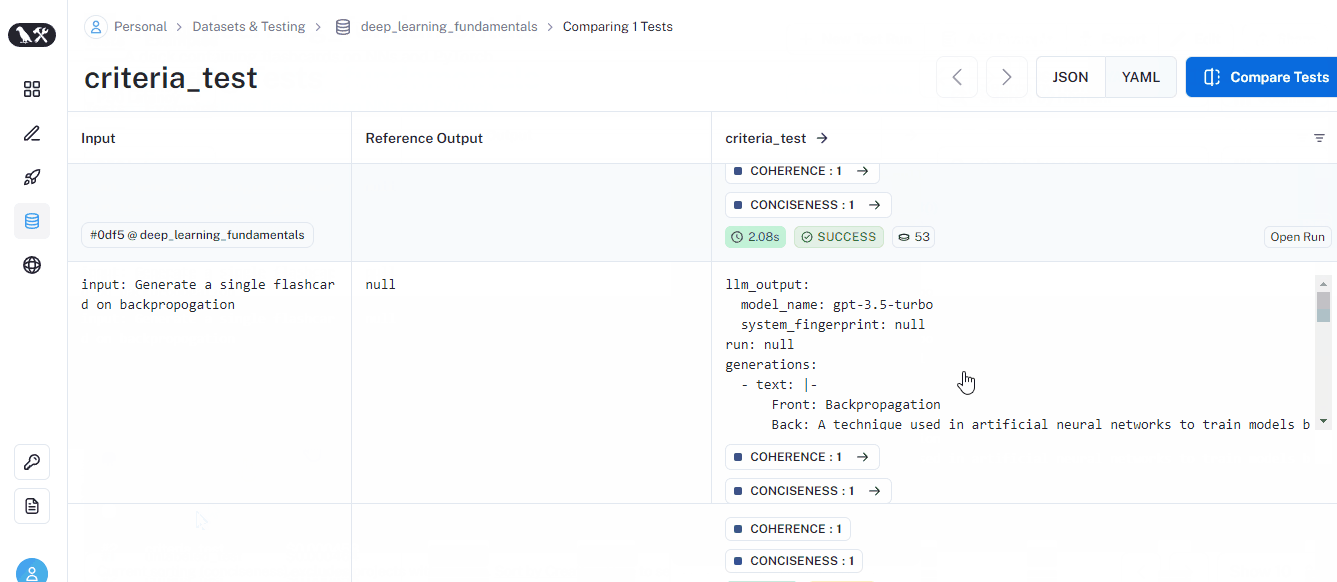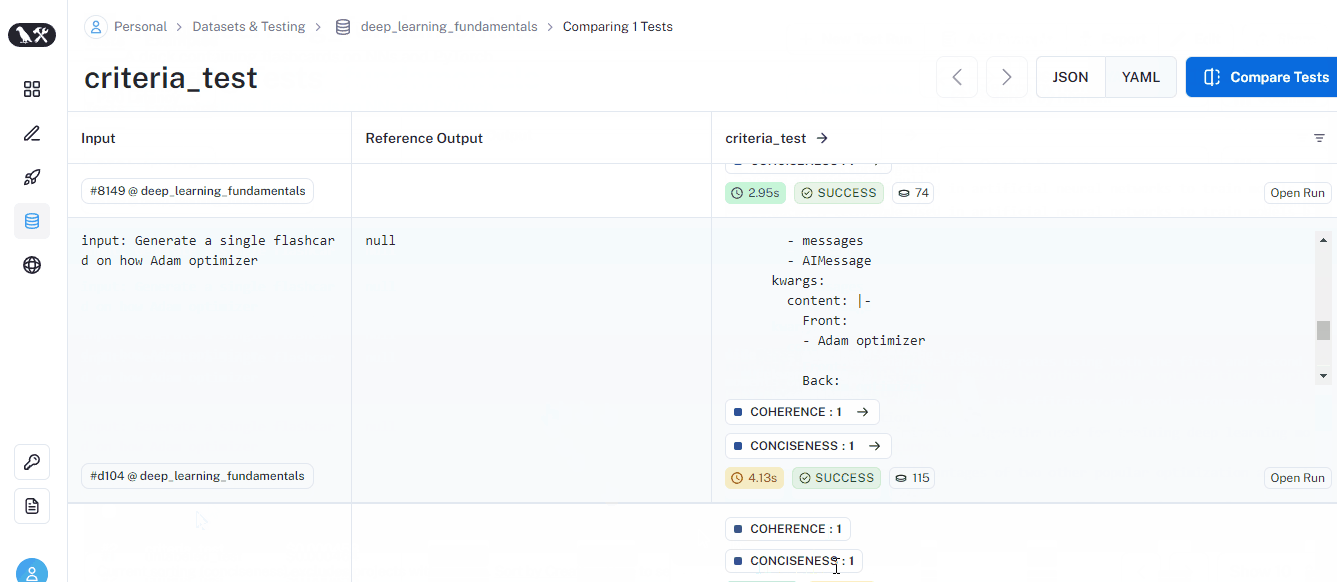
Kali ini, eksekusi memiliki metrik koherensi dan keringkasan untuk setiap prompt. Di bagian bawah, Anda juga akan melihat skor rata-rata untuk setiap metrik.
Untuk melihat daftar semua kriteria bawaan, jalankan potongan kode di bawah ini:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Tentu saja, tidak semua kasus penggunaan LLM dapat diperiksa dengan evaluator dasar. Misalnya, tidak ada evaluator untuk memeriksa apakah sebuah kartu kilat berisi pertanyaan tentang pemrograman atau tidak. Jadi, sebaiknya kita mendefinisikannya:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Untuk meneruskan kriteria kustom dengan bahasa alami, kita cukup meneruskan {“criteria_name”: “Kondisi yang diperiksa”} ke kelas Criteria. Di atas, kita membuat dua evaluator tambahan, sehingga LangSmith akan menjalankan dua prompt tambahan di atas keluaran yang dihasilkan oleh prompt di dataset kita:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Jika Anda memeriksa eksekusinya, Anda akan melihat kriteria kustom yang kita definisikan di bawah setiap prompt. Jika Anda mengarahkan kursor, Anda akan mendapatkan penalaran LLM setelahnya:
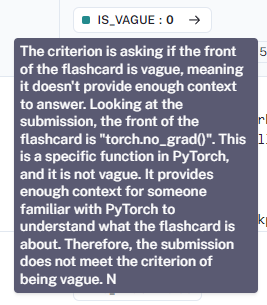
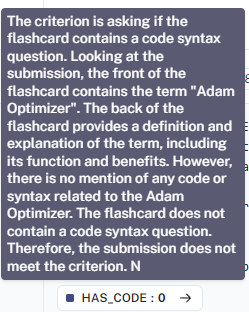
Dengan memeriksa hasil evaluasi untuk semua prompt, Anda akan melihat bahwa kriteria kita belum mengevaluasi sesuai harapan. Jadi, ada hal yang perlu dipertimbangkan — Anda juga perlu melakukan rekayasa prompt pada kriteria Anda agar memastikan mereka memeriksa hal yang tepat.
Terkadang, Anda mungkin memutuskan untuk membuat dataset berisi prompt dengan keluaran yang diharapkan, misalnya dataset berlabel. Anda dapat membuat dataset berlabel dalam berbagai format, tetapi mungkin yang paling umum adalah file CSV. Misalnya, berikut adalah file yang saya buat dengan ChatGPT yang berisi lima pertanyaan tentang sintaks PyTorch:
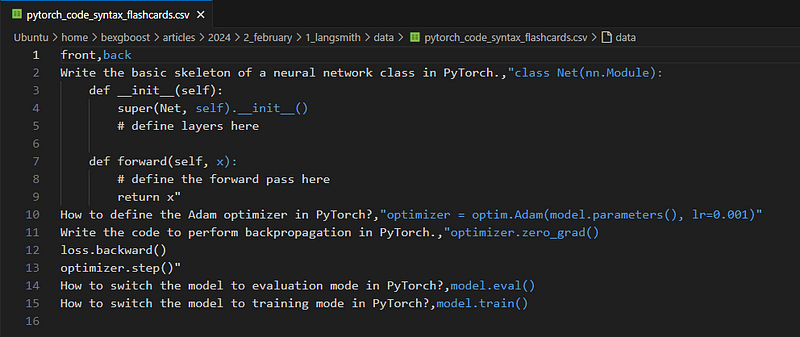
Untuk membuat dataset dari ini, kita dapat menggunakan fungsi upload_csv:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
Fungsi ini memiliki tiga parameter wajib: path CSV dan nama kolom input/output. Setelah unggahan selesai, dataset akan muncul di antarmuka:
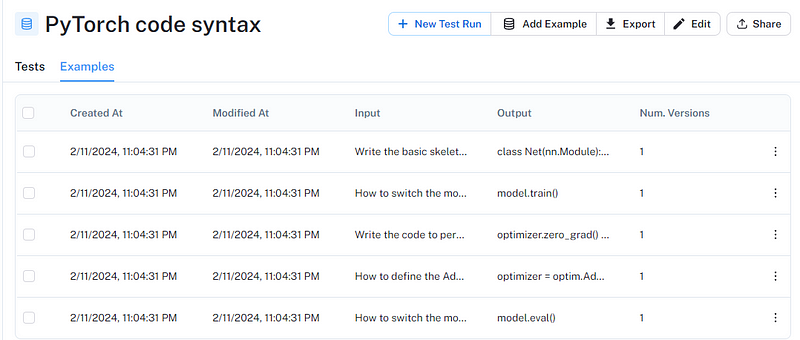
Mari jalankan kriteria kustom dari bagian sebelumnya pada dataset ini juga:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
Jika Anda membuka halaman dataset dan memeriksa eksekusinya, kita dapat melihat skor rata-rata untuk setiap kriteria kustom:
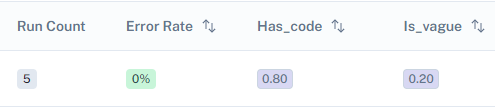
Evaluator bawaan dan kustom yang ditulis dalam bahasa alami umumnya untuk dataset tanpa label. Untuk dataset berlabel seperti dataset CSV yang kita unggah, LangSmith menawarkan evaluator yang lebih komprehensif untuk mengukur kebenaran respons terhadap sebuah prompt:
context_qa (Q&A kontekstual): Menggunakan keluaran contoh sebagai konteks saat mengevaluasi kebenaranqa (Q&A): Menginstruksikan LLM untuk langsung menilai respons sebagai "benar" atau "salah" menggunakan keluaran referensicot_qa (Chain-of-thought Q&A): Mirip dengan context_qa tetapi evaluator ini memaksa LLM menggunakan penalaran rantai-pemikiran sebelum mencapai vonis.Mari coba yang terakhir pada contoh kita:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
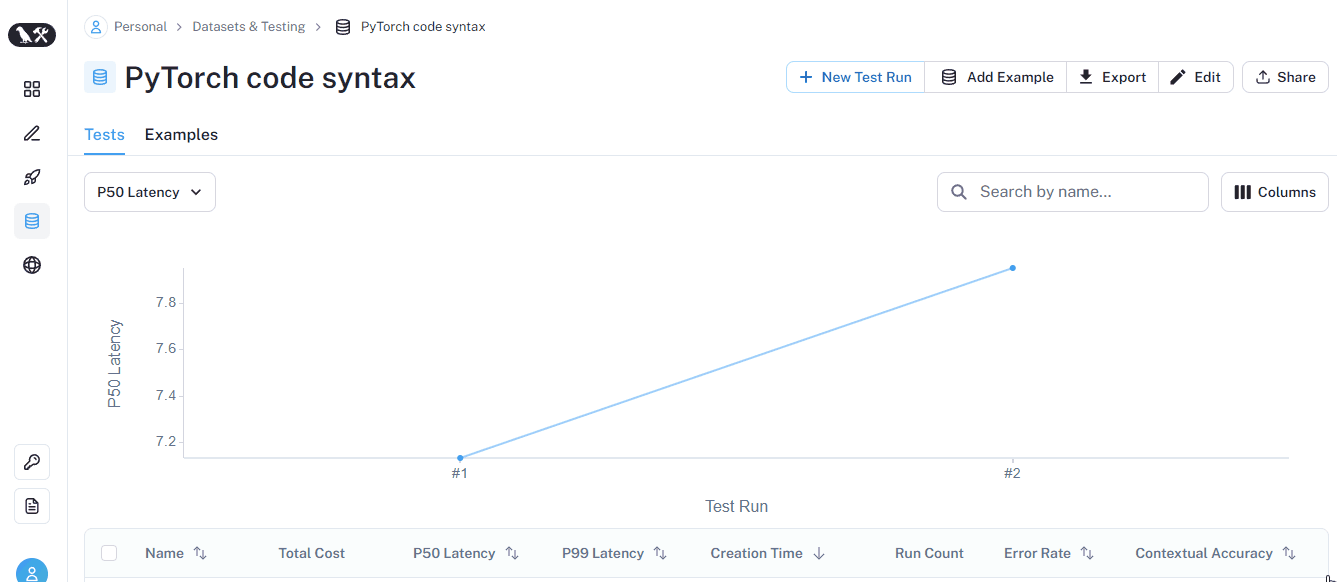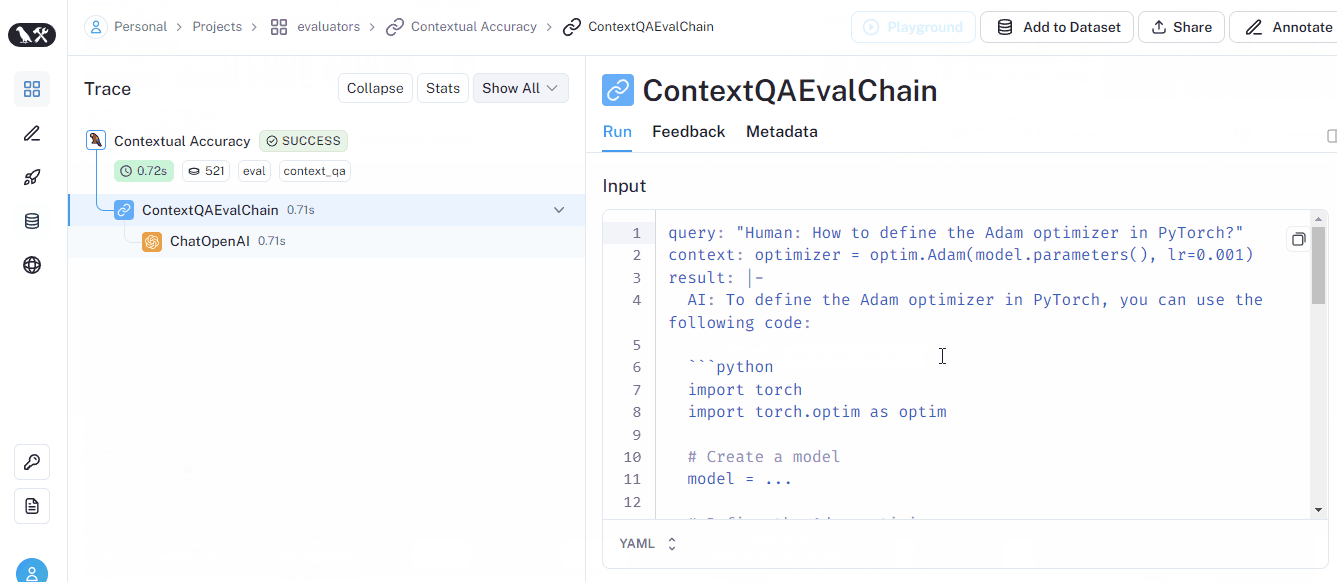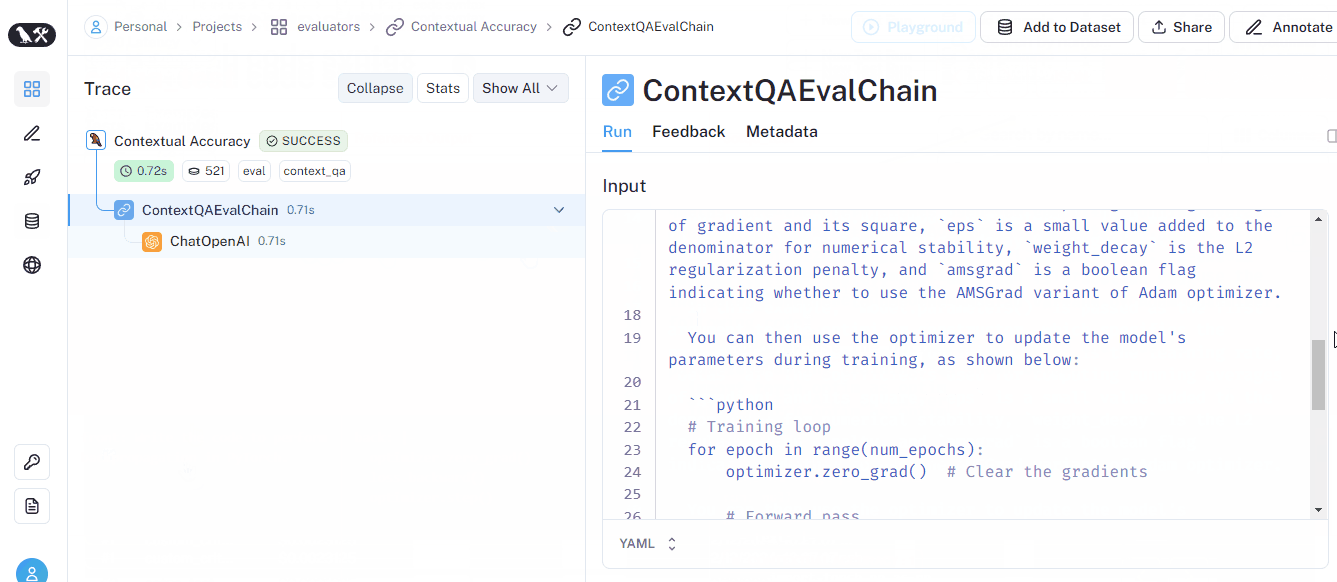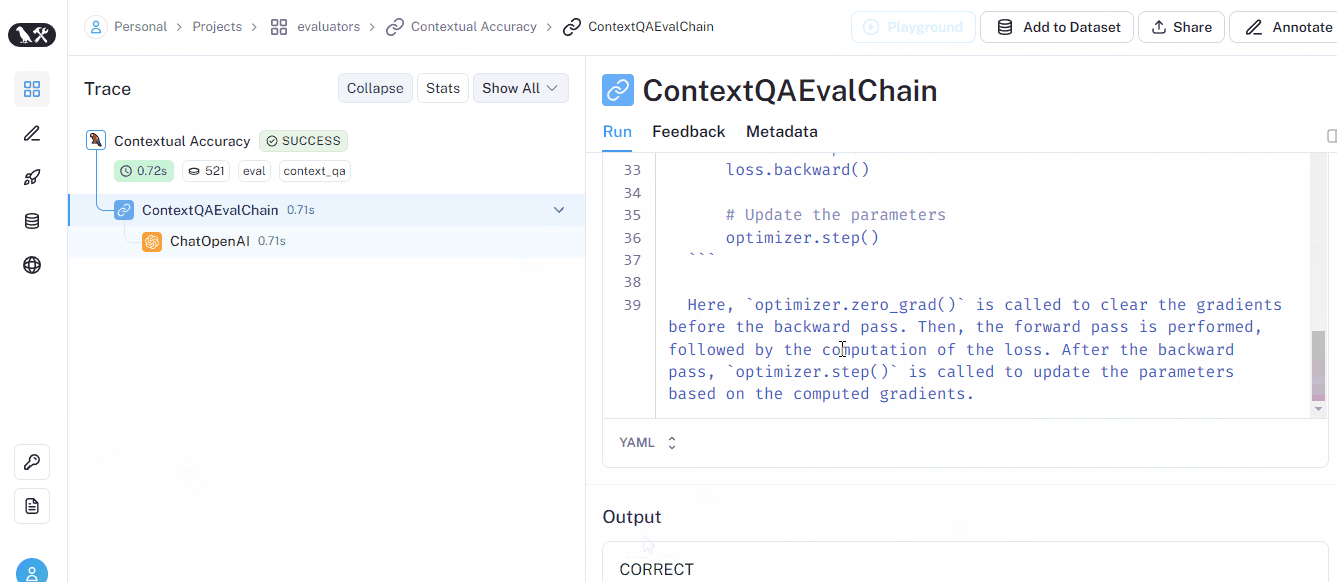
Kriteria CoTQA mengembalikan skor bernama Contextual accuracy, seperti terlihat pada GIF di bawah (juga di antarmuka):
Silakan kunjungi bagian evaluator LangChain pada dokumentasi LangSmith untuk mempelajari lebih banyak tentang evaluator.
Jika setelah membaca tutorial ini Anda mendapat kesan bahwa LangSmith pada dasarnya adalah alat kompleks untuk rekayasa prompt, Anda benar! Saat ini, LangSmith adalah kerangka kerja terbaik untuk memastikan instruksi dan keluaran LLM benar-benar sesuai dengan yang Anda inginkan.
Anda juga pasti menyadari upaya yang diperlukan untuk membangun aplikasi LLM tingkat produksi. Jadi, gunakan LangSmith untuk pengalaman yang lebih mulus saat mengerjakan proyek LLM.
Jika beberapa konsep di LangSmith masih belum jelas, mungkin Anda kekurangan beberapa dasar di LangChain. Berikut beberapa sumbernya:
Mulai Perjalanan LangChain Anda Hari Ini
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt





