
Last chance! 50% off DataCamp Premium
Sale ends in
Di recente ho trovato una piattaforma AI che genera automaticamente flashcard da qualsiasi tipo di contenuto multimediale. Siccome adoro memorizzare concetti con la ripetizione dilazionata, ho subito caricato il mio tutorial su XGBoost e ho chiesto all’AI di creare 50 flashcard.
Ma sono rimasto deluso. La maggior parte delle domande era troppo facile e pochissime riguardavano la sintassi del codice. Ancora più strano, il 10% delle domande era identico e completamente fuori contesto — “Qual è la capitale della Francia?”.
Errori di questo tipo suggeriscono una mancanza di valutazione e validazione adeguate degli output prodotti dai servizi di AI. Forse non conoscevano LangSmith.
LangSmith è una piattaforma completa per testare, fare debug e valutare applicazioni basate su LLM. Forse la sua funzione più importante è la valutazione degli output degli LLM e il monitoraggio delle prestazioni. In questo tutorial vedremo il framework in azione e impareremo tecniche da applicare ai tuoi progetti.
Iniziamo!
Come accennato sopra, LangSmith è una piattaforma completa per valutare applicazioni di linguaggio di grandi dimensioni. Ecco alcune delle sue funzionalità e i benefici concreti che portano nel mondo reale:
Gli sviluppatori possono iniziare a sperimentare con LangSmith in minuti, non ore. Questo significa che un piccolo team o uno sviluppatore singolo può prototipare un’app AI in un weekend e potenzialmente lanciare un servizio a pagamento già il lunedì.
Con strumenti di valutazione rigorosi, le aziende possono evitare l’imbarazzo e i costi di rilasci AI difettosi (come l’esempio che ho fatto nell’introduzione). LangSmith ti permette di controllare l’output degli LLM rispetto a criteri integrati come utilità, coerenza, misoginia, o anche valutazioni personalizzate in linguaggio naturale come “Il contenuto dell’output è un cliché?” o, nel caso della generazione di flashcard, “La card contiene una domanda di coding?”.
LangSmith usa i trace per registrare quasi ogni aspetto delle esecuzioni degli LLM. Tra queste rientrano metriche come latenza, conteggio token, costo delle esecuzioni e tutti i tipi di metadati. La Web UI ti permette di filtrare rapidamente le esecuzioni in base a percentuale di errore, latenza, data o persino per contenuto testuale usando il linguaggio naturale. Questo significa che, se ad esempio un tutor AI inizia a dare risposte difettose agli studenti reali, puoi rilasciare una correzione in poche ore.
LangChain è il framework “genitore” di LangSmith, focalizzato in particolare sulla fase di sviluppo degli LLM. Offre un design modulare per concatenare più LLM (agenti) e integrarli con altre API come YouTube, Google Search e così via. LangSmith è la ciliegina sulla torta, assicurando, con i suoi potenti strumenti di valutazione e monitoraggio, che i prototipi costruiti con LangChain si comportino come previsto.
Dai un’occhiata al nostro tutorial sulle applicazioni LLM con LangChain per saperne di più su LangChain.
Un’altra ottima funzione di LangSmith sono i dataset. Possono essere usati per migliorare catene, agenti o modelli di LangChain rispetto a un set di esempi standardizzati prima del deployment. Per esempio, potremmo avere un file CSV con due colonne — domande e risposte per flashcard in un formato specifico.
Convertendo questo file in un dataset di riferimento, possiamo istruire gli LLM a valutare il proprio output usando le metriche di assicurazione qualità menzionate sopra.
Ora vedremo tutte queste funzionalità con esempi, una per volta.
Nello sviluppo di app di ML, raccogli i dati, alleni, fai fine-tuning, testi e distribuisci i modelli: i passaggi sono ben definiti. Con le app LLM, però, spesso parti da un modello pronto del fornitore. Fine-tuning? Può essere costoso. Quindi ti concentrerai molto sul progettare i prompt giusti — si tratta di fare alla tua app LLM le domande corrette. Pensalo come la necessità di tanti prompt per fare test, proprio come servono tanti dati per un buon modello di ML.
Tuttavia, con i prompt lavori con testi in ingresso e in uscita, non con numeri. Quindi i metodi tradizionali per misurare errori o accuratezza, come MSE o cross-entropy, qui non funzionano. Inoltre, immagina di leggere ogni input e output per la valutazione: ci vorrebbero giorni se hai migliaia di prompt da valutare.
Ti serve quindi un workflow incentrato sulla creazione e sul testing efficienti di questi prompt per capire come sta andando la tua app LLM, senza affogare nei controlli manuali. Ecco come potrebbe apparire:
In questa fase, prototiperai il basamento della tua applicazione usando framework come LangChain. Per un progetto di generazione di flashcard, il tuo prototipo potrebbe includere più componenti sopra l’LLM scelto dal fornitore. Ad esempio, potresti doverlo concatenare a:
e così via (vedi quali componenti puoi aggiungere da questa pagina della documentazione di LangChain). Ma puoi ridurre drasticamente i tempi di sviluppo usando le chain pronte all’uso offerte da LangChain per compiti comuni ad alto livello.
In questa fase, testerai la tua applicazione sul maggior numero possibile di scenari. Significa assicurarti che ogni componente aggiunto funzioni bene, si concateni correttamente e produca output coerenti e di alta qualità.
Dato che gli LLM sono non deterministici (non generano lo stesso output a parità di input) e, con la complessità dei componenti aggiunti, passerai gran parte del tempo in questa fase. E LangSmith è stato sviluppato proprio per ridurre al minimo quel tempo. Ne parleremo meglio lungo il tutorial.
Una volta che hai un’app valida, puoi distribuirla come REST API. Una REST API sostanzialmente converte le tue chain o agent di LangChain in link HTTPS a cui altri possono inviare richieste per interagire con il tuo modello AI. Ora costruirai l’interfaccia utente del tuo servizio, ad esempio un’app desktop o, più comunemente, un sito web.
Al momento non c’è un modo semplicissimo per farlo, ma gli sviluppatori di LangChain stanno per rilasciare LangServe, che sarà integrato in FastAPI (quanto sarebbe fantastico?). Dai un’occhiata all’anteprima su questa pagina della documentazione.
Ora iniziamo finalmente a smanettare con LangSmith.
Partiremo dalla Web UI. È disponibile al link smith.langchain.com. Per l’accesso, devi registrarti ed essere approvato dalla lista d’attesa, dato che al momento è in closed beta.
Ma una volta dentro, la landing page apparirà così:
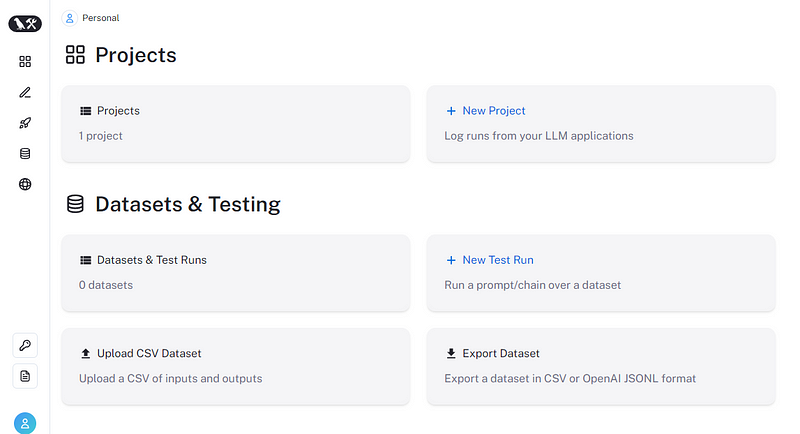
Le due sezioni principali sono progetti e dataset & test, e entrambe possono essere gestite tramite SDK Python. La piattaforma ha anche tab per deployment e code di annotazione, ma sono fuori dallo scopo di questo articolo.
Gestire i progetti in LangSmith è molto più semplice con il suo SDK Python, che è connesso alla piattaforma tramite una chiave API.
Per ottenere una chiave, clicca sull’icona della chiave nella piattaforma e salvala in un posto sicuro. Poi, in una nuova cartella con un nuovo ambiente virtuale inizializzato, crea un file .env. Al suo interno, incolla le seguenti due righe:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Successivamente, nel terminale, esegui i seguenti comandi per installare LangSmith e python-dotenv per leggere le variabili d’ambiente:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Ora, è il momento di scrivere il codice:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
Importiamo le funzioni find_dotenv e load_dotenv per leggere le variabili d’ambiente e le impostiamo con os:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Impostare LANGCHAIN_TRACING_V2 su True abilita il tracing (logging), essenziale per il debug degli LLM. Dopodiché, inizializziamo un client per comunicare con la piattaforma LangSmith:
from langsmith import Client

# Initialize a client
client = Client()
client contiene comandi di alto livello per gestire progetti e asset in LangSmith. Il primo comando del client che useremo è la creazione di un nuovo progetto:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
Dopo l’esecuzione corretta di create_project, puoi vedere il progetto elencato nella sezione Projects della Web UI:
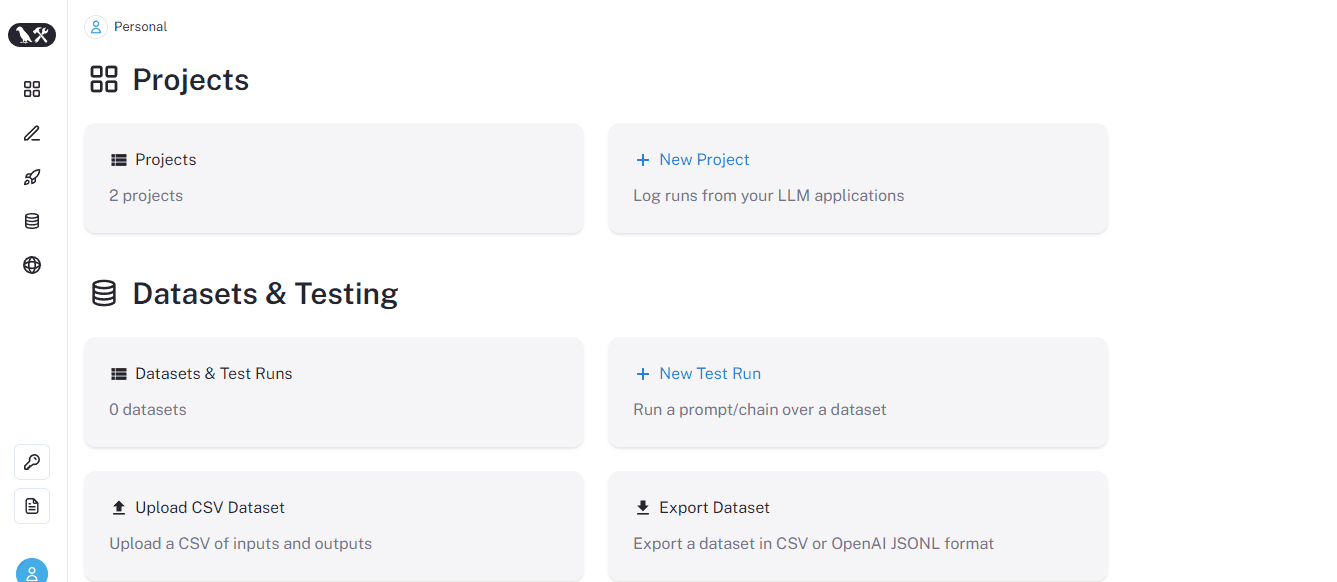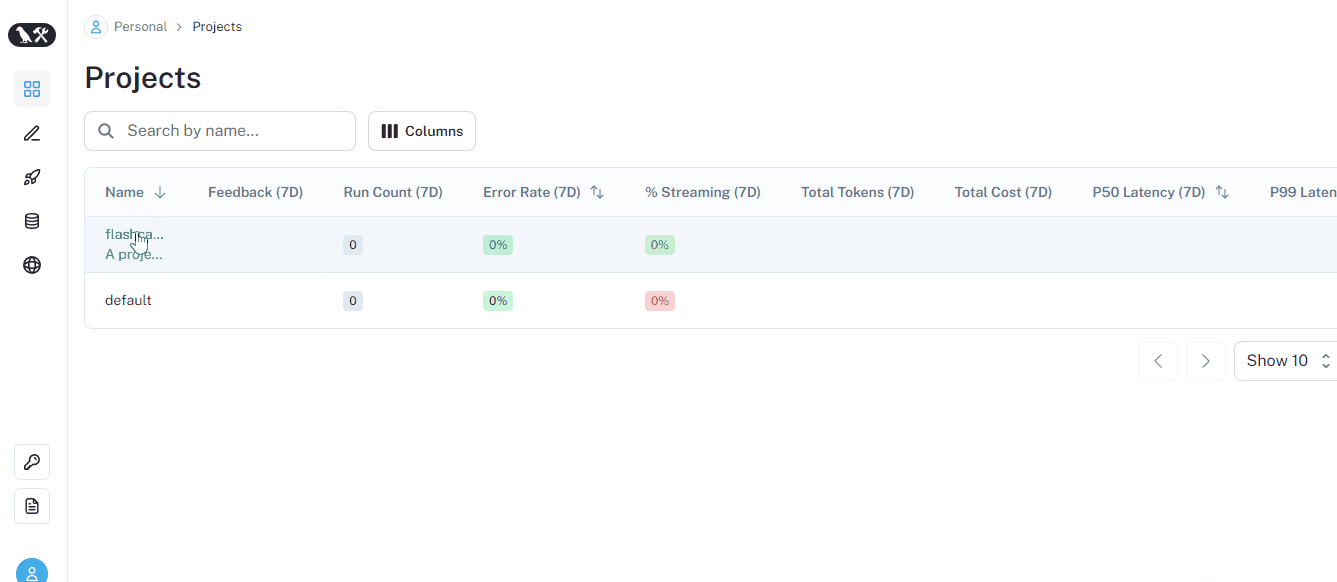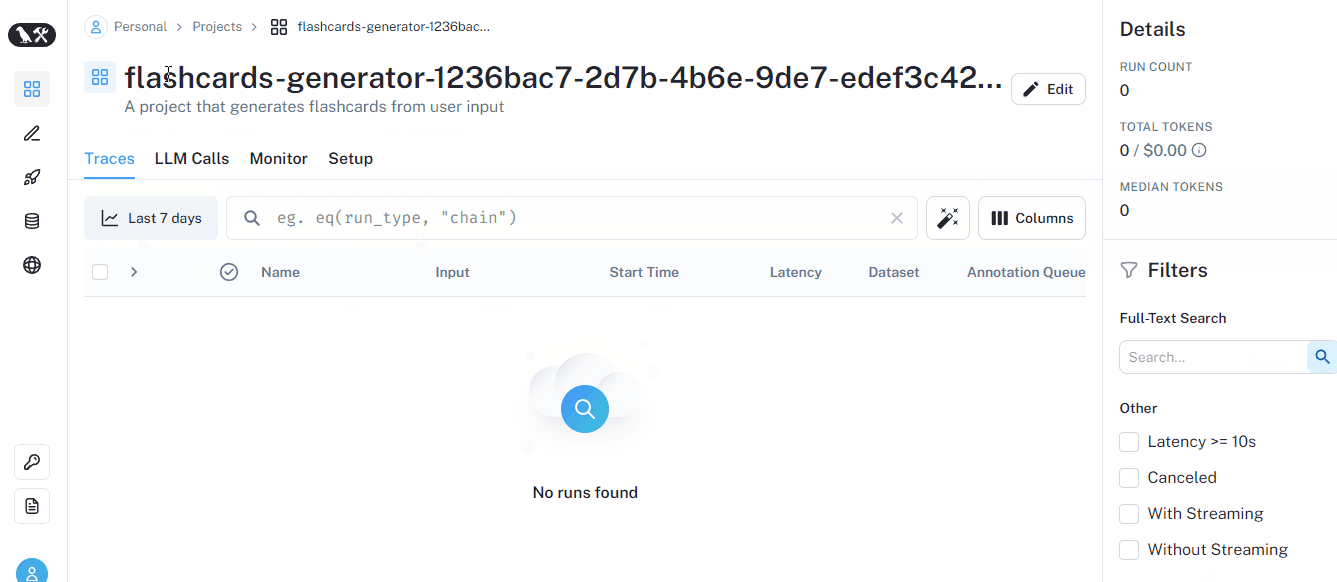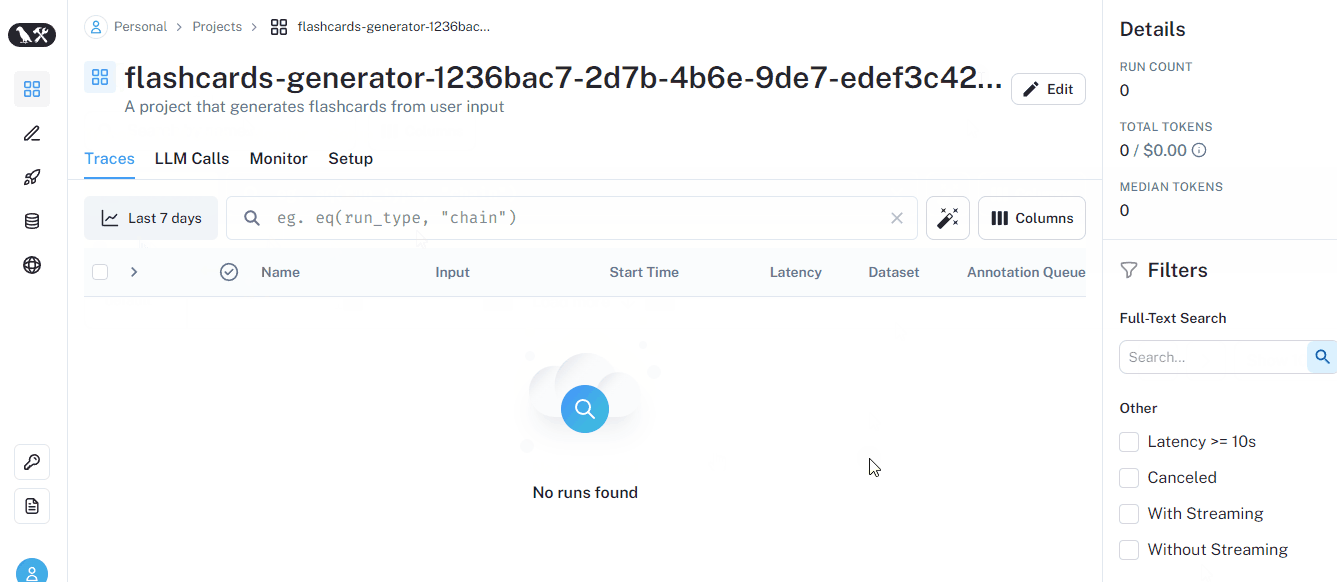
Ora dobbiamo impostare il nuovo progetto come predefinito con un’altra variabile d’ambiente:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Ora ci serve un LLM per il nostro progetto. Sceglieremo GPT-3.5 turbo perché è più economico, ma puoi usare molti altri modelli disponibili tramite langchain. I modelli OpenAI si inizializzano con la classe ChatOpenAI.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Facciamo la nostra prima esecuzione:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
Se controlli rapidamente il progetto dalla UI, vedrai l’esecuzione sopra tracciata (loggata):
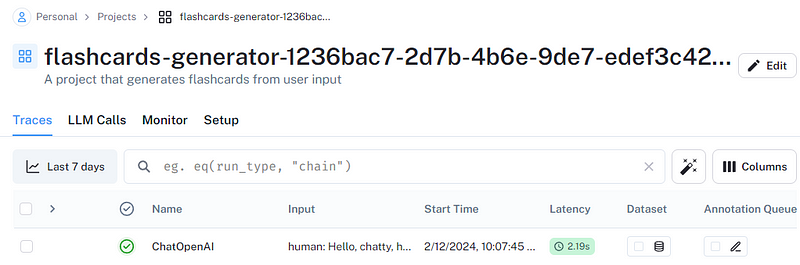
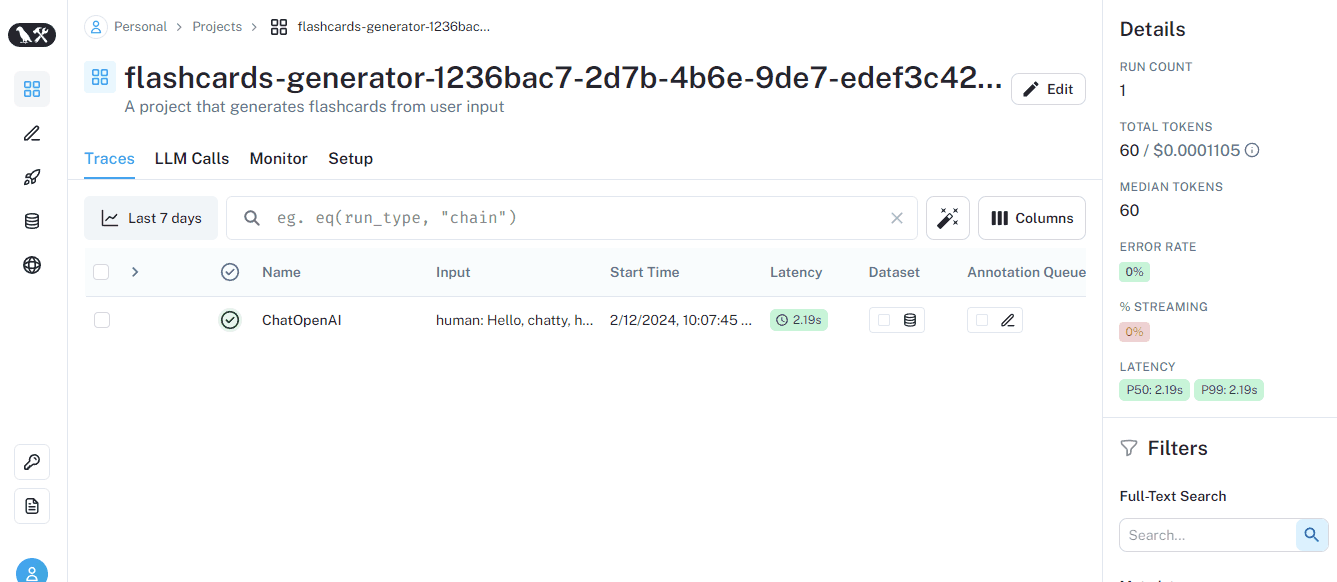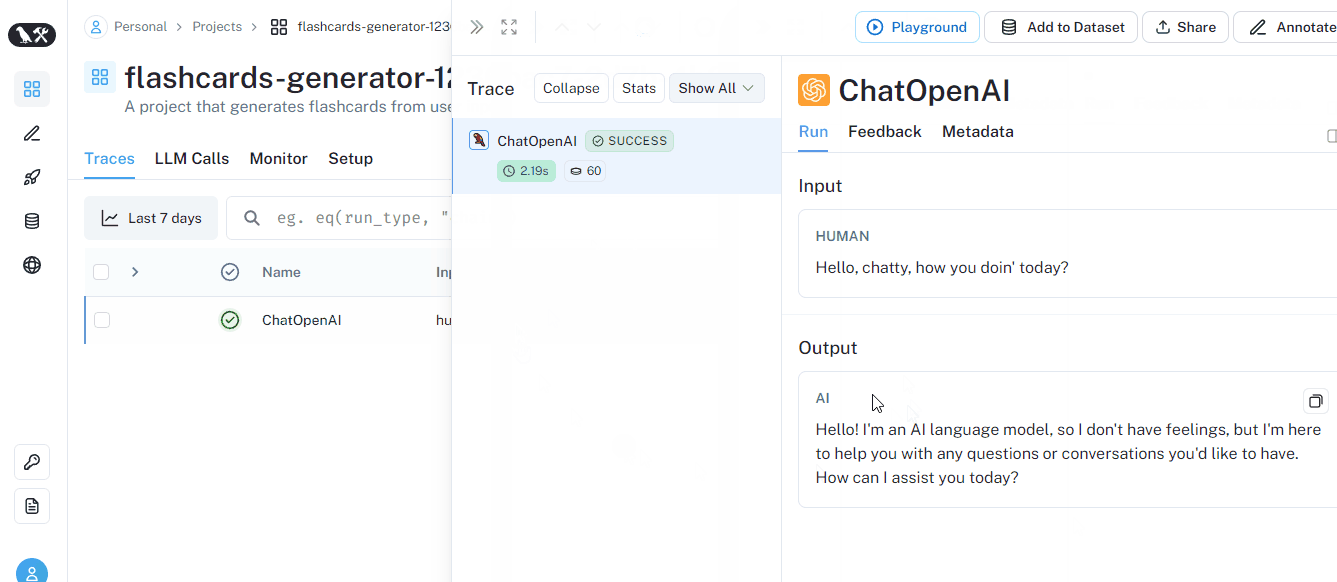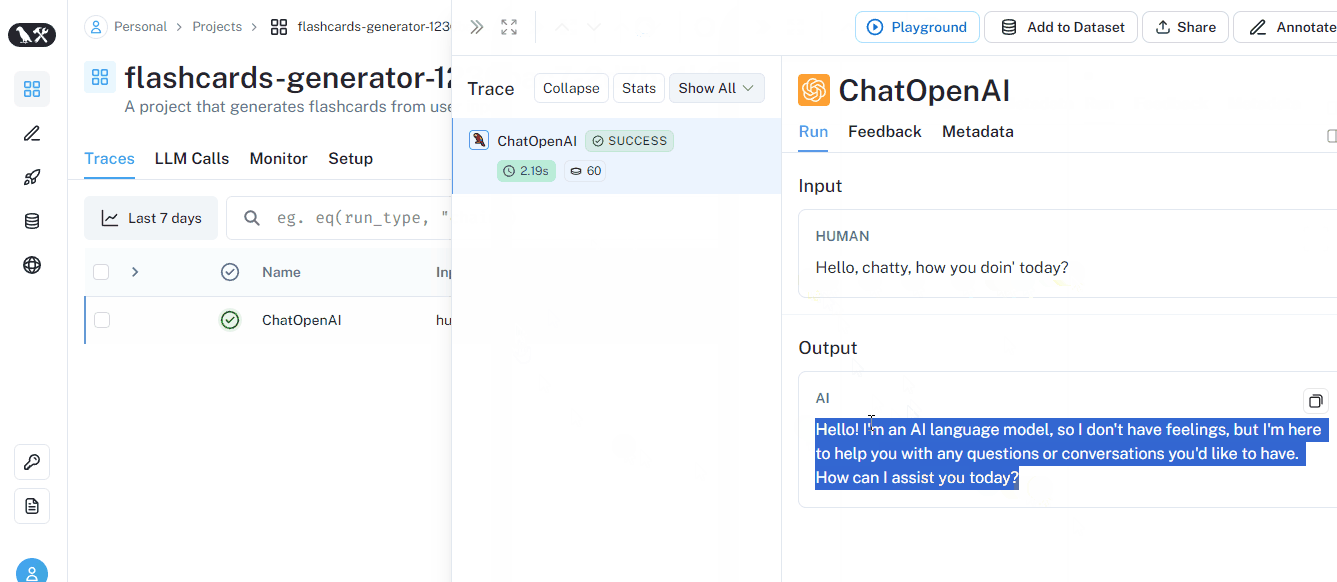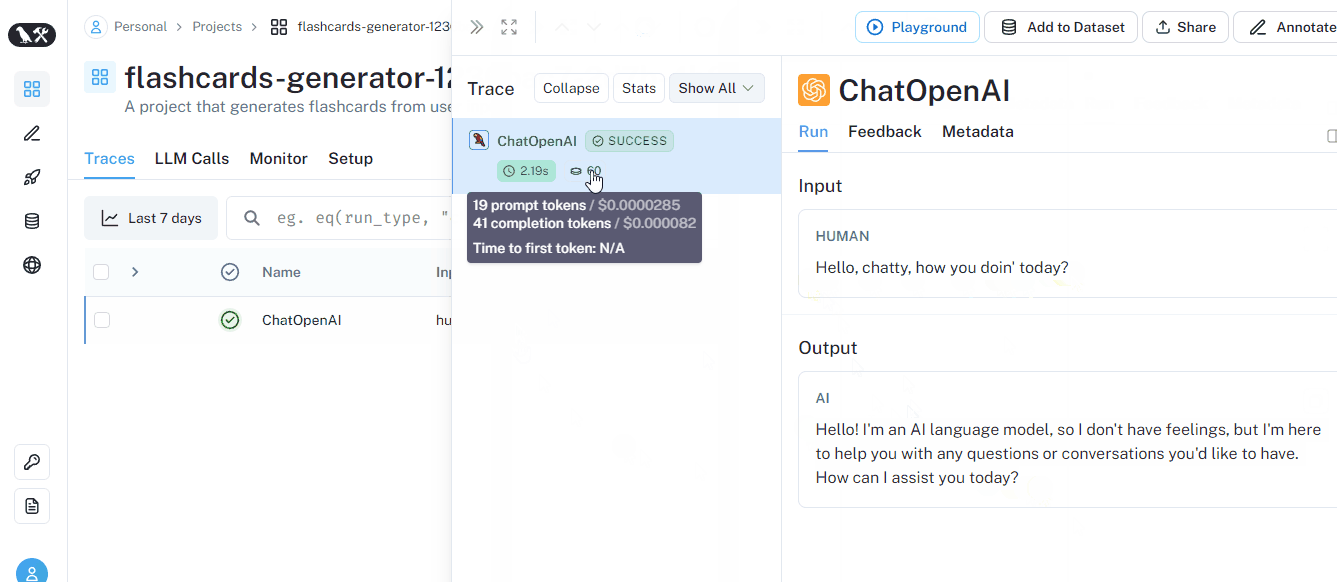
Quando abbiamo impostato le variabili d’ambiente e il client, abbiamo abilitato automaticamente il logging. Come vedi, abbiamo già un bel po’ di metadati sull’esecuzione.
Lanciamo un paio di prompt in più:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Possiamo già costruire un semplice riassuntore di testo. Riassumiamo l’output dell’ultima esecuzione:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Ottimo, ora è il momento di creare il nostro primo dataset.
Come accennato nella sezione “Workflow di sviluppo di applicazioni LLM”, probabilmente dovrai creare o raccogliere migliaia di prompt per valutare il tuo modello, chain o agent LLM. Quindi eseguirli uno per uno come abbiamo fatto sopra non è la pratica migliore.
Per questo motivo, LangSmith offre dataset in tre tipi:
kv) - predefinito: definisce gli input come coppie chiave-valore arbitrarie. Sono utili quando si valutano chain e agent che richiedono più input o restituiscono più output.llm): input e output sono definiti in stile “completion” dagli LLM - stringa in, stringa out.chat): sono dataset convertiti da chat LLM e definiti usando input strutturati e messaggi serializzati.Per prima cosa, vediamo come creare un dataset key-value senza output. Useremo la funzione create_dataset del client:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Ora aggiungiamo tre input che chiedono ciascuno all’LLM di creare una singola flashcard:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
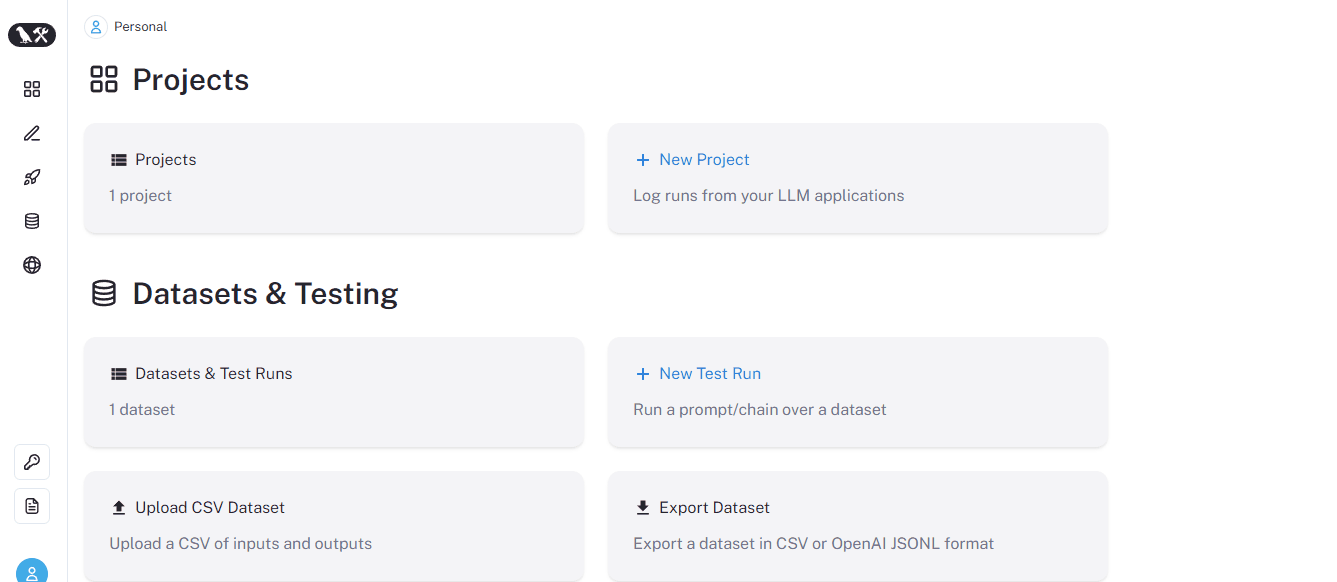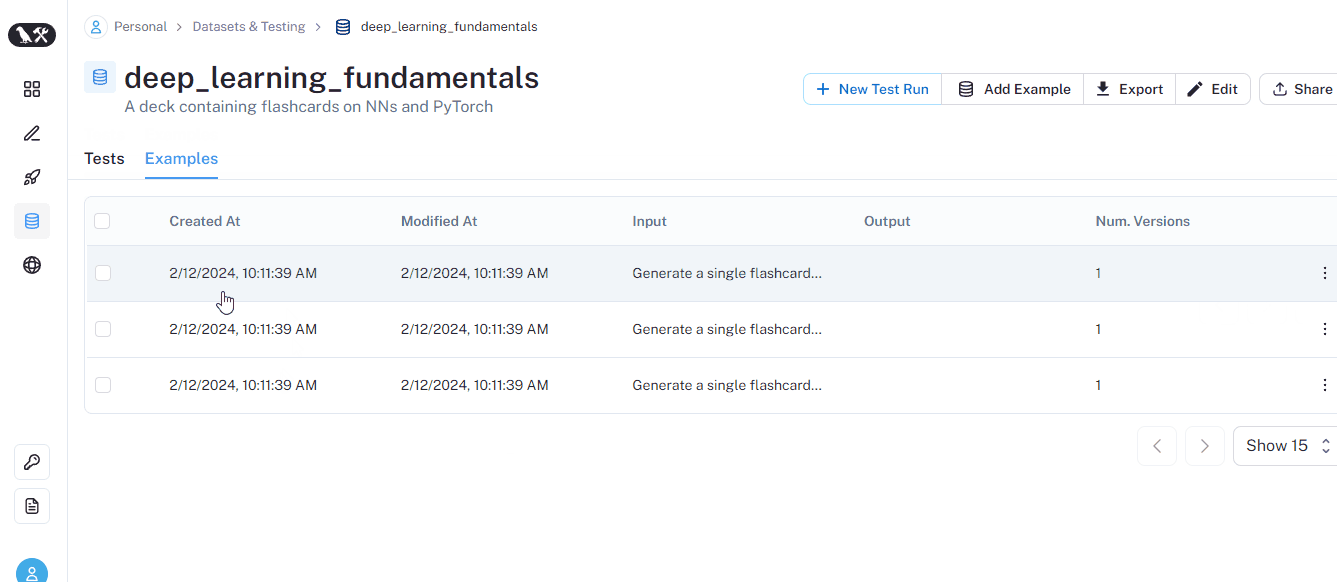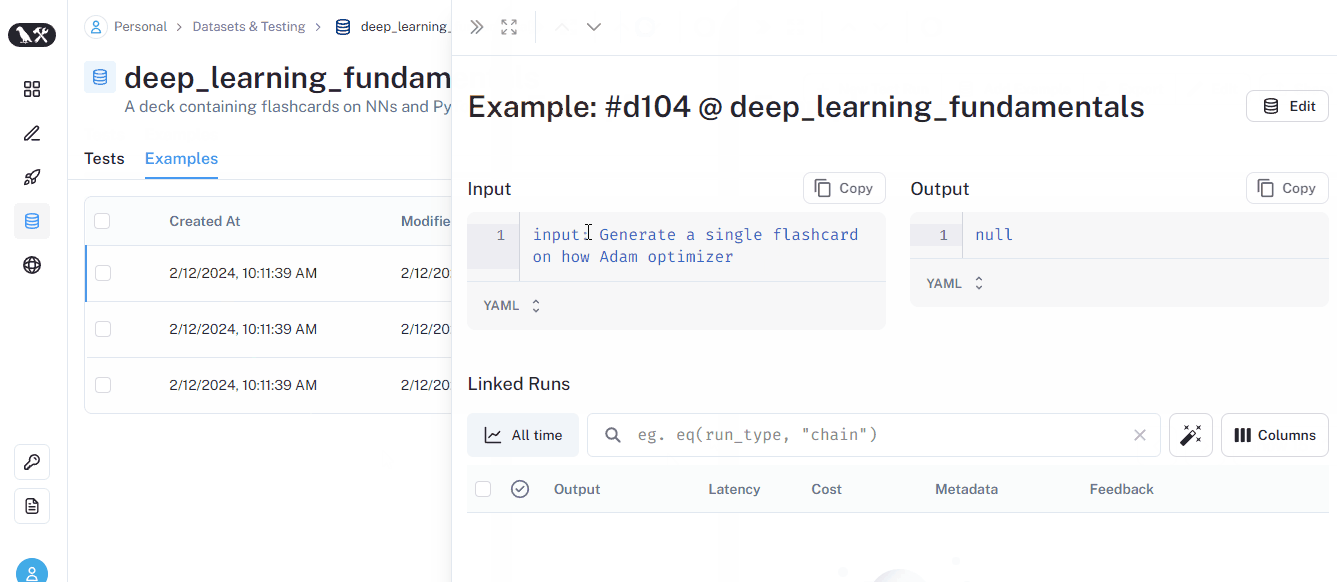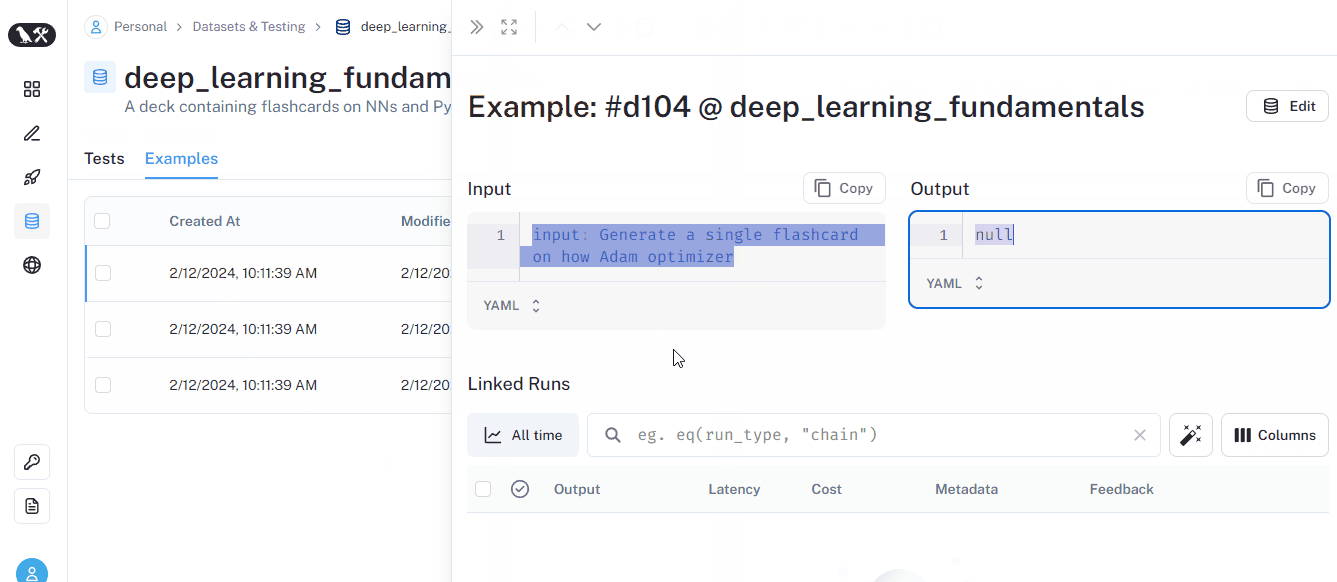
Se vai nella tab del dataset della UI, vedrai ogni prompt elencato con output NULL:
Ora eseguiamo tutti i prompt in una sola riga di codice usando la funzione run_on_dataset:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Una volta terminata l’esecuzione, verrà elencata nella pagina del dataset. Ecco come appare:
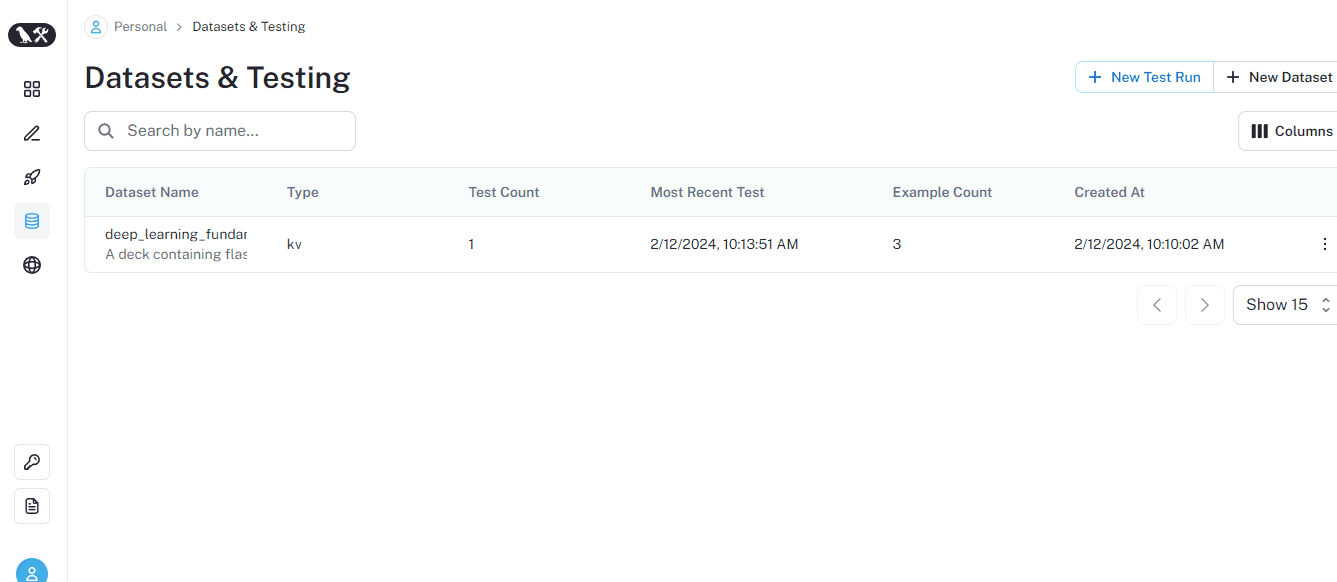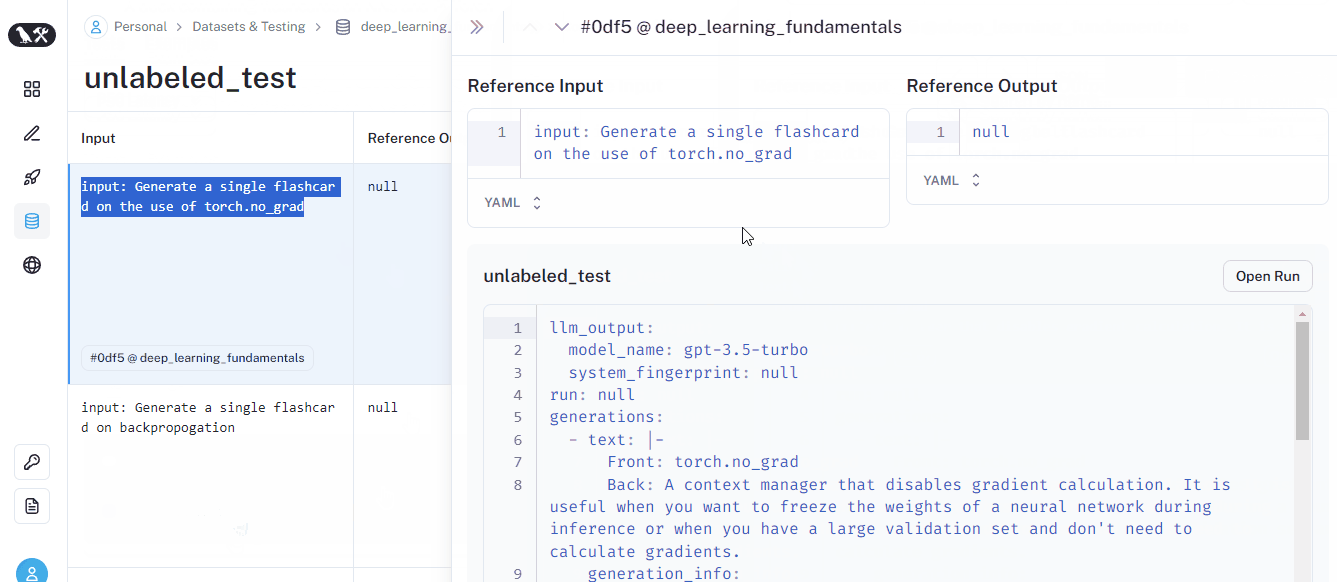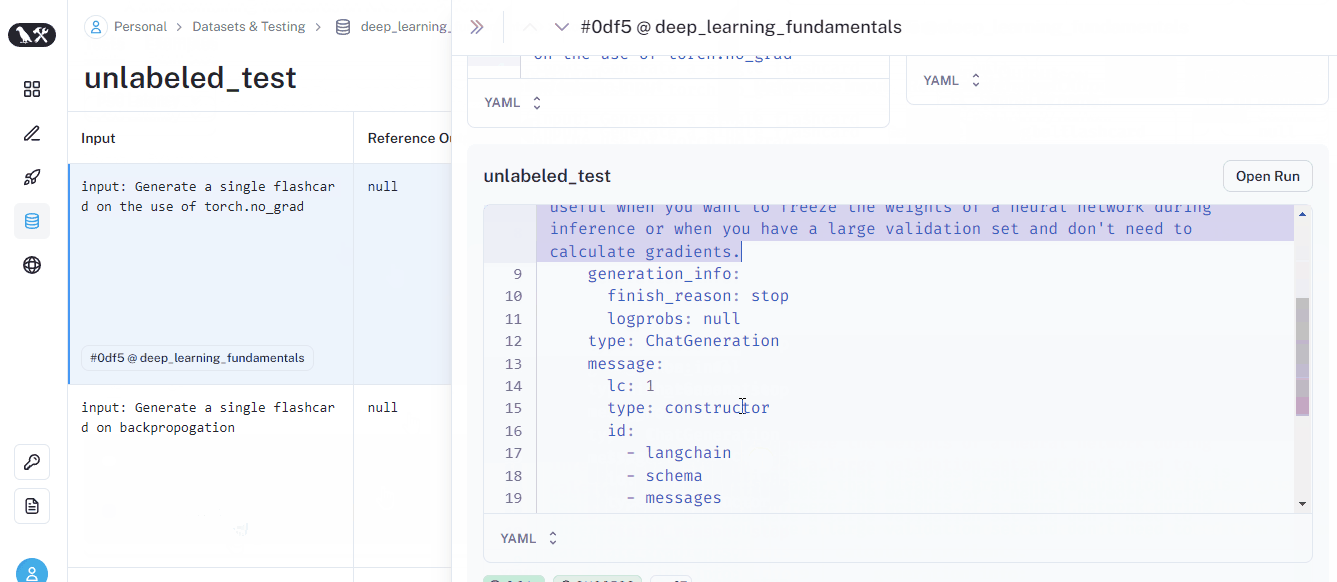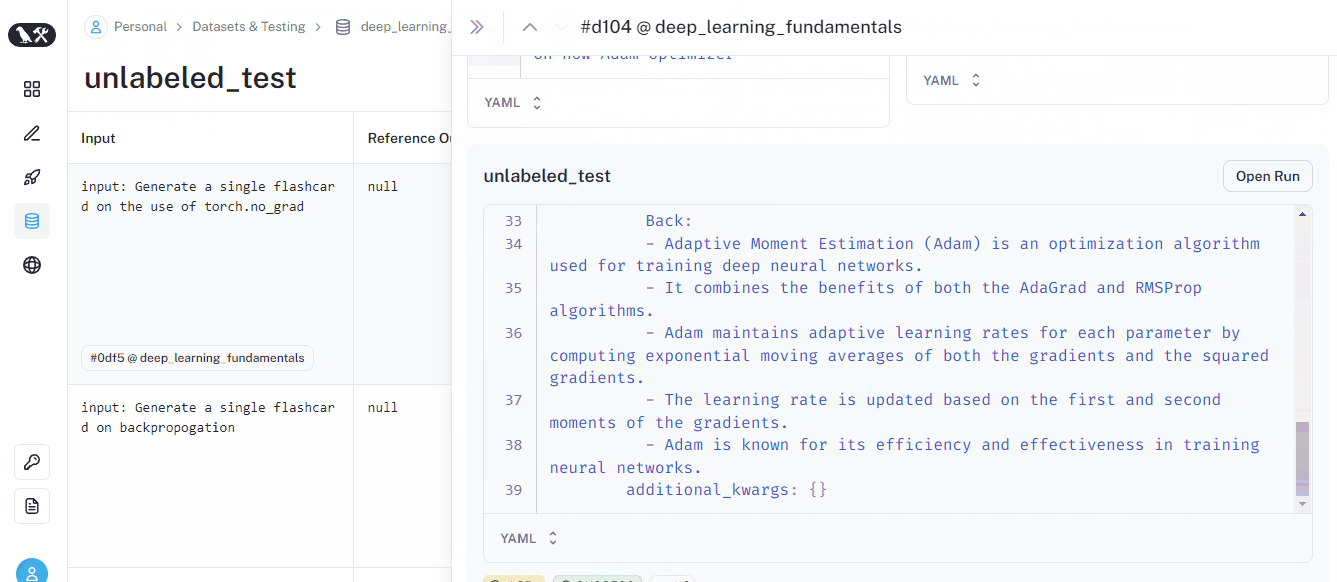
Abbiamo appena fatto un test su un dataset non etichettato — un dataset con prompt di esempio ma senza output di esempio. Il nostro test ha semplicemente prodotto una risposta a ciascun prompt ma non ha valutato nulla. Vorremmo però eseguire controlli di base come “L’output è utile?” o “La risposta è breve o lunga”?
LangSmith ci permette di eseguire questi controlli usando valutatori integrati.
Per eseguire valutazioni di conciseness e coherence usando i tre prompt che abbiamo nel dataset, possiamo usare la classe RunEvalConfig:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Sopra stiamo definendo due criteri in una lista chiamata evaluators. Passiamo questi valutatori al parametro evaluation della funzione run_on_dataset:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset è una funzione utile per eseguire tutti i prompt in un dataset usando l’LLM fornito ed effettuare qualsiasi tipo di valutazione al volo. I risultati saranno visibili nella pagina dedicata di ciascun dataset:
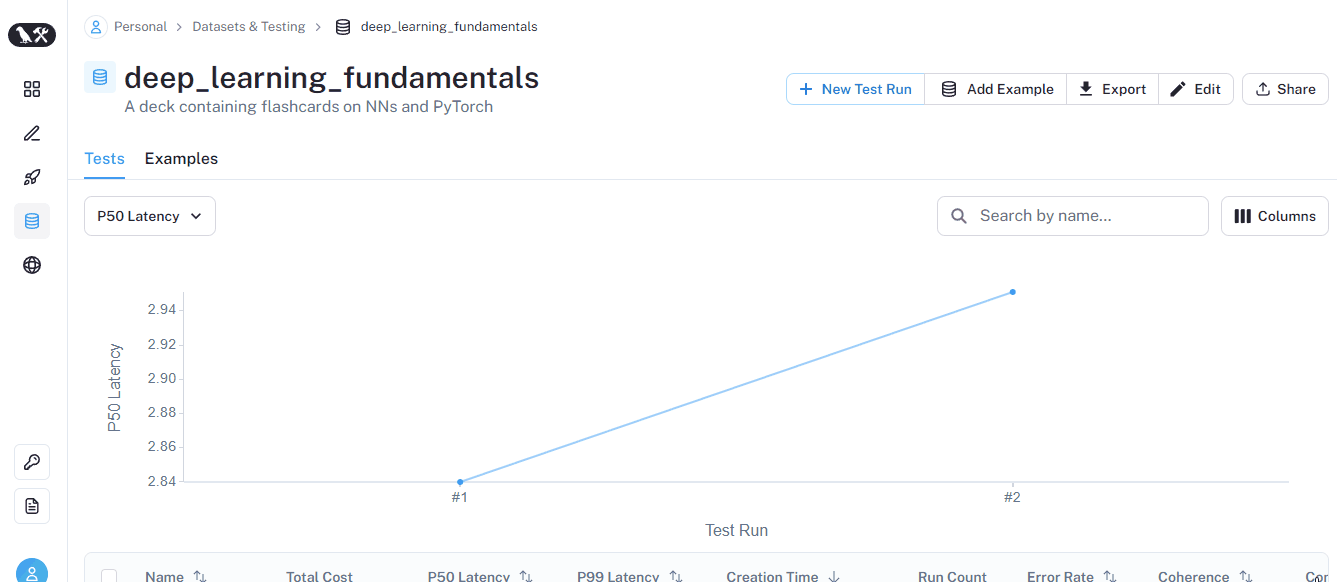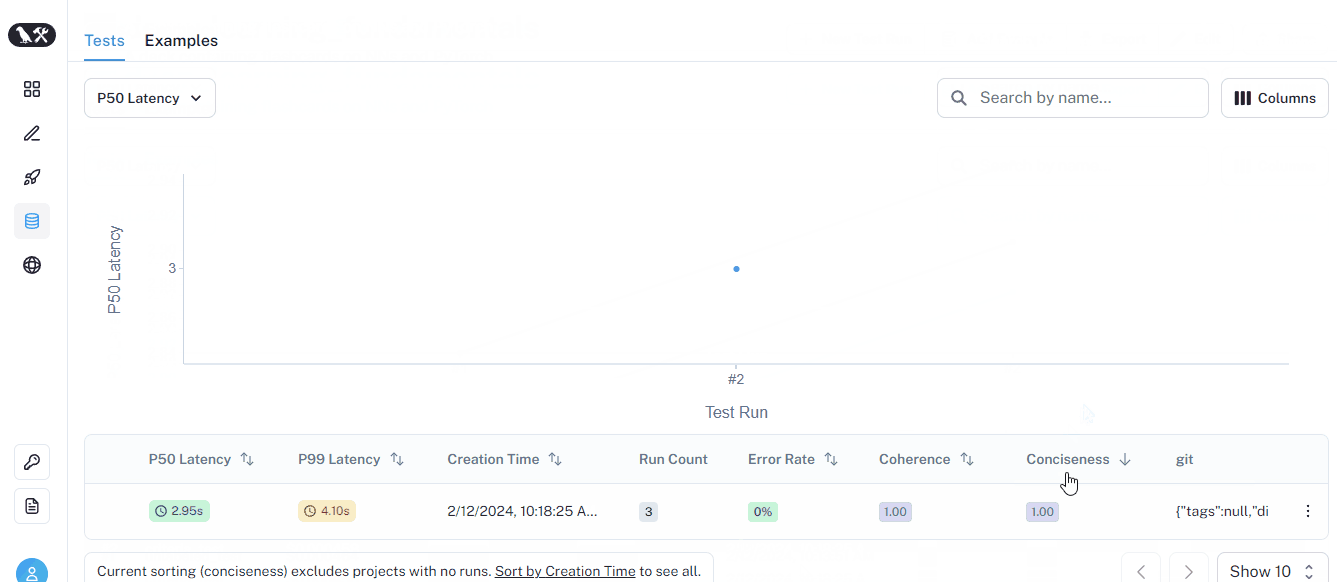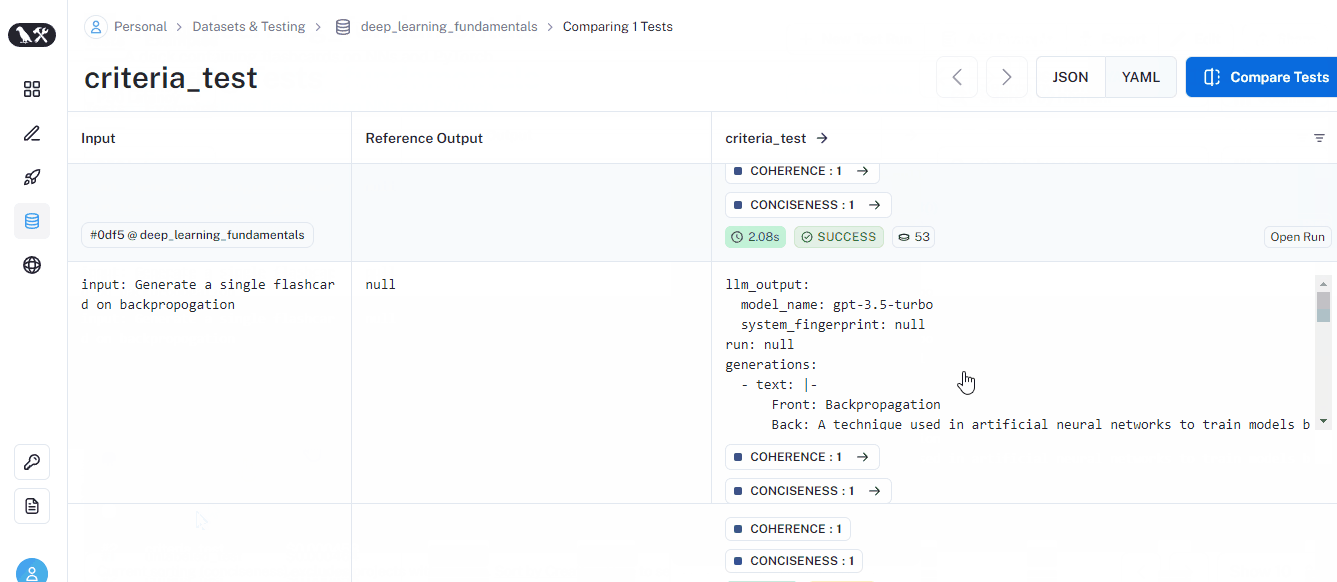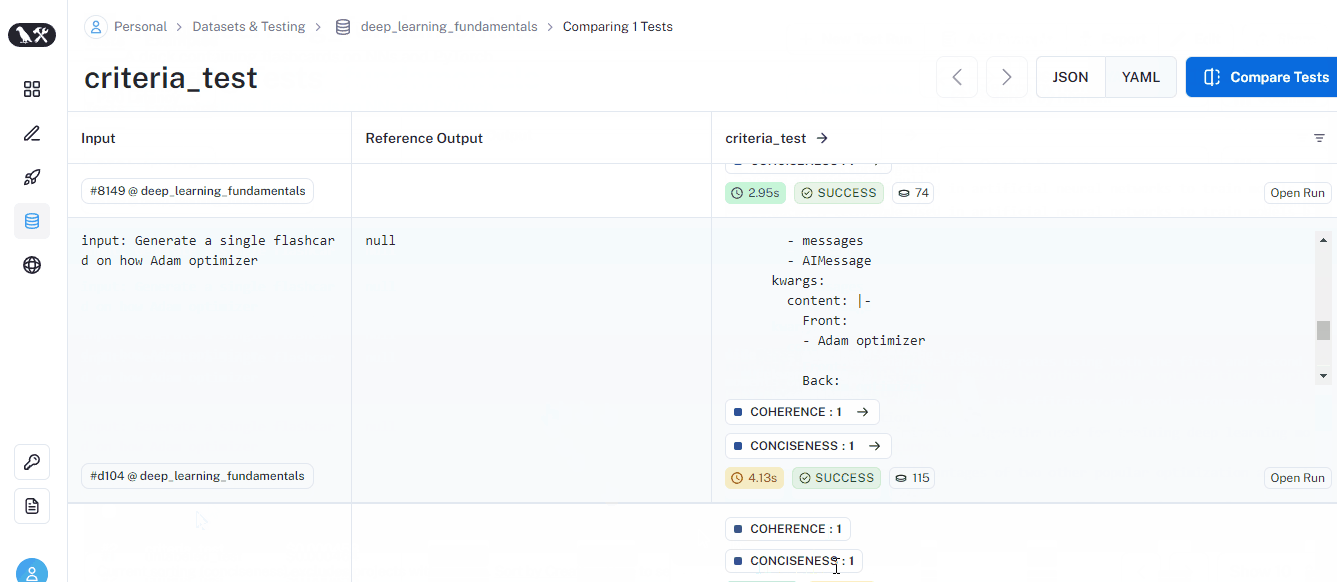
Questa volta, l’esecuzione ha metriche di coerenza e concisione per ciascun prompt. In fondo vedrai anche un punteggio medio per ogni metrica.
Per vedere l’elenco di tutti i criteri integrati, esegui lo snippet seguente:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Ovviamente non tutti i casi d’uso degli LLM possono essere verificati con valutatori di base. Per esempio, non c’è un valutatore che controlli se una flashcard contiene una domanda di coding o meno. Quindi meglio definirlo:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Per passare un criterio personalizzato in linguaggio naturale, passiamo semplicemente {“criteria_name”: “Condition to check”} alla classe Criteria. Sopra stiamo creando due valutatori extra, quindi LangSmith eseguirà due prompt aggiuntivi sopra l’output prodotto dai prompt nel nostro dataset:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Se controlli l’esecuzione, vedrai i criteri personalizzati che abbiamo definito sotto ciascun prompt. Passandoci sopra col mouse, otterrai anche la motivazione dell’LLM:
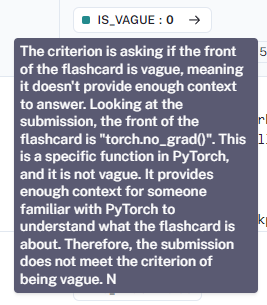
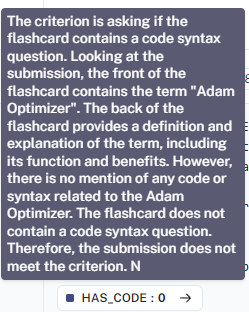
Controllando i risultati della valutazione per tutti i prompt, vedrai che i nostri criteri non stanno valutando come previsto. Quindi, ecco qualcosa da considerare — serve anche fare prompt engineering sui tuoi criteri per assicurarti che verifichino le cose giuste.
A volte potresti decidere di creare un dataset di prompt con output attesi, ad esempio dataset etichettati. Puoi creare dataset etichettati in vari formati, ma forse il più comune è un file CSV. Per esempio, qui c’è un file che ho generato con ChatGPT e che contiene cinque domande sulla sintassi di PyTorch:
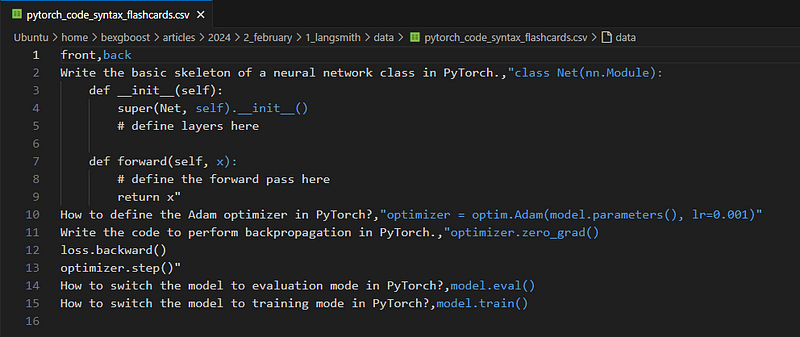
Per creare un dataset a partire da questo, possiamo usare la funzione upload_csv:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
La funzione ha tre parametri obbligatori: il percorso del CSV e i nomi delle colonne di input/output. Una volta completato il caricamento, il dataset apparirà nella UI:
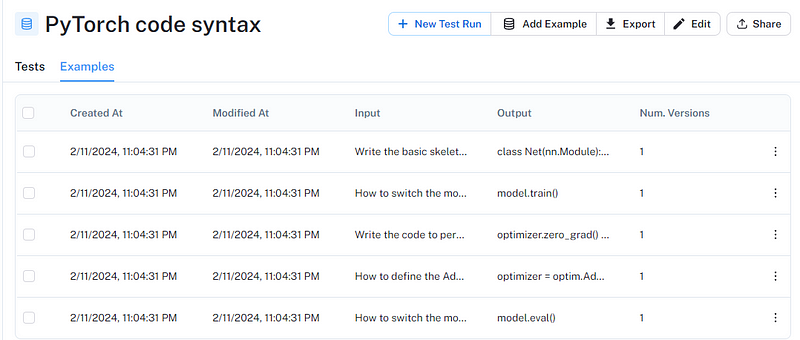
Eseguiamo i nostri criteri personalizzati della sezione precedente anche su questo dataset:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
Se vai alla pagina del dataset e controlli l’esecuzione, possiamo vedere i punteggi medi per ciascun criterio personalizzato:
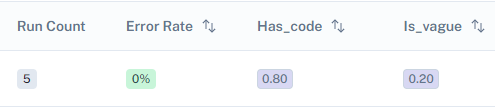
I valutatori integrati e personalizzati scritti in linguaggio naturale sono per lo più pensati per dataset non etichettati. Per i dataset etichettati come il CSV che abbiamo caricato, LangSmith offre valutatori più completi per misurare la correttezza della risposta a un prompt:
context_qa (Q&A contestuale): usa l’output di esempio come contesto durante la valutazione della correttezzaqa (Q&A): istruisce l’LLM a valutare direttamente una risposta come "corretta" o "errata" usando l’output di riferimentocot_qa (Chain-of-thought Q&A): simile a context_qa ma forza l’LLM a usare il ragionamento chain-of-thought prima di arrivare a un verdetto.Proviamo l’ultimo sui nostri esempi:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
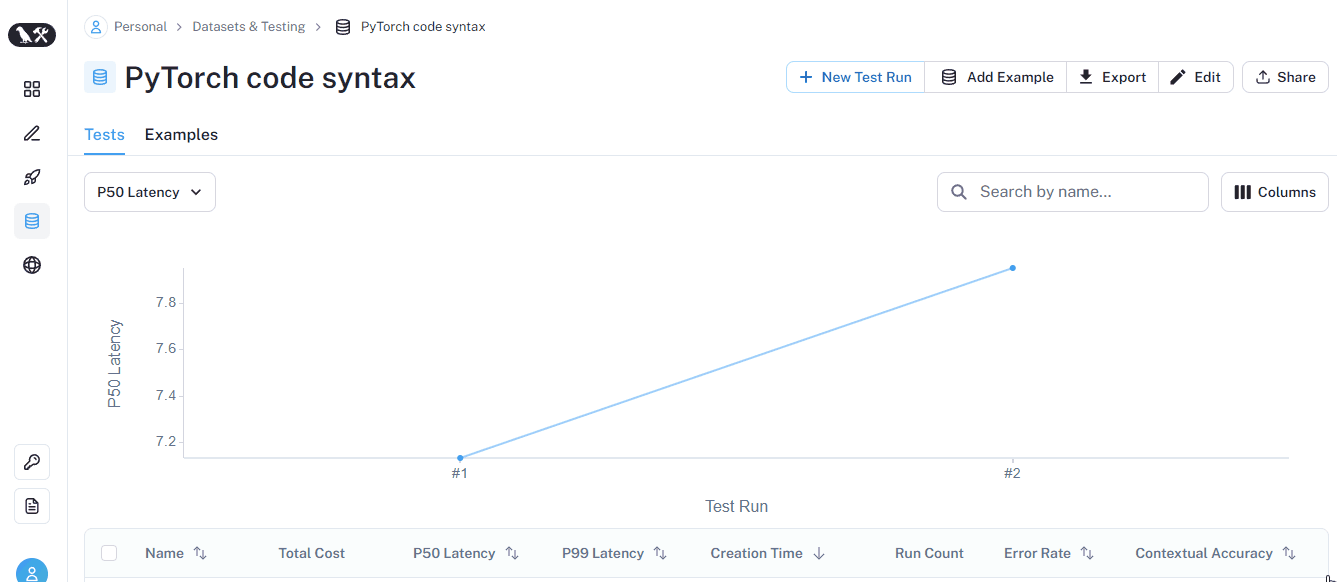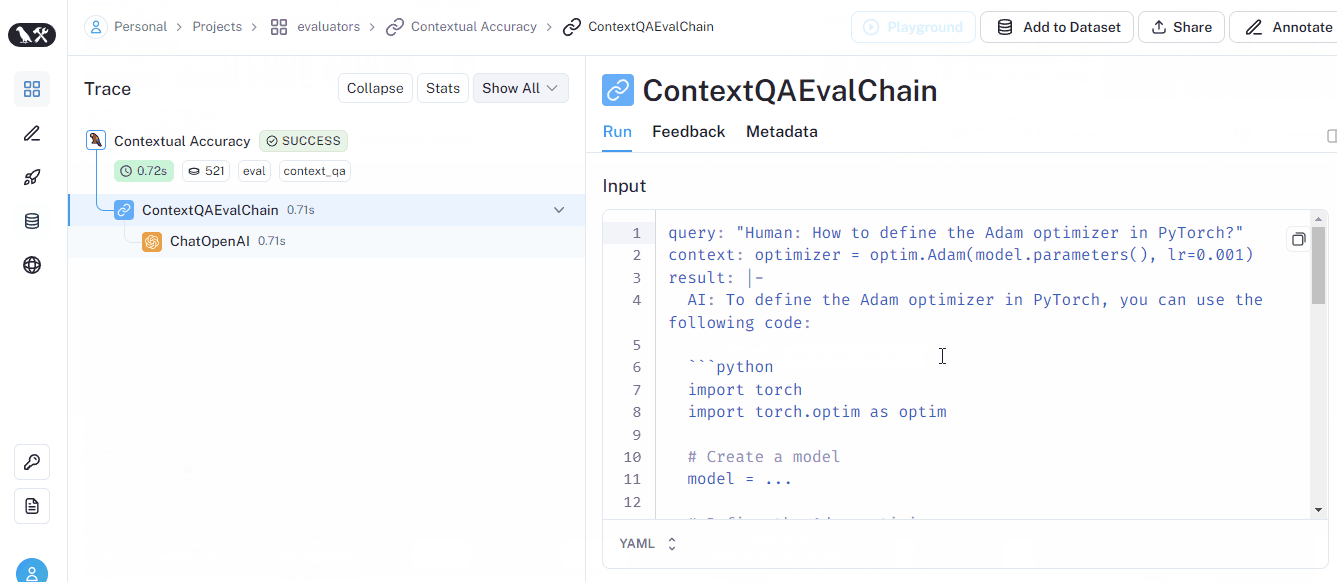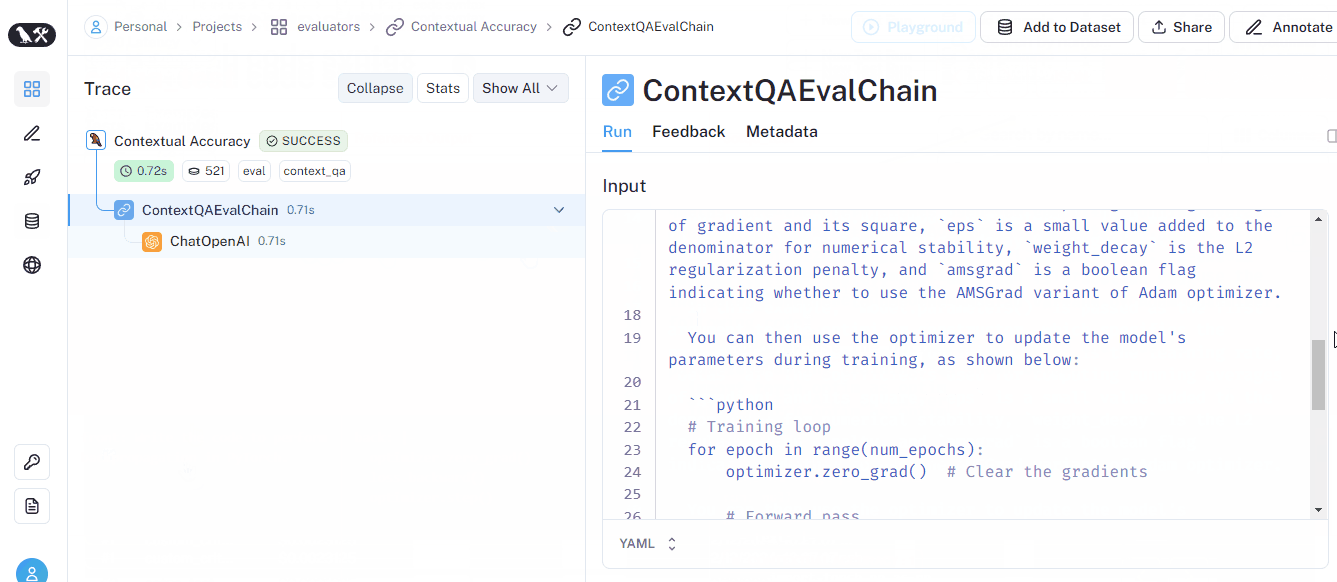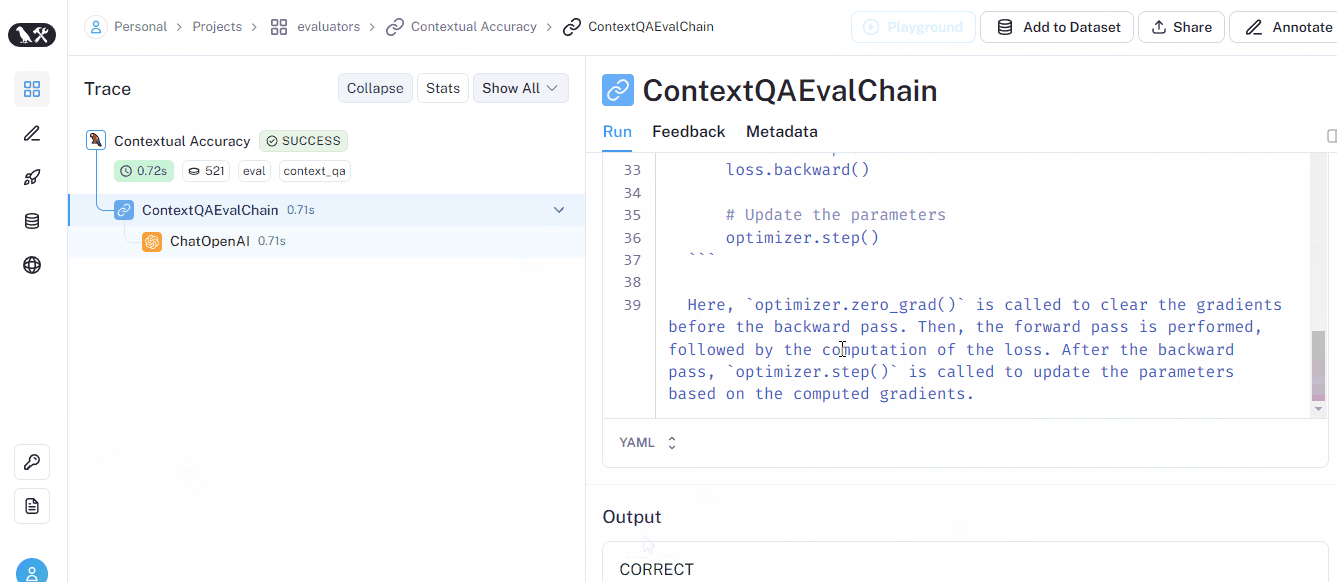
Il criterio CoTQA restituisce un punteggio chiamato Contextual accuracy, come mostrato nella GIF qui sotto (anche nella UI):
Visita la sezione LangChain evaluators della documentazione di LangSmith per saperne molto di più sui valutatori.
Se dopo aver letto questo tutorial hai avuto l’impressione che LangSmith sia in realtà uno strumento complesso per il prompt engineering, ci hai preso! In questo momento, LangSmith è il miglior framework per assicurarsi che le istruzioni e gli output degli LLM siano davvero quelli che vuoi.
Avrai anche notato l’impegno necessario per costruire applicazioni LLM di livello produttivo. Quindi usa LangSmith per un’esperienza più fluida mentre lavori su progetti LLM.
Se alcuni concetti in LangSmith non ti sono chiari, potresti avere qualche lacuna nelle basi di LangChain. Ecco alcune risorse:
Inizia oggi il tuo percorso con LangChain
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




