Curso
Desenvolvimento de aplicativos de LLM com LangChain
3 h
50.6K
Recentemente encontrei uma plataforma de IA que gera flashcards automaticamente a partir de qualquer tipo de mídia. Como eu adoro memorizar conceitos com repetição espaçada, subi na hora meu tutorial de XGBoost e pedi para a IA criar 50 flashcards sobre ele.
Mas fiquei decepcionado. A maioria das perguntas era fácil demais e quase não havia questões sobre sintaxe de código. Mais estranho ainda, 10% das perguntas eram idênticas e totalmente fora de contexto — “Qual é a capital da França?”.
Erros desse tipo sugerem falta de avaliação e validação adequadas dos outputs produzidos por serviços de IA. Talvez eles não conhecessem o LangSmith.
O LangSmith é uma plataforma completa para testar, depurar e avaliar aplicações com LLMs. Talvez seu recurso mais importante seja a avaliação de outputs de LLM e o monitoramento de performance. Neste tutorial, vamos ver o framework em ação e aprender técnicas para aplicá‑lo nos seus próprios projetos.
Vamos começar!
Como mencionei acima, o LangSmith é uma plataforma abrangente para avaliar aplicações de linguagem de grande porte. Aqui vão alguns recursos e os benefícios práticos que eles trazem:
Programadores conseguem começar a experimentar o LangSmith em minutos, não horas. Isso significa que um time pequeno ou um desenvolvedor solo pode prototipar uma aplicação de IA no fim de semana e, potencialmente, lançar um serviço pago já na segunda-feira.
Com ferramentas de avaliação rigorosas, empresas evitam o constrangimento e o custo de lançar IAs com falhas (como no exemplo da introdução). O LangSmith permite checar o output de LLMs com critérios nativos, como utilidade, coerência, misoginia, ou até avaliações personalizadas em linguagem natural, como “O conteúdo do output é clichê?” ou, no caso de geração de flashcards, “O card contém uma pergunta de programação?”.
O LangSmith usa traces para registrar praticamente todos os aspectos das execuções de LLM. Isso inclui métricas como latência, contagem de tokens, custo das execuções e vários tipos de metadados. A interface web permite filtrar rapidamente execuções por porcentagem de erro, latência, data ou até pelo conteúdo do texto usando linguagem natural. Isso quer dizer que, se um tutor de IA começar a apresentar respostas com falhas a alunos reais, você consegue liberar uma correção em poucas horas.
O LangChain é o framework “pai” do LangSmith, focado especificamente na fase de desenvolvimento com LLMs. Ele oferece um design modular para encadear vários LLMs (agentes) e integrá-los a outras APIs como YouTube, Google Search e muito mais. O LangSmith é a cereja do bolo, garantindo que protótipos construídos com LangChain performem como esperado por meio de suas ferramentas poderosas de avaliação e monitoramento.
Confira nosso tutorial sobre aplicações com LLM no LangChain para saber mais.
Outro recurso excelente do LangSmith são os datasets. Eles podem ser usados para melhorar cadeias, agentes ou modelos do LangChain com um conjunto de exemplos padronizados antes do deploy. Por exemplo, podemos ter um arquivo CSV com duas colunas — perguntas e respostas para flashcards em um formato específico.
Ao converter esse arquivo em um dataset de referência, podemos instruir os LLMs a avaliar seus próprios outputs usando as métricas de garantia de qualidade mencionadas anteriormente.
Agora vamos ver todos esses recursos na prática, um por um.
No desenvolvimento de apps de ML, você coleta dados, treina, faz fine-tuning, testa e faz o deploy dos modelos — as etapas são bem definidas. Já em apps com LLM, você geralmente começa com um modelo pronto de um fornecedor. Fine-tuning? Pode sair caro. Então você vai focar bastante em criar os prompts certos — tudo gira em torno de fazer as perguntas corretas ao seu app de LLM. Pense nisso como precisar de muitos prompts para testar as coisas, do mesmo jeito que você precisa de muitos dados para um bom modelo de ML.
Porém, com prompts você lida com textos de entrada e saída, não números. Então, métricas tradicionais de erro ou acurácia, como MSE ou entropia cruzada, não se aplicam aqui. E imaginar ler cada input e output para avaliar — isso levaria dias se você tiver milhares de prompts.
Você precisa, portanto, de um workflow focado em criar e testar prompts com eficiência para medir o desempenho do seu app com LLM sem se afogar em checagens manuais. Eis como isso pode parecer:
Nesta etapa, você vai prototipar a base da sua aplicação usando frameworks como o LangChain. Para um projeto de gerador de flashcards, seu protótipo pode incluir vários componentes em cima do LLM escolhido do fornecedor. Por exemplo, você pode precisar encadear com:
e por aí vai (veja que tipo de componente você pode adicionar nesta página da documentação do LangChain). Mas você pode reduzir drasticamente o tempo de desenvolvimento usando chains prontas oferecidas pelo LangChain para tarefas comuns de alto nível.
Nesta etapa, você vai testar sua aplicação no maior número possível de cenários. Isso significa garantir que cada componente adicionado funcione bem, se encadeie corretamente e gere outputs consistentes e de alta qualidade.
Como LLMs são não determinísticos (não geram sempre o mesmo output para a mesma entrada) e pela complexidade dos componentes adicionados, você vai gastar a maior parte do tempo aqui. E o LangSmith foi desenvolvido justamente para encurtar ao máximo esse período. Vamos falar mais sobre isso ao longo do tutorial.
Quando sua aplicação estiver viável, você pode fazer o deploy como uma API REST. Uma API REST basicamente converte suas cadeias ou agentes do LangChain em links HTTPS para que outros façam requisições e interajam com seu modelo de IA. Agora você constrói a interface do usuário do seu serviço, como um aplicativo desktop ou, mais comumente, um site.
No momento, não há um jeito super simples de fazer isso, mas os desenvolvedores do LangChain estão prestes a lançar o LangServe, que será integrado ao FastAPI (imagina que incrível!). Veja o sneak peek nesta página da documentação.
Agora sim, vamos colocar a mão na massa com o LangSmith.
Vamos começar entendendo a interface web. Ela está disponível em smith.langchain.com. Para ter acesso, você precisa se cadastrar e ser liberado da lista de espera, pois está em beta fechado.
Depois que você entrar, a página inicial será assim:
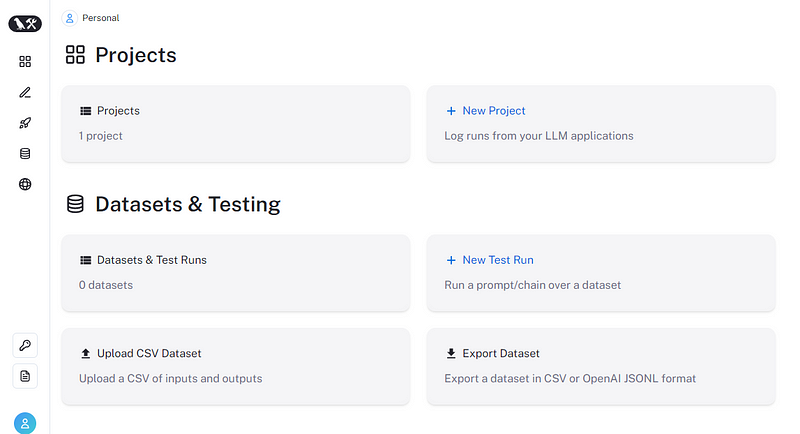
As duas seções principais são projects e datasets & testing, e ambas podem ser manipuladas pelo SDK em Python. A plataforma também tem abas para deployment e filas de anotação, mas isso foge ao escopo deste artigo.
Gerenciar projetos no LangSmith é muito mais fácil com o SDK em Python, que se conecta à plataforma via chave de API.
Para obter uma chave, clique no ícone de chave na plataforma e salve-a em um local seguro. Depois, em um novo diretório com um novo ambiente virtual inicializado, crie um arquivo .env. Dentro dele, cole as duas linhas a seguir:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Em seguida, no terminal, rode os comandos abaixo para instalar o LangSmith e o python-dotenv para ler variáveis de ambiente:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Agora, vamos escrever código:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
Importamos as funções find_dotenv e load_dotenv para ler variáveis de ambiente e configurá-las com os:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Definir LANGCHAIN_TRACING_V2 como true ativa o tracing (log), essencial para depurar LLMs. Depois, inicializamos um client para conversar com a plataforma LangSmith:
from langsmith import Client

# Initialize a client
client = Client()
O client traz comandos de alto nível para manipular projetos e ativos no LangSmith. O primeiro comando que vamos usar é criar um novo projeto:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
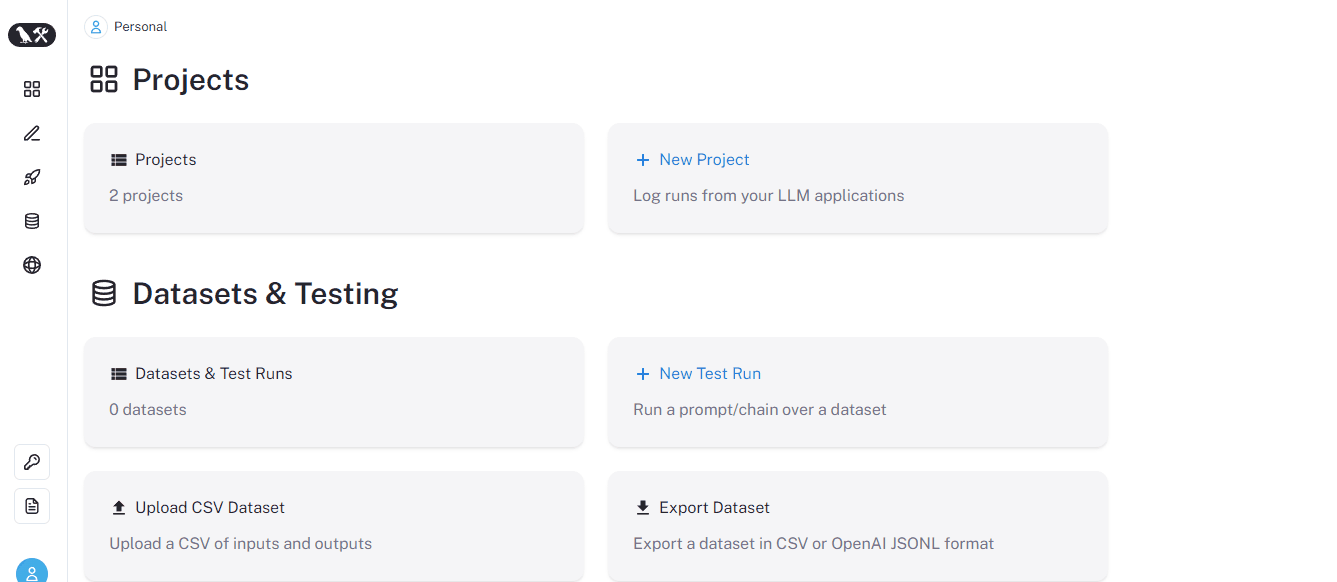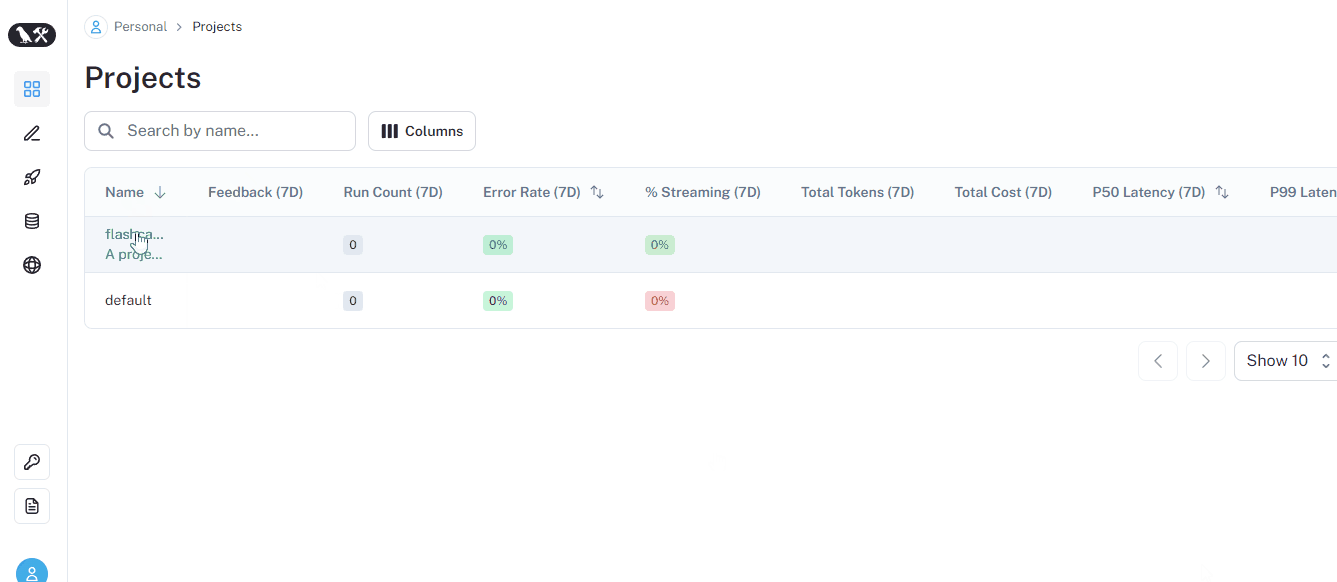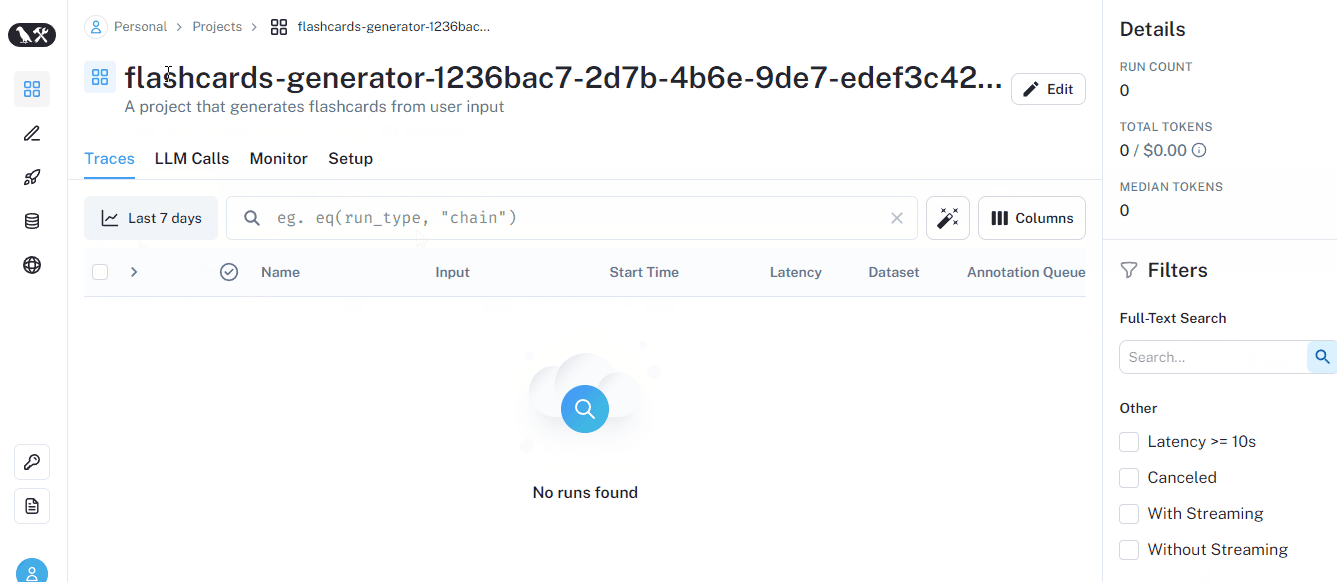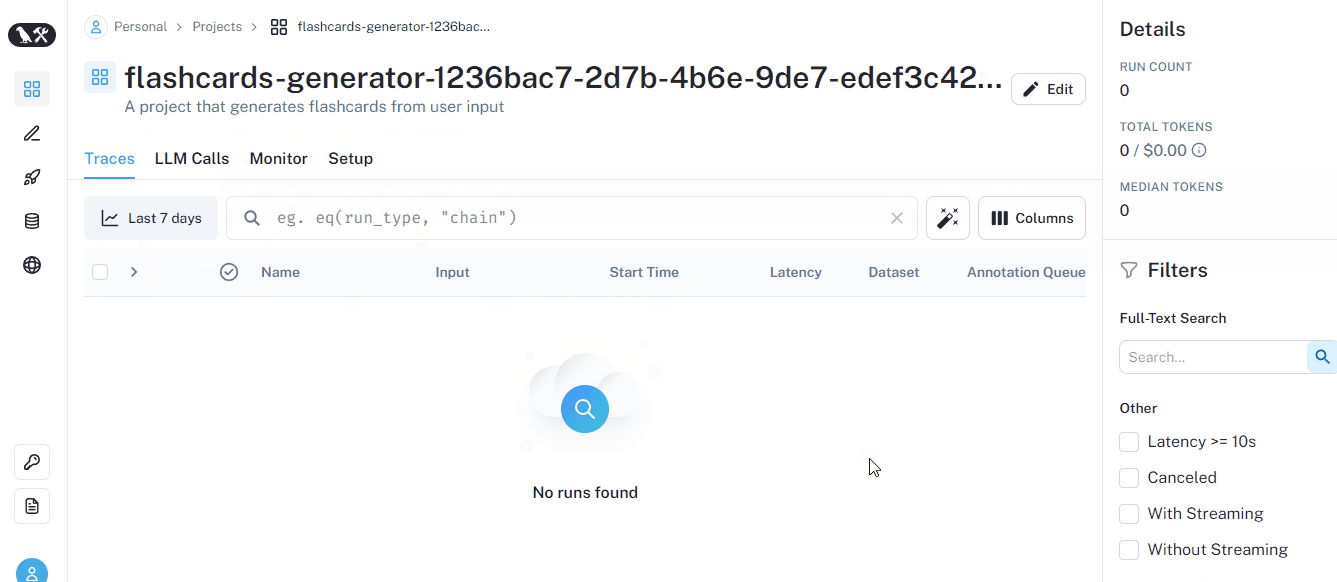
Depois que o create_project rodar com sucesso, você verá o projeto listado na seção Projects da interface web:
Agora precisamos definir o novo projeto como padrão com outra variável de ambiente:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Agora precisamos de um LLM para o nosso projeto. Vamos usar o GPT-3.5 turbo por ser mais barato, mas você pode usar vários outros modelos disponíveis via langchain. Modelos da OpenAI são inicializados com a classe ChatOpenAI.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Vamos fazer nossa primeira execução:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
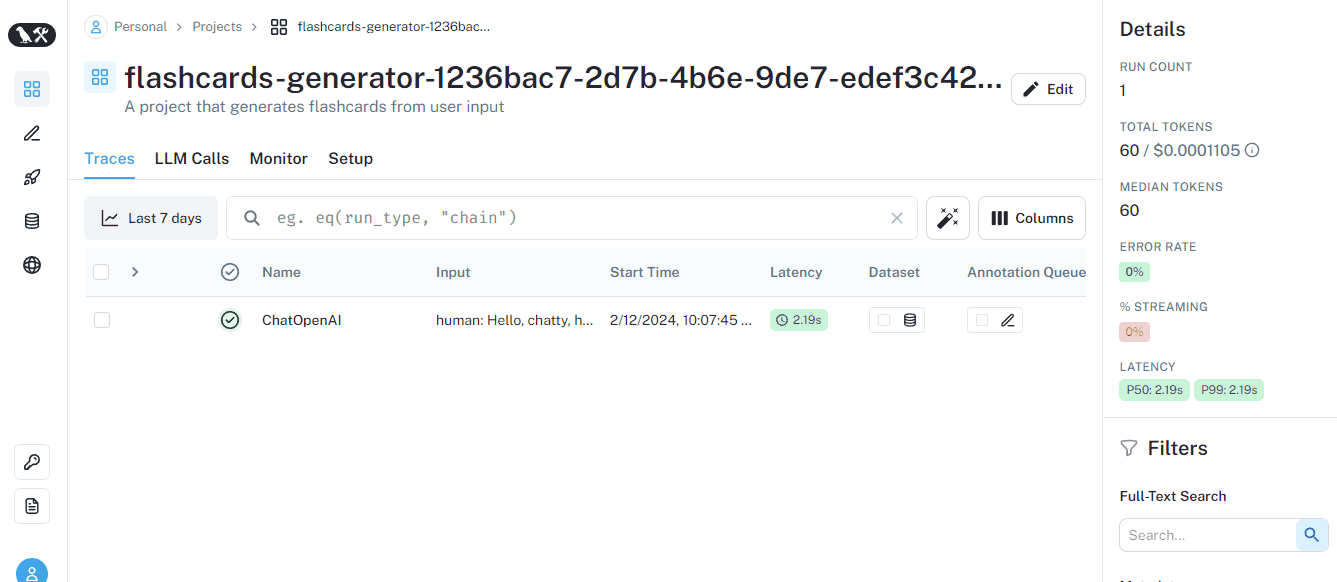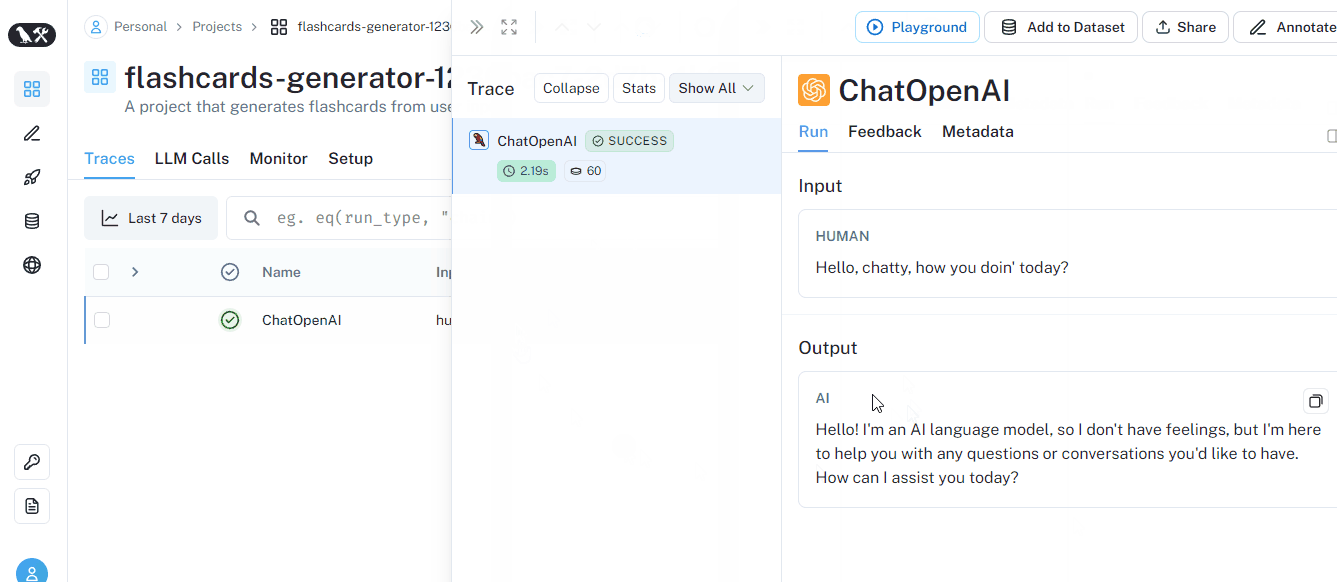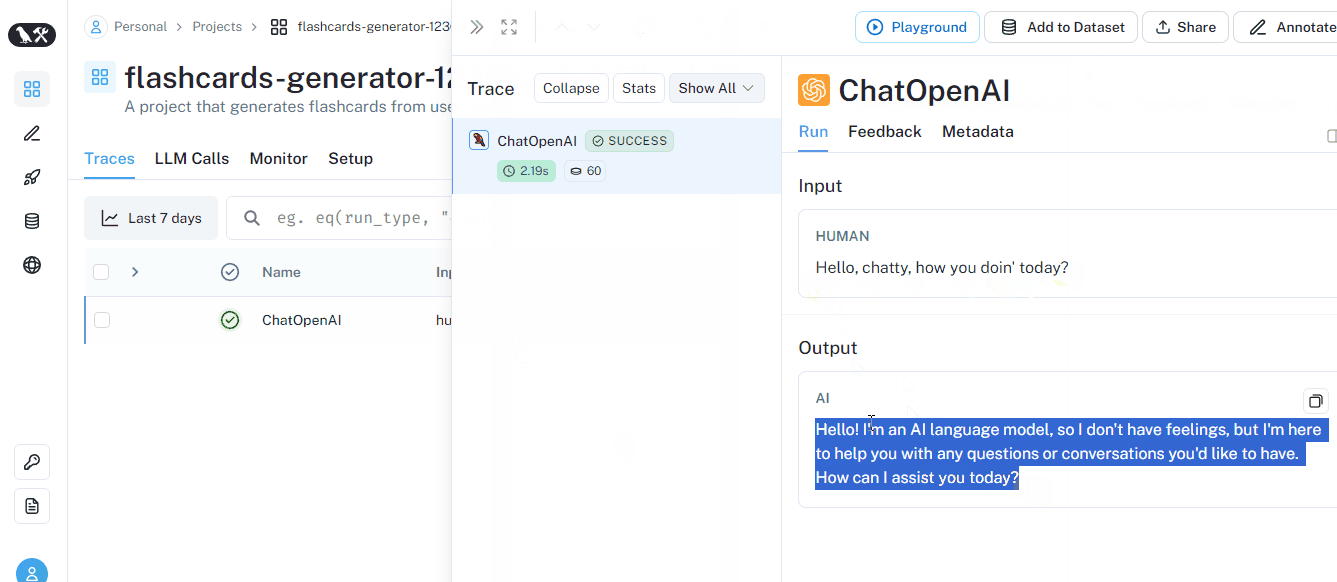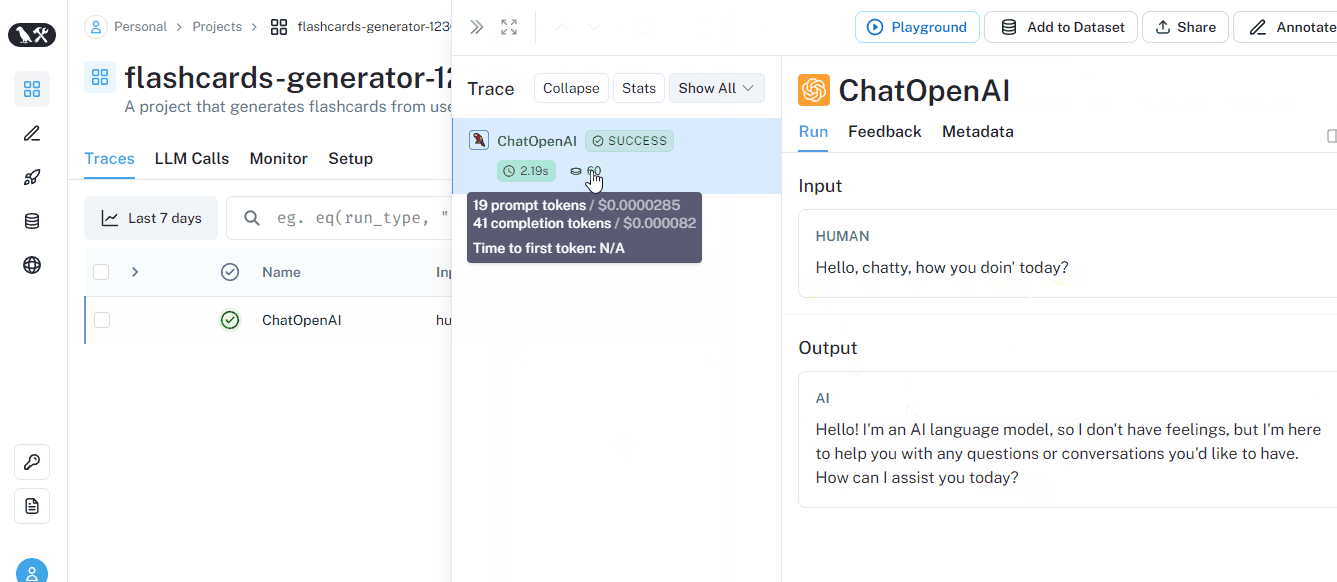
Se você checar rapidamente o projeto na interface, verá a execução acima registrada (logada):
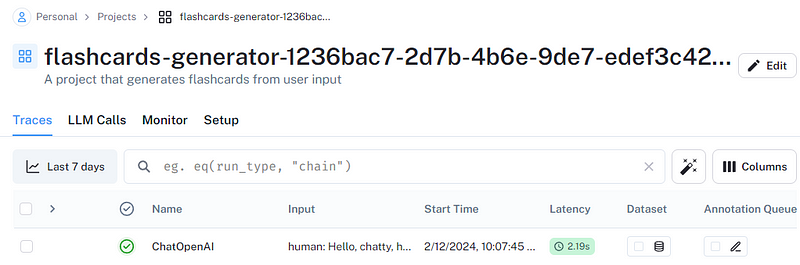
Ao configurar as variáveis de ambiente e o client, ativamos o logging automaticamente. Como dá para ver, já temos um monte de metadados sobre a execução.
Vamos rodar mais alguns prompts:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Já dá para montar um resumidor de texto básico. Vamos resumir o output da última execução:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Perfeito, agora é hora de criar nosso primeiro dataset.
Como mencionei na seção “workflow de desenvolvimento de aplicações com LLM”, você provavelmente vai precisar criar ou coletar milhares de prompts para avaliar seu modelo, cadeia ou agente. Rodar um por um, como fizemos acima, não é a melhor prática.
Por isso, o LangSmith oferece datasets em três tipos:
kv) - padrão: define entradas como pares arbitrários de chave-valor. Úteis quando se avaliam chains e agentes que exigem múltiplas entradas ou retornam múltiplas saídas.llm): entradas e saídas definidas em “estilo completion” por LLMs — string entra, string sai.chat): datasets convertidos de chats de LLM e definidos com entradas estruturadas e mensagens serializadas.Primeiro, vamos ver como criar um dataset key-value sem saídas. Vamos usar a função create_dataset do client:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Agora, vamos adicionar três entradas, cada uma pedindo ao LLM para criar um único flashcard:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
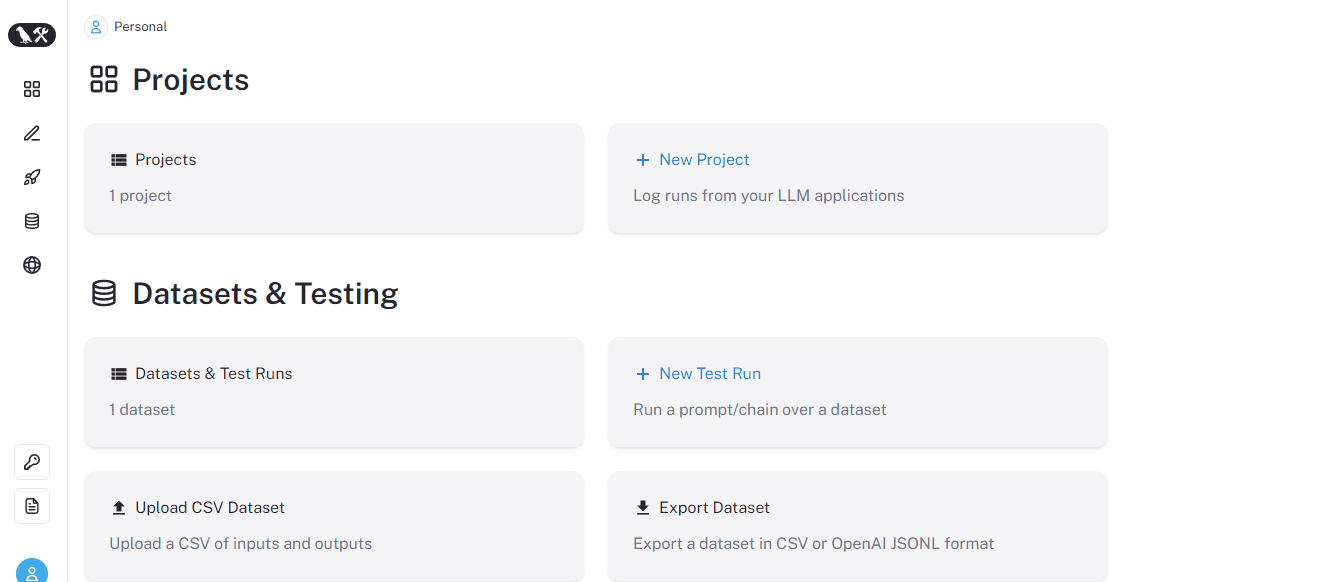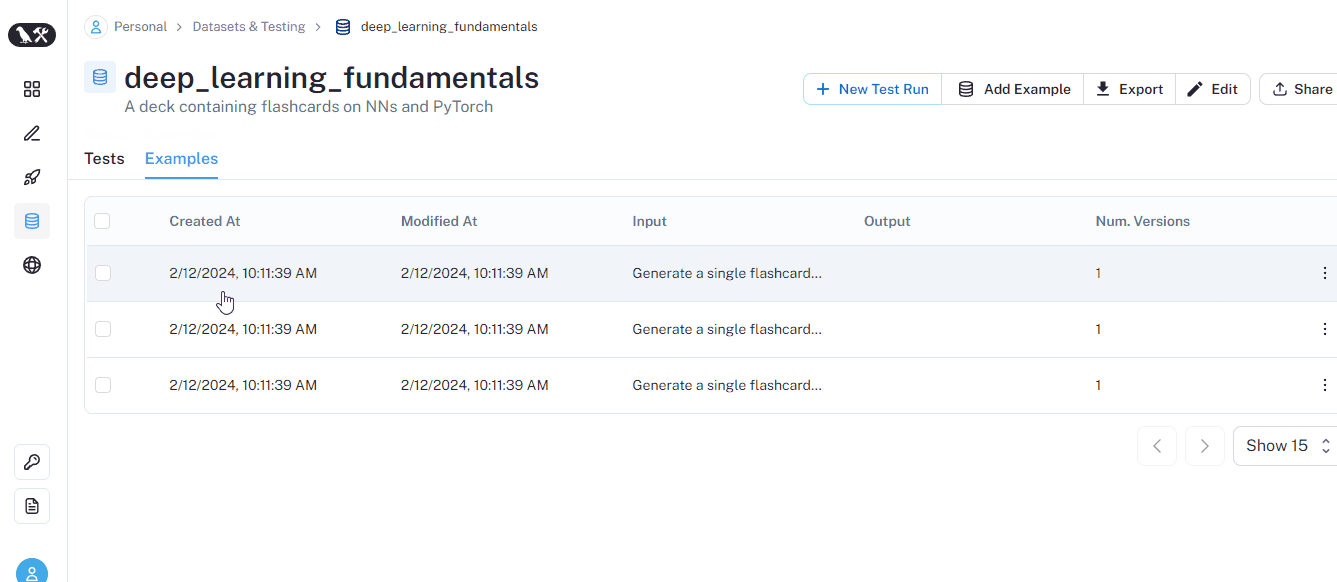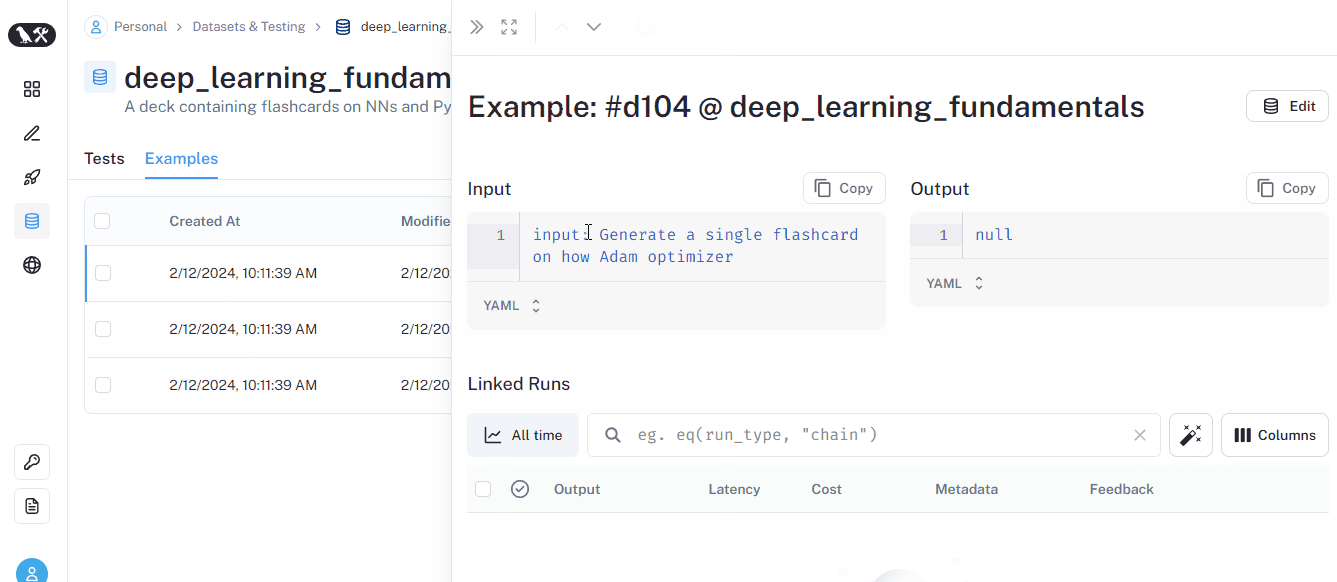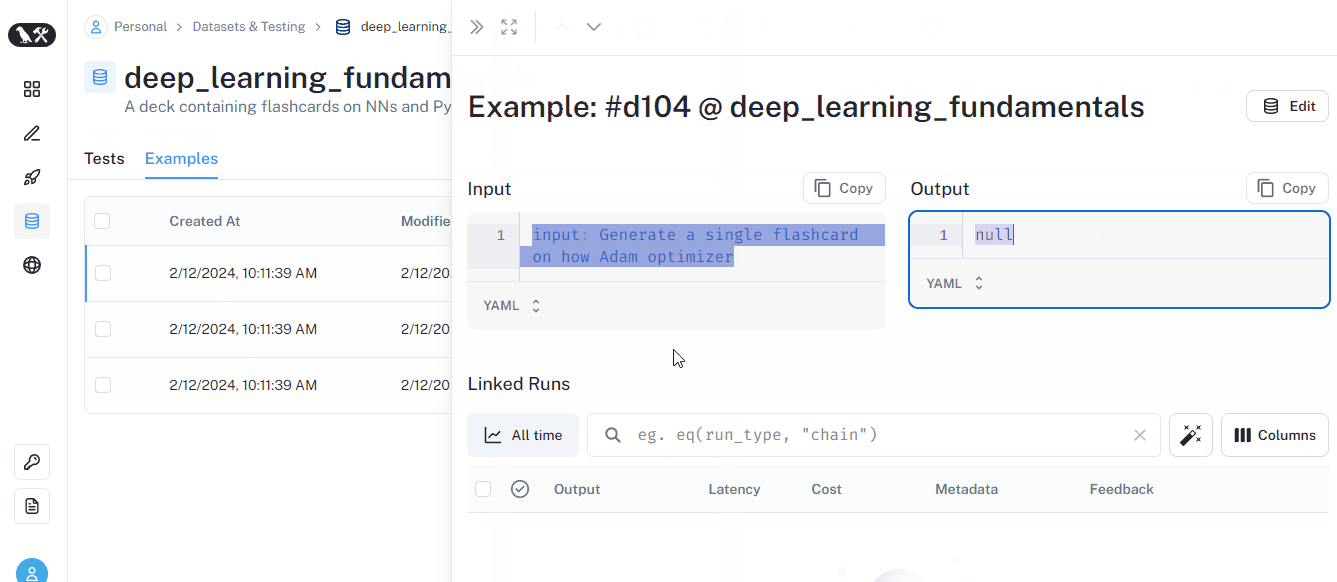
Se você for até a aba de datasets na interface, verá cada prompt listado com saída NULL:
Agora, vamos rodar todos os prompts em uma única linha de código usando a função run_on_dataset:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Quando a execução terminar, ela aparecerá na página do dataset. Veja como fica:
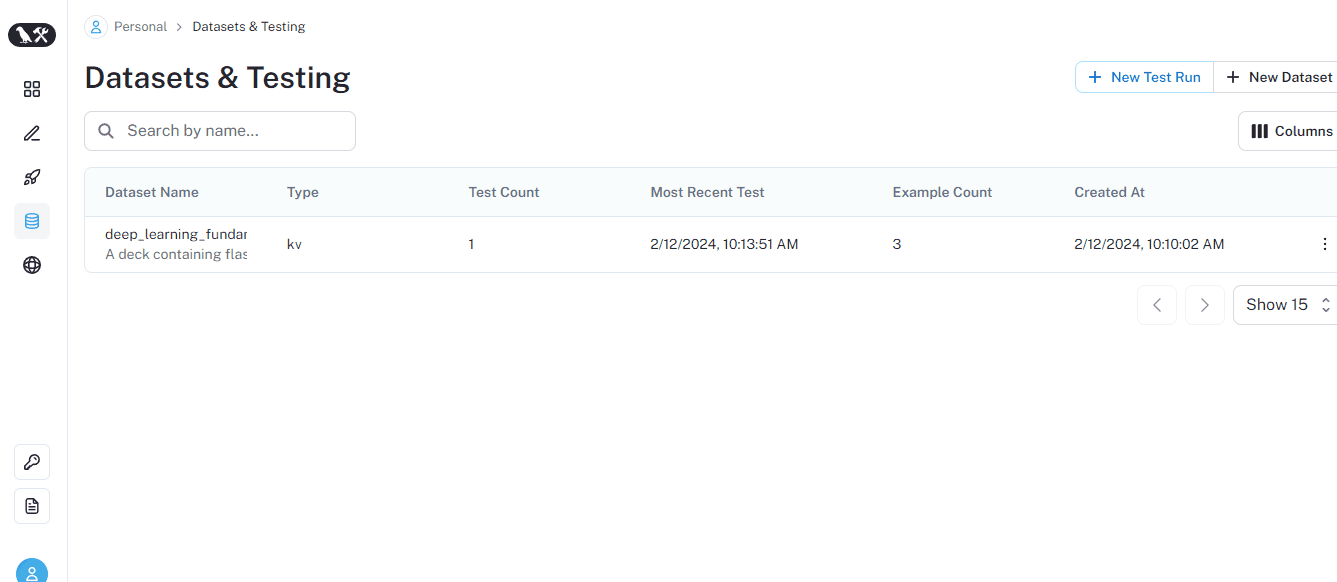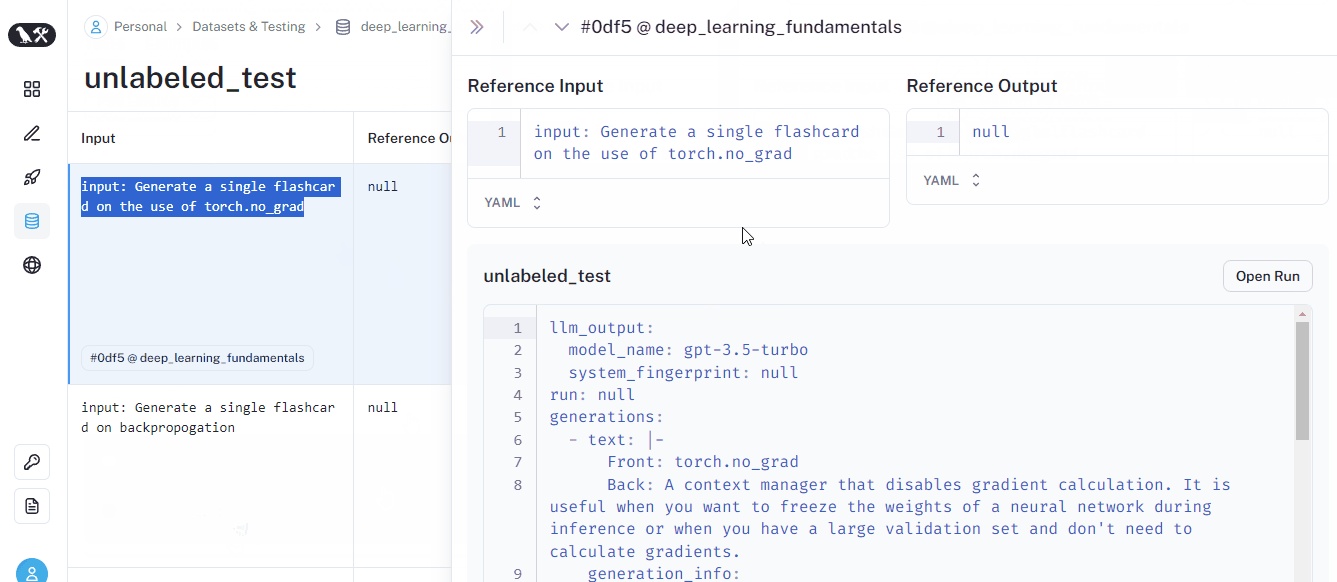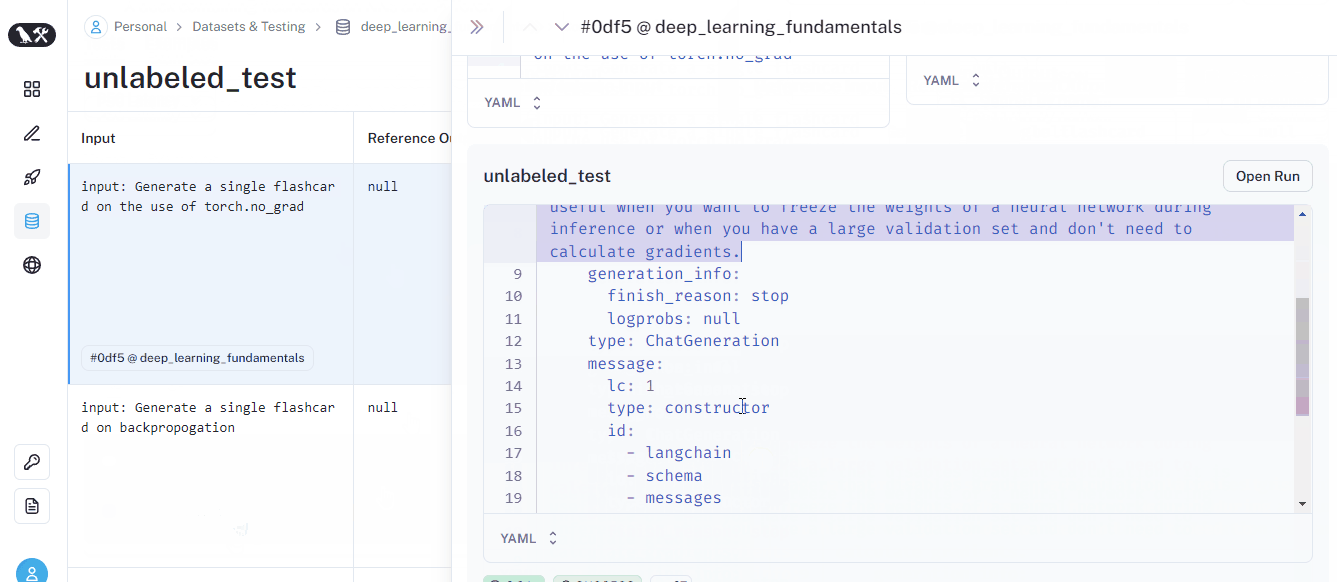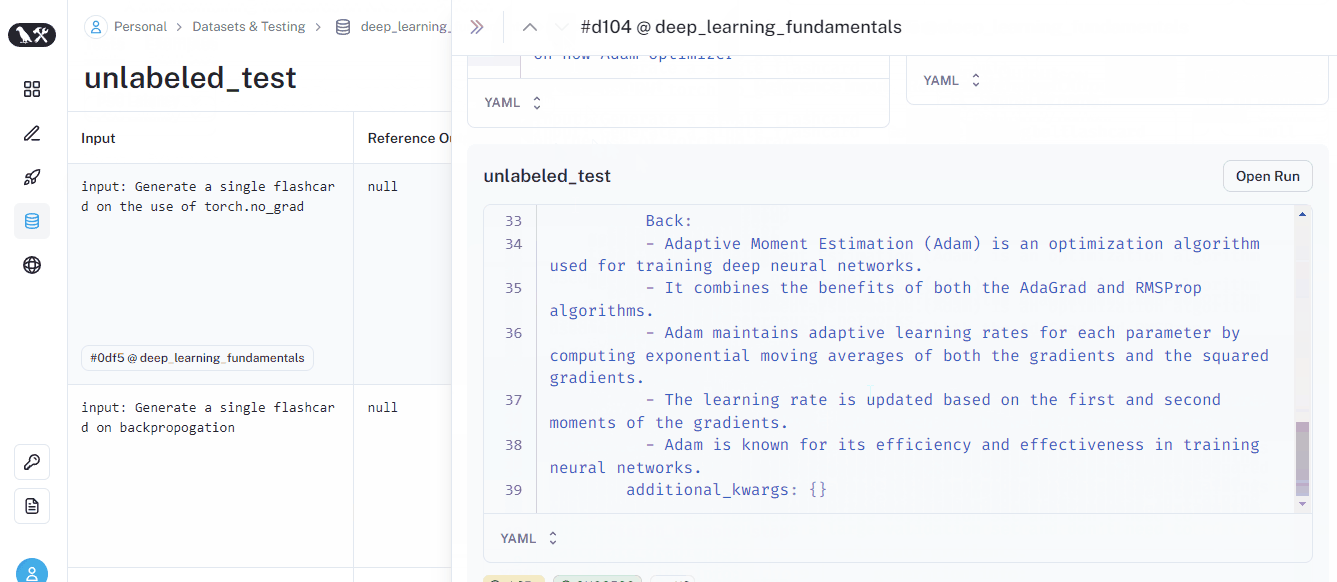
Acabamos de fazer um teste em um dataset não rotulado — um dataset com prompts de exemplo, mas sem outputs de referência. Nosso teste apenas gerou uma resposta para cada prompt, sem avaliar nada. Mas queremos fazer checagens básicas como “O output é útil?” ou “A resposta é curta ou longa?”
O LangSmith permite realizar essas checagens usando avaliadores nativos.
Para rodar avaliações de conciseness e coherence usando os três prompts do nosso dataset, podemos usar a classe RunEvalConfig:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Acima, definimos dois critérios em uma lista chamada evaluators. Passamos esses avaliadores para o parâmetro evaluation da função run_on_dataset:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
O run_on_dataset é uma função útil para rodar todos os prompts de um dataset com o LLM fornecido e realizar qualquer tipo de avaliação em tempo real. Os resultados ficam visíveis na página dedicada de cada dataset:
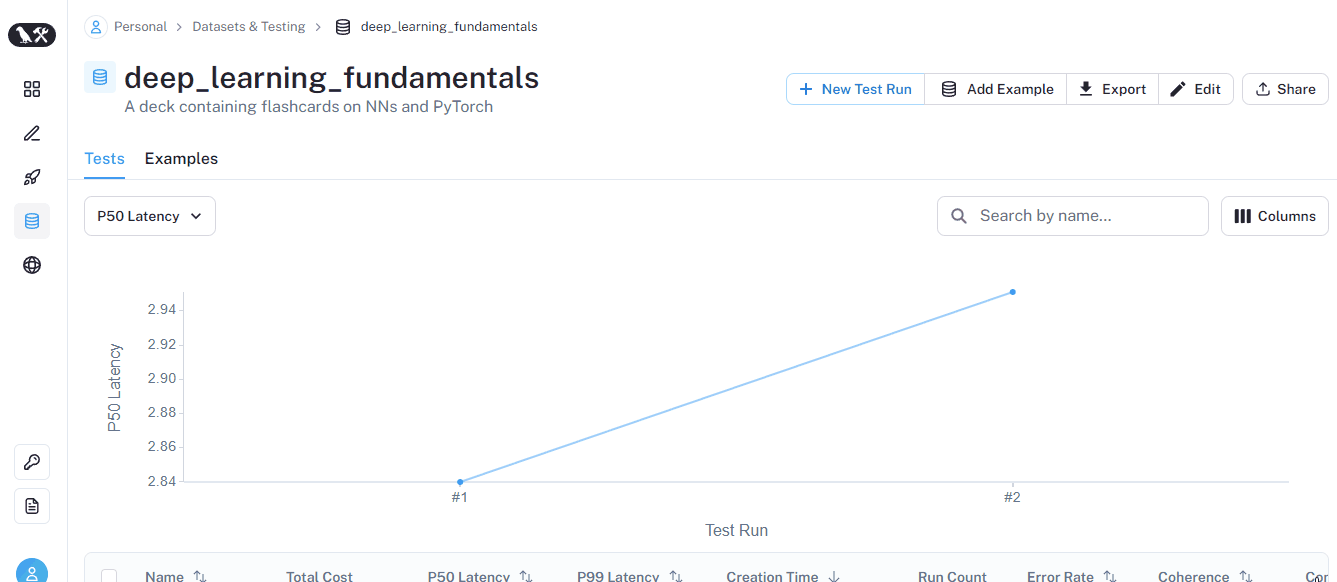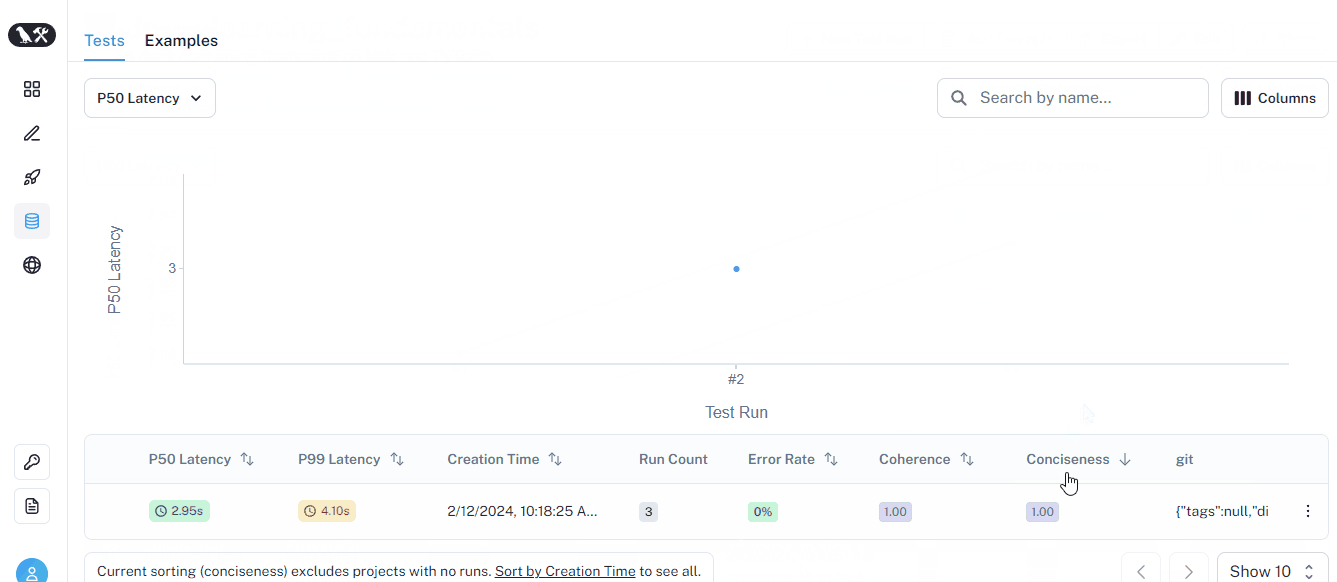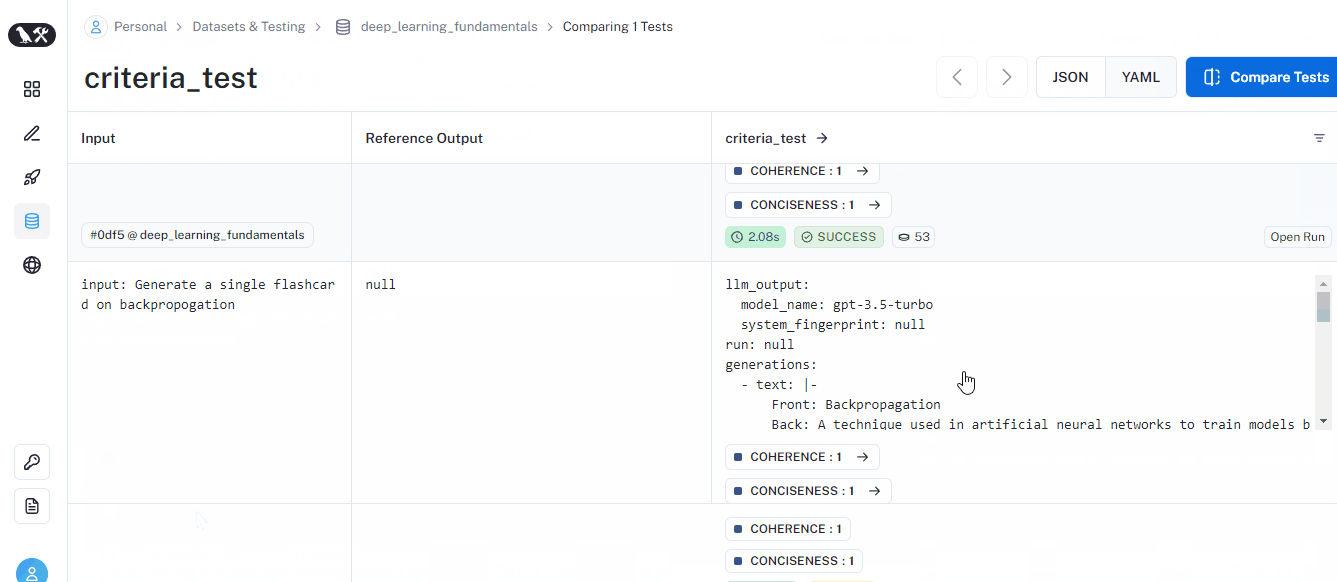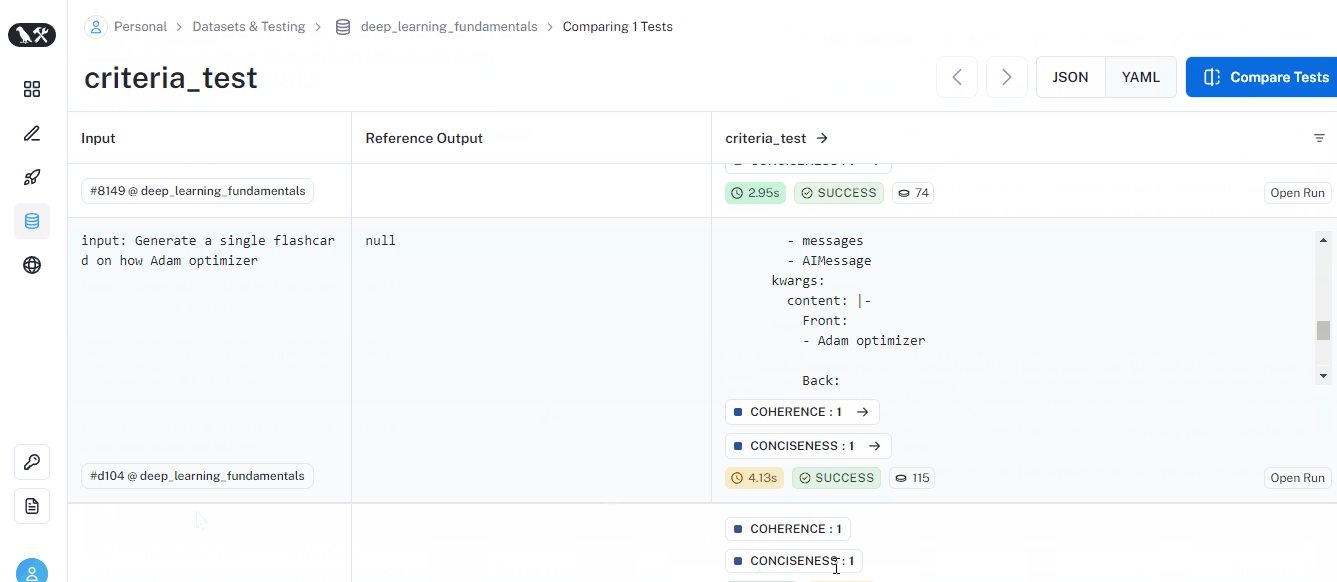
Desta vez, a execução trouxe métricas de coerência e concisão para cada prompt. Na parte inferior, você também verá uma média para cada métrica.
Para ver a lista completa de critérios nativos, rode o snippet abaixo:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Claro que nem todos os casos de uso com LLM podem ser verificados com avaliadores básicos. Por exemplo, não há um avaliador para checar se um flashcard contém uma pergunta de programação. Então, vamos defini-lo:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Para passar um critério personalizado em linguagem natural, basta enviar {“criteria_name”: “Condição a checar”} para a classe Criteria. Acima, estamos criando dois avaliadores extras, então o LangSmith vai rodar dois prompts adicionais em cima do output produzido pelos prompts do nosso dataset:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Se você conferir a execução, verá os critérios personalizados que definimos sob cada prompt. Ao passar o mouse, você verá também o raciocínio do LLM:
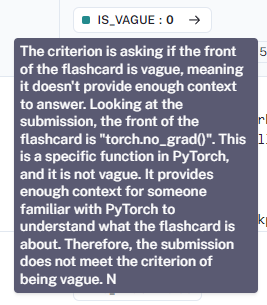
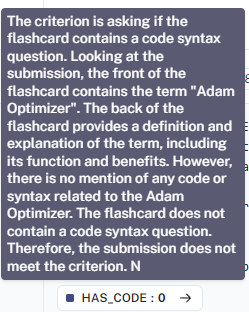
Ao checar os resultados da avaliação para todos os prompts, você verá que nossos critérios não estão avaliando como esperado. Então aqui vai um ponto de atenção — você também precisa fazer prompt engineering nos seus critérios para garantir que eles verifiquem as coisas certas.
Às vezes, você pode optar por criar um dataset de prompts com outputs esperados, ou seja, datasets rotulados. É possível criar datasets rotulados em vários formatos, mas talvez o mais comum seja um arquivo CSV. Por exemplo, aqui está um arquivo que gerei com o ChatGPT contendo cinco perguntas sobre sintaxe do PyTorch:
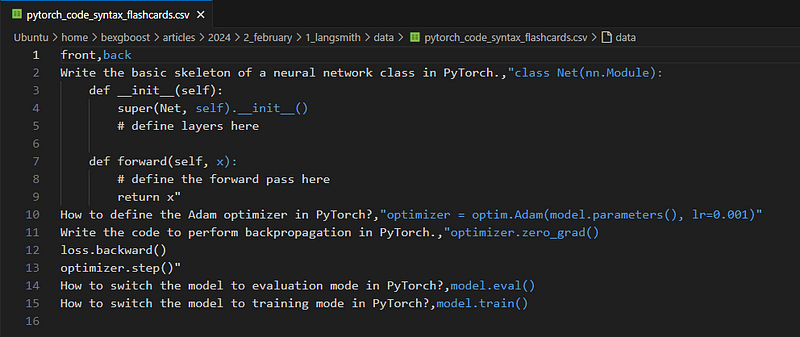
Para criar um dataset a partir disso, podemos usar a função upload_csv:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
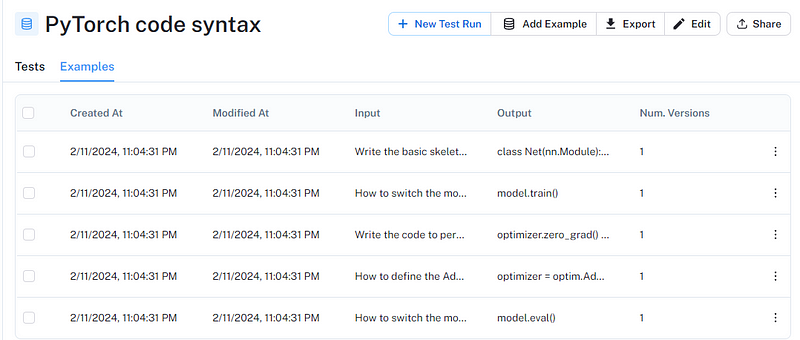
A função tem três parâmetros obrigatórios: o caminho do CSV e os nomes das colunas de input/output. Quando o upload terminar, o dataset aparecerá na interface:
Vamos rodar também nossos critérios personalizados da seção anterior nesse dataset:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
Indo até a página do dataset e verificando a execução, conseguimos ver as pontuações médias de cada critério personalizado:
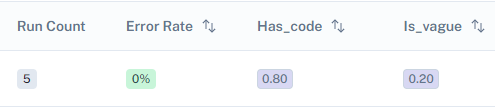
Avaliadores nativos e personalizados escritos em linguagem natural são mais indicados para datasets não rotulados. Para datasets rotulados, como o CSV que subimos, o LangSmith oferece avaliadores mais completos para medir a correção da resposta a um prompt:
context_qa (Q&A contextual): usa o output de referência como contexto ao avaliar a correçãoqa (Q&A): instrui o LLM a classificar diretamente uma resposta como “correta” ou “incorreta” usando o output de referênciacot_qa (Chain‑of‑thought Q&A): semelhante ao context_qa, mas força o LLM a usar raciocínio chain‑of‑thought antes do veredito.Vamos testar o último nos nossos exemplos:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
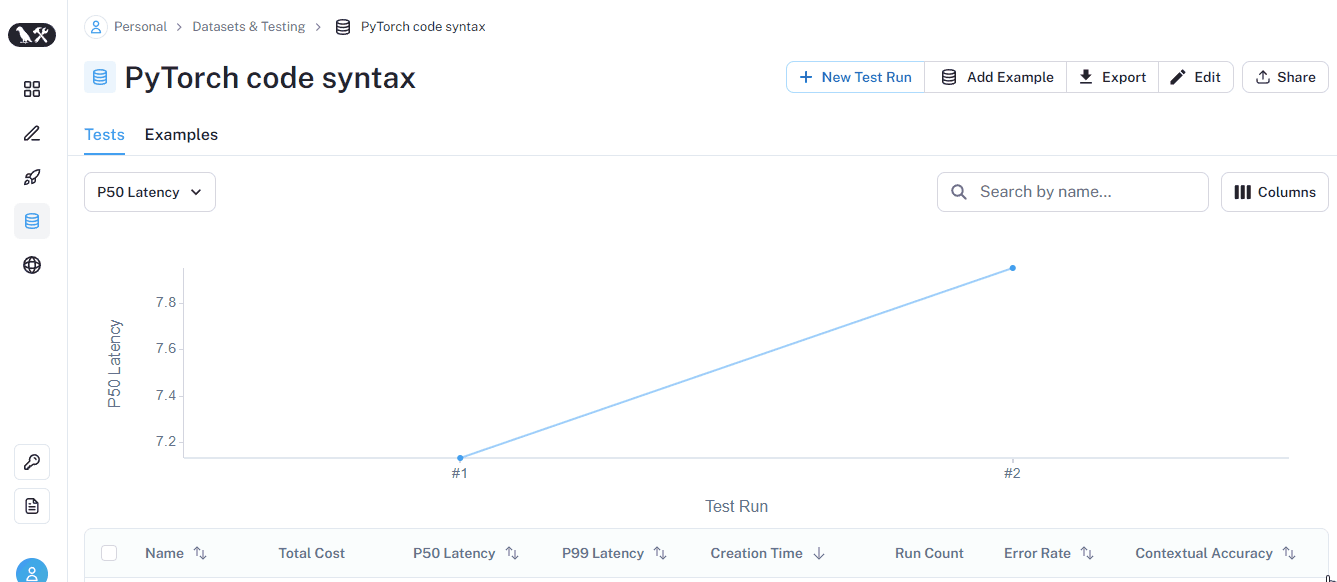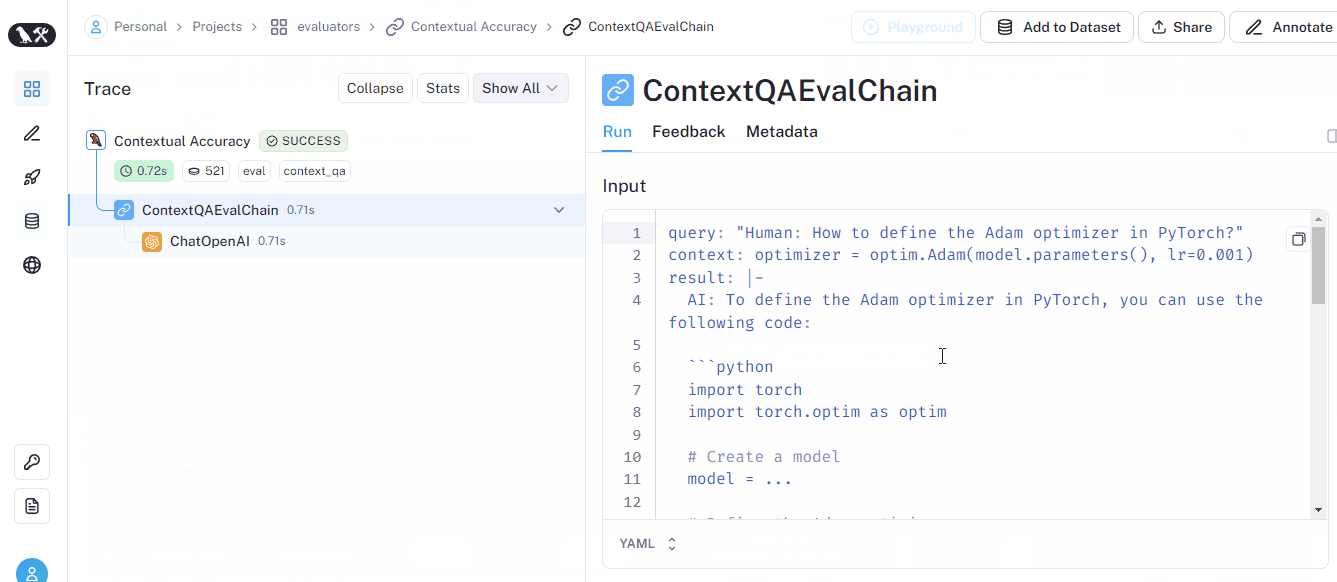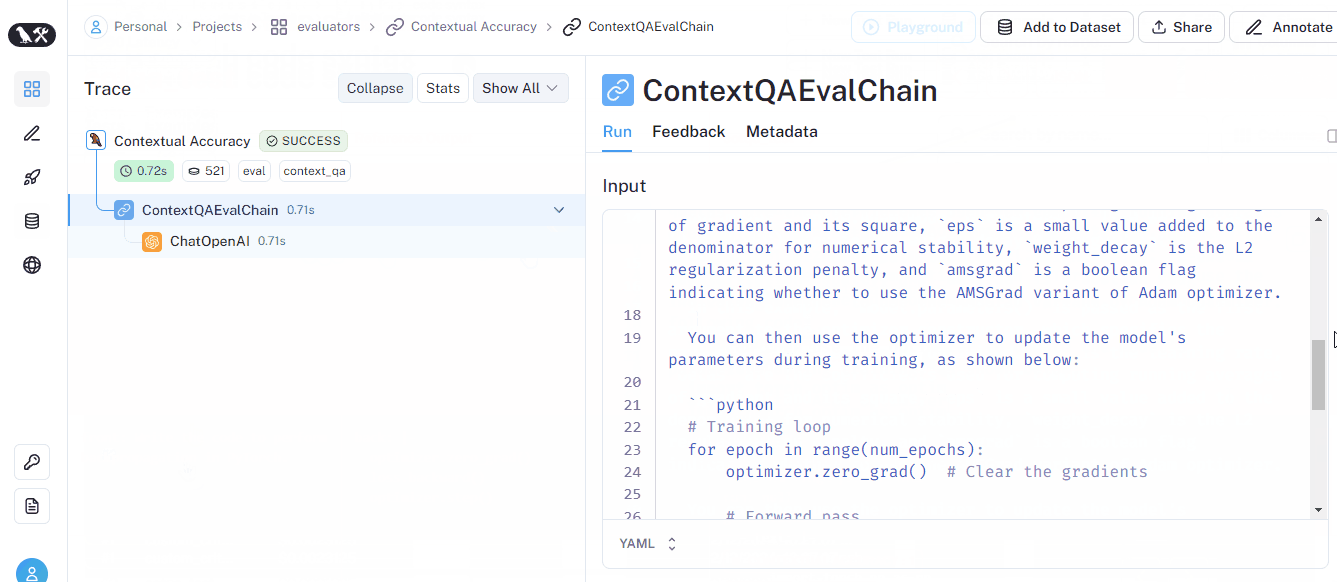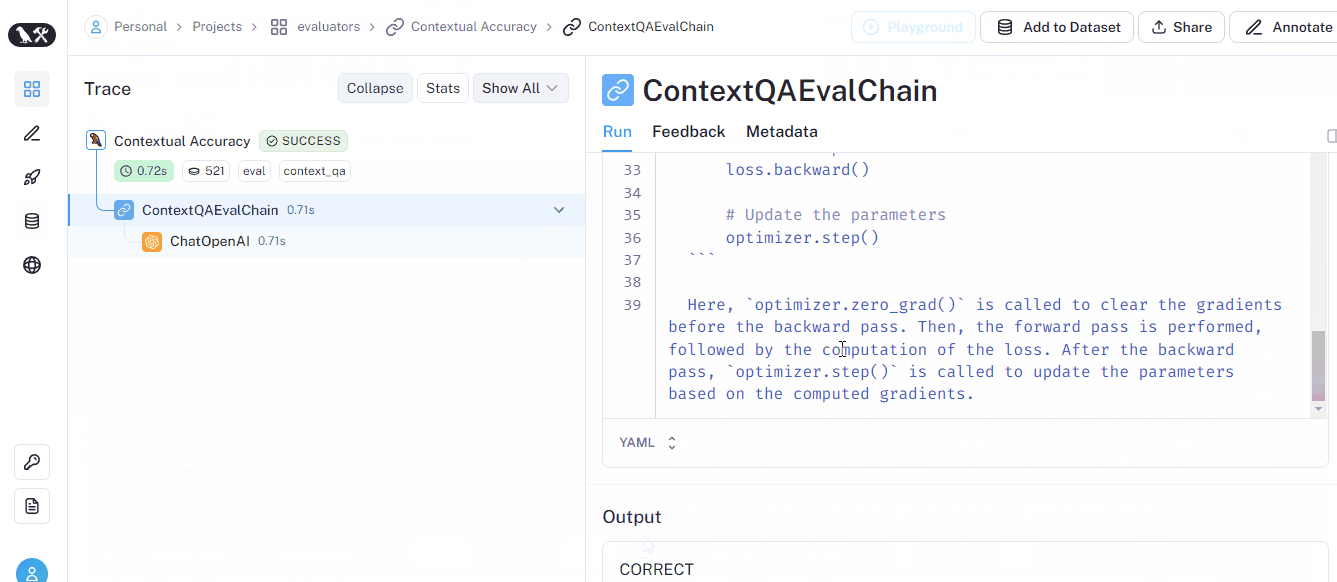
O critério CoTQA retorna uma pontuação chamada Contextual accuracy, como mostrado no GIF abaixo (também disponível na interface):
Visite a seção de avaliadores do LangChain na documentação do LangSmith para saber muito mais sobre eles.
Se, ao ler este tutorial, você ficou com a impressão de que o LangSmith é, no fim das contas, uma ferramenta robusta para engenharia de prompts, você está certo! Hoje, o LangSmith é o melhor framework para garantir que as instruções e os outputs dos LLMs sejam exatamente o que você precisa.
Você também deve ter percebido o esforço necessário para construir aplicações com LLM em nível de produção. Use o LangSmith para ter uma experiência mais tranquila enquanto trabalha em projetos com LLM.
Se alguns conceitos do LangSmith não fizeram sentido, talvez esteja faltando revisar alguns fundamentos do LangChain. Aqui vão alguns materiais:
Comece sua jornada com LangChain hoje
Curso
Curso
Curso
blog
Abid Ali Awan
8 min
blog
Nisha Arya Ahmed
12 min
blog
Abid Ali Awan
13 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
11 min