
कोर्स
LangChain के साथ LLM एप्लिकेशन विकसित करना
3 घंटा
51.4K
हाल ही में मुझे एक AI प्लेटफ़ॉर्म मिला जो किसी भी प्रकार के मीडिया से अपने-आप फ्लैशकार्ड बनाता है। चूंकि मुझे स्पेस्ड रिपिटिशन से अवधारणाएँ याद रखना पसंद है, मैंने तुरंत अपना XGBoost ट्यूटोरियल अपलोड किया और AI से इस पर 50 फ्लैशकार्ड बनाने को कहा।
पर मैं निराश हो गया। ज़्यादातर सवाल बहुत आसान थे, और बहुत कम सवाल कोड सिंटैक्स पर थे। और भी अजीब यह कि 10% सवाल एक जैसे और बिल्कुल संदर्भ से बाहर थे—“फ्रांस की राजधानी क्या है?”।
ऐसी गलतियाँ बताती हैं कि AI सेवाओं द्वारा उत्पन्न आउटपुट का ठीक से मूल्यांकन और वैधता-जांच नहीं हुई। शायद उन्हें LangSmith के बारे में पता नहीं था।
LangSmith LLM अनुप्रयोगों के परीक्षण, डीबगिंग और मूल्यांकन के लिए एक पूर्ण प्लेटफ़ॉर्म है। शायद इसकी सबसे महत्वपूर्ण विशेषता है LLM आउटपुट का मूल्यांकन और प्रदर्शन मॉनिटरिंग। इस ट्यूटोरियल में, हम इस फ़्रेमवर्क को काम करते हुए देखेंगे और इसे अपने प्रोजेक्ट्स में लागू करने की तकनीकें सीखेंगे।
चलिए शुरू करते हैं!
जैसा कि ऊपर बताया, LangSmith बड़े भाषा अनुप्रयोगों के मूल्यांकन के लिए एक व्यापक प्लेटफ़ॉर्म है। यहाँ इसकी कुछ विशेषताएँ और वे जो ठोस वास्तविक-जीवन लाभ लाती हैं:
प्रोग्रामर मिनटों में, घंटों में नहीं, LangSmith के साथ प्रयोग शुरू कर सकते हैं। इसका मतलब है कि कोई छोटी टीम या सोलो डेवलपर वीकेंड में AI एप्लिकेशन का प्रोटोटाइप बना सकता है और संभवतः सोमवार तक पेड सर्विस शुरू कर सकता है।
कड़े मूल्यांकन उपकरणों के साथ, कंपनियाँ खामियों वाले AI रिलीज़ की शर्मिंदगी और लागत से बच सकती हैं (जैसे कि मैंने प्रस्तावना में दिया उदाहरण)। LangSmith आपको LLMs के आउटपुट को बिल्ट-इन मानदंडों जैसे उपयोगिता, सुसंगति, स्त्री-विरोध, या प्राकृतिक भाषा में कस्टम मूल्यांकन जैसे “क्या आउटपुट की सामग्री घिसी-पिटी है?” या फ्लैशकार्ड जनरेशन के मामले में, “क्या कार्ड में कोडिंग से संबंधित प्रश्न है?” के विरुद्ध जाँचने देता है।
LangSmith ट्रेसेज़ का उपयोग करके LLM रन के लगभग हर पहलू को लॉग करता है। इनमें लेटेंसी, टोकन काउंट, रन की लागत, और तरह-तरह के मेटाडेटा जैसे मेट्रिक्स शामिल हैं। वेब UI आपको त्रुटि प्रतिशत, लेटेंसी, तिथि या प्राकृतिक भाषा से टेक्स्ट सामग्री द्वारा भी रन फ़िल्टर करने देता है। यानी यदि, उदाहरण के लिए, कोई AI ट्यूटर वास्तविक छात्रों को जवाब देते समय गड़बड़ाने लगे, तो आप कुछ घंटों में फ़िक्स जारी कर सकते हैं।
LangChain LangSmith का पैरेंट फ़्रेमवर्क है जो विशेष रूप से LLMs के विकास चरण पर केंद्रित है। यह कई LLMs (एजेंट्स) को चेन करने और उन्हें YouTube, Google Search आदि जैसे अन्य APIs से जोड़ने के लिए मॉड्यूलर सॉफ़्टवेयर डिज़ाइन प्रदान करता है। LangSmith शीर्ष पर चेरी की तरह है, जो अपनी शक्तिशाली मूल्यांकन और मॉनिटरिंग टूल्स से सुनिश्चित करता है कि LangChain से बने प्रोटोटाइप अपेक्षा के अनुरूप काम करें।
LangChain के बारे में और जानने के लिए हमारा LLM Applications with LangChain ट्यूटोरियल देखें।
LangSmith की एक और बेहतरीन विशेषता है डेटासेट्स। इन्हें डिप्लॉयमेंट से पहले मानकीकृत उदाहरणों के सेट के विरुद्ध LangChain चेन, एजेंट्स या मॉडलों को बेहतर करने के लिए इस्तेमाल किया जा सकता है। मसलन, हमारे पास एक CSV फ़ाइल हो सकती है जिसमें दो कॉलम—किसी विशिष्ट फ़ॉर्मेट में फ्लैशकार्ड्स के लिए प्रश्न और उत्तर—हों।
इस फ़ाइल को संदर्भ डेटासेट में बदलकर, हम LLMs को पहले बताए गए क्वालिटी एश्योरेंस मेट्रिक्स का उपयोग करके अपने आउटपुट का स्वयं मूल्यांकन करने का निर्देश दे सकते हैं।
अब हम इन सभी विशेषताओं को उदाहरणों के माध्यम से एक-एक करके देखेंगे।
ML ऐप विकास में, आप डेटा इकट्ठा करते हैं, ट्रेन, फ़ाइन-ट्यून, टेस्ट और डिप्लॉय करते हैं—कदम साफ़-परिभाषित हैं। लेकिन LLM ऐप्स में आप अक्सर किसी विक्रेता के तैयार मॉडल से शुरू करते हैं। फ़ाइन-ट्यूनिंग? वह महँगा हो सकता है। इसलिए, आप ठीक-ठीक प्रॉम्प्ट गढ़ने पर अधिक ध्यान देंगे—यानी अपने LLM ऐप से सही सवाल पूछना। इसे ऐसे समझें कि जैसे किसी अच्छे ML मॉडल के लिए बहुत सारा डेटा चाहिए, वैसे ही परीक्षण के लिए आपको ढेरों प्रॉम्प्ट्स चाहिए।
पर प्रॉम्प्ट्स में आप अंकों के बजाय टेक्स्ट के साथ काम करते हैं—इनपुट और आउटपुट दोनों टेक्स्ट होते हैं। इसलिए, MSE या क्रॉस-एंट्रॉपी जैसी सामान्य त्रुटि/सटीकता माप यहाँ काम नहीं करतीं। और सोचिए, हर इनपुट और आउटपुट को पढ़कर मूल्यांकन करना—हज़ारों प्रॉम्प्ट्स हों तो यह दिनों ले सकता है।
इसलिए, आपको ऐसा वर्कफ़्लो चाहिए जो इन प्रॉम्प्ट्स को कुशलता से बनाकर और टेस्ट करके यह बताए कि आपका LLM ऐप कितना अच्छा कर रहा है—बिना थकाऊ मैन्युअल जाँच में डूबे। यह कुछ ऐसा दिख सकता है:
इस चरण में, आप LangChain जैसे फ़्रेमवर्क का उपयोग करके अपने एप्लिकेशन की नींव का प्रोटोटाइप बनाएँगे। फ्लैशकार्ड जनरेटर प्रोजेक्ट में, आपका प्रोटोटाइप विक्रेता के चुने हुए LLM के ऊपर कई कंपोनेंट्स शामिल कर सकता है। उदाहरण के लिए, आपको इसे इनसे चेन करना पड़ सकता है:
आदि (देखें कि आप LangChain के इस पृष्ठ से कौन-कौन से कंपोनेंट्स जोड़ सकते हैं)। लेकिन आप LangChain के रेडीमेड चेन का उपयोग करके विकास समय को काफ़ी घटा सकते हैं।
इस चरण में, आप अपने एप्लिकेशन को जितने अधिक परिदृश्यों पर हो सके, टेस्ट करेंगे। यानी हर जोड़ा गया कंपोनेंट सही काम करे, आपस में अच्छी तरह चेन हो, और सुसंगत व उच्च-गुणवत्ता का आउटपुट दे—इसकी पुष्टि करें।
क्योंकि LLMs गैर-नियतात्मक होते हैं (एक ही इनपुट पर वही आउटपुट नहीं देते) और जोड़े गए कंपोनेंट्स जटिल हो सकते हैं, आप अपना अधिकांश समय इसी चरण में बिताएँगे। और LangSmith का उद्देश्य इसी समय को यथासंभव छोटा करना है। पूरे ट्यूटोरियल में हम इस पर विस्तार से बात करेंगे।
जब आपका एप्लिकेशन व्यावहारिक रूप से उपयोग के लायक हो जाए, तो आप इसे REST API के रूप में डिप्लॉय कर सकते हैं। REST API मूलतः आपकी मौजूदा LangChain चेन या एजेंट्स को ऐसे HTTPS लिंक्स में बदल देती है, जिन पर अन्य लोग अनुरोध भेजकर आपके AI मॉडल से इंटरैक्ट कर सकते हैं। अब, आप अपनी सेवा का यूज़र इंटरफ़ेस बनाएँगे—डेस्कटॉप ऐप या, आमतौर पर, वेबसाइट।
अभी यह करने का कोई बेहद आसान तरीका नहीं है, लेकिन LangChain डेवलपर LangServe जारी करने वाले हैं, जिसे FastAPI में एकीकृत किया जाएगा (यह कितना शानदार होगा!)। दस्तावेज़ के इस पृष्ठ से झलक देखें।
अब, अंततः LangSmith के साथ छेड़छाड़ शुरू करें।
हम वेब UI को समझने से शुरू करेंगे। यह smith.langchain.com लिंक से उपलब्ध है। एक्सेस के लिए, आपको साइन अप कर वेटलिस्ट से क्लियर होना होगा, क्योंकि यह अभी क्लोज़्ड बीटा में है।
पर एक बार अंदर आ गए, तो लैंडिंग पेज कुछ ऐसा दिखेगा:
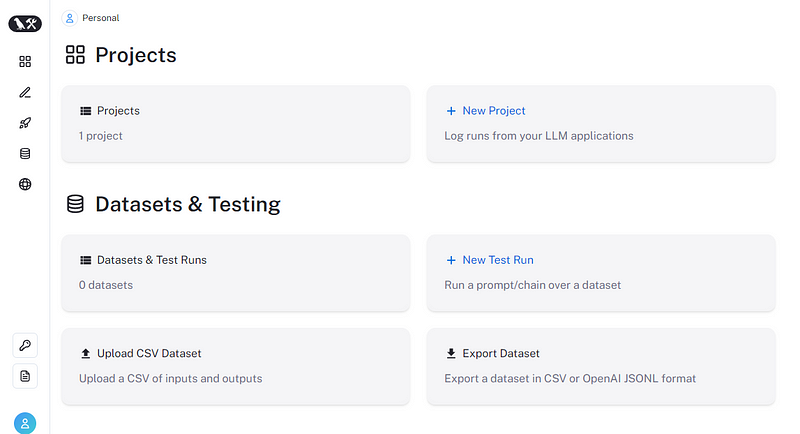
दो मुख्य सेक्शन हैं—प्रोजेक्ट्स और डेटासेट्स एवं टेस्टिंग—और दोनों को Python SDK से नियंत्रित किया जा सकता है। प्लेटफ़ॉर्म में डिप्लॉयमेंट और एनोटेशन क्यूज़ के टैब भी हैं, मगर वे इस लेख के दायरे से बाहर हैं।
LangSmith में प्रोजेक्ट्स मैनेज करना इसके Python SDK के साथ काफ़ी आसान है, जो API कुंजी के माध्यम से प्लेटफ़ॉर्म से जुड़ता है।
कुंजी पाने के लिए, प्लेटफ़ॉर्म में की-आइकन पर क्लिक करें और उसे सुरक्षित रखें। फिर, एक नए डायरेक्टरी में नया वर्चुअल एन्वायरनमेंट इनिशियलाइज़ करके .env फ़ाइल बनाएँ। उसके अंदर ये दो पंक्तियाँ पेस्ट करें:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
फिर, अपने टर्मिनल में, LangSmith और python-dotenv (एन्वायरनमेंट वेरिएबल पढ़ने के लिए) स्थापित करने हेतु ये कमांड चलाएँ:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
अब, कोड लिखने का समय:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
हम find_dotenv और load_dotenv फ़ंक्शंस को इम्पोर्ट करते हैं ताकि एन्वायरनमेंट वेरिएबल पढ़ सकें और उन्हें os के साथ सेट कर सकें:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
LANGCHAIN_TRACING_V2 को True पर सेट करने से ट्रेसिंग (लॉगिंग) सक्षम होती है, जो LLMs को डीबग करने के लिए आवश्यक है। इसके बाद, हम LangSmith प्लेटफ़ॉर्म से बात करने के लिए एक क्लाइंट इनिशियलाइज़ करते हैं:
from langsmith import Client

# Initialize a client
client = Client()
client में LangSmith में प्रोजेक्ट्स और एसेट्स को मैनेज करने के उच्च-स्तरीय कमांड्स होते हैं। क्लाइंट का पहला कमांड जो हम उपयोग करेंगे, वह नया प्रोजेक्ट बनाना है:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
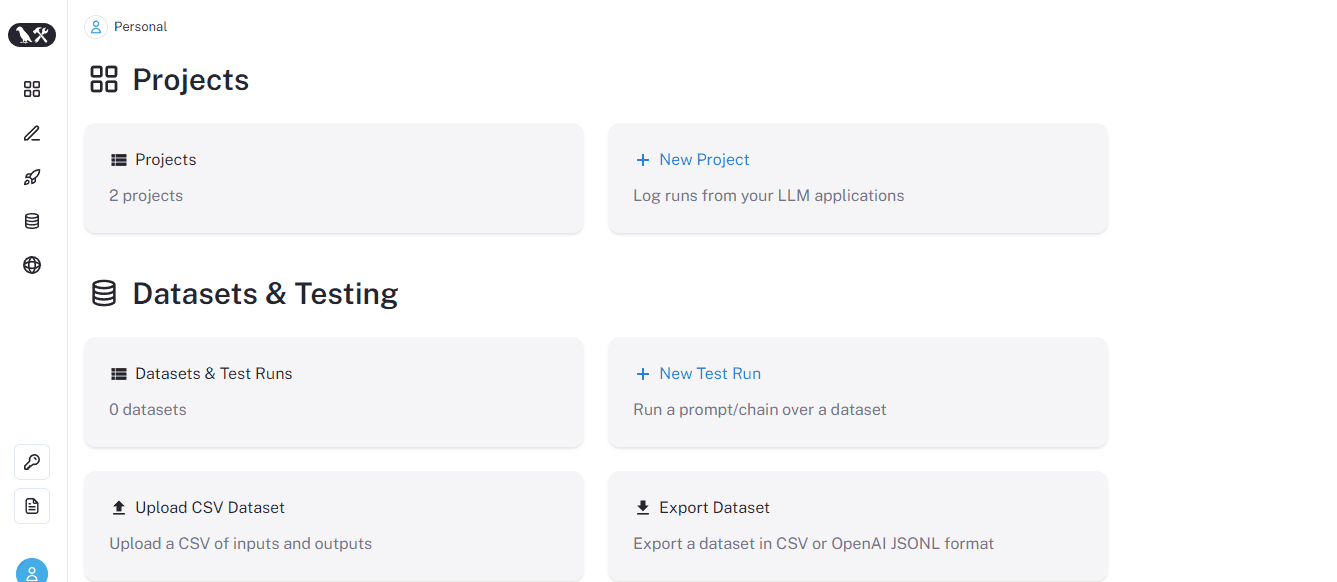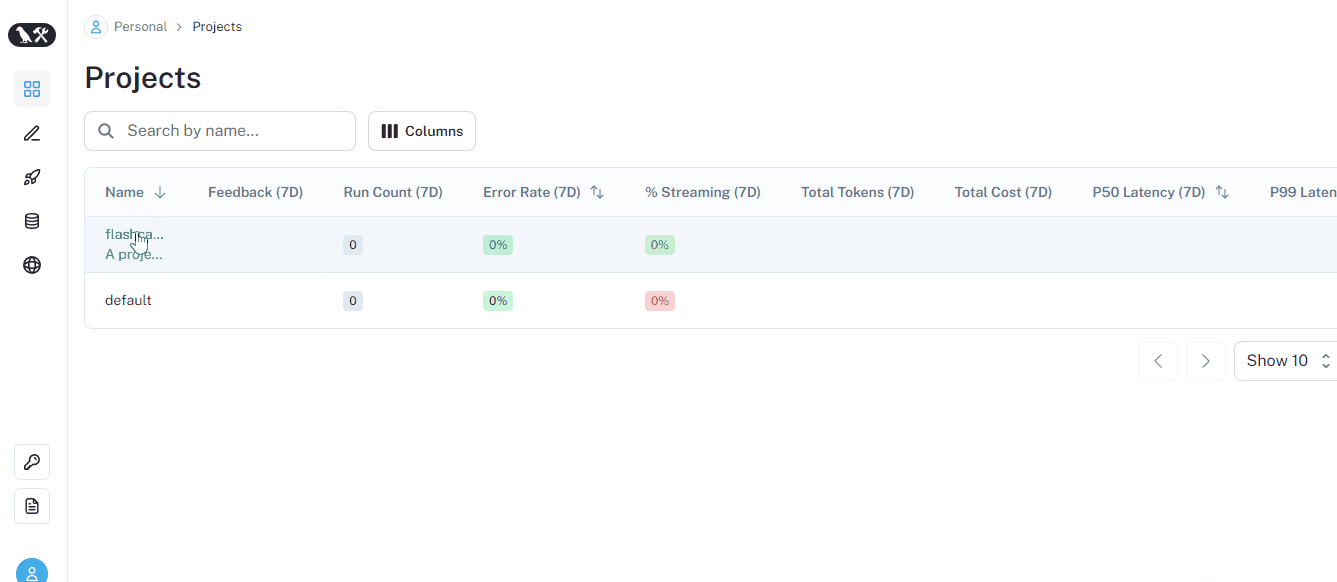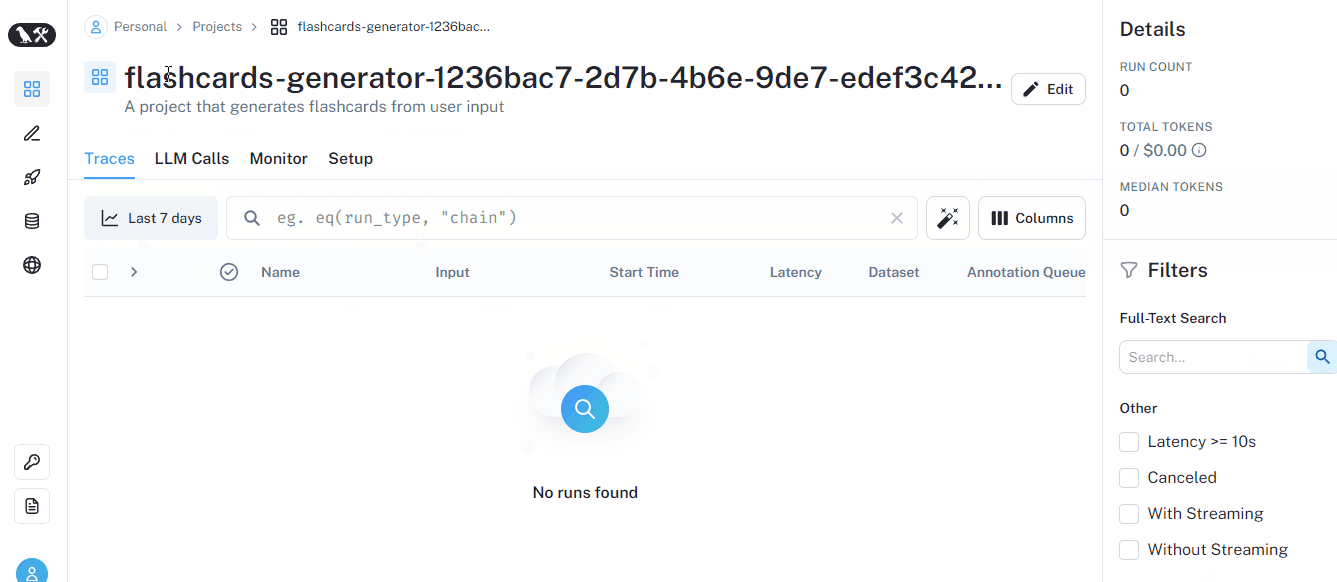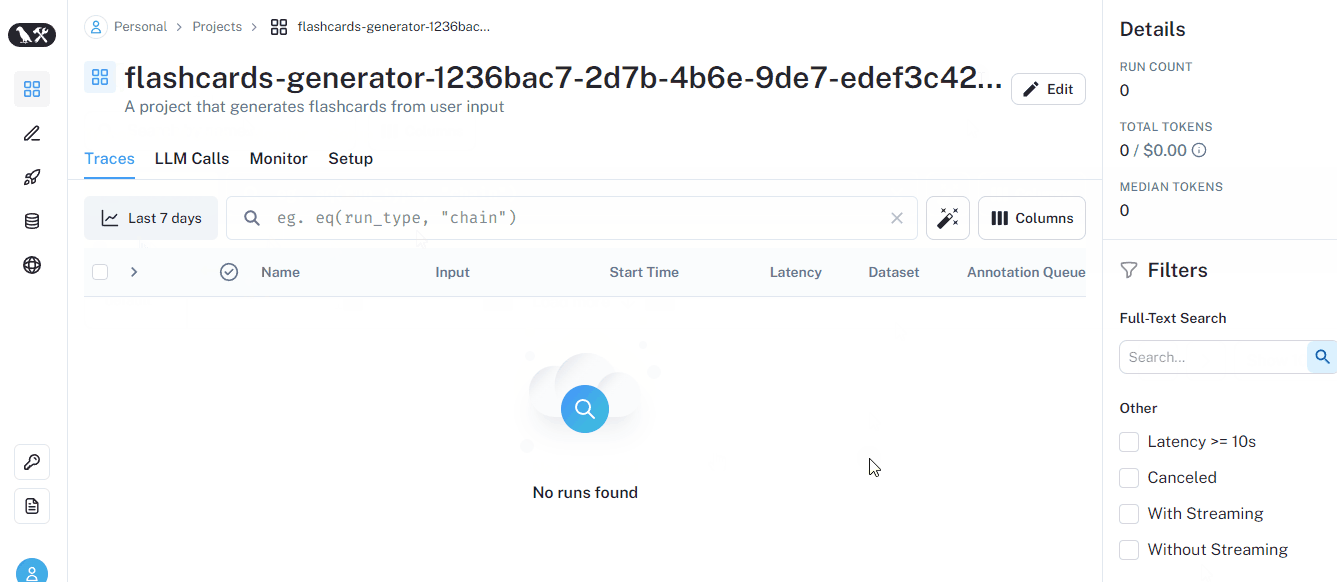
create_project के सफलतापूर्वक चलने के बाद, आप वेब UI के Projects सेक्शन में प्रोजेक्ट को सूचीबद्ध देखेंगे:
अगला कदम है नए प्रोजेक्ट को एक और एन्वायरनमेंट वेरिएबल के साथ डिफ़ॉल्ट के रूप में सेट करना:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
अब, हमें अपने प्रोजेक्ट के लिए एक LLM चाहिए। हम GPT-3.5 turbo लेंगे क्योंकि यह सस्ता है, पर आप langchain के माध्यम से उपलब्ध कई अन्य मॉडलों का उपयोग कर सकते हैं। OpenAI मॉडल्स को ChatOpenAI क्लास से इनिशियलाइज़ किया जाता है।
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
चलो पहला रन करते हैं:
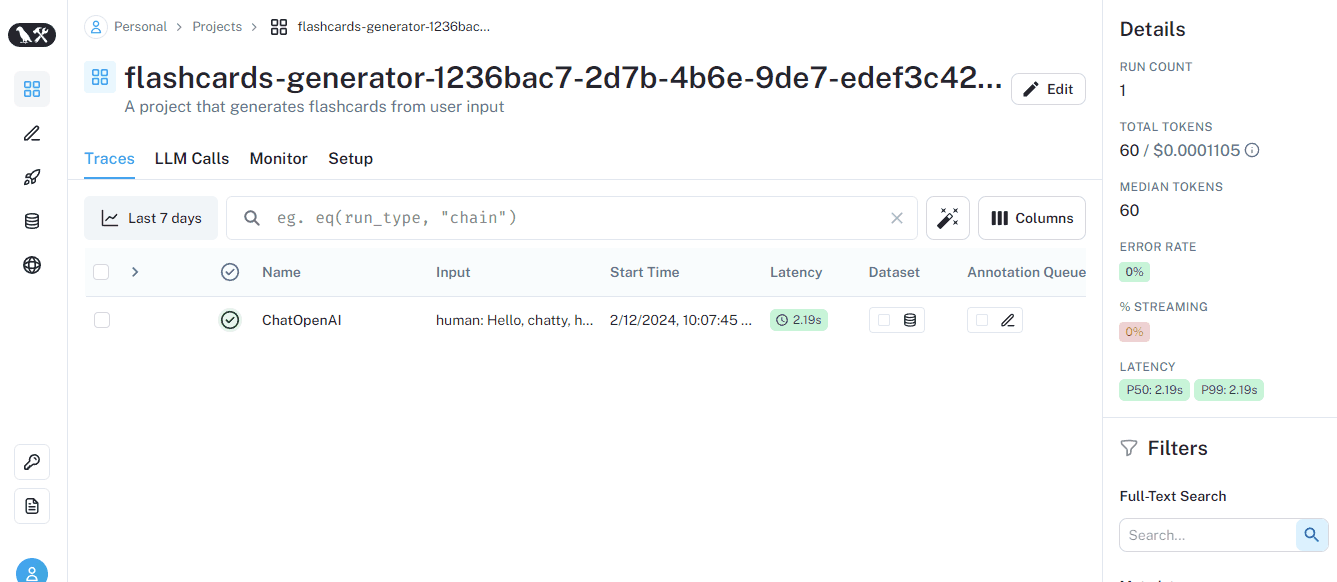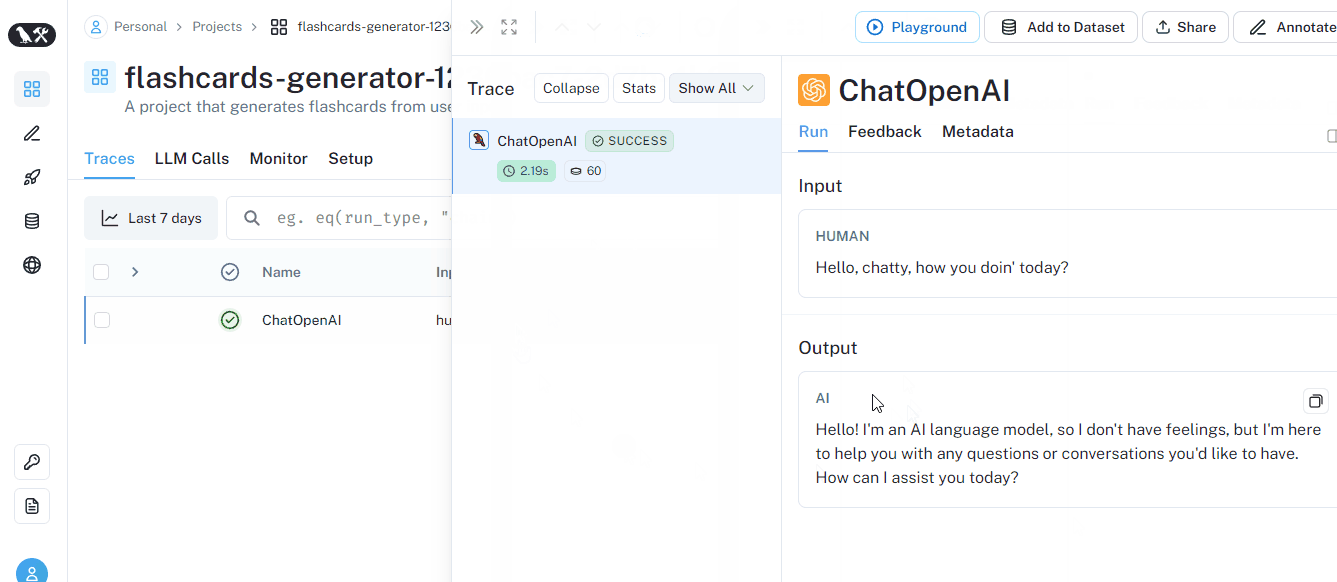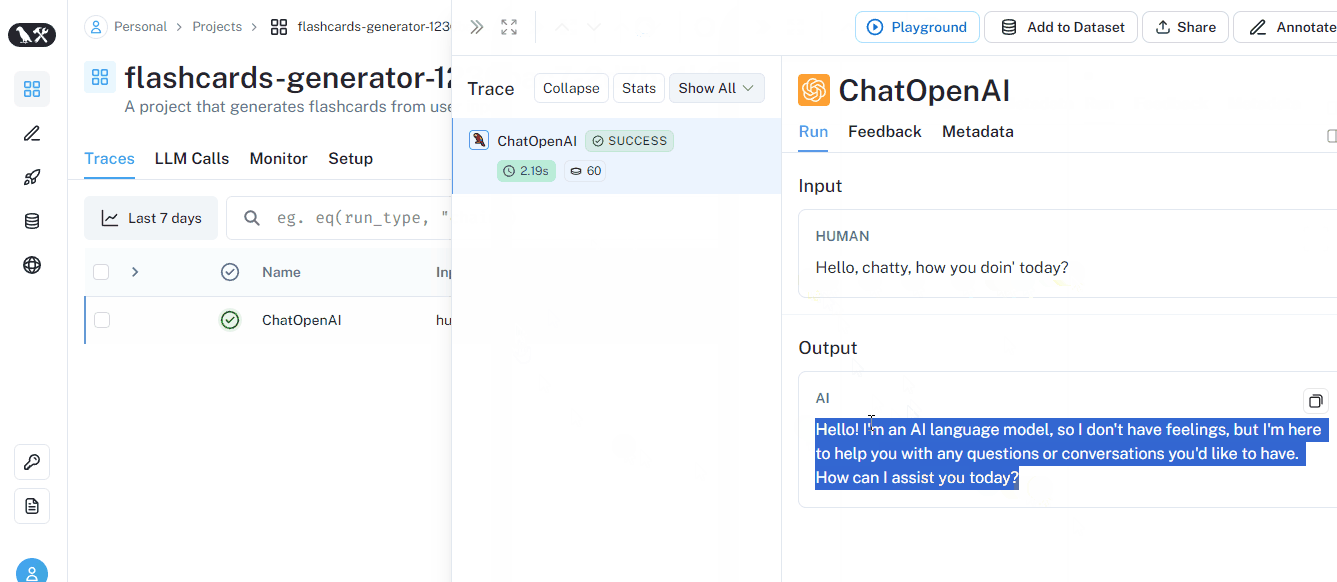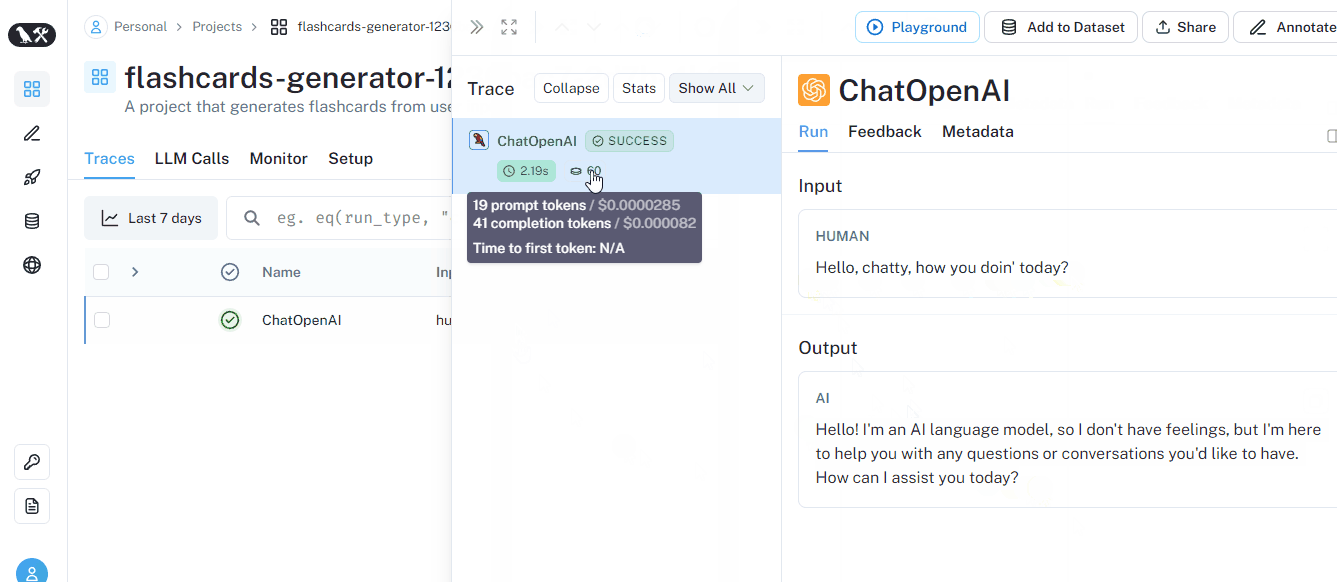
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
यदि आप UI से प्रोजेक्ट को तुरंत जाँचें, तो आप उपरोक्त रन को ट्रेस (लॉग) होते हुए देखेंगे:
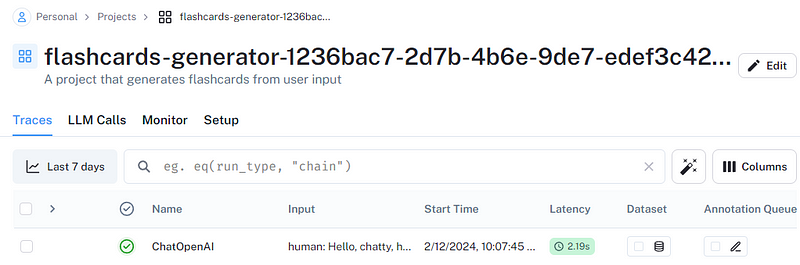
जब हमने एन्वायरनमेंट वेरिएबल्स और क्लाइंट सेट किए, तो हमने स्वतः लॉगिंग सक्षम कर दी। जैसा कि आप देख सकते हैं, हमारे पास पहले से ही रन के बारे में ढेर सारा मेटाडेटा है।
आइए दो-तीन और प्रॉम्प्ट्स चलाएँ:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
हम पहले से ही एक बुनियादी टेक्स्ट समरीज़र बना सकते हैं। पिछली रन का आउटपुट समरी करें:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
बढ़िया, अब अपना पहला डेटासेट बनाने का समय है।
जैसा कि “LLM एप्लिकेशन डेवलपमेंट वर्कफ़्लो” सेक्शन में बताया, आप अपने LLM मॉडल, चेन, या एजेंट का मूल्यांकन करने के लिए संभवतः हज़ारों प्रॉम्प्ट्स बनाएँगे या इकट्ठा करेंगे। इसलिए, ऊपर की तरह एक-एक करके चलाना सर्वश्रेष्ठ तरीका नहीं है।
इसी कारण, LangSmith तीन प्रकार के डेटासेट्स प्रदान करता है:
kv) - डिफ़ॉल्ट: इनपुट्स को मनमाने की-वैल्यू पेयर्स के रूप में परिभाषित करता है। वे तब उपयोगी हैं जब उन चेन और एजेंट्स का मूल्यांकन करना हो जिन्हें अनेक इनपुट चाहिए या अनेक आउटपुट लौटाते हों।llm): इनपुट और आउटपुट LLMs द्वारा “कम्प्लीशन स्टाइल” में परिभाषित—स्ट्रिंग इन, स्ट्रिंग आउट।chat): ये LLM चैट्स से कन्वर्ट किए गए डेटासेट्स हैं और स्ट्रक्चर्ड इनपुट्स व सिरियलाइज़्ड मैसेजेज़ से परिभाषित होते हैं।पहले, बिना आउटपुट वाला की-वैल्यू डेटासेट कैसे बनाते हैं, देखें। हम client के create_dataset फ़ंक्शन का उपयोग करेंगे:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
अब, तीन इनपुट्स जोड़ते हैं जो प्रत्येक LLM से एक-एक फ्लैशकार्ड बनाने के लिए कहते हैं:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
यदि आप UI के डेटासेट टैब पर जाएँ, तो आप प्रत्येक प्रॉम्प्ट को NULL आउटपुट के साथ सूचीबद्ध देखेंगे:
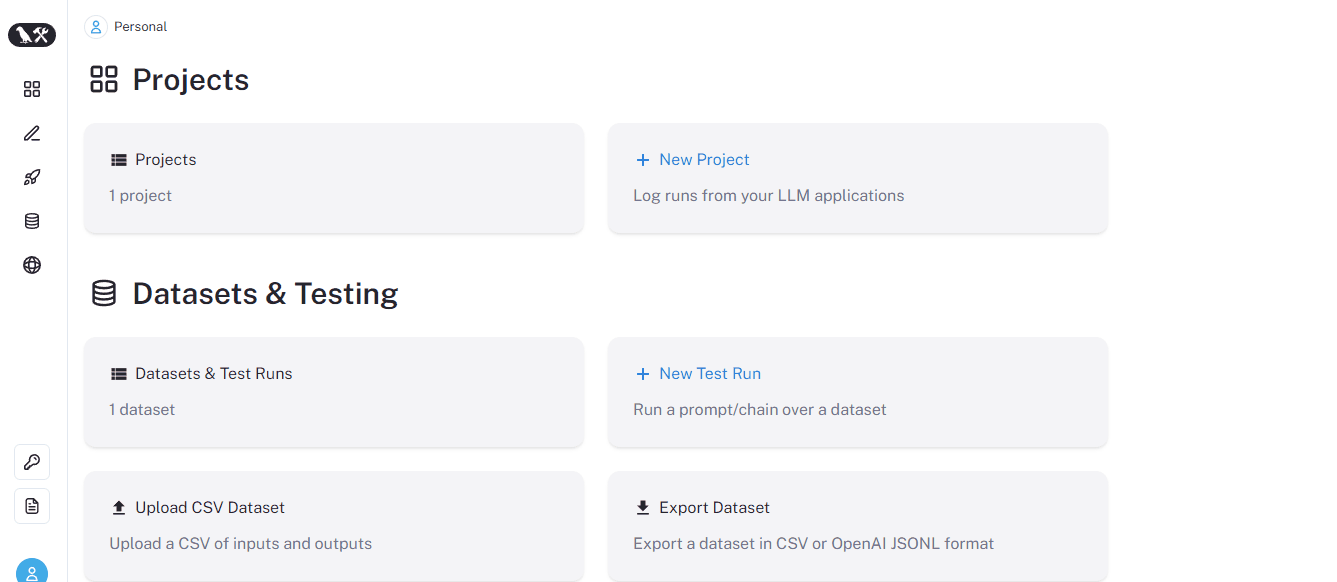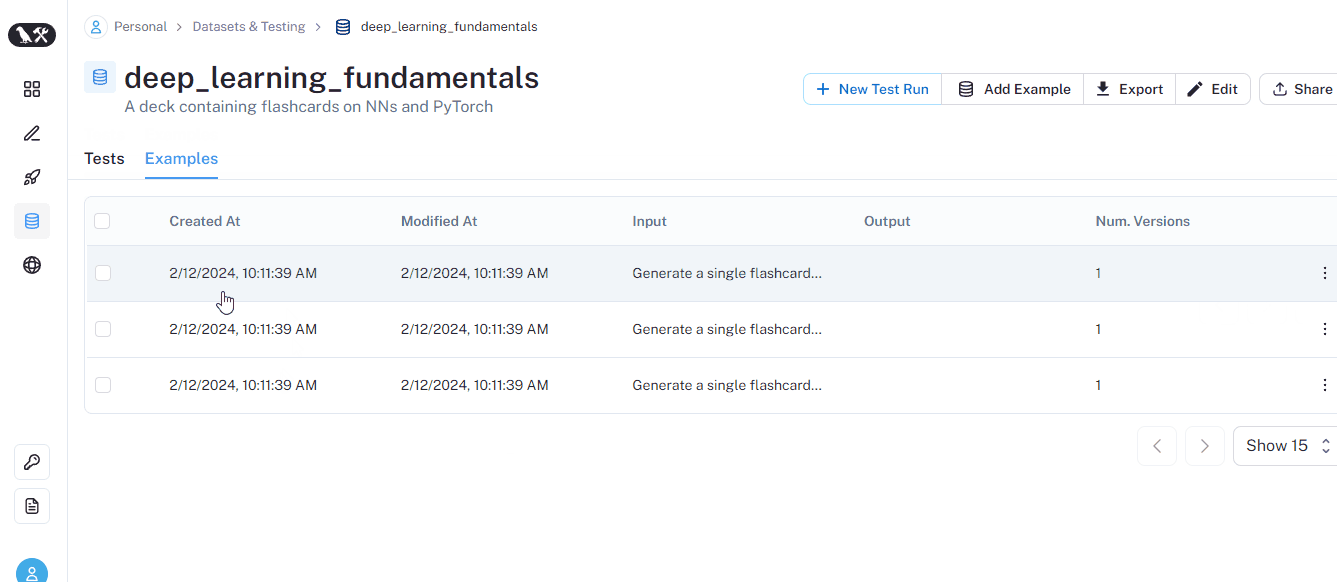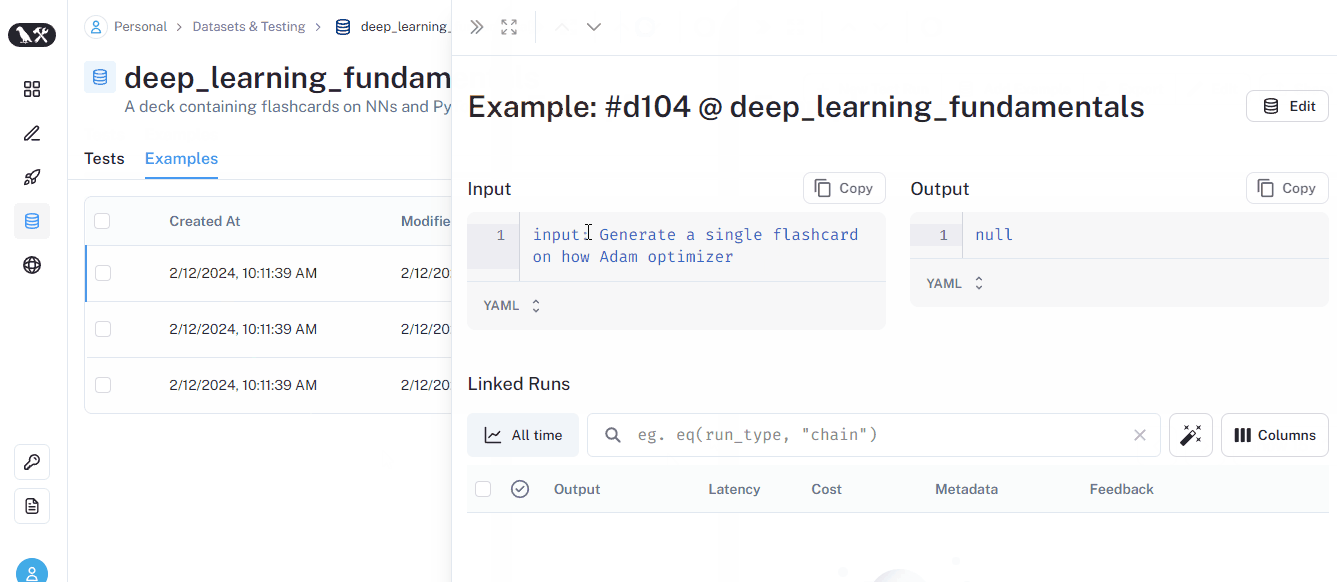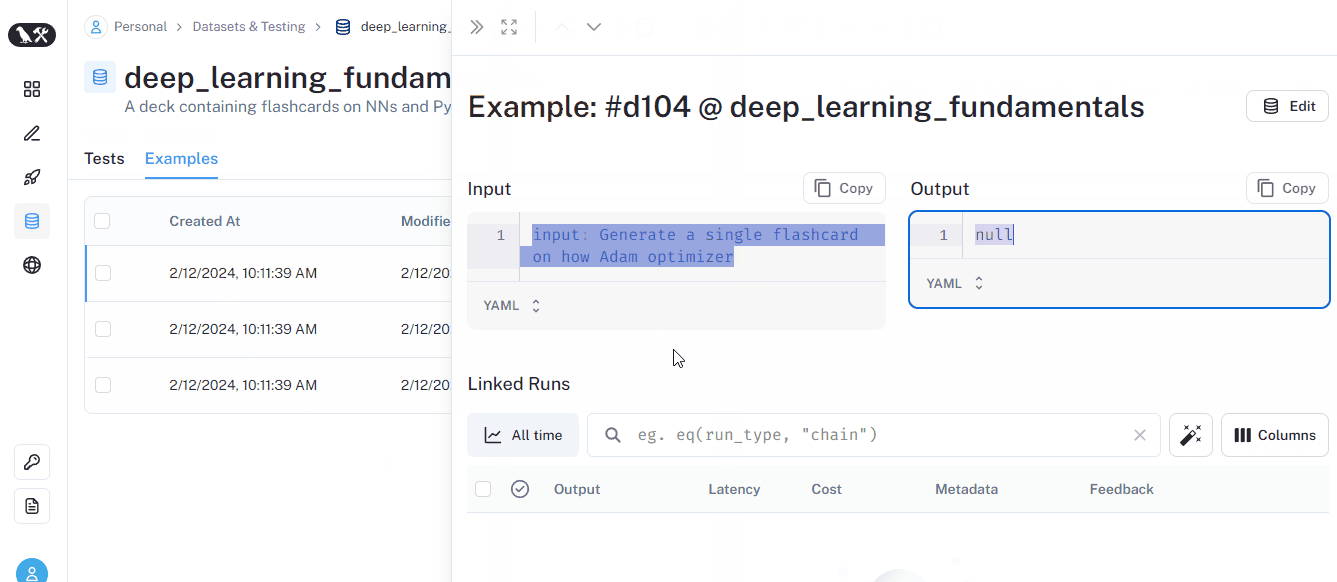
अब, run_on_dataset फ़ंक्शन का उपयोग करके सभी प्रॉम्प्ट्स को एक ही लाइन के कोड में चलाएँ:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
रन पूरा होने पर, यह डेटासेट पेज पर सूचीबद्ध होगा। यह कुछ ऐसा दिखता है:
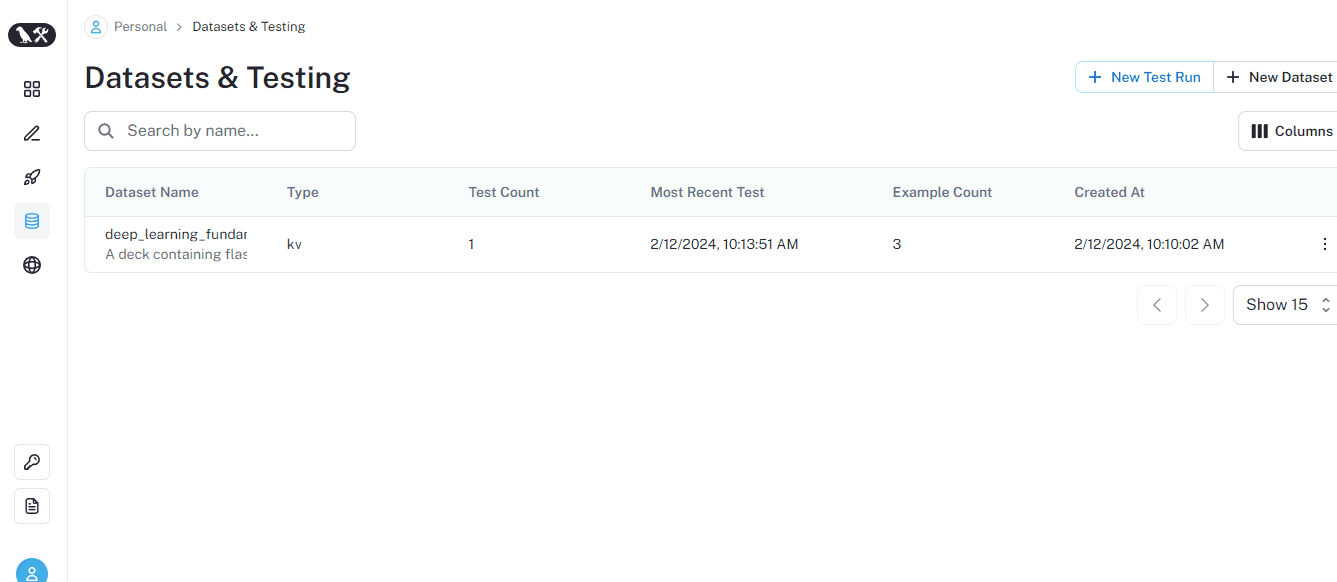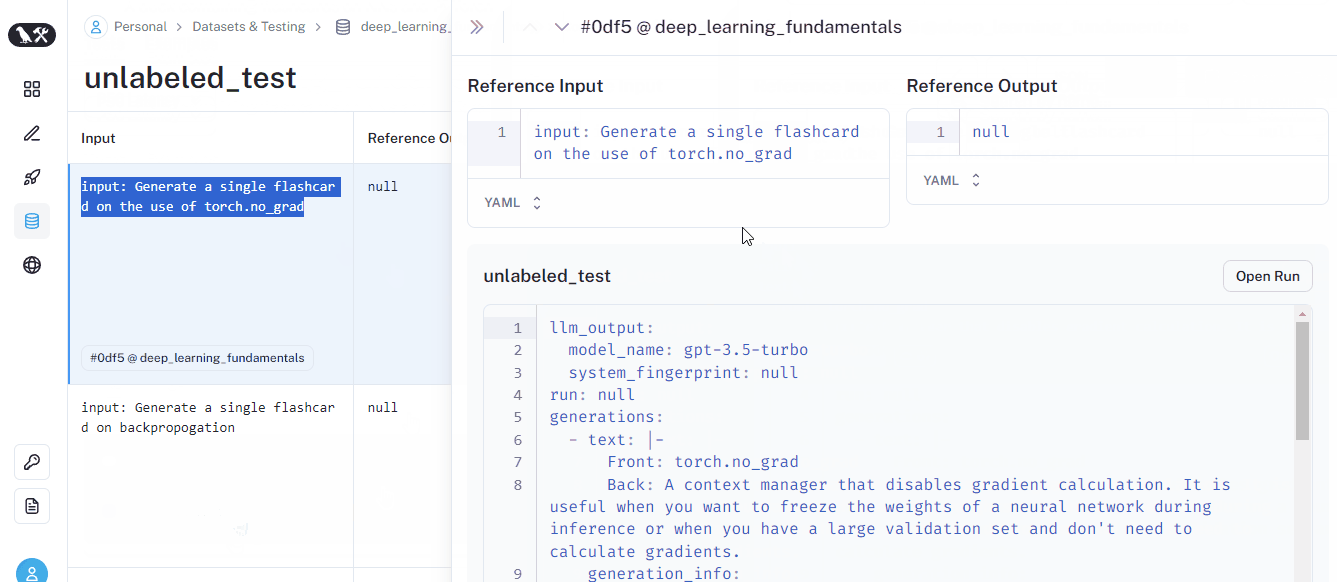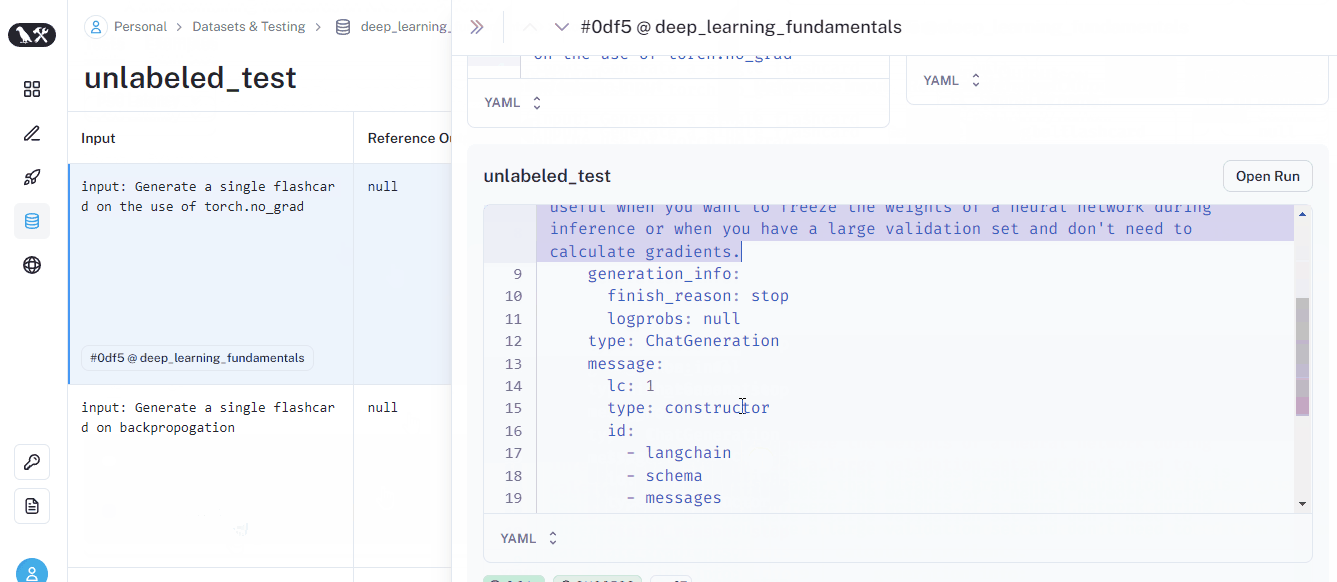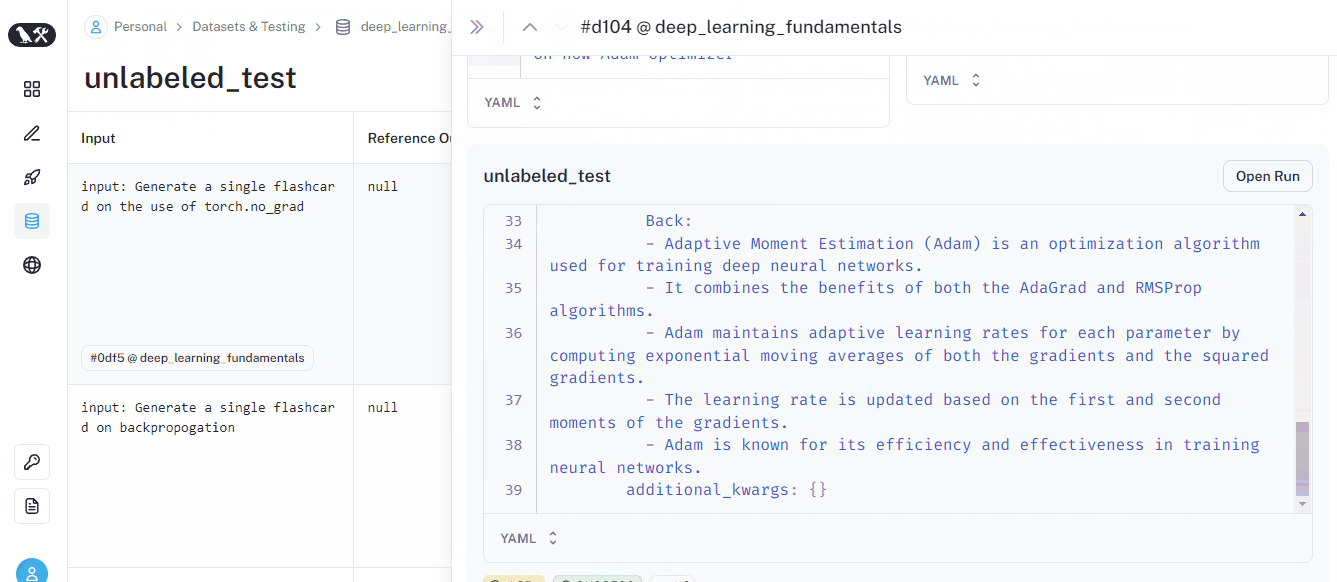
हमने अभी एक बिना लेबल वाले डेटासेट पर टेस्ट रन किया—ऐसा डेटासेट जिसमें उदाहरण प्रॉम्प्ट्स हैं पर उदाहरण आउटपुट नहीं। हमारे टेस्ट ने बस प्रत्येक प्रॉम्प्ट का जवाब पैदा किया, कोई मूल्यांकन नहीं किया। पर हम बुनियादी जाँच करना चाहेंगे, जैसे “क्या आउटपुट उपयोगी है?” या “क्या प्रतिक्रिया छोटी है या लंबी?”
LangSmith हमें बिल्ट-इन इवैल्यूएटर्स से ऐसी जाँच करने देता है।
हमारे डेटासेट के तीन प्रॉम्प्ट्स पर conciseness और coherence मूल्यांकन चलाने के लिए, हम RunEvalConfig क्लास का उपयोग कर सकते हैं:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
ऊपर, हमने evaluators नामक सूची में दो मानदंड परिभाषित किए हैं। इन्हें हम run_on_dataset फ़ंक्शन के evaluation पैरामीटर को पास करते हैं:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset एक सहायक फ़ंक्शन है जो दिए गए LLM का उपयोग कर किसी डेटासेट के सभी प्रॉम्प्ट्स चलाता है और साथ ही किसी भी प्रकार का मूल्यांकन कर देता है। इसके परिणाम हर डेटासेट के समर्पित पेज पर दिखते हैं:
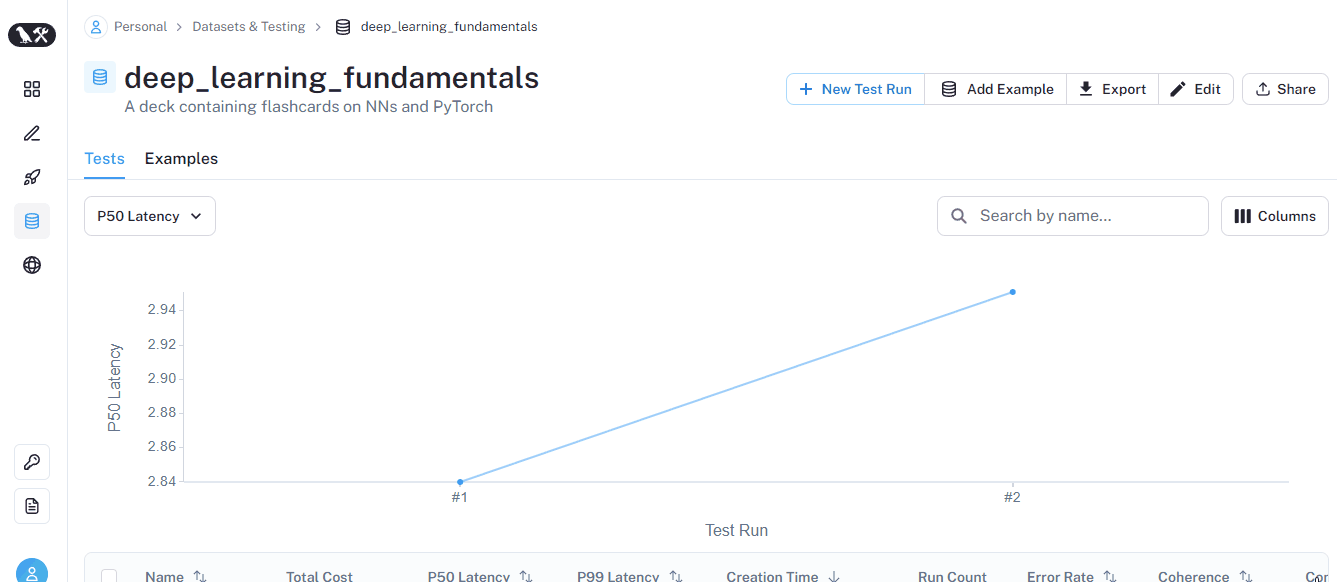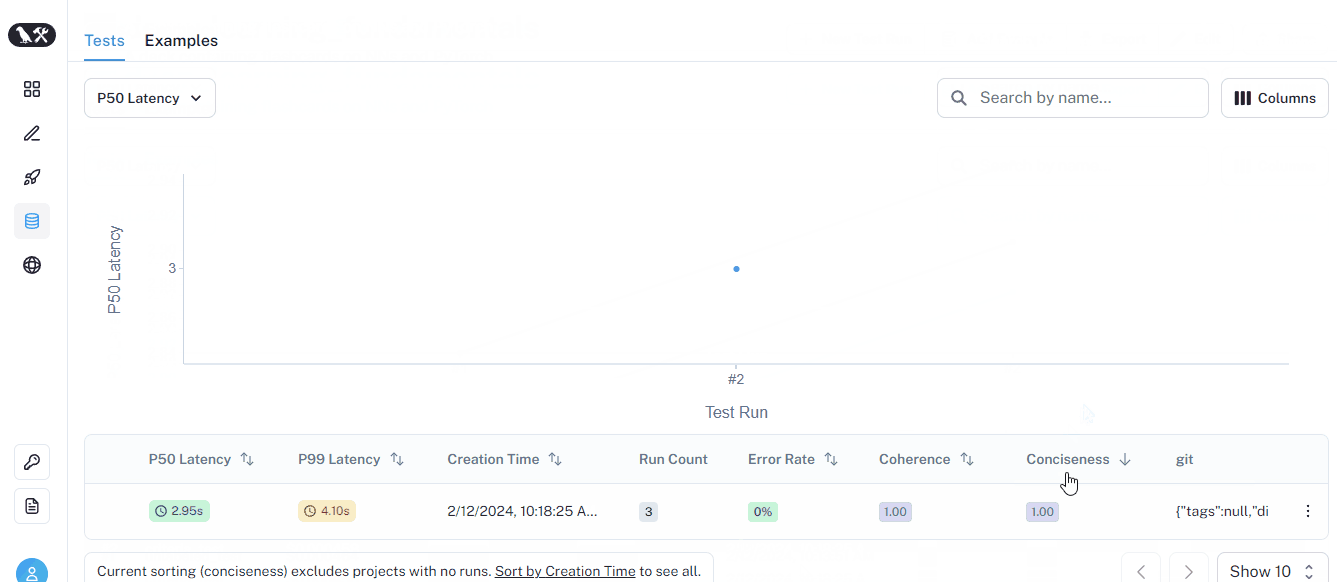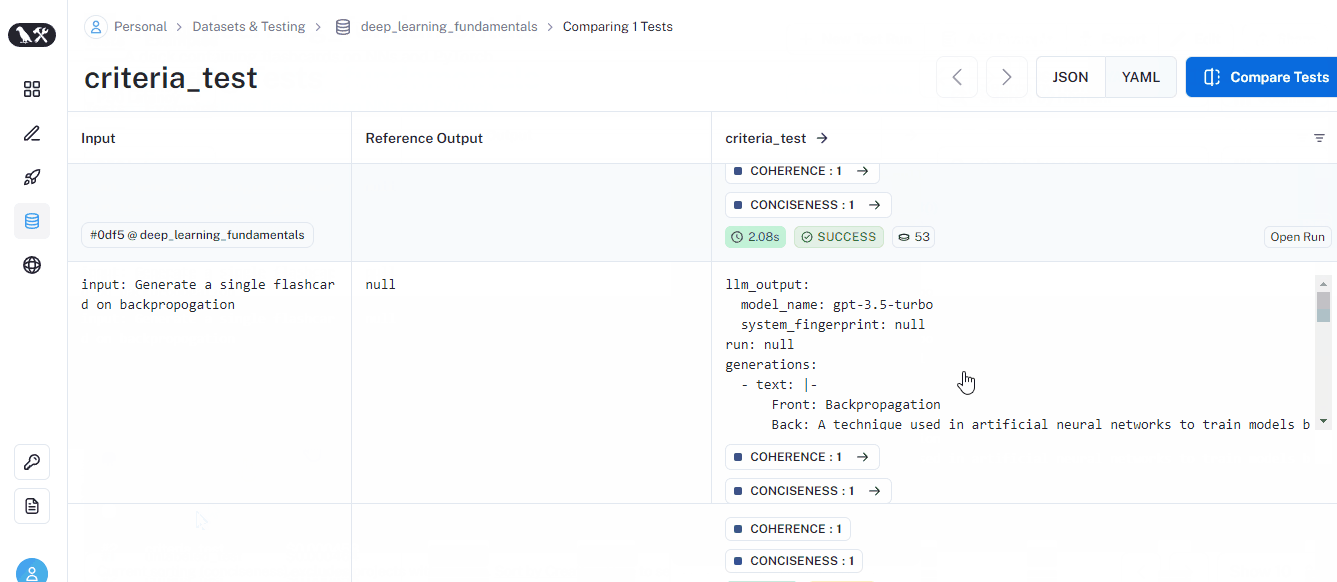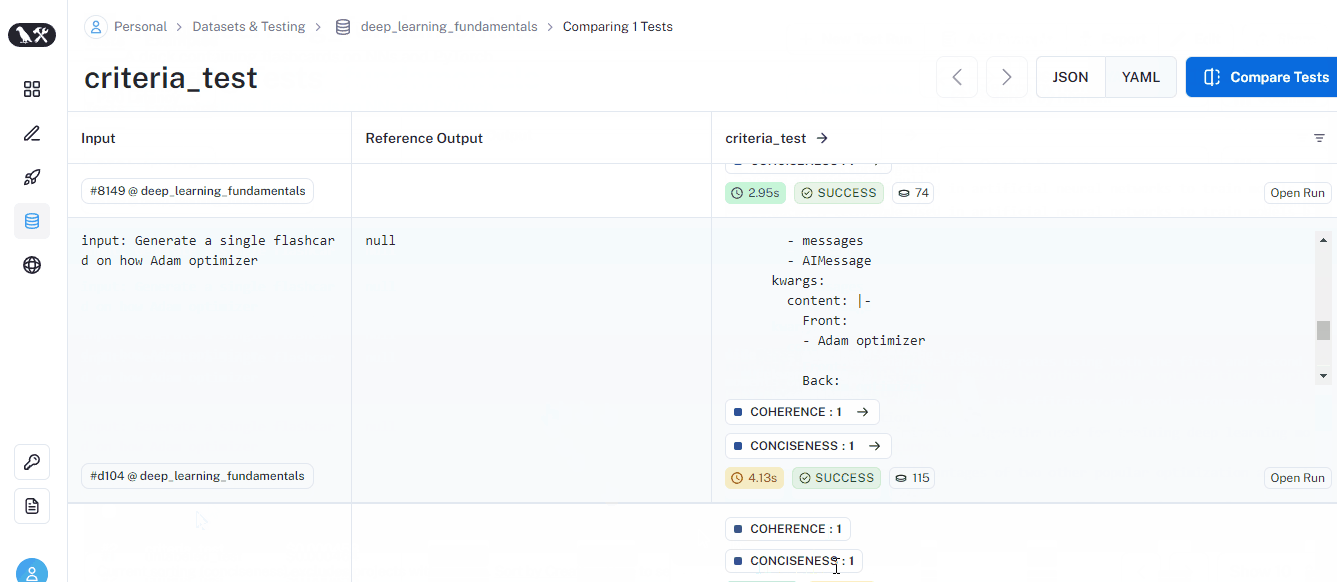
इस बार, हर प्रॉम्प्ट के लिए रन में coherence और conciseness मेट्रिक्स हैं। नीचे, हर मेट्रिक का औसत स्कोर भी दिखेगा।
सभी बिल्ट-इन मानदंडों की सूची देखने के लिए, नीचे का स्निपेट चलाएँ:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
बेशक, सभी LLM उपयोग मामलों को बुनियादी इवैल्यूएटर्स से नहीं जाँचा जा सकता। उदाहरण के लिए, ऐसा कोई इवैल्यूएटर नहीं है जो जाँचे कि किसी फ्लैशकार्ड में कोडिंग सवाल है या नहीं। तो, हमें इसे परिभाषित करना होगा:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
प्राकृतिक भाषा में कस्टम मानदंड पास करने के लिए, हम बस {“criteria_name”: “जाँचने की शर्त”} को Criteria क्लास में पास करते हैं। ऊपर, हम दो अतिरिक्त इवैल्यूएटर्स बना रहे हैं, इसलिए LangSmith हमारे डेटासेट के प्रॉम्प्ट्स से उत्पन्न आउटपुट के ऊपर दो अतिरिक्त प्रॉम्प्ट्स चलाएगा:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
यदि आप रन देखें, तो प्रत्येक प्रॉम्प्ट के तहत हमारे द्वारा परिभाषित कस्टम मानदंड दिखेंगे। उन पर होवर करें, तो आपको बाद में LLM का तर्क भी मिलेगा:
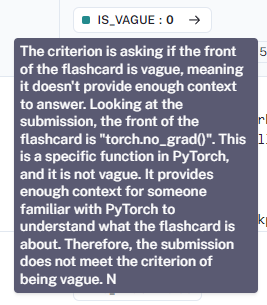
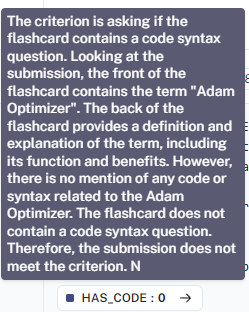
सभी प्रॉम्प्ट्स के मूल्यांकन परिणाम जाँचकर, आप देखेंगे कि हमारे मानदंड अपेक्षित रूप से मूल्यांकन नहीं कर रहे। तो, यह ध्यान रखने की बात है—आपको यह सुनिश्चित करने के लिए अपने मानदंडों की भी प्रॉम्प्ट-इंजीनियरिंग करनी होगी कि वे सही चीज़ें जाँचें।
कभी-कभी, आप अपेक्षित आउटपुट्स वाले प्रॉम्प्ट्स का डेटासेट बनाना चाहेंगे, यानी लेबल्ड डेटासेट्स। आप लेबल्ड डेटासेट्स अनेक फ़ॉर्मेट्स में बना सकते हैं, पर शायद सबसे आम CSV फ़ाइल है। उदाहरण के लिए, यहाँ एक फ़ाइल है जो मैंने ChatGPT से जनरेट कराई है और इसमें PyTorch सिंटैक्स पर पाँच प्रश्न हैं:
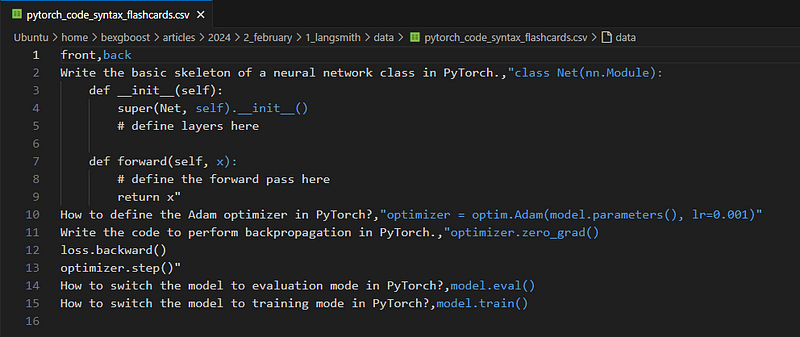
इससे डेटासेट बनाने के लिए, हम upload_csv फ़ंक्शन का उपयोग कर सकते हैं:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
फ़ंक्शन के तीन आवश्यक पैरामीटर हैं: CSV पथ और इनपुट/आउटपुट कॉलम के नाम। अपलोड पूरा होने पर डेटासेट UI में दिखेगा:
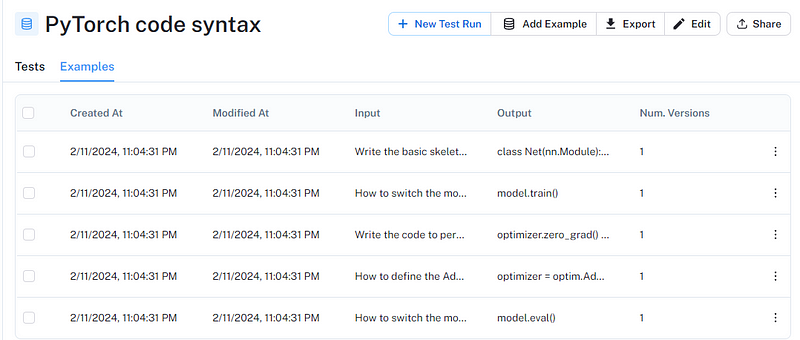
पिछले सेक्शन के अपने कस्टम मानदंड इस डेटासेट पर भी चलाते हैं:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
यदि आप डेटासेट पेज पर जाएँ और रन देखें, तो प्रत्येक कस्टम मानदंड के औसत स्कोर दिखेंगे:
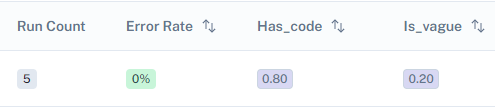
प्राकृतिक भाषा में लिखे गए बिल्ट-इन और कस्टम इवैल्यूएटर्स ज़्यादातर बिना लेबल वाले डेटासेट्स के लिए होते हैं। हमारे CSV जैसे लेबल्ड डेटासेट्स के लिए, LangSmith प्रॉम्प्ट के उत्तर की शुद्धता मापने के लिए अधिक व्यापक इवैल्यूएटर्स प्रदान करता है:
context_qa (प्रसंग-आधारित Q&A): शुद्धता का मूल्यांकन करते समय नमूना आउटपुट को प्रसंग के रूप में उपयोग करता हैqa (Q&A): संदर्भ आउटपुट का उपयोग कर LLM को सीधे प्रतिक्रिया को “सही” या “गलत” ग्रेड करने का निर्देश देता हैcot_qa (चेन-ऑफ़-थॉट Q&A): context_qa के समान, पर यह इवैल्यूएटर निर्णय तक पहुँचने से पहले LLM को चेन-ऑफ़-थॉट तर्क का उपयोग करने को बाध्य करता है।आइए आखिरी वाले को अपने उदाहरणों पर आज़माएँ:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
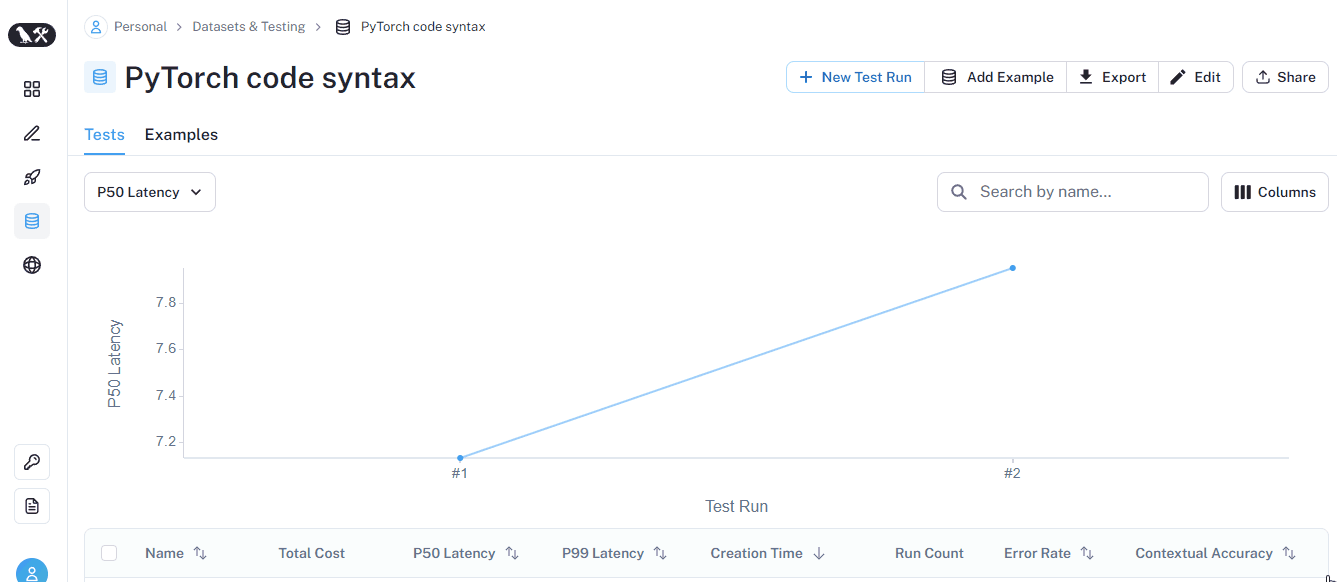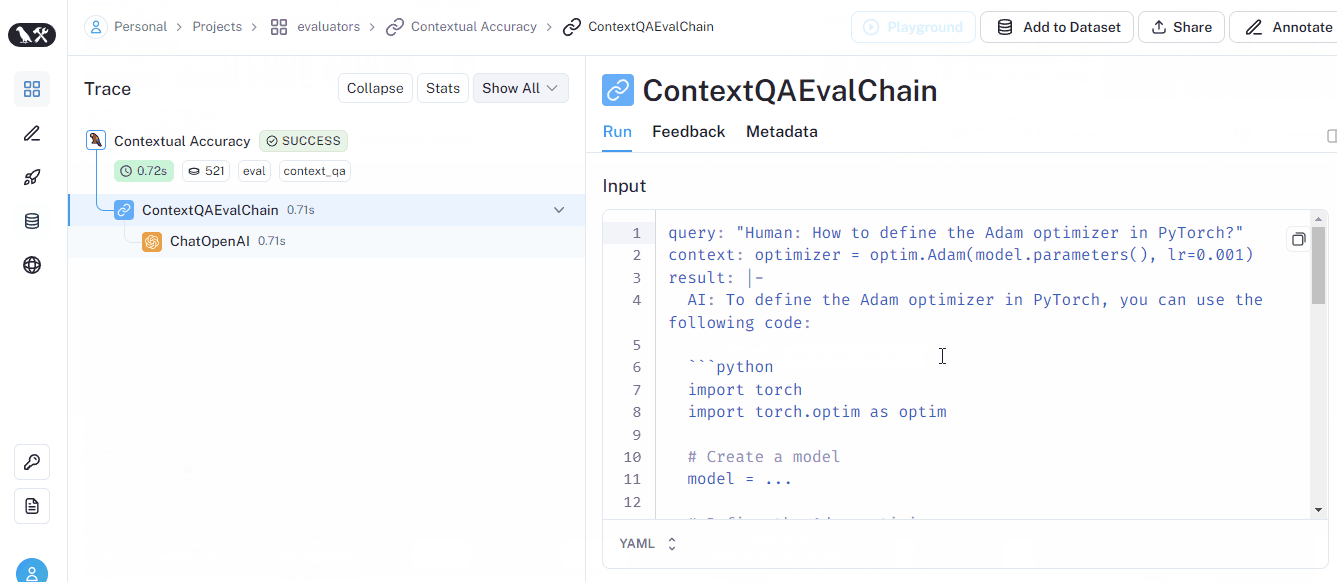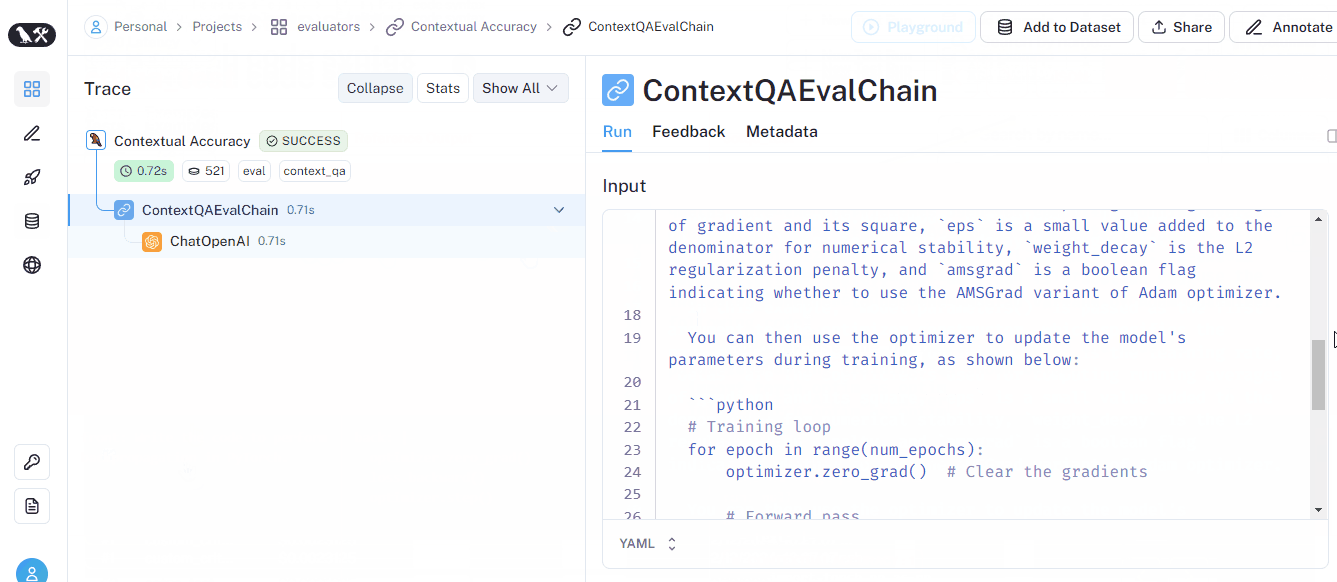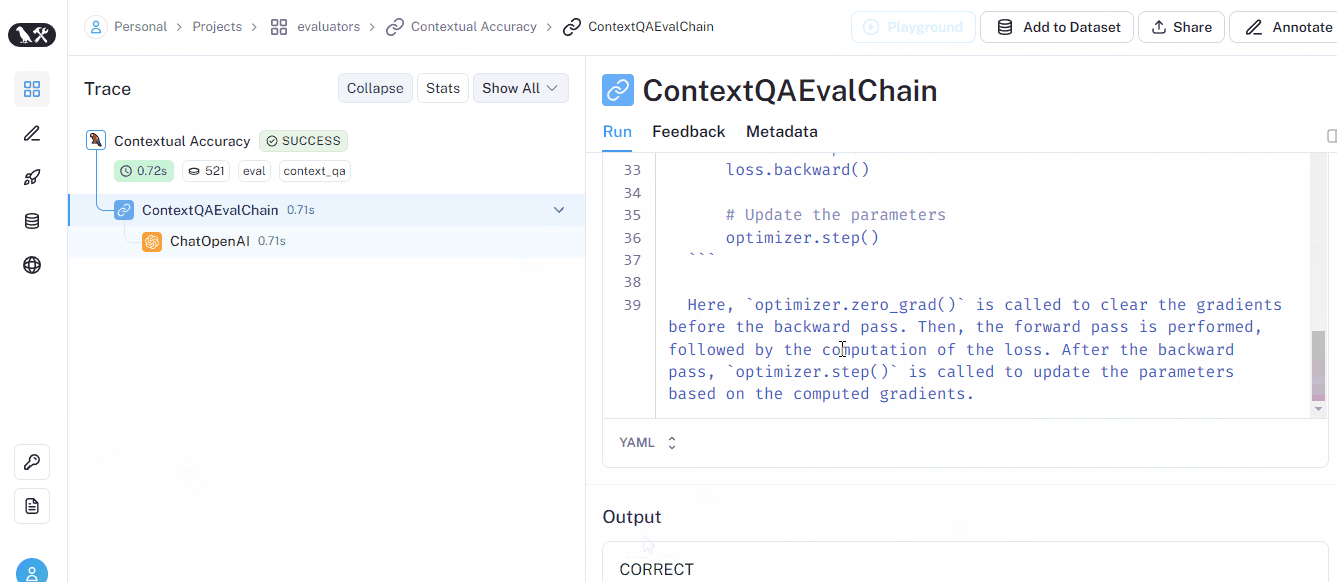
CoTQA मानदंड Contextual accuracy नामक स्कोर लौटाता है, जैसा कि नीचे दिए GIF (और UI) में दिखाया गया है:
इवैल्यूएटर्स के बारे में और जानने के लिए LangSmith डॉक्यूमेंटेशन के LangChain evaluators सेक्शन पर जाएँ।
यदि यह ट्यूटोरियल पढ़कर आपको लगा कि LangSmith मूल रूप से प्रॉम्प्ट इंजीनियरिंग के लिए एक जटिल उपकरण है, तो आप सही हैं! अभी, LangSmith वह सर्वोत्तम फ़्रेमवर्क है जो सुनिश्चित करता है कि LLMs को दी गई निर्देशिका और उनके आउटपुट वास्तव में वही हों जो आप चाहते हैं।
आपने यह भी समझ लिया होगा कि प्रोडक्शन-ग्रेड LLM एप्लिकेशन बनाना कितना प्रयास माँगता है। इसलिए, LLM प्रोजेक्ट्स पर काम करते समय बेहतर अनुभव के लिए LangSmith का उपयोग करें।
यदि LangSmith की कुछ अवधारणाएँ स्पष्ट नहीं हुईं, तो संभव है कि LangChain की कुछ बुनियादी बातें छूट रही हों। यहाँ उस पर कुछ संसाधन हैं:
आज ही अपना LangChain सफर शुरू करें
कोर्स
कोर्स
कोर्स