
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
51.9K
Kısa süre önce herhangi bir tür medyadan otomatik olarak flashcard oluşturan bir yapay zekâ platformu buldum. Aralıklı tekrar tekniğiyle kavram ezberlemeyi sevdiğim için, hemen XGBoost eğitimimi yükledim ve yapay zekâdan bununla ilgili 50 flashcard hazırlamasını istedim.
Ama hayal kırıklığına uğradım. Soruların çoğu fazlasıyla kolaydı ve çok azı kod sözdizimiyle ilgiliydi. Daha da garibi, soruların %10'u birebir aynı ve tamamen bağlam dışıydı — “Fransa'nın başkenti neresidir?”.
Bu tür hatalar, yapay zekâ servislerinin ürettiği çıktılara yönelik uygun değerlendirme ve doğrulama eksikliğine işaret ediyor. Belki de LangSmith'ten haberleri yoktu.
LangSmith, LLM uygulamalarını test etmek, hata ayıklamak ve değerlendirmek için tam teşekküllü bir platformdur. Belki de en önemli özelliği, LLM çıktılarının değerlendirilmesi ve performansın izlenmesidir. Bu eğitimde, çerçeveyi uygulamada görecek ve kendi projelerinize uygulamak için teknikler öğreneceğiz.
Haydi başlayalım!
Yukarıda belirttiğim gibi, LangSmith geniş kapsamlı dil uygulamalarını değerlendirmek için kapsamlı bir platformdur. İşte bazı özellikleri ve bunların sağladığı somut gerçek dünya faydaları:
Programcılar LangSmith'i saatler değil, dakikalar içinde denemeye başlayabilir. Bu da küçük bir ekibin veya tek bir geliştiricinin bir hafta sonu içinde bir yapay zekâ uygulaması prototipini çıkarıp pazartesiye kadar ücretli bir hizmet olarak sunabilmesi demektir.
Sıkı değerlendirme araçları sayesinde şirketler hatalı yapay zekâ sürümlerinin (girişte verdiğim örnekteki gibi) utancından ve maliyetinden kaçınabilir. LangSmith, LLM çıktısını, yardımseverlik, tutarlılık, kadın düşmanlığı gibi yerleşik ölçütlere veya doğal dilde yazılmış özel değerlendirmelere göre kontrol etmenizi sağlar: “Çıktının içeriği klişe mi?” ya da flashcard üretimi özelinde “Kartta bir kodlama sorusu var mı?” gibi.
LangSmith, izleri (trace) kullanarak LLM çalıştırmalarının neredeyse her yönünü kaydeder. Bunlar gecikme, token sayısı, çalışma maliyeti ve her türden metaveri gibi ölçümleri içerir. Web arayüzü, hata yüzdesi, gecikme, tarih hatta doğal dille metin içeriğine göre çalıştırmaları hızla filtrelemenize olanak tanır. Bu, örneğin bir yapay zekâ eğitmeninin gerçek öğrencilerle konuşurken cevaplarında aksaklıklar başlarsa, birkaç saat içinde bir düzeltme yayınlayabileceğiniz anlamına gelir.
LangChain, özellikle LLM'lerin geliştirme aşamasına odaklanan ve LangSmith'in ana çatısını oluşturan bir çerçevedir. Birden fazla LLM'yi (ajanları) zincirlemek ve YouTube, Google Search gibi diğer API'lerle entegre etmek için modüler bir yazılım tasarımı sunar. LangSmith ise üstündeki çilektir; LangChain ile oluşturulan prototiplerin güçlü değerlendirme ve izleme araçlarıyla beklendiği gibi çalışmasını sağlar.
LangChain hakkında daha fazla bilgi edinmek için LangChain ile LLM Uygulamaları eğitimimize göz atın.
LangSmith'in bir diğer harika özelliği veri kümeleridir. Yayına almadan önce LangChain zincirlerini, ajanlarını veya modellerini standartlaştırılmış örneklerden oluşan bir diziye karşı iyileştirmek için kullanılabilirler. Örneğin, belirli bir formatta flashcard'lar için iki sütun içeren — sorular ve yanıtlar — bir CSV dosyamız olabilir.
Bu dosyayı bir referans veri kümesine dönüştürerek, LLM'lere önceki kalite güvencesi metriklerini kullanarak kendi çıktılarını değerlendirmelerini söyleyebiliriz.
Şimdi bu özelliklerin tümünü örnekler üzerinden teker teker göreceğiz.
ML uygulaması geliştirmede veri toplar, eğitir, ince ayar yapar, test eder ve modelleri dağıtırsınız - adımlar nettir. LLM uygulamalarındaysa çoğu zaman bir sağlayıcıdan hazır bir modelle başlarsınız. İnce ayar? Pahalı olabilir. Bu yüzden doğru istemleri oluşturmak üzerinde çok durursunuz — meselenin özü, LLM uygulamanıza doğru soruları sormaktır. Bunu, iyi bir ML modeli için çok veriye ihtiyaç duymak gibi, denemek için çok sayıda isteme ihtiyaç duymak şeklinde düşünün.
Ancak istemlerde, sayılarla değil, giren ve çıkan metinlerle uğraşırsınız. Bu nedenle MSE veya çapraz entropi gibi hatayı ya da doğruluğu ölçmek için kullanılan klasik yöntemler burada işlemez. Ayrıca, değerlendirme için her girdi ve çıktıyı tek tek okumayı düşünün — değerlendirilecek binlerce istem varsa bu günlerinizi alır.
Dolayısıyla, LLM uygulamanızın ne kadar iyi olduğunu verimli biçimde görmek için bu istemleri hızlıca oluşturup test etmeye odaklanan ve sizi manuel kontrollerde boğmayan bir iş akışına ihtiyacınız var. Bu da şöyle görünebilir:
Bu aşamada, LangChain gibi çerçeveleri kullanarak uygulamanızın temelini prototipleyeceksiniz. Bir flashcard oluşturucu proje için, prototipiniz seçtiğiniz bir sağlayıcıdan aldığınız LLM'in üzerine birden fazla bileşen içerebilir. Örneğin, şunlara zincirlemeniz gerekebilir:
ve benzeri (ekleyebileceğiniz bileşen türlerini LangChain dokümanlarının bu sayfasından görebilirsiniz). Ancak, LangChain'in yaygın üst seviye görevler için sunduğu hazır zincirleri kullanarak geliştirme sürenizi ciddi ölçüde kısaltabilirsiniz.
Bu aşamada, uygulamanızı mümkün olduğunca çok senaryoya karşı test edeceksiniz. Bu, eklenen her bileşenin iyi çalıştığından, birbirine düzgünce bağlandığından ve tutarlı, yüksek kaliteli çıktılar ürettiğinden emin olmanız gerektiği anlamına gelir.
LLM'lerin belirlenimci olmaması (aynı girdi için aynı çıktıyı üretmemeleri) ve eklenen bileşenlerin karmaşıklığı göz önüne alındığında, zamanınızın çoğunu bu aşamada harcayacaksınız. LangSmith de tam olarak bu süreyi mümkün olduğunca kısaltmak için geliştirildi. Bunu eğitim boyunca daha fazla konuşacağız.
Yaşayan bir uygulamanız olduğunda, bunu bir REST API olarak dağıtabilirsiniz. REST API temelde mevcut LangChain zincirlerinizi veya ajanlarınızı, başkalarının yapay zekâ modelinizle etkileşime geçmek için istek gönderebileceği HTTPS bağlantılarına dönüştürür. Şimdi hizmetinizin kullanıcı arayüzünü, bir masaüstü uygulaması veya daha yaygın olarak bir web sitesi şeklinde oluşturacaksınız.
Şu anda bunu yapmanın kolay bir yolu yok, ancak LangChain geliştiricileri FastAPI ile entegre olacak LangServe'ü çıkarmak üzereler (ne kadar harika olurdu, değil mi?). Dokümantasyondaki bu sayfadan ön gösterime göz atın.
Artık nihayet LangSmith ile oynamaya başlayalım.
Önce web arayüzünü anlamakla başlayacağız. smith.langchain.com bağlantısı üzerinden erişilebilir. Erişim için kaydolmanız ve bekleme listesinden onay almanız gerekiyor; şu anda kapalı betada.
Ancak içeri girdiğinizde açılış sayfası şöyle görünecek:
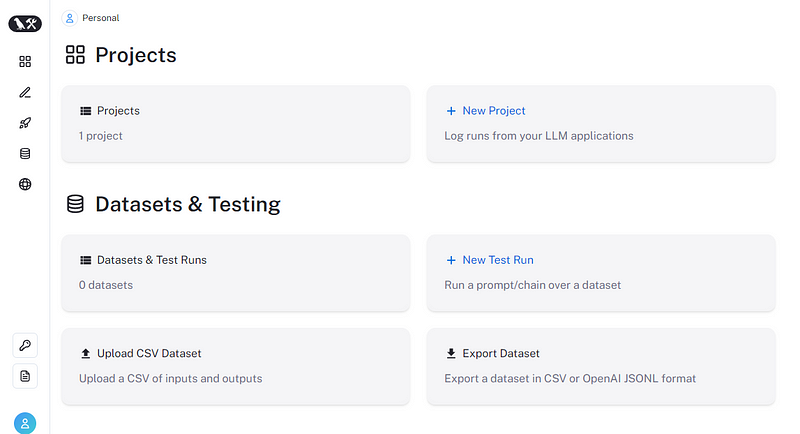
İki ana bölüm projeler ve veri kümeleri & testtir ve her iki bölüm de Python SDK üzerinden yönetilebilir. Platformda dağıtım ve açıklama (annotation) kuyrukları için sekmeler de vardır, ancak bunlar bu makalenin kapsamı dışındadır.
LangSmith'te projeleri yönetmek, platforma bir API anahtarıyla bağlı olan Python SDK'sı sayesinde çok daha kolaydır.
Bir anahtar almak için platformdaki anahtar simgesine tıklayın ve güvenli bir yerde saklayın. Ardından, yeni bir sanal ortamın başlatıldığı yeni bir dizinde bir .env dosyası oluşturun. İçine şu iki satırı yapıştırın:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Sonra, terminalinizde, LangSmith'i ve ortam değişkenlerini okumak için python-dotenv'i kurmak üzere aşağıdaki komutları çalıştırın:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Şimdi, kod yazma zamanı:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
find_dotenv ve load_dotenv fonksiyonlarını ortam değişkenlerini okumak ve os ile kurmak için içe aktarıyoruz:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
LANGCHAIN_TRACING_V2'yi True yapmak izlemeyi (loglamayı) etkinleştirir; bu, LLM'lerde hata ayıklamak için esastır. Sonrasında LangSmith platformuyla konuşmak için bir istemci başlatıyoruz:
from langsmith import Client

# Initialize a client
client = Client()
client, LangSmith'teki projeleri ve varlıkları yönetmek için üst düzey komutlar içerir. Kullanacağımız ilk istemci komutu yeni bir proje oluşturmaktır:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
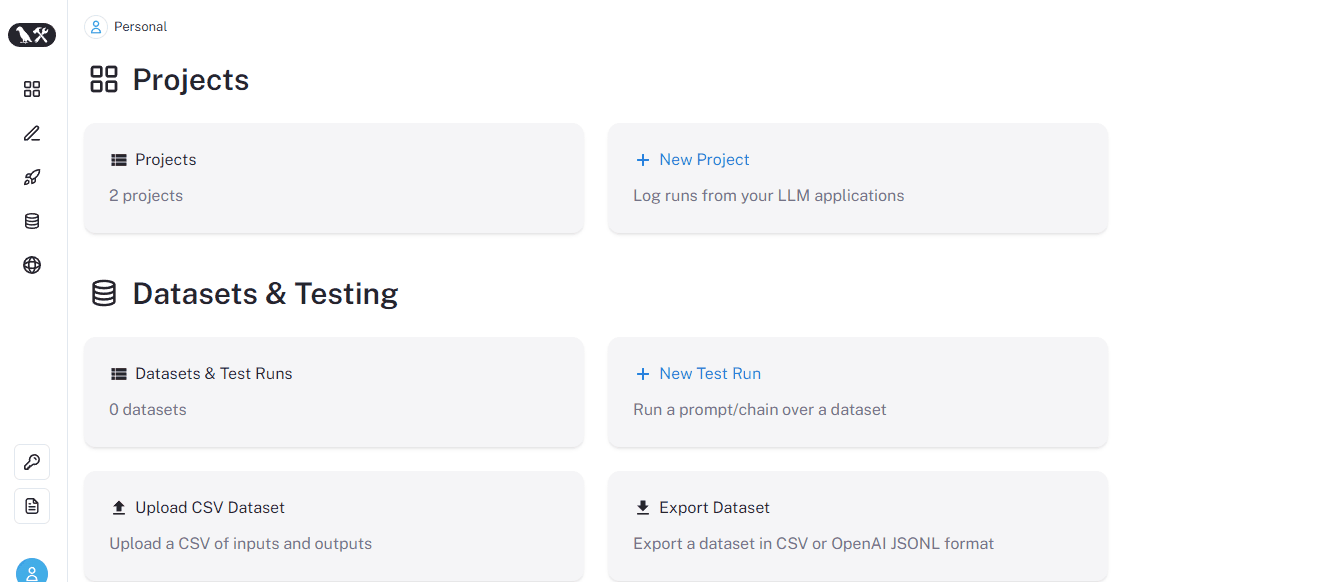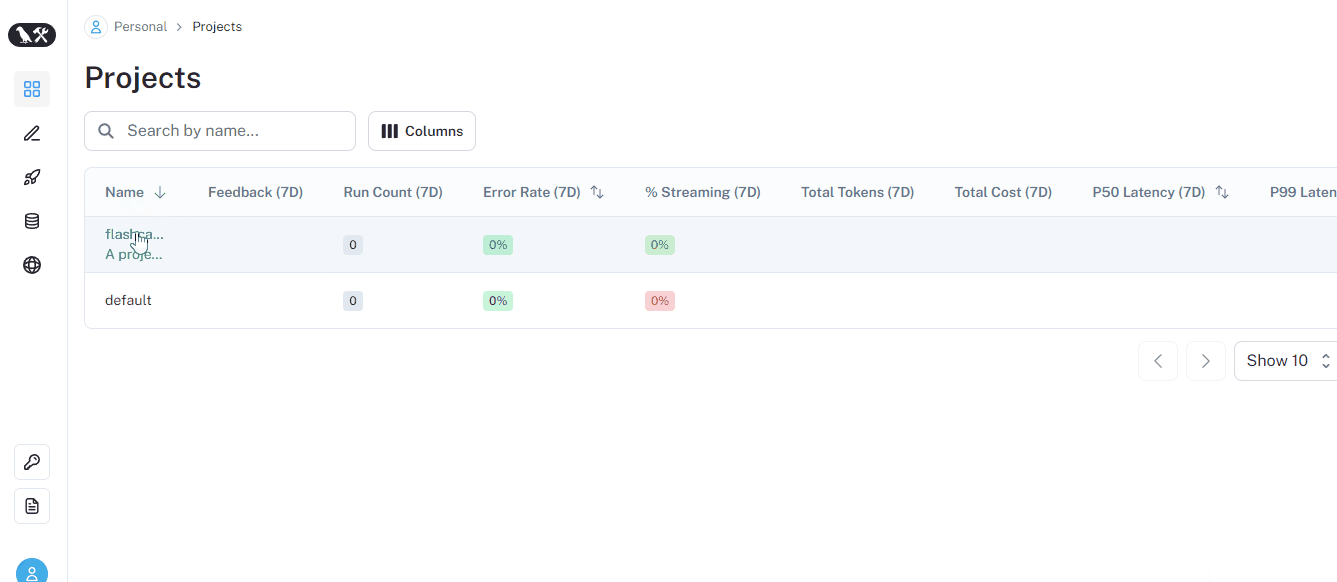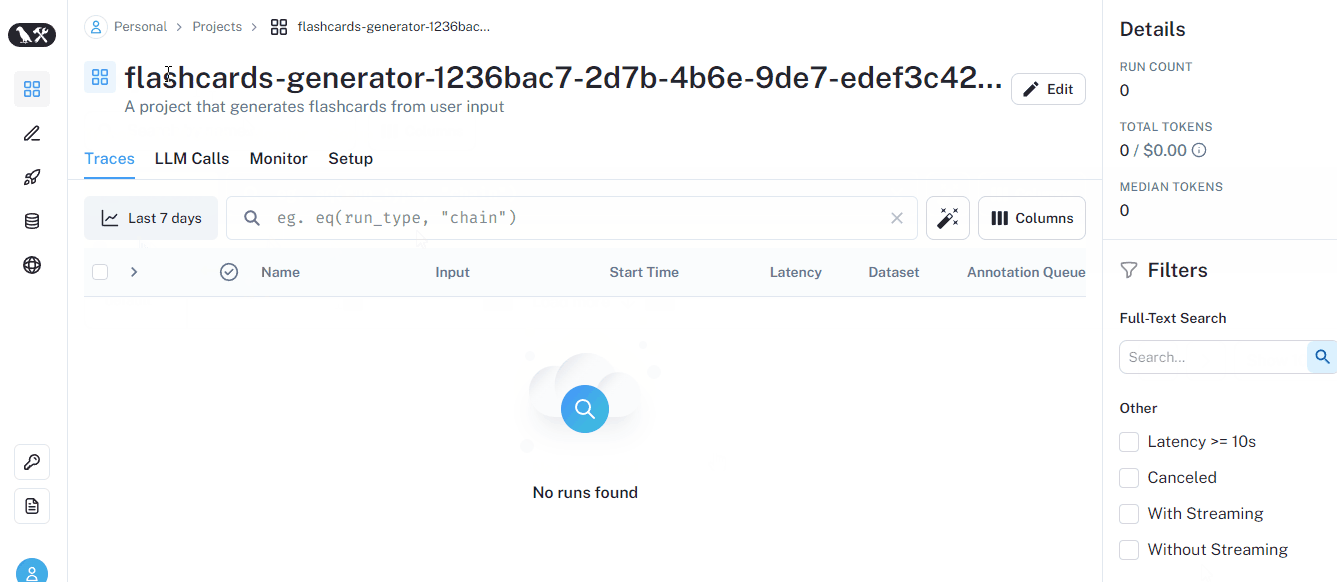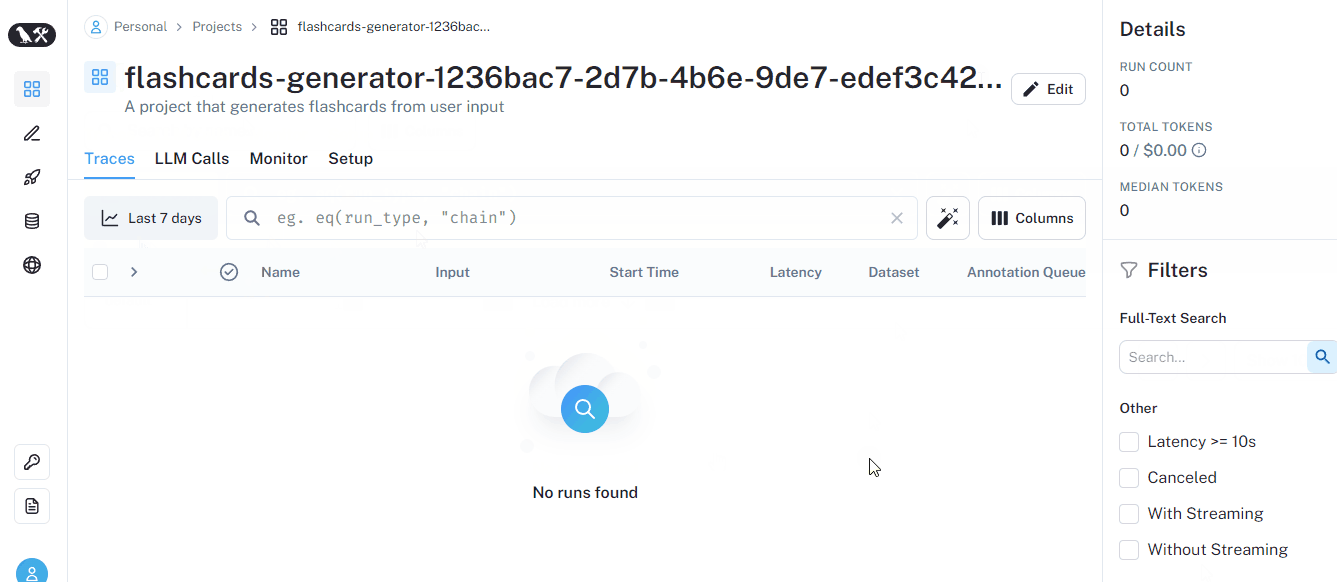
create_project başarıyla çalıştıktan sonra projeyi web arayüzündeki Projeler bölümünde listelenmiş görebilirsiniz:
Sonra, yeni projeyi başka bir ortam değişkeniyle varsayılan olarak ayarlamamız gerekiyor:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Şimdi projemiz için bir LLM'e ihtiyacımız var. Daha ucuz olduğu için GPT-3.5 turbo'yu kullanacağız, ancak langchain üzerinden kullanılabilen birçok başka model de var. OpenAI modelleri ChatOpenAI sınıfıyla başlatılır.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
İlk çalıştırmamızı yapalım:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
Projeyi arayüzden hızlıca kontrol ederseniz, yukarıdaki çalıştırmanın izinin (logunun) alındığını göreceksiniz:
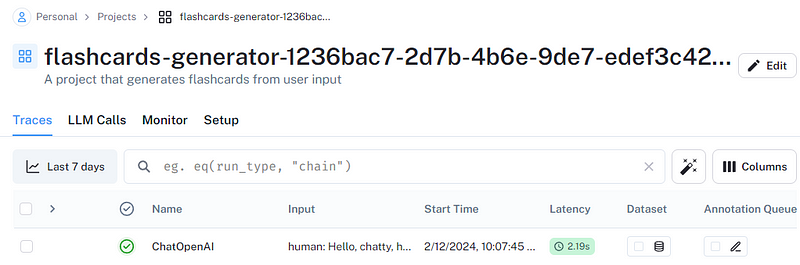
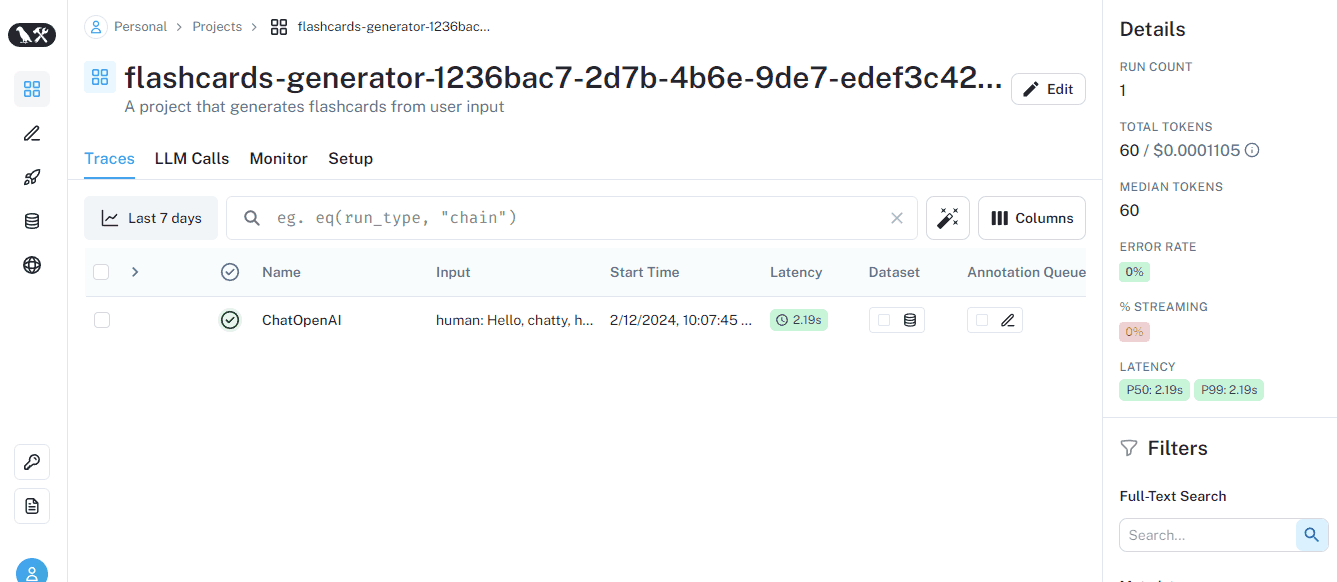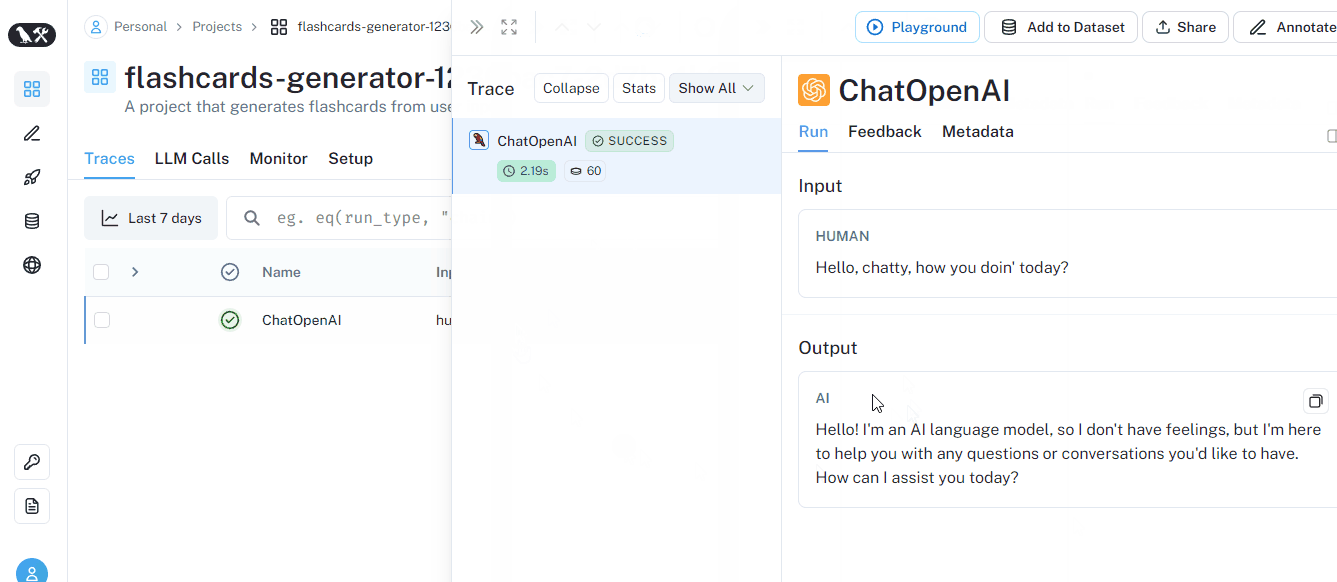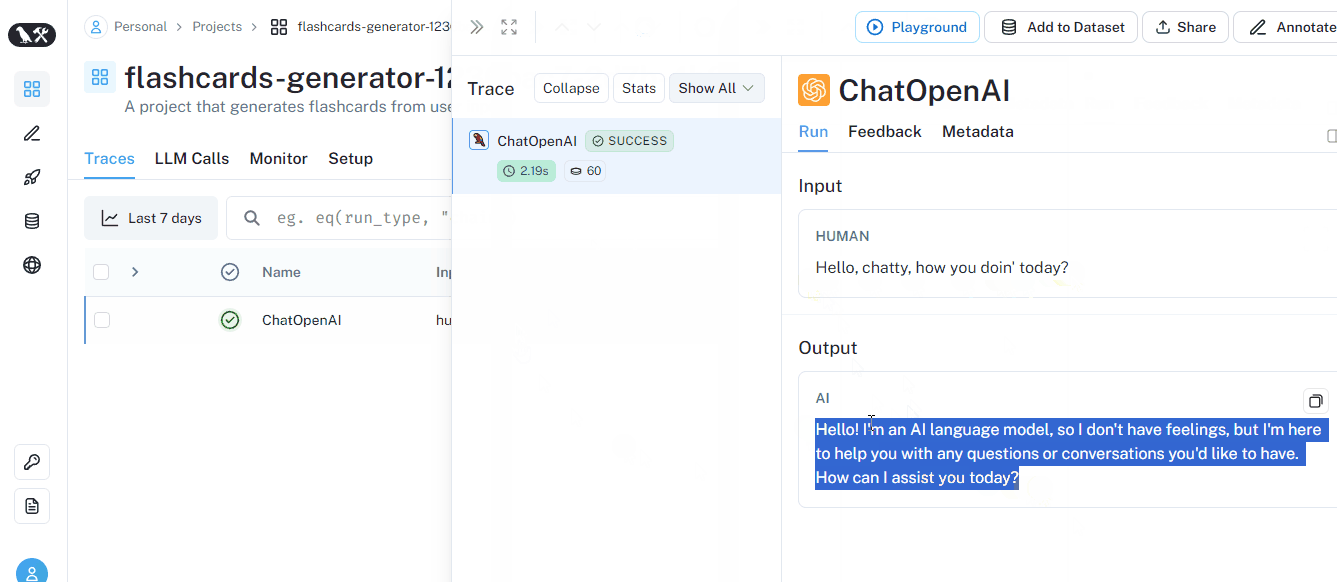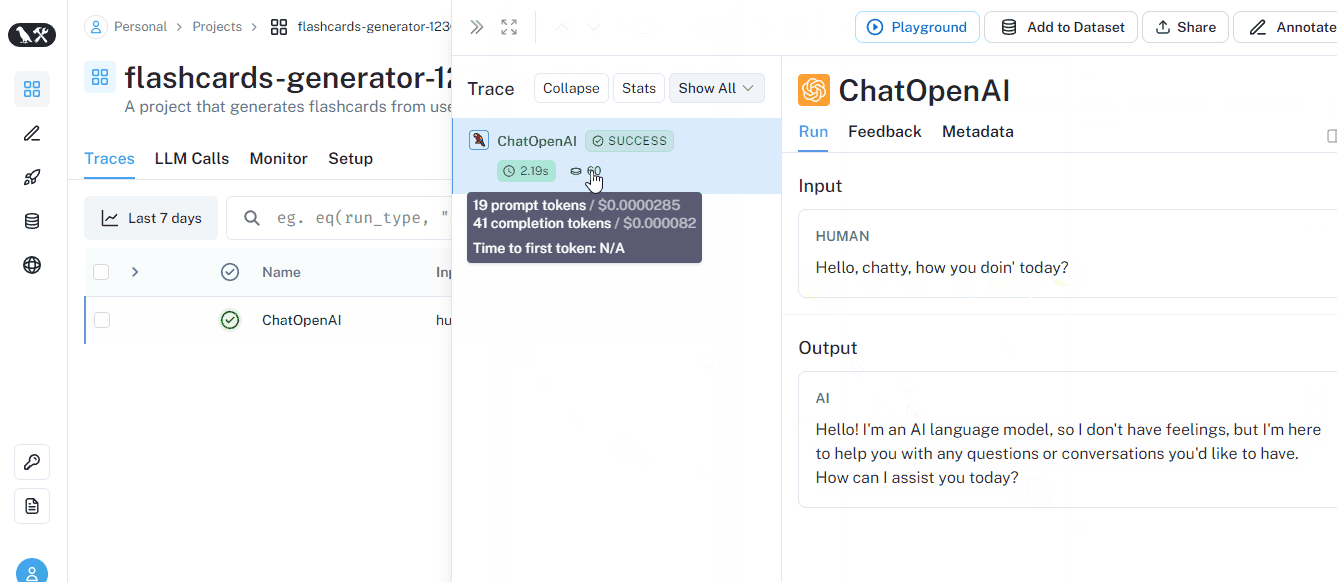
Ortam değişkenlerini ve istemciyi kurduğumuzda, loglamayı otomatik olarak etkinleştirmiş olduk. Gördüğünüz gibi, çalıştırma hakkında şimdiden bir dizi metaveriye sahibiz.
Bir iki istem daha çalıştıralım:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Artık temel bir metin özetleyici bile oluşturabiliriz. Son çalıştırmanın çıktısını özetleyelim:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Harika, şimdi ilk veri kümemizi oluşturmaya geçelim.
“LLM uygulama geliştirme iş akışı” bölümünde belirttiğim gibi, LLM modelinizi, zincirinizi veya ajanınızı değerlendirmek için muhtemelen binlerce istem oluşturmanız ya da toplamanız gerekecek. Bu yüzden, yukarıda yaptığımız gibi bunları tek tek çalıştırmak en iyi uygulama değildir.
Bu nedenle LangSmith üç türde veri kümesi sunar:
kv) - varsayılan: Girdileri key-value çiftleri olarak tanımlar. Birden çok girdi gerektiren veya birden çok çıktı döndüren zincirleri ve ajanları değerlendirirken kullanışlıdır.llm): Girdi ve çıktılar LLM'ler tarafından “tamamlama tarzında” tanımlanır - string girer, string çıkar.chat): Bunlar LLM sohbetlerinden dönüştürülmüş ve yapılandırılmış girdiler ile serileştirilmiş mesajlar kullanılarak tanımlanmış veri kümeleridir.Önce, çıktısı olmayan bir anahtar-değer veri kümesinin nasıl oluşturulacağını görelim. client'ın create_dataset fonksiyonunu kullanacağız:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Şimdi, her biri LLM'den tek bir flashcard oluşturmasını isteyen üç girdi ekleyelim:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
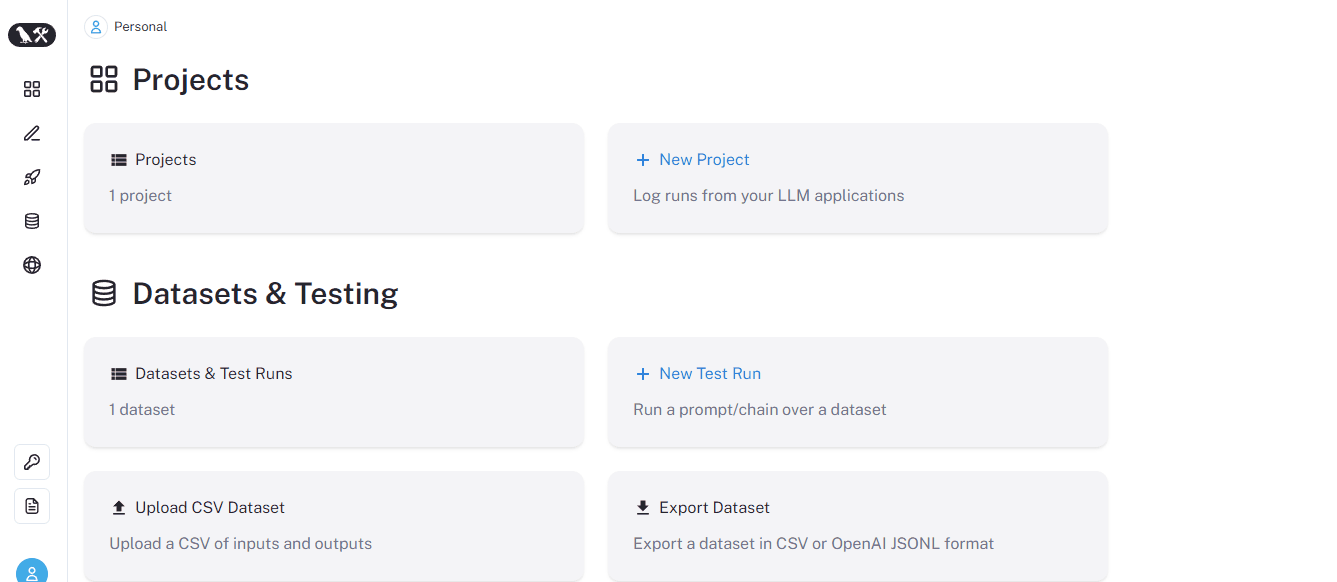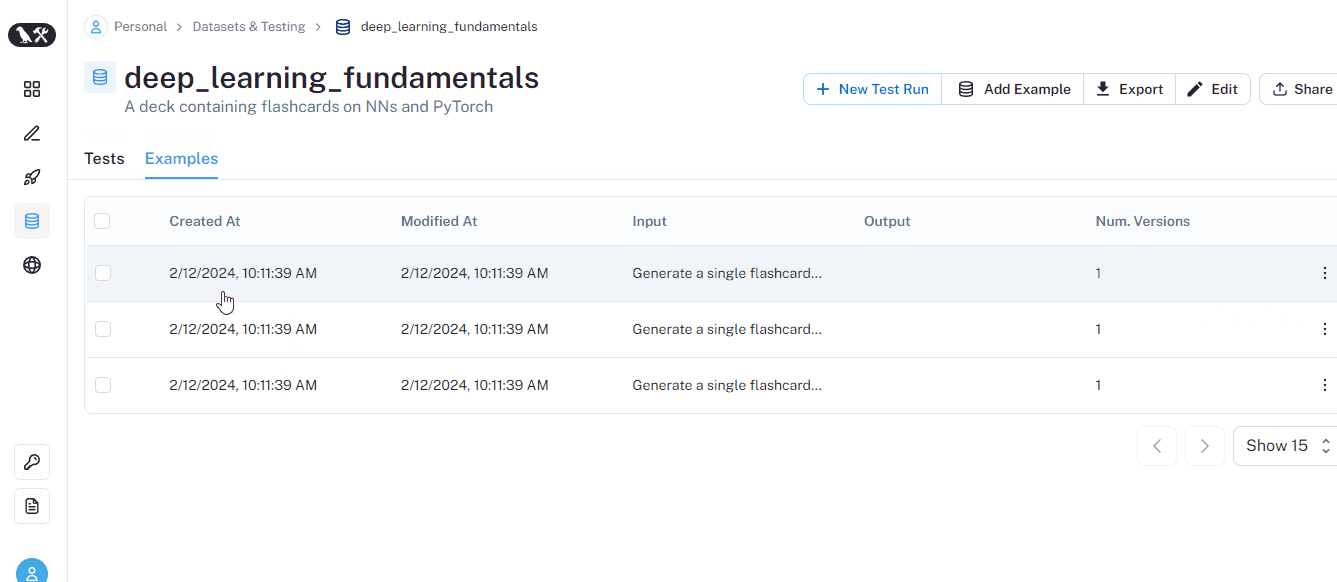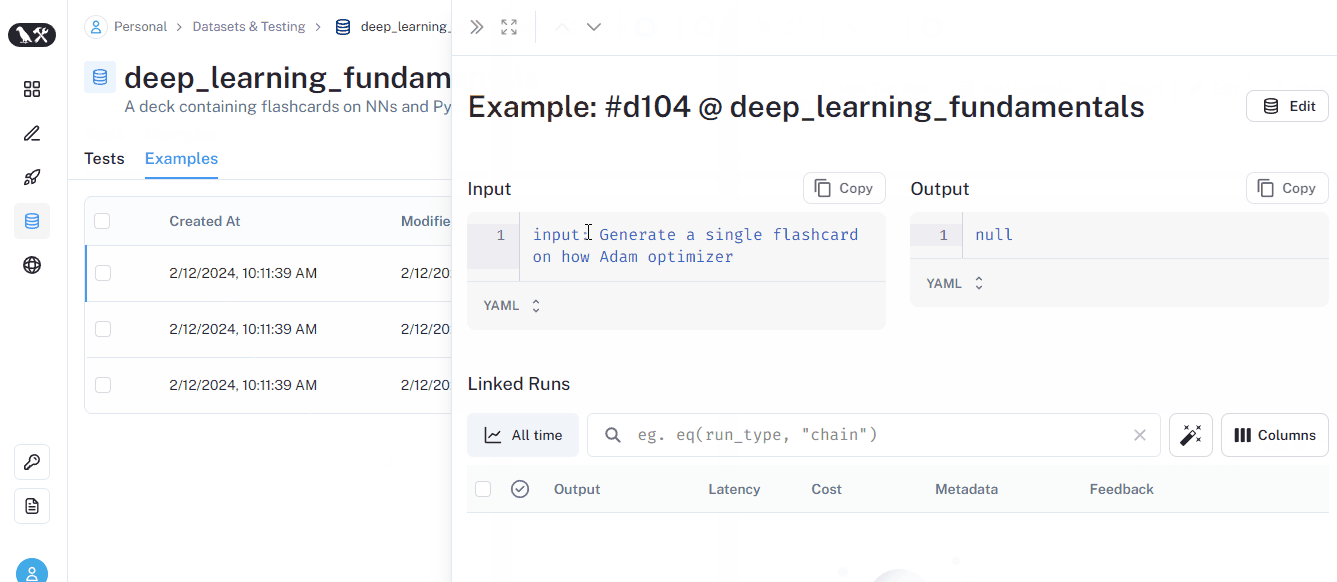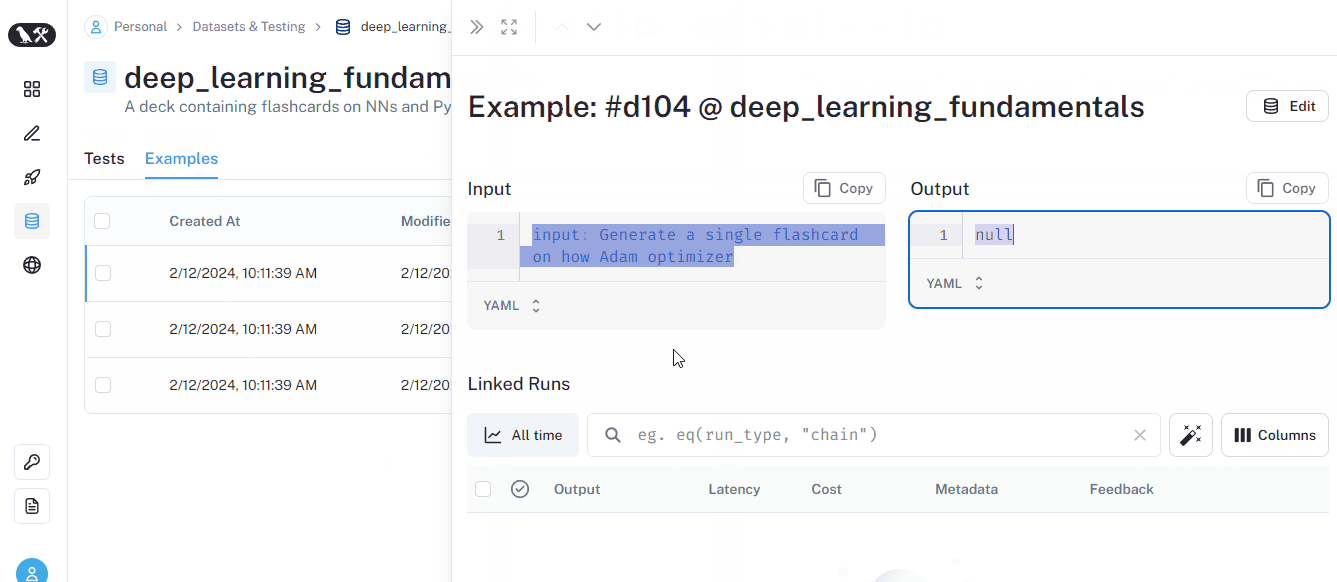
Arayüzdeki veri kümesi sekmesine giderseniz, her bir istemi ÇIKTI alanı NULL olacak şekilde listelenmiş göreceksiniz:
Şimdi, run_on_dataset fonksiyonunu kullanarak tüm istemleri tek satır kodla çalıştıralım:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Çalıştırma bittiğinde, veri kümesi sayfasında listelenecek. Şöyle görünecek:
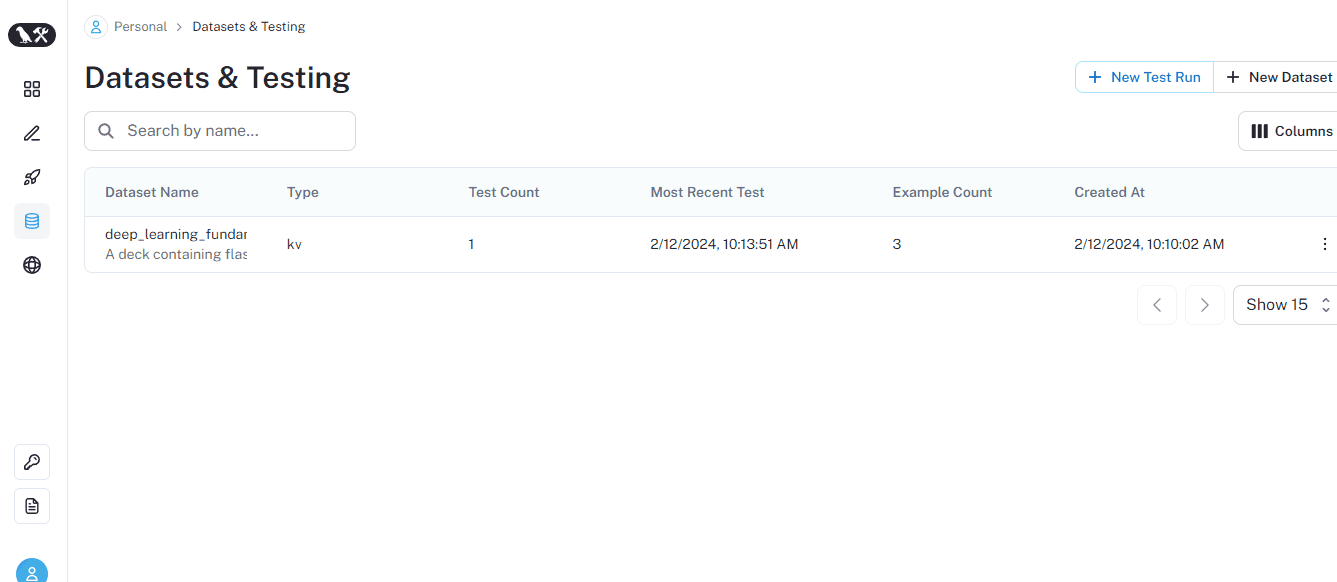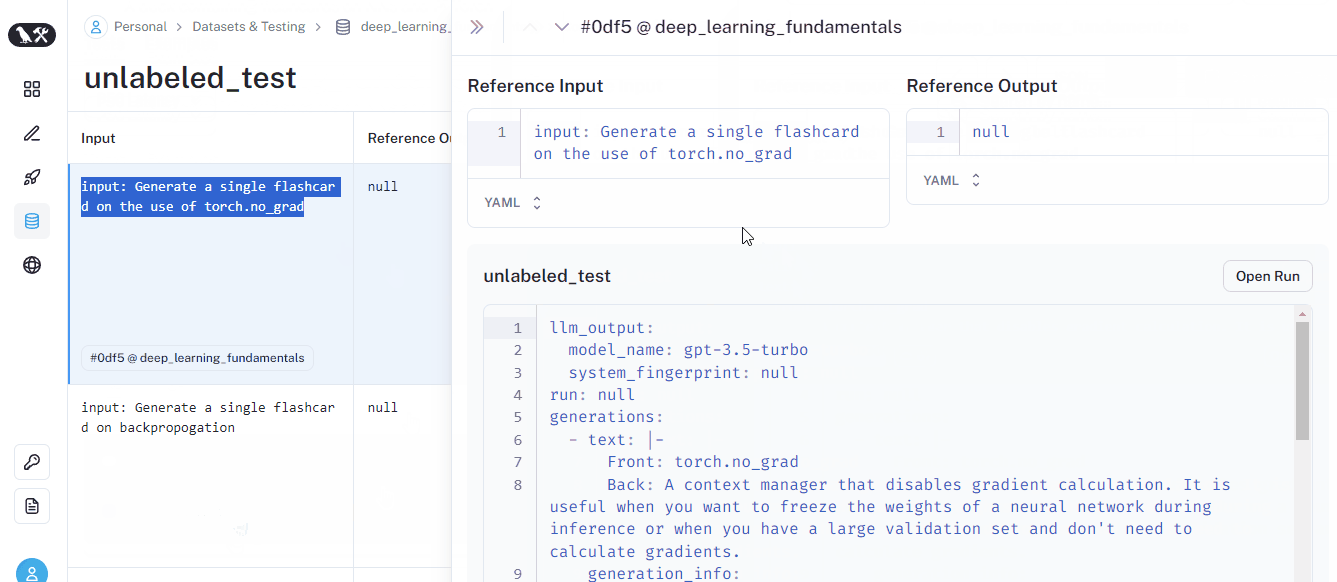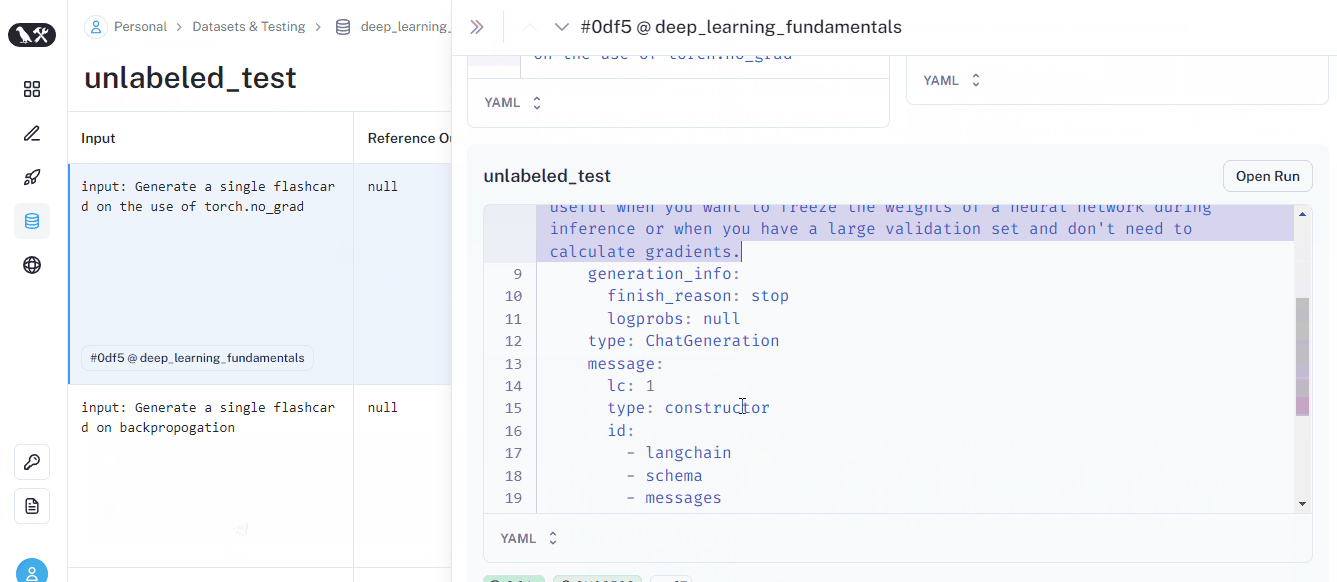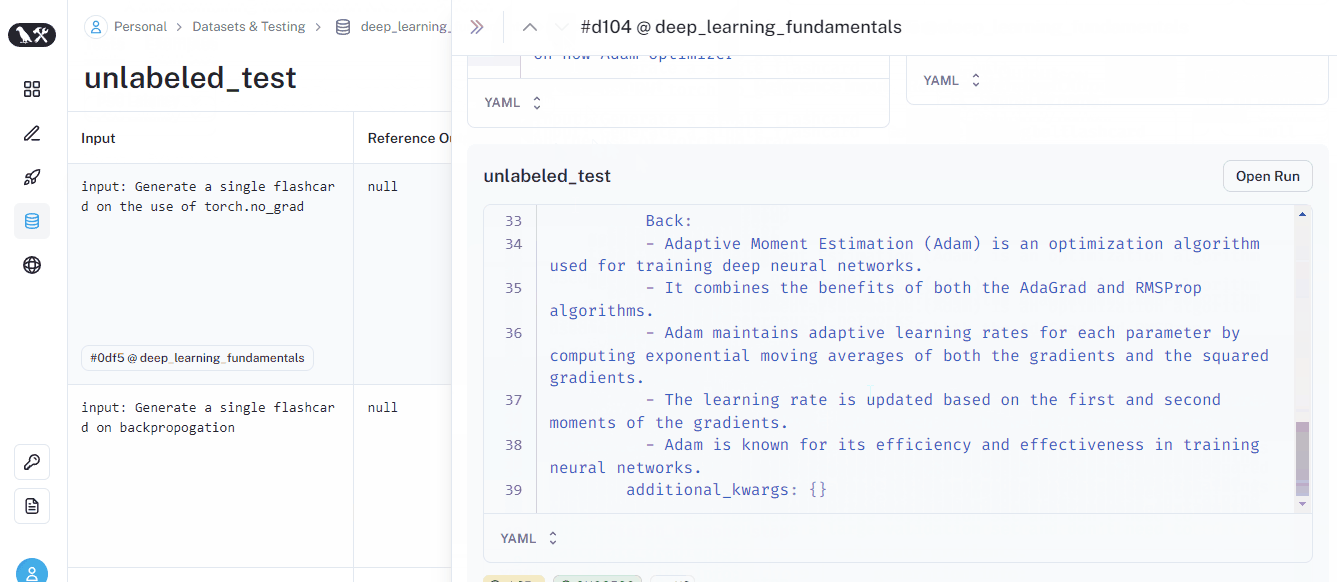
Az önce etiketsiz bir veri kümesi üzerinde bir test çalıştırdık — örnek istemleri olan ama örnek çıktıları olmayan bir veri kümesi. Testimiz her bir isteme birer yanıt üretti ama hiçbir şeyi değerlendirmedi. Oysa “Çıktı yardımcı mı?” ya da “Yanıt kısa mı uzun mu?” gibi temel kontroller yapmak isteriz.
LangSmith, yerleşik değerlendiriciler kullanarak bu tür kontrolleri yapmamıza olanak tanır.
Veri kümemizdeki üç istemi kullanarak conciseness (özlülük) ve coherence (tutarlılık) değerlendirmelerini çalıştırmak için RunEvalConfig sınıfını kullanabiliriz:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Yukarıda, değerlendiriciler adlı bir listede iki ölçüt tanımlıyoruz. Bu değerlendiricileri run_on_dataset fonksiyonunun evaluation parametresine iletiyoruz:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset, bir veri kümesindeki tüm istemleri verilen LLM ile çalıştırmak ve anlık olarak her türlü değerlendirmeyi yapmak için kullanışlı bir fonksiyondur. Sonuçları, her veri kümesinin ayrılmış sayfasında görülebilir:
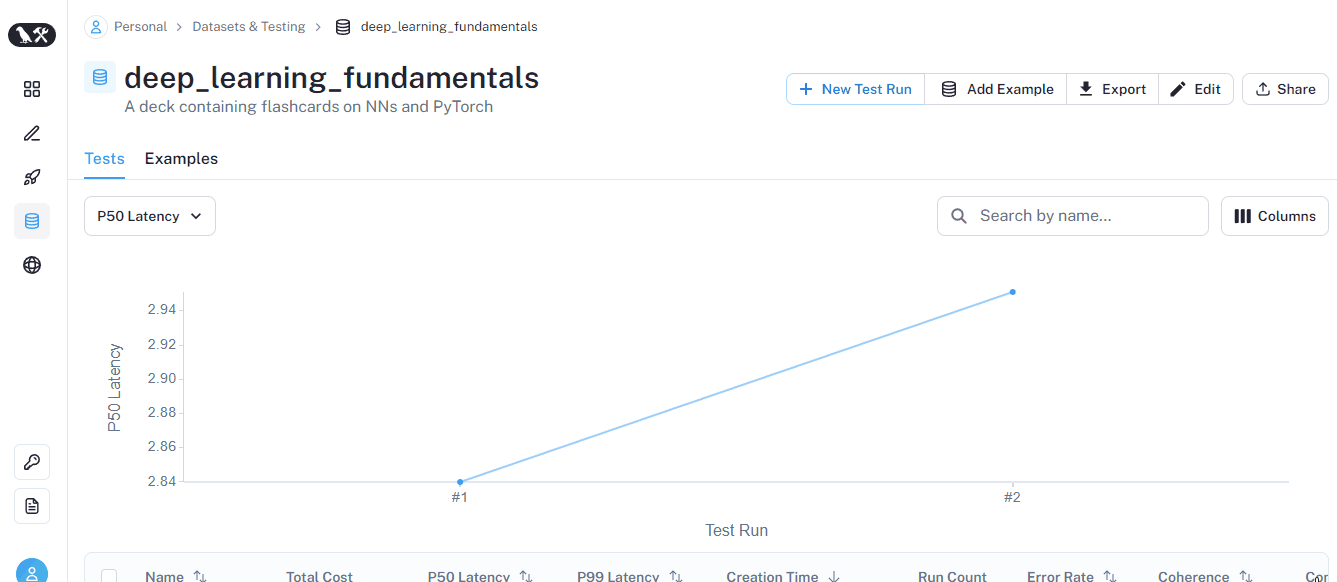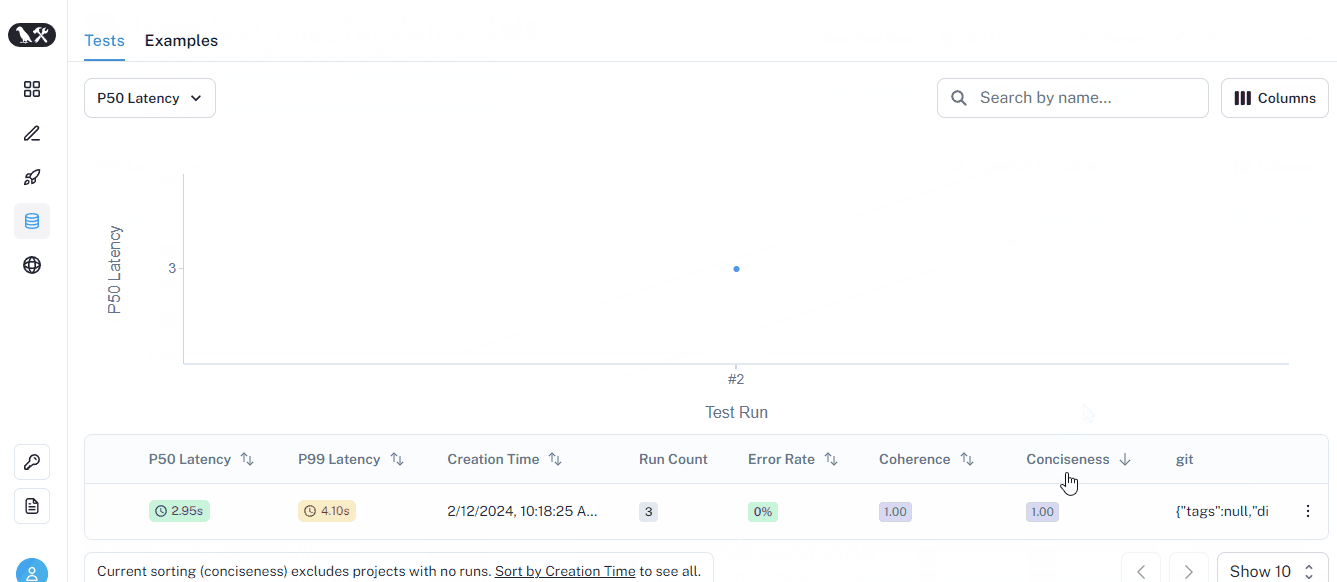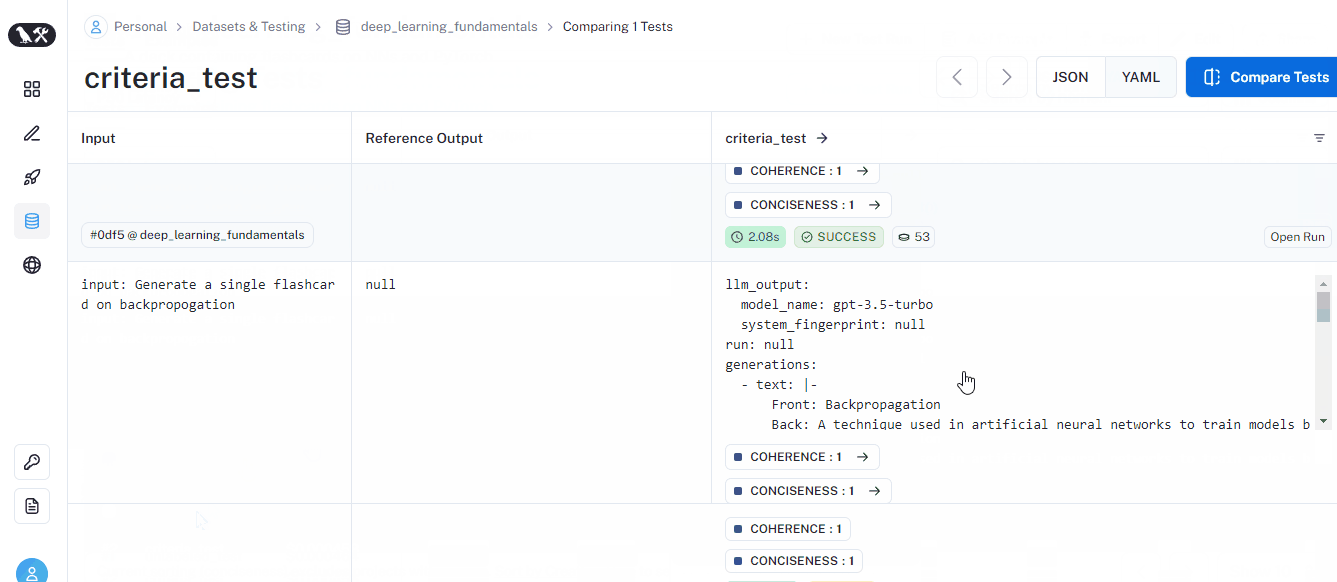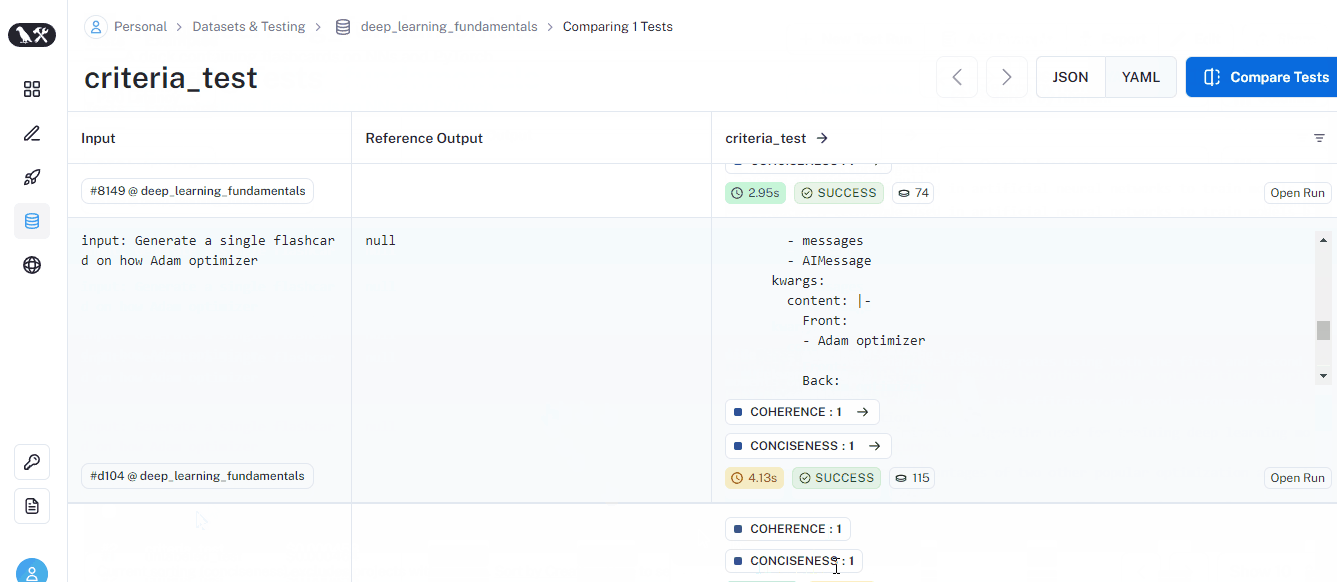
Bu kez, çalıştırmada her bir istem için tutarlılık ve özlülük metrikleri var. Altta, her bir metrik için ortalama bir puan da göreceksiniz.
Tüm yerleşik ölçütlerin listesini görmek için aşağıdaki parçacığı çalıştırın:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Elbette tüm LLM kullanım senaryoları temel değerlendiricilerle kontrol edilemez. Örneğin, bir flashcard'ın bir kodlama sorusu içerip içermediğini kontrol eden bir değerlendirici yok. O hâlde bunu tanımlasak iyi olur:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Doğal dille özel bir ölçüt geçirmek için {“criteria_name”: “Condition to check”} sözlüğünü Criteria sınıfına iletmemiz yeterlidir. Yukarıda iki ek değerlendirici oluşturuyoruz; böylece LangSmith, veri kümemizdeki istemlerin ürettiği çıktının üzerine iki ek istem daha çalıştıracak:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Çalıştırmayı kontrol ederseniz, tanımladığımız özel ölçütleri her bir istem altında göreceksiniz. Üzerine geldiğinizde, ardından LLM'in gerekçelendirmesini de alacaksınız:
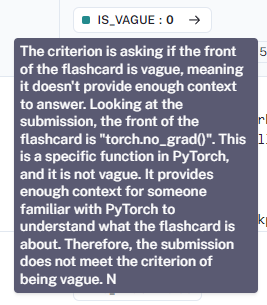
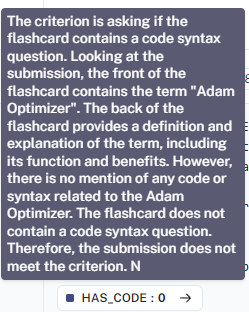
Tüm istemler için değerlendirme sonuçlarını kontrol ettiğinizde, ölçütlerimizin beklediğimiz gibi değerlendirme yapmadığını göreceksiniz. O hâlde şunu da göz önünde bulundurun — doğru şeyleri kontrol ettiklerinden emin olmak için ölçütlerinizi de istem mühendisliği ile iyileştirmeniz gerekir.
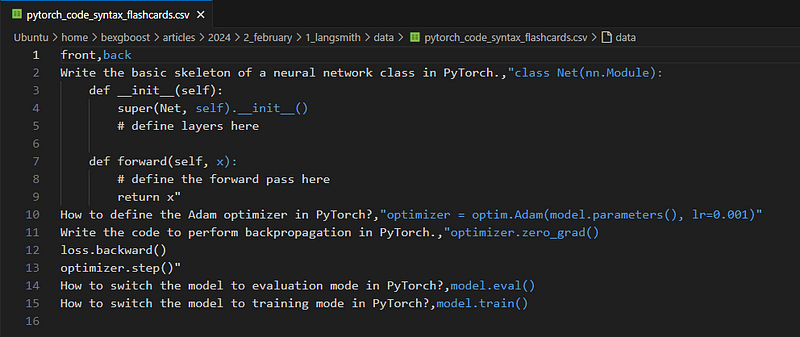
Bazen beklenen çıktılara sahip istemlerden oluşan bir veri kümesi oluşturmak isteyebilirsiniz; yani etiketli veri kümeleri. Etiketli veri kümelerini çeşitli formatlarda oluşturabilirsiniz, ancak en yaygın olanı muhtemelen bir CSV dosyasıdır. Örneğin, burada ChatGPT ile oluşturduğum ve PyTorch sözdizimi hakkında beş soru içeren bir dosya var:
Bundan bir veri kümesi oluşturmak için upload_csv fonksiyonunu kullanabiliriz:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
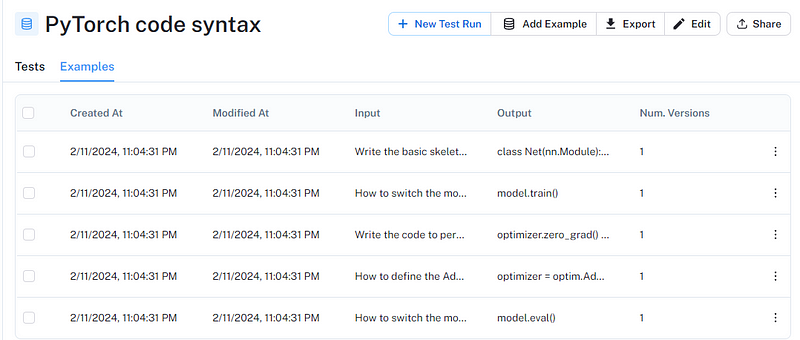
Fonksiyonun üç zorunlu parametresi vardır: CSV yolu ve girdi/çıktı sütunlarının adları. Yükleme tamamlandığında veri kümesi arayüzde görünecek:
Önceki bölümdeki özel ölçütümüzü bu veri kümesi üzerinde de çalıştıralım:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
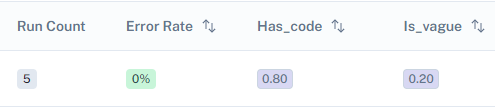
Veri kümesi sayfasına gidip çalıştırmayı kontrol ederseniz, her bir özel ölçüt için ortalama puanları görebiliriz:
Doğal dille yazılmış yerleşik ve özel değerlendiriciler çoğunlukla etiketsiz veri kümeleri içindir. Yüklediğimiz CSV gibi etiketli veri kümeleri için, LangSmith bir isteme verilen yanıtın doğruluğunu ölçmek üzere daha kapsamlı değerlendiriciler sunar:
context_qa (bağlamsal S&C): Doğruluğu değerlendirirken örnek çıktıyı bağlam olarak kullanırqa (S&C): LLM'e referans çıktıyı kullanarak bir yanıtı doğrudan “doğru” ya da “yanlış” olarak notlamasını söylercot_qa (Düşünce zinciri S&C): context_qa'ya benzer, ancak bu değerlendirici LLM'i nihai karara varmadan önce düşünce zinciri akıl yürütmesine zorlar.Sonuncusunu örneklerimiz üzerinde deneyelim:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
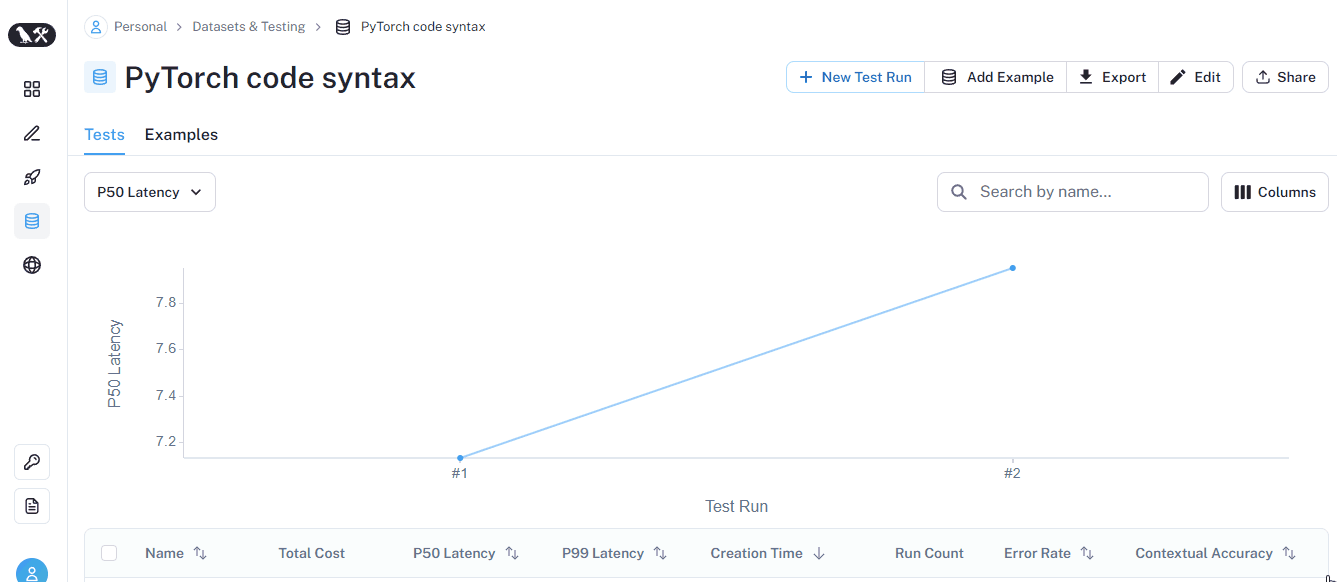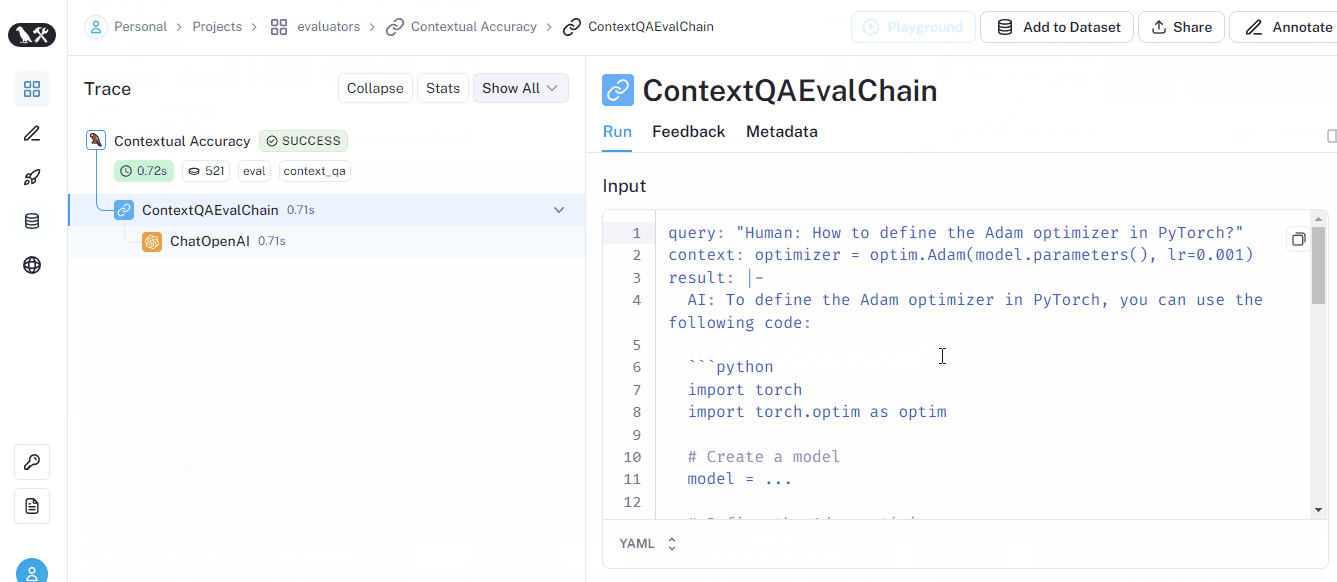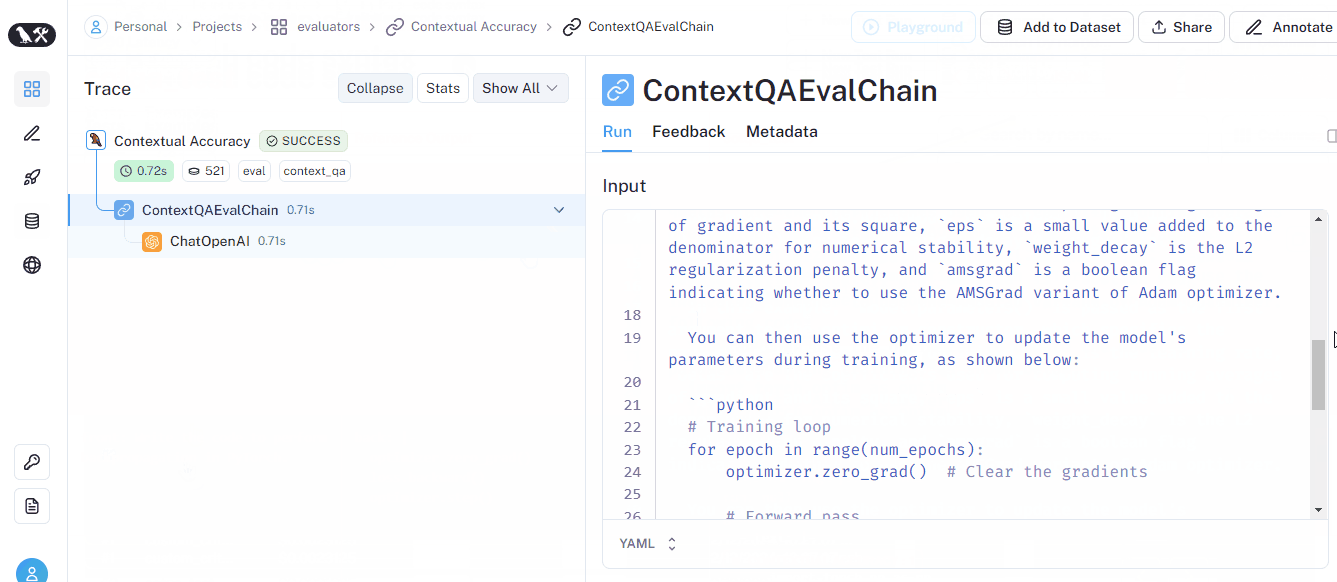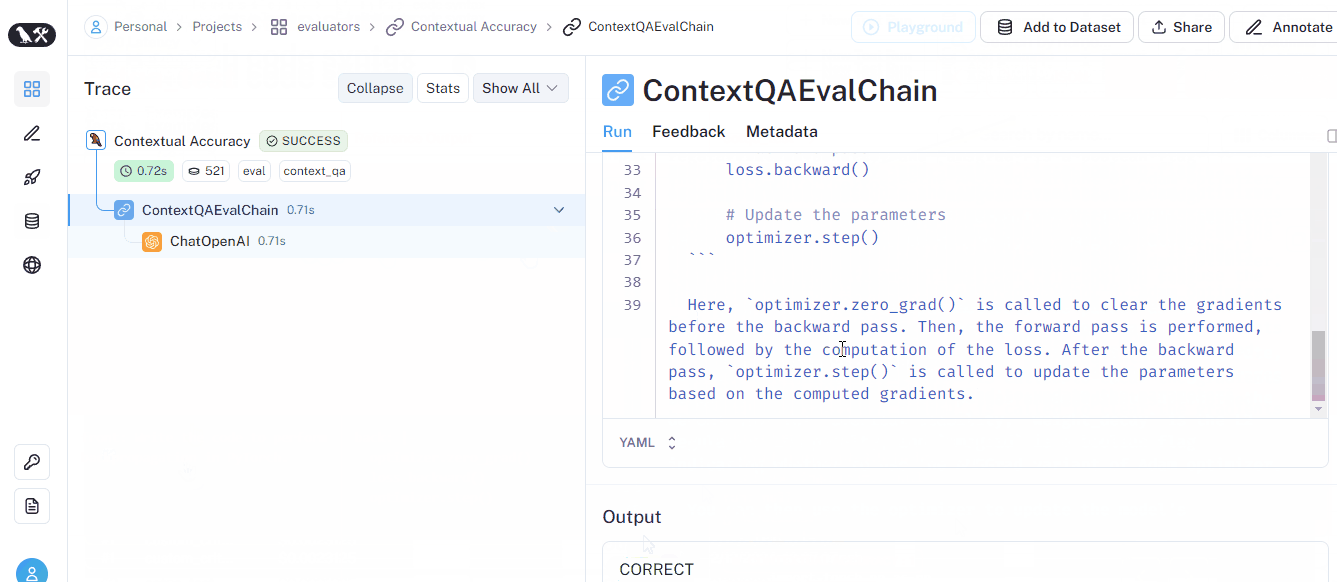
CoTQA ölçütü, aşağıdaki GIF'te (ayrıca arayüzde) gösterildiği gibi Contextual accuracy adlı bir puan döndürür:
Değerlendiriciler hakkında çok daha fazlasını öğrenmek için lütfen LangSmith dokümanlarındaki LangChain değerlendiricileri bölümünü ziyaret edin.
Bu eğitimi okuduktan sonra LangSmith'in aslında istem mühendisliği için gelişmiş bir araç olduğu izlenimini edindiyseniz, haklısınız! Şu anda LangSmith, LLM'lerin talimatlarının ve çıktılarının gerçekten istediğiniz şey olduğundan emin olmak için en iyi çerçevedir.
Ayrıca üretim düzeyinde LLM uygulamaları oluşturmanın ne kadar emek istediğini de fark etmiş olmalısınız. Bu nedenle, LLM projelerinde çalışırken daha akıcı bir deneyim için LangSmith'i kullanın.
LangSmith'teki bazı kavramlar anlam ifade etmediyse, LangChain'de bazı temelleriniz eksik olabilir. İşte bununla ilgili bazı kaynaklar:
LangChain Yolculuğunuza Bugün Başlayın
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



