
Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
50.6K
Kürzlich bin ich auf eine KI-Plattform gestoßen, die automatisch Karteikarten aus beliebigen Medien generiert. Da ich Konzepte gern mit Spaced Repetition lerne, habe ich direkt mein XGBoost-Tutorial hochgeladen und die KI gebeten, 50 Karteikarten dazu zu erstellen.
Die Enttäuschung folgte prompt. Die meisten Fragen waren zu leicht, kaum eine betraf Codesyntax. Noch merkwürdiger: 10% der Fragen waren identisch und völlig aus dem Zusammenhang gerissen — “What is the capital of France?”.
Solche Fehler deuten auf fehlende Evaluation und Validierung der von KI-Diensten erzeugten Ausgaben hin. Vielleicht kannten sie LangSmith nicht.
LangSmith ist eine umfassende Plattform zum Testen, Debuggen und Evaluieren von LLM-Anwendungen. Besonders wichtig ist die Bewertung der LLM-Ausgaben und die Leistungsüberwachung. In diesem Tutorial siehst du das Framework in Aktion und lernst Techniken, die du in deinen eigenen Projekten einsetzen kannst.
Los geht’s!
Wie oben erwähnt, ist LangSmith eine Komplettplattform zur Bewertung von Anwendungen mit großen Sprachmodellen. Hier sind einige Features und ihre konkreten Vorteile:
Entwicklerinnen und Entwickler können in Minuten, nicht Stunden, mit LangSmith experimentieren. So kann ein kleines Team oder eine Einzelperson am Wochenende einen Prototyp bauen und unter Umständen schon am Montag einen bezahlten Dienst veröffentlichen.
Mit strengen Evaluationswerkzeugen lassen sich peinliche und teure Fehlveröffentlichungen von KI-Produkten vermeiden (wie im Beispiel aus der Einleitung). LangSmith ermöglicht, LLM-Ausgaben anhand integrierter Kriterien wie Nützlichkeit, Kohärenz, Misogynie oder sogar benutzerdefinierter Bewertungen in natürlicher Sprache zu prüfen, etwa “Ist der Inhalt klischeehaft?” oder beim Generieren von Karteikarten “Enthält die Karte eine Frage zur Codesyntax?”.
LangSmith zeichnet mit Traces nahezu jeden Aspekt von LLM-Runs auf: Latenz, Tokenanzahl, Kosten und allerlei Metadaten. In der Weboberfläche kannst du Runs schnell nach Fehlerrate, Latenz, Datum oder sogar nach Textinhalt per natürlicher Sprache filtern. Das heißt: Wenn ein KI-Tutor echten Lernenden plötzlich fehlerhafte Antworten liefert, kannst du innerhalb weniger Stunden einen Fix ausrollen.
LangChain ist das Mutter-Framework von LangSmith und konzentriert sich auf die Entwicklungsphase von LLMs. Es bietet ein modulares Design, um mehrere LLMs (Agenten) zu verketten und mit anderen APIs wie YouTube oder Google Search zu integrieren. LangSmith setzt dem Ganzen die Krone auf und stellt mit starken Evaluations- und Monitoring-Tools sicher, dass mit LangChain erstellte Prototypen wie erwartet performen.
Sieh dir unser LLM Applications with LangChain Tutorial an, um mehr über LangChain zu erfahren.
Ein weiteres Highlight von LangSmith sind Datasets. Damit kannst du Ketten, Agenten oder Modelle in LangChain vor dem Deployment mit standardisierten Beispielen verbessern. Zum Beispiel könnte eine CSV-Datei zwei Spalten enthalten — Fragen und Antworten für Karteikarten in einem bestimmten Format.
Indem wir diese Datei in ein Referenzdataset umwandeln, können wir LLMs anweisen, ihre eigenen Ausgaben anhand der oben genannten QA-Metriken zu bewerten.
Wir sehen uns diese Funktionen nun nacheinander mit Beispielen an.
In der klassischen ML-Entwicklung sammelst du Daten, trainierst, finetunest, testest und deployest Modelle – die Schritte sind klar definiert. Bei LLM-Apps startest du aber oft mit einem fertigen Modell eines Anbieters. Finetuning? Häufig teuer. Daher verbringst du viel Zeit mit dem Formulieren guter Prompts — entscheidend ist, deiner LLM-App die richtigen Fragen zu stellen. Du brauchst viele Prompts zum Testen – so wie du viele Daten für ein gutes ML-Modell brauchst.
Mit Prompts arbeitest du jedoch mit Text statt Zahlen. Übliche Fehler- oder Genauigkeitsmaße wie MSE oder Cross-Entropy greifen hier nicht. Und jeden Ein- und Output manuell zu lesen? Bei Tausenden Prompts würde das Tage dauern.
Du brauchst also einen Workflow, der das systematische Erstellen und Testen von Prompts effizient macht – um die Leistung deiner LLM-App zu messen, ohne in manueller Prüfung zu versinken. So könnte das aussehen:
In dieser Phase baust du das Fundament deiner Anwendung mit Frameworks wie LangChain. Für einen Karteikarten-Generator kann dein Prototyp aus mehreren Bausteinen auf Basis des gewählten LLMs bestehen. Du könntest es beispielsweise verketten mit:
und mehr (siehe die möglichen Komponenten in den LangChain-Dokumenten). Viel Entwicklungszeit sparst du, wenn du vorgefertigte Chains von LangChain für gängige Aufgaben nutzt.
Jetzt testest du deine Anwendung gegen möglichst viele Szenarien. Das bedeutet: Jeder hinzugefügte Baustein muss funktionieren, sauber zusammenarbeiten und konsistente, hochwertige Ergebnisse liefern.
Da LLMs nicht deterministisch sind (sie erzeugen für denselben Input nicht immer dieselbe Ausgabe) und zusätzliche Komponenten die Komplexität erhöhen, verbringst du hier die meiste Zeit. Genau dafür wurde LangSmith entwickelt: um diese Phase deutlich zu verkürzen. Mehr dazu gleich.
Sobald deine Anwendung tragfähig ist, kannst du sie als REST-API bereitstellen. Eine REST-API macht deine LangChain-Chains oder -Agenten über HTTPS-Endpunkte nutzbar, an die andere Anfragen schicken können, um mit deinem KI-Modell zu interagieren. Anschließend baust du das User Interface – als Desktop-App oder, meistens, als Website.
Aktuell ist das noch nicht ganz trivial, aber die LangChain-Entwickler veröffentlichen bald LangServe, integriert in FastAPI (wie cool wäre das?). Einen Vorgeschmack findest du in der Doku.
Jetzt wird es Zeit, mit LangSmith zu experimentieren.
Zuerst lernen wir die Weboberfläche kennen. Du erreichst sie unter smith.langchain.com. Für den Zugriff musst du dich anmelden und von der Warteliste freigeschaltet werden, da die Beta aktuell geschlossen ist.
Bist du drin, sieht die Startseite so aus:
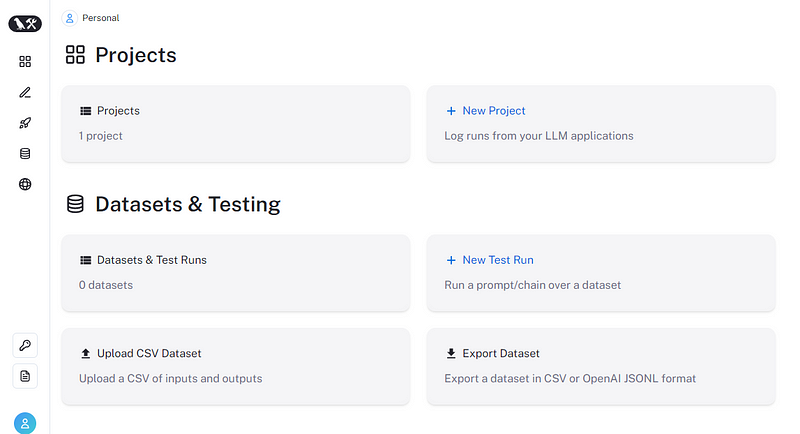
Die zwei wichtigsten Bereiche sind Projects sowie Datasets & Testing, und beide lassen sich auch über das Python-SDK steuern. Es gibt außerdem Tabs für Deployment und Annotation Queues, die hier aber nicht behandelt werden.
Projekte in LangSmith zu verwalten ist mit dem Python-SDK deutlich einfacher, das per API-Schlüssel mit der Plattform verbunden wird.
Um einen Schlüssel zu erhalten, klicke in der Plattform auf das Schlüssel-Icon und speichere ihn sicher. Lege dann in einem neuen Verzeichnis mit frischer virtueller Umgebung eine .env-Datei an. Füge darin folgende zwei Zeilen ein:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Installiere anschließend in deinem Terminal LangSmith und python-dotenv, um Umgebungsvariablen einzulesen:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Jetzt schreiben wir etwas Code:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
Wir importieren die Funktionen find_dotenv und load_dotenv, um Umgebungsvariablen aus der .env-Datei zu lesen, und richten sie mit os ein:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Wenn LANGCHAIN_TRACING_V2 auf True gesetzt ist, wird Tracing (Logging) aktiviert – essenziell fürs Debugging von LLMs. Danach initialisieren wir einen Client, um mit LangSmith zu sprechen:
from langsmith import Client

# Initialize a client
client = Client()
client enthält High-Level-Befehle zum Verwalten von Projekten und Assets in LangSmith. Zuerst erstellen wir ein neues Projekt:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
Nach erfolgreichem create_project siehst du das Projekt im Bereich Projects der Weboberfläche:
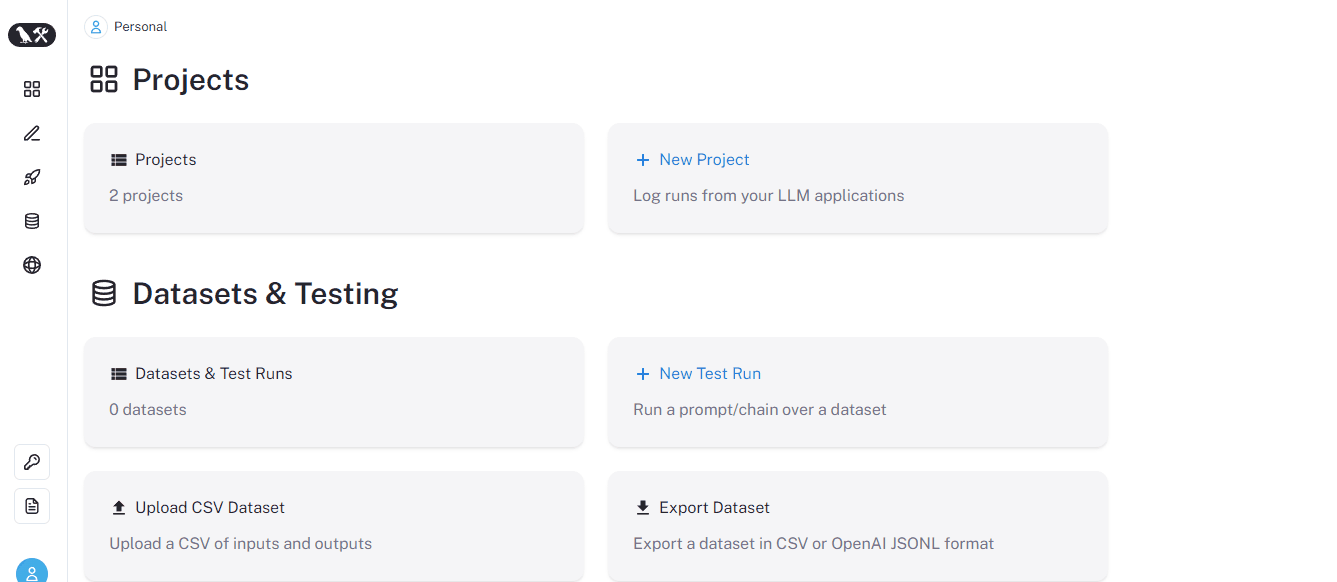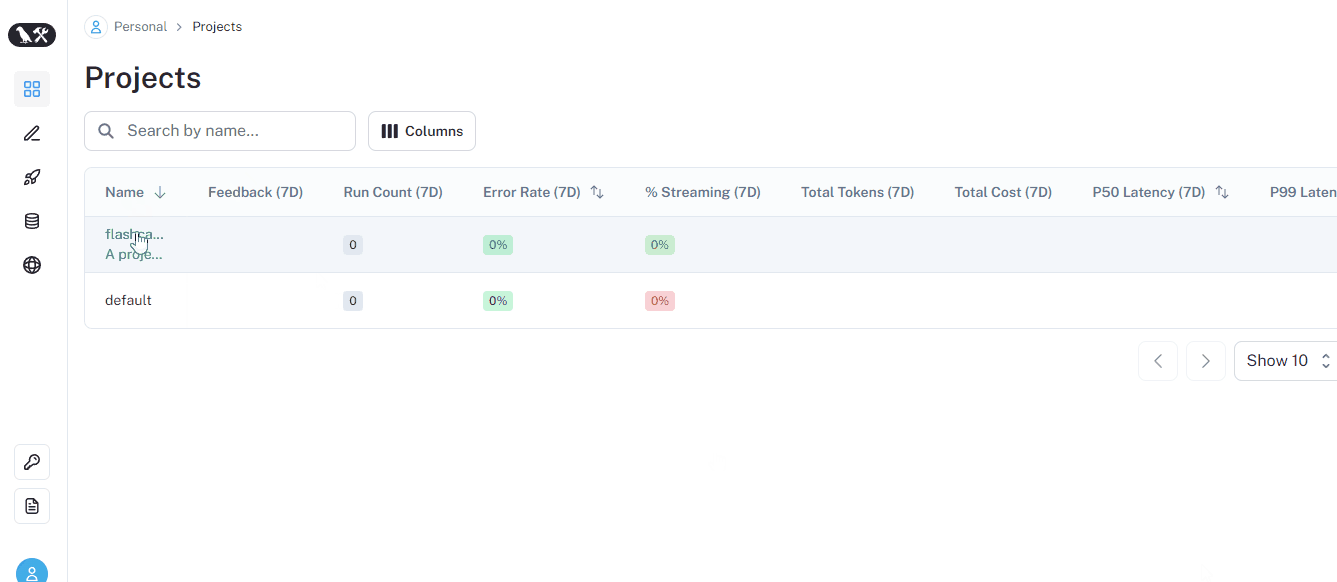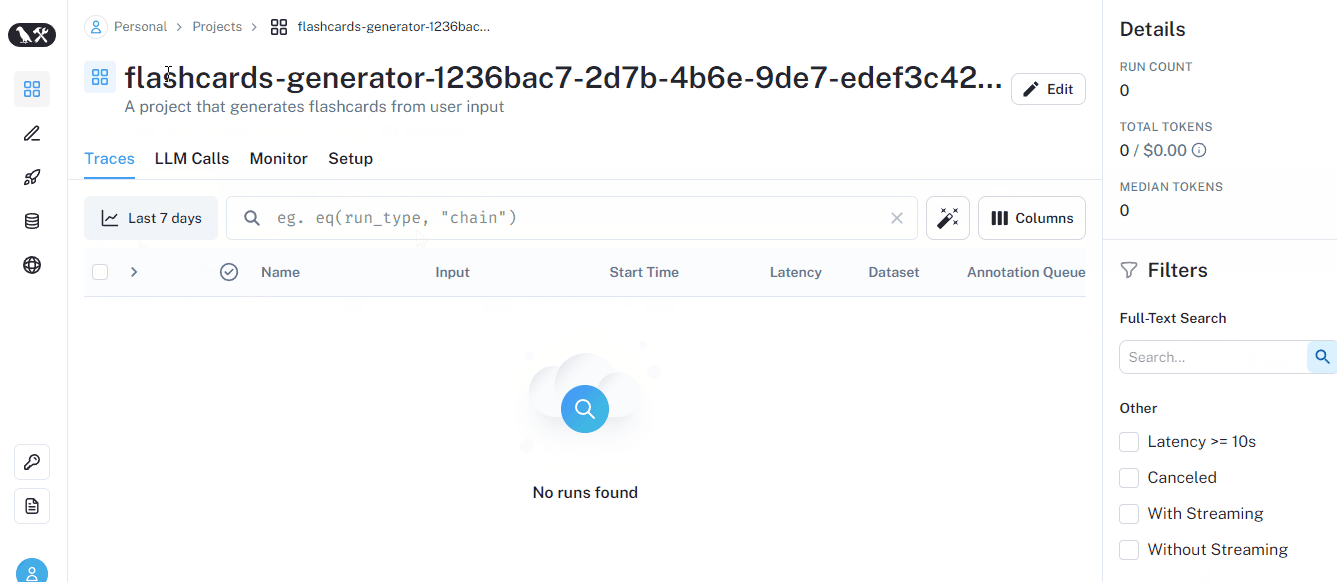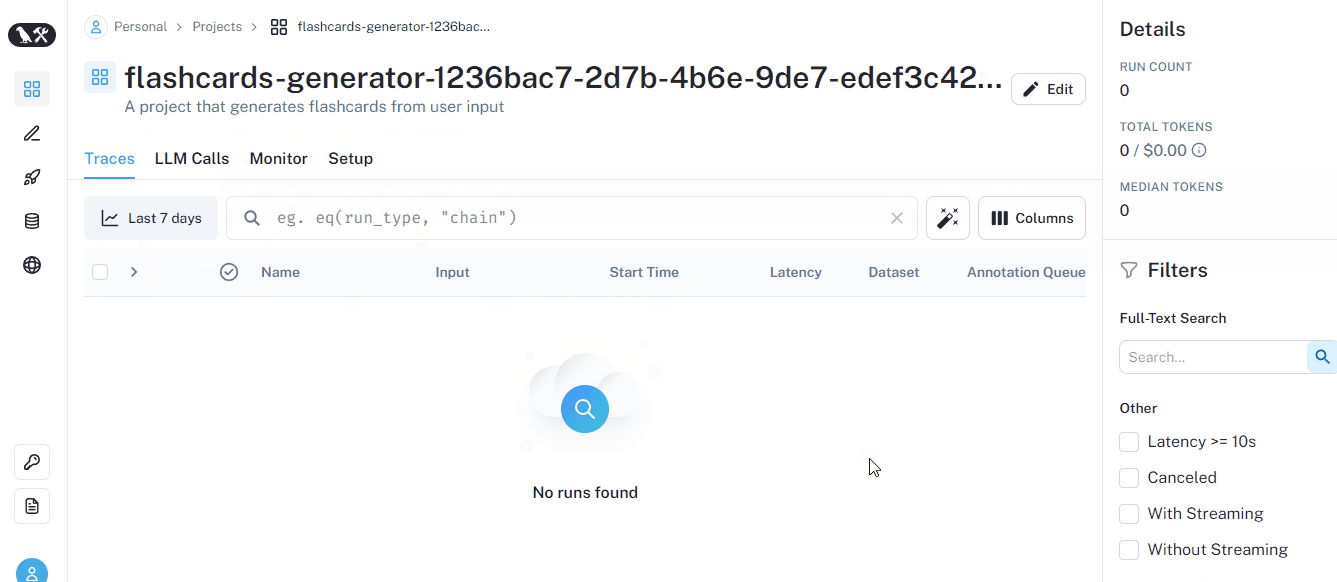
Als Nächstes setzen wir das neue Projekt per Umgebungsvariable als Standard:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Nun brauchen wir ein LLM für unser Projekt. Wir nehmen GPT-3.5 turbo, weil es günstiger ist. Du kannst aber viele andere Modelle über langchain nutzen. OpenAI-Modelle werden mit der Klasse ChatOpenAI initialisiert.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Starten wir den ersten Run:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
Wenn du kurz in der UI ins Projekt schaust, siehst du den Run bereits getraced (geloggt):
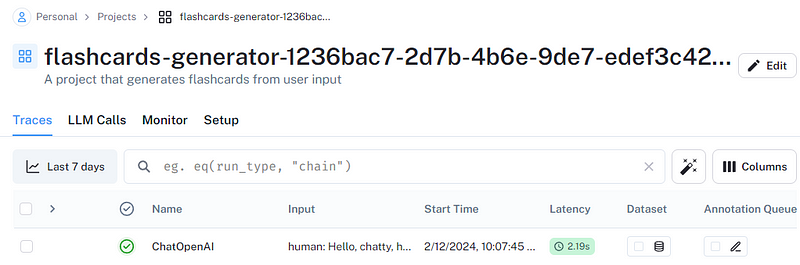
Durch das Setzen der Umgebungsvariablen und den Client haben wir das Logging automatisch aktiviert. Wie du siehst, gibt es bereits eine Menge Metadaten zum Run.
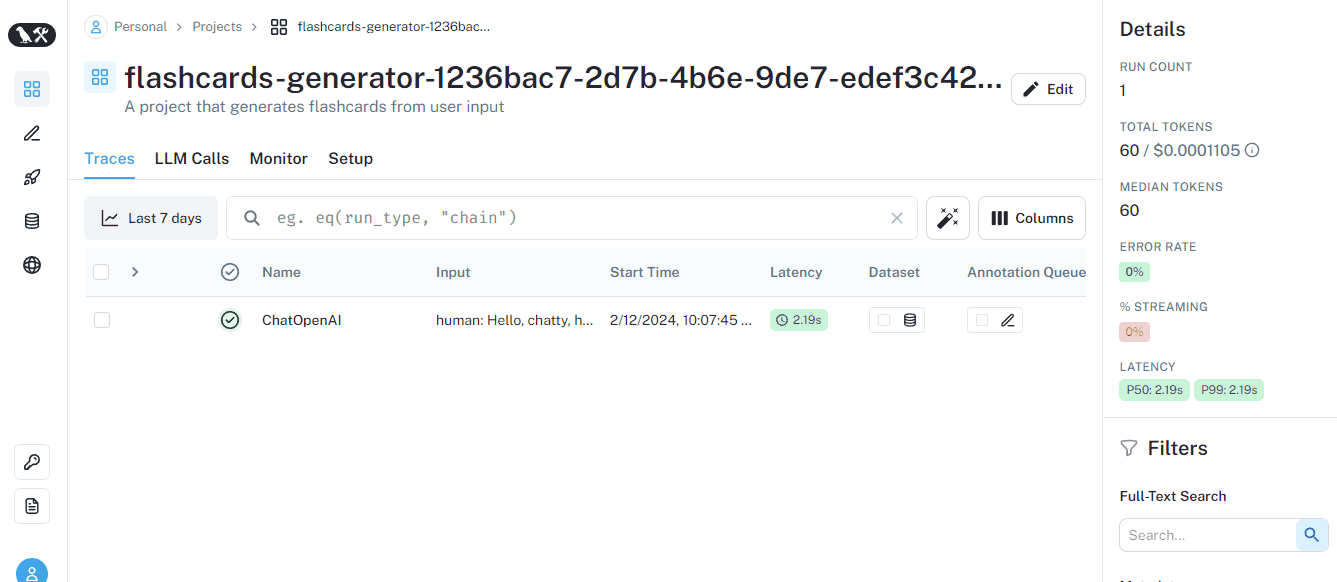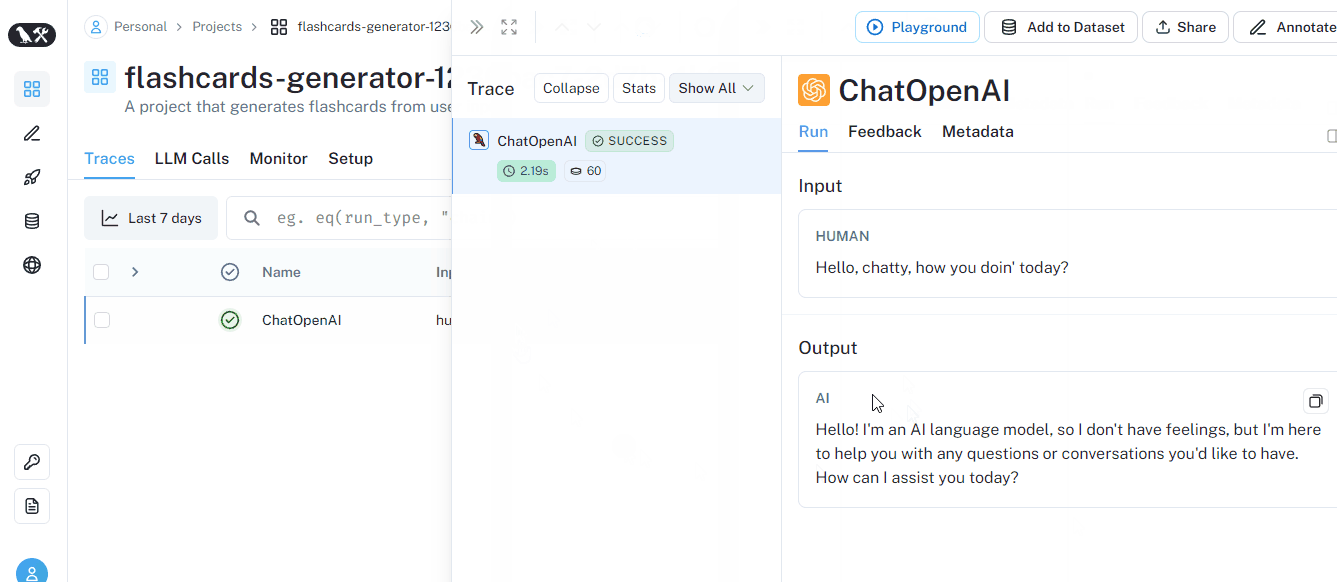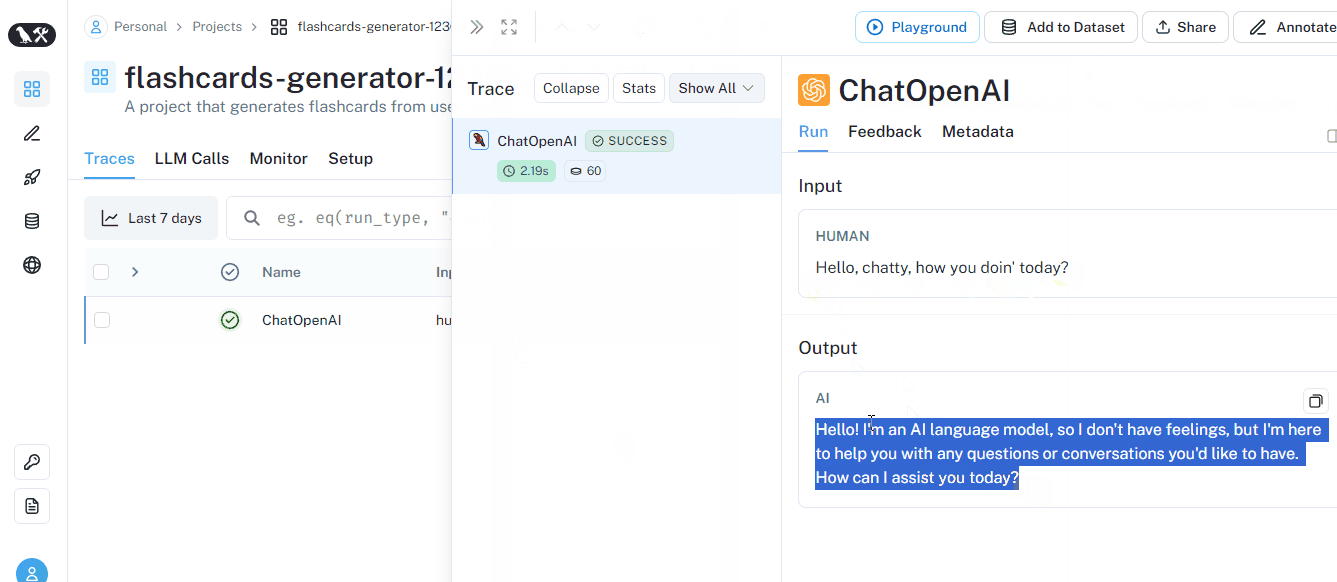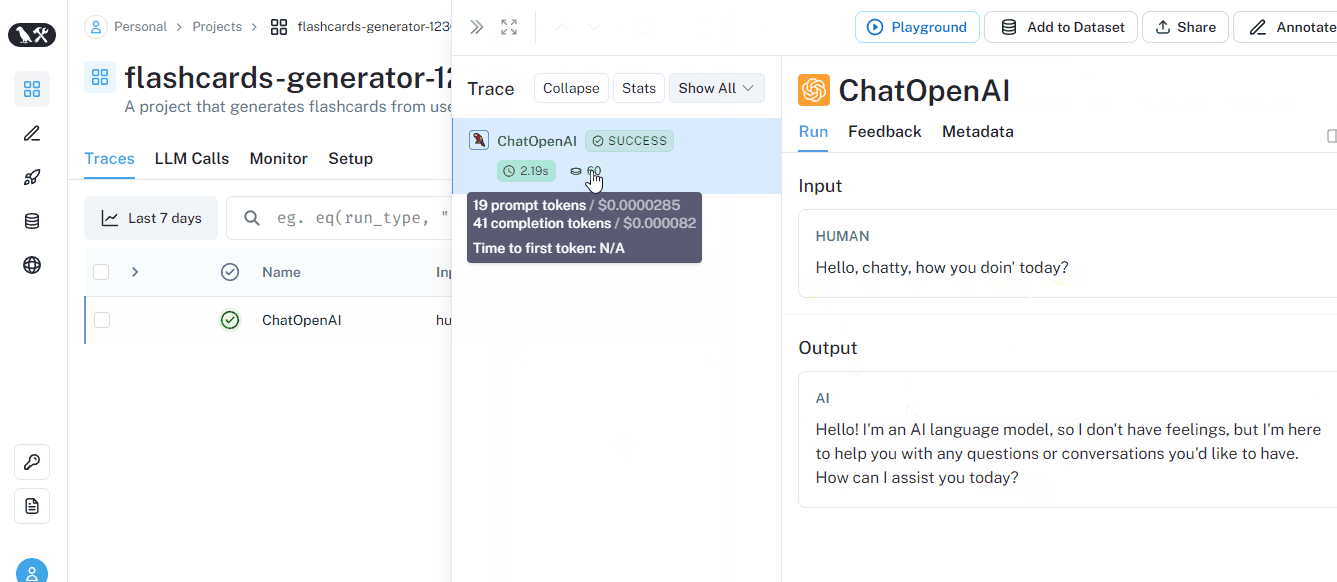
Lassen wir noch ein paar Prompts laufen:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Damit können wir schon einen einfachen Textzusammenfasser bauen. Fassen wir die letzte Ausgabe zusammen:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Super, jetzt erstellen wir unser erstes Dataset.
Wie im Abschnitt “Entwicklungsworkflow” erwähnt, musst du wahrscheinlich Tausende Prompts erstellen oder sammeln, um dein LLM, deine Chain oder deinen Agenten zu evaluieren. Diese einzeln auszuführen, wie oben gezeigt, ist nicht best practice.
Daher bietet LangSmith drei Dataset-Typen:
kv) – Standard: Definiert Inputs als beliebige Schlüssel-Wert-Paare. Nützlich, wenn Chains oder Agenten mehrere Inputs benötigen oder mehrere Outputs liefern.llm): Inputs und Outputs sind im Completion-Stil definiert – String rein, String raus.chat): Aus LLM-Chats konvertierte Datasets mit strukturierten Inputs und serialisierten Nachrichten.Erstellen wir zuerst ein Key-Value-Dataset ohne Outputs. Dafür nutzen wir die Funktion create_dataset des client:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Jetzt fügen wir drei Inputs hinzu, die jeweils das LLM bitten, eine einzelne Karteikarte zu erstellen:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
In der Dataset-Ansicht der UI siehst du nun jeden Prompt mit NULL-Output gelistet:
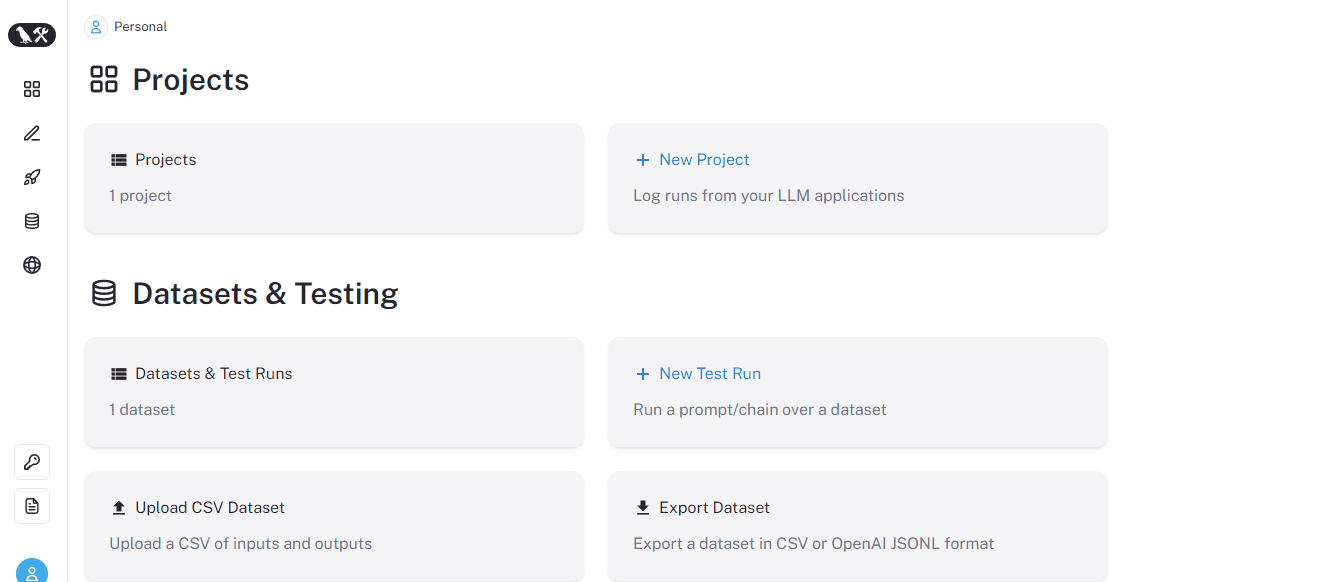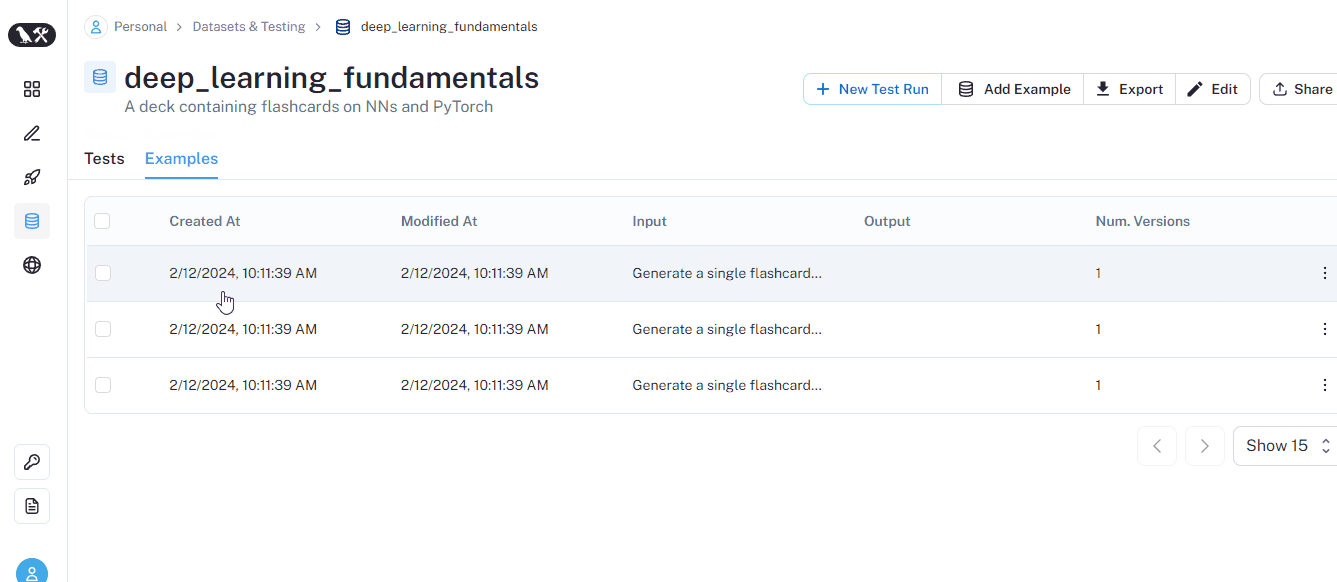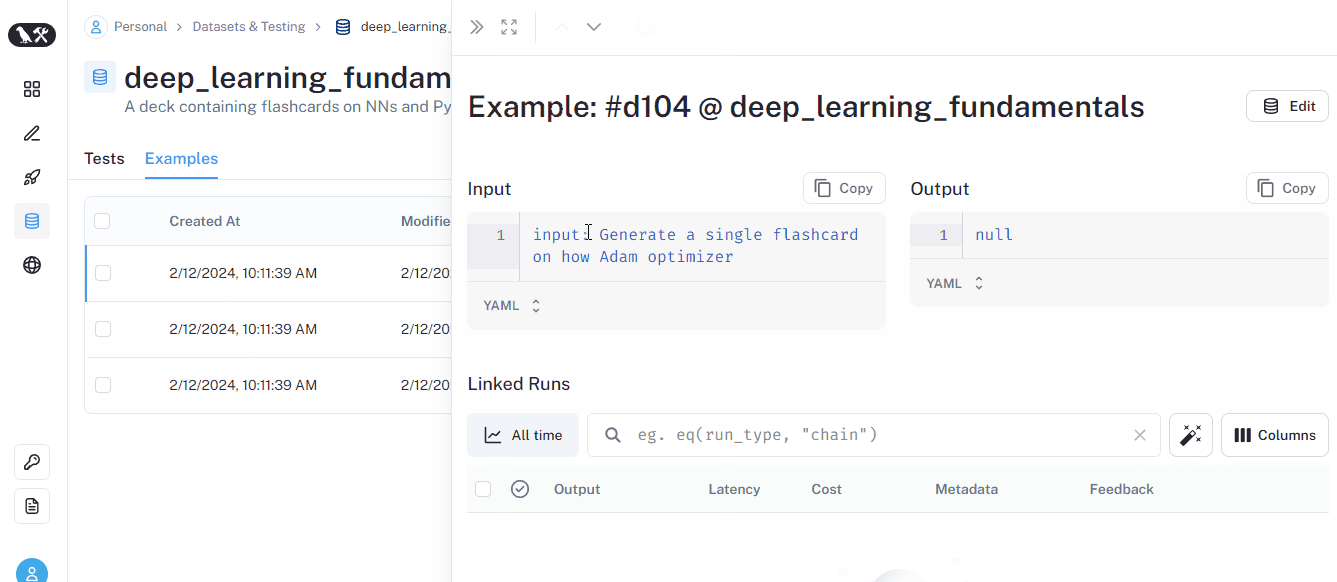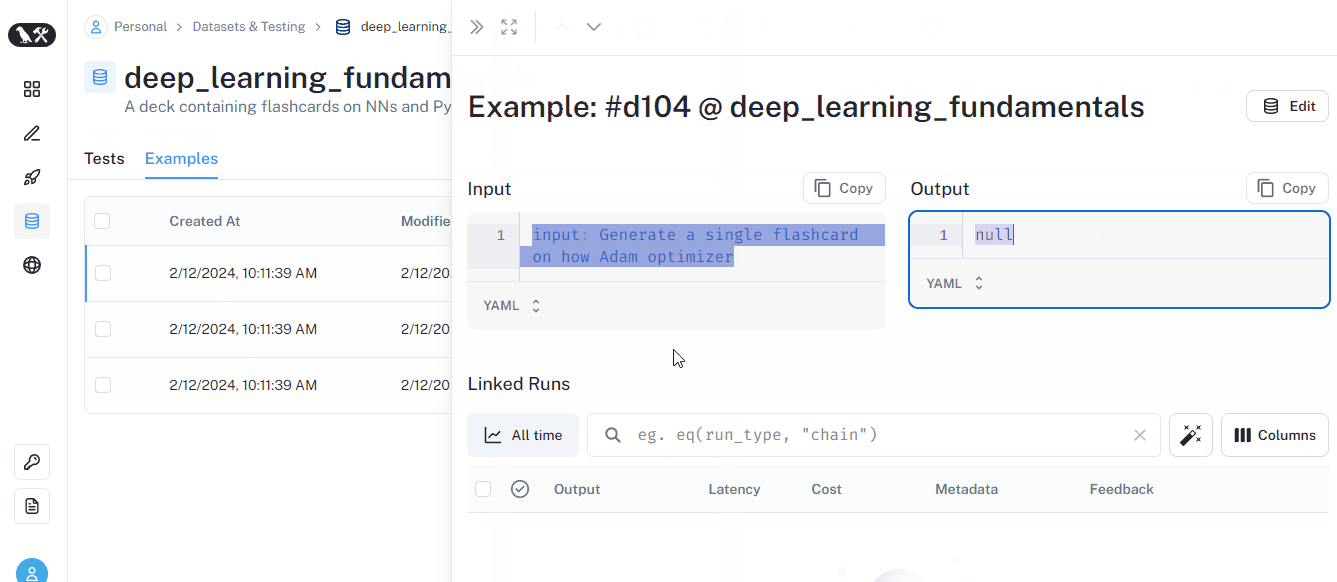
Jetzt führen wir alle Prompts in einer einzigen Codezeile mit run_on_dataset aus:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Nach Abschluss des Runs erscheint er auf der Dataset-Seite. So sieht das aus:
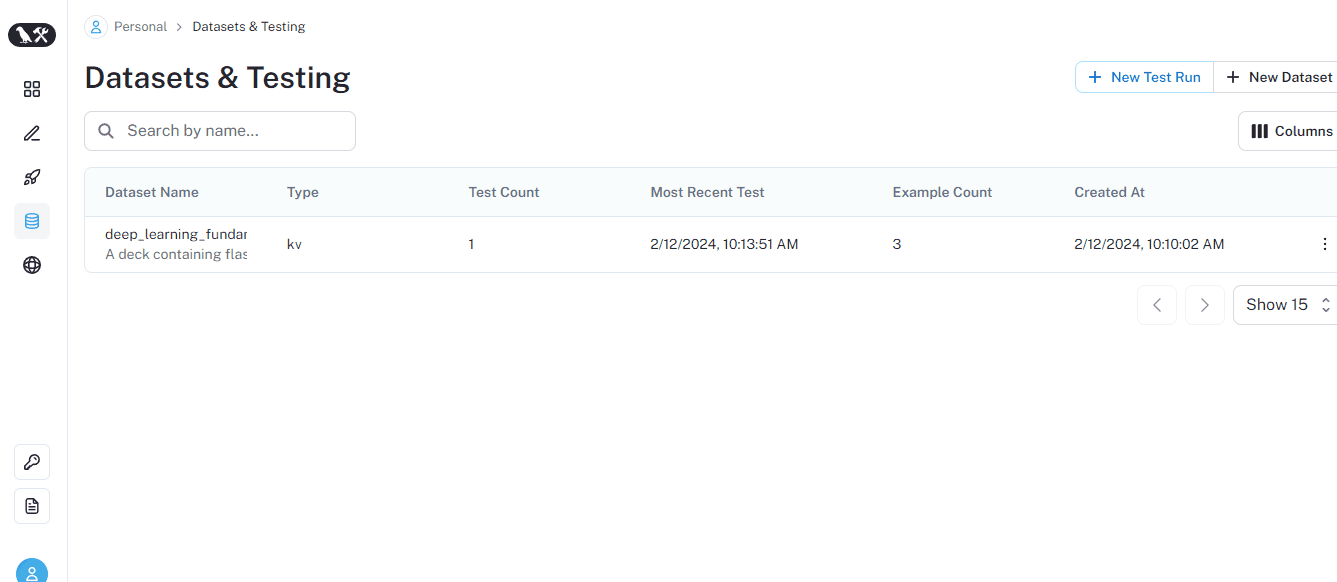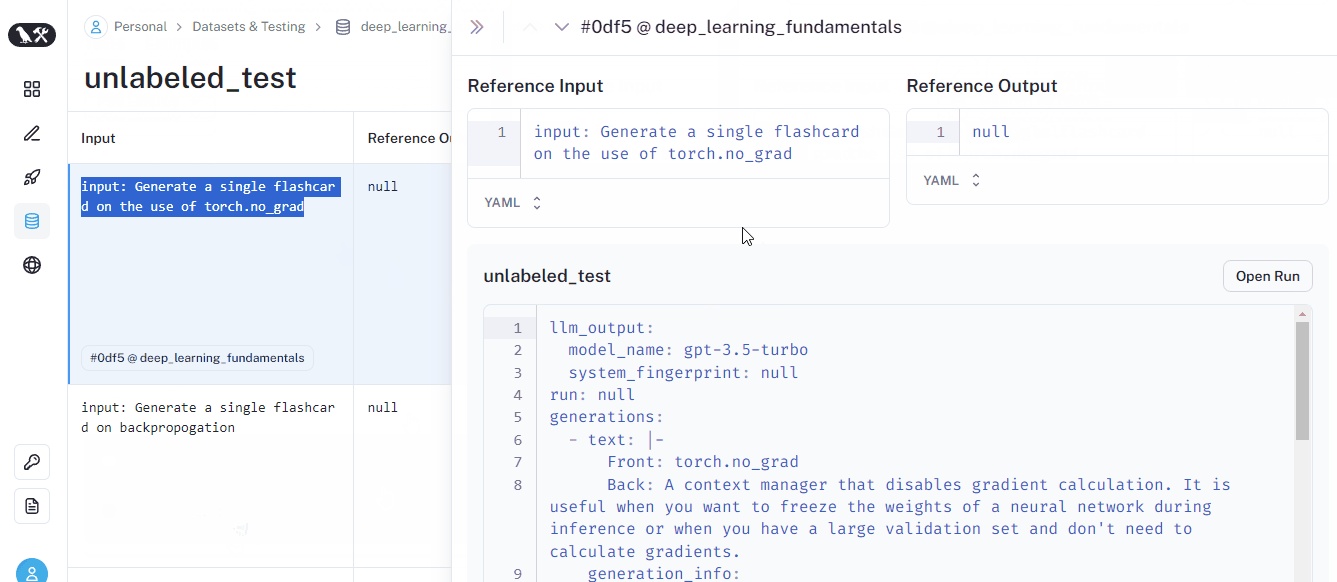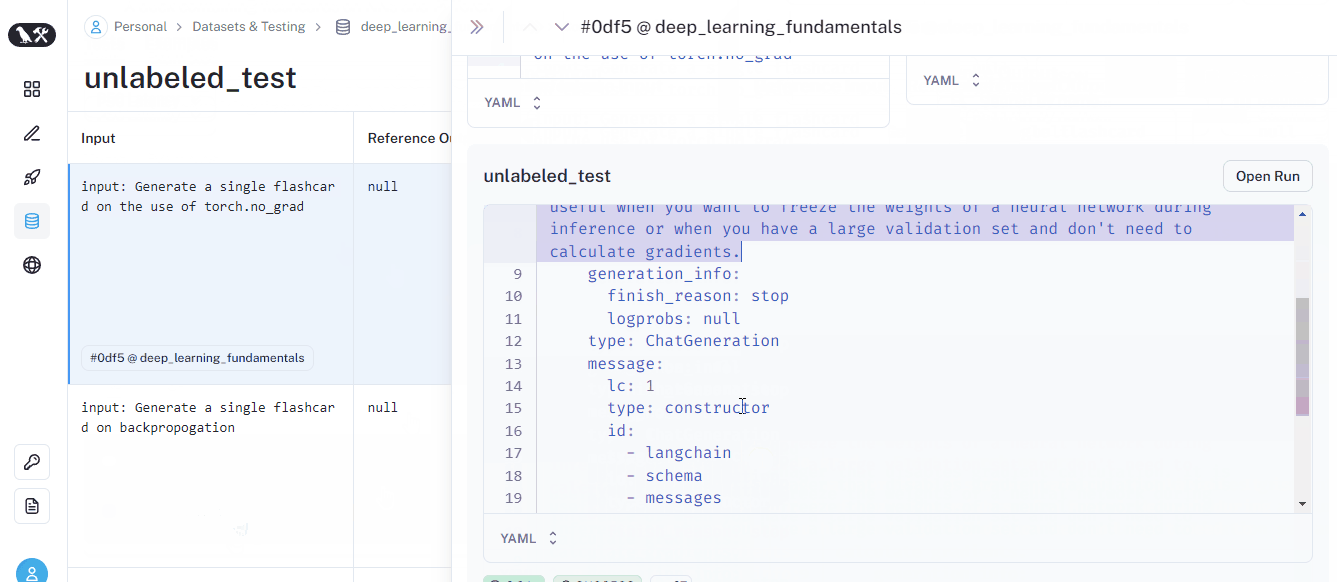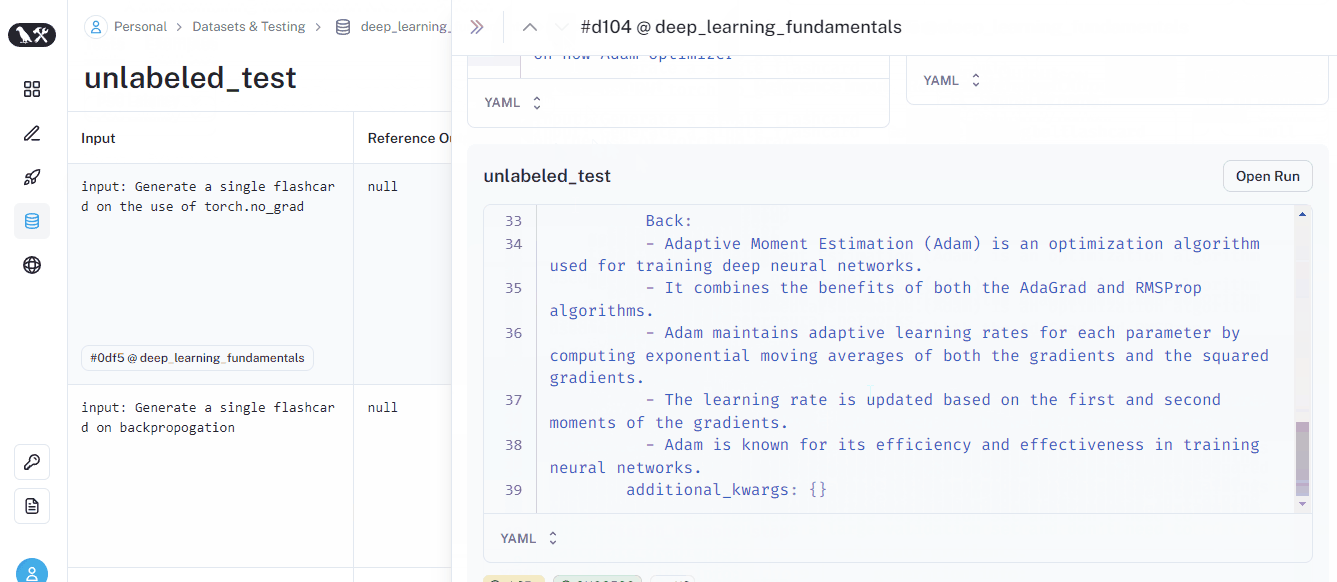
Wir haben gerade einen Testrun auf einem ungelabelten Dataset gemacht — ein Dataset mit Beispielprompts, aber ohne Beispieloutputs. Unser Test hat lediglich eine Antwort zu jedem Prompt erzeugt, aber nichts bewertet. Wir möchten jedoch Basischecks durchführen wie “Ist die Ausgabe hilfreich?” oder “Ist die Antwort kurz oder lang?”
LangSmith ermöglicht solche Checks mit integrierten Evaluatoren.
Um conciseness und coherence auf unsere drei Prompts anzuwenden, nutzen wir die Klasse RunEvalConfig:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Oben definieren wir zwei Kriterien in einer Liste namens evaluators. Diese übergeben wir an den Parameter evaluation von run_on_dataset:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset ist eine praktische Funktion, um alle Prompts eines Datasets mit dem angegebenen LLM auszuführen und on the fly beliebige Evaluationen durchzuführen. Die Ergebnisse sind auf der jeweiligen Dataset-Seite sichtbar:
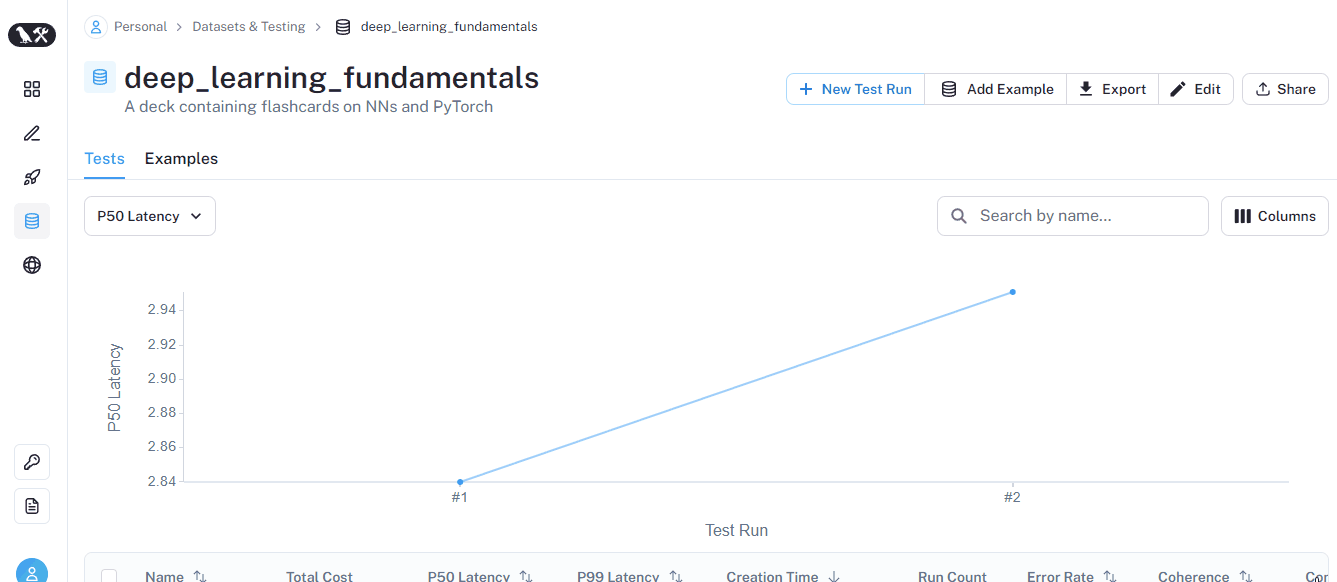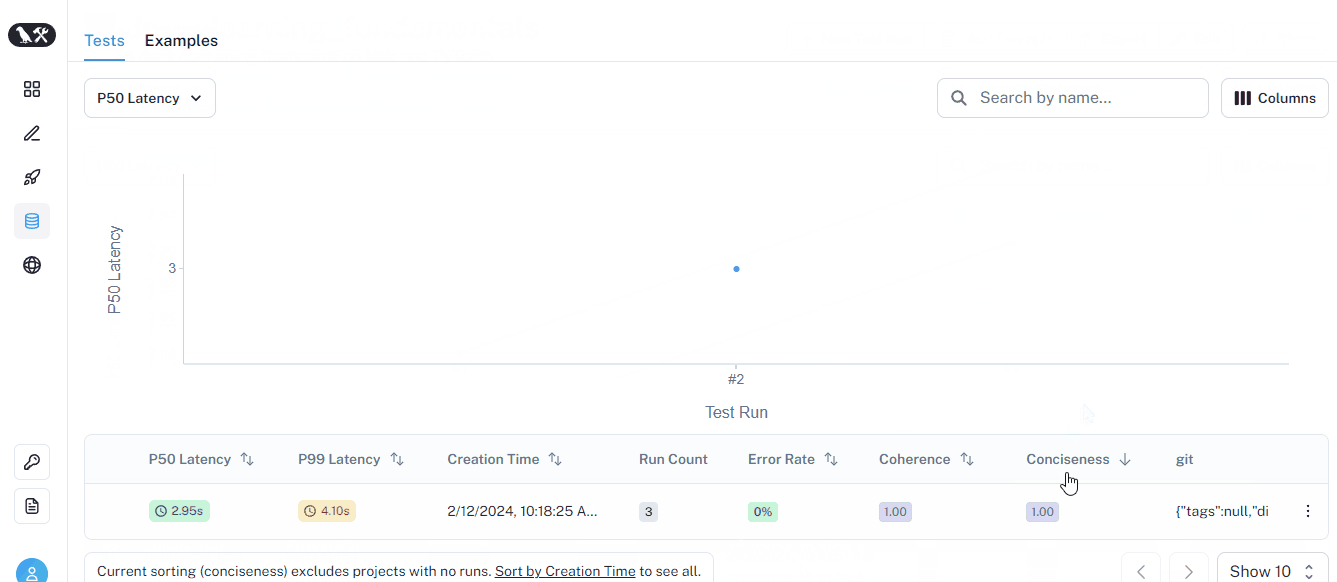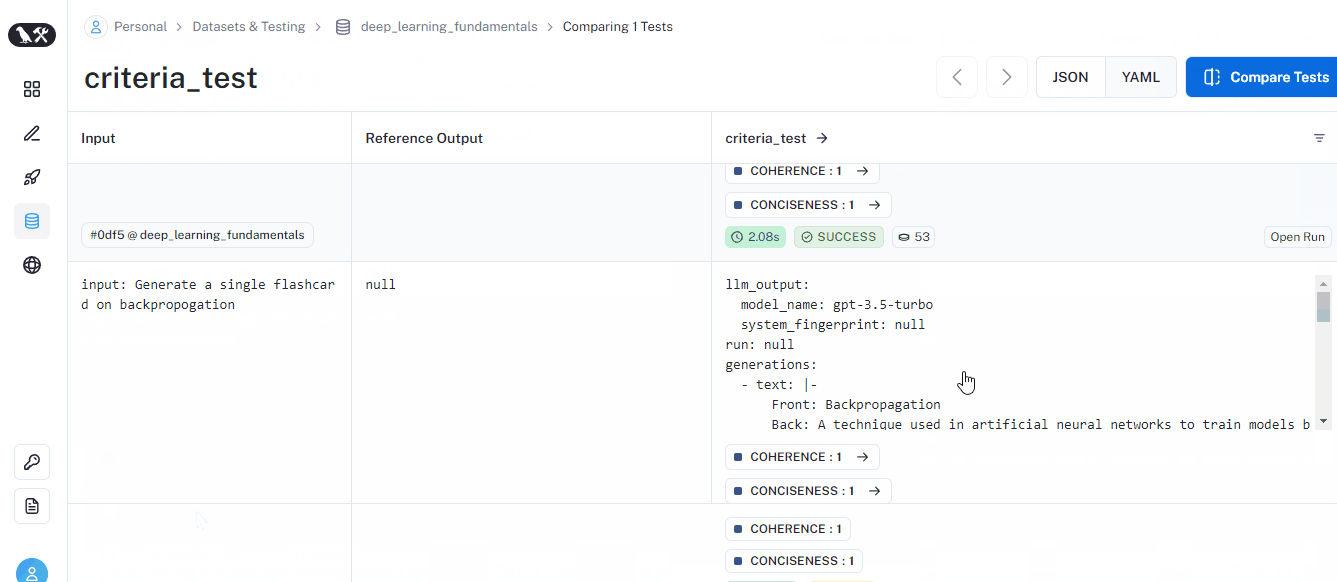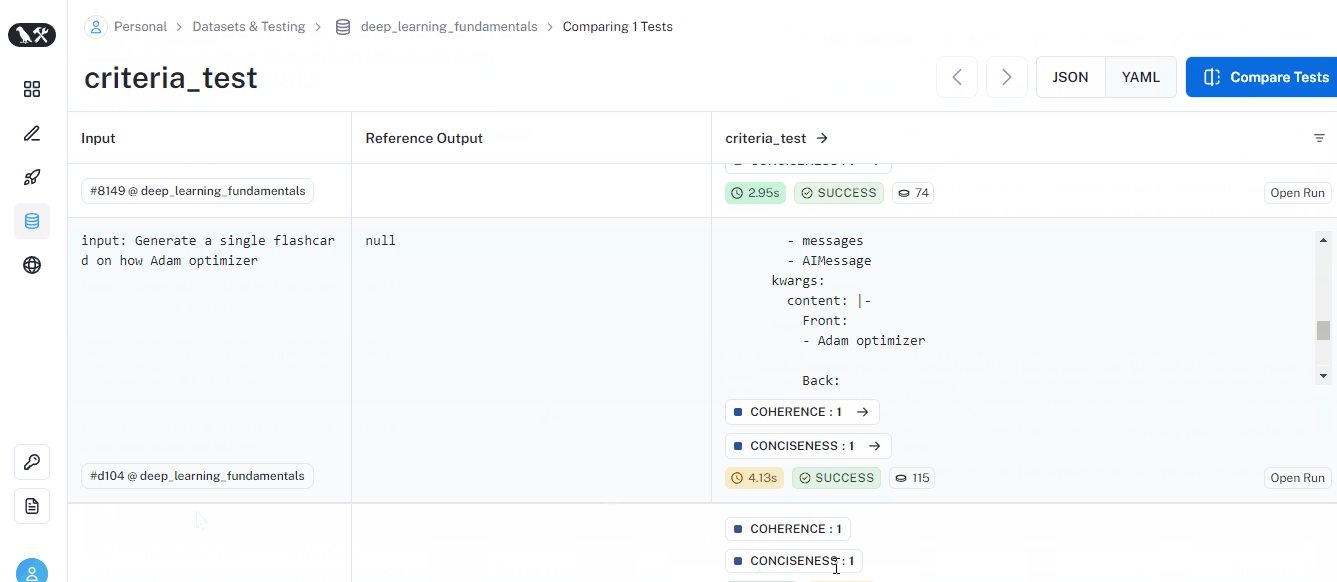
Diesmal gibt es für jeden Prompt Werte zu Kohärenz und Prägnanz. Unten siehst du außerdem einen Durchschnittswert je Metrik.
Die Liste aller integrierten Kriterien erhältst du mit folgendem Snippet:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Natürlich lassen sich nicht alle LLM-Use-Cases mit Basisevaluatoren prüfen. Zum Beispiel gibt es keinen Evaluator, der erkennt, ob eine Karteikarte eine Frage zur Codesyntax enthält. Also definieren wir ihn selbst:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Um ein benutzerdefiniertes Kriterium in natürlicher Sprache zu übergeben, reichen wir einfach {“criteria_name”: “Condition to check”} an die Klasse Criteria durch. Oben erstellen wir zwei zusätzliche Evaluatoren, sodass LangSmith zwei weitere Prompts auf die vom Dataset erzeugten Outputs anwendet:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Im Run siehst du die von uns definierten Custom-Kriterien unter jedem Prompt. Wenn du darüber hoverst, erhältst du die Begründung des LLMs danach:
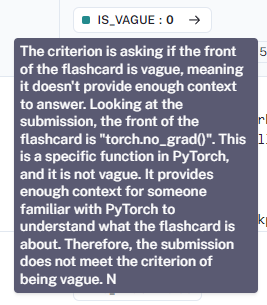
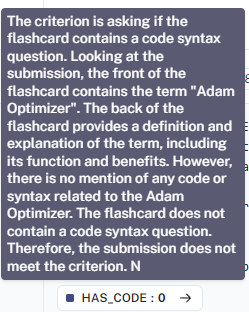
Wenn du dir die Evaluationsergebnisse über alle Prompts ansiehst, fällt auf: Unsere Kriterien bewerten noch nicht wie gewünscht. Merke: Auch deine Kriterien musst du per Prompt-Engineering so formulieren, dass sie das Richtige prüfen.
Mitunter möchtest du ein Dataset aus Prompts mit erwarteten Outputs erstellen, also ein gelabeltes Dataset. Das geht in verschiedenen Formaten, am verbreitetsten ist wohl CSV. Hier ist zum Beispiel eine Datei, die ich mit ChatGPT erzeugt habe und die fünf Fragen zur PyTorch-Syntax enthält:
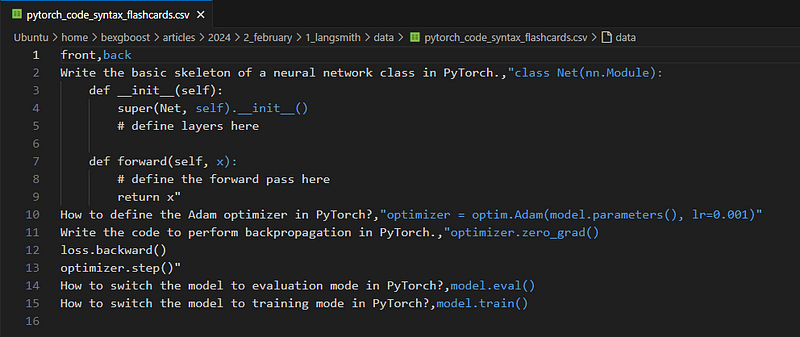
Um daraus ein Dataset zu erstellen, nutzen wir upload_csv:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
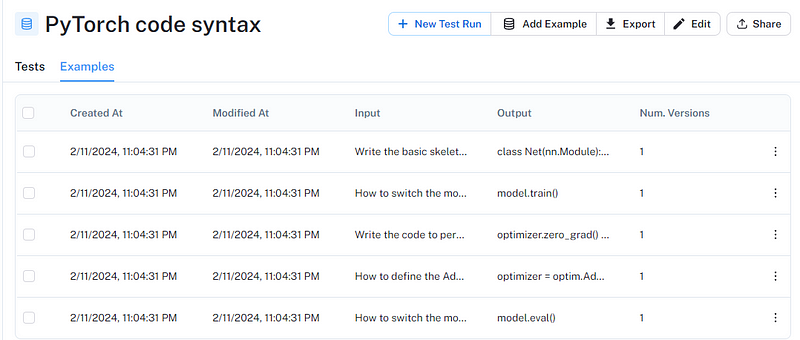
Die Funktion hat drei Pflichtparameter: den CSV-Pfad sowie die Namen der Input-/Output-Spalten. Nach dem Upload erscheint das Dataset in der UI:
Lassen wir unsere Custom-Kriterien aus dem vorherigen Abschnitt auch auf dieses Dataset laufen:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
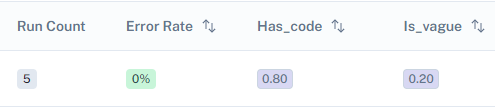
Auf der Dataset-Seite siehst du im Run die Durchschnittswerte für jedes Custom-Kriterium:
Integrierte und in natürlicher Sprache formulierte Custom-Evaluatoren sind vor allem für ungelabelte Datasets gedacht. Für gelabelte Datasets wie unsere CSV bietet LangSmith umfassendere Evaluatoren, um die Korrektheit der Antworten zu messen:
context_qa (kontextuelles Q&A): Nutzt den Beispieloutput als Kontext für die Bewertung der Korrektheitqa (Q&A): Weist das LLM an, eine Antwort mithilfe des Referenzoutputs direkt als "correct" oder "incorrect" zu bewertencot_qa (Chain-of-Thought Q&A): Ähnlich wie context_qa, zwingt das LLM aber zu Chain-of-Thought-Begründungen vor dem Urteil.Testen wir das letzte auf unseren Beispielen:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
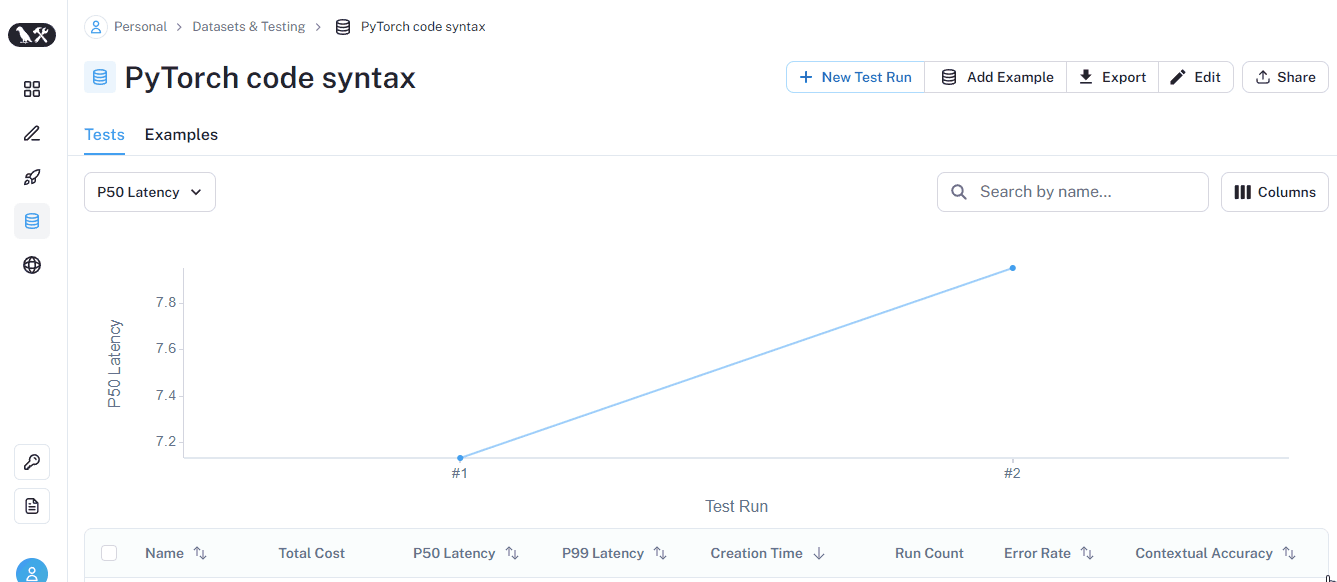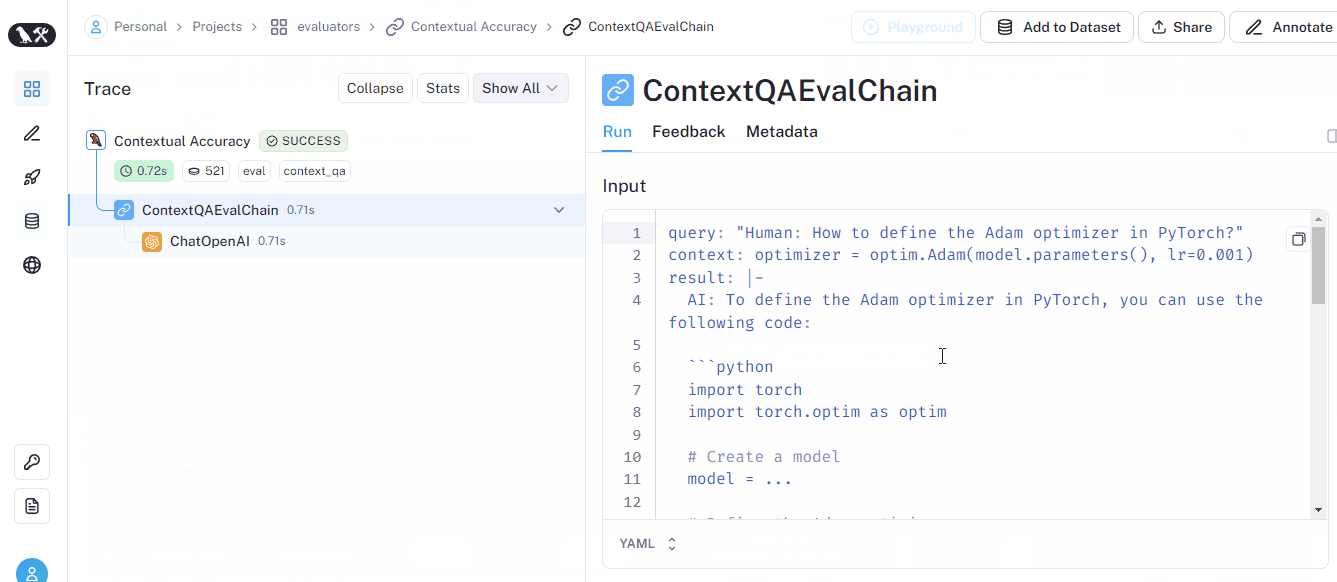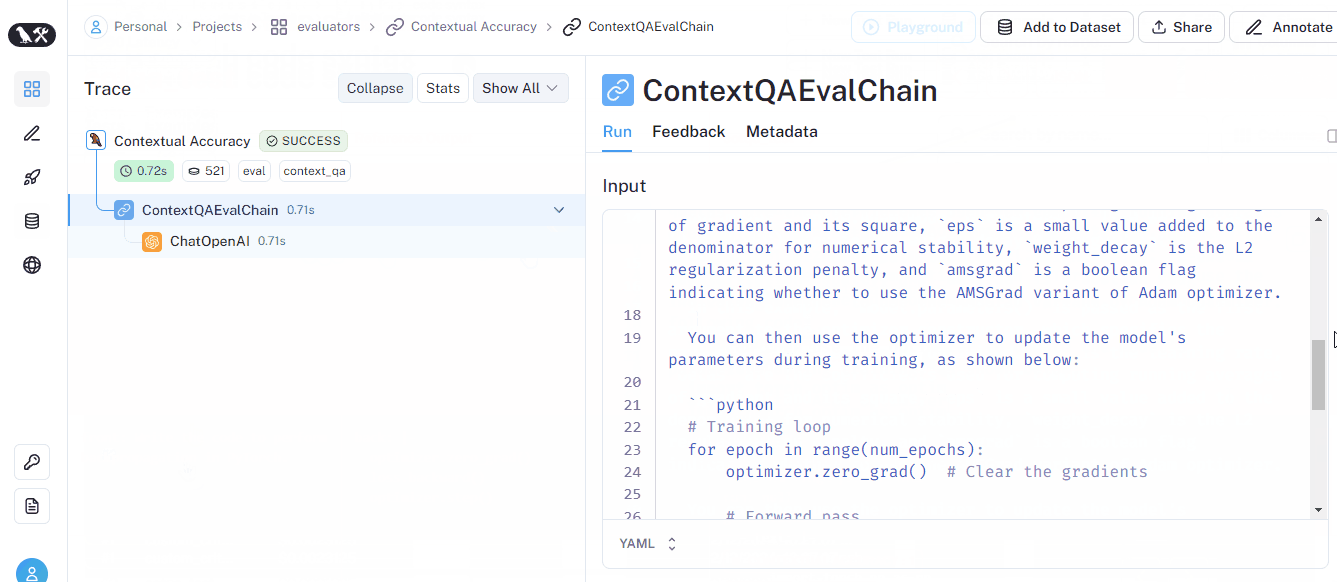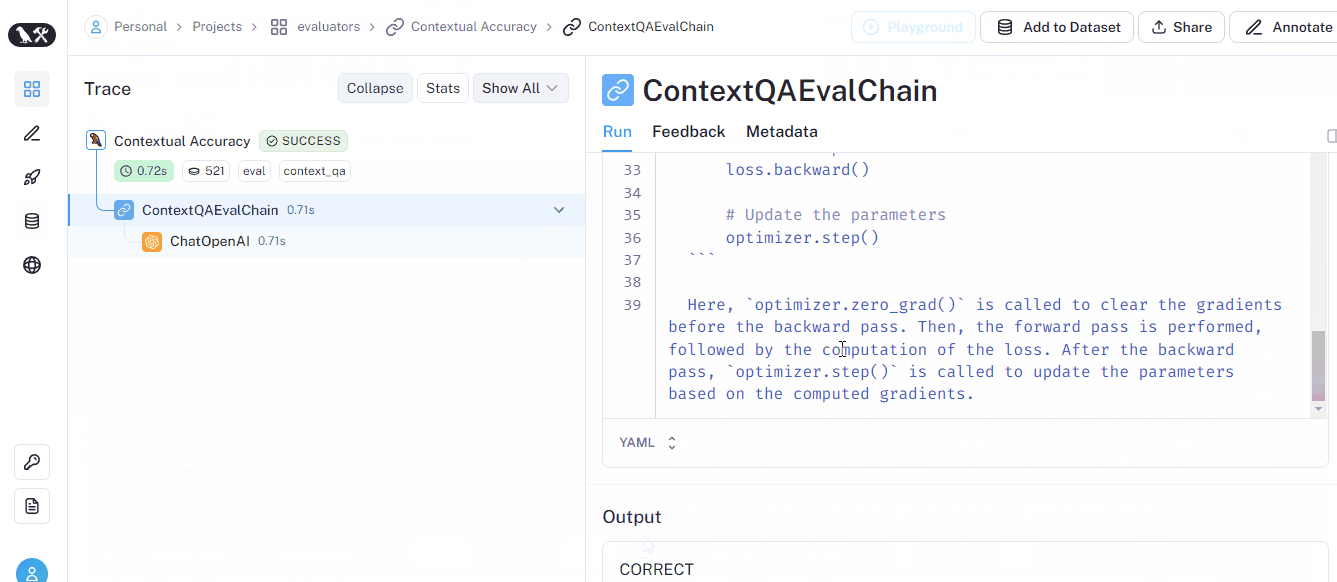
Das Kriterium CoTQA liefert einen Score namens Contextual accuracy, wie im GIF unten (und in der UI) zu sehen:
Besuche den Abschnitt LangChain evaluators in der LangSmith-Dokumentation, um noch viel mehr über Evaluatoren zu lernen.
Wenn du nach diesem Tutorial den Eindruck hast, dass LangSmith im Kern ein mächtiges Werkzeug für Prompt Engineering ist, liegst du richtig! Aktuell ist LangSmith das beste Framework, um sicherzustellen, dass Anweisungen und Ausgaben von LLMs wirklich deinen Anforderungen entsprechen.
Du hast sicher auch gesehen, wie viel Aufwand es ist, LLM-Anwendungen für den produktiven Einsatz zu bauen. Nutze LangSmith, um diesen Weg deutlich reibungsloser zu machen.
Falls dir einige Konzepte in LangSmith unklar geblieben sind, fehlen dir vielleicht noch Grundlagen in LangChain. Hier sind Ressourcen dazu:
Starte heute deine LangChain-Reise
Kurs
Kurs
Kurs
Blog
Blog
Nisha Arya Ahmed
15 Min.
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Adel Nehme
3 Min.
Tutorial
Mark Pedigo
10 Min.



