
Last chance! 50% off DataCamp Premium
Sale ends in
Onlangs vond ik een AI-platform dat automatisch flashcards genereert uit elk type media. Omdat ik dol ben op het onthouden van concepten met gespreide herhaling, uploadde ik meteen mijn XGBoost-tutorial en vroeg de AI om er 50 flashcards over te maken.
Maar ik was teleurgesteld. De meeste vragen waren te makkelijk en slechts een paar gingen over codesyntaxis. Nog vreemder: 10% van de vragen was identiek en totaal buiten de context—“Wat is de hoofdstad van Frankrijk?”.
Dit soort fouten wijst op een gebrek aan goede evaluatie en validatie van de output van AI-services. Misschien kenden ze LangSmith niet.
LangSmith is een volwaardig platform om LLM-toepassingen te testen, debuggen en evalueren. Misschien is de belangrijkste functie wel de evaluatie van LLM-output en prestatiemonitoring. In deze tutorial zien we het framework in actie en leren we technieken om het in je eigen projecten toe te passen.
Laten we beginnen!
Zoals ik hierboven al noemde, is LangSmith een compleet platform voor het evalueren van toepassingen met grote taalmodellen. Hier zijn enkele functies en de tastbare voordelen in de praktijk:
Programmeurs kunnen binnen minuten, niet uren, met LangSmith experimenteren. Dit betekent dat een klein team of solodeveloper in een weekend een AI-toepassing kan prototypen en die op maandag als betaalde service kan lanceren.
Met strenge evaluatietools kunnen bedrijven de schaamte en kosten van gebrekkige AI-releases vermijden (zoals in het voorbeeld uit de inleiding). LangSmith laat je de output van LLM’s toetsen aan ingebouwde criteria zoals behulpzaamheid, coherentie, misogynie, of zelfs aangepaste evaluaties in natuurlijke taal zoals “Is de inhoud van de output cliché?” of, in het geval van flashcards genereren, “Bevat de kaart een codevraag?”.
LangSmith gebruikt traces om bijna elk aspect van LLM-runs te loggen. Denk aan metrics zoals latentie, aantal tokens, kosten per run en allerlei metadata. De web-UI laat je snel runs filteren op foutpercentage, latentie, datum of zelfs op tekstinhoud met natuurlijke taal. Dit betekent dat je, als bijvoorbeeld een AI-tutor begint te haperen in antwoorden aan echte studenten, binnen een paar uur een fix kunt uitrollen.
LangChain is het moederframework van LangSmith en richt zich specifiek op de ontwikkelfase van LLM’s. Het biedt een modulaire software-architectuur om meerdere LLM’s (agents) te chainen en ze te integreren met andere API’s zoals YouTube, Google Search, enzovoort. LangSmith is de kers op de taart die ervoor zorgt dat prototypes gebouwd met LangChain presteren zoals verwacht, dankzij krachtige evaluatie- en monitoringtools.
Bekijk onze LLM-toepassingen met LangChain-tutorial om meer te leren over LangChain.
Een andere sterke functie van LangSmith zijn datasets. Hiermee kun je LangChain-chains, agents of modellen verbeteren aan de hand van een set gestandaardiseerde voorbeelden vóór uitrol. Zo kan je bijvoorbeeld een CSV-bestand hebben met twee kolommen—vragen en antwoorden voor flashcards in een specifiek formaat.
Door dit bestand om te zetten naar een referentiedataset kunnen we LLM’s hun eigen output laten evalueren met de eerder genoemde kwaliteitscriteria.
We gaan al deze functies nu één voor één met voorbeelden bekijken.
Bij ML-appontwikkeling verzamel je data, train je, fine-tune je, test je en rol je modellen uit—de stappen zijn helder gedefinieerd. Bij LLM-apps begin je vaak met een kant-en-klaar model van een aanbieder. Fine-tunen? Dat kan duur zijn. Dus focus je sterk op het maken van de juiste prompts—het draait om je LLM-app de juiste vragen stellen. Zie het als: je hebt veel prompts nodig om te testen, net zoals je veel data nodig hebt voor een goed ML-model.
Maar met prompts werk je met tekst in en uit, geen getallen. Klassieke fout- of nauwkeurigheidsmaten zoals MSE of cross-entropy werken hier dus niet. En stel je voor dat je elke input en output moet lezen voor evaluatie—dat kost dagen als je duizenden prompts hebt.
Je hebt dus een workflow nodig die draait om het efficiënt maken en testen van prompts om te zien hoe goed je LLM-app het doet, zonder te verdrinken in handmatige checks. Zo kan dat eruitzien:
In deze fase prototype je de fundering van je applicatie met frameworks zoals LangChain. Voor een flashcardgenerator kan je prototype meerdere componenten bevatten bovenop je gekozen LLM van een aanbieder. Je zou het bijvoorbeeld kunnen chainen met:
enzovoort (bekijk welke componenten je kunt toevoegen op deze pagina van de LangChain-docs). Maar je kunt je ontwikkeltijd drastisch verkorten door kant-en-klare chains van LangChain te gebruiken voor veelvoorkomende, hogere-orde taken.
In deze fase test je je applicatie tegen zoveel mogelijk scenario’s. Je moet ervoor zorgen dat elke toegevoegde component goed werkt, goed samenwerkt in de chain en consistente, hoogwaardige output produceert.
Omdat LLM’s niet-deterministisch zijn (ze genereren niet steeds dezelfde output voor dezelfde input) en door de complexiteit van extra componenten, zal je de meeste tijd in deze fase besteden. En LangSmith is ontwikkeld met het doel om die tijd zo kort mogelijk te maken. We gaan dit verder bespreken in de tutorial.
Zodra je een bruikbare applicatie hebt, kun je die als een REST API uitrollen. Een REST API zet je bestaande LangChain-chains of agents om in HTTPS-links waar anderen verzoeken naartoe kunnen sturen om met je AI-model te interageren. Nu bouw je de gebruikersinterface van je service, zoals een desktopapp of, vaker, een website.
Momenteel is er geen makkelijke manier om dit te doen, maar de ontwikkelaars van LangChain staan op het punt LangServe uit te brengen, geïntegreerd met FastAPI (hoe gaaf zou dat zijn?). Bekijk alvast de sneak peek op deze pagina van de documentatie.
Laten we nu eindelijk met LangSmith gaan spelen.
We beginnen met de web-UI begrijpen. Die is beschikbaar via de link smith.langchain.com. Voor toegang moet je je aanmelden en van de wachtlijst worden gehaald, want het zit momenteel in gesloten bèta.
Maar eenmaal binnen ziet de landingspagina er zo uit:
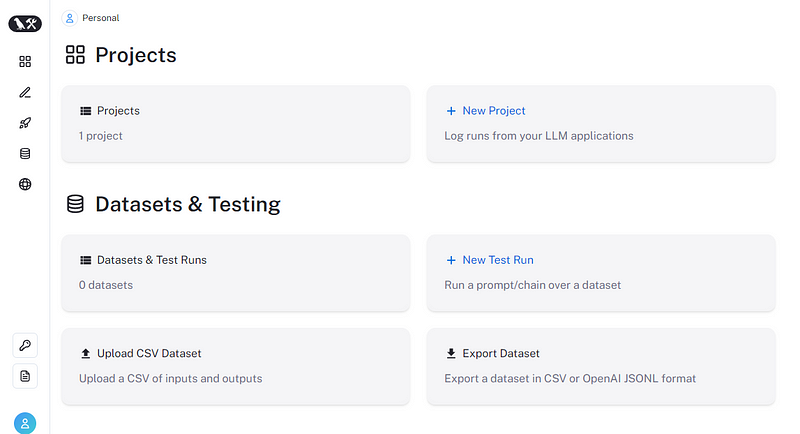
De twee hoofdsecties zijn projects en datasets & testing, en beide secties zijn te beheren via de Python-SDK. Het platform heeft ook tabs voor deployment en annotation queues, maar die vallen buiten de scope van dit artikel.
Projecten beheren in LangSmith gaat veel makkelijker met de Python-SDK, die via een API-sleutel met het platform is verbonden.
Om een sleutel te krijgen, klik je op het sleutelpictogram in het platform en sla je die veilig op. Maak vervolgens, in een nieuwe map met een nieuwe virtual environment, een .env-bestand aan. Plak hierin de volgende twee regels:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Voer daarna in je terminal de volgende commando’s uit om LangSmith en python-dotenv te installeren om omgevingsvariabelen te lezen:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Tijd om code te schrijven:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
We importeren de functies find_dotenv en load_dotenv om omgevingsvariabelen te lezen en zetten ze op met os:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Door LANGCHAIN_TRACING_V2 op True te zetten, schakel je tracing (logging) in, wat essentieel is voor het debuggen van LLM’s. Vervolgens initialiseren we een client om met het LangSmith-platform te praten:
from langsmith import Client

# Initialize a client
client = Client()
client bevat high-level commando’s om projecten en assets in LangSmith te beheren. Het eerste commando dat we gebruiken is het maken van een nieuw project:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
Na een geslaagde create_project-run, zie je het project in de sectie Projects van de web-UI:
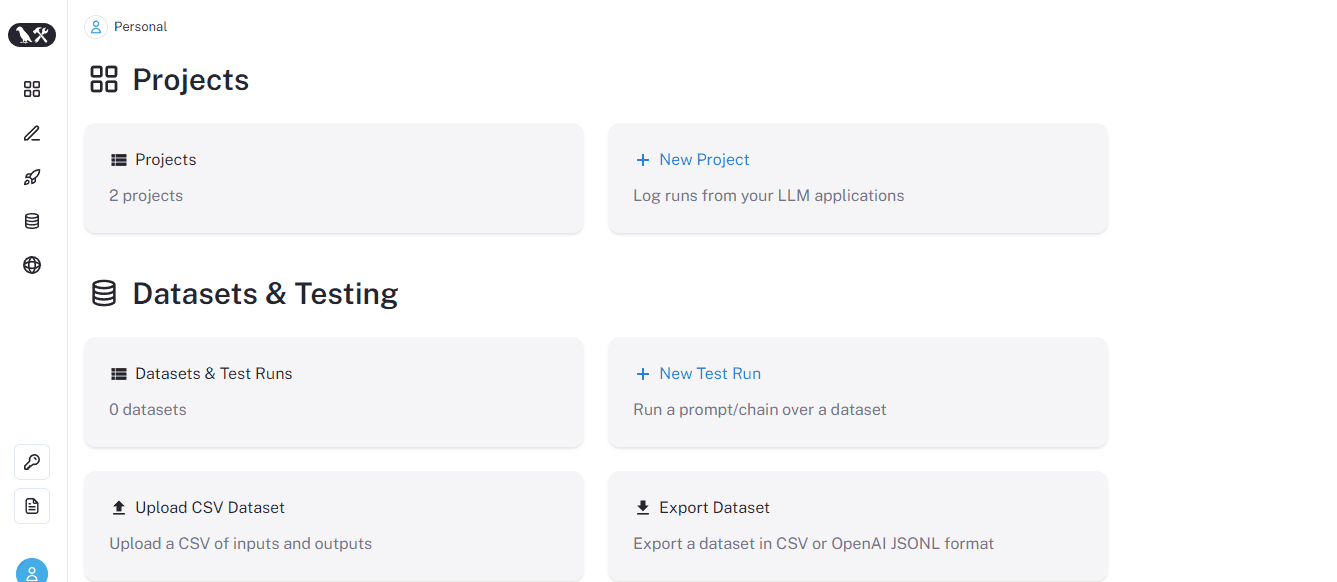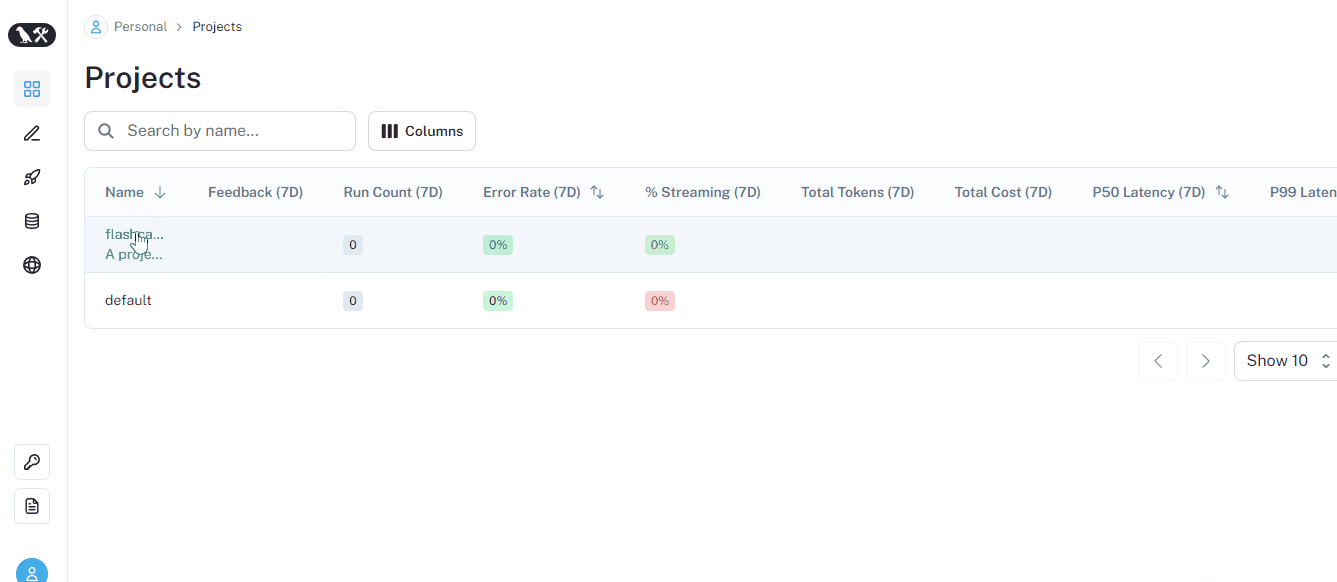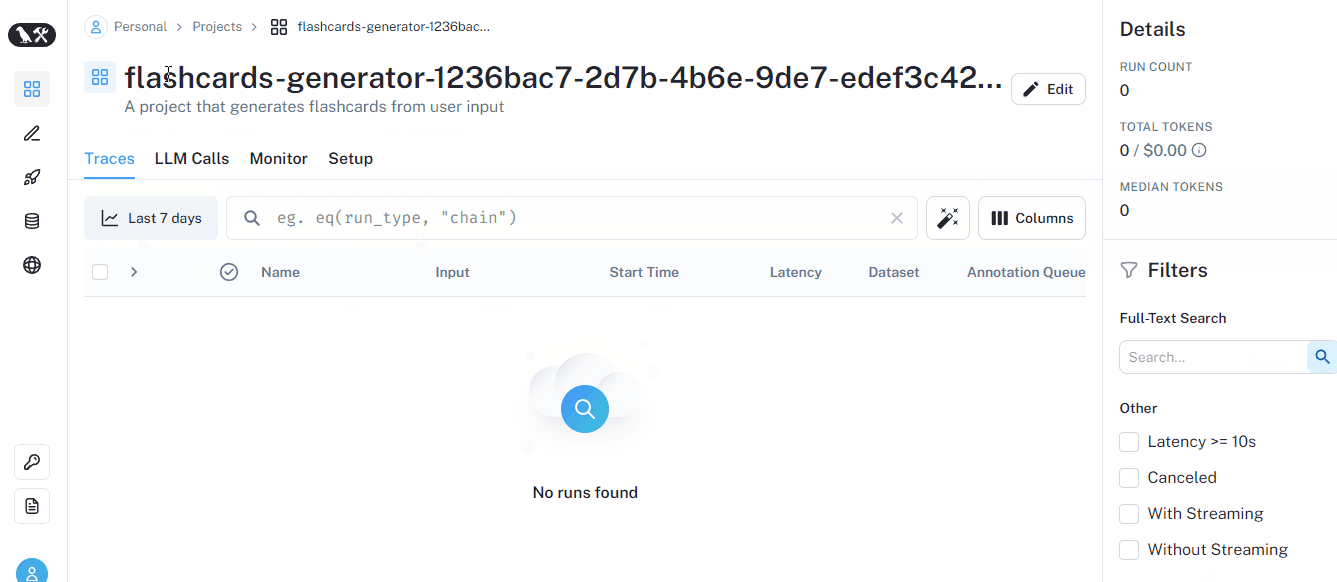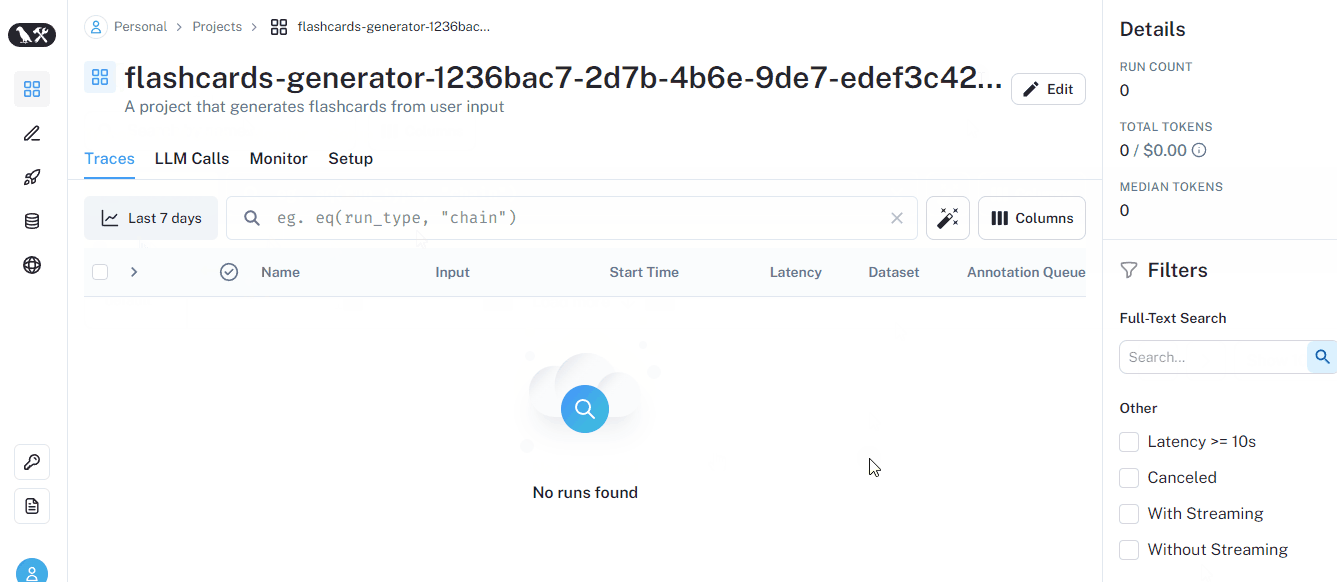
Vervolgens moeten we het nieuwe project als standaard instellen met nog een omgevingsvariabele:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Nu hebben we een LLM nodig voor ons project. We kiezen voor GPT-3.5 turbo omdat die goedkoper is, maar je kunt veel andere modellen gebruiken via langchain. OpenAI-modellen worden geïnitialiseerd met de klasse ChatOpenAI.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Laten we onze eerste run doen:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
Als je het project snel in de UI bekijkt, zie je dat de bovenstaande run is getraced (gelogd):
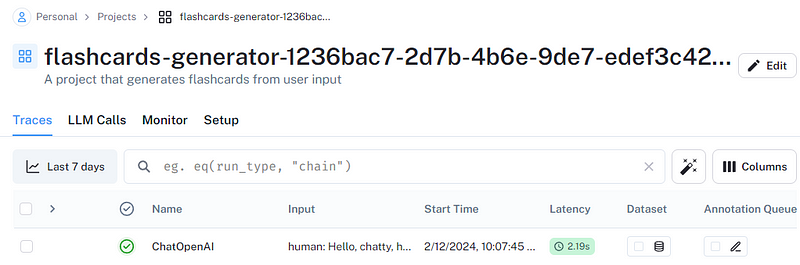
Door de omgevingsvariabelen en de client in te stellen, hebben we automatisch logging ingeschakeld. Zoals je ziet, hebben we al een hoop metadata over de run.
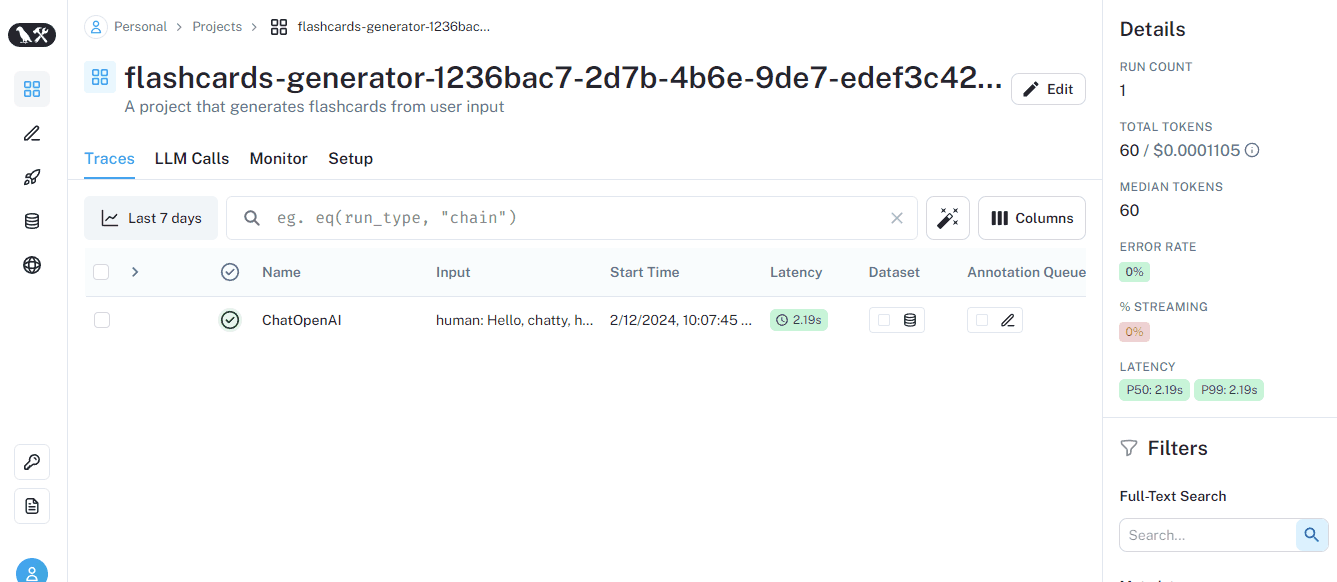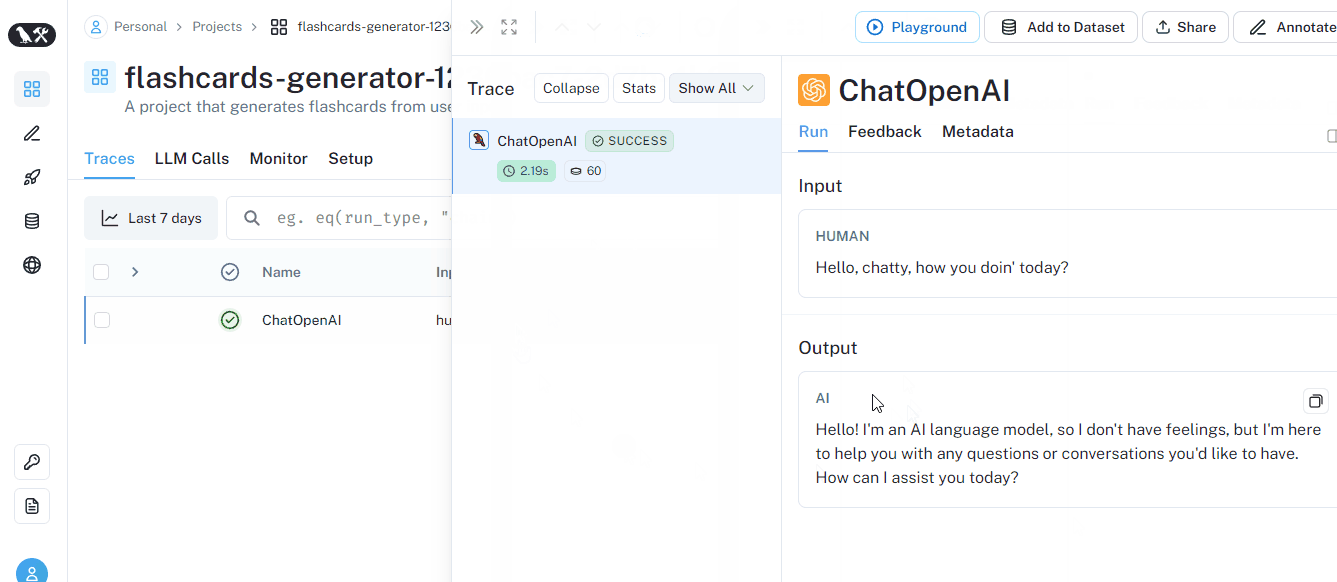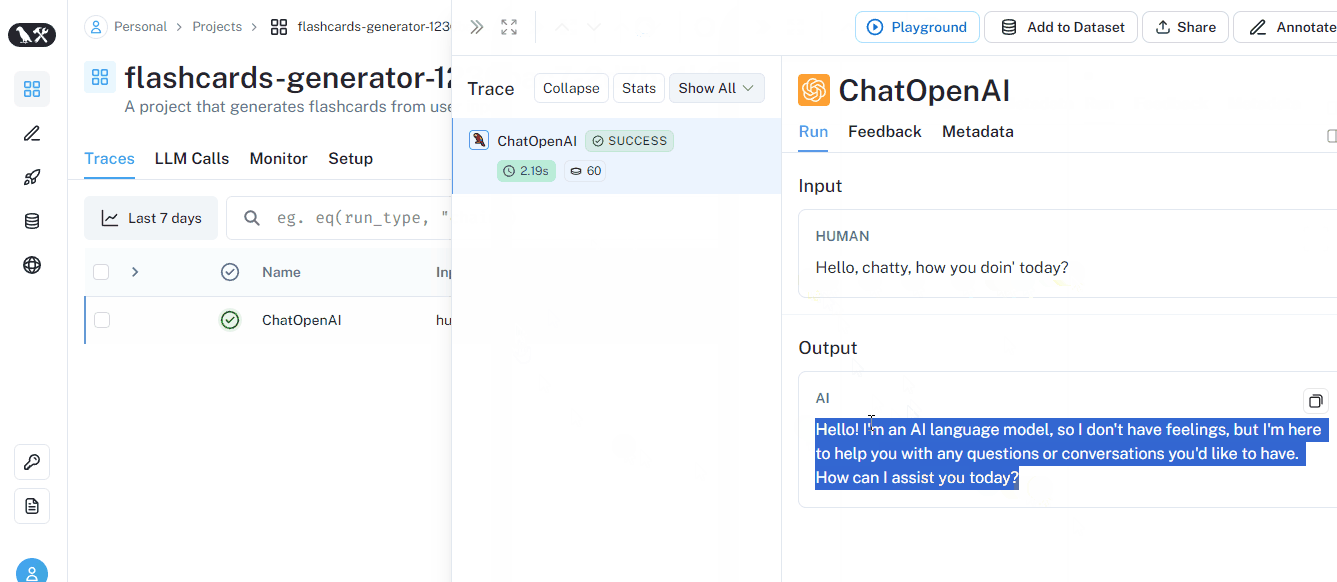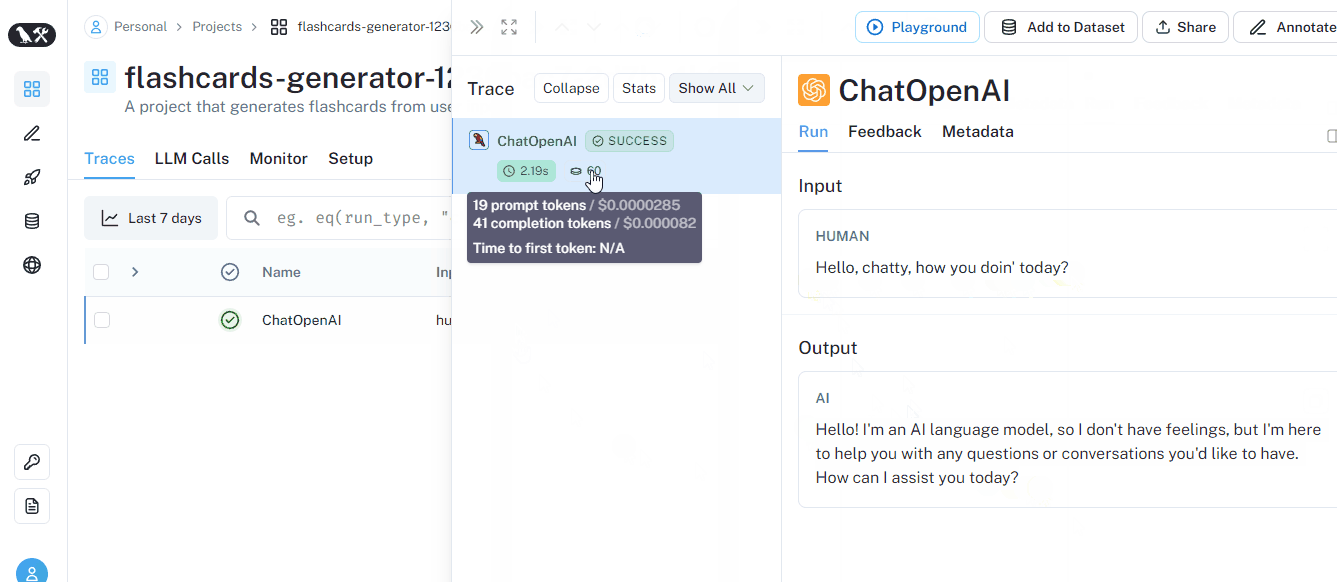
Laten we nog een paar prompts runnen:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
We kunnen nu al een eenvoudige tekstsamenvatter bouwen. Laten we de output van de laatste run samenvatten:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Mooi, tijd om onze eerste dataset te maken.
Zoals ik in de sectie “Workflow voor LLM-applicatieontwikkeling” noemde, zul je waarschijnlijk duizenden prompts moeten maken of verzamelen om je LLM-model, chain of agent te evalueren. Die één voor één draaien zoals we hierboven deden, is geen best practice.
Daarom biedt LangSmith drie typen datasets:
kv) - standaard: definieert inputs als willekeurige key-value-paren. Handig bij het evalueren van chains en agents die meerdere inputs nodig hebben of meerdere outputs teruggeven.llm): inputs en outputs zijn gedefinieerd in “completion-stijl” door LLM’s—string in, string uit.chat): dit zijn datasets geconverteerd uit LLM-chats en gedefinieerd met gestructureerde inputs en geserialiseerde berichten.Laten we eerst zien hoe je een key-value-dataset maakt zonder outputs. We gebruiken de functie create_dataset van de client:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Nu voegen we drie inputs toe die elk de LLM vragen om één flashcard te maken:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
Als je naar het dataset-tabblad van de UI gaat, zie je elke prompt met NULL als output:
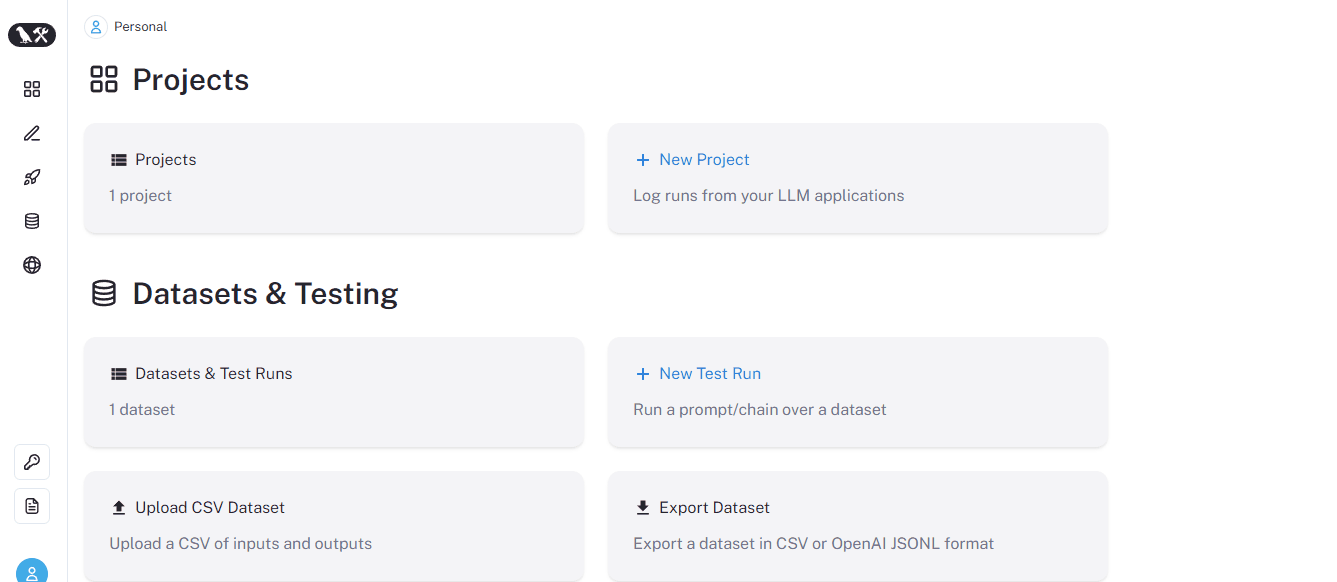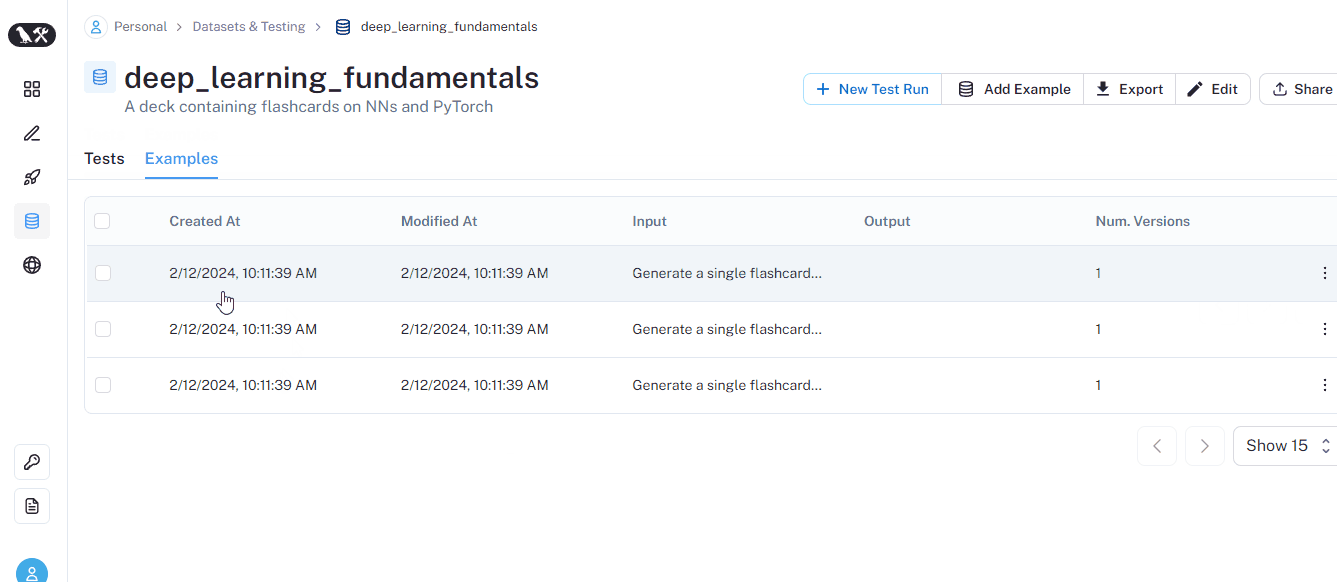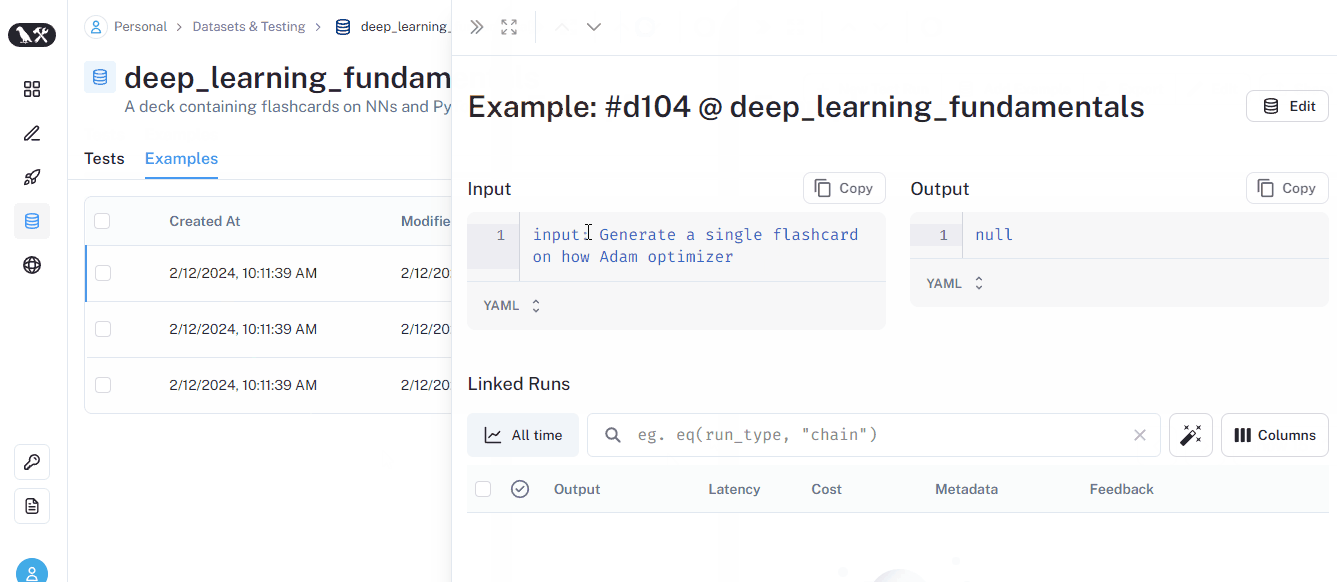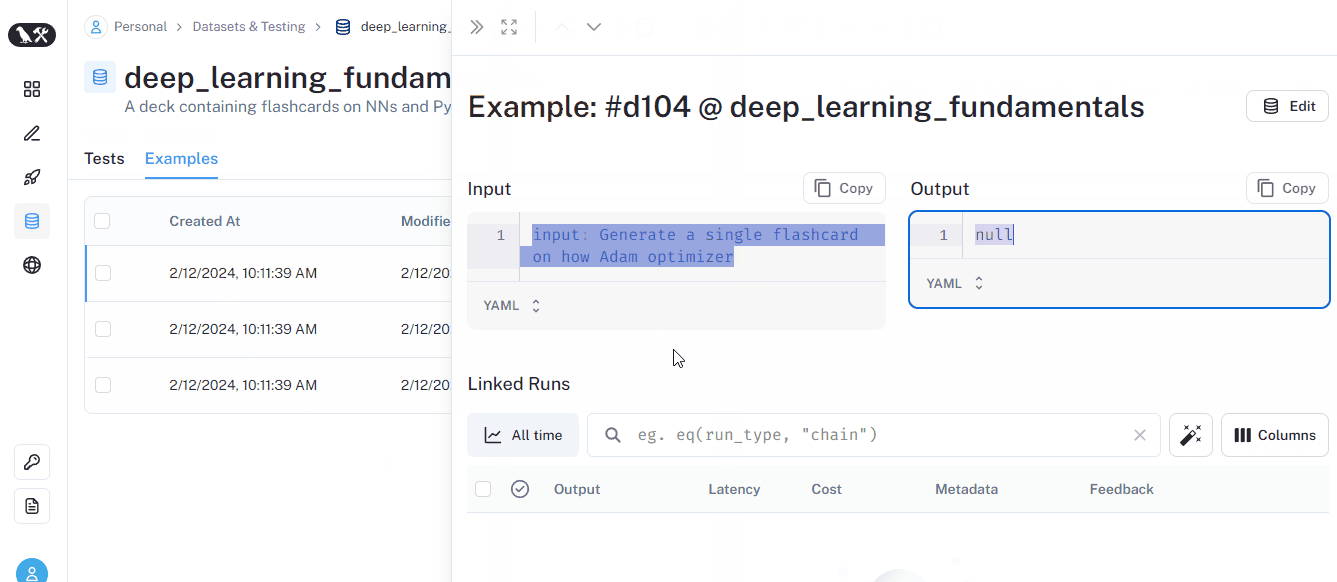
Laten we nu alle prompts in één regel code uitvoeren met de functie run_on_dataset:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Zodra de run klaar is, verschijnt die op de datasetpagina. Zo ziet het eruit:
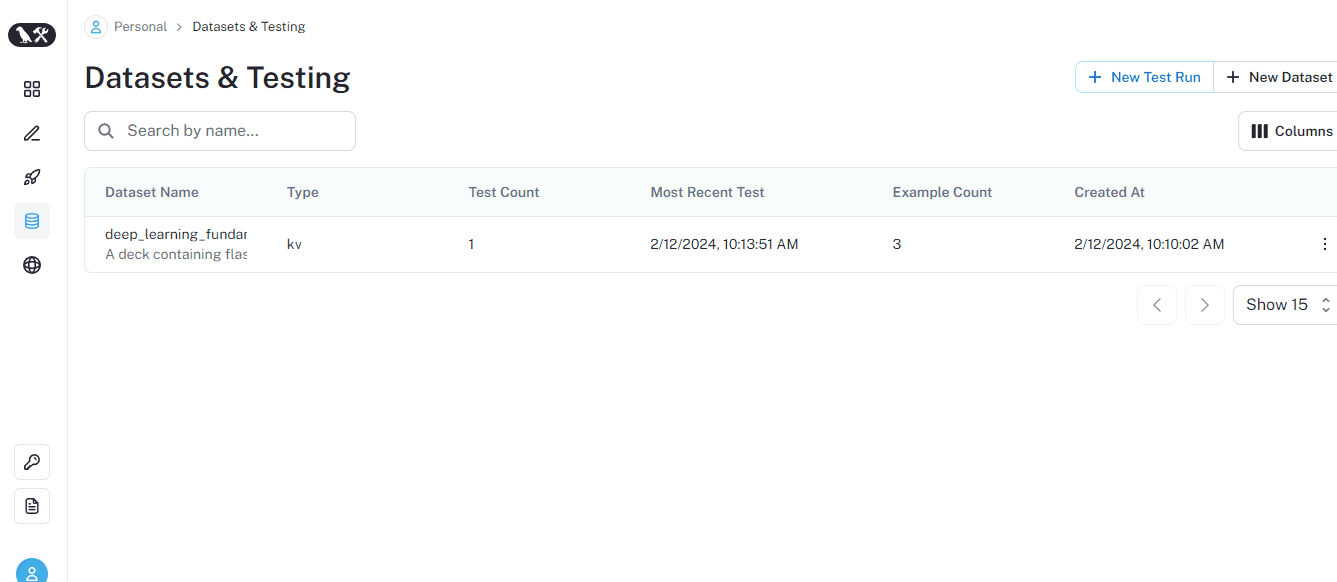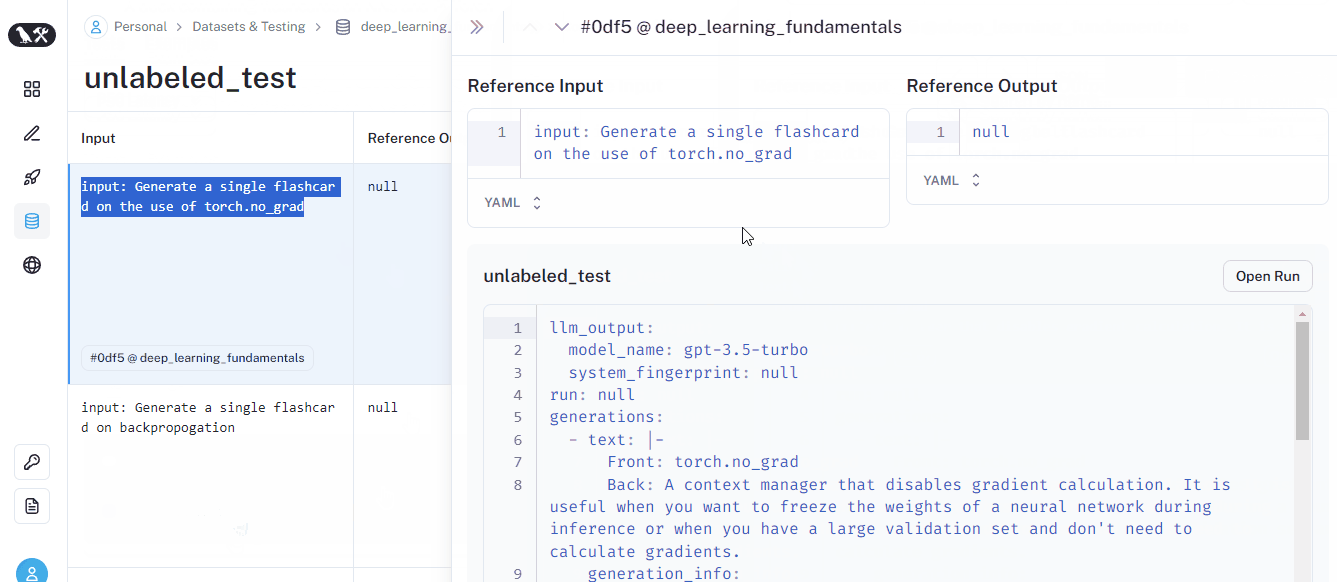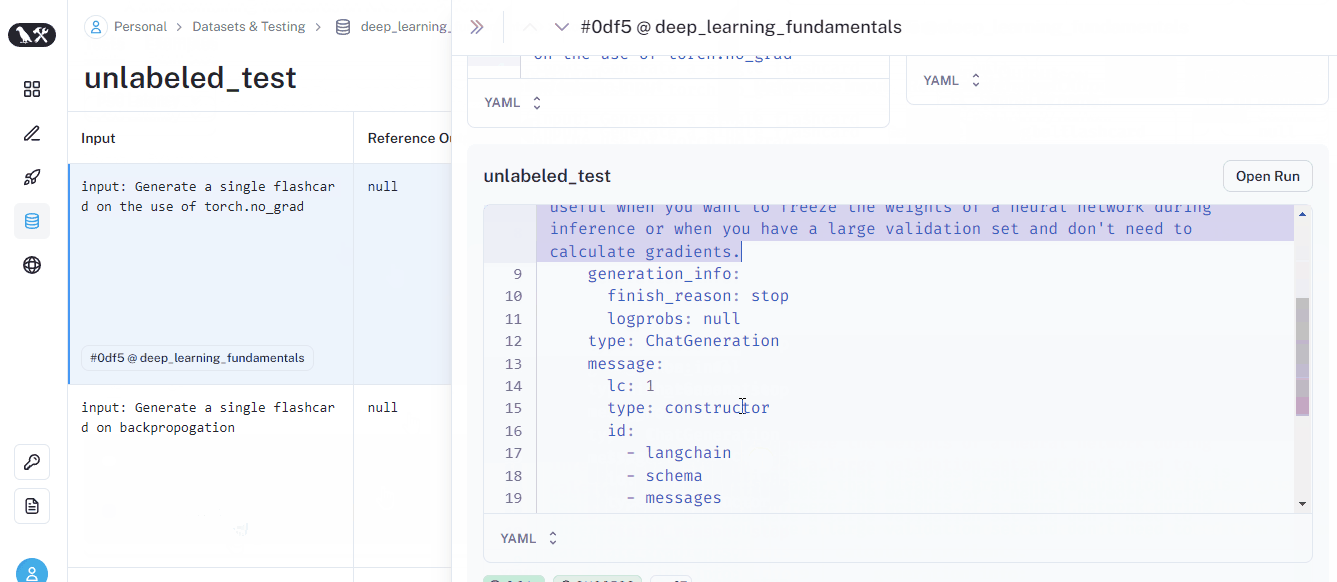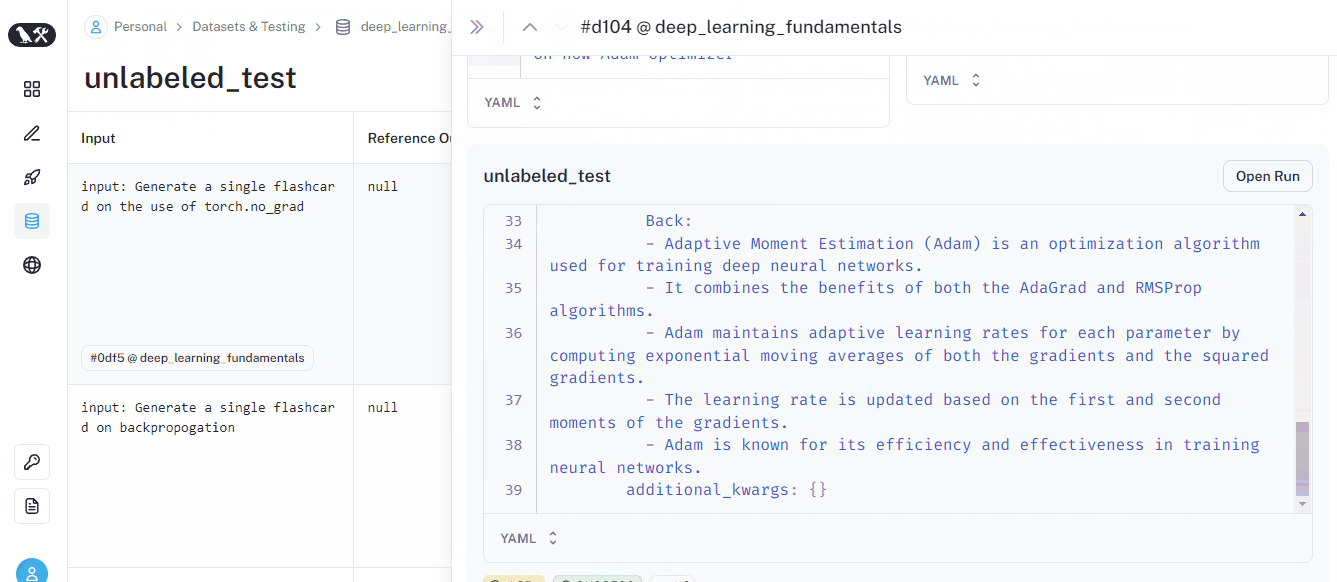
We hebben net een testrun gedaan op een ongetagde dataset—een dataset met voorbeeldprompts maar zonder voorbeeldoutputs. Onze test produceerde simpelweg een antwoord op elke prompt, maar evalueerde niets. We willen echter basischecks doen zoals “Is de output behulpzaam?” of “Is het antwoord kort of lang?”
LangSmith laat ons zulke checks uitvoeren met ingebouwde evaluators.
Om een conciseness- en coherence-evaluatie te draaien met de drie prompts in onze dataset, kunnen we de klasse RunEvalConfig gebruiken:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Hierboven definiëren we twee criteria in een lijst genaamd evaluators. We geven deze evaluators mee aan de parameter evaluation van de functie run_on_dataset:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset is een handige functie om alle prompts in een dataset te runnen met de opgegeven LLM en elke soort evaluatie on-the-fly uit te voeren. De resultaten zijn zichtbaar op de eigen pagina van elke dataset:
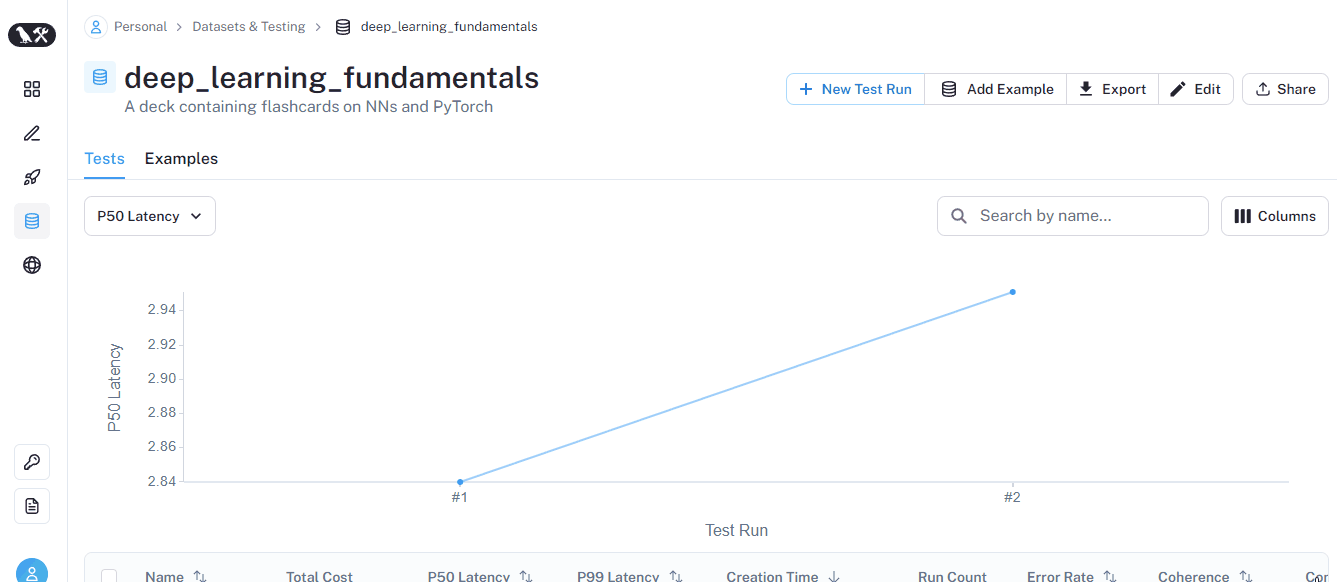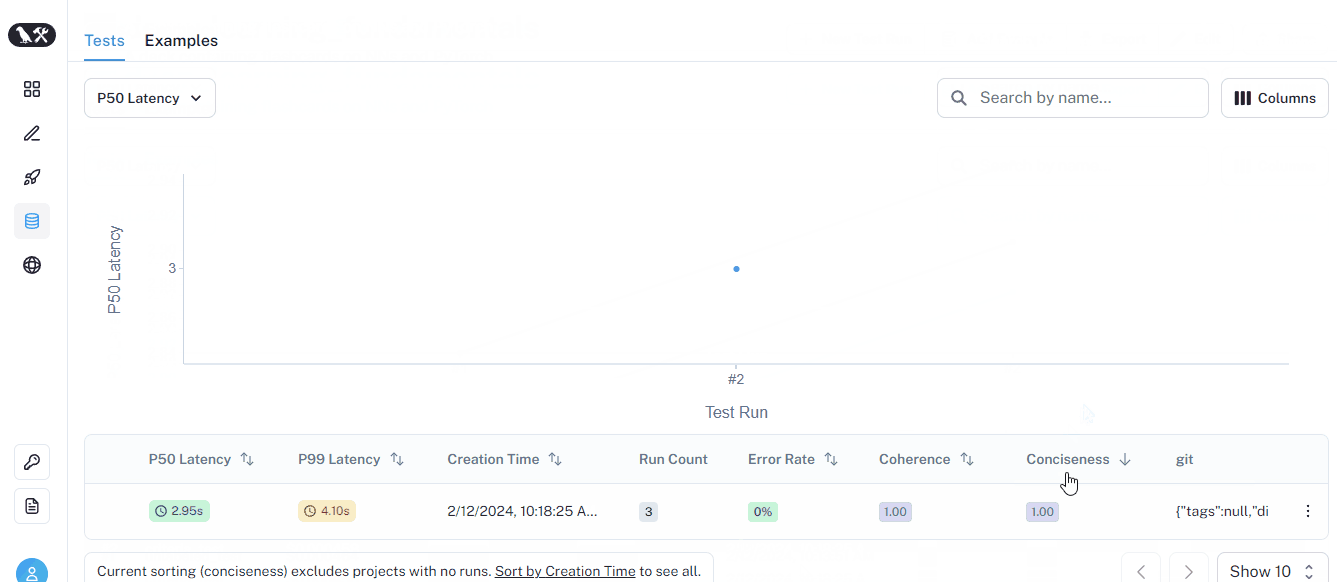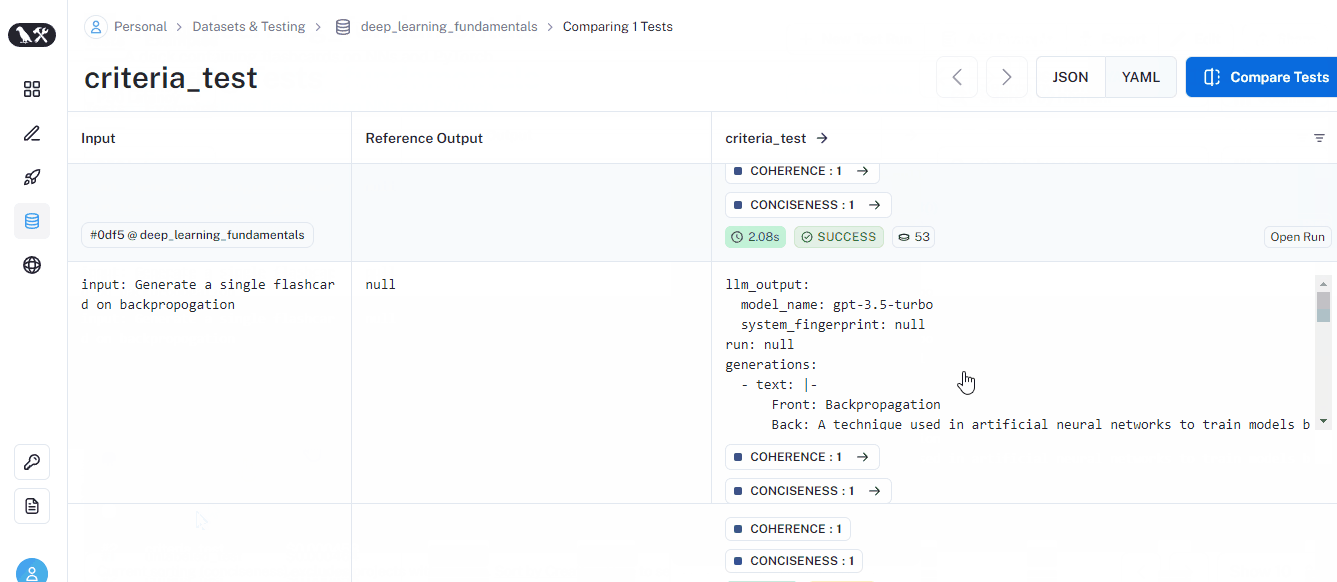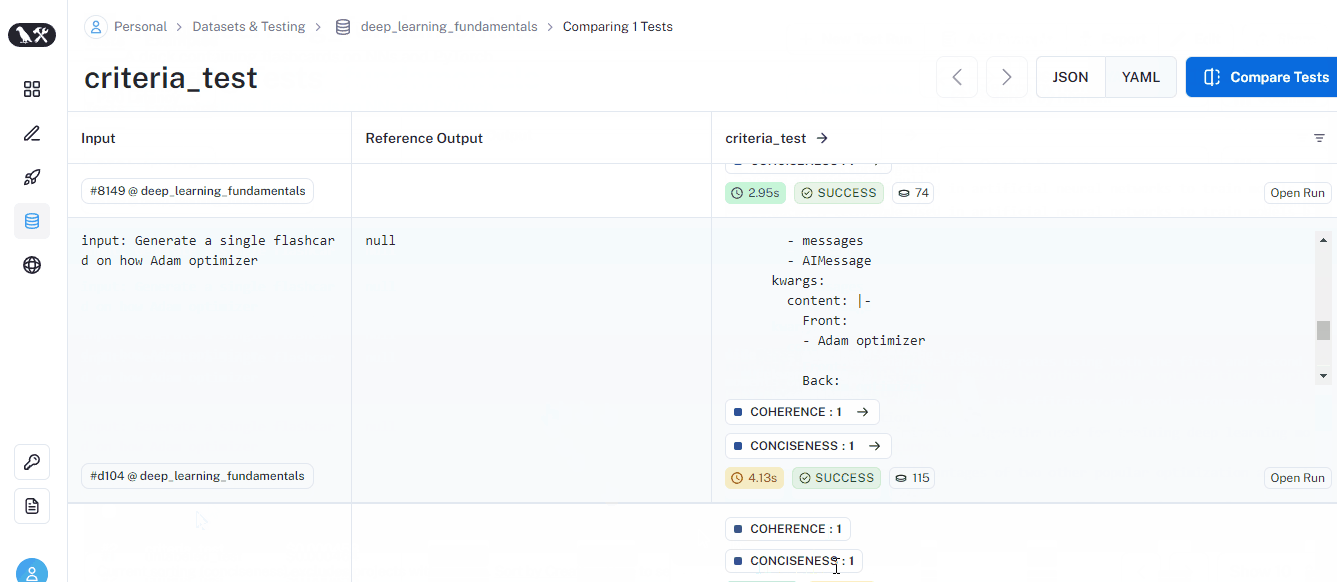
Deze keer heeft de run coherentie- en bondigheidsmetrics voor elke prompt. Onderaan zie je ook een gemiddelde score per metric.
Om de lijst met alle ingebouwde criteria te zien, voer je onderstaande snippet uit:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Niet alle LLM-usecases zijn natuurlijk met basisevaluators te controleren. Er is bijvoorbeeld geen evaluator die checkt of een flashcard een codevraag bevat. Dus definiëren we die zelf:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Om een aangepast criterium in natuurlijke taal mee te geven, geven we simpelweg {“criteria_name”: “Voorwaarde om te checken”} door aan de klasse Criteria. Hierboven maken we twee extra evaluators, dus LangSmith zal twee extra prompts draaien bovenop de output die door de prompts in onze dataset is geproduceerd:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Als je de run bekijkt, zie je de aangepaste criteria die we hebben gedefinieerd onder elke prompt. Als je erover hovert, krijg je de redenering van de LLM te zien daarna:
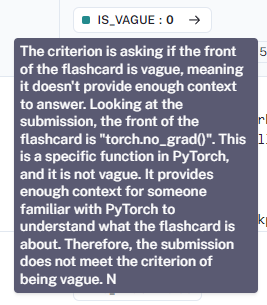
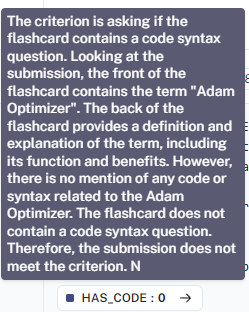
Als je de evaluatieresultaten voor alle prompts bekijkt, zie je dat onze criteria niet evalueren zoals verwacht. Iets om rekening mee te houden dus: je moet ook je criteria prompt-engineeren om zeker te zijn dat ze het juiste toetsen.
Soms besluit je een dataset met prompts en verwachte outputs te maken, oftewel getagde datasets. Je kunt getagde datasets in verschillende formaten maken, maar de meest gebruikte is wellicht een CSV-bestand. Hier is bijvoorbeeld een bestand dat ik met ChatGPT heb gegenereerd en dat vijf vragen over PyTorch-syntaxis bevat:
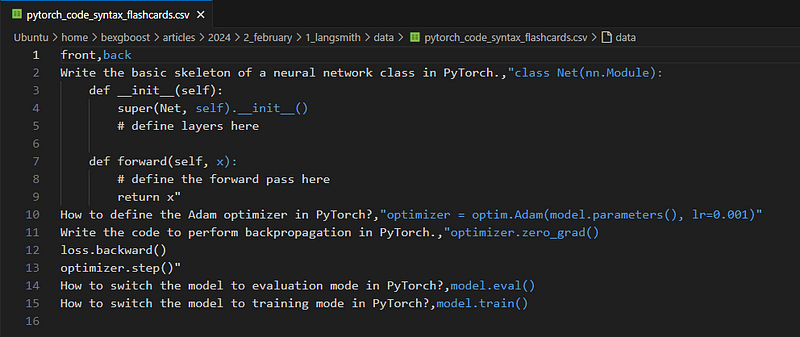
Om hiervan een dataset te maken gebruiken we de functie upload_csv:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
De functie heeft drie vereiste parameters: het CSV-pad en de namen van input-/outputkolommen. Zodra de upload klaar is, verschijnt de dataset in de UI:
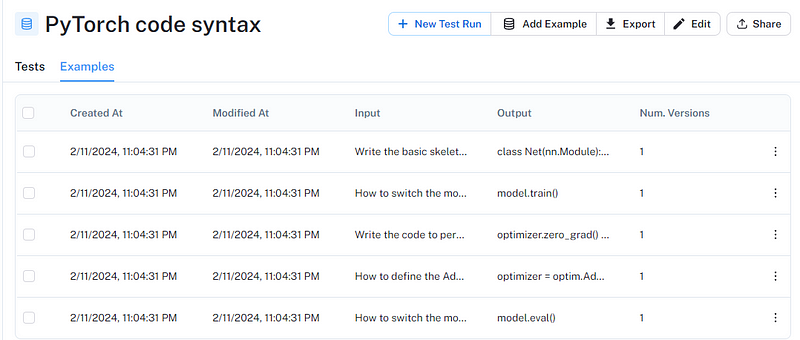
Laten we ons aangepaste criterium uit de vorige sectie ook op deze dataset draaien:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
Als je naar de datasetpagina gaat en de run bekijkt, zie je de gemiddelde scores voor elk aangepast criterium:
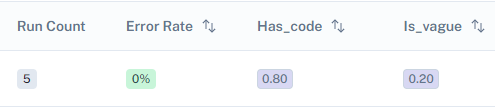
Ingebouwde en aangepaste evaluators in natuurlijke taal zijn vooral bedoeld voor ongetagde datasets. Voor getagde datasets, zoals de CSV-dataset die we hebben geüpload, biedt LangSmith uitgebreidere evaluators om de juistheid van het antwoord op een prompt te meten:
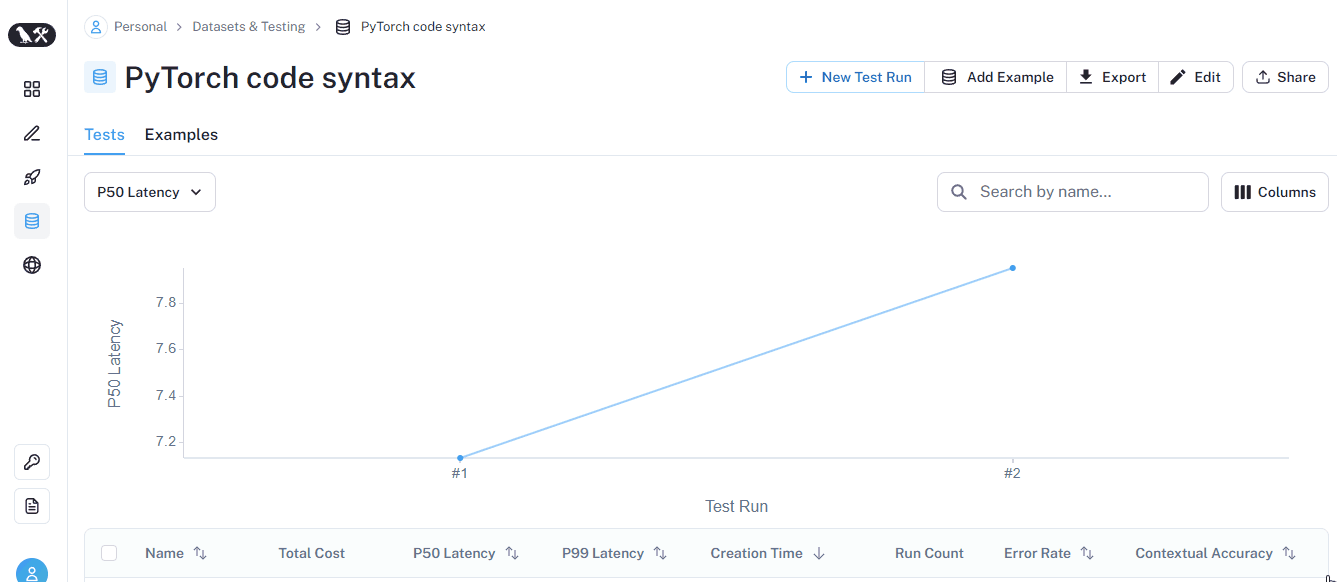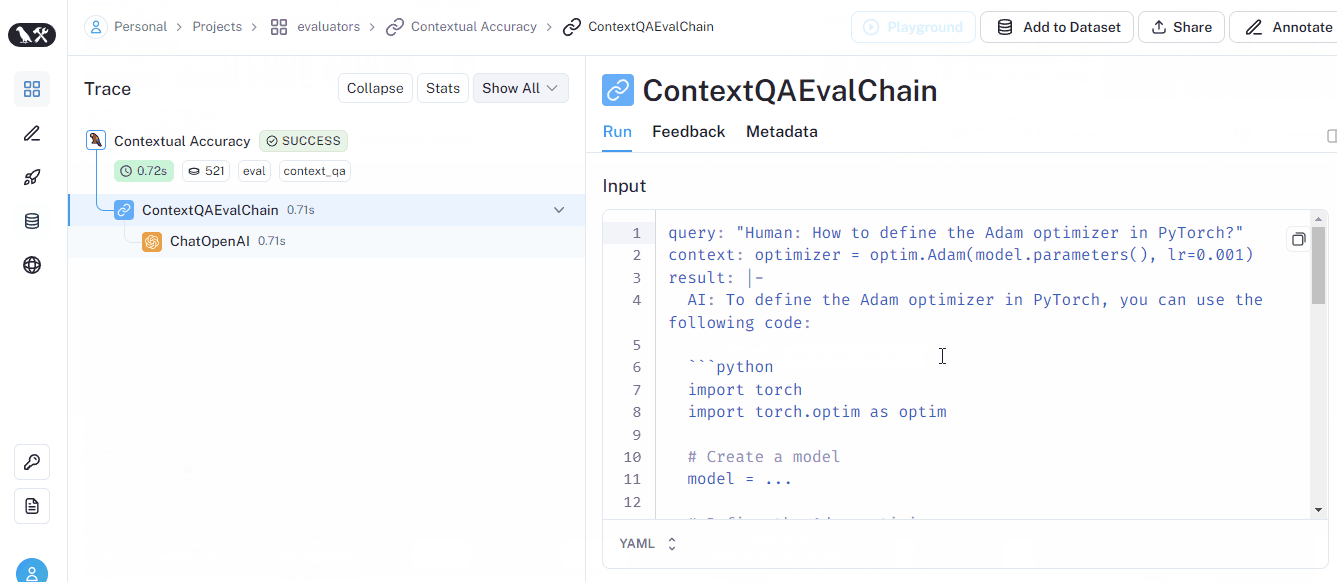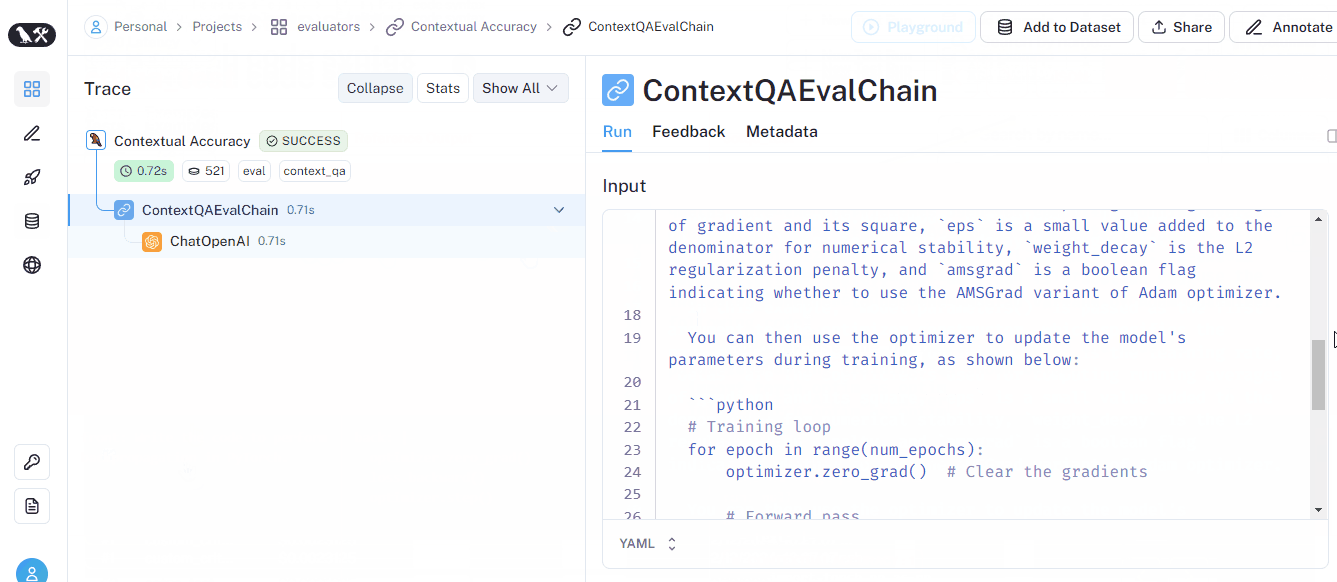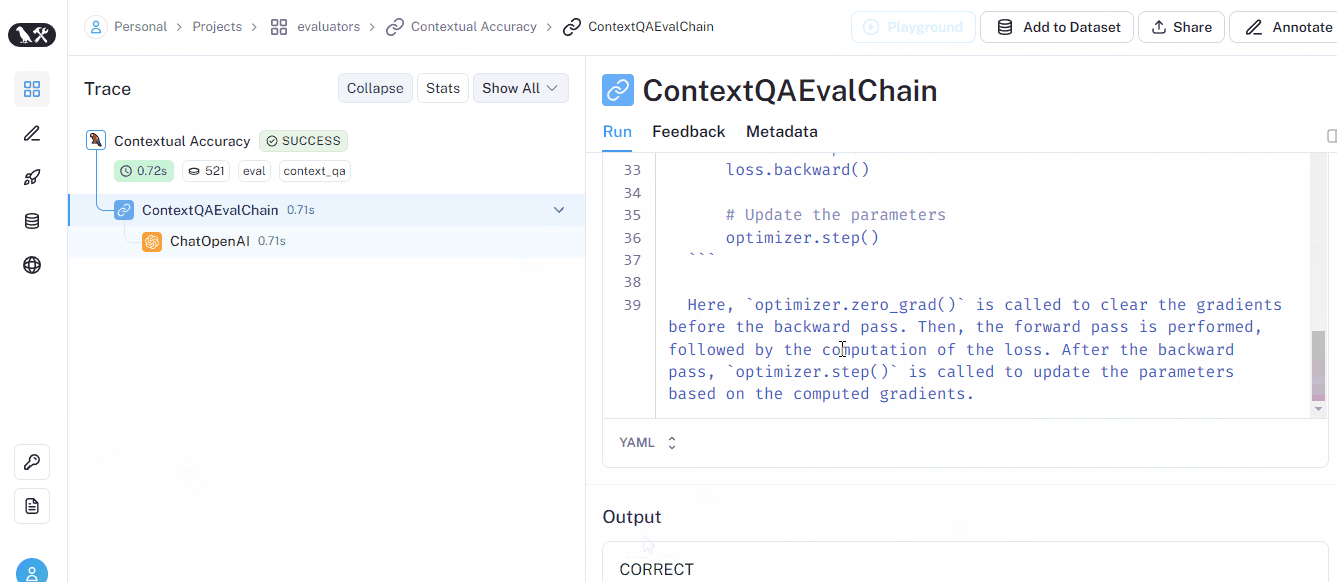
context_qa (contextuele Q&A): gebruikt de voorbeeldoutput als context bij het beoordelen van correctheidqa (Q&A): instrueert de LLM om een antwoord direct als “correct” of “incorrect” te beoordelen aan de hand van de referentie-outputcot_qa (Chain-of-thought Q&A): vergelijkbaar met context_qa, maar deze evaluator dwingt de LLM tot chain-of-thought-redenering vóór het oordeel.Laten we de laatste uitproberen op onze voorbeelden:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
Het CoTQA-criterium geeft een score terug genaamd Contextual accuracy, zoals te zien in de GIF hieronder (ook in de UI):
Bezoek de sectie LangChain evaluators in de LangSmith-docs om veel meer te leren over evaluators.
Als je na het lezen van deze tutorial de indruk hebt gekregen dat LangSmith eigenlijk vooral een complex hulpmiddel is voor prompt engineering, dan heb je gelijk! Op dit moment is LangSmith het beste framework om ervoor te zorgen dat de instructies en outputs van LLM’s daadwerkelijk zijn wat je wilt.
Je hebt vast ook gezien hoeveel werk het is om LLM-toepassingen op productieniveau te bouwen. Gebruik LangSmith dus voor een soepelere ervaring tijdens je LLM-projecten.
Als sommige concepten in LangSmith niet helemaal duidelijk waren, mis je misschien wat basiskennis van LangChain. Hier zijn enkele resources:
Begin vandaag nog aan je LangChain-reis
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


