
Cours
Développement d'applications LLM avec LangChain
3 h
51.3K
J’ai récemment découvert une plateforme d’IA qui génère automatiquement des fiches de révision à partir de n’importe quel type de média. Comme j’adore mémoriser des concepts avec la répétition espacée, j’ai aussitôt téléversé mon tutoriel XGBoost et demandé à l’IA de créer 50 fiches sur ce contenu.
Mais j’ai été déçu. La plupart des questions étaient trop simples, et très peu portaient sur la syntaxe du code. Plus surprenant encore, 10 % des questions étaient identiques et totalement hors sujet — « Quelle est la capitale de la France ? ».
Ce type d’erreurs trahit l’absence d’une évaluation et d’une validation rigoureuses des sorties produites par ces services d’IA. Peut-être ne connaissaient-ils pas LangSmith.
LangSmith est une plateforme complète pour tester, déboguer et évaluer des applications basées sur des LLM. Sa fonctionnalité phare est l’évaluation des sorties des LLM et le suivi de performance. Dans ce tutoriel, nous allons voir le cadre en action et apprendre à l’appliquer à vos propres projets.
C’est parti !
Comme indiqué plus haut, LangSmith est une plateforme exhaustive pour évaluer des applications de langage. Voici quelques-unes de ses fonctionnalités et les bénéfices concrets qu’elles apportent :
Les développeurs peuvent commencer à expérimenter avec LangSmith en quelques minutes, pas en heures. Résultat : une petite équipe ou un·e développeur·se en solo peut prototyper une application d’IA le week-end et, potentiellement, lancer un service payant dès le lundi.
Grâce à des outils d’évaluation rigoureux, les entreprises évitent la gêne (et le coût) de mises en production défaillantes (comme dans l’exemple de l’introduction). LangSmith permet de contrôler les sorties des LLM selon des critères intégrés — utilité, cohérence, misogynie — ou des évaluations personnalisées en langage naturel telles que « Le contenu de la sortie est-il cliché ? » ou, pour la génération de fiches, « La carte contient-elle une question de code ? ».
LangSmith consigne presque tous les aspects des exécutions via des traces : latence, nombre de tokens, coût des runs, et toutes sortes de métadonnées. L’interface Web vous permet de filtrer rapidement les runs par taux d’erreur, latence, date, ou même par contenu textuel en langage naturel. Concrètement, si un tuteur IA commence à « buguer » dans ses réponses aux apprenants, vous pouvez déployer un correctif en quelques heures.
LangChain est le cadre parent de LangSmith, axé sur la phase de développement des LLM. Il propose une conception modulaire pour chaîner plusieurs LLM (agents) et les intégrer à d’autres API comme YouTube, Google Search, etc. LangSmith vient couronner l’ensemble en garantissant, grâce à ses puissants outils d’évaluation et de monitoring, que les prototypes construits avec LangChain se comportent comme prévu.
Consultez notre tutoriel LLM Applications with LangChain pour en savoir plus sur LangChain.
Autre atout majeur de LangSmith : les jeux de données. Ils servent à améliorer les chaînes, agents ou modèles LangChain sur un ensemble d’exemples standardisés avant le déploiement. Par exemple, nous pouvons disposer d’un fichier CSV avec deux colonnes — questions et réponses — pour des fiches dans un format précis.
En transformant ce fichier en jeu de données de référence, nous pouvons demander aux LLM d’évaluer leurs propres sorties à l’aide des métriques d’assurance qualité mentionnées plus haut.
Nous allons maintenant passer en revue ces fonctionnalités, exemples à l’appui.
En développement d’applications ML, on collecte des données, on entraîne, on ajuste finement, on teste et on déploie les modèles — les étapes sont bien établies. Avec les applications LLM, vous partez souvent d’un modèle prêt à l’emploi fourni par un éditeur. Le fine-tuning ? Coûteux. Vous allez donc investir surtout dans l’ingénierie de prompts — tout l’enjeu est de poser les bonnes questions à votre application LLM. Voyez cela comme un besoin de nombreux prompts pour tester, à l’image de la quantité de données requise pour un bon modèle ML.
Sauf qu’avec les prompts, vous manipulez des textes en entrée et en sortie, pas des nombres. Les métriques classiques d’erreur ou de précision comme la MSE ou l’entropie croisée ne s’appliquent pas. Et lire chaque entrée et sortie pour évaluer ? Avec des milliers de prompts, cela prendrait des jours.
Vous avez donc besoin d’un workflow dédié à la création et au test efficaces de prompts pour mesurer les performances de votre application LLM sans vous noyer dans les vérifications manuelles. Voici à quoi cela peut ressembler :
À ce stade, vous prototypez le socle de votre application avec des frameworks comme LangChain. Pour un générateur de fiches, votre prototype peut inclure plusieurs composants au-dessus du LLM choisi auprès d’un fournisseur. Par exemple, vous pouvez le chaîner à :
etc. (voyez les composants possibles sur cette page de la doc LangChain). Mais vous pouvez réduire drastiquement votre temps de développement en utilisant des chaînes prêtes à l’emploi proposées par LangChain pour des tâches courantes de haut niveau.
Ici, vous testez votre application sur un maximum de scénarios. Il s’agit de vous assurer que chaque composant ajouté fonctionne bien, s’enchaîne correctement et produit des sorties fiables et de qualité.
Étant donné le caractère non déterministe des LLM (ils ne génèrent pas toujours la même sortie pour une même entrée) et la complexité des composants ajoutés, vous passerez l’essentiel de votre temps à cette étape. Et LangSmith a été conçu précisément pour raccourcir ce temps au maximum. Nous y reviendrons tout au long du tutoriel.
Une fois l’application viable, vous pouvez la déployer sous forme d’API REST. En pratique, une API REST convertit vos chaînes ou agents LangChain en endpoints HTTPS vers lesquels d’autres enverront des requêtes pour interagir avec votre modèle d’IA. Il ne vous reste plus qu’à construire l’interface utilisateur — application desktop ou, le plus souvent, site web.
À l’heure actuelle, il n’existe pas de voie toute tracée, mais les développeurs de LangChain s’apprêtent à lancer LangServe, intégré à FastAPI (plutôt prometteur, non ?). Jetez un œil à l’aperçu sur cette page de la documentation.
Passons maintenant à la prise en main de LangSmith.
Commençons par l’interface Web, accessible via smith.langchain.com. Pour y accéder, vous devez vous inscrire et être validé·e sur liste d’attente, la bêta étant actuellement fermée.
Une fois connecté·e, la page d’accueil ressemble à ceci :
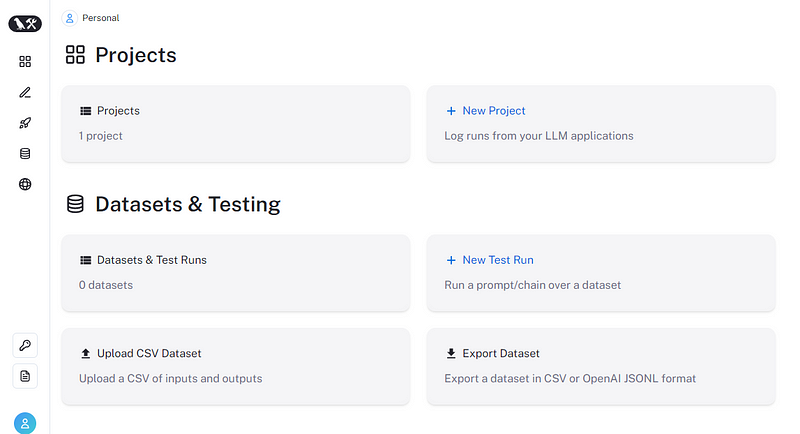
Les deux sections principales sont « Projects » et « Datasets & Testing », manipulables toutes deux via le SDK Python. La plateforme propose aussi des onglets pour le déploiement et les files d’annotation, mais ils sortent du cadre de cet article.
La gestion des projets dans LangSmith est bien plus simple avec son SDK Python, connecté à la plateforme via une clé API.
Pour obtenir une clé, cliquez sur l’icône de clé dans la plateforme et conservez-la en lieu sûr. Puis, dans un nouveau répertoire avec un nouvel environnement virtuel initialisé, créez un fichier .env. À l’intérieur, collez les deux lignes suivantes :
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
Ensuite, dans votre terminal, exécutez les commandes suivantes pour installer LangSmith et python-dotenv pour lire les variables d’environnement :
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Place au code :
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
Nous importons les fonctions find_dotenv et load_dotenv pour lire les variables d’environnement et les définir avec os :
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Le paramètre LANGCHAIN_TRACING_V2 à True active le tracing (journalisation), indispensable pour déboguer les LLM. Ensuite, nous initialisons un client pour dialoguer avec LangSmith :
from langsmith import Client

# Initialize a client
client = Client()
client regroupe des commandes de haut niveau pour manipuler projets et ressources dans LangSmith. Commençons par créer un nouveau projet :
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
Après l’exécution de create_project, vous voyez le projet listé dans la section Projects de l’interface Web :
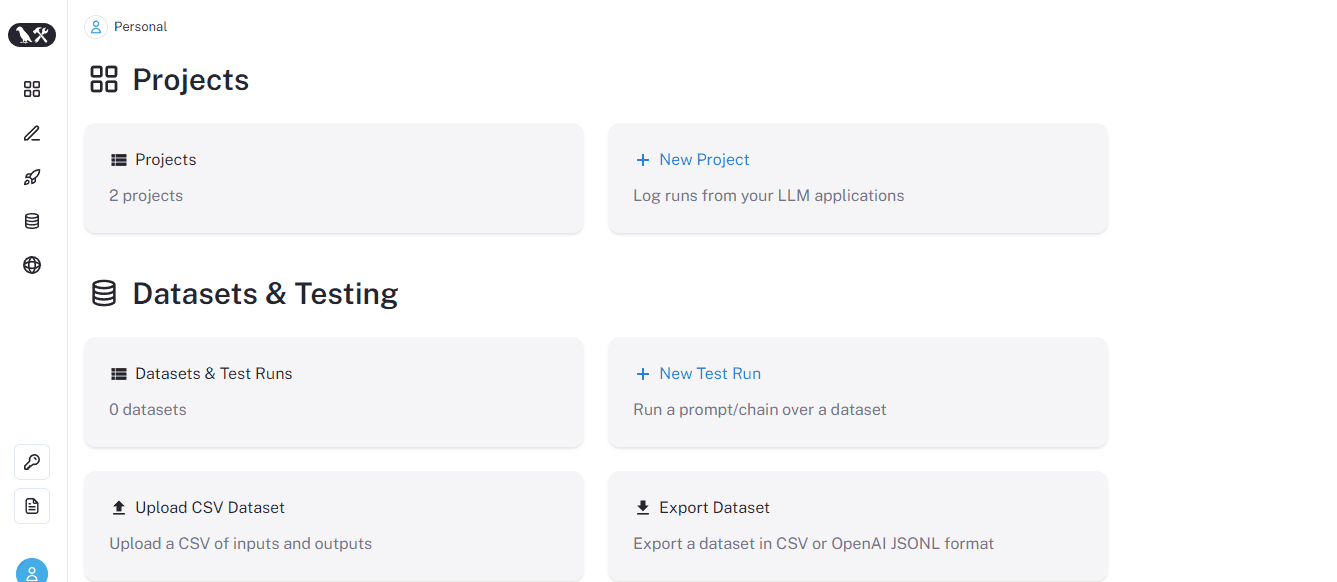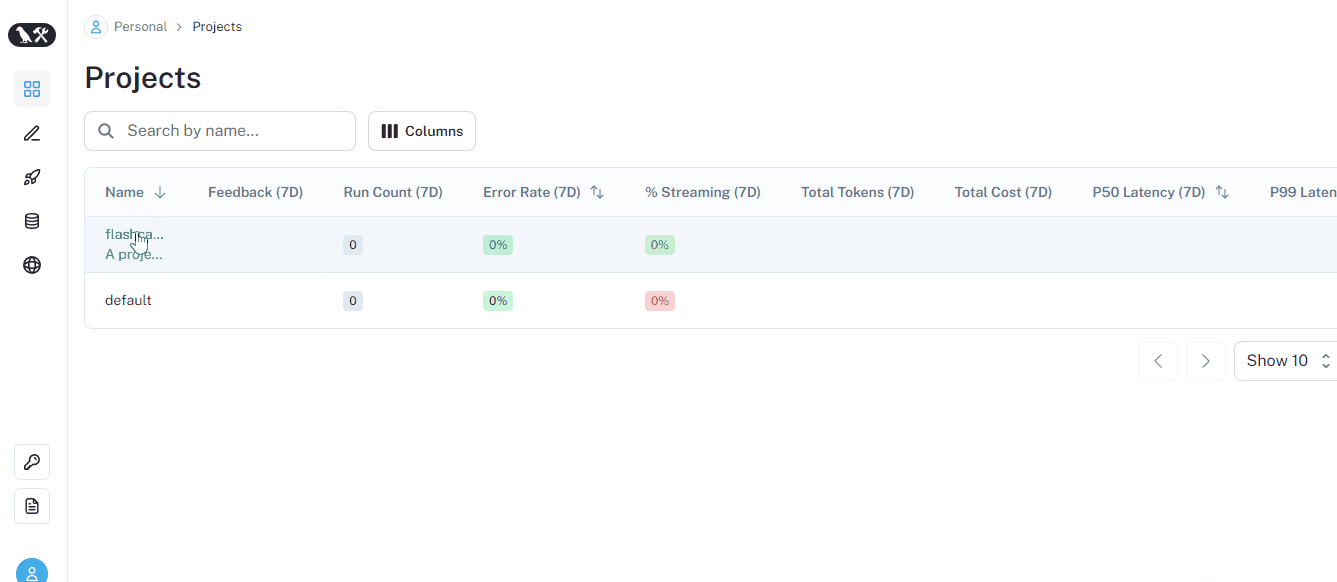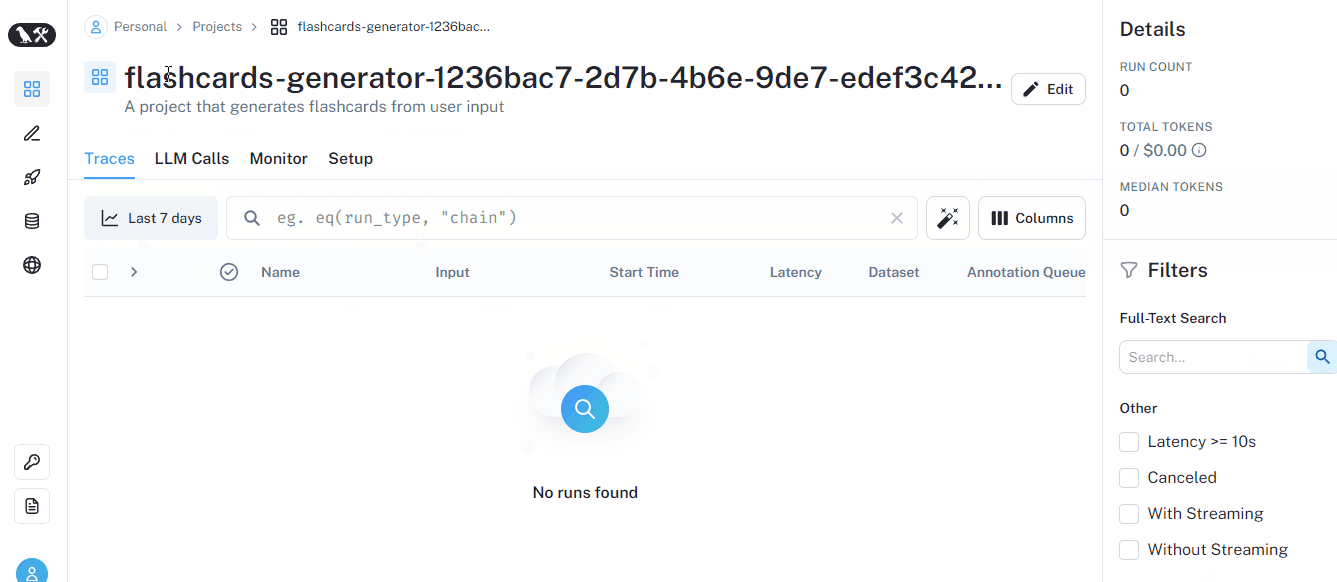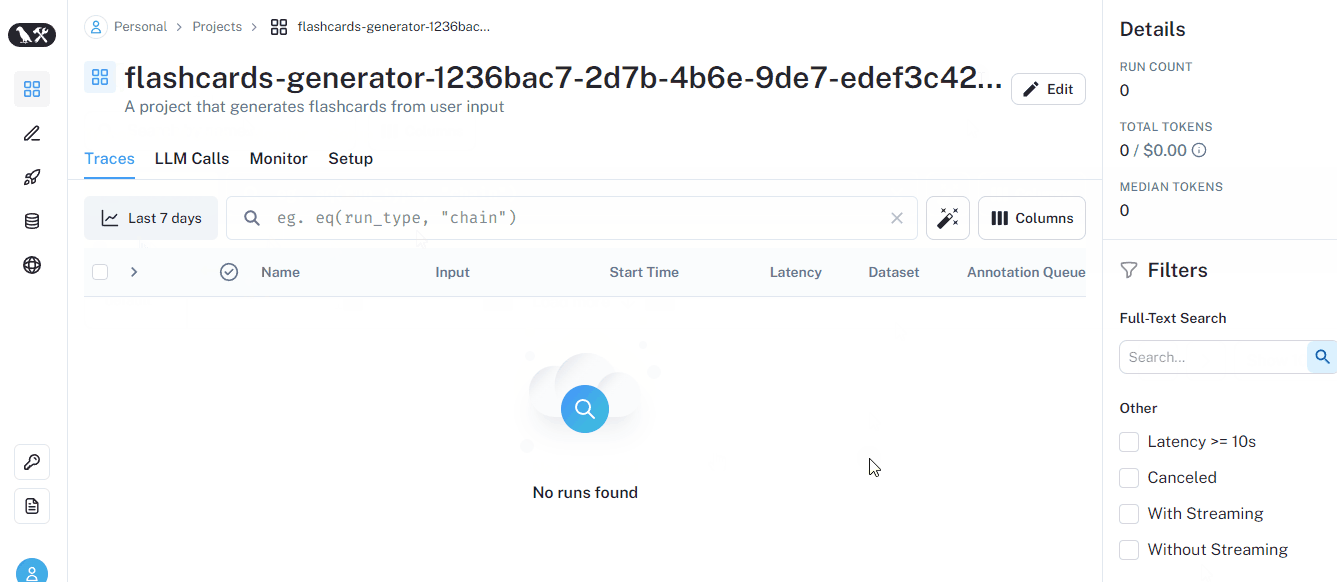
Ensuite, définissons ce nouveau projet comme projet par défaut via une autre variable d’environnement :
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Il nous faut maintenant un LLM pour notre projet. Nous allons choisir GPT-3.5 turbo pour son coût plus faible, mais vous pouvez utiliser bien d’autres modèles disponibles via langchain. Les modèles OpenAI sont initialisés avec la classe ChatOpenAI.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Faisons un premier run :
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
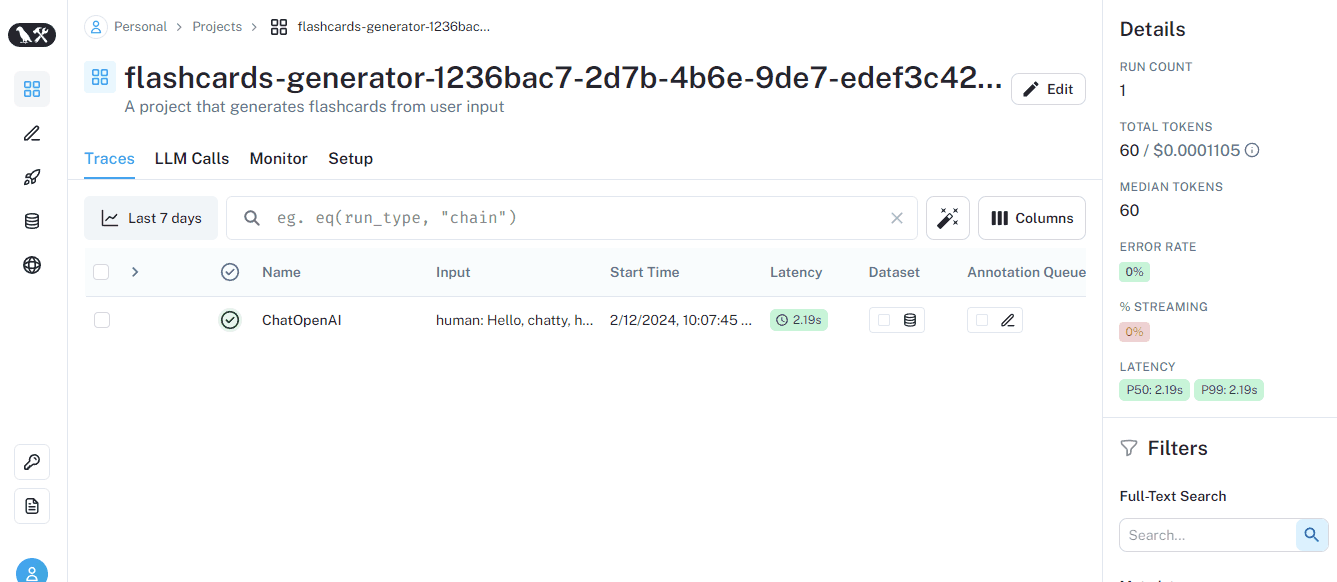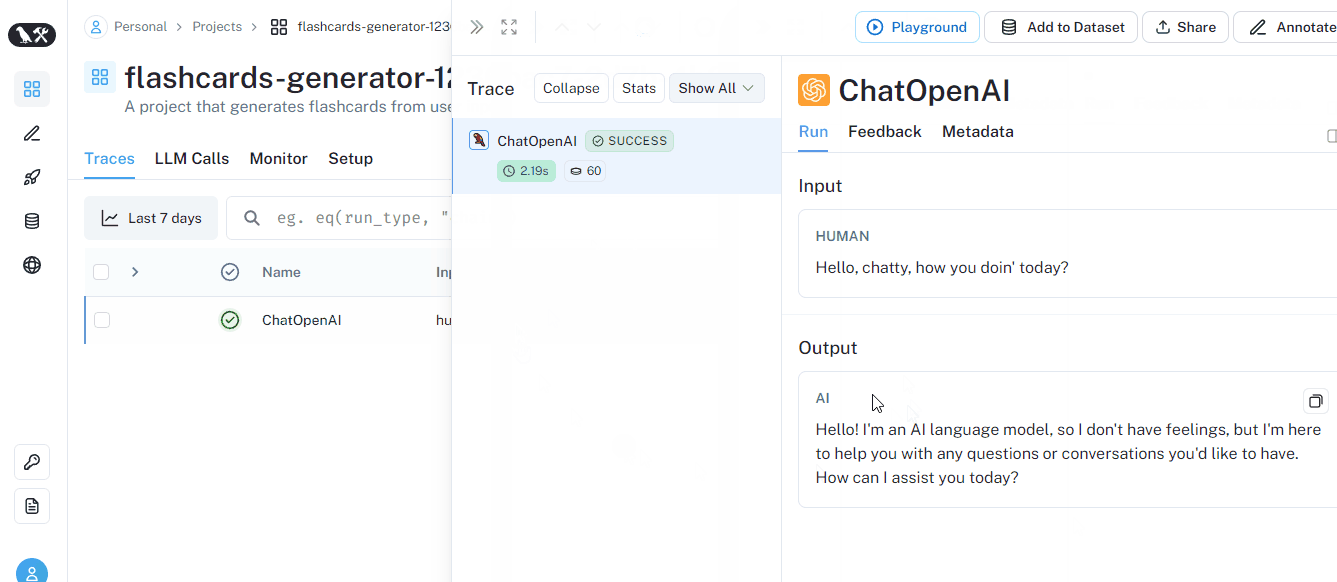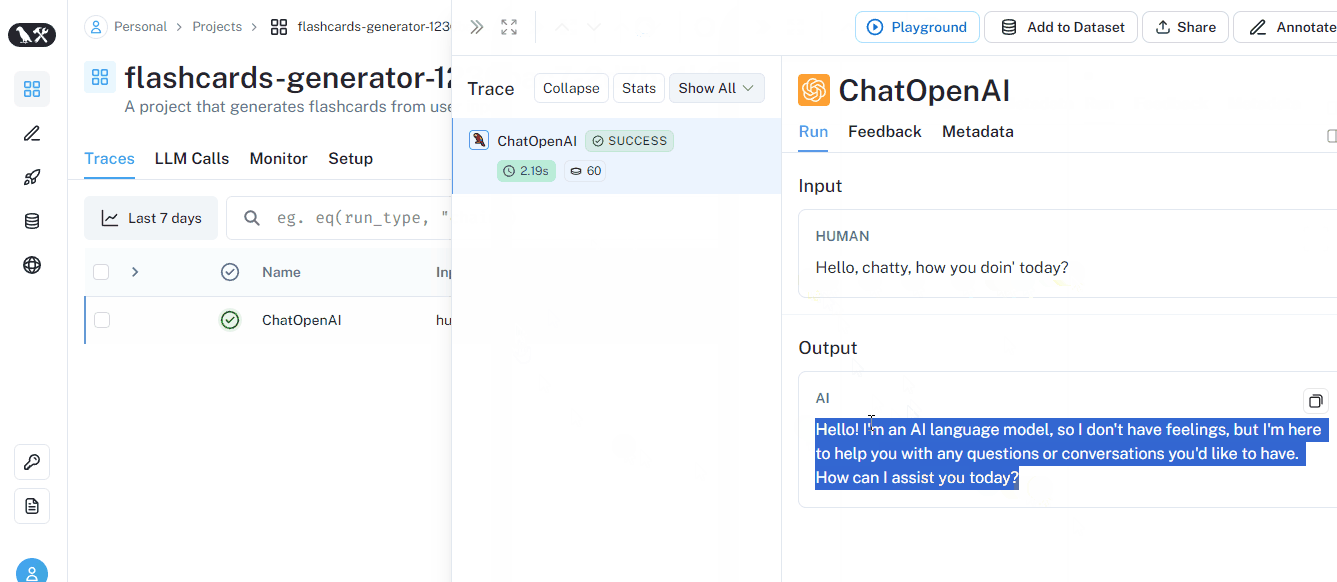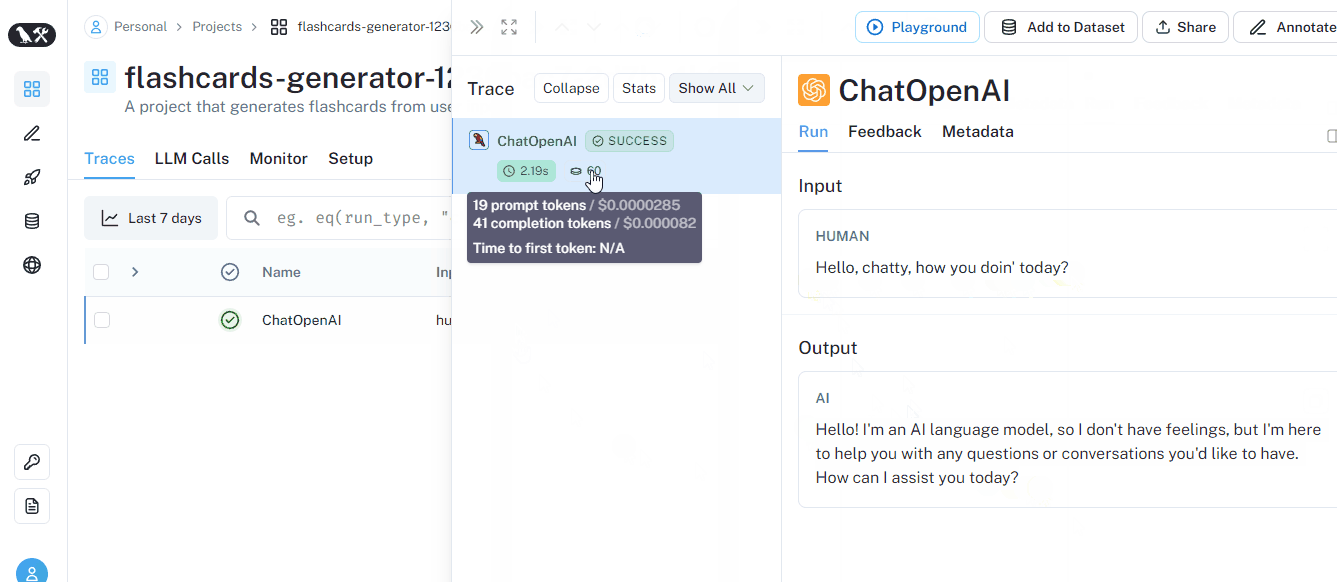
Si vous jetez un coup d’œil au projet dans l’interface, vous verrez ce run tracé (journalisé) :
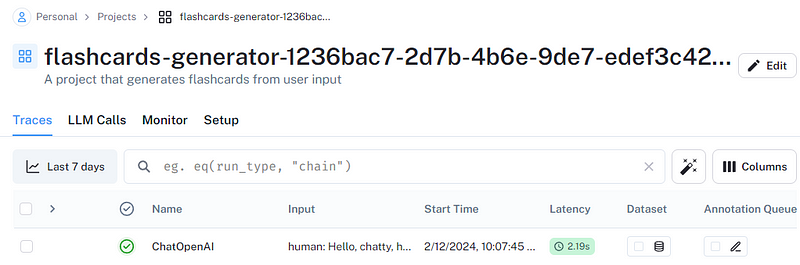
En configurant les variables d’environnement et le client, nous avons activé la journalisation automatiquement. Comme vous le voyez, nous disposons déjà d’un ensemble de métadonnées sur le run.
Lançons encore quelques prompts :
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Nous pouvons déjà construire un synthétiseur de texte basique. Résumons la sortie du dernier run :
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Parfait, créons maintenant notre premier jeu de données.
Comme indiqué dans la section « workflow de développement », vous aurez sans doute à créer ou collecter des milliers de prompts pour évaluer votre modèle, chaîne ou agent LLM. Les exécuter un par un, comme plus haut, n’est pas optimal.
Pour cela, LangSmith propose trois types de jeux de données :
kv) — par défaut : définit des entrées comme des paires clé-valeur arbitraires. Utile pour évaluer des chaînes et agents nécessitant plusieurs entrées ou produisant plusieurs sorties.llm) : entrées et sorties de type « completion » — texte en entrée, texte en sortie.chat) : jeux dérivés d’échanges LLM, définis avec des entrées structurées et des messages sérialisés.Voyons d’abord comment créer un jeu key-value sans sorties. Nous allons utiliser la fonction create_dataset du client :
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Ajoutons maintenant trois entrées demandant chacune au LLM de créer une fiche unique :
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
Dans l’onglet Dataset de l’interface, chaque prompt apparaît avec une sortie NULL :
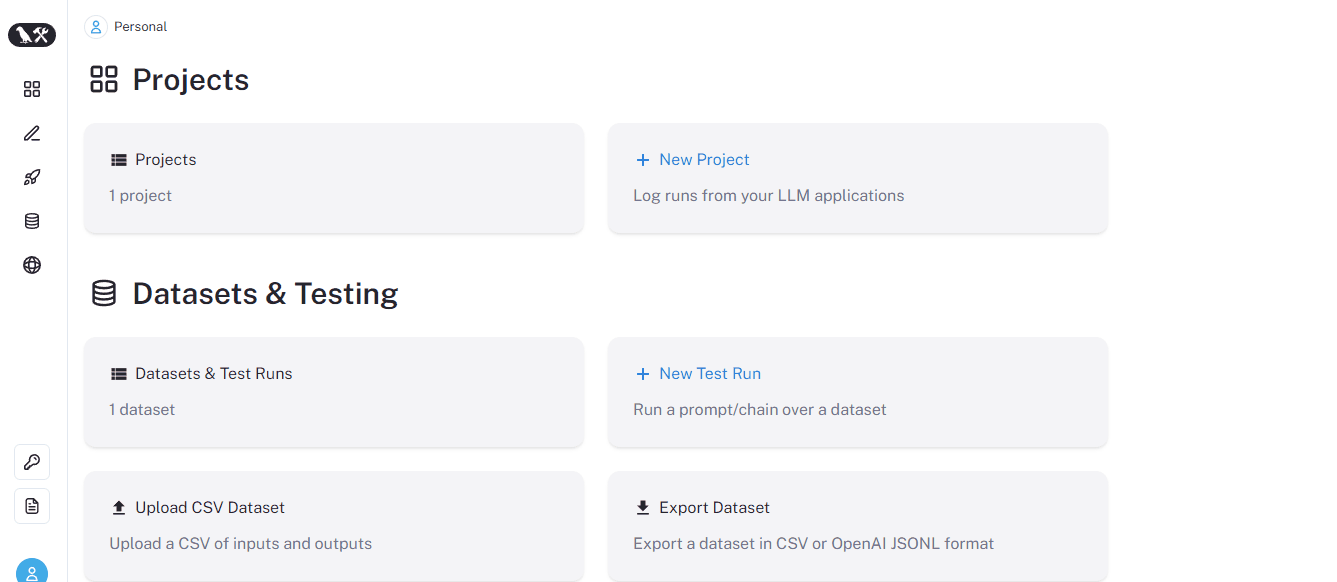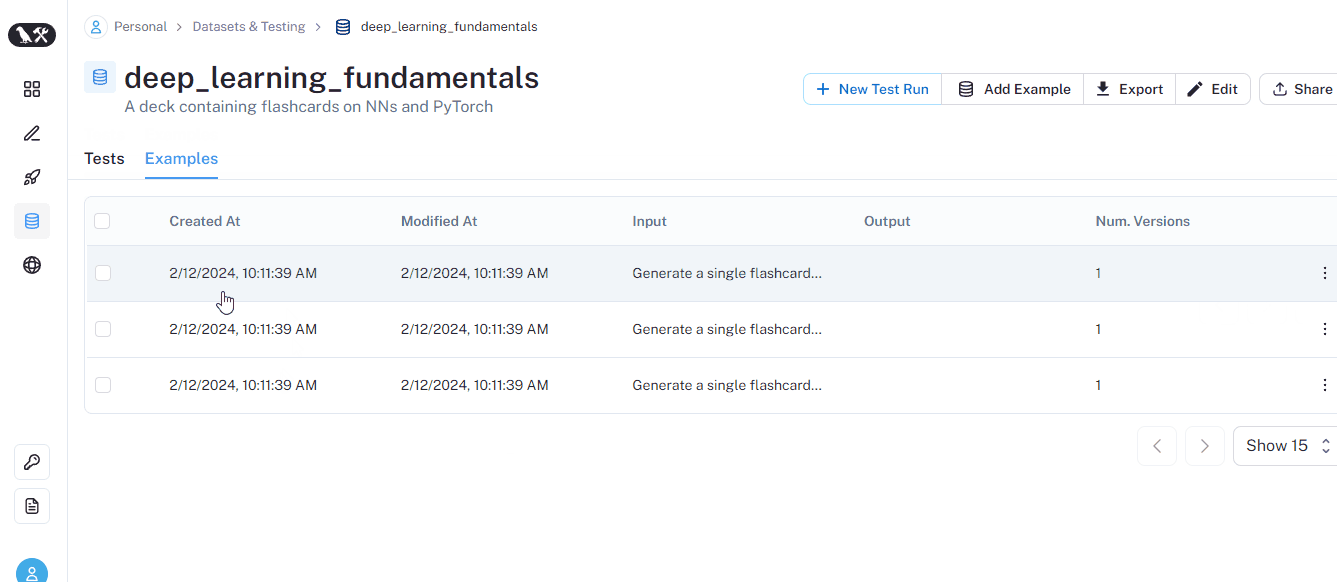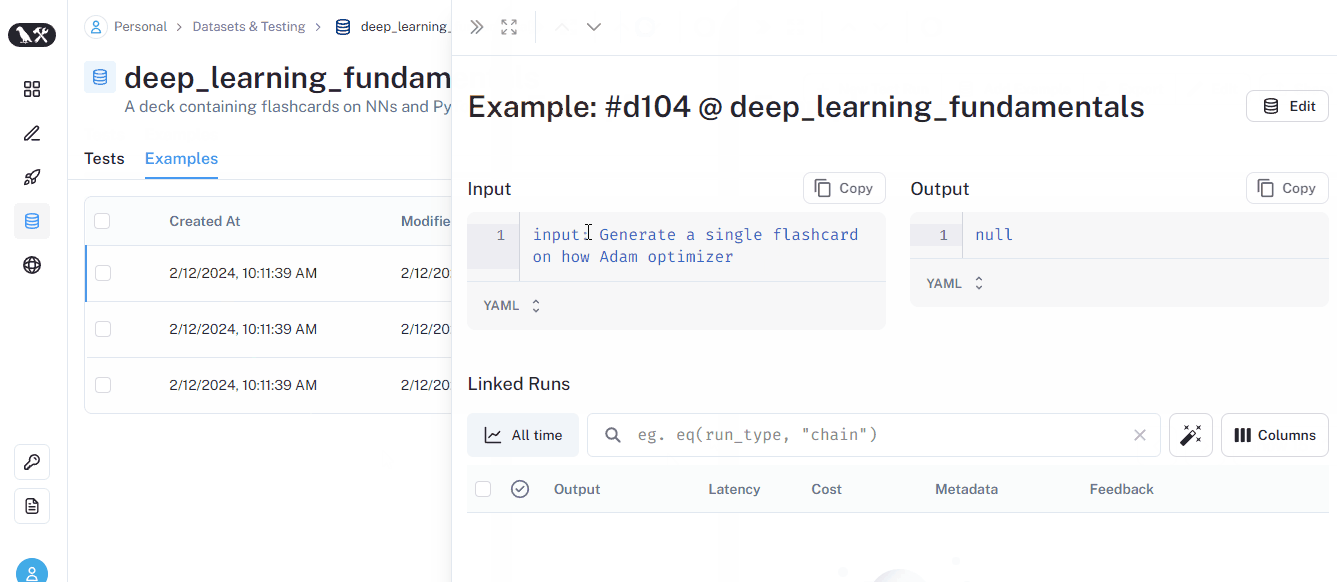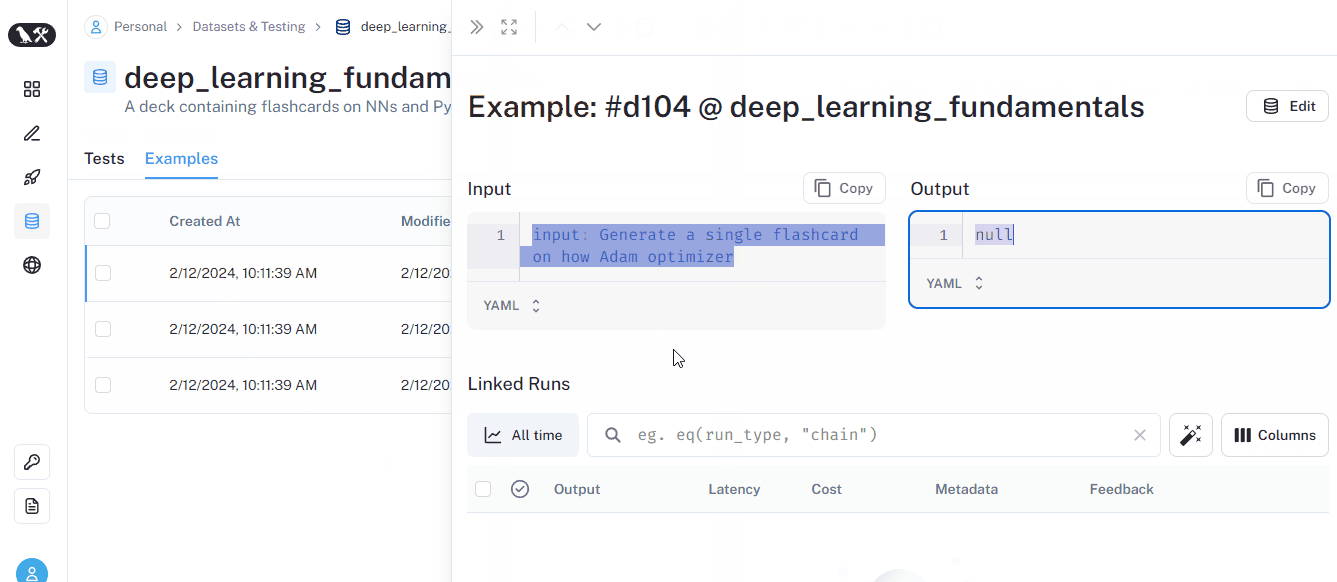
Lançons tous les prompts d’un coup avec la fonction run_on_dataset :
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Une fois le run terminé, il est listé sur la page du dataset. Voici à quoi cela ressemble :
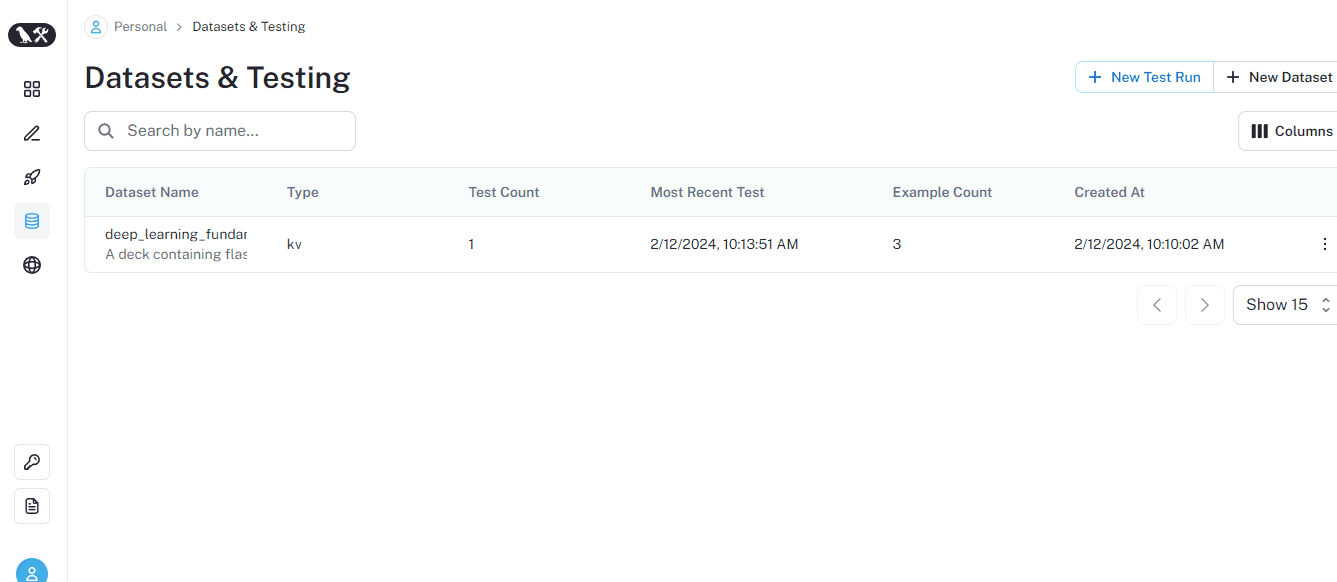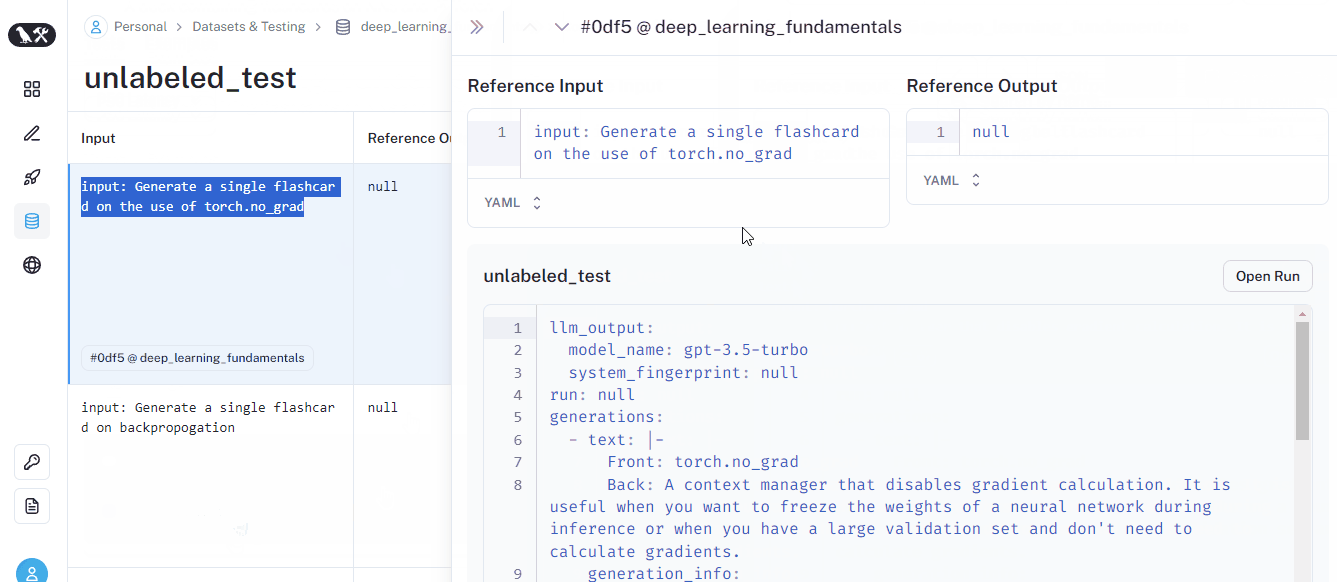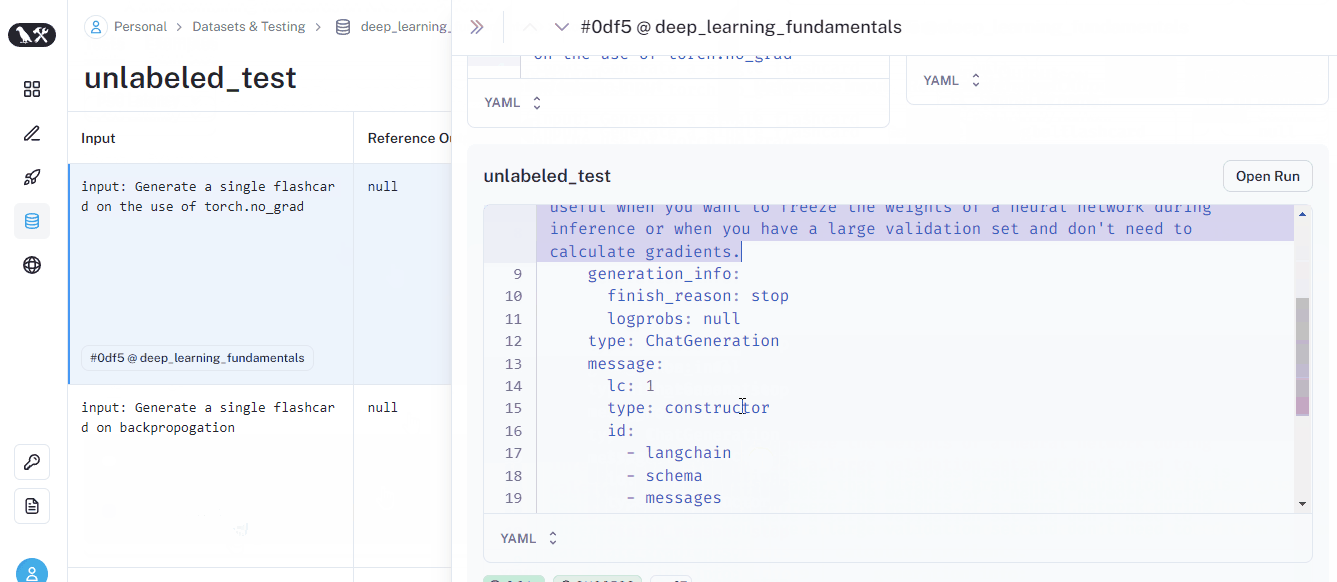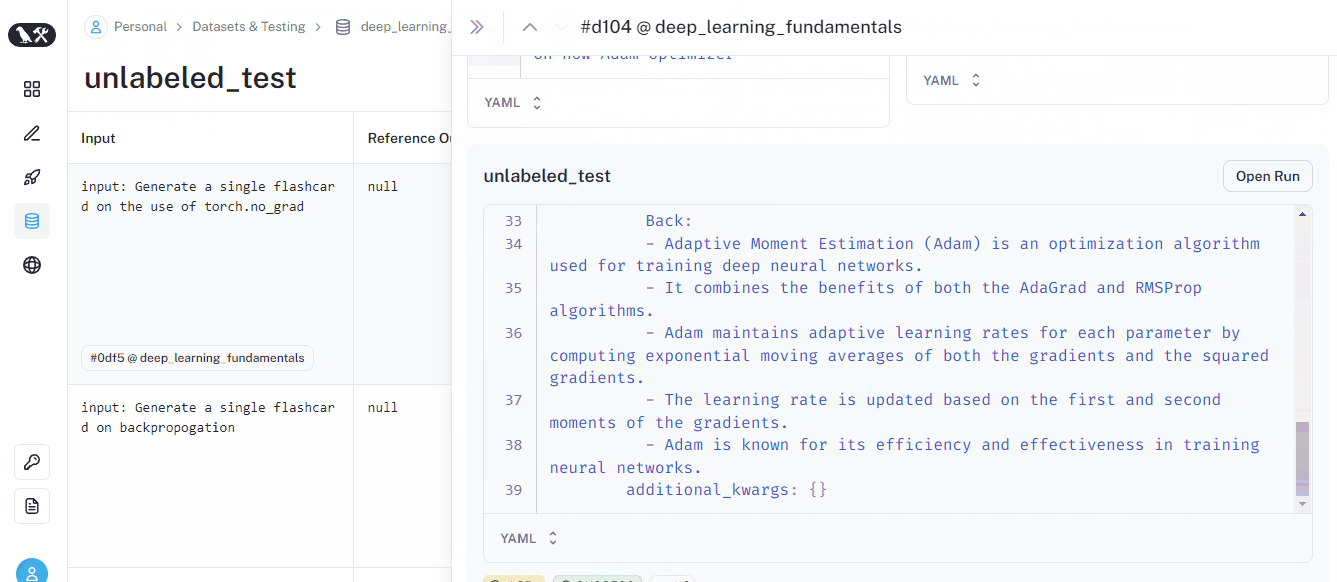
Nous venons d’effectuer un test sur un dataset non étiqueté — un ensemble d’exemples de prompts sans sorties de référence. Notre test a simplement produit une réponse à chaque prompt, sans évaluation. Or, nous souhaiterions des vérifications basiques du type « La sortie est-elle utile ? » ou « La réponse est-elle courte ou longue ? »
LangSmith permet d’effectuer ces contrôles via des évaluateurs intégrés.
Pour lancer des évaluations de conciseness et de coherence avec les trois prompts de notre dataset, utilisons la classe RunEvalConfig :
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Ci-dessus, nous définissons deux critères dans une liste nommée evaluators. Passons-les au paramètre evaluation de run_on_dataset :
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset est une fonction pratique pour exécuter tous les prompts d’un dataset avec le LLM fourni et réaliser tout type d’évaluation à la volée. Les résultats sont visibles sur la page dédiée du dataset :
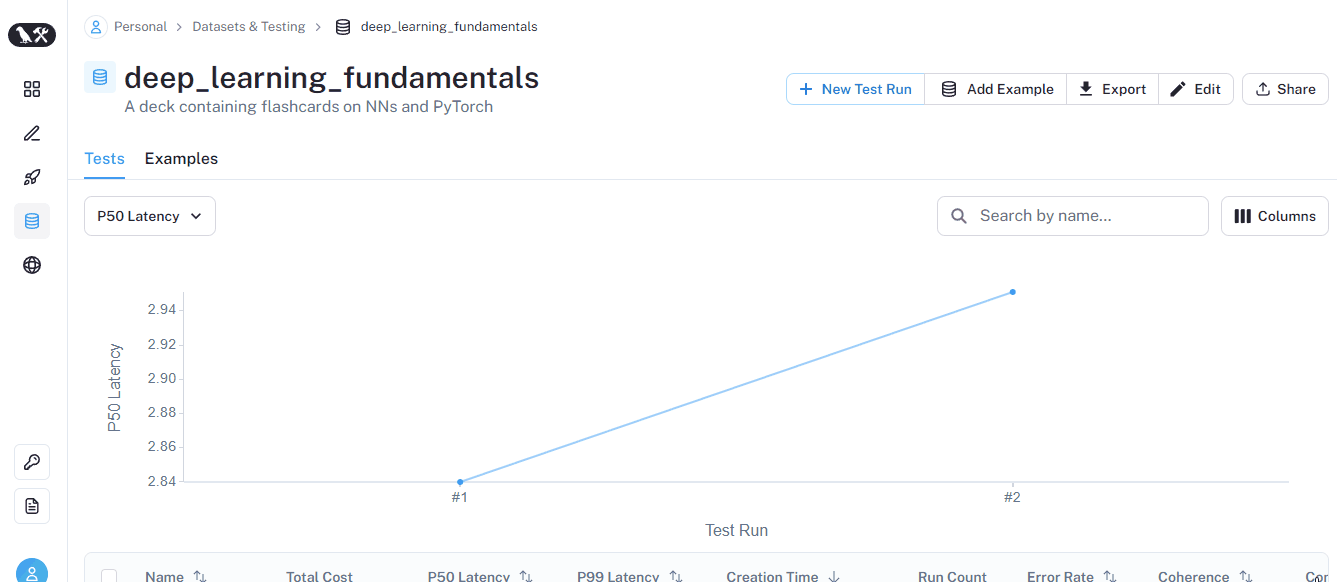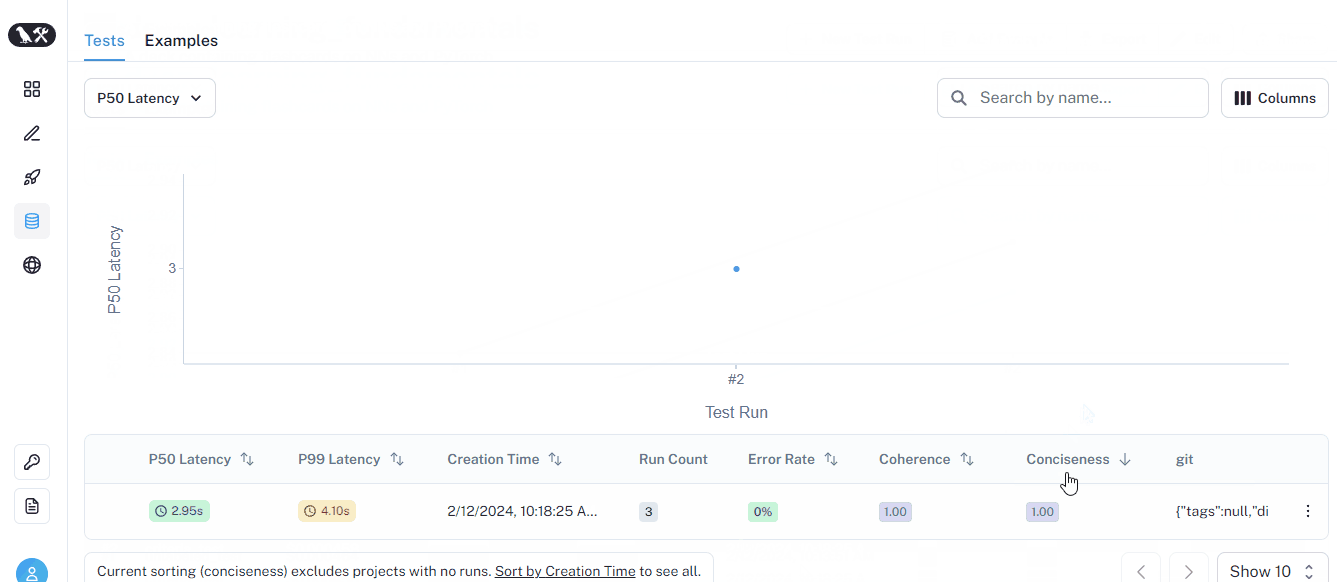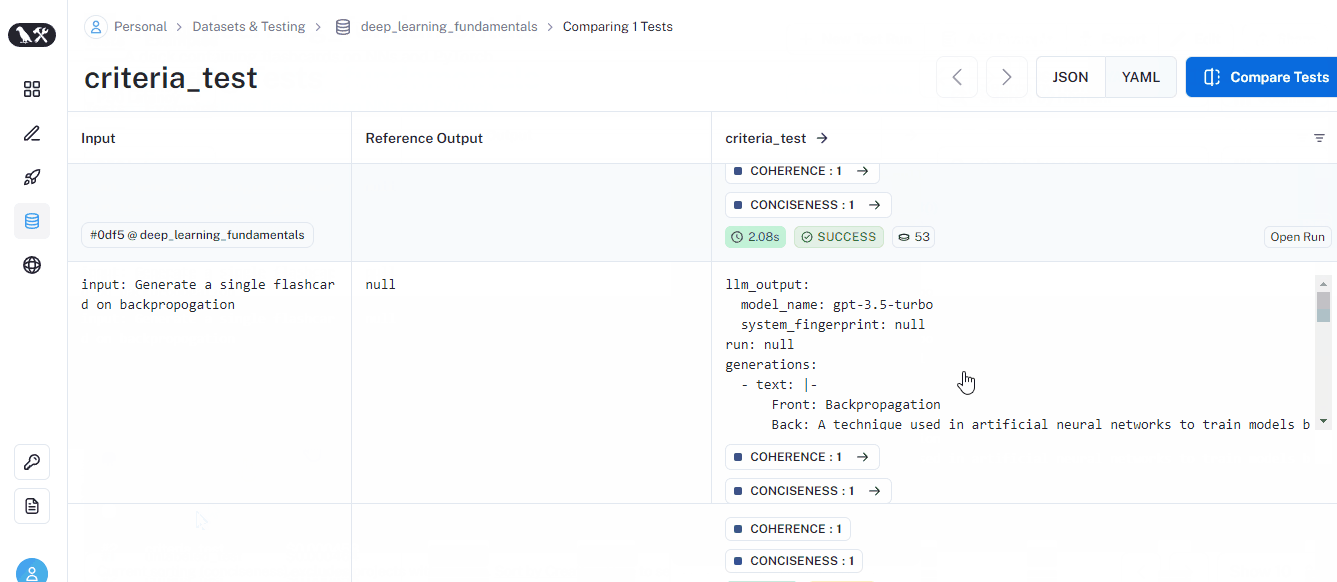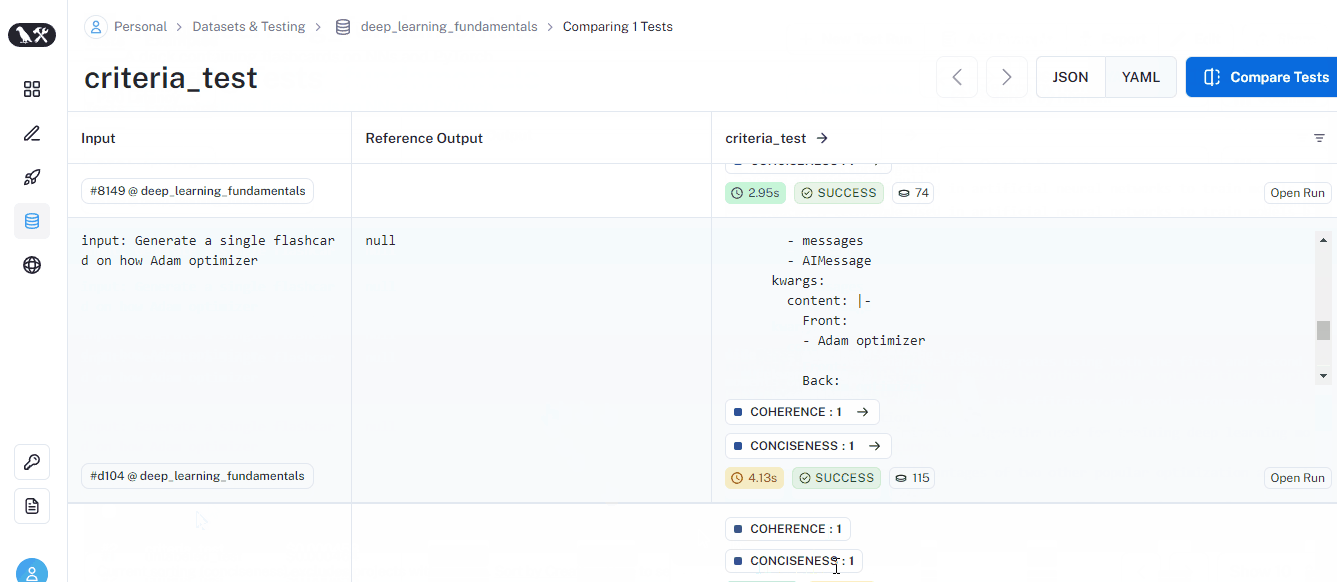
Cette fois, chaque prompt est associé à des métriques de cohérence et de concision. En bas, vous verrez également un score moyen par métrique.
Pour lister tous les critères intégrés, exécutez l’extrait ci-dessous :
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Évidemment, tous les cas d’usage LLM ne se couvrent pas avec des évaluateurs basiques. Par exemple, il n’existe pas d’évaluateur vérifiant si une fiche contient une question de code. Définissons-le :
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Pour passer un critère personnalisé en langage naturel, il suffit de fournir {“criteria_name”: “Condition to check”} à la classe Criteria. Ici, nous créons deux évaluateurs supplémentaires ; LangSmith exécutera donc deux prompts additionnels par-dessus la sortie produite par les prompts du dataset :
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Dans le run, vous verrez les critères personnalisés définis sous chaque prompt. En survolant, vous obtiendrez le raisonnement du LLM :
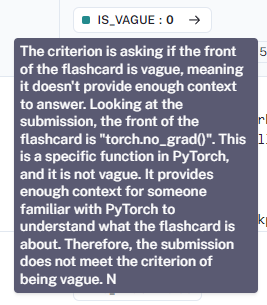
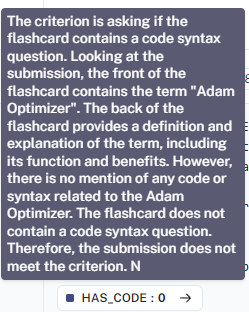
En parcourant les résultats pour tous les prompts, vous constaterez que nos critères n’évaluent pas exactement comme souhaité. À retenir : vous devez aussi « prompt-engineerer » vos critères pour vous assurer qu’ils vérifient bien ce qu’il faut.
Il arrive que vous souhaitiez créer un dataset de prompts avec sorties attendues, c’est-à-dire étiqueté. Vous pouvez créer des datasets étiquetés sous divers formats, mais le plus courant reste le CSV. Par exemple, voici un fichier généré avec ChatGPT contenant cinq questions sur la syntaxe PyTorch :
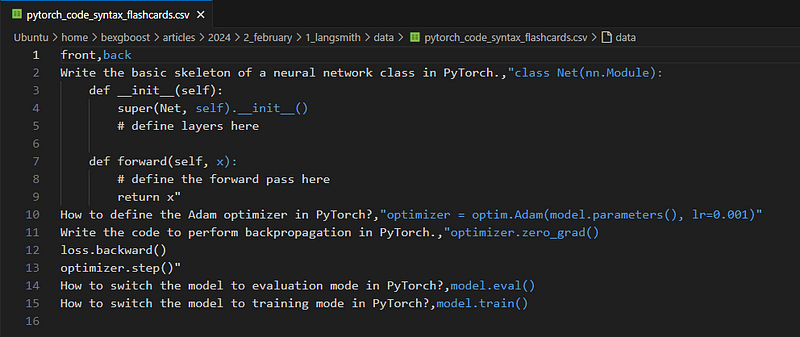
Pour créer un dataset à partir de celui-ci, utilisons la fonction upload_csv :
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
La fonction a trois paramètres requis : le chemin du CSV et les noms des colonnes d’entrée/de sortie. Une fois l’import terminé, le dataset apparaît dans l’interface :
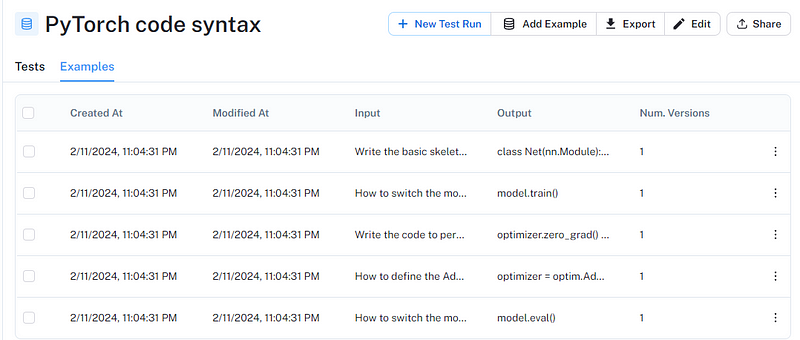
Lançons nos critères personnalisés de la section précédente sur ce dataset également :
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
Sur la page du dataset, en consultant le run, vous verrez les scores moyens pour chaque critère personnalisé :
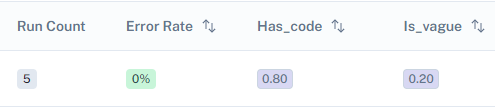
Les évaluateurs intégrés et personnalisés, rédigés en langage naturel, visent surtout les datasets non étiquetés. Pour les datasets étiquetés comme notre CSV, LangSmith propose des évaluateurs plus complets pour mesurer la justesse de la réponse au prompt :
context_qa (Q&R contextuelle) : utilise la sortie de référence comme contexte pour évaluer la correctionqa (Q&R) : demande au LLM de noter directement une réponse « correcte » ou « incorrecte » à partir de la référencecot_qa (Q&R avec chaîne de raisonnement) : proche de context_qa, mais force le LLM à raisonner en chaîne avant de trancher.Essayons le dernier sur nos exemples :
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
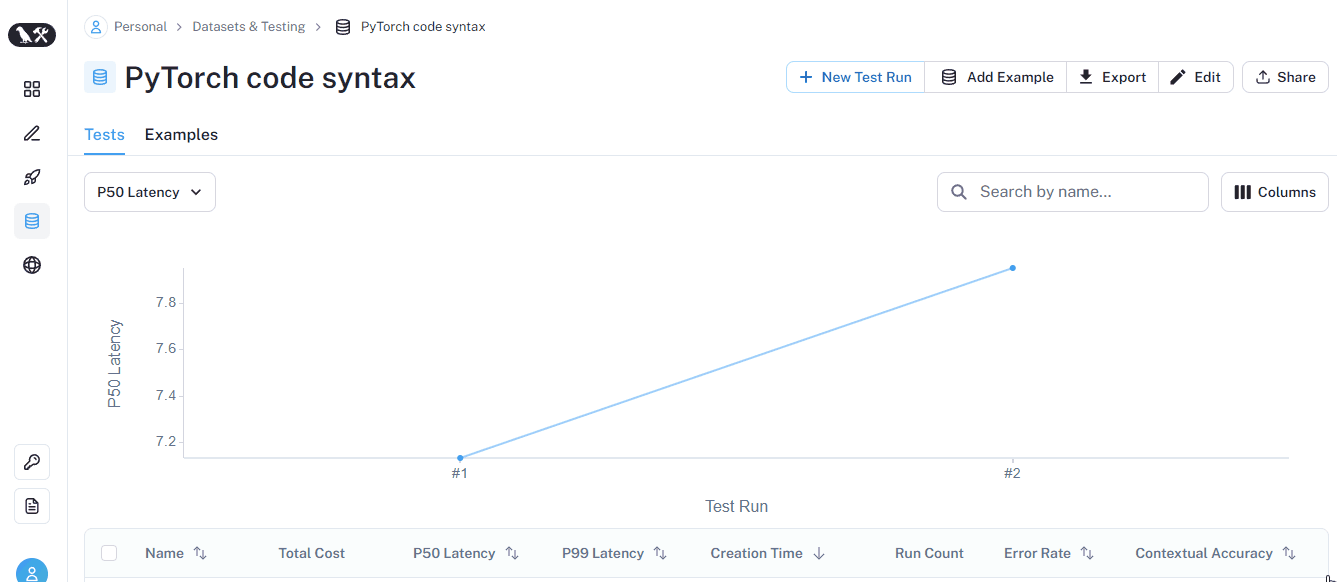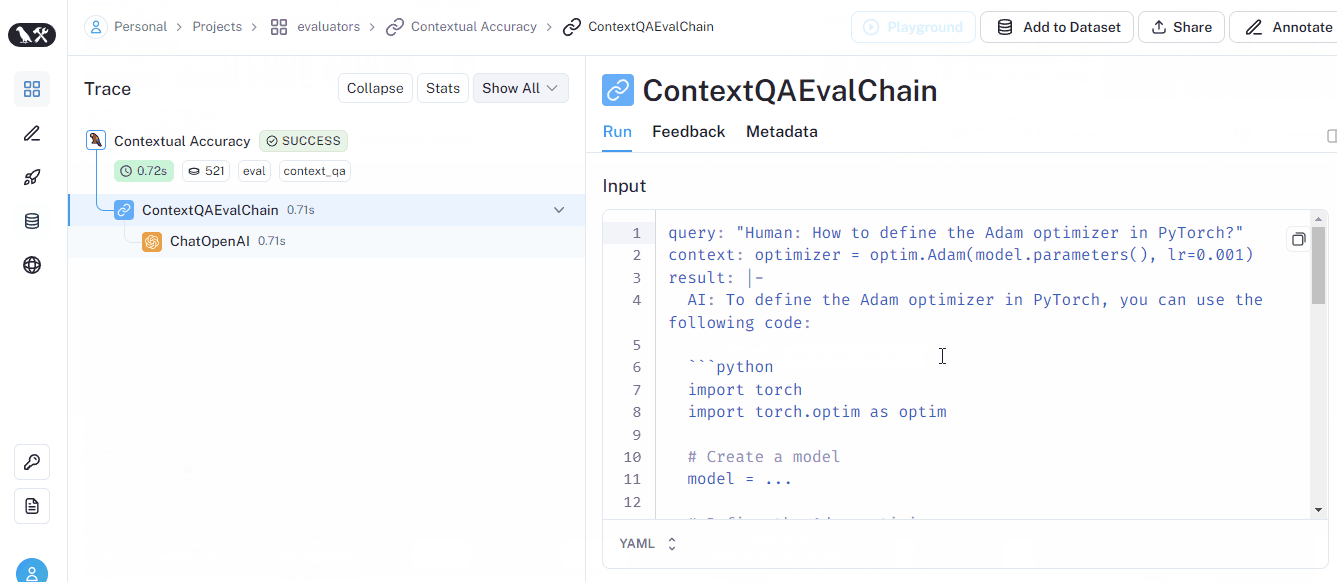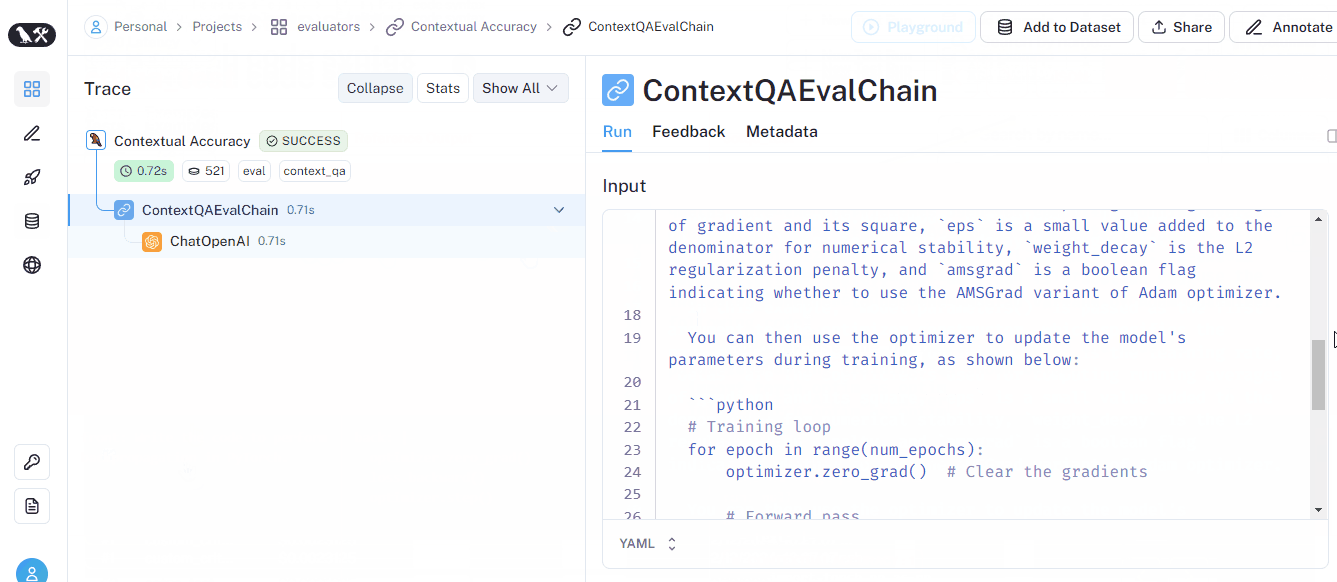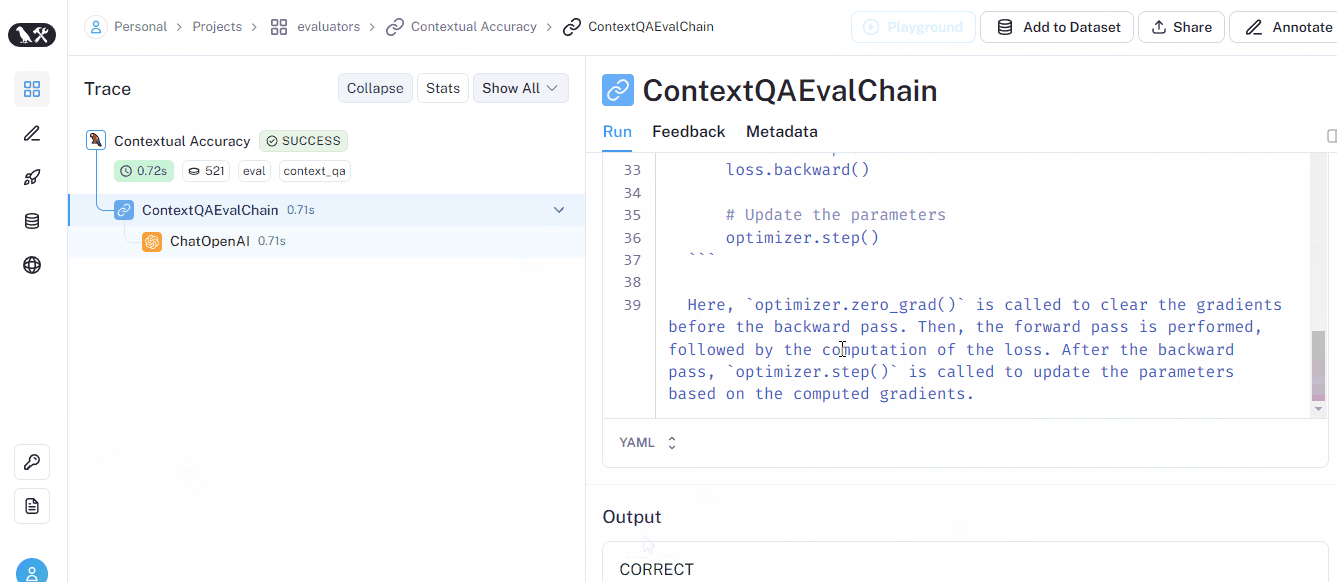
Le critère CoTQA renvoie un score nommé Contextual accuracy, comme illustré dans le GIF ci-dessous (et dans l’interface) :
Pour en savoir plus, consultez la section LangChain evaluators de la documentation LangSmith.
Si, à la lecture de ce tutoriel, vous avez l’impression que LangSmith est avant tout un outil puissant pour l’ingénierie de prompts, vous avez raison ! Aujourd’hui, LangSmith est le meilleur cadre pour garantir que les instructions et les sorties des LLM correspondent réellement à vos attentes.
Vous aurez aussi mesuré l’effort nécessaire pour construire des applications LLM prêtes pour la production. Utilisez LangSmith pour fluidifier votre expérience sur vos projets LLM.
Si certaines notions de LangSmith vous semblent obscures, il vous manque peut-être des fondamentaux sur LangChain. Voici quelques ressources :
Commencez votre parcours LangChain dès aujourd’hui
Cours
Cours
Cours
blog
Kurtis Pykes
9 min
blog
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Matt Crabtree
5 min



