Curso
Desarrollo de aplicaciones LLM con LangChain
3 h
50.6K
Hace poco di con una plataforma de IA que genera automáticamente tarjetas de estudio a partir de cualquier tipo de contenido. Como me encanta memorizar conceptos con repetición espaciada, subí enseguida mi tutorial de XGBoost y le pedí a la IA que creara 50 tarjetas sobre él.
Pero me decepcionó. La mayoría de las preguntas eran demasiado fáciles y casi ninguna trataba sobre sintaxis de código. Más extraño aún, un 10% de las preguntas eran idénticas y totalmente fuera de contexto: «¿Cuál es la capital de Francia?».
Este tipo de errores apunta a una falta de evaluación y validación adecuadas de los resultados que producen los servicios de IA. Quizá no conocían LangSmith.
LangSmith es una plataforma completa para probar, depurar y evaluar aplicaciones con LLM. Tal vez su función más importante sea la evaluación del output de los LLM y el seguimiento del rendimiento. En este tutorial veremos el framework en acción y aprenderemos técnicas para aplicarlo en tus propios proyectos.
¡Vamos allá!
Como comentaba arriba, LangSmith es una plataforma integral para evaluar aplicaciones de lenguaje a gran escala. Estas son algunas de sus funciones y los beneficios tangibles que aportan:
Los programadores pueden empezar a experimentar con LangSmith en minutos, no horas. Esto permite que un equipo pequeño o una persona sola prototipe una aplicación de IA durante el fin de semana y, potencialmente, lance un servicio de pago el lunes.
Con herramientas de evaluación rigurosas, las empresas pueden evitar la vergüenza y el coste de publicar versiones defectuosas de IA (como el ejemplo de la introducción). LangSmith te permite comprobar el output de los LLM según criterios predefinidos como utilidad, coherencia, misoginia, o incluso evaluaciones personalizadas en lenguaje natural como «¿El contenido del resultado es un cliché?» o, en el caso de generar tarjetas de estudio, «¿La tarjeta incluye una pregunta de programación?».
LangSmith usa trazas para registrar casi todos los aspectos de las ejecuciones de LLM. Incluye métricas como latencia, recuento de tokens, coste de las ejecuciones y todo tipo de metadatos. La interfaz web te permite filtrar ejecuciones por porcentaje de errores, latencia, fecha o incluso por contenido de texto usando lenguaje natural. Esto significa que, si por ejemplo un tutor de IA empieza a fallar en sus respuestas a estudiantes reales, puedes publicar una corrección en pocas horas.
LangChain es el framework del que nace LangSmith y está centrado en la fase de desarrollo de LLM. Ofrece un diseño modular para encadenar varios LLM (agentes) e integrarlos con otras APIs como YouTube, Google Search, etc. LangSmith es la guinda, garantizando con sus potentes herramientas de evaluación y monitorización que los prototipos creados con LangChain rindan como esperas.
Echa un vistazo a nuestro tutorial de aplicaciones con LLM en LangChain para saber más sobre LangChain.
Otra gran función de LangSmith son los datasets. Sirven para mejorar cadenas, agentes o modelos de LangChain frente a un conjunto de ejemplos estandarizados antes del despliegue. Por ejemplo, podemos tener un archivo CSV con dos columnas: preguntas y respuestas para tarjetas de estudio en un formato específico.
Al convertir este archivo en un dataset de referencia, podemos indicar a los LLM que evalúen su propio output usando las métricas de garantía de calidad mencionadas.
Ahora veremos todas estas funciones con ejemplos, una a una.
En el desarrollo de apps de ML, recopilas datos, entrenas, ajustas, pruebas y despliegas modelos: los pasos están bien definidos. Con apps de LLM, sin embargo, a menudo empiezas con un modelo ya hecho de un proveedor. ¿Fine-tuning? Puede ser caro. Así que te centrarás mucho en diseñar los prompts adecuados: todo consiste en hacerle las preguntas correctas a tu app con LLM. Piénsalo como necesitar muchos prompts para probar cosas, igual que necesitas muchos datos para un buen modelo de ML.
Sin embargo, con los prompts tratas con textos de entrada y salida, no con números. Por eso, las formas habituales de medir error o precisión, como MSE o entropía cruzada, aquí no funcionan. Además, imaginar revisar cada entrada y salida para evaluar: te llevaría días si tienes miles de prompts que verificar.
Necesitas, por tanto, un flujo de trabajo centrado en crear y probar estos prompts con eficiencia para medir cómo va tu app con LLM sin ahogarte en comprobaciones manuales. Podría verse así:
En esta fase, prototiparás la base de tu aplicación usando frameworks como LangChain. Para un generador de tarjetas, tu prototipo puede incluir varios componentes encima del LLM que elijas del proveedor. Por ejemplo, puedes encadenarlo con:
y así sucesivamente (consulta qué componentes puedes añadir en esta página de la documentación de LangChain). Pero puedes recortar drásticamente tu tiempo de desarrollo usando cadenas preconfiguradas que ofrece LangChain para tareas comunes de alto nivel.
En esta fase, probarás tu aplicación contra tantos escenarios como puedas. Esto implica asegurarte de que cada componente añadido funcione bien, se encadene correctamente y produzca resultados consistentes y de calidad.
Dado que los LLM son no deterministas (no generan siempre el mismo resultado para la misma entrada) y por la complejidad de los componentes añadidos, pasarás la mayor parte del tiempo en esta etapa. Y LangSmith se creó con el único objetivo de acortar al máximo ese tiempo. Lo veremos a lo largo del tutorial.
Cuando tengas una aplicación viable, puedes desplegarla como una REST API. Una REST API básicamente convierte tus cadenas o agentes de LangChain en enlaces HTTPS a los que otros pueden enviar solicitudes para interactuar con tu modelo de IA. Ahora crearás la interfaz de usuario de tu servicio, como una aplicación de escritorio o, más comúnmente, un sitio web.
A día de hoy no hay una forma sencilla de hacerlo, pero los desarrolladores de LangChain están a punto de lanzar LangServe, que se integrará con FastAPI (¿no sería genial?). Echa un vistazo al adelanto en esta página de la documentación.
Ahora sí, vamos a trastear con LangSmith.
Empezaremos por la interfaz web. Está disponible en smith.langchain.com. Para acceder, debes registrarte y salir de la lista de espera, ya que actualmente está en beta cerrada.
Una vez dentro, la página de inicio se verá así:
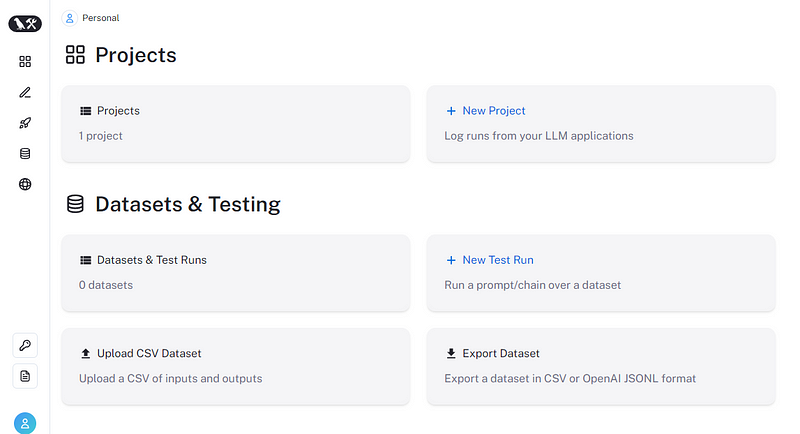
Las dos secciones principales son proyectos y datasets & testing, y ambas se pueden gestionar mediante el SDK de Python. La plataforma también tiene pestañas para despliegue y colas de anotación, pero quedan fuera del alcance de este artículo.
Gestionar proyectos en LangSmith es mucho más sencillo con su SDK de Python, que se conecta a la plataforma mediante una clave de API.
Para obtener una clave, haz clic en el icono de la llave en la plataforma y guárdala en un lugar seguro. Luego, en un directorio nuevo con un entorno virtual recién inicializado, crea un archivo .env. Dentro, pega estas dos líneas:
LANGCHAIN_API_KEY="LangSmith-API-key"
OPENAI_API_KEY="Your-OPENAI-key"
A continuación, en tu terminal, ejecuta estos comandos para instalar LangSmith y python-dotenv para leer las variables de entorno:
python-dotenv to read environment variables:
pip install -U langsmith
pip install python-dotenv
Hora de escribir código:
import warnings

from dotenv import find_dotenv, load_dotenv

warnings.filterwarnings("ignore")
Importamos las funciones find_dotenv y load_dotenv para leer variables de entorno y las configuramos con os:
import os

load_dotenv(find_dotenv())
os.environ["LANGCHAIN_API_KEY"] = str(os.getenv("LANGCHAIN_API_KEY"))
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_ENDPOINT"] = "https://api.smith.langchain.com"
Al poner LANGCHAIN_TRACING_V2 en True activas el tracing (registro), esencial para depurar LLM. Después, inicializamos un cliente para hablar con la plataforma LangSmith:
from langsmith import Client

# Initialize a client
client = Client()
client incluye comandos de alto nivel para manipular proyectos y recursos en LangSmith. El primer comando que usaremos es crear un proyecto nuevo:
import uuid

# Create id
uid = uuid.uuid4()
# Create a unique name
PROJECT_NAME = "flashcards-generator-" + str(uid)
# Create the project
session = client.create_project(
   project_name=PROJECT_NAME,
   description="A project that generates flashcards from user input",
)
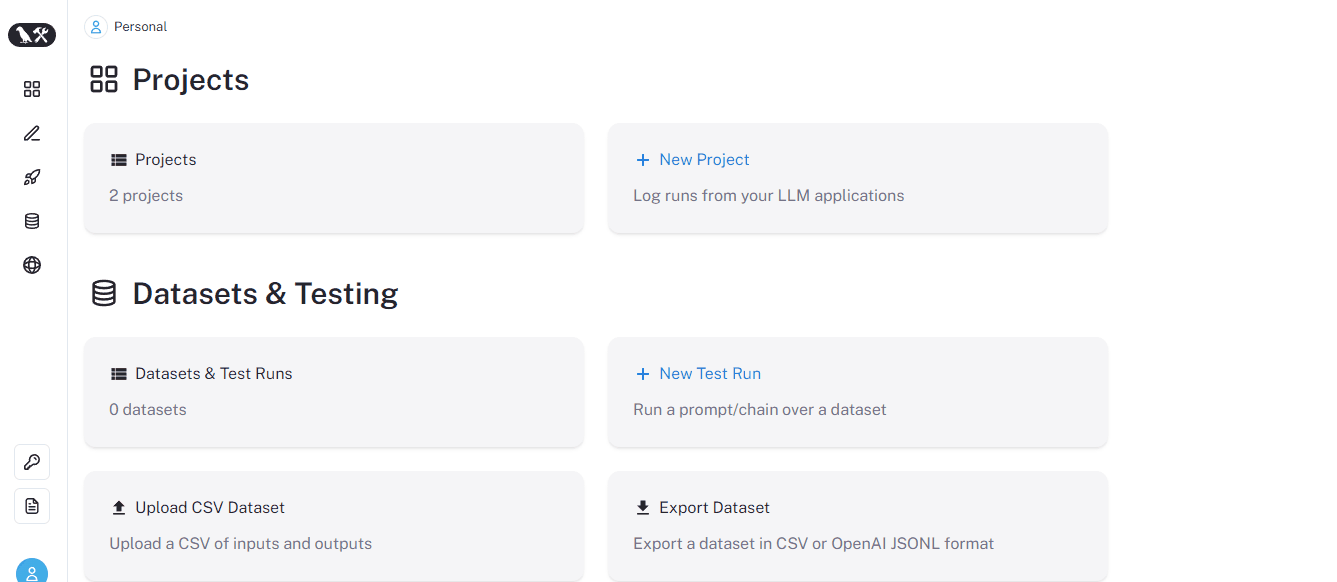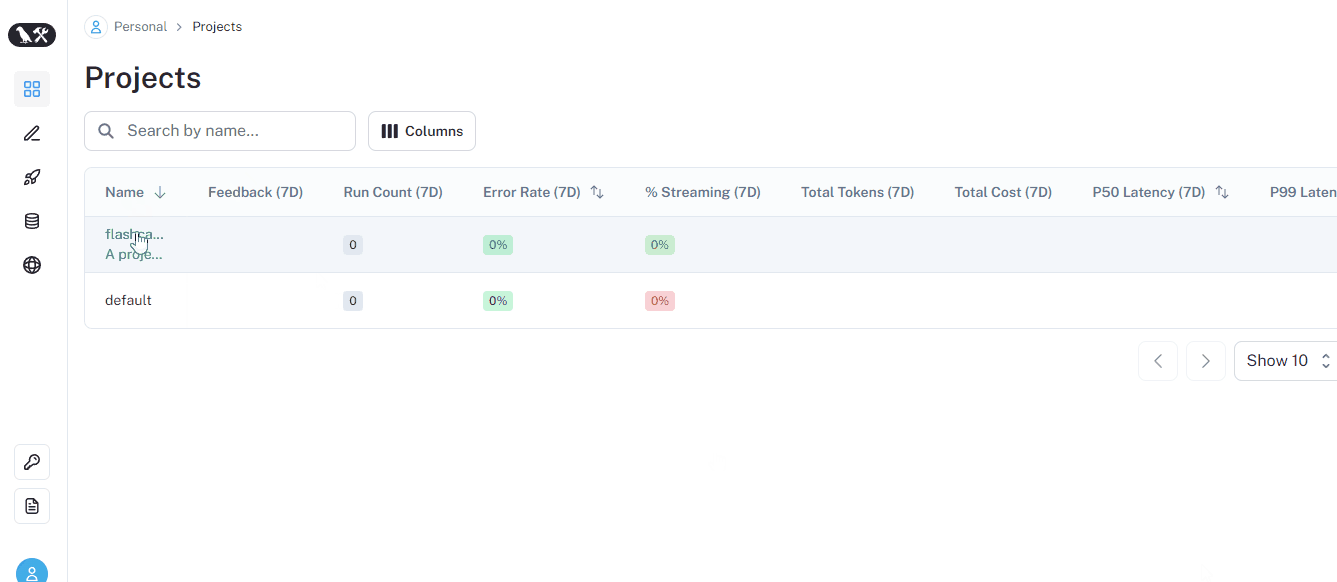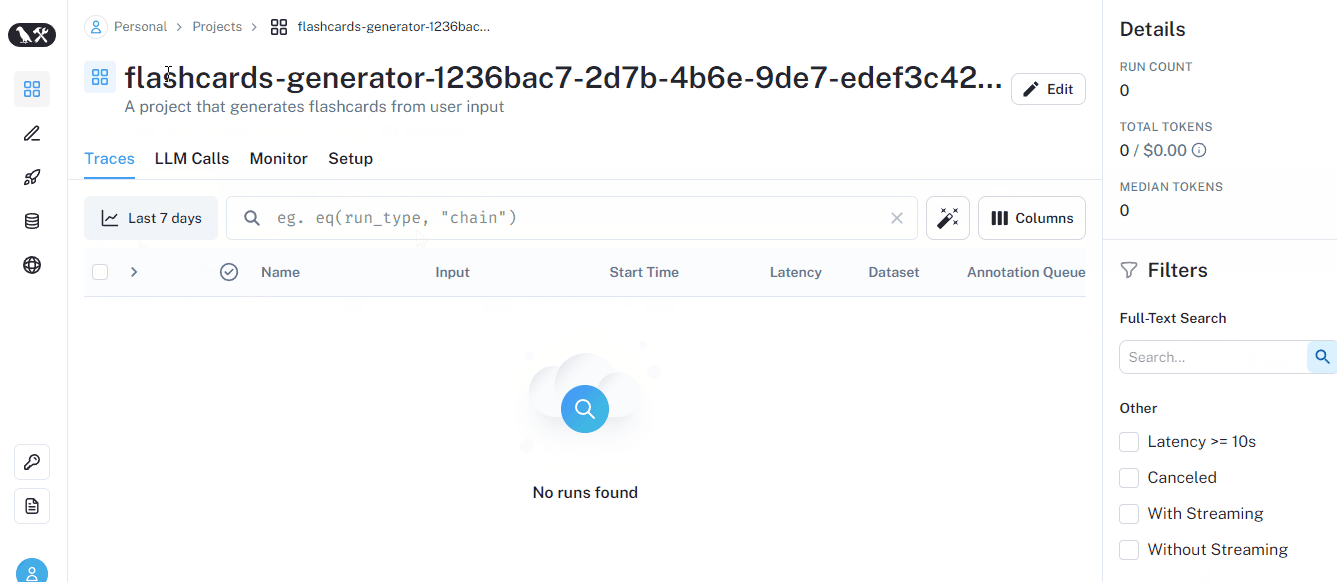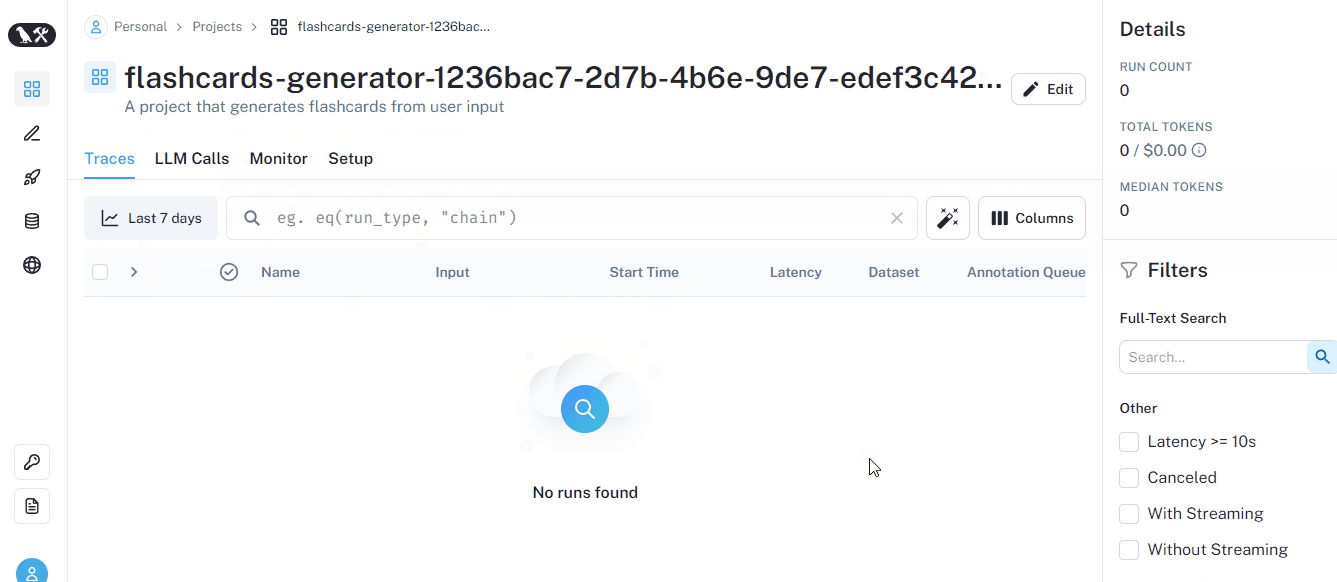
Tras ejecutar correctamente create_project, verás el proyecto en la sección Projects de la interfaz web:
Ahora debemos establecer el nuevo proyecto como predeterminado con otra variable de entorno:
os.environ["LANGCHAIN_PROJECT"] = PROJECT_NAME
Necesitamos un LLM para nuestro proyecto. Usaremos GPT-3.5 turbo porque es más económico, pero puedes usar muchos otros modelos disponibles a través de langchain. Los modelos de OpenAI se inicializan con la clase ChatOpenAI.
from langchain.chat_models import ChatOpenAI

llm = ChatOpenAI()  # Uses gpt-3.5-turbo by default
Hagamos nuestra primera ejecución:
llm.invoke("Hello, chatty, how you doin' today?")

AIMessage(content="Hello! I'm an AI language model, so I don't have feelings, but I'm here to help you. How can I assist you today?")
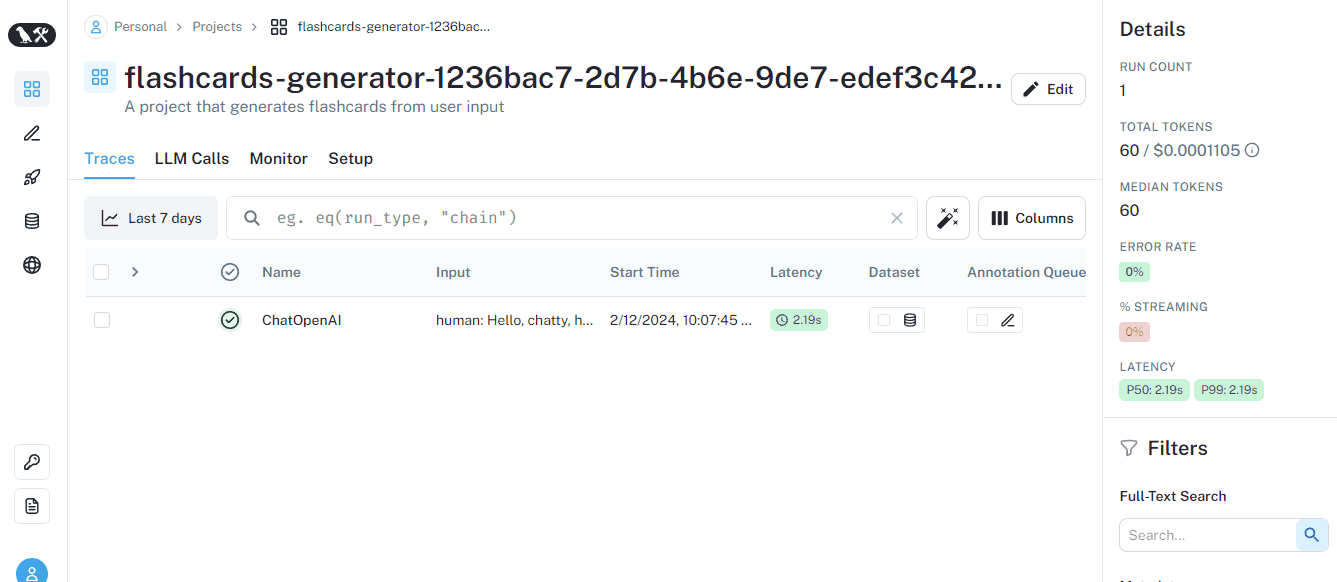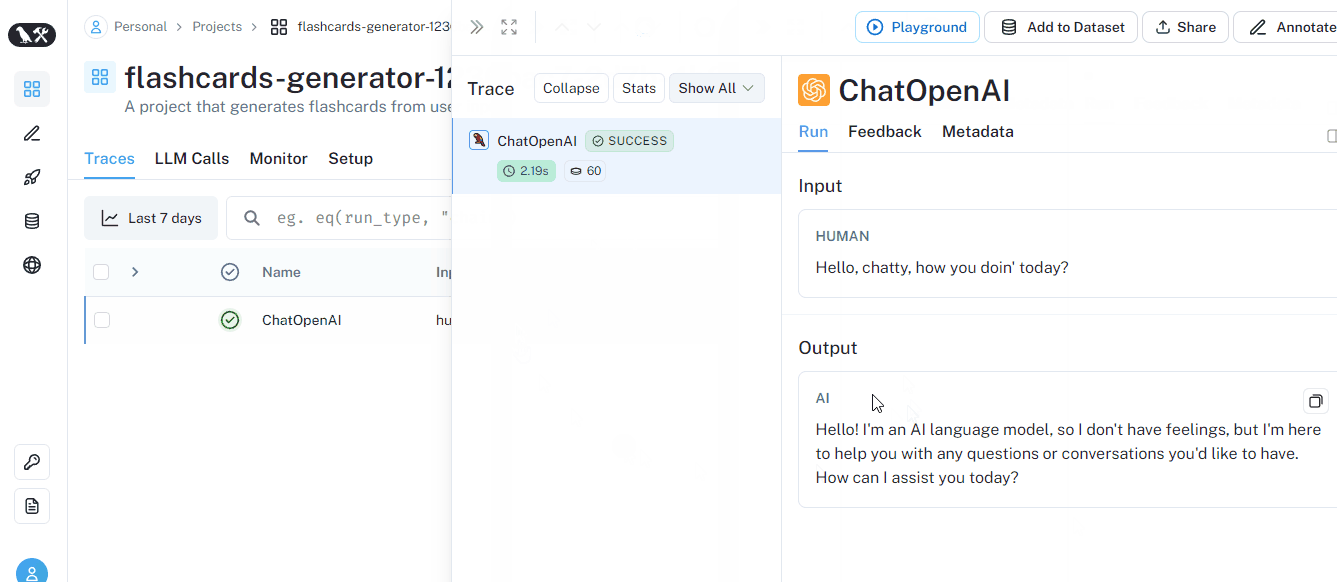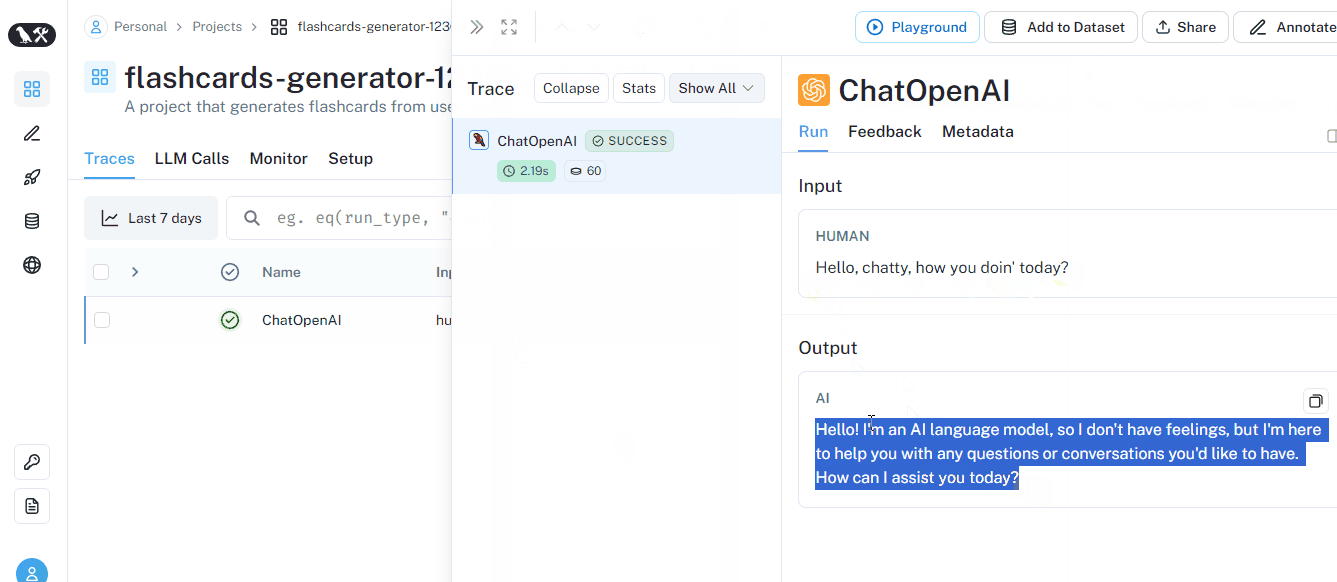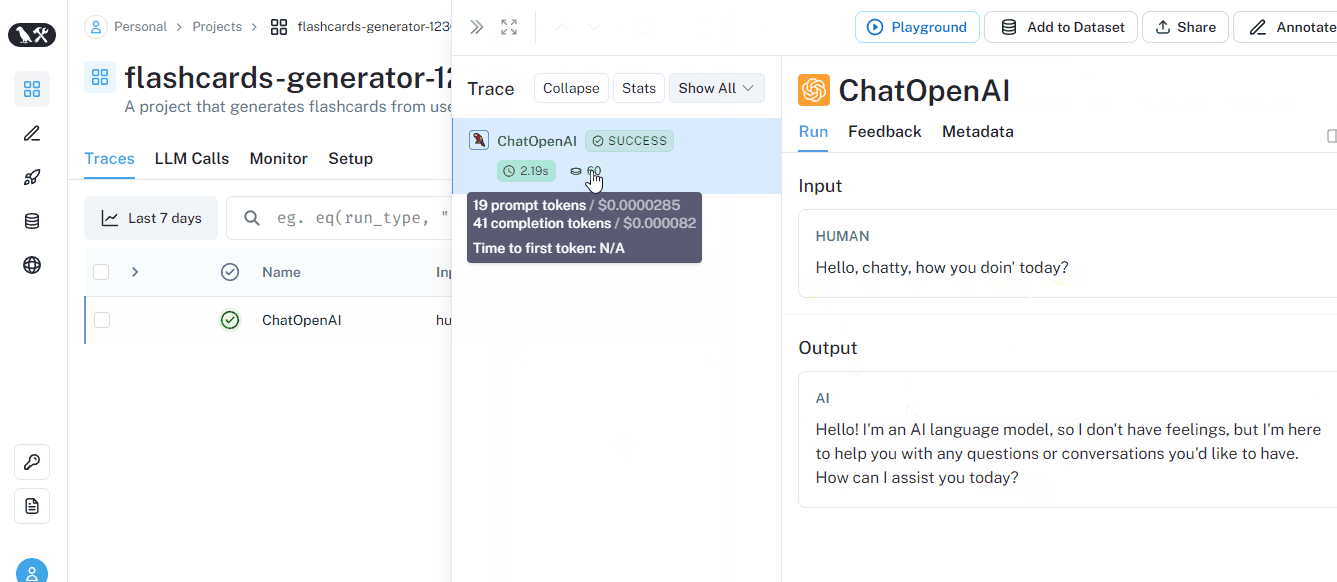
Si vas un momento al proyecto desde la interfaz, verás esta ejecución registrada (trazada):
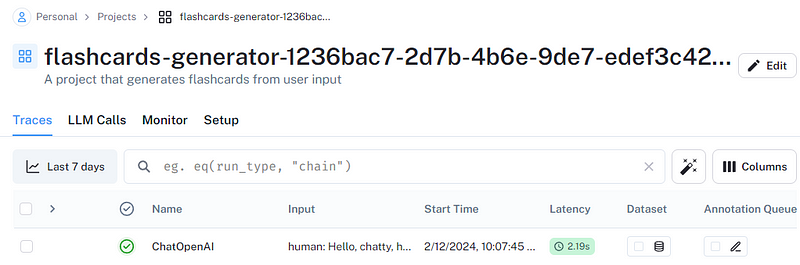
Al configurar las variables de entorno y el cliente, activamos el registro automáticamente. Como ves, ya tenemos un buen conjunto de metadatos sobre la ejecución.
Lanzamos un par de prompts más:
message = llm.invoke("Do you know how to generate flashcards?")

message.content[:50]

'Yes, I can help you generate flashcards. There are'
Ya podemos montar un resumidor básico de texto. Resumamos la salida de la última ejecución:
prompt = f"Summarize this text: {message.content}"

summary = llm.invoke(prompt)
summary.content

'The text explains different methods for creating flashcards. These methods include writing on small index cards, using online flashcard generators, utilizing flashcard apps on mobile devices, and using word processing software like Microsoft Word or Google Docs. It emphasizes the importance of consistency in format and organization for effective studying.'
Genial, toca crear nuestro primer dataset.
Como comenté en la sección «Flujo de trabajo de desarrollo de aplicaciones con LLM», probablemente necesites crear o recopilar miles de prompts para evaluar tu modelo, cadena o agente con LLM. Así que ejecutarlos uno a uno como arriba no es lo ideal.
Por eso, LangSmith ofrece datasets de tres tipos:
kv) - por defecto: define entradas como pares clave-valor arbitrarios. Útiles al evaluar cadenas y agentes que requieren múltiples entradas o devuelven múltiples salidas.llm): entradas y salidas definidas en estilo "completion" por LLM — cadena de texto de entrada, cadena de salida.chat): datasets convertidos desde chats con LLM y definidos con entradas estructuradas y mensajes serializados.Primero, veamos cómo crear un dataset key-value sin salidas. Usaremos la función create_dataset del client:
create_dataset function of the client:
dataset_name = "deep_learning_fundamentals"

# Creating a blank dataset
dl_dataset = client.create_dataset(
   dataset_name=dataset_name,
   description="A deck containing flashcards on NNs and PyTorch",
   data_type="kv",  # default
)
Ahora añadimos tres entradas que piden al LLM crear una única tarjeta cada una:
# Storing only inputs into a dataset
example_inputs = [
   "Generate a single flashcard on backpropagation",
   "Generate a single flashcard on the use of torch.no_grad",
   "Generate a single flashcard on how Adam optimizer",
]

for ex in example_inputs:
   # Each example input must be unique
   # The output is optional
   client.create_example(
       inputs={"input": ex},
       outputs=None,
       dataset_id=dl_dataset.id,
   )
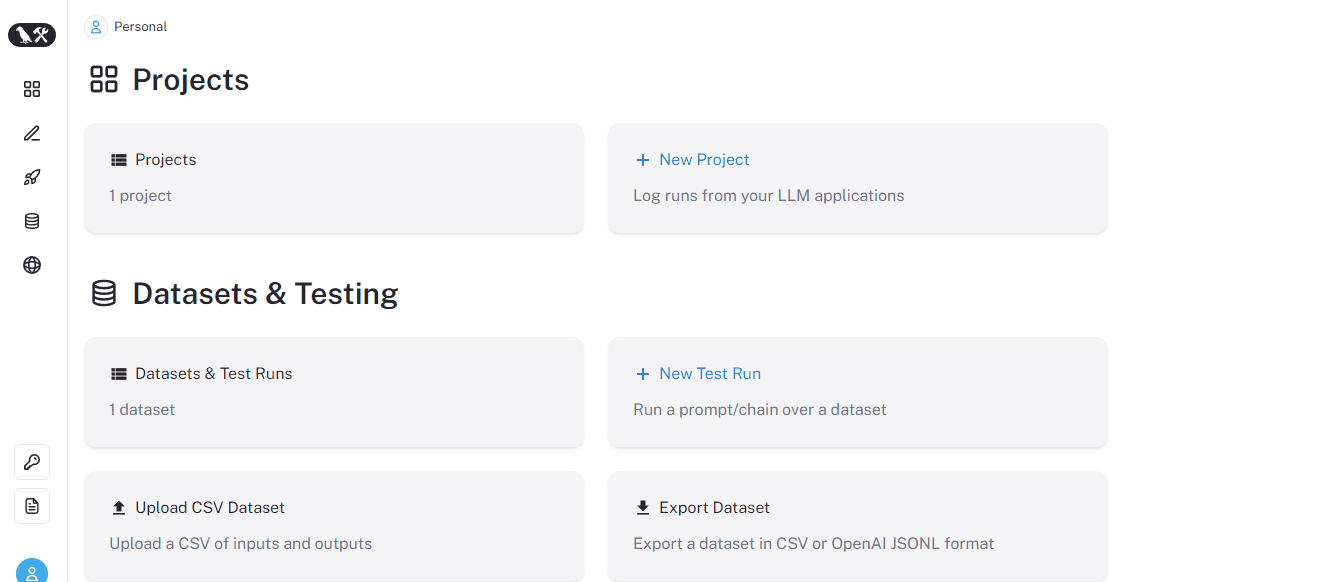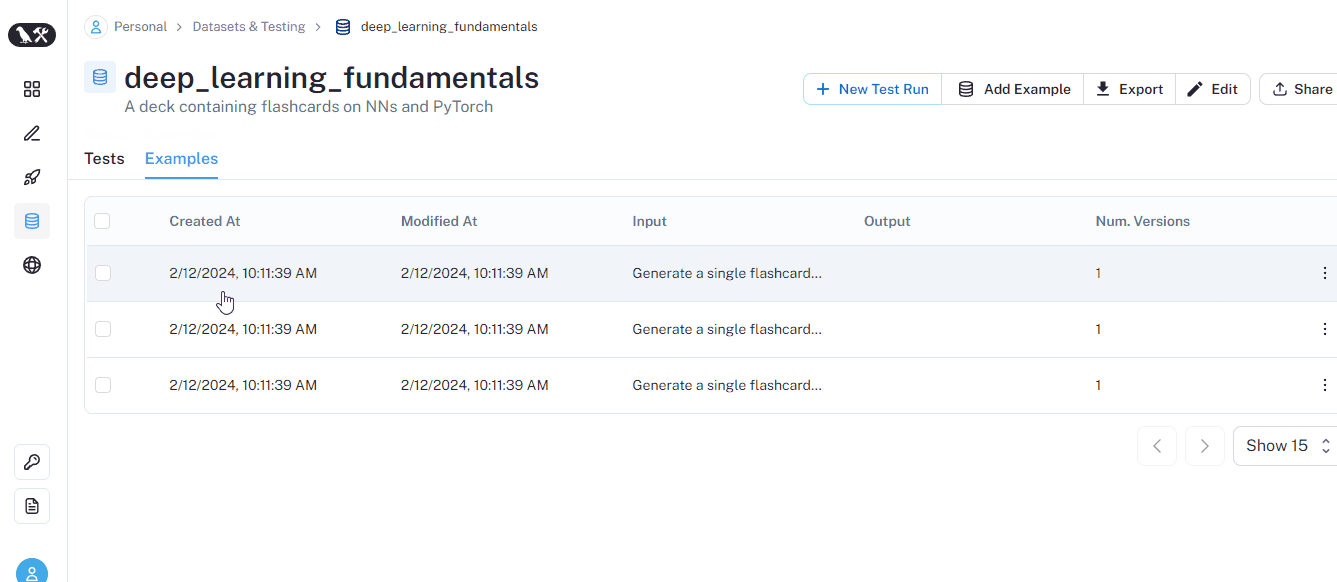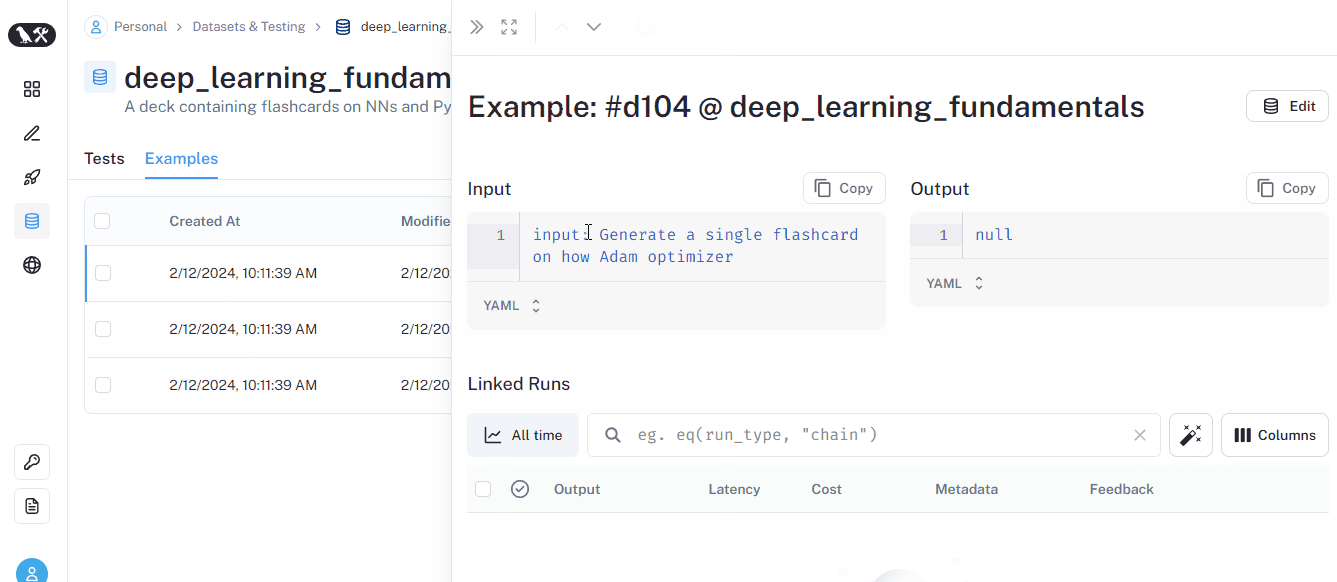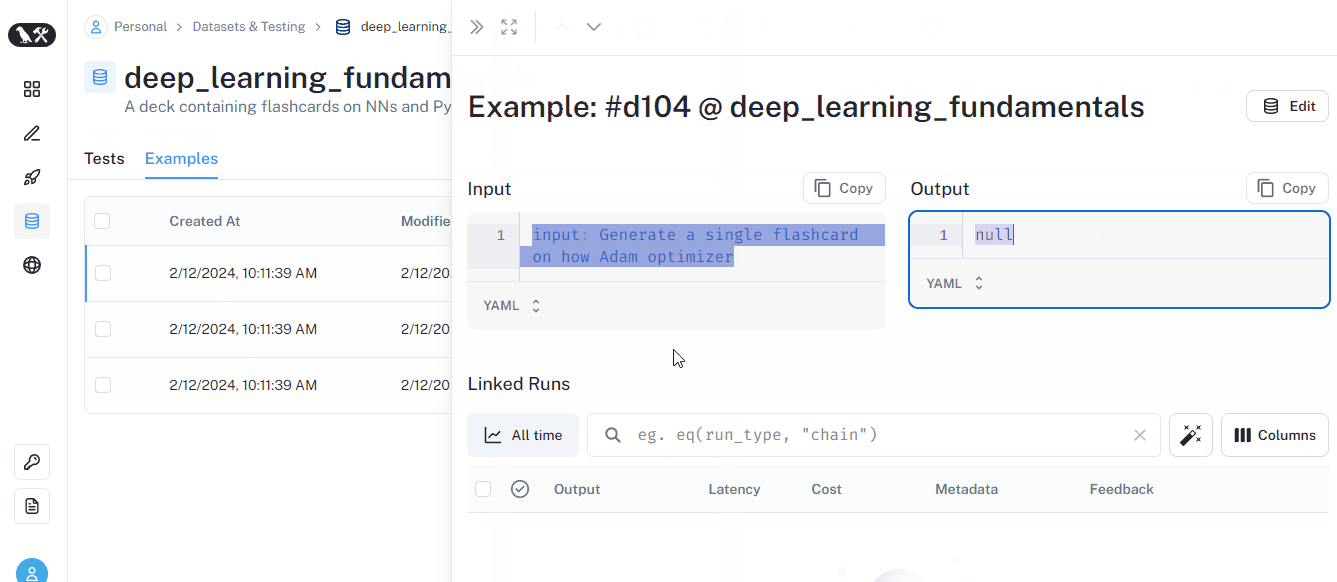
Si vas a la pestaña del dataset en la interfaz, verás cada prompt listado con salida NULL:
Ahora ejecutemos todos los prompts en una sola línea de código usando la función run_on_dataset:
from langchain.smith import run_on_dataset

results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   project_name="unlabeled_test",
)
Cuando termine la ejecución, aparecerá listada en la página del dataset. Así se ve:
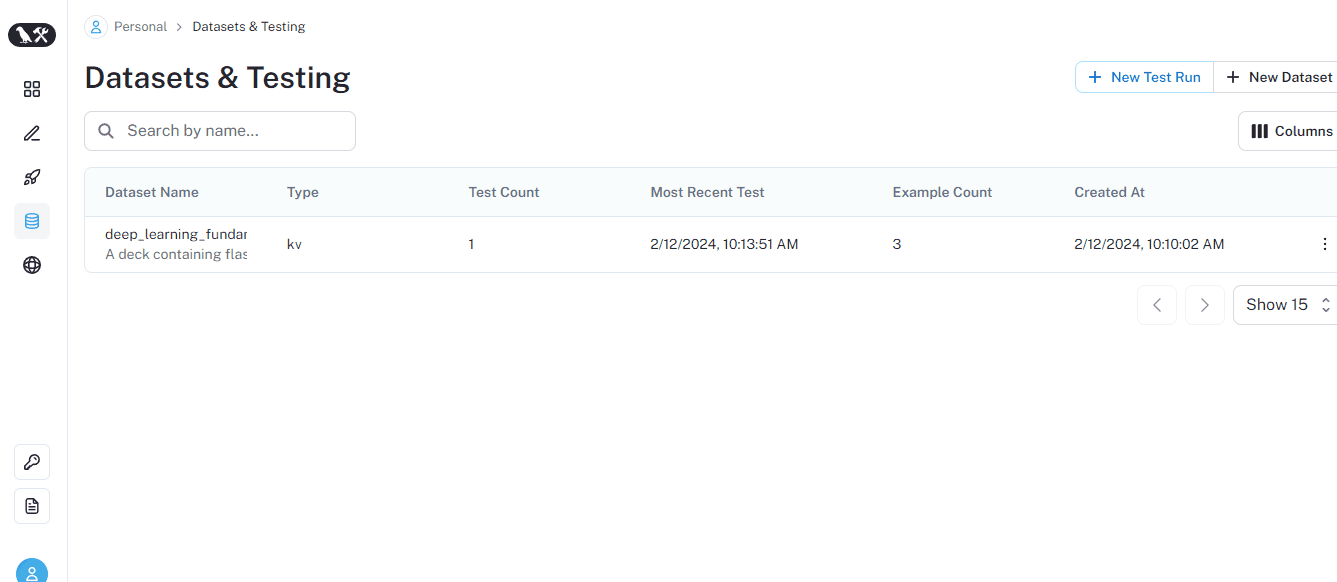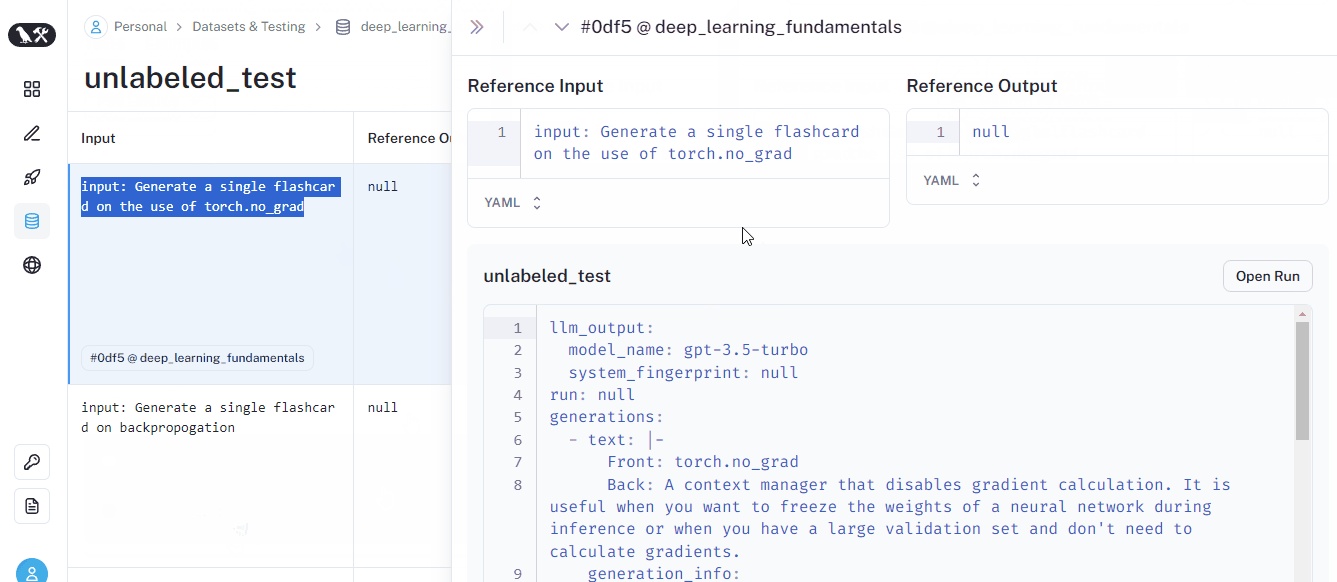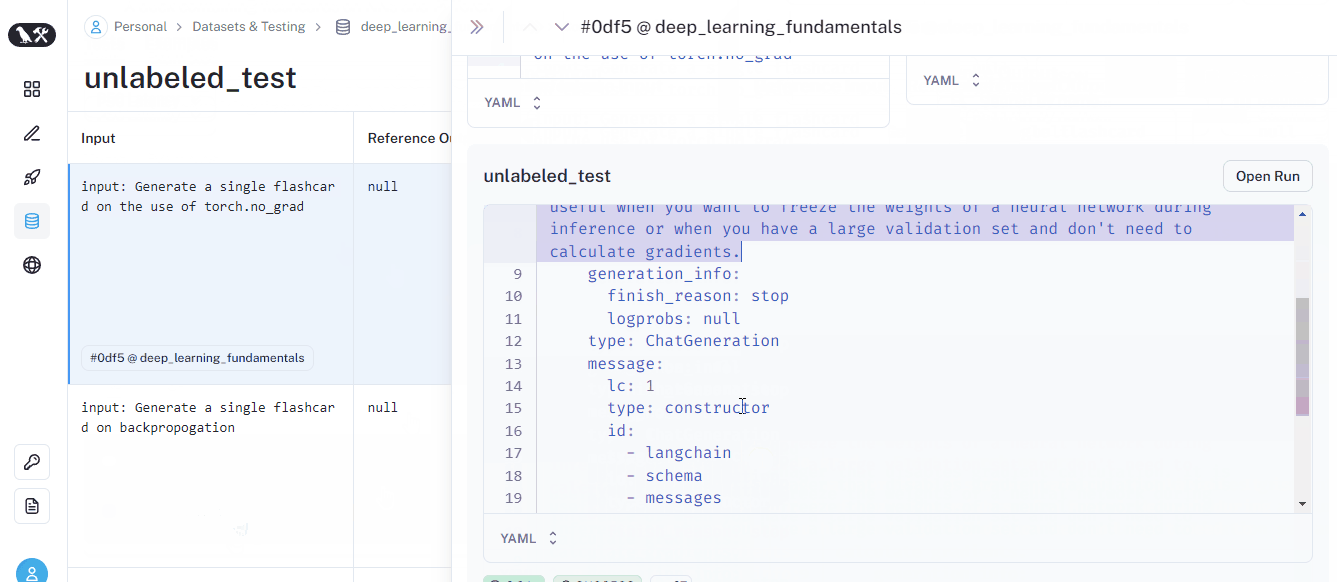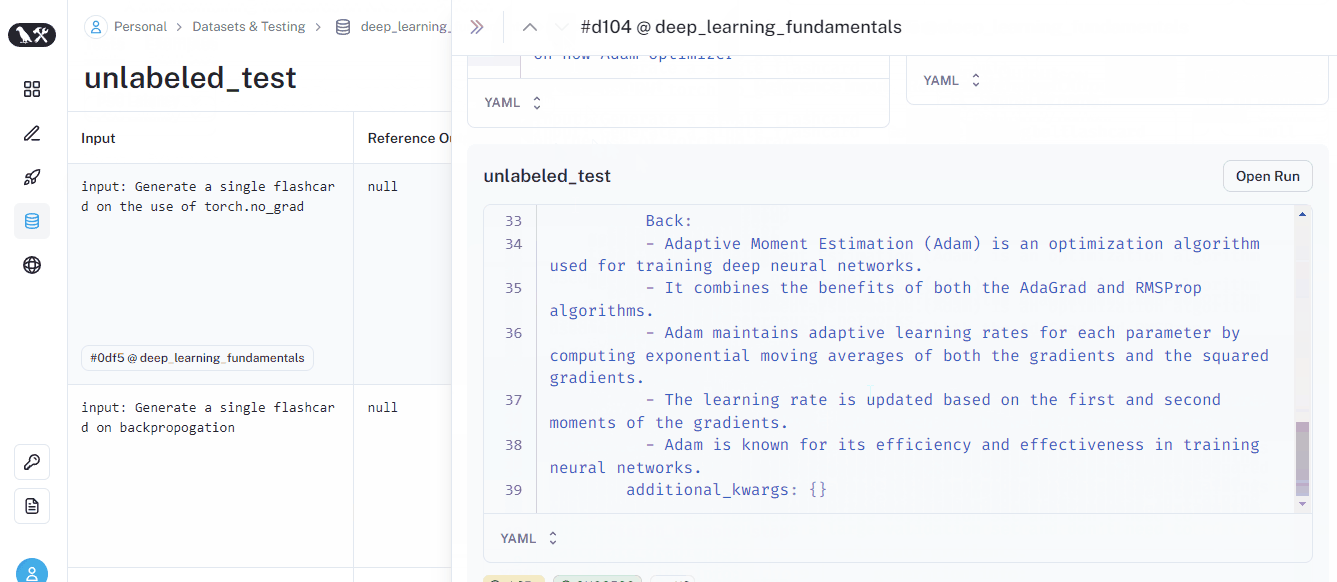
Acabamos de hacer una prueba sobre un dataset sin etiquetas — un dataset con prompts de ejemplo pero sin salidas de ejemplo. Nuestra prueba simplemente generó una respuesta a cada prompt, pero no evaluó nada. Nos gustaría hacer comprobaciones básicas como «¿El resultado es útil?» o «¿La respuesta es corta o larga?».
LangSmith nos permite realizar esas comprobaciones con evaluadores integrados.
Para ejecutar evaluaciones de conciseness y coherence usando los tres prompts de nuestro dataset, podemos usar la clase RunEvalConfig:
from langchain.smith import RunEvalConfig

# List the eval criteria
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria("conciseness"),
       RunEvalConfig.Criteria("coherence"),
   ]
)
Arriba definimos dos criterios en una lista llamada evaluators. Pasamos estos evaluadores al parámetro evaluation de la función run_on_dataset:
results = run_on_dataset(
   client=client,
   dataset_name=dataset_name,
   llm_or_chain_factory=llm,
   evaluation=eval_config,
   project_name="criteria_test",
)
run_on_dataset es una función muy práctica para ejecutar todos los prompts de un dataset con el LLM indicado y realizar cualquier tipo de evaluación sobre la marcha. Sus resultados se verán en la página dedicada de cada dataset:
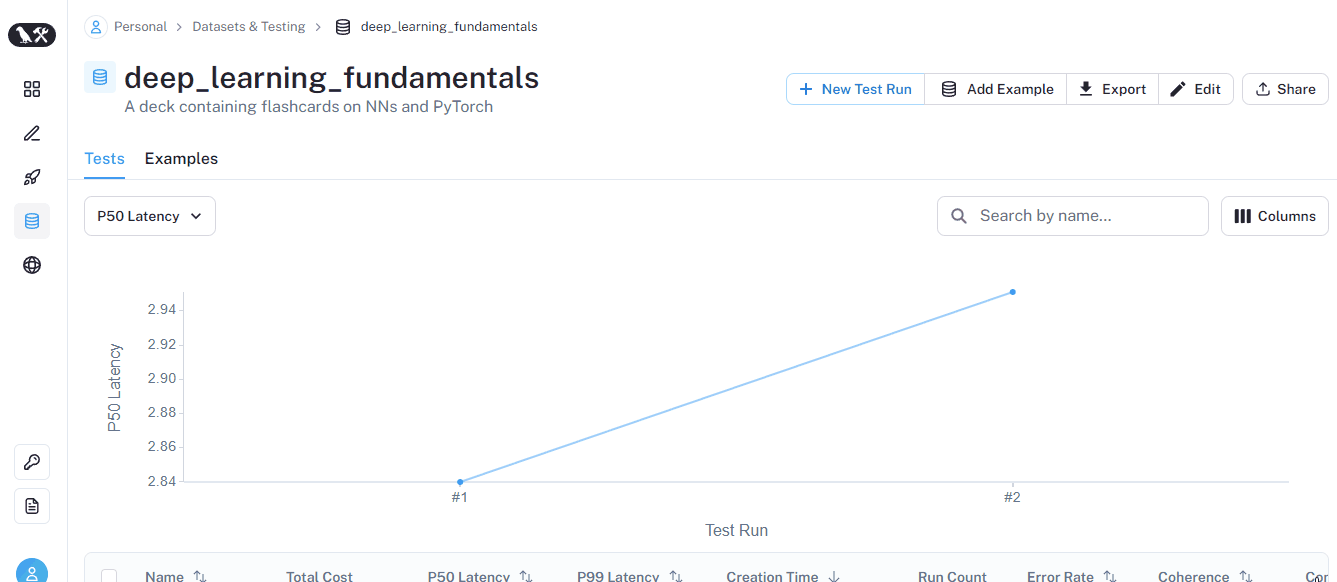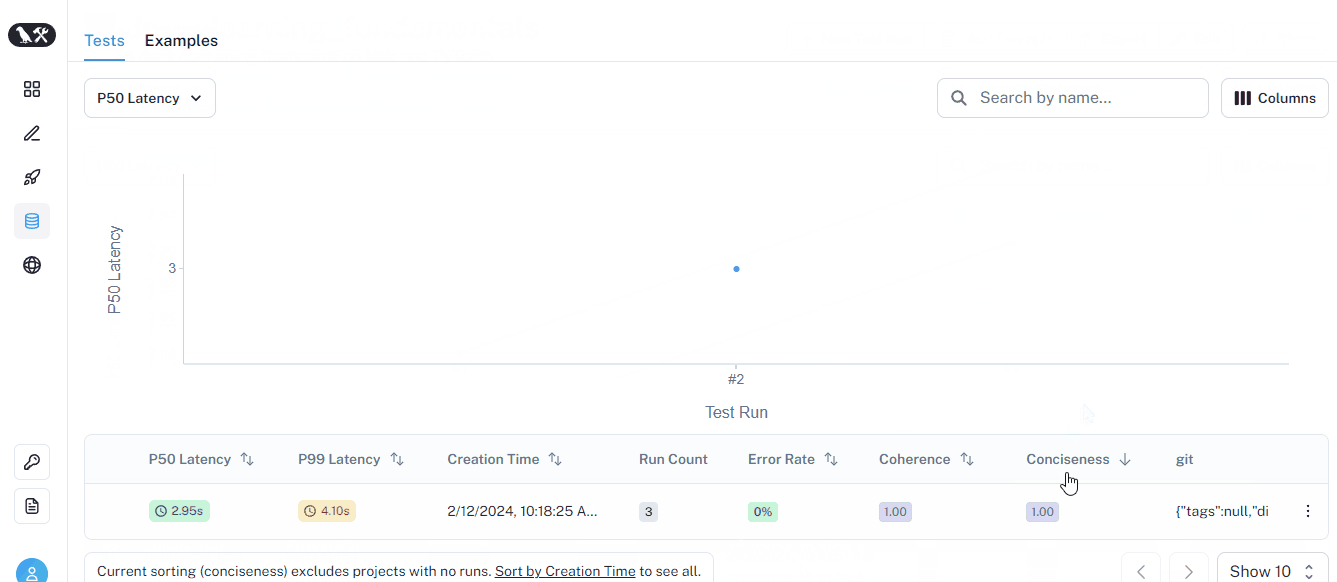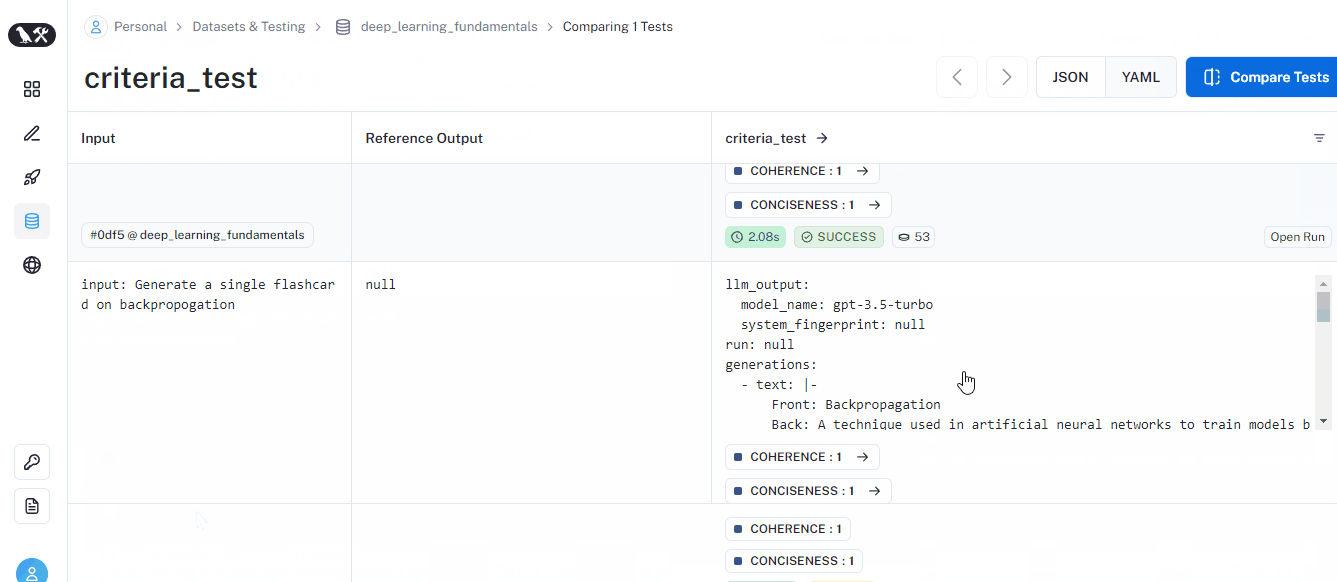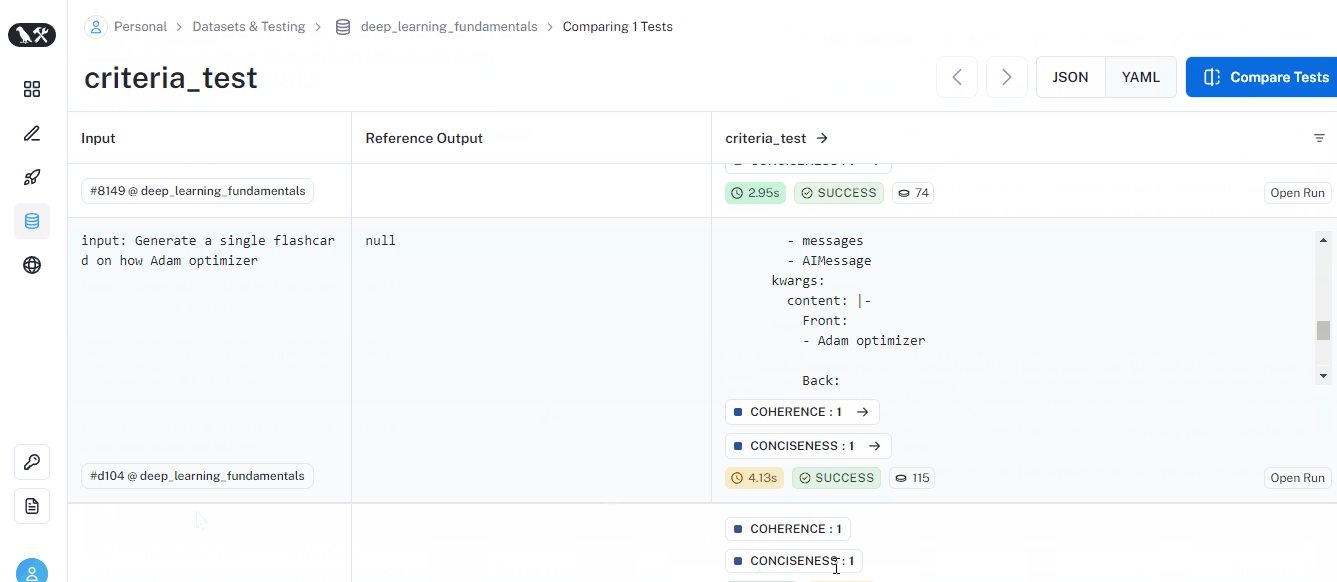
Esta vez, la ejecución incluye métricas de coherencia y concisión para cada prompt. Abajo también verás una puntuación media para cada métrica.
Para ver la lista de todos los criterios integrados, ejecuta este fragmento:
from langchain.evaluation import Criteria

list(Criteria)

[<Criteria.CONCISENESS: 'conciseness'>,
<Criteria.RELEVANCE: 'relevance'>,
<Criteria.CORRECTNESS: 'correctness'>,
<Criteria.COHERENCE: 'coherence'>,
<Criteria.HARMFULNESS: 'harmfulness'>,
<Criteria.MALICIOUSNESS: 'maliciousness'>,
<Criteria.HELPFULNESS: 'helpfulness'>,
<Criteria.CONTROVERSIALITY: 'controversiality'>,
<Criteria.MISOGYNY: 'misogyny'>,
<Criteria.CRIMINALITY: 'criminality'>,
<Criteria.INSENSITIVITY: 'insensitivity'>,
<Criteria.DEPTH: 'depth'>,
<Criteria.CREATIVITY: 'creativity'>,
<Criteria.DETAIL: 'detail'>]
Está claro que no todos los casos de uso de LLM se cubren con evaluadores básicos. Por ejemplo, no hay un evaluador para comprobar si una tarjeta contiene una pregunta de código o no. Así que mejor lo definimos:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)
Para pasar un criterio personalizado en lenguaje natural, simplemente pasamos {"criteria_name": "Condition to check"} a la clase Criteria. Arriba estamos creando dos evaluadores extra, así que LangSmith ejecutará dos prompts adicionales sobre el output producido por los prompts de nuestro dataset:
# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test",
)
Si revisas la ejecución, verás los criterios personalizados que definimos bajo cada prompt. Si pasas el ratón por encima, obtendrás el razonamiento del LLM a continuación:
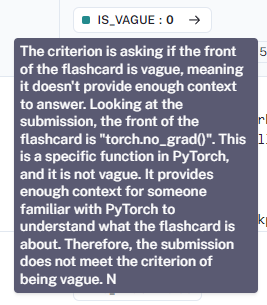
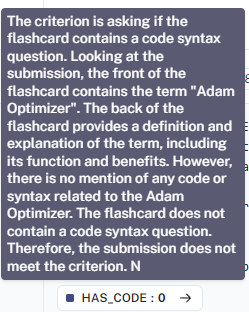
Al revisar los resultados de evaluación de todos los prompts, verás que nuestros criterios no están evaluando como esperábamos. Así que aquí va una idea: también necesitas afinar los prompts de tus criterios para asegurar que comprueban lo correcto.
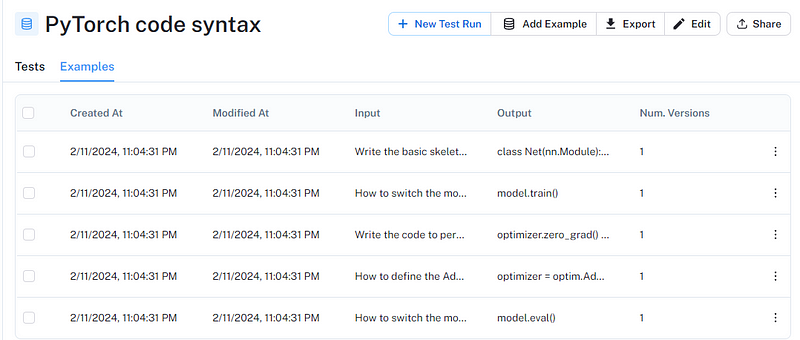
A veces puedes decidir crear un dataset de prompts con salidas esperadas, es decir, datasets etiquetados. Puedes crearlos en varios formatos, pero quizá el más común sea un archivo CSV. Por ejemplo, aquí tienes un archivo que generé con ChatGPT que contiene cinco preguntas sobre sintaxis de PyTorch:
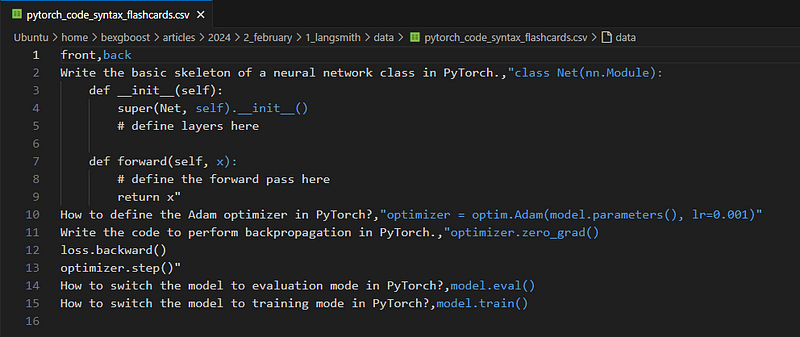
Para crear un dataset a partir de esto, usamos la función upload_csv:
dataset_name = "PyTorch code syntax"

csv_path = "data/pytorch_code_syntax_flashcards.csv"
input_keys = ["front"]
output_keys = ["back"]

csv_dataset = client.upload_csv(
   csv_file=csv_path,
   input_keys=input_keys,
   output_keys=output_keys,
   name=dataset_name,
   data_type="kv",
)
La función tiene tres parámetros obligatorios: la ruta del CSV y los nombres de las columnas de entrada/salida. Cuando termine la subida, el dataset aparecerá en la interfaz:
Ejecutemos también nuestro criterio personalizado de la sección anterior sobre este dataset:
eval_config = RunEvalConfig(
   evaluators=[
       RunEvalConfig.Criteria(
           {"has_code": "Does the card contain a code syntax question?"}
       ),
       RunEvalConfig.Criteria(
           {
               "is_vague": "Is the front of the flashcard vague, meaning it hasn't enough context to answer?"
           }
       ),
   ]
)

# Run the evaluation
results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="custom_criteria_test_csv",
)
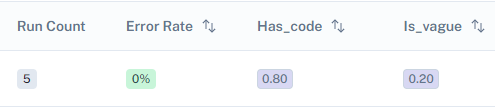
Si vas a la página del dataset y revisas la ejecución, verás las puntuaciones medias para cada criterio personalizado:
Los evaluadores integrados y los personalizados escritos en lenguaje natural se usan sobre todo para datasets sin etiquetas. Para datasets etiquetados como el CSV que subimos, LangSmith ofrece evaluadores más completos para medir la corrección de la respuesta a un prompt:
context_qa (Q&A contextual): usa la salida de referencia como contexto al evaluar la correcciónqa (Q&A): instruye al LLM para calificar directamente una respuesta como "correct" o "incorrect" usando la salida de referenciacot_qa (Chain-of-thought Q&A): similar a context_qa pero obliga al LLM a razonar con chain-of-thought antes del veredicto.Probemos el último con nuestros ejemplos:
eval_config = RunEvalConfig(evaluators=[RunEvalConfig.CoTQA()])

results = run_on_dataset(
   client,
   dataset_name,
   llm,
   evaluation=eval_config,
   project_name="cotqa_test",
)
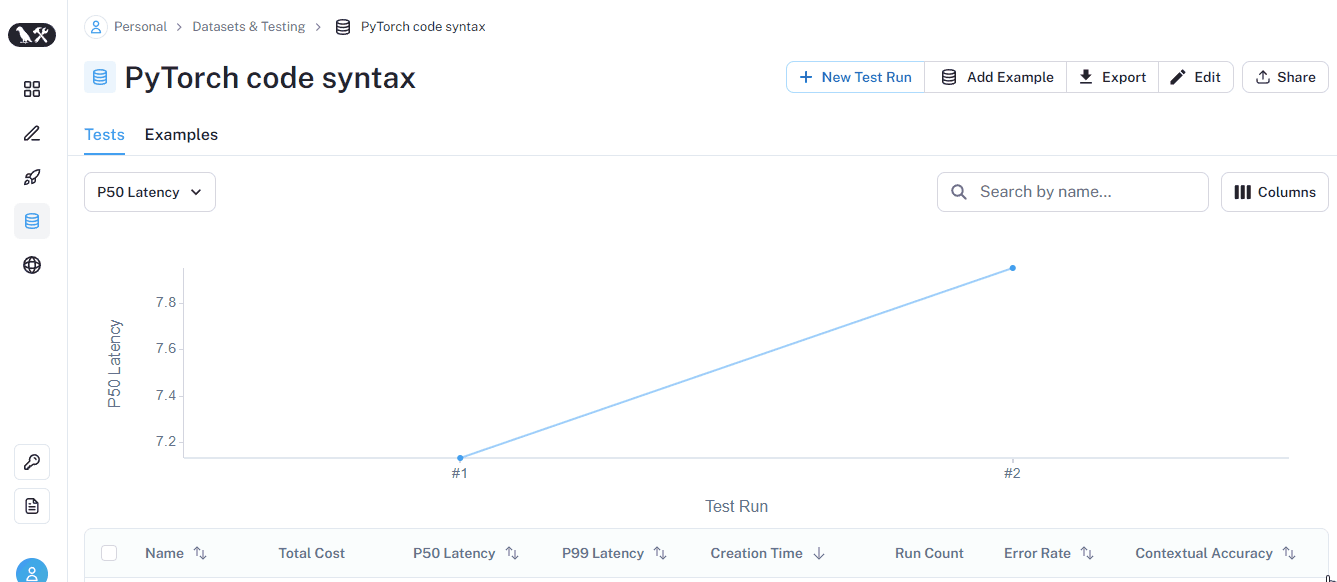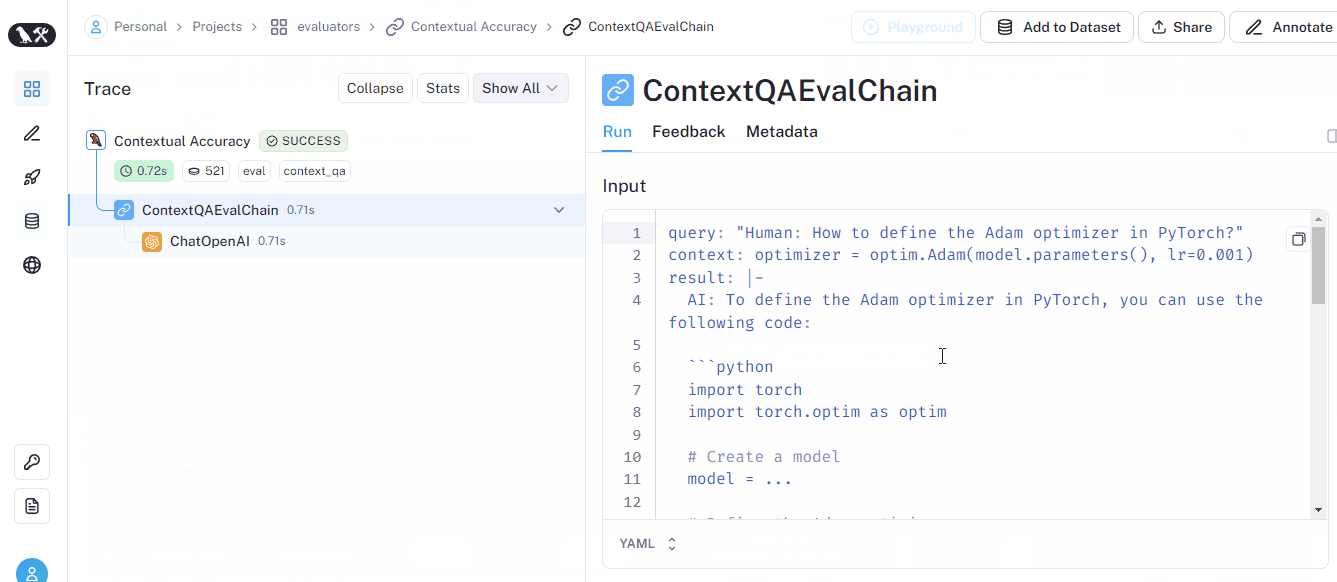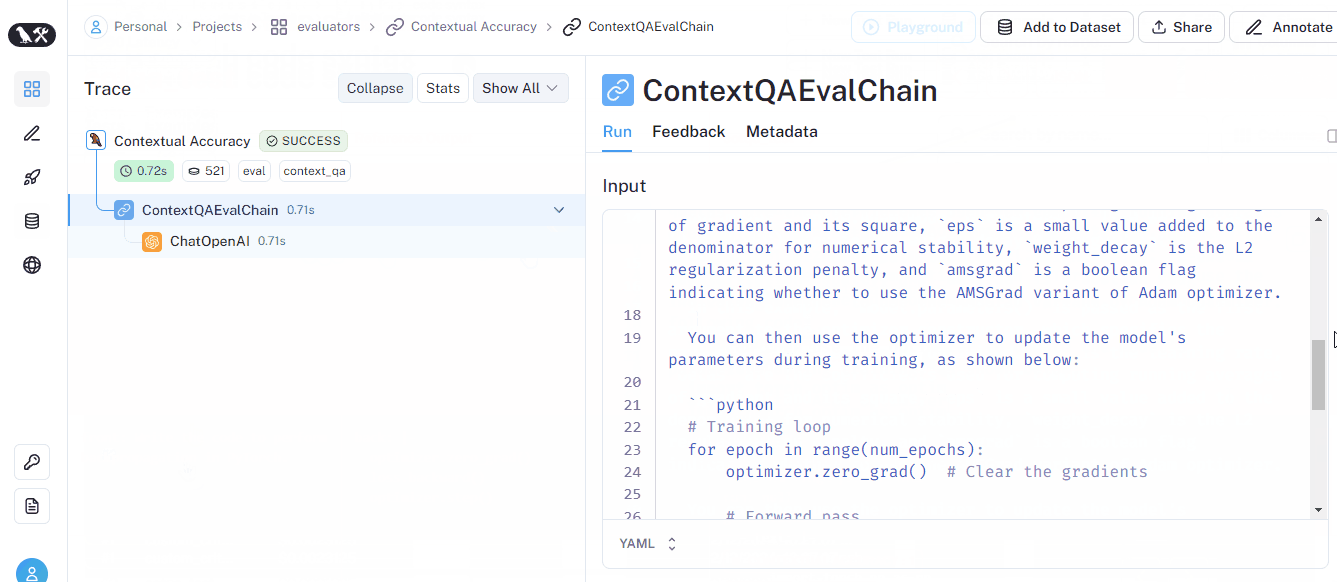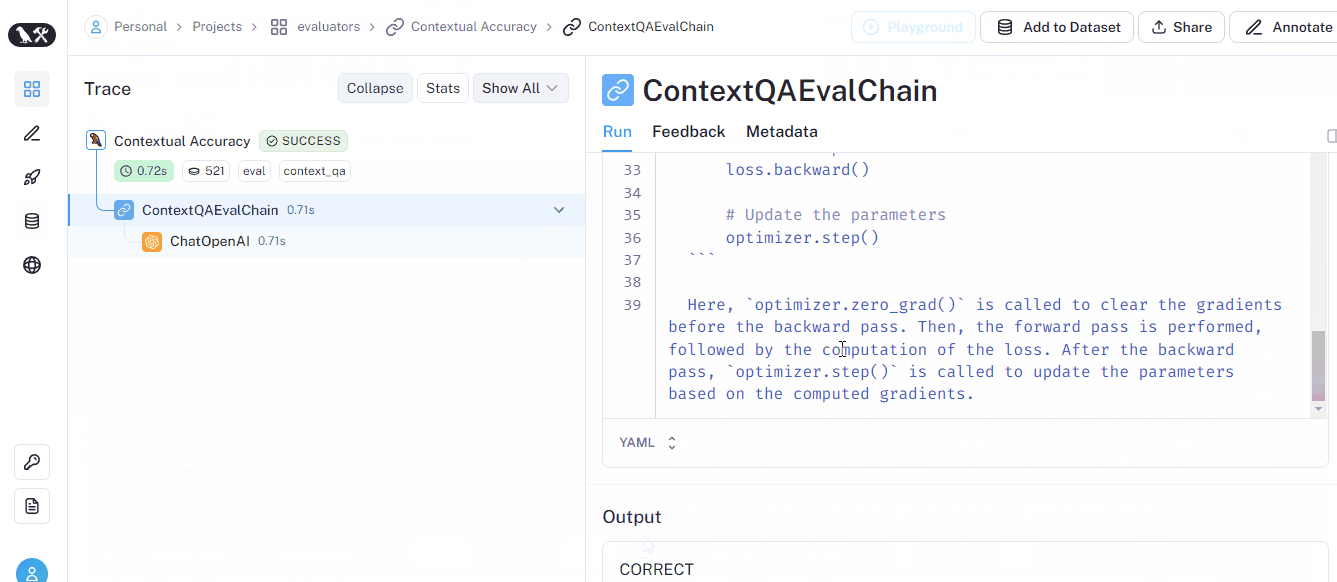
El criterio CoTQA devuelve una puntuación llamada Contextual accuracy, como se muestra en el GIF de abajo (también visible en la interfaz):
Visita la sección de evaluadores de LangChain en la documentación de LangSmith para aprender mucho más sobre ellos.
Si tras leer este tutorial te ha dado la impresión de que LangSmith es, en esencia, una herramienta compleja para el prompt engineering, vas bien encaminado. A día de hoy, LangSmith es el mejor framework para asegurarte de que las instrucciones y los resultados de los LLM sean realmente lo que quieres.
También habrás visto el esfuerzo que requiere crear aplicaciones con LLM de nivel producción. Así que usa LangSmith para trabajar de forma más fluida en tus proyectos con LLM.
Si algunos conceptos de LangSmith no te han quedado claros, puede que te falten algunos fundamentos de LangChain. Aquí tienes algunos recursos:
Empieza hoy tu camino con LangChain
Curso
Curso
Curso
blog
Abid Ali Awan
13 min
blog
Abid Ali Awan
10 min
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
11 min