{count, plural, one {Kursus} other {Kursus}}
Pengantar Deep Learning dengan Python
{hours} jam
264.7K
Dalam deep learning, sering ada banyak diskusi tentang tensor sebagai struktur data utama. Kata tensor bahkan muncul dalam nama pustaka machine learning andalan Google: “TensorFlow”. Tensor adalah jenis struktur data yang digunakan dalam aljabar linear, dan seperti vektor serta matriks, Anda dapat melakukan operasi aritmetika dengan tensor.
Di sisi lain, PyTorch adalah paket Python yang dibuat oleh Facebook yang menyediakan dua fitur tingkat tinggi: 1) Komputasi Tensor (seperti Numpy) dengan akselerasi GPU yang kuat dan 2) Jaringan Saraf Dalam yang dibangun di atas sistem diferensiasi otomatis berbasis tape.
Dalam tutorial ini, Anda akan mengetahui apa itu tensor dan bagaimana memanipulasinya di Python dengan PyTorch.
Jadi, tanpa berlama-lama mari mulai dengan pengantar Tensor.
Tensor adalah generalisasi dari vektor dan matriks dan mudah dipahami sebagai array multidimensi. Menurut buku deep learning populer berjudul "Deep Learning" (Goodfellow dkk.) -
"Secara umum, array angka yang disusun pada kisi reguler dengan jumlah sumbu variabel dikenal sebagai tensor."
Sebuah skalar adalah tensor orde nol atau tensor derajat nol. Vektor adalah tensor satu dimensi atau orde pertama, dan matriks adalah tensor dua dimensi atau orde kedua.
Info-grafik berikut menjelaskan tensor dengan cara yang sangat ringkas:
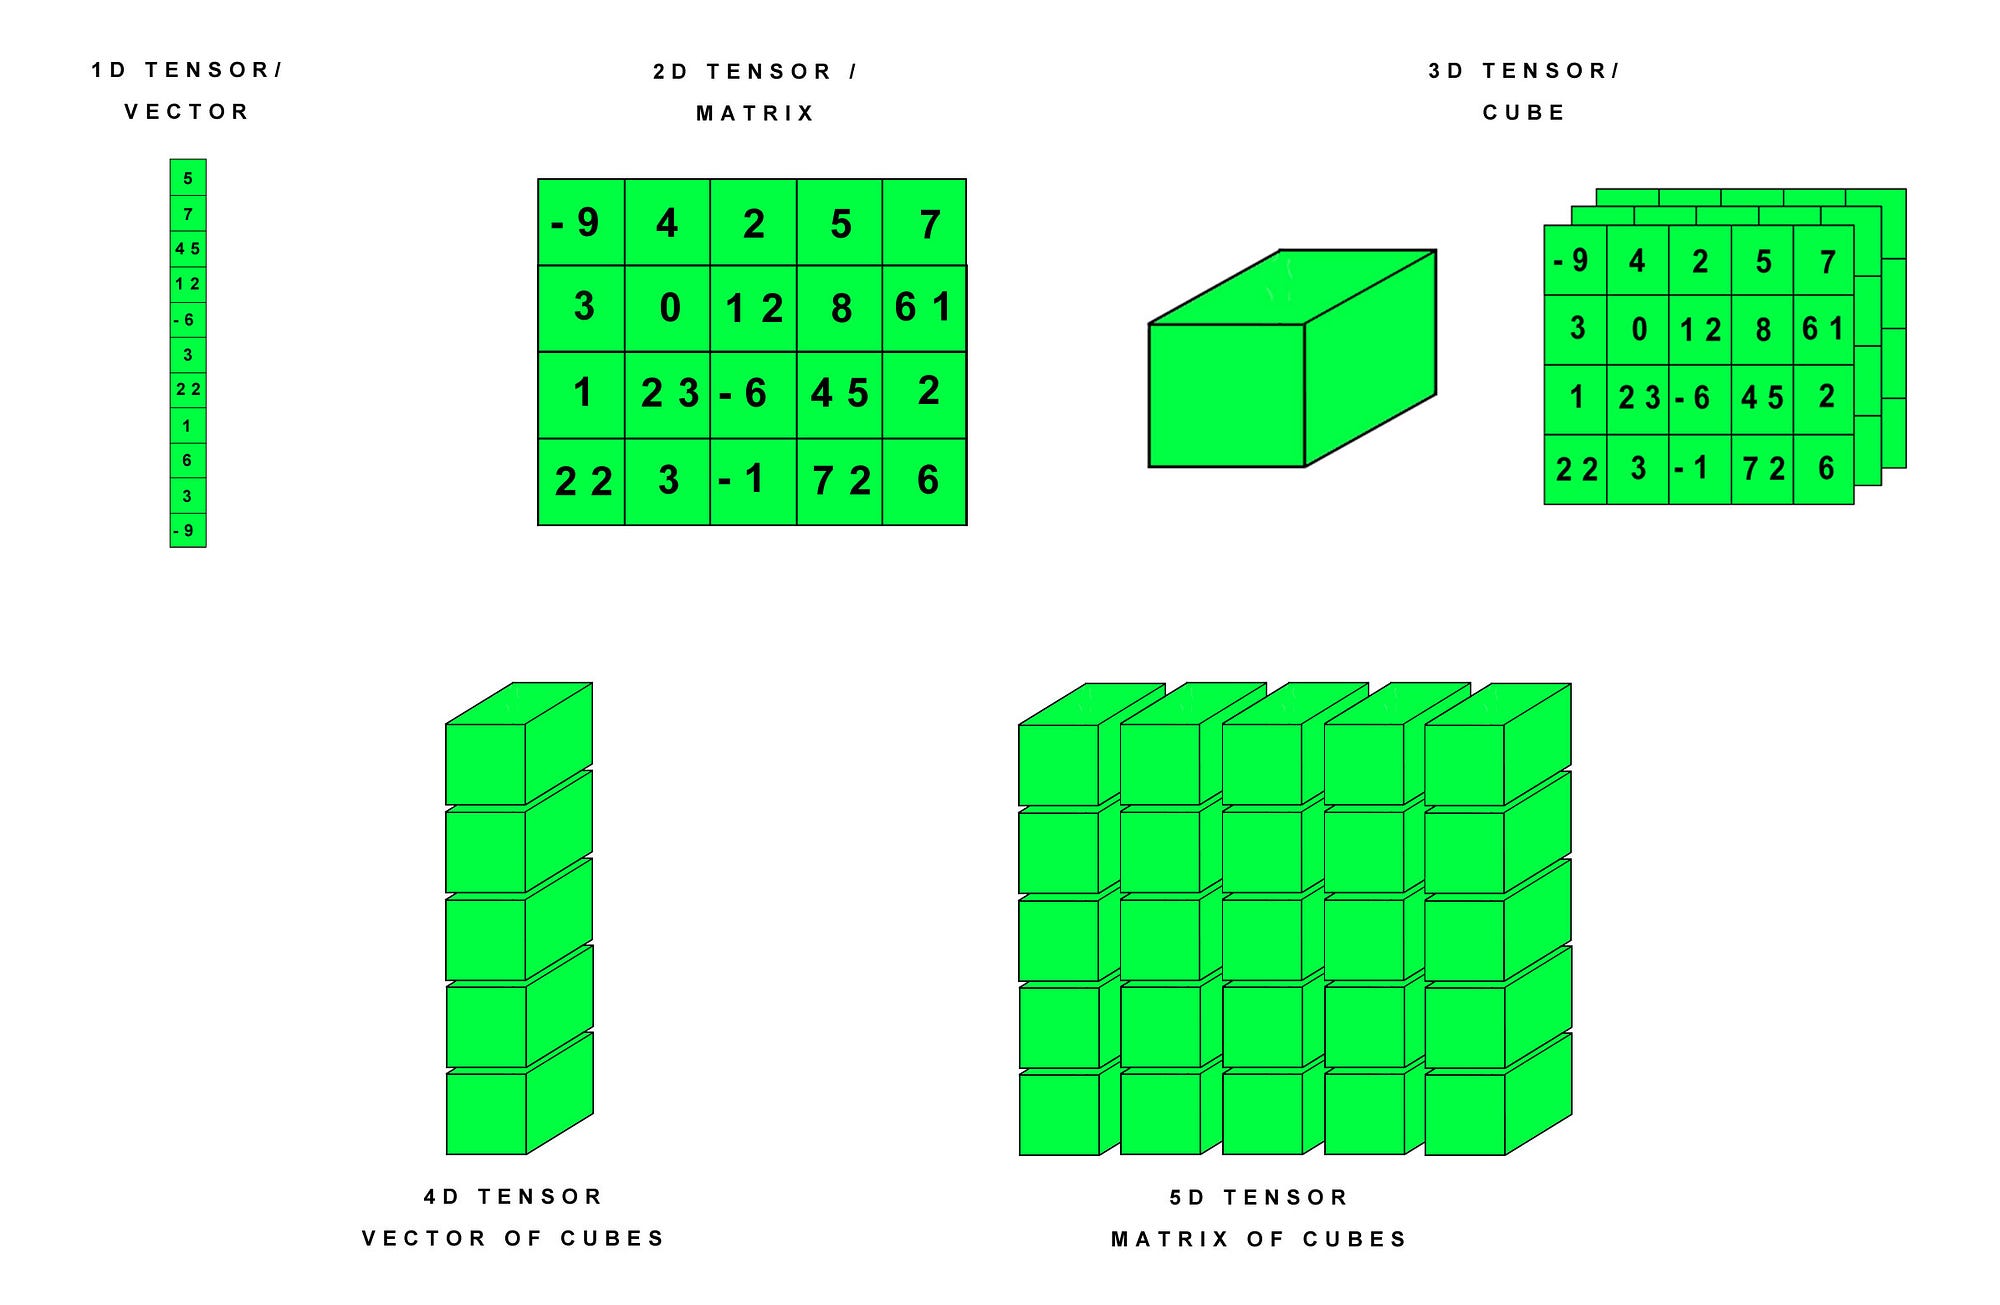
Sekarang mari bangun intuisi di balik tensor dengan cara yang lebih lugas.
Tensor adalah blok bangunan dasar machine learning modern. Intinya, ini adalah wadah data. Kebanyakan berisi angka. Kadang-kadang bahkan mencakup string, tetapi itu jarang. Jadi bayangkan saja sebagai ember angka.
Namun sering kali, orang menyamakan tensor dengan array multidimensi. Menurut StackExchange:
Tensor dan array multidimensi adalah jenis objek yang berbeda. Yang pertama adalah jenis fungsi. Yang kedua adalah struktur data yang cocok untuk merepresentasikan tensor dalam suatu sistem koordinat.
Secara matematis, tensor didefinisikan sebagai fungsi multi-linear. Fungsi multi-linear terdiri dari berbagai variabel vektor. Medan tensor adalah fungsi bernilai tensor. Untuk penjelasan matematis yang ketat, Anda dapat membaca di sini.
Jadi, tensor adalah fungsi atau wadah yang perlu Anda definisikan. Perhitungan sebenarnya terjadi ketika data diberikan. Apa yang Anda lihat sebagai array atau multi-dimensi (1D, 2D, …, ND) dapat dianggap sebagai tensor generik.
Sekarang, mari sedikit membahas tentang notasi Tensor.
Notasi tensor mirip dengan notasi matriks dengan huruf kapital mewakili tensor dan huruf kecil dengan subskrip bilangan bulat mewakili nilai skalar di dalam tensor.

Banyak operasi yang dapat dilakukan dengan skalar, vektor, dan matriks dapat diformulasikan ulang untuk dilakukan dengan tensor.
Sebagai alat, tensor dan aljabar tensor banyak digunakan di bidang fisika dan teknik. Istilah dan seperangkat teknik yang dikenal dalam machine learning untuk pelatihan dan pengoperasian model deep learning dapat dijelaskan dalam kerangka tensor.
PyTorch adalah paket komputasi ilmiah berbasis Python yang ditujukan untuk:
Mari ringkas dengan cepat fitur-fitur unik PyTorch -
PyTorch menyediakan beragam rutin tensor untuk mempercepat dan memenuhi kebutuhan komputasi ilmiah Anda seperti slicing, indexing, operasi matematika, aljabar linear, reduksi. Dan semuanya cepat.
PyTorch memiliki cara unik untuk membangun jaringan saraf: menggunakan dan memutar ulang perekam tape.
Kebanyakan kerangka kerja seperti TensorFlow, Theano, Caffe, dan CNTK memiliki pandangan dunia yang statis. Anda harus membangun jaringan saraf dan menggunakan kembali struktur yang sama berulang kali. Mengubah perilaku jaringan berarti harus mulai dari awal.
PyTorch menggunakan teknik yang disebut diferensiasi otomatis mode-balik (Reverse-mode auto-differentiation), yang memungkinkan Anda mengubah perilaku jaringan secara sewenang-wenang tanpa jeda atau overhead. Inspirasi kami datang dari beberapa makalah riset tentang topik ini, serta pekerjaan saat ini dan sebelumnya seperti autograd, autograd, Chainer, dll.
(Meskipun teknik ini bukan satu-satunya milik PyTorch, ini adalah salah satu implementasi tercepat hingga saat ini. Anda mendapatkan perpaduan terbaik antara kecepatan dan fleksibilitas untuk riset Anda.)
(Karena itu, PyTorch cukup cepat – baik Anda menjalankan jaringan saraf kecil maupun besar.)
Blog ini membandingkan PyTorch dan TensorFlow dengan sangat baik.
P.S.: Blog DataCamp ini adalah materi awal yang sangat baik untuk memulai dengan TensorFlow.
Instalasi PyTorch cukup mudah. Karena PyTorch mendukung komputasi GPU yang efisien, ia berkomunikasi efektif dengan driver Cuda Anda dan menjalankan proses lebih cepat.
Anda akan memerlukan torch dan torchvision untuk menggunakan PyTorch. Mari memasangnya untuk lingkungan Windows. Nanti, Anda juga akan melihat langkah-langkah untuk Linux dan Mac.
Saya menggunakan Python 3.5 dengan setelan Anaconda. Saya juga tidak memiliki CUDA. Jalankan perintah berikut untuk memasang torch dan torchvision:
(Harap diingat bahwa PyTorch tidak mendukung Python 2.7. Jadi wajib menggunakan Python versi => 3.5.)
Jika Anda mengaktifkan CUDA di mesin Anda, silakan jalankan perintah berikut (ini untuk CUDA 9.0):
Sekarang, mari lihat langkah instalasi untuk lingkungan Linux dengan Python 3.5 dan tanpa dukungan CUDA:
Ya, tebakan Anda benar! Sama seperti di Windows.
Sekarang, jika Anda memiliki dukungan CUDA (9.0) maka langkahnya adalah:
Untuk lingkungan Mac dengan Python 3.5 dan tanpa dukungan CUDA langkahnya adalah:
Dan, dengan dukungan CUDA (9.0):
(Biner MacOS tidak mendukung CUDA, instal dari source jika CUDA diperlukan)
Semoga, Anda sudah selesai memasang PyTorch sekarang!
Sekarang, mari langsung menyelami beberapa aritmetika Tensor dengan PyTorch.
Pertama, mari impor semua pustaka yang diperlukan.
from __future__ import print_function
import torch
Jika instalasi PyTorch berhasil, maka menjalankan baris kode di atas tidak akan menimbulkan error.
Sekarang, mari membangun matriks 5x3, tidak diinisialisasi:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Buat matriks berisi nol dan bertipe data long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Buat tensor langsung dari data:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Jika Anda memahami Tensor dengan benar, beri tahu saya jenis Tensor apa x itu di kolom komentar!
Anda dapat membuat tensor berdasarkan tensor yang sudah ada. Metode ini akan menggunakan kembali properti tensor masukan, misalnya dtype (tipe data), kecuali jika nilai baru disediakan oleh pengguna:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Dapatkan ukurannya:
print(x.size())
torch.Size([5, 3])
Perhatikan bahwa torch.Size sebenarnya adalah tuple, jadi mendukung semua operasi tuple.
Sekarang, mari lakukan operasi penjumlahan pada Tensor.
Penjumlahan elemen-per-elemen dari dua tensor dengan dimensi yang sama menghasilkan tensor baru dengan dimensi yang sama di mana setiap nilai skalar adalah hasil penjumlahan elemen-per-elemen dari skalar pada tensor induk.

# Sintaks 1 untuk penjumlahan Tensor di PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Sintaks 2 untuk penjumlahan Tensor di PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Sekarang mari lakukan pengurangan Tensor.
Pengurangan elemen-per-elemen dari satu tensor terhadap tensor lain dengan dimensi yang sama menghasilkan tensor baru dengan dimensi yang sama di mana setiap nilai skalar adalah hasil pengurangan elemen-per-elemen dari skalar pada tensor induk4.

Sekarang mari lihat Produk Tensor:
Melakukan perkalian matriks dari matriks mat1 dan mat2.
Jika mat1 adalah tensor (n×m), mat2 adalah tensor (m×p), maka out akan menjadi tensor (n×p).
Anda melakukan produk Tensor di PyTorch seperti berikut:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Perhatikan bahwa torch.mm() tidak melakukan broadcasting. Mari bahas sedikit tentang broadcasting.
Istilah broadcasting menggambarkan bagaimana array dengan bentuk berbeda diperlakukan selama operasi aritmetika. Dengan tunduk pada batasan tertentu, array yang lebih kecil “disiarkan” melintasi array yang lebih besar sehingga bentuknya menjadi kompatibel. Broadcasting menyediakan cara untuk memvektorisasi operasi array sehingga looping terjadi di C, bukan di Python. Ini dilakukan tanpa membuat salinan data yang tidak perlu dan biasanya menghasilkan implementasi algoritme yang efisien. Namun, ada kasus di mana broadcasting bukan ide yang baik karena menyebabkan penggunaan memori tidak efisien yang memperlambat komputasi.
Dua tensor “dapat dibroadcast” jika aturan berikut berlaku:
Mari pahami ini dengan PyTorch menggunakan cuplikan kode berikut:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# bentuk yang sama selalu dapat dibroadcast (yaitu aturan di atas selalu berlaku)
x=torch.empty((0,))
y=torch.empty(2,2)
# x dan y tidak dapat dibroadcast, karena x tidak memiliki setidaknya 1 dimensi
# dapat menyelaraskan dimensi belakang
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x dan y dapat dibroadcast.
# Dimensi belakang ke-1: keduanya berukuran 1
# Dimensi belakang ke-2: y berukuran 1
# Dimensi belakang ke-3: ukuran x == ukuran y
# Dimensi belakang ke-4: dimensi y tidak ada
# tetapi:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x dan y tidak dapat dibroadcast, karena pada dimensi belakang ke-3 2 != 3
Sekarang setelah Anda punya gambaran yang cukup tentang broadcasting, mari lihat jika dua tensor "dapat dibroadcast" maka seperti apa tensor hasilnya.
Jika dua tensor x, y “dapat dibroadcast”, ukuran tensor hasil dihitung sebagai berikut:
Jika jumlah dimensi x dan y tidak sama, tambahkan 1 di depan dimensi tensor dengan jumlah dimensi lebih sedikit untuk menyamakannya. Lalu, untuk setiap ukuran dimensi, ukuran dimensi hasil adalah nilai maksimum dari ukuran x dan y pada dimensi tersebut. Contoh:
# dapat menyelaraskan dimensi belakang agar lebih mudah dibaca
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# tapi tidak wajib:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
---->  3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Anda sudah paham konsepnya sekarang!
Produk tensor adalah bentuk perkalian tensor yang paling umum Anda temui, tetapi ada banyak jenis perkalian tensor lain, seperti tensor dot product dan tensor contraction.
Mengonversi Torch Tensor ke array NumPy dan sebaliknya sangat mudah. Konsep ini disebut Numpy Bridge. Mari kita lihat.
Torch Tensor dan array NumPy akan berbagi lokasi memori yang mendasarinya, dan mengubah yang satu akan mengubah yang lain.
Mengonversi Torch Tensor ke Array NumPy.
# Tensor 1D berisi 5 nilai satu
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Konversi tensor Torch menjadi array NumPy
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Lihat bagaimana nilai array NumPy berubah.
Jadi, pada bagian di atas, Anda melakukan beberapa aritmetika Tensor dasar seperti penjumlahan, pengurangan, dan produk tensor. Sekarang pada bagian berikut, Anda akan mengimplementasikan jaringan saraf sederhana di PyTorch.
Jika Anda perlu penyegaran tentang neural net, maka artikel DataCamp ini adalah rujukan terbaik. Anda juga mungkin ingin memeriksa tautan berikut:
Sebelum implementasi, mari bahas sedikit tentang konsep Diferensiasi Otomatis yang menjadi inti semua jaringan saraf di PyTorch. Ini sangat berguna untuk menghitung gradien dalam proses backpropagation.
Paket autograd menyediakan diferensiasi otomatis untuk semua operasi pada Tensor. Ini adalah kerangka kerja define-by-run, yang berarti backpropagation Anda ditentukan oleh bagaimana kode Anda dijalankan dan setiap iterasi bisa berbeda.
Mari lihat Diferensiasi Otomatis beraksi dengan contoh kode yang sangat sederhana.
# Buat tensor Rank-2 berisi semua nilai satu
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Lakukan operasi penjumlahan.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Lakukan beberapa operasi lagi pada y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Sekarang lakukan backprop karena out berisi satu skalar, out.backward() setara dengan out.backward(torch.tensor(1)).
out.backward()

# cetak gradien d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Sekarang Anda tahu tentang Diferensiasi Otomatis dan bagaimana PyTorch menanganinya. Anda sekarang akan membuat kode jaringan saraf sederhana menggunakan PyTorch.
Anda akan membuat jaringan saraf sederhana dengan satu lapisan tersembunyi dan satu unit keluaran. Anda akan menggunakan aktivasi ReLU di lapisan tersembunyi dan aktivasi sigmoid di lapisan keluaran.
Pertama, Anda perlu mengimpor pustaka PyTorch. Jaringan saraf dapat dibangun menggunakan paket torch.nn.
import torch
import torch.nn as nn
Kemudian Anda mendefinisikan ukuran semua lapisan dan ukuran batch:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Dan sekarang, Anda akan membuat beberapa data masukan dummy x dan beberapa data target dummy y. Anda akan menggunakan PyTorch Tensor untuk menyimpan data ini. PyTorch Tensor dapat digunakan dan dimanipulasi seperti array NumPy tetapi dengan manfaat tambahan bahwa tensor PyTorch dapat berjalan di GPU. Namun untuk tutorial ini Anda akan menjalankannya di CPU saja. Meski begitu, memindahkannya ke GPU cukup sederhana.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
Dan sekarang, Anda akan mendefinisikan model kita dalam satu baris kode.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Ini membuat model yang terlihat seperti input -> linear -> relu -> linear -> sigmoid. Ada cara lain untuk mendefinisikan model Anda yang digunakan untuk mendefinisikan model yang lebih rumit dan kustom. Caranya dengan mendefinisikan model dalam sebuah kelas. Anda dapat membacanya di sini.
Sekarang, saatnya menyusun fungsi loss Anda. Anda akan menggunakan Mean Squared Error Loss.
criterion = torch.nn.MSELoss()
Juga, jangan lupa untuk mendefinisikan optimizer Anda. Anda akan menggunakan Stochastic Gradient Descent dan laju pembelajaran 0,01. model.parameters() mengembalikan iterator atas parameter model Anda (bobot dan bias).
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Sekarang, Anda akan menjalankan Gradient Descent selama 50 epoch. Ini melakukan forward propagation, perhitungan loss, backward propagation, dan pembaruan parameter dalam urutan tersebut.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred mendapatkan nilai prediksi dari forward pass model kita. Anda meneruskannya, bersama dengan nilai target y ke criterion yang menghitung loss.
Kemudian, optimizer.zero_grad() mengosongkan semua gradien. Anda perlu melakukan ini agar gradien sebelumnya tidak terus menumpuk.
Kemudian, loss.backward() adalah “sihir” utama PyTorch yang menggunakan fitur Autograd PyTorch. Autograd menghitung semua gradien terhadap semua parameter secara otomatis berdasarkan computation graph yang dibuatnya secara dinamis. Pada dasarnya, ini melakukan backward pass (backpropagation) dari gradient descent.
Terakhir, Anda memanggil optimizer.step() yang melakukan satu pembaruan semua parameter menggunakan gradien baru.
Jadi, Anda sudah mencapai akhir. Dalam tulisan ini, Anda membahas banyak hal mulai dari Tensor hingga Diferensiasi Otomatis dan lainnya! Anda juga mengimplementasikan neural net sederhana menggunakan PyTorch dan sistem tensornya.
Jika Anda ingin mempelajari lebih lanjut tentang PyTorch dan ingin menyelaminya lebih dalam, lihat dokumentasi dan tutorial resmi PyTorch. Keduanya ditulis dengan sangat baik. Anda dapat menemukannya di sini.
Berikut beberapa referensi yang membantu saya menulis tutorial ini:
Beri tahu saya jika Anda punya sesuatu untuk ditanyakan atau didiskusikan di kolom komentar!
Jika Anda tertarik mempelajari lebih lanjut tentang Python, ikuti Statistical Thinking in Python (Bagian 1) dari DataCamp.
Pelajari lebih lanjut tentang Python dan PyTorch
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




