Kurs
Einführung in Deep Learning mit Python
4 Std.
264.6K
Im Deep Learning dreht sich vieles um Tensors als grundlegende Datenstruktur. Sogar Googles bekannteste Machine-Learning-Bibliothek trägt sie im Namen: „TensorFlow“. Tensors sind eine Datenstruktur aus der linearen Algebra, und wie bei Vektoren und Matrizen kannst du mit ihnen arithmetische Operationen durchführen.
PyTorch hingegen ist ein Python-Paket von Facebook mit zwei zentralen Stärken: 1) Tensor-Berechnungen (ähnlich wie NumPy) mit starker GPU-Beschleunigung und 2) tiefe neuronale Netze auf Basis eines bandprotokollierten Autodifferenzierungs-Systems.
In diesem Tutorial erfährst du, was Tensors sind und wie du sie in Python mit PyTorch verwendest und manipulierst.
Also, legen wir los mit der Einführung in Tensors.
Ein Tensor ist eine Verallgemeinerung von Vektoren und Matrizen und lässt sich am einfachsten als mehrdimensionales Array vorstellen. Laut dem populären Deep-Learning-Buch „Deep Learning“ (Goodfellow et al.) gilt:
„Im Allgemeinen bezeichnet man ein Zahlenfeld auf einem regulären Gitter mit variabler Achsenzahl als Tensor.“
Ein Skalar ist ein Tensor nullter Ordnung beziehungsweise vom Rang null. Ein Vektor ist ein Tensor erster Ordnung (eindimensional) und eine Matrix ein Tensor zweiter Ordnung (zweidimensional).
Die folgende Infografik veranschaulicht Tensors sehr anschaulich:
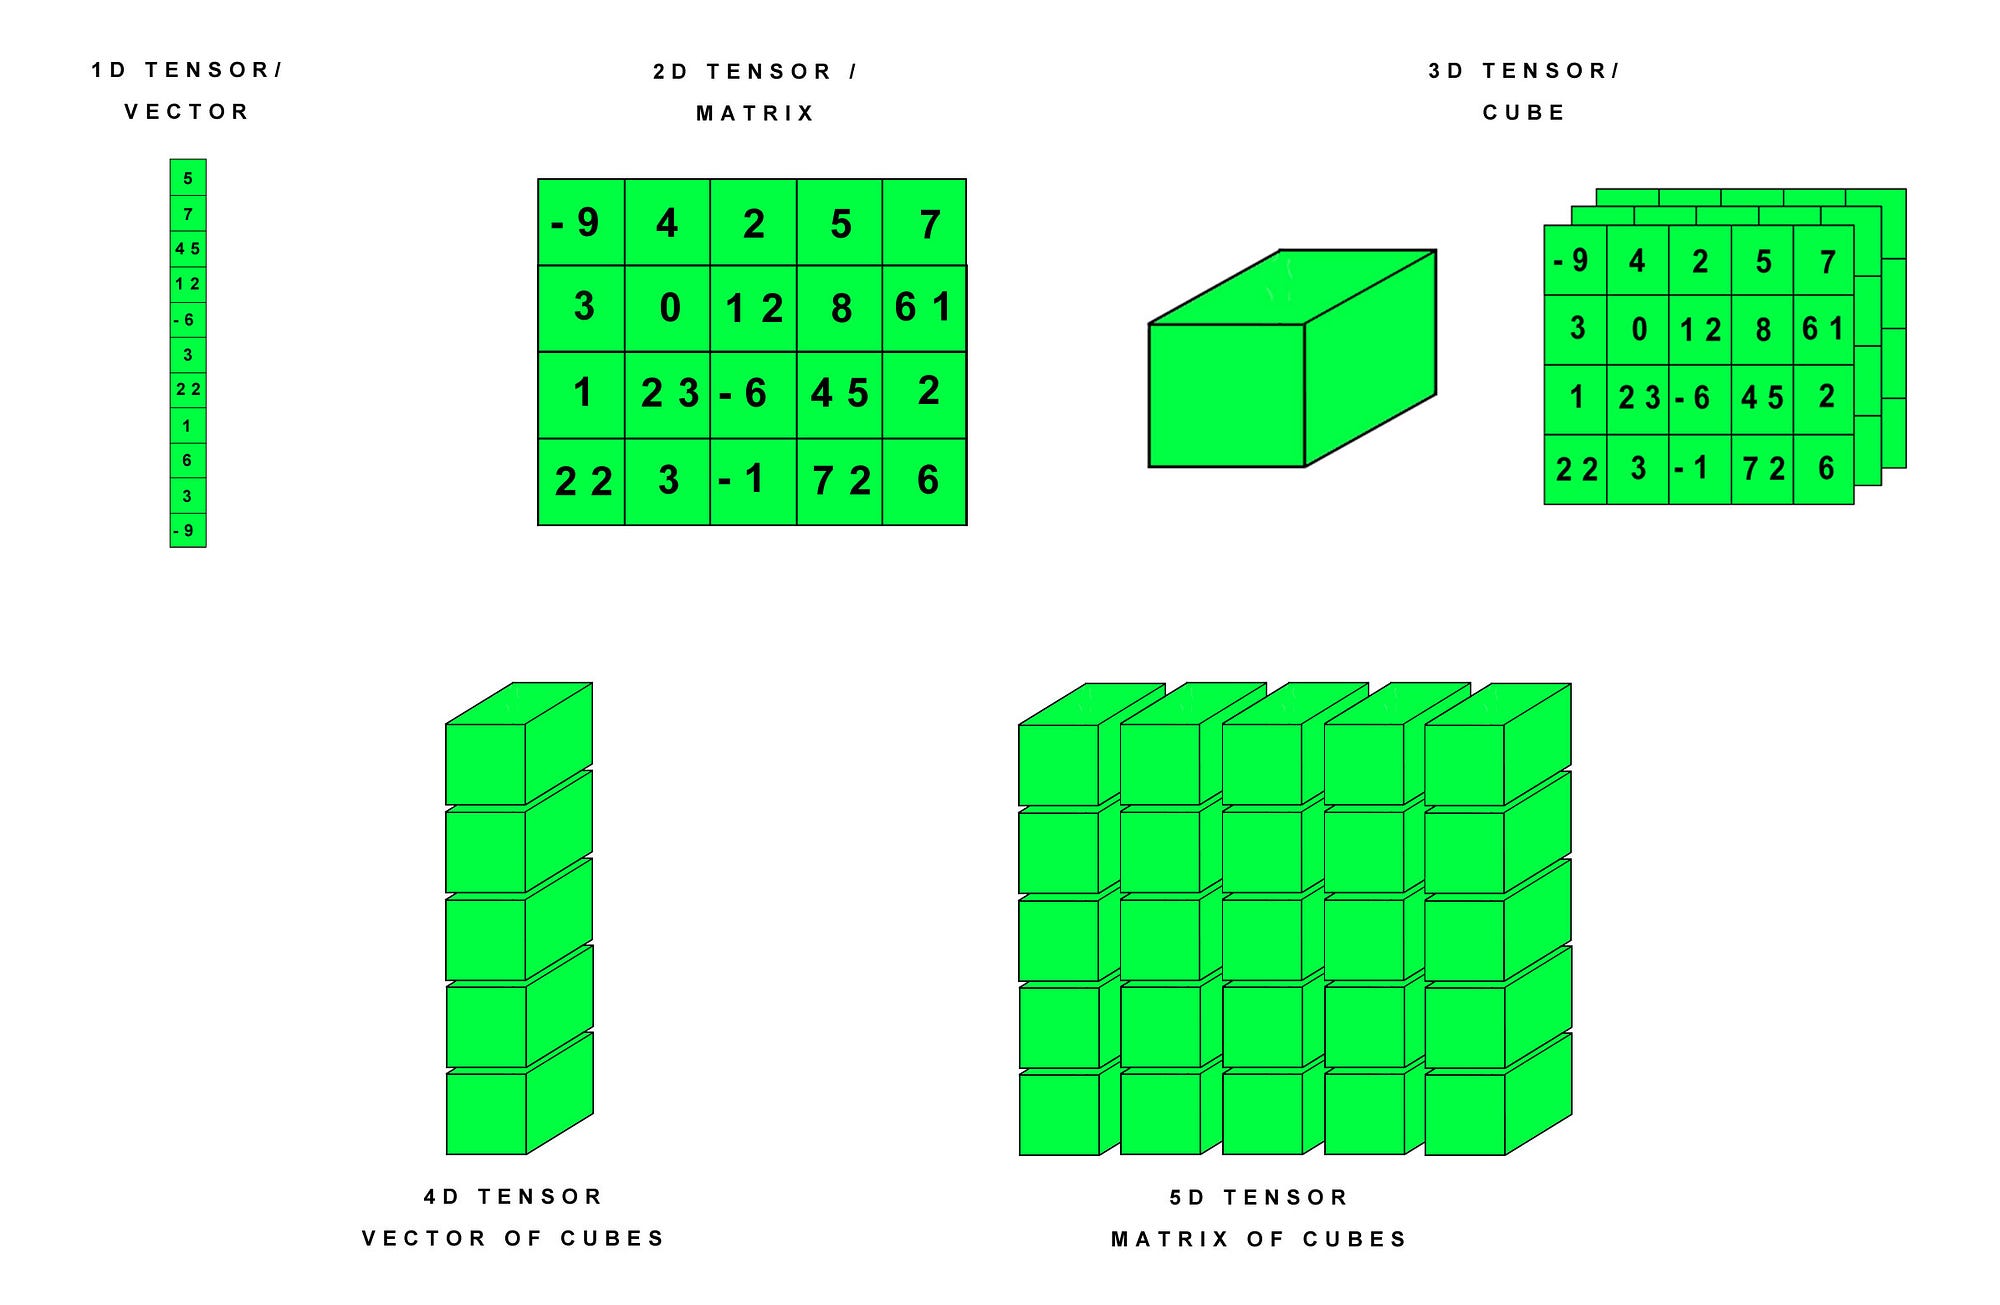
Bauen wir die Intuition dahinter nun noch greifbarer auf.
Ein Tensor ist der elementare Baustein des modernen Machine Learnings. Im Kern ist er ein Datencontainer. Meist enthält er Zahlen. Manchmal auch Zeichenketten, das ist aber selten. Stell ihn dir also wie einen Eimer voller Zahlen vor.
Häufig werden Tensors mit mehrdimensionalen Arrays verwechselt. Laut StackExchange gilt:
Tensors und mehrdimensionale Arrays sind unterschiedliche Objekttypen. Ersteres ist ein Funktionstyp, Letzteres eine Datenstruktur, die sich eignet, einen Tensor in einem Koordinatensystem darzustellen.
Mathematisch sind Tensors multilineare Funktionen. Eine multilineare Funktion hängt von mehreren Vektorvariablen ab. Ein Tensorfeld ist eine tensorwertige Funktion. Eine saubere mathematische Einführung findest du hier.
Tensors sind also Funktionen oder Container, die du definierst. Die eigentliche Rechnung passiert, sobald Daten hineinfließen. Was du als Arrays oder mehrdimensionale Strukturen (1D, 2D, …, ND) siehst, kannst du als generische Tensors betrachten.
Kommen wir nun kurz zur Tensornotation.
Die Tensornotation ähnelt der Matrixnotation: Großbuchstaben stehen für Tensors, Kleinbuchstaben mit Index für Skalarwerte innerhalb des Tensors.

Viele Operationen, die du mit Skalaren, Vektoren und Matrizen durchführen kannst, lassen sich für Tensors formulieren.
Als Werkzeug werden Tensors und Tensoralgebra breit in Physik und Ingenieurwesen eingesetzt. Auch das Training und der Betrieb von Deep-Learning-Modellen lassen sich gut über Tensors beschreiben.
PyTorch ist ein Python-basiertes Paket für wissenschaftliches Rechnen und zielt auf:
Hier ein schneller Überblick über die Besonderheiten von PyTorch:
PyTorch bietet eine große Bandbreite an Tensor-Routinen für wissenschaftliche Berechnungen wie Slicing, Indexierung, mathematische Operationen, lineare Algebra und Reduktionen – und das sehr performant.
PyTorch hat eine besondere Art, neuronale Netze zu bauen: mithilfe eines „Bandrekorders“, der Ausführungen aufzeichnet und wieder abspielt.
Viele Frameworks wie TensorFlow, Theano, Caffe und CNTK haben eine statische Sicht auf die Welt. Man baut ein Netz und verwendet dessen Struktur immer wieder. Will man das Verhalten ändern, fängt man oft von vorne an.
PyTorch nutzt Reverse-Mode-Autodifferenzierung. Damit kannst du das Verhalten deines Netzes beliebig ändern – ohne spürbare Latenz oder Overhead. Die Idee ist durch zahlreiche Forschungsarbeiten sowie Tools wie autograd und Chainer inspiriert.
(Diese Technik ist nicht exklusiv für PyTorch, aber die Implementierung zählt zu den schnellsten. Du bekommst also Tempo und Flexibilität für deine Experimente.)
(Daher ist PyTorch sehr schnell – egal ob kleine oder große Netze.)
Dieser Blog vergleicht PyTorch und TensorFlow sehr anschaulich.
P.S.: Dieser DataCamp-Blog ist ein sehr guter Einstieg in TensorFlow.
Die Installation von PyTorch ist unkompliziert. Da PyTorch effiziente GPU-Berechnungen unterstützt, spricht es sauber mit deinen CUDA-Treibern und beschleunigt Abläufe.
Für PyTorch brauchst du torch und torchvision. Installieren wir das in einer Windows-Umgebung. Weiter unten folgen die Schritte für Linux und Mac.
Ich nutze Python 3.5 mit Anaconda und habe kein CUDA. Führe die folgenden Befehle aus, um torch und torchvision zu installieren:
(Beachte: PyTorch unterstützt Python 2.7 nicht. Du brauchst Python >= 3.5.)
Wenn auf deinem Rechner CUDA aktiviert ist, nutze Folgendes (für CUDA 9.0):
Nun die Installationsschritte für eine Linux-Umgebung mit Python 3.5 ohne CUDA:
Ja, genau! Das ist identisch zu Windows.
Mit CUDA-Unterstützung (9.0) lautet der Schritt:
Für macOS mit Python 3.5 und ohne CUDA-Unterstützung:
Und mit CUDA-Unterstützung (9.0):
(macOS-Binaries unterstützen CUDA nicht. Wenn du CUDA brauchst, kompiliere aus dem Quellcode.)
Ich hoffe, die Installation von PyTorch ist damit erledigt!
Steigen wir jetzt direkt in etwas Tensor-Arithmetik mit PyTorch ein.
Importieren wir zunächst die benötigten Bibliotheken.
from __future__ import print_function
import torch
Wenn PyTorch korrekt installiert wurde, liefern diese Zeilen keine Fehlermeldung.
Erzeuge nun eine 5x3-Matrix mit Zufallswerten:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Erzeuge eine Matrix aus Nullen mit dem Datentyp long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Erzeuge einen Tensor direkt aus Daten:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Wenn du Tensors richtig verstanden hast, schreib in die Kommentare, welcher Art von Tensor x ist!
Du kannst einen Tensor auf Basis eines bestehenden Tensors erstellen. Diese Methoden übernehmen Eigenschaften des Eingangstensors, z. B. den Datentyp (dtype), sofern du nichts anderes angibst:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Gib die Größe aus:
print(x.size())
torch.Size([5, 3])
Beachte: torch.Size ist eigentlich ein Tuple und unterstützt daher alle Tuple-Operationen.
Machen wir weiter mit einer Addition auf Tensors.
Die elementweise Addition zweier Tensors gleicher Dimensionen ergibt einen neuen Tensor derselben Dimensionen. Jeder Skalar im Ergebnis ist die Summe der entsprechenden Skalare der beiden Ausgangstensors.

# Syntax 1 für Tensor-Addition in PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Syntax 2 für Tensor-Addition in PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Als Nächstes die Tensor-Subtraktion.
Die elementweise Subtraktion zweier Tensors gleicher Dimensionen ergibt einen neuen Tensor derselben Dimensionen. Jeder Skalar im Ergebnis ist die Differenz der entsprechenden Skalare der beiden Ausgangstensors.

Schauen wir uns nun das Tensorprodukt an:
Führt eine Matrixmultiplikation der Matrizen mat1 und mat2 durch.
Ist mat1 ein (n×m)-Tensor und mat2 ein (m×p)-Tensor, dann ist das Ergebnis ein (n×p)-Tensor.
In PyTorch führst du Tensorprodukte wie folgt aus:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Beachte, dass torch.mm() kein Broadcasting unterstützt. Sprechen wir kurz über Broadcasting.
Broadcasting beschreibt, wie Arrays unterschiedlicher Form bei arithmetischen Operationen behandelt werden. Unter bestimmten Bedingungen wird das kleinere Array über das größere „gestreckt“, sodass kompatible Formen entstehen. So lassen sich Operationen vektorisieren, wodurch Schleifen in C statt in Python laufen. Das geschieht ohne unnötige Datenkopien und führt meist zu effizienten Implementierungen. Es gibt jedoch Fälle, in denen Broadcasting zu hohem Speicherverbrauch und damit langsamer Berechnung führt.
Zwei Tensors sind „broadcastfähig“, wenn Folgendes gilt:
Veranschaulichen wir das in PyTorch mit folgendem Snippet:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# Gleiche Formen sind immer broadcastfähig (die obigen Regeln sind erfüllt)
x=torch.empty((0,))
y=torch.empty(2,2)
# x und y sind nicht broadcastfähig, da x nicht mindestens 1 Dimension hat
# Hintere Dimensionen lassen sich ausrichten
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x und y sind broadcastfähig.
# 1. hintere Dimension: beide Größe 1
# 2. hintere Dimension: y hat Größe 1
# 3. hintere Dimension: x Größe == y Größe
# 4. hintere Dimension: y-Dimension existiert nicht
# Aber:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x und y sind nicht broadcastfähig, da in der 3. hinteren Dimension 2 != 3
Jetzt, da das Prinzip klar ist, schauen wir uns an, welche Größe der Ergebnistensor hat, wenn zwei Tensors „broadcastfähig“ sind.
Sind zwei Tensors x, y „broadcastfähig“, berechnet sich die Zielgröße so:
Haben x und y eine unterschiedliche Anzahl an Dimensionen, werden vorne 1en an die Dimensionen des kleineren Tensors angefügt, bis beide gleich lang sind. Dann gilt für jede Dimension: Die resultierende Größe ist das Maximum der beiden Größen entlang dieser Dimension. Beispiel:
# Hintere Dimensionen ausrichten, um es lesbarer zu machen
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# Ist aber nicht zwingend nötig:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Das Konzept sitzt jetzt!
Das Tensorprodukt ist die gängigste Form der Tensor-Multiplikation, aber es gibt weitere Varianten wie das Tensordot-Produkt oder die Tensor-Kontraktion.
Das Konvertieren zwischen Torch Tensor und NumPy-Array ist ein Kinderspiel. Dieses Konzept heißt NumPy Bridge. Schauen wir es uns an.
Der Torch Tensor und das NumPy-Array teilen sich den darunterliegenden Speicher. Änderungen am einen ändern daher auch das andere.
Konvertiere einen Torch Tensor in ein NumPy-Array.
# Ein 1D-Tensor aus fünf Einsen
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Torch Tensor in ein NumPy-Array umwandeln
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Sieh dir an, wie sich das NumPy-Array entsprechend ändert.
In den obigen Abschnitten hast du grundlegende Tensor-Arithmetik wie Addition, Subtraktion und Tensorprodukte durchgeführt. Im nächsten Abschnitt implementierst du ein einfaches neuronales Netz in PyTorch.
Falls du eine Auffrischung zu neuronalen Netzen brauchst, ist dieser DataCamp-Artikel ein sehr guter Start. Schau dir auch diese Links an:
Bevor wir loslegen, kurz zum zentralen Konzept der Automatischen Differenzierung, das allen PyTorch-Netzen zugrunde liegt. Es ist besonders nützlich, um Gradienten für Backpropagation zu berechnen.
Das Paket autograd bietet automatische Differenzierung für alle Tensor-Operationen. Es ist „define-by-run“: Die Backpropagation folgt deiner tatsächlichen Programmausführung – jede Iteration kann anders sein.
Schauen wir uns automatische Differenzierung an einem einfachen Beispiel an.
# Erzeuge einen Rang-2-Tensor aus lauter Einsen
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Führe eine Addition aus.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Führe weitere Operationen auf y aus.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Jetzt zurückpropagieren: Da out ein Skalar ist, ist out.backward() äquivalent zu out.backward(torch.tensor(1)).
out.backward()

# Gradienten d(out)/dx ausgeben
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Jetzt weißt du, wie automatische Differenzierung in PyTorch funktioniert. Als Nächstes codest du ein einfaches neuronales Netz.
Du erstellst ein kleines Netz mit einer versteckten Schicht und einer Ausgabeeinheit. In der Hidden Layer nutzt du ReLU als Aktivierung, in der Ausgabe Sigmoid.
Importiere zunächst die PyTorch-Bibliothek. Neuronale Netze konstruierst du mit dem Paket torch.nn.
import torch
import torch.nn as nn
Dann definierst du die Größen aller Schichten und die Batch-Größe:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Jetzt erzeugst du Dummy-Eingabedaten x und Dummy-Zieldaten y. Du speicherst sie in PyTorch-Tensors. PyTorch-Tensors lassen sich wie NumPy-Arrays verwenden, mit dem Vorteil, dass sie auch auf der GPU laufen können. In diesem Tutorial bleiben wir auf der CPU – das Verschieben auf eine GPU ist aber einfach.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
Jetzt definierst du das Modell in einer einzigen Codezeile.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Das ergibt: input -> linear -> relu -> linear -> sigmoid. Es gibt noch eine zweite, flexiblere Art, Modelle zu definieren – per Klasse. Mehr dazu hier.
Jetzt brauchst du eine Loss-Funktion. Wir verwenden die Mean Squared Error Loss.
criterion = torch.nn.MSELoss()
Und nicht vergessen: den Optimierer definieren. Wir nutzen Stochastic Gradient Descent mit einer Lernrate von 0,01. model.parameters() liefert einen Iterator über die Modellparameter (Gewichte und Biases).
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Jetzt lässt du Gradient Descent 50 Epochen laufen. In jeder Epoche folgen Vorwärtsdurchlauf, Loss-Berechnung, Rückwärtsdurchlauf und Parameter-Update.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Loss berechnen und ausgeben
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Gradienten nullen
    optimizer.zero_grad()

    # Backward Pass (Backpropagation)
    loss.backward()

    # Parameter aktualisieren
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred enthält die Vorhersagen aus dem Forward Pass. Zusammen mit den Zielwerten y gibst du das an die Loss-Funktion (criterion), die den Fehler berechnet.
optimizer.zero_grad() setzt alle Gradienten auf null, damit sich frühere Gradienten nicht aufsummieren.
loss.backward() ist die PyTorch-Magie dank Autograd. Autograd berechnet automatisch alle Gradienten zu allen Parametern basierend auf dem dynamisch erzeugten Rechengraphen – das ist der Backward Pass (Backpropagation).
Zum Schluss aktualisiert optimizer.step() alle Parameter mit den neuen Gradienten.
Geschafft bis zum Ende! In diesem Beitrag hast du vieles abgedeckt: von Tensors über automatische Differenzierung bis hin zur Implementierung eines einfachen Netzes mit PyTorch.
Wenn du tiefer in PyTorch einsteigen willst, lohnt sich die offizielle Dokumentation und die Tutorials – wirklich gut geschrieben. Du findest sie hier.
Folgende Referenzen haben mir beim Schreiben dieses Tutorials geholfen:
Schreib mir gern Fragen oder Anmerkungen in die Kommentare!
Wenn du mehr über Python lernen möchtest, starte mit DataCamps Statistical Thinking in Python (Part 1).
Mehr über Python und PyTorch lernen
Kurs
Kurs
Tutorial
DataCamp Team
3 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
DataCamp Team
4 Min.
Tutorial
Satyabrata Pal
15 Min.


