Cours
Introduction au Deep Learning en Python
4 h
264.6K
En deep learning, on parle très souvent des tenseurs comme structure de données fondamentale. Le terme tensor figure même dans le nom de la bibliothèque phare de Google pour l'apprentissage automatique : « TensorFlow ». Les tenseurs sont un type de structure de données utilisé en algèbre linéaire et, comme les vecteurs et les matrices, on peut effectuer des opérations arithmétiques avec des tenseurs.
PyTorch est, de son côté, un package Python développé par Facebook qui offre deux fonctionnalités de haut niveau : 1) le calcul sur des tenseurs (comme NumPy) avec une forte accélération GPU et 2) des réseaux de neurones profonds basés sur un système d'auto-différenciation par enregistrement (tape-based).
Dans ce tutoriel, vous allez voir ce que sont les tenseurs et comment les manipuler en Python avec PyTorch.
Sans plus attendre, commençons par une introduction aux tenseurs.
Un tenseur est une généralisation des vecteurs et des matrices et peut se voir simplement comme un tableau multidimensionnel. D'après l'ouvrage de référence « Deep Learning » (Goodfellow et al.) -
« Dans le cas général, un tableau de nombres disposés sur une grille régulière avec un nombre variable d’axes est appelé un tenseur. »
Un scalaire est un tenseur d’ordre zéro. Un vecteur est un tenseur unidimensionnel, d’ordre un, et une matrice est un tenseur bidimensionnel, d’ordre deux.
L’infographie suivante décrit les tenseurs de manière très parlante :
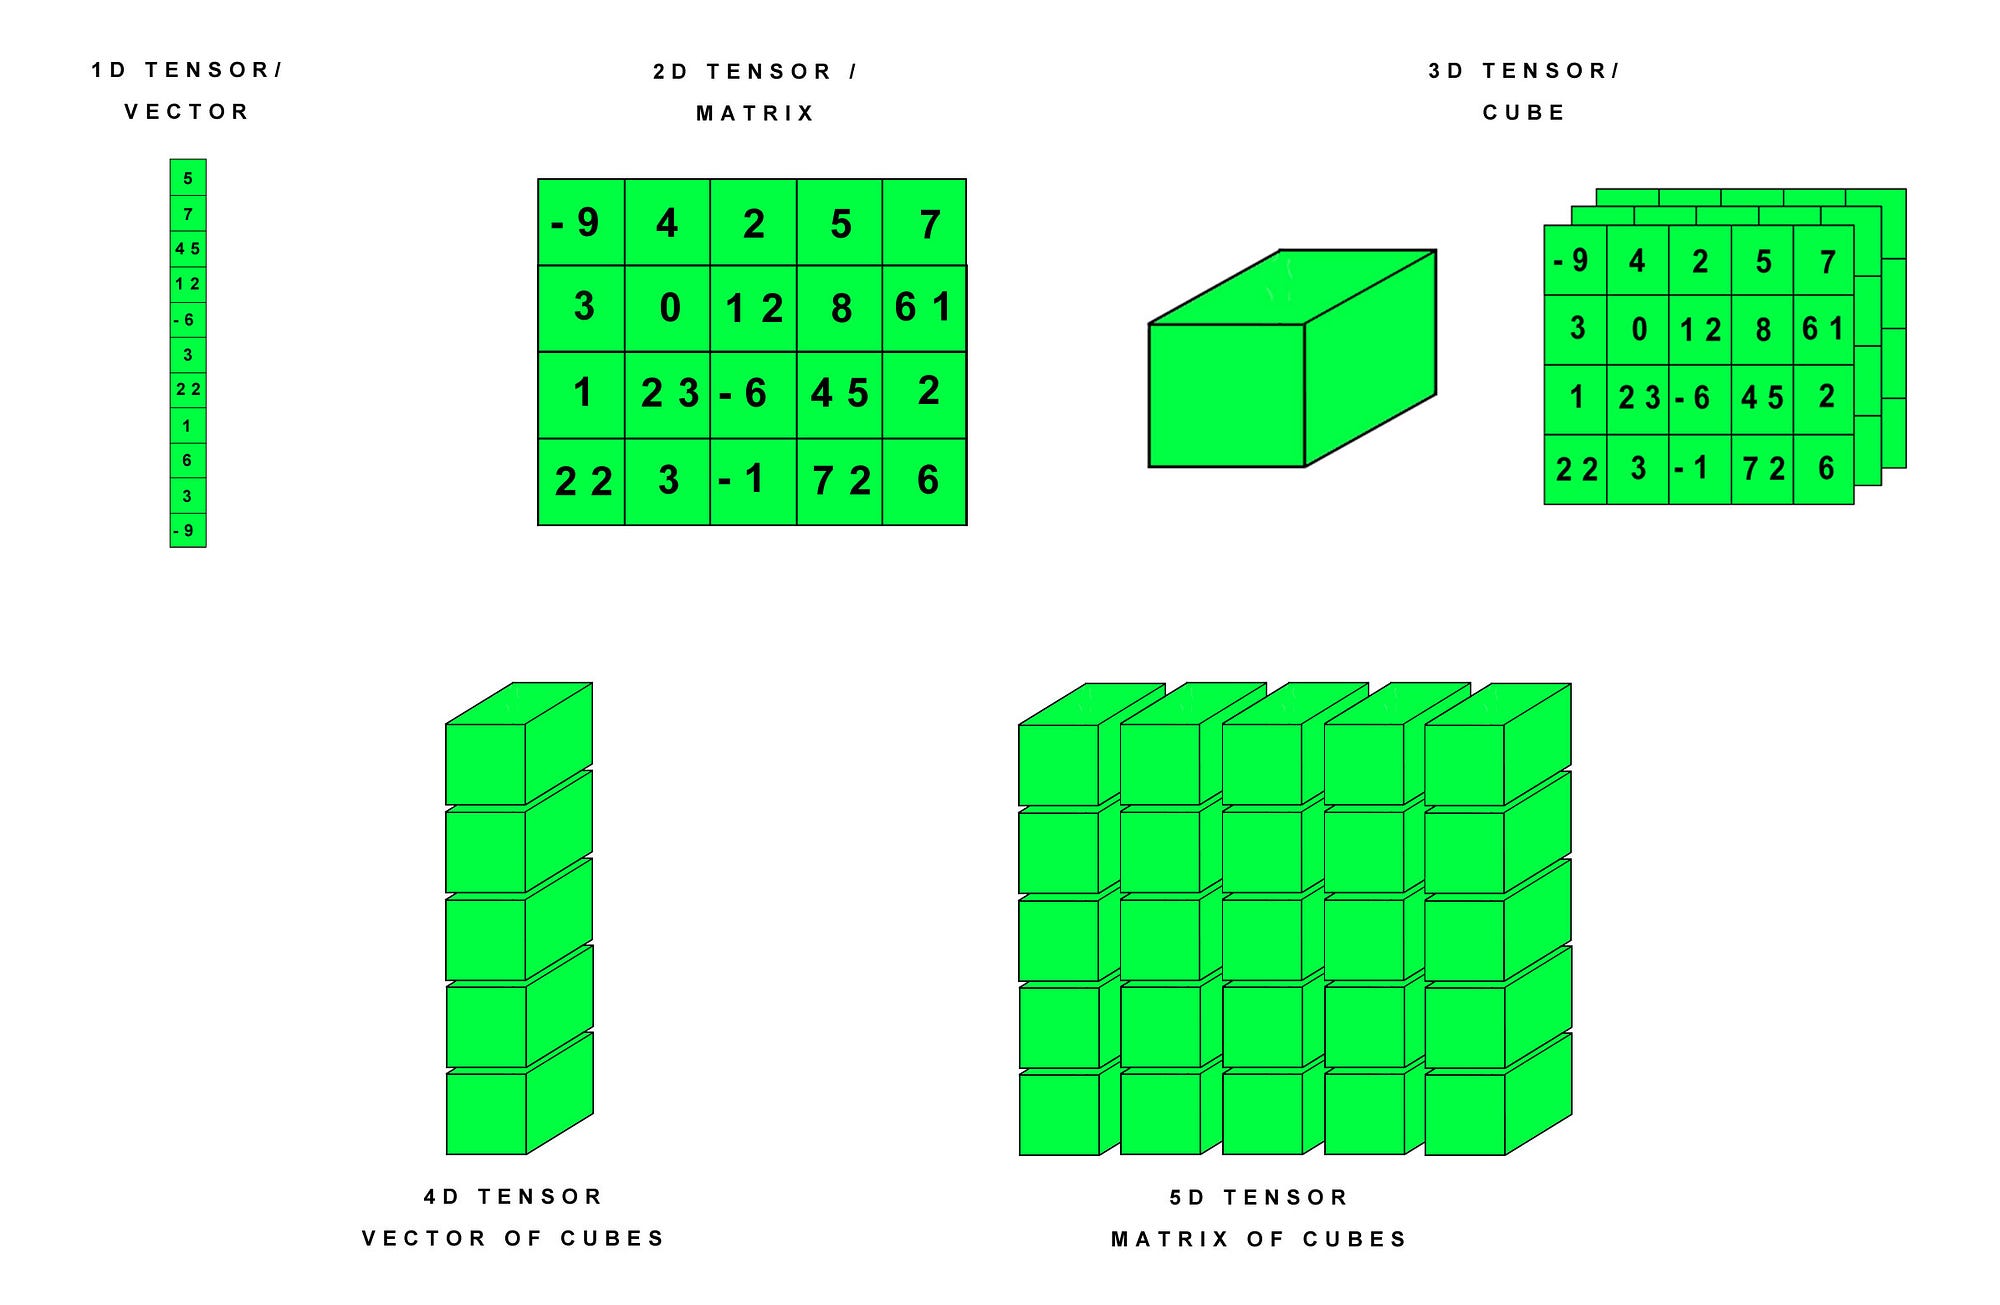
Construisons maintenant l’intuition derrière les tenseurs de façon plus concrète.
Le tenseur est le bloc de base du machine learning moderne. Au fond, c’est un conteneur de données. La plupart du temps, il contient des nombres. Il peut parfois contenir des chaînes de caractères, mais c’est rare. Imaginez-le comme un seau de nombres.
On confond souvent tenseurs et tableaux multidimensionnels. Selon StackExchange :
Les tenseurs et les tableaux multidimensionnels sont de natures différentes. Les premiers sont un type de fonction. Les seconds sont une structure de données adaptée pour représenter un tenseur dans un système de coordonnées.
Mathématiquement, les tenseurs sont définis comme des fonctions multilinéaires. Une fonction multilinéaire prend plusieurs variables vectorielles. Un champ tensoriel est une fonction à valeurs tensorielles. Pour une explication mathématique rigoureuse, vous pouvez lire ici.
Les tenseurs sont donc des fonctions ou des conteneurs que vous devez définir. Le calcul effectif a lieu quand on leur fournit des données. Ce que vous voyez comme des tableaux 1D, 2D, …, ND peut être considéré comme des tenseurs génériques.
Parlons maintenant un peu de la notation tensorielle.
La notation tensorielle ressemble beaucoup à la notation matricielle : une lettre majuscule représente un tenseur et des lettres minuscules avec des indices entiers représentent les valeurs scalaires à l’intérieur du tenseur.

La plupart des opérations réalisables avec des scalaires, vecteurs et matrices peuvent être reformulées pour être effectuées avec des tenseurs.
En tant qu’outil, les tenseurs et l’algèbre tensorielle sont largement utilisés en physique et en ingénierie. En machine learning, l’entraînement et l’inférence des modèles de deep learning se décrivent naturellement en termes de tenseurs.
PyTorch est un package scientifique Python conçu pour :
Résumons rapidement ce qui fait la spécificité de PyTorch :
PyTorch propose un large éventail de routines sur les tenseurs pour accélérer vos calculs scientifiques : slicing, indexation, opérations mathématiques, algèbre linéaire, réductions… Et c’est rapide.
PyTorch a une façon unique de construire des réseaux de neurones : en utilisant et rejouant un « magnétophone » (tape recorder).
La plupart des frameworks comme TensorFlow, Theano, Caffe et CNTK ont une vue statique : on construit un réseau et on réutilise la même structure encore et encore. Pour modifier le comportement du réseau, il faut souvent repartir de zéro.
PyTorch utilise une technique appelée auto-différenciation en mode reverse (Reverse-mode), qui vous permet d’altérer librement le comportement du réseau sans latence ni surcoût. L’inspiration vient de nombreux articles de recherche sur le sujet, ainsi que de travaux passés et actuels comme autograd, Chainer, etc.
(Cette technique n’est pas propre à PyTorch, mais son implémentation fait partie des plus rapides à ce jour. Vous alliez vitesse et flexibilité pour vos recherches les plus ambitieuses.)
(Ainsi, PyTorch est très rapide — que vous exécutiez de petits ou de grands réseaux.)
Ce billet de blog compare très bien PyTorch et TensorFlow.
P.S. : ce billet DataCamp est une excellente porte d’entrée pour débuter avec TensorFlow.
L’installation de PyTorch est assez simple. Comme PyTorch prend en charge le calcul GPU, il communique efficacement avec vos pilotes CUDA pour accélérer les traitements.
Vous aurez besoin de torch et torchvision pour utiliser PyTorch. Installons-les dans un environnement Windows. Plus loin, vous verrez aussi les étapes pour Linux et Mac.
J’ai Python 3.5 avec Anaconda. Je n’ai pas CUDA. Exécutez les commandes suivantes pour installer torch et torchvision :
(Gardez en tête que PyTorch ne prend pas en charge Python 2.7. Il vous faut une version de Python ≥ 3.5.)
Si votre machine dispose de CUDA, exécutez ce qui suit (pour CUDA 9.0) :
Voici maintenant les étapes d’installation pour un environnement Linux avec Python 3.5 et sans support CUDA :
Oui, vous avez bien deviné ! C’est identique à Windows.
Si vous avez le support CUDA (9.0), la commande sera :
Pour un Mac, avec Python 3.5 et sans support CUDA :
Et, avec CUDA (9.0) :
(Les binaires MacOS ne prennent pas en charge CUDA, installez depuis les sources si nécessaire.)
Espérons que votre installation de PyTorch est terminée !
Passons maintenant directement à quelques opérations arithmétiques sur les tenseurs avec PyTorch.
Commençons par importer les bibliothèques nécessaires.
from __future__ import print_function
import torch
Si l’installation de PyTorch s’est bien déroulée, l’exécution de ces lignes ne renverra aucune erreur.
Construisons maintenant une matrice 5x3, non initialisée :
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Construire une matrice remplie de zéros et de type long :
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Construire un tenseur directement à partir de données :
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Si vous avez bien compris les tenseurs, dites-moi dans les commentaires de quel type de tenseur est x !
Vous pouvez créer un tenseur à partir d’un tenseur existant. Ces méthodes réutilisent les propriétés du tenseur d’entrée, par exemple le dtype (type), sauf si vous fournissez de nouvelles valeurs :
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Obtenir sa taille :
print(x.size())
torch.Size([5, 3])
Notez que torch.Size est en fait un tuple ; il prend donc en charge toutes les opérations sur les tuples.
Passons maintenant à une opération d’addition sur les tenseurs.
L’addition élément par élément de deux tenseurs de mêmes dimensions produit un nouveau tenseur de mêmes dimensions, où chaque valeur scalaire est la somme des scalaires correspondants dans les tenseurs d’origine.

# Syntaxe 1 pour l'addition de tenseurs dans PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Syntaxe 2 pour l'addition de tenseurs dans PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Passons maintenant à la soustraction.
La soustraction élément par élément d’un tenseur à un autre, de mêmes dimensions, produit un nouveau tenseur de mêmes dimensions, où chaque scalaire est la différence des scalaires correspondants dans les tenseurs d’origine.

Regardons maintenant le produit tensoriel :
Réalise une multiplication matricielle entre les matrices mat1 et mat2.
Si mat1 est un tenseur (n×m) et mat2 un tenseur (m×p), le résultat est un tenseur (n×p).
Vous effectuez des produits tensoriels dans PyTorch comme suit :
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Notez que torch.mm() ne diffuse pas (« broadcast »). Parlons un peu de l’autoréplication des dimensions (broadcasting).
Le terme broadcasting décrit la façon dont les tableaux de formes différentes sont traités lors d’opérations arithmétiques. Sous certaines contraintes, le plus petit tableau est « étendu » pour rendre les formes compatibles. Le broadcasting permet de vectoriser les opérations pour que les boucles s’exécutent en C plutôt qu’en Python. Cela évite des copies inutiles de données et conduit généralement à des implémentations efficaces. Il existe toutefois des cas où le broadcasting est déconseillé car il peut induire une utilisation mémoire inefficace et ralentir les calculs.
Deux tenseurs sont « diffusables » (broadcastable) si les règles suivantes sont respectées :
Comprenons cela avec PyTorch grâce à l’extrait suivant :
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# des formes identiques sont toujours diffusables (les règles ci-dessus sont alors toujours vérifiées)
x=torch.empty((0,))
y=torch.empty(2,2)
# x et y ne sont pas diffusables, car x n'a pas au moins 1 dimension
# on peut aligner les dimensions de fin
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x et y sont diffusables.
# 1re dimension de fin : taille 1 pour les deux
# 2e dimension de fin : y a une taille de 1
# 3e dimension de fin : taille de x == taille de y
# 4e dimension de fin : la dimension de y n'existe pas
# mais :
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x et y ne sont pas diffusables, car dans la 3e dimension de fin 2 != 3
Maintenant que vous avez une bonne idée du broadcasting, voyons la forme du tenseur résultant lorsque deux tenseurs sont « diffusables ».
Si deux tenseurs x, y sont « diffusables », la taille du tenseur résultant se calcule ainsi :
Si le nombre de dimensions de x et y n’est pas égal, préfixez de 1 les dimensions du tenseur ayant le moins de dimensions pour les rendre de même longueur. Ensuite, pour chaque dimension, la taille résultante est le maximum des tailles de x et y le long de cette dimension. Par exemple :
# aligner les dimensions de fin facilite la lecture
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# mais ce n'est pas nécessaire :
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Vous avez saisi l’idée !
Le produit tensoriel est la forme la plus courante de multiplication entre tenseurs, mais il en existe d’autres : le produit scalaire tensoriel (tensor dot product) et la contraction tensorielle, par exemple.
Convertir un tenseur Torch en tableau NumPy et inversement est un jeu d’enfant. On parle de Numpy Bridge. Voyons cela.
Le tenseur Torch et le tableau NumPy partagent la même zone mémoire sous-jacente ; modifier l’un modifie l’autre.
Conversion d’un tenseur Torch en tableau NumPy.
# Un tenseur 1D de 5 uns
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Convertir le tenseur Torch en tableau NumPy
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Voyez comme le tableau NumPy reflète les valeurs.
Dans les sections précédentes, vous avez effectué des opérations de base sur les tenseurs : addition, soustraction et produits. Dans la section suivante, vous allez implémenter un réseau de neurones simple avec PyTorch.
Si vous avez besoin d’un rappel sur les réseaux de neurones, cet article DataCamp est une excellente référence. Vous pouvez aussi consulter :
Avant l’implémentation, parlons d’un concept central pour tous les réseaux de neurones dans PyTorch : l’auto-différenciation. Elle est particulièrement utile pour calculer les gradients lors de la rétropropagation.
Le package autograd fournit l’auto-différenciation pour toutes les opérations sur les tenseurs. C’est un framework define-by-run : la rétropropagation est définie par l’exécution de votre code, chaque itération pouvant être différente.
Voyons l’auto-différenciation à l’œuvre avec un exemple très simple.
# Créer un tenseur d'ordre 2 rempli de uns
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Faites une addition.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Effectuez quelques opérations supplémentaires sur y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Passons à la rétropropagation : comme out est un scalaire, out.backward() équivaut à out.backward(torch.tensor(1)).
out.backward()

# afficher les gradients d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Vous connaissez maintenant l’auto-différenciation et la manière dont PyTorch la gère. Vous allez coder un réseau de neurones simple avec PyTorch.
Vous allez créer un réseau avec une couche cachée et une seule unité de sortie. Vous utiliserez l’activation ReLU dans la couche cachée et la sigmoïde en sortie.
Commencez par importer PyTorch. Les réseaux de neurones se construisent avec le package torch.nn.
import torch
import torch.nn as nn
Définissez ensuite les tailles de toutes les couches et la taille de lot (batch size) :
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Créez maintenant des données d’entrée factices x et des cibles factices y. Vous utiliserez des tenseurs PyTorch pour stocker ces données. Les tenseurs PyTorch s’utilisent comme des tableaux NumPy, avec l’avantage supplémentaire de pouvoir tourner sur GPU. Dans ce tutoriel, nous resterons sur CPU, mais le passage au GPU est très simple.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
Définissez maintenant le modèle en une seule ligne.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Ce modèle correspond à : input -> linear -> ReLU -> linear -> sigmoid. Il existe une autre manière de définir des modèles — pratique pour des architectures plus complexes et personnalisées — en définissant une classe. Plus d’infos ici.
Il est temps de définir la fonction de perte. Nous utiliserons la moyenne des erreurs quadratiques (Mean Squared Error).
criterion = torch.nn.MSELoss()
N’oubliez pas de définir l’optimiseur. Nous utiliserons le puissant Stochastic Gradient Descent avec un taux d’apprentissage de 0,01. model.parameters() renvoie un itérateur sur les paramètres (poids et biais) du modèle.
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Exécutons maintenant la descente de gradient pendant 50 époques. Chaque itération effectue, dans l’ordre : propagation avant, calcul de la perte, rétropropagation et mise à jour des paramètres.
for epoch in range(50):
    # Propagation avant
    y_pred = model(x)
    # Calcul et affichage de la perte
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Remise à zéro des gradients
    optimizer.zero_grad()

    # Rétropropagation
    loss.backward()

    # Mise à jour des paramètres
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred contient les valeurs prédites issues de la passe avant du modèle. Vous le passez, avec les cibles y, au critère qui calcule la perte.
Puis optimizer.zero_grad() remet tous les gradients à zéro, pour éviter leur accumulation au fil des itérations.
Ensuite, loss.backward() est la magie PyTorch qui utilise Autograd : il calcule automatiquement tous les gradients par rapport à tous les paramètres en se basant sur le graphe de calcul généré dynamiquement. C’est la rétropropagation de la descente de gradient.
Enfin, optimizer.step() met à jour une fois tous les paramètres à partir des nouveaux gradients.
Vous êtes arrivé au bout. Dans cet article, nous avons couvert un large éventail de sujets, des tenseurs à l’auto-différenciation, et plus encore ! Vous avez aussi implémenté un petit réseau de neurones avec PyTorch et son système de tenseurs.
Pour aller plus loin avec PyTorch, consultez la documentation et les tutoriels officiels, très bien écrits. Vous les trouverez ici.
Voici quelques références qui m’ont aidé à rédiger ce tutoriel :
N’hésitez pas à poser vos questions ou partager vos idées dans les commentaires !
Si vous souhaitez approfondir Python, suivez le cours Statistical Thinking in Python (Part 1) sur DataCamp.
Approfondir Python et PyTorch
Cours
Cours