Curso
Introducción al Deep Learning en Python
4 h
264.6K
En deep learning, es muy habitual hablar de los tensores como la estructura de datos fundamental. De hecho, tensor aparece en el nombre de la biblioteca de machine learning de Google: «TensorFlow». Los tensores son un tipo de estructura de datos usada en álgebra lineal y, al igual que los vectores y las matrices, permiten realizar operaciones aritméticas.
Por otro lado, PyTorch es un paquete de Python creado por Facebook que ofrece dos capacidades principales: 1) Cálculo con tensores (como NumPy) con gran aceleración por GPU y 2) redes neuronales profundas construidas sobre un sistema de diferenciación automática basado en cinta.
En este tutorial, descubrirás qué son los tensores y cómo manipularlos en Python con PyTorch.
Así que, sin más preámbulos, empecemos con la introducción a los tensores.
Un tensor es una generalización de vectores y matrices y puede entenderse fácilmente como un array multidimensional. Según el conocido libro «Deep Learning» (Goodfellow et al.) -
«En el caso general, un array de números dispuesto en una rejilla regular con un número variable de ejes se conoce como tensor.»
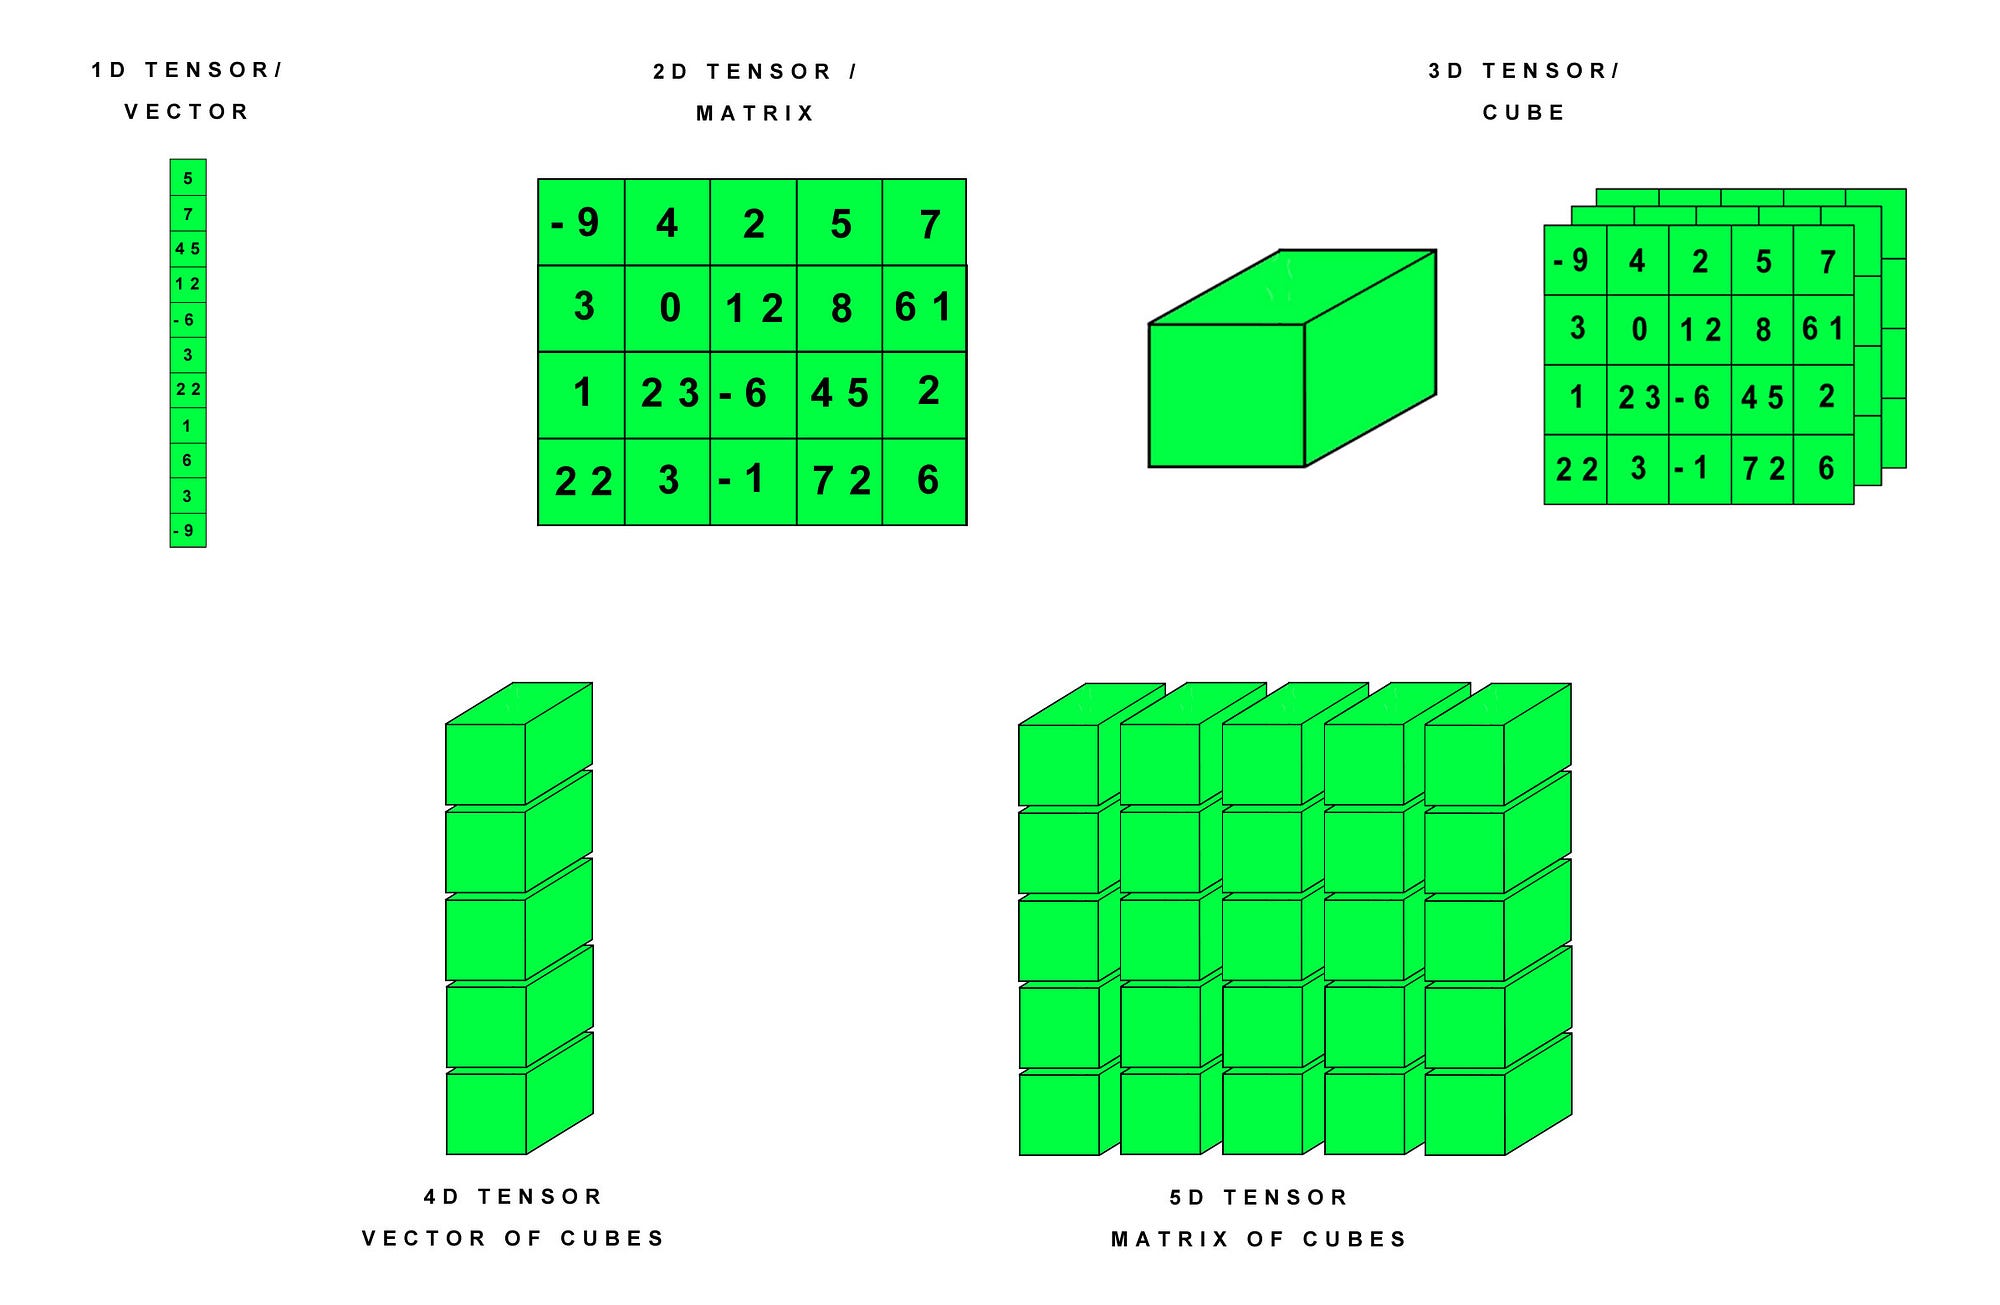
Un escalar es un tensor de orden cero o de rango cero. Un vector es un tensor unidimensional o de primer orden, y una matriz es un tensor bidimensional o de segundo orden.
La siguiente infografía describe los tensores de forma muy clara:
Ahora construyamos la intuición detrás de los tensores de una forma más sencilla.
Un tensor es el bloque básico de la IA moderna. En esencia, es un contenedor de datos. Normalmente contiene números. A veces incluso cadenas, aunque es poco común. Piensa en él como en un «cubo» de números.
A menudo, se confunde tensor con array multidimensional. Según StackExchange:
Los tensores y los arrays multidimensionales son tipos de objetos distintos. El primero es un tipo de función. El segundo es una estructura de datos adecuada para representar un tensor en un sistema de coordenadas.
Matemáticamente, los tensores se definen como funciones multilineales. Una función multilineal consta de varias variables vectoriales. Un campo tensorial es una función con valores tensoriales. Para una explicación matemática rigurosa, puedes leer aquí.
Así que, los tensores son funciones o contenedores que necesitas definir. El cálculo real ocurre cuando se les alimenta con datos. Lo que ves como arrays o multidimensional (1D, 2D, …, ND) puede considerarse como tensores genéricos.
Ahora, hablemos un poco de la notación tensorial.
La notación tensorial se parece mucho a la matricial: una letra mayúscula representa un tensor y letras minúsculas con subíndices enteros representan valores escalares dentro del tensor.

Muchas de las operaciones que pueden realizarse con escalares, vectores y matrices pueden reformularse para trabajar con tensores.
Como herramienta, los tensores y el álgebra tensorial se usan ampliamente en física e ingeniería. El entrenamiento y funcionamiento de modelos de deep learning emplea estos conceptos de forma natural.
PyTorch es un paquete de computación científica basado en Python orientado a:
Resumamos rápidamente las características únicas de PyTorch:
PyTorch ofrece una amplia variedad de rutinas con tensores para acelerar y cubrir tus necesidades de computación científica: slicing, indexación, operaciones matemáticas, álgebra lineal, reducciones… Y son rápidas.
PyTorch tiene una forma única de construir redes neuronales: utilizando y reproduciendo una «grabadora de cinta».
La mayoría de frameworks como TensorFlow, Theano, Caffe o CNTK tienen una vista estática del mundo. Hay que construir una red neuronal y reutilizar la misma estructura una y otra vez. Cambiar el comportamiento de la red significa empezar desde cero.
PyTorch utiliza una técnica llamada diferenciación automática en modo inverso, que te permite cambiar el comportamiento de tu red de forma arbitraria con latencia y sobrecarga prácticamente nulas. Nuestra inspiración proviene de varios artículos de investigación sobre este tema, así como de trabajos actuales y pasados como autograd, Chainer, etc.
(Aunque esta técnica no es exclusiva de PyTorch, su implementación es de las más rápidas hasta la fecha. Obtienes lo mejor de la velocidad y la flexibilidad para tus investigaciones más ambiciosas).
(Por tanto, PyTorch es bastante rápido, tanto si ejecutas redes pequeñas como grandes).
Este blog compara muy bien PyTorch y TensorFlow.
P. D.: este blog de DataCamp es un excelente punto de partida para empezar con TensorFlow.
Instalar PyTorch es bastante directo. Como PyTorch aprovecha el cómputo eficiente en GPU, se comunica con tus drivers de CUDA y acelera las operaciones.
Vas a necesitar torch y torchvision para usar PyTorch. Vamos a instalarlos en un entorno Windows. Más adelante verás los pasos para Linux y Mac.
Tengo Python 3.5 con Anaconda instalado. Además, no tengo CUDA. Ejecuta los siguientes comandos para instalar torch y torchvision:
(Ten en cuenta que PyTorch no es compatible con Python 2.7. Debes tener Python => 3.5).
Si tienes CUDA habilitado en tu máquina, puedes ejecutar lo siguiente (para CUDA 9.0):
Ahora, veamos los pasos de instalación en Linux con Python 3.5 y sin soporte CUDA:
¡Sí, lo has adivinado! Es igual que en Windows.
Si tienes soporte CUDA (9.0), entonces el paso sería:
Para Mac con Python 3.5 y sin soporte CUDA, los pasos serían:
Y, con soporte CUDA (9.0):
(Los binarios de macOS no soportan CUDA; instala desde el código fuente si necesitas CUDA)
¡Esperamos que ya tengas PyTorch instalado!
Ahora, pasemos directamente a hacer algo de aritmética con tensores en PyTorch.
Primero, importemos las librerías necesarias.
from __future__ import print_function
import torch
Si la instalación de PyTorch fue correcta, ejecutar las líneas anteriores no debería dar errores.
Ahora, construyamos una matriz 5x3, no inicializada:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Construye una matriz de ceros y de tipo de datos long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Construye un tensor directamente a partir de datos:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Si has entendido bien los tensores, ¡cuéntame en los comentarios qué tipo de tensor es x!
Puedes crear un tensor a partir de otro existente. Estos métodos reutilizan las propiedades del tensor de entrada, por ejemplo el dtype (tipo de dato), a menos que el usuario proporcione nuevos valores:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Obtén su tamaño:
print(x.size())
torch.Size([5, 3])
Ten en cuenta que torch.Size es en realidad una tupla, por lo que admite todas las operaciones de tuplas.
Ahora, hagamos una operación de suma con tensores.
La suma elemento a elemento de dos tensores con las mismas dimensiones produce un nuevo tensor con las mismas dimensiones, donde cada valor escalar es la suma elemento a elemento de los escalares en los tensores originales.

# Sintaxis 1 para sumar tensores en PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Sintaxis 2 para sumar tensores en PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Hagamos ahora una resta de tensores.
La resta elemento a elemento de un tensor a otro con las mismas dimensiones produce un nuevo tensor con las mismas dimensiones, donde cada valor escalar es la resta elemento a elemento de los escalares en los tensores originales.

Ahora veamos el producto tensorial:
Realiza una multiplicación matricial de las matrices mat1 y mat2.
Si mat1 es un tensor (n×m), mat2 es un tensor (m×p), la salida será un tensor (n×p).
Puedes hacer productos tensoriales en PyTorch así:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Ten en cuenta que torch.mm() no hace broadcasting. Hablemos un poco del broadcasting.
El término broadcasting describe cómo se tratan arrays de formas distintas durante operaciones aritméticas. Sujeto a ciertas restricciones, el array más pequeño se «difunde» sobre el más grande para que sus formas sean compatibles. El broadcasting permite vectorizar operaciones con arrays para que los bucles ocurran en C en lugar de en Python. Lo hace sin crear copias innecesarias de datos y suele conducir a implementaciones eficientes. Sin embargo, hay casos en los que el broadcasting no conviene porque implica un uso ineficiente de memoria que ralentiza el cálculo.
Dos tensores son «broadcastables» si se cumplen las siguientes reglas:
Entendámoslo en PyTorch con el siguiente fragmento:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# las mismas formas siempre son broadcastables (las reglas anteriores siempre se cumplen)
x=torch.empty((0,))
y=torch.empty(2,2)
# x e y no son broadcastables, porque x no tiene al menos 1 dimensión
# se pueden alinear las dimensiones finales
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x e y son broadcastables.
# 1.ª dimensión final: ambos tienen tamaño 1
# 2.ª dimensión final: y tiene tamaño 1
# 3.ª dimensión final: tamaño de x == tamaño de y
# 4.ª dimensión final: la dimensión de y no existe
# pero:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x e y no son broadcastables, porque en la 3.ª dimensión final 2 != 3
Ahora que tienes una idea clara del broadcasting, veamos cuál sería el tensor resultante cuando dos tensores son «broadcastables».
Si dos tensores x, y son «broadcastables», el tamaño del tensor resultante se calcula así:
Si el número de dimensiones de x e y no es igual, antepone 1 a las dimensiones del tensor con menos dimensiones para igualarlas. Luego, para cada dimensión, el tamaño resultante es el máximo de los tamaños de x e y en esa dimensión. Por ejemplo:
# alinear dimensiones finales facilita la lectura
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# pero no es necesario:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
¡Ya tienes el concepto!
El producto tensorial es la forma más común de multiplicación de tensores que encontrarás, pero existen otros tipos, como el producto punto de tensores y la contracción tensorial.
Convertir un tensor de Torch en un array de NumPy y viceversa es pan comido. A esto se le llama el puente con NumPy (Numpy Bridge). Veámoslo.
El tensor de Torch y el array de NumPy comparten la misma memoria subyacente, por lo que cambiar uno cambia el otro.
Convertir un tensor de Torch en un array de NumPy.
# Un tensor 1D de 5 unos
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Convertir el tensor de Torch a un array de NumPy
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Observa cómo el array de NumPy cambia de valor.
En las secciones anteriores hiciste aritmética básica con tensores como suma, resta y productos. Ahora, en la siguiente sección, implementarás una red neuronal básica en PyTorch.
Si necesitas un recordatorio de redes neuronales, este artículo de DataCamp es un gran recurso. También puedes consultar:
Antes de implementarla, hablemos un poco de un concepto llamado diferenciación automática, central en todas las redes neuronales en PyTorch. Es especialmente útil para calcular gradientes durante la retropropagación.
El paquete autograd proporciona diferenciación automática para todas las operaciones sobre tensores. Es un framework define-by-run, lo que significa que la retropropagación se define por cómo se ejecuta tu código y que cada iteración puede ser diferente.
Veamos la diferenciación automática en acción con un ejemplo sencillo.
# Crea un tensor de rango 2 de unos
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Haz una suma.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Realiza algunas operaciones más sobre y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Ahora hagamos backprop: como out contiene un único escalar, out.backward() es equivalente a out.backward(torch.tensor(1)).
out.backward()

# imprime los gradientes d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Ya conoces la diferenciación automática y cómo la maneja PyTorch. Ahora vas a programar una red neuronal sencilla con PyTorch.
Crearás una red neuronal simple con una capa oculta y una única unidad de salida. Utilizarás la activación ReLU en la capa oculta y la activación sigmoide en la capa de salida.
Primero, necesitas importar la librería PyTorch. Las redes neuronales pueden construirse con el paquete torch.nn.
import torch
import torch.nn as nn
Después define los tamaños de todas las capas y el tamaño de batch:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Ahora crearás algunos datos de entrada ficticios x y datos objetivo ficticios y. Usarás tensores de PyTorch para almacenarlos. Los tensores de PyTorch se pueden usar y manipular como los arrays de NumPy, con la ventaja añadida de que pueden ejecutarse en GPU. En este tutorial los ejecutaremos en CPU, aunque pasarlos a GPU es muy sencillo.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
Y ahora definirás el modelo en una sola línea de código.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Esto crea un modelo con la forma input -> linear -> relu -> linear -> sigmoid. Hay otra manera de definir modelos, útil para arquitecturas más complejas y personalizadas: definir el modelo en una clase. Puedes leer sobre ello aquí.
Ahora toca construir la función de pérdida. Usarás el error cuadrático medio (MSE).
criterion = torch.nn.MSELoss()
Y no olvides definir el optimizador. En este caso, usarás el potente descenso estocástico por gradiente (SGD) con una tasa de aprendizaje de 0.01. model.parameters() devuelve un iterador sobre los parámetros (pesos y sesgos) del modelo.
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Ahora ejecutarás gradiente descendente durante 50 epochs. Esto realiza, en ese orden, la propagación hacia delante, el cálculo de la pérdida, la retropropagación y la actualización de parámetros.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred obtiene los valores predichos tras la pasada hacia delante del modelo. Pasas esto, junto con los valores objetivo y, al criterio que calcula la pérdida.
Luego, optimizer.zero_grad() pone a cero todos los gradientes. Es necesario para que los gradientes previos no se acumulen.
Después, loss.backward() es la magia de PyTorch que usa Autograd. Autograd calcula automáticamente todos los gradientes con respecto a todos los parámetros según el grafo de cómputo que crea dinámicamente. Básicamente, hace la pasada hacia atrás (backpropagation) del gradiente descendente.
Por último, llamas a optimizer.step(), que realiza una única actualización de todos los parámetros usando los nuevos gradientes.
Has llegado al final. En este post has cubierto un montón de conceptos, desde tensores hasta diferenciación automática y mucho más. También implementaste una red neuronal sencilla usando PyTorch y su sistema de tensores.
Si quieres aprender más sobre PyTorch y profundizar, échale un vistazo a la documentación y los tutoriales oficiales. Están muy bien escritos. Los encontrarás aquí.
A continuación tienes algunas referencias que me ayudaron a escribir este tutorial:
Si tienes alguna pregunta o quieres comentar algo, ¡déjalo en la sección de comentarios!
Si te interesa aprender más sobre Python, haz el curso de DataCamp Statistical Thinking in Python (Part 1).
Aprende más sobre Python y PyTorch
Curso
Curso
Tutorial
Arjun Sarkar
15 min
Tutorial
Tutorial
Abid Ali Awan
15 min
Tutorial
Natassha Selvaraj
10 min
Tutorial
Abid Ali Awan
14 min
Tutorial
Moez Ali
14 min