
Last chance! 50% off DataCamp Premium
Sale ends in
Nel deep learning, è comune vedere molte discussioni sui tensori come struttura dati fondamentale. Tensor compare persino nel nome della libreria di machine learning di punta di Google: “TensorFlow”. I tensori sono un tipo di struttura dati usata in algebra lineare e, come vettori e matrici, puoi eseguire operazioni aritmetiche con i tensori.
PyTorch è invece un pacchetto Python sviluppato da Facebook che offre due funzionalità di alto livello: 1) Calcolo con tensori (come NumPy) con potente accelerazione GPU e 2) Reti neurali profonde costruite su un sistema di differenziazione automatica basato su “tape”.
In questo tutorial scoprirai cosa sono i tensori e come manipolarli in Python con PyTorch.
Quindi, senza ulteriori indugi, iniziamo con l’introduzione ai tensori.
Un tensore è una generalizzazione di vettori e matrici e si può intendere facilmente come un array multidimensionale. Secondo il noto libro di deep learning “Deep Learning” (Goodfellow et al.) -
"Nel caso generale, un array di numeri disposto su una griglia regolare con un numero variabile di assi è noto come tensore."
Uno scalare è un tensore di ordine zero (o rango zero). Un vettore è un tensore monodimensionale o di primo ordine, e una matrice è un tensore bidimensionale o di secondo ordine.
La seguente infografica descrive i tensori in modo molto intuitivo:
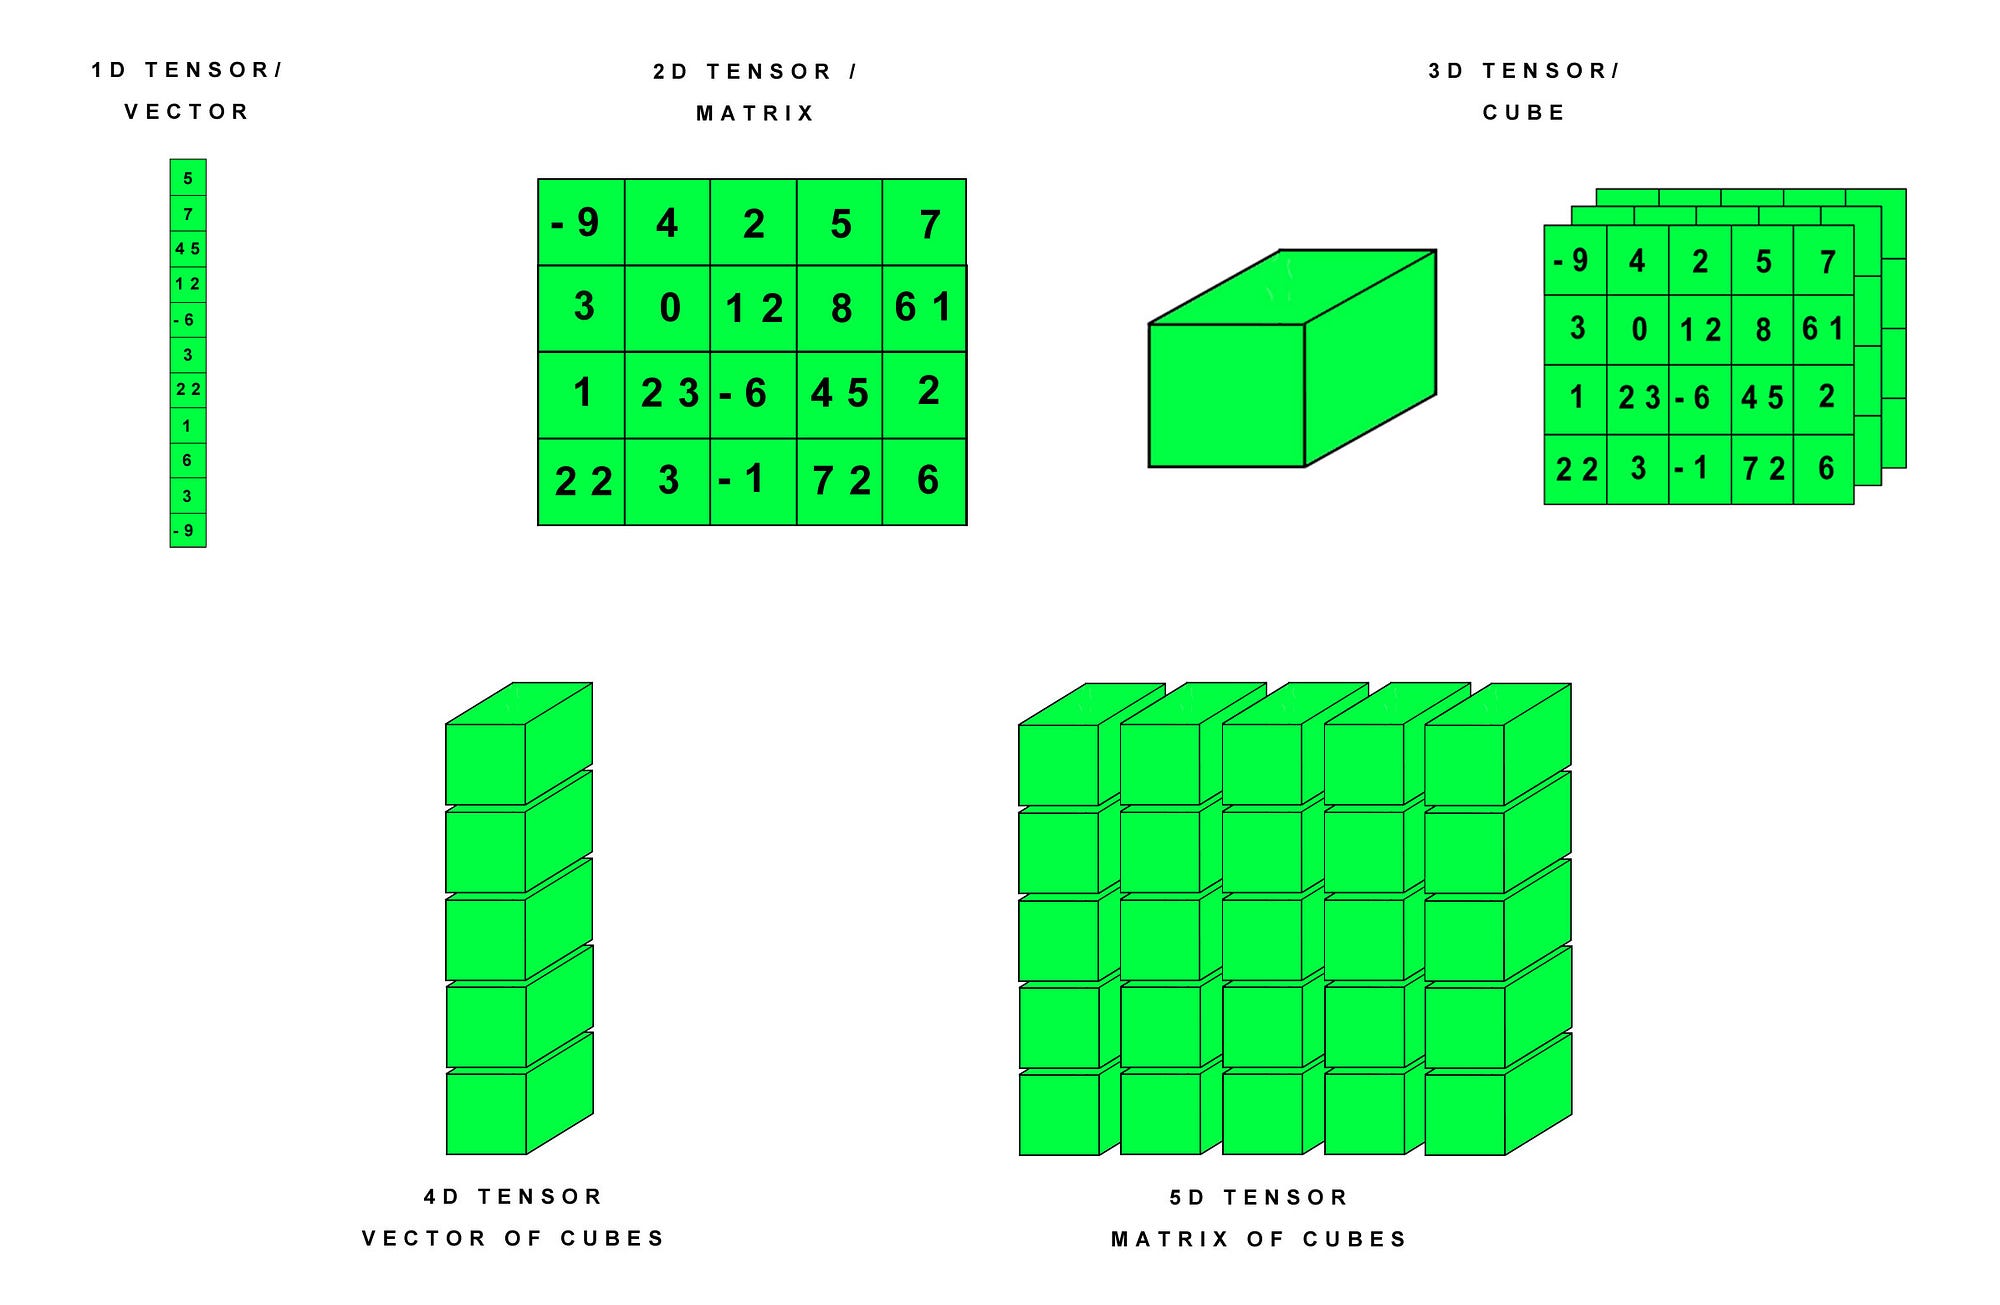
Costruiamo ora l’intuizione dietro i tensori in modo ancora più chiaro.
Un tensore è il mattone di base del machine learning moderno. Alla base è un contenitore di dati. Per lo più contiene numeri. A volte include anche stringhe, ma è raro. Quindi pensalo come a un secchio di numeri.
Spesso però si confondono i tensori con gli array multidimensionali. Come dice StackExchange:
I tensori e gli array multidimensionali sono tipi di oggetti diversi. Il primo è un tipo di funzione. Il secondo è una struttura dati adatta a rappresentare un tensore in un sistema di coordinate.
Matematicamente, i tensori sono definiti come funzioni multilineari. Una funzione multilineare consiste di varie variabili vettoriali. Un campo tensoriale è una funzione a valori tensoriali. Per una spiegazione matematica rigorosa, puoi leggere qui.
Dunque, i tensori sono funzioni o contenitori che devi definire. Il calcolo vero e proprio avviene quando vengono forniti i dati. Quello che vedi come array o multidimensionale (1D, 2D, …, ND) può essere considerato come tensori generici.
Parliamo ora un po’ della notazione dei tensori.
La notazione dei tensori assomiglia a quella delle matrici: una lettera maiuscola rappresenta un tensore e lettere minuscole con indici interi rappresentano i valori scalari all’interno del tensore.

Molte delle operazioni che si possono eseguire con scalari, vettori e matrici possono essere riformulate per essere eseguite con i tensori.
Come strumento, i tensori e l’algebra tensoriale sono ampiamente usati in fisica e ingegneria. Il termine e l’insieme di tecniche note nel machine learning per l’addestramento e l’uso di modelli di deep learning possono essere descritti in termini di tensori.
PyTorch è un pacchetto di calcolo scientifico basato su Python pensato per:
Riassumiamo rapidamente le caratteristiche uniche di PyTorch:
PyTorch offre un’ampia varietà di routine sui tensori per accelerare e soddisfare le tue esigenze di calcolo scientifico, come slicing, indicizzazione, operazioni matematiche, algebra lineare, riduzioni. E sono veloci.
PyTorch ha un modo unico di costruire reti neurali: usando e rigiocando un registratore a nastro.
La maggior parte dei framework come TensorFlow, Theano, Caffe e CNTK hanno una visione statica del mondo. Bisogna costruire una rete neurale e riutilizzare la stessa struttura più e più volte. Cambiare il comportamento della rete significa dover ripartire da zero.
PyTorch usa una tecnica chiamata auto-differenziazione in modalità inversa (Reverse-mode), che ti permette di cambiare arbitrariamente il comportamento della tua rete con latenza o overhead nulli. La nostra ispirazione arriva da diversi articoli di ricerca su questo tema, oltre che da lavori passati e presenti come autograd, autograd, Chainer, ecc.
(Sebbene questa tecnica non sia unica di PyTorch, la sua è una delle implementazioni più veloci finora. Ottieni il meglio in termini di velocità e flessibilità per le tue ricerche più ardite.)
(Perciò, PyTorch è piuttosto veloce — che tu esegua reti neurali piccole o grandi.)
Questo blog mette molto bene a confronto PyTorch e TensorFlow.
P.S.: Questo blog di DataCamp è un ottimo punto di partenza per iniziare con TensorFlow.
L’installazione di PyTorch è piuttosto semplice. Poiché PyTorch supporta un calcolo GPU efficiente, comunica in modo efficace con i driver Cuda e lavora più velocemente.
Per usare PyTorch ti serviranno torch e torchvision. Installiamoli in ambiente Windows. Più avanti vedrai i passaggi anche per Linux e Mac.
Io ho Python 3.5 con Anaconda configurato. Inoltre, non ho CUDA. Esegui i seguenti comandi per installare torch e torchvision:
(Tieni presente che PyTorch non supporta Python 2.7. Quindi è necessario avere una versione di Python => 3.5.)
Se hai CUDA abilitato sulla tua macchina, esegui pure quanto segue (questo è per CUDA 9.0):
Vediamo ora i passaggi di installazione per un ambiente Linux con Python 3.5 e senza supporto CUDA:
Sì, l’hai indovinato! È uguale a quello per Windows.
Ora, se hai il supporto CUDA (9.0), allora il passaggio sarà:
Per un ambiente Mac con Python 3.5 e senza supporto CUDA i passaggi saranno:
E, con supporto CUDA (9.0):
(I binari MacOS non supportano CUDA, installa dai sorgenti se ti serve CUDA)
Spero che a questo punto tu abbia completato l’installazione di PyTorch!
Ora tuffiamoci direttamente in un po’ di aritmetica con i tensori in PyTorch.
Per prima cosa, importiamo tutte le librerie necessarie.
from __future__ import print_function
import torch
Se l’installazione di PyTorch è andata a buon fine, l’esecuzione delle righe di codice sopra non darà errori.
Ora, costruiamo una matrice 5x3, non inizializzata:
x = torch.rand(5, 3)
print(x)
tensor([[ 0.5991,  0.9365,  0.6120],
        [ 0.3622,  0.1408,  0.8811],
        [ 0.6248,  0.4808,  0.0322],
        [ 0.2267,  0.3715,  0.8430],
        [ 0.0145,  0.0900,  0.3418]])
Costruiamo una matrice piena di zeri e di tipo long:
x = torch.zeros(5, 3, dtype=torch.long)
print(x)
tensor([[ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0],
        [ 0,  0,  0]])
Costruiamo un tensore direttamente dai dati:
x = torch.tensor([5.5, 3])
print(x)
tensor([ 5.5000, 3.0000])
Se hai capito bene i tensori, dimmi nei commenti che tipo di tensore è x!
Puoi creare un tensore a partire da un tensore esistente. Questi metodi riutilizzeranno le proprietà del tensore di input, ad esempio il dtype (tipo di dato), a meno che l’utente non fornisca nuovi valori:
x = x.new_ones(5, 3, dtype=torch.double)
print(x)

x = torch.randn_like(x, dtype=torch.float)
print(x)
tensor([[ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.],
        [ 1.,  1.,  1.]], dtype=torch.float64)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
Ottieni la sua dimensione:
print(x.size())
torch.Size([5, 3])
Nota che torch.Size è in realtà una tupla, quindi supporta tutte le operazioni sulle tuple.
Ora facciamo un’operazione di somma sui tensori.
L’addizione elemento per elemento di due tensori con le stesse dimensioni produce un nuovo tensore con le stesse dimensioni in cui ogni valore scalare è la somma elemento per elemento degli scalari nei tensori di partenza.

# Sintassi 1 per l'addizione di tensori in PyTorch
y = torch.rand(5, 3)
print(x)
print(y)
print(x + y)
tensor([[-1.2174,  1.1807,  1.4249],
        [-1.1114, -0.8098,  0.4003],
        [ 0.0780, -0.5011, -1.0985],
        [ 1.8160, -0.3778, -0.8610],
        [-0.7109, -2.0509, -1.2079]])
tensor([[ 0.8285,  0.7619,  0.1147],
        [ 0.1624,  0.8994,  0.6119],
        [ 0.2802,  0.2950,  0.7098],
        [ 0.8132,  0.3382,  0.4383],
        [ 0.6738,  0.2022,  0.3264]])
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
# Sintassi 2 per l'addizione di tensori in PyTorch
print(torch.add(x, y))
tensor([[-0.3889,  1.9426,  1.5396],
        [-0.9490,  0.0897,  1.0122],
        [ 0.3583, -0.2061, -0.3887],
        [ 2.6292, -0.0396, -0.4227],
        [-0.0371, -1.8487, -0.8815]])
Facciamo ora la sottrazione tra tensori.
La sottrazione elemento per elemento di un tensore da un altro con le stesse dimensioni produce un nuovo tensore con le stesse dimensioni in cui ogni valore scalare è la sottrazione elemento per elemento degli scalari nei tensori di partenza4.

Ora diamo un’occhiata al prodotto tra tensori:
Esegue una moltiplicazione tra matrici su mat1 e mat2.
Se mat1 è un tensore (n×m), mat2 è un tensore (m×p), l’output sarà un tensore (n×p).
In PyTorch fai i prodotti tra tensori come segue:
mat1 = torch.randn(2, 3)
mat2 = torch.randn(3, 3)
print(mat1)
print(mat2)
print(torch.mm(mat1, mat2))
tensor([[ 1.9490, -0.6503, -1.9448],
        [-0.7126,  1.0519, -0.4250]])
tensor([[ 0.0846,  0.4410, -0.0625],
        [-1.3264, -0.5265,  0.2575],
        [-1.3324,  0.6644,  0.3528]])
tensor([[ 3.6185, -0.0901, -0.9753],
        [-0.8892, -1.1504,  0.1654]])
Nota che torch.mm() non effettua broadcasting. Parliamo un po’ di broadcasting.
Il termine broadcasting descrive come vengono trattati gli array con forme diverse durante le operazioni aritmetiche. Soggetto a determinate condizioni, l’array più piccolo viene “esteso” sull’array più grande in modo che abbiano forme compatibili. Il broadcasting offre un modo per vettorializzare le operazioni sugli array così che i cicli avvengano in C invece che in Python. Lo fa senza creare copie inutili dei dati e solitamente porta a implementazioni efficienti degli algoritmi. Ci sono però casi in cui il broadcasting è una cattiva idea perché porta a un uso inefficiente della memoria che rallenta il calcolo.
Due tensori sono “broadcastable” se valgono le seguenti regole:
Capiremo questo con PyTorch usando il seguente snippet di codice:
x=torch.empty(5,7,3)
y=torch.empty(5,7,3)
# same shapes are always broadcastable (i.e. the above rules always hold)
x=torch.empty((0,))
y=torch.empty(2,2)
# x and y are not broadcastable, because x does not have at least 1 dimension
# can line up trailing dimensions
x=torch.empty(5,3,4,1)
y=torch.empty(  3,1,1)
# x and y are broadcastable.
# 1st trailing dimension: both have size 1
# 2nd trailing dimension: y has size 1
# 3rd trailing dimension: x size == y size
# 4th trailing dimension: y dimension doesn't exist
# but:
>>> x=torch.empty(5,2,4,1)
>>> y=torch.empty(  3,1,1)
# x and y are not broadcastable, because in the 3rd trailing dimension 2 != 3
Ora che hai un’idea chiara del broadcasting, vediamo, se due tensori sono “broadcastable”, quale sarà il tensore risultante.
Se due tensori x, y sono “broadcastable”, la dimensione del tensore risultante si calcola così:
Se il numero di dimensioni di x e y non è uguale, si premette 1 alle dimensioni del tensore con meno dimensioni per renderle di uguale lunghezza. Poi, per ogni dimensione, la dimensione risultante è il massimo tra le dimensioni di x e y lungo quella dimensione. Per esempio:
# can line up trailing dimensions to make reading easier
x=torch.empty(5,1,4,1)
y=torch.empty(  3,1,1)
(x+y).size()
torch.Size([5, 3, 4, 1])
torch.Size([5, 3, 4, 1])
# but not necessary:
x=torch.empty(1)
y=torch.empty(3,1,7)
(x+y).size()
torch.Size([3, 1, 7])
torch.Size([3, 1, 7])
x=torch.empty(5,2,4,1)
y=torch.empty(3,1,1)
(x+y).size()
---------------------------------------------------------------------------

RuntimeError                              Traceback (most recent call last)

<ipython-input-17-72fb34250db7> in <module>()
      1 x=torch.empty(5,2,4,1)
      2 y=torch.empty(3,1,1)
----> 3 (x+y).size()


RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Ora il concetto ti è chiaro!
Il prodotto tensoriale è la forma più comune di moltiplicazione tra tensori che potresti incontrare, ma esistono molti altri tipi di moltiplicazioni tra tensori, come il prodotto scalare tra tensori e la contrazione di tensori.
Convertire un tensore Torch in un array NumPy e viceversa è un gioco da ragazzi. Il concetto è chiamato Numpy Bridge. Diamo un’occhiata.
Il tensore Torch e l’array NumPy condivideranno la stessa area di memoria sottostante, e cambiare uno cambierà anche l’altro.
Conversione di un tensore Torch in un array NumPy.
# A 1D tensor of 5 ones
a = torch.ones(5)
print(a)
tensor([ 1., 1., 1., 1., 1.])
# Convert the Torch tensor to a NumPy array
b = a.numpy()
print(b)
[1. 1. 1. 1. 1.]
Guarda come l’array NumPy cambia di valore.
Quindi, nelle sezioni sopra, hai fatto alcune operazioni di base con i tensori come addizione, sottrazione e prodotti tra tensori. Ora, nella sezione seguente, implementerai una semplice rete neurale in PyTorch.
Se ti serve un ripasso sulle reti neurali, allora questo articolo di DataCamp è il posto migliore da cui partire. Potresti anche voler consultare i seguenti link:
Prima di implementare, discutiamo un po’ di un concetto chiamato differenziazione automatica che è centrale per tutte le reti neurali in PyTorch. È particolarmente utile per calcolare i gradienti durante la backpropagation.
Il pacchetto autograd fornisce la differenziazione automatica per tutte le operazioni sui tensori. È un framework “define-by-run”, il che significa che la tua backpropagation è definita da come viene eseguito il tuo codice e che ogni singola iterazione può essere diversa.
Vediamo la differenziazione automatica in azione con un esempio di codice molto semplice.
# Create a Rank-2 tensor of all ones
x = torch.ones(2, 2, requires_grad=True)
print(x)
tensor([[ 1.,  1.],
        [ 1.,  1.]])
Esegui un’operazione di addizione.
y = x + 2
print(y)
tensor([[ 3.,  3.],
        [ 3.,  3.]])
Esegui qualche altra operazione su y.
z = y * y * 3
out = z.mean()

print(z, out)
tensor([[ 27.,  27.],
        [ 27.,  27.]]) tensor(27.)
Facciamo ora la backprop, perché out contiene uno scalare, out.backward() è equivalente a out.backward(torch.tensor(1)).
out.backward()

# print gradients d(out)/dx
print(x.grad)
tensor([[ 4.5000,  4.5000],
        [ 4.5000,  4.5000]])

Ora conosci la differenziazione automatica e come PyTorch la gestisce. Adesso coderai una semplice rete neurale usando PyTorch.
Creerai una semplice rete neurale con uno strato nascosto e una singola unità di output. Userai l’attivazione ReLU nello strato nascosto e l’attivazione sigmoid nello strato di output.
Per prima cosa devi importare la libreria PyTorch. Le reti neurali possono essere costruite usando il pacchetto torch.nn.
import torch
import torch.nn as nn
Poi definisci le dimensioni di tutti gli strati e la dimensione del batch:
n_in, n_h, n_out, batch_size = 10, 5, 1, 10
Ora creerai alcuni dati di input fittizi x e alcuni dati target fittizi y. Userai i tensori di PyTorch per archiviare questi dati. I tensori di PyTorch possono essere usati e manipolati proprio come gli array NumPy, con il vantaggio aggiuntivo che possono essere eseguiti sulle GPU. In questo tutorial li eseguirai semplicemente sulla CPU. Anche se, trasferirli su una GPU è piuttosto semplice.
x = torch.randn(batch_size, n_in)
y = torch.tensor([[1.0], [0.0], [0.0], [1.0], [1.0], [1.0], [0.0], [0.0], [1.0], [1.0]])
E ora definirai il modello in una riga di codice.
model = nn.Sequential(nn.Linear(n_in, n_h),
                     nn.ReLU(),
                     nn.Linear(n_h, n_out),
                     nn.Sigmoid())
Questo crea un modello che appare come input -> linear -> relu -> linear -> sigmoid. Esiste un altro modo per definire i modelli, usato per modelli più complessi e personalizzati. Si fa definendo il modello in una classe. Puoi leggerne qui.
Ora è il momento di costruire la funzione di perdita. Userai la Mean Squared Error Loss.
criterion = torch.nn.MSELoss()
Inoltre, non dimenticare di definire l’ottimizzatore. In questo esempio userai il potente Stochastic Gradient Descent e un learning rate di 0.01. model.parameters() restituisce un iteratore sui parametri del modello (pesi e bias).
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
Ora eseguirai la discesa del gradiente per 50 epoche. Questo esegue, in sequenza, forward propagation, calcolo della loss, backward propagation e aggiornamento dei parametri.
for epoch in range(50):
    # Forward Propagation
    y_pred = model(x)
    # Compute and print loss
    loss = criterion(y_pred, y)
    print('epoch: ', epoch,' loss: ', loss.item())
    # Zero the gradients
    optimizer.zero_grad()

    # perform a backward pass (backpropagation)
    loss.backward()

    # Update the parameters
    optimizer.step()
epoch:  0  loss:  0.2399429827928543
epoch:  1  loss:  0.23988191783428192
epoch:  2  loss:  0.23982088267803192
epoch:  3  loss:  0.2397598922252655
epoch:  4  loss:  0.23969893157482147
epoch:  5  loss:  0.23963800072669983
epoch:  6  loss:  0.23957709968090057
epoch:  7  loss:  0.23951618373394012
epoch:  8  loss:  0.23945537209510803
epoch:  9  loss:  0.23939454555511475
epoch:  10  loss:  0.23933371901512146
epoch:  11  loss:  0.23927298188209534
epoch:  12  loss:  0.23921218514442444
epoch:  13  loss:  0.23915143311023712
epoch:  14  loss:  0.2390907108783722
epoch:  15  loss:  0.23903003334999084
epoch:  16  loss:  0.23896940052509308
epoch:  17  loss:  0.23890872299671173
epoch:  18  loss:  0.23884813487529755
epoch:  19  loss:  0.23878750205039978
epoch:  20  loss:  0.23872694373130798
epoch:  21  loss:  0.2386663407087326
epoch:  22  loss:  0.2386058121919632
epoch:  23  loss:  0.23854532837867737
epoch:  24  loss:  0.23848481476306915
epoch:  25  loss:  0.23842433094978333
epoch:  26  loss:  0.2383638620376587
epoch:  27  loss:  0.23830339312553406
epoch:  28  loss:  0.2382429838180542
epoch:  29  loss:  0.23818258941173553
epoch:  30  loss:  0.2381247729063034
epoch:  31  loss:  0.2380656749010086
epoch:  32  loss:  0.23800739645957947
epoch:  33  loss:  0.2379491776227951
epoch:  34  loss:  0.2378900945186615
epoch:  35  loss:  0.23783239722251892
epoch:  36  loss:  0.23777374625205994
epoch:  37  loss:  0.23771481215953827
epoch:  38  loss:  0.23765745759010315
epoch:  39  loss:  0.23759838938713074
epoch:  40  loss:  0.23753997683525085
epoch:  41  loss:  0.2374821901321411
epoch:  42  loss:  0.23742322623729706
epoch:  43  loss:  0.23736533522605896
epoch:  44  loss:  0.23730707168579102
epoch:  45  loss:  0.23724813759326935
epoch:  46  loss:  0.23719079792499542
epoch:  47  loss:  0.23713204264640808
epoch:  48  loss:  0.23707345128059387
epoch:  49  loss:  0.2370160073041916
y_pred ottiene i valori predetti da un forward pass del modello. Passi questo, insieme ai valori target y, al criterion che calcola la loss.
Poi, optimizer.zero_grad() azzera tutti i gradienti. Devi farlo per evitare che i gradienti precedenti continuino ad accumularsi.
Quindi, loss.backward() è la magia principale di PyTorch che usa la funzione Autograd. Autograd calcola automaticamente tutti i gradienti rispetto a tutti i parametri in base al grafo computazionale che crea dinamicamente. In pratica, esegue il backward pass (backpropagation) della discesa del gradiente.
Infine, chiami optimizer.step() che esegue un singolo aggiornamento di tutti i parametri usando i nuovi gradienti.
Sei arrivato alla fine. In questo post hai coperto un bel po’ di argomenti partendo dai tensori fino alla differenziazione automatica e altro ancora! Hai anche implementato una semplice rete neurale usando PyTorch e il suo sistema di tensori.
Se vuoi saperne di più su PyTorch e approfondire, dai un’occhiata alla documentazione e ai tutorial ufficiali di PyTorch. Sono scritti davvero bene. Li trovi qui.
Di seguito alcune referenze che mi hanno aiutato a scrivere questo tutorial:
Fammi sapere se hai qualcosa da chiedere o discutere nei commenti!
Se ti interessa imparare di più su Python, segui il corso di DataCamp Statistical Thinking in Python (Parte 1).
Scopri di più su Python e PyTorch
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



